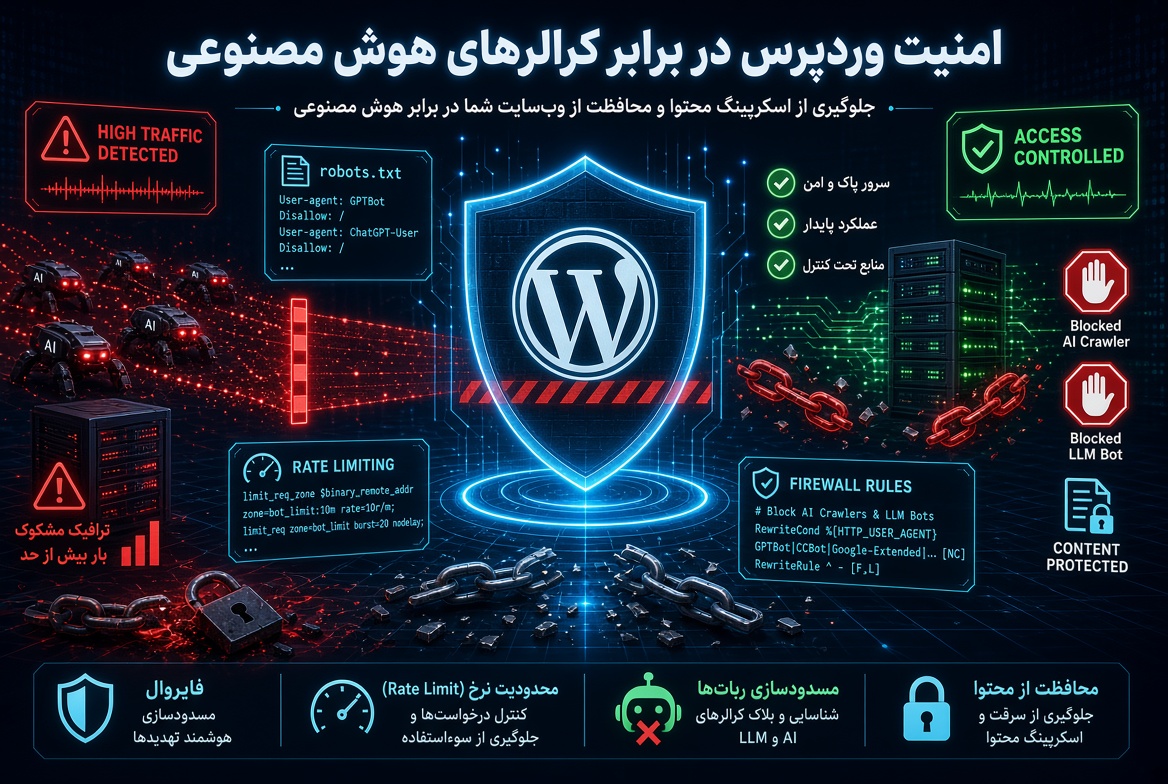
کرالرهای هوش مصنوعی دیگر فقط یک موضوع مربوط به «کپی شدن محتوا» نیستند. وقتی یک بات صدها یا هزاران صفحه وردپرس را بهصورت خودکار میخواند، علاوه بر برداشت محتوا میتواند باعث افزایش مصرف CPU، RAM، PHP Worker، پهنای باند و Queryهای دیتابیس شود. مشکل زمانی جدیتر میشود که اسکرپرها به robots.txt احترام نگذارند، User-Agent جعلی داشته باشند یا با پارامترهای تصادفی کش سایت را دور بزنند.
📌 پاسخ کوتاه: برای محافظت واقعی از وردپرس نباید فقط چند User-Agent را در robots.txt مسدود کنید.
🔹 برای جلوگیری از استفاده محتوا در آموزش مدلها، کرالرهای Training را در robots.txt محدود کنید.
🔹 اگر حضور در پاسخهای ChatGPT، Claude و موتورهای AI برایتان مهم است، باتهای Search را جداگانه بررسی کنید.
🔹 برای مقابله با اسکرپرهایی که robots.txt را نادیده میگیرند، از WAF، Rate Limit و کنترل در سطح CDN یا وبسرور استفاده کنید.
🔹 محتوای خصوصی یا پولی را هرگز فقط با robots.txt محافظت نکنید؛ این محتوا باید پشت احراز هویت قرار بگیرد.
کرالر هوش مصنوعی چیست و چرا برای وردپرس مهم شده است؟
کرالر AI یا LLM Crawler برنامهای خودکار است که صفحات وب را دریافت و پردازش میکند. اما همه این رباتها هدف یکسانی ندارند. برخی برای جمعآوری دادهای فعالیت میکنند که ممکن است در آموزش مدلهای زبانی استفاده شود، برخی صفحات را برای موتورهای جستوجوی مبتنی بر هوش مصنوعی ایندکس میکنند و برخی فقط زمانی به یک URL مراجعه میکنند که کاربر مستقیماً از یک دستیار AI درخواست بررسی آن صفحه را داشته باشد.
همین تفاوت باعث میشود سیاست «همه باتهای AI را ببند» برای بسیاری از سایتها تصمیم مناسبی نباشد. برای مثال، OpenAI بهطور رسمی GPTBot و OAI-SearchBot را با کاربردهای جداگانه معرفی میکند؛ GPTBot به جمعآوری محتوایی مربوط است که میتواند در توسعه و آموزش مدلها استفاده شود، درحالیکه OAI-SearchBot برای حضور وبسایتها در قابلیتهای جستوجوی ChatGPT به کار میرود. :contentReference[oaicite:1]{index=1}
آیا کرالرهای LLM واقعاً «حمله» محسوب میشوند؟
هر بازدید یک کرالر هوش مصنوعی حمله سایبری نیست. یک ربات شناختهشده که با سرعت منطقی چند صفحه را میخواند، بیشتر یک مصرفکننده خودکار محتوا محسوب میشود. اما همان فعالیت وقتی به اسکرپینگ تهاجمی، Crawl با نرخ بالا، جعل هویت، نادیده گرفتن robots.txt یا ایجاد فشار محسوس روی منابع سرور تبدیل شود، از دید عملیاتی شباهت زیادی به یک حمله لایه Application خواهد داشت.
| نوع فعالیت | رفتار معمول | ریسک برای وردپرس | کنترل مناسب |
|---|---|---|---|
| Training Crawler | جمعآوری گسترده محتوا | برداشت محتوا و مصرف منابع | robots.txt + WAF در صورت نیاز |
| AI Search Bot | ایندکس برای پاسخ و ارجاع | مصرف منابع، اما احتمال Referral | Allow یا Rate Limit کنترلشده |
| User Fetcher | دریافت صفحه به درخواست کاربر | معمولاً محدودتر | بررسی موردی و جلوگیری از Block کور |
| Unknown Scraper | جعل UA، درخواست سریع و انبوه | بالا | WAF، Rate Limit، Challenge و تحلیل رفتار |
کدام باتهای AI را باید بشناسیم؟
| Crawler | اپراتور | کاربرد اصلی | پیشنهاد عملی |
|---|---|---|---|
| GPTBot | OpenAI | محتوایی که ممکن است برای آموزش مدلها استفاده شود | در صورت عدم تمایل به Training مسدود شود |
| OAI-SearchBot | OpenAI | جستوجو و نمایش سایت در ChatGPT Search | اگر AI Visibility مهم است Allow شود |
| ClaudeBot | Anthropic | جمعآوری محتوای بالقوه برای توسعه و آموزش مدل | در صورت Opt-out مسدود شود |
| Claude-SearchBot | Anthropic | بهبود نتایج جستوجوی Claude | برای حضور در Search بهتر است جداگانه تصمیمگیری شود |
| Google-Extended | توکن کنترلی برای برخی استفادههای Gemini؛ User-Agent مستقل نیست | بدون مسدودکردن Googlebot قابل محدودسازی است | |
| CCBot | Common Crawl | جمعآوری Dataset وب | برای سایتهای حساس معمولاً کاندید محدودسازی است |
| Bytespider | ByteDance | AI Crawler | بر اساس لاگ و سیاست محتوا تصمیمگیری شود |
| Meta-ExternalAgent | Meta | AI Crawler | برای سایتهای محتوایی قابل بررسی و محدودسازی است |
⚠️
Google-Extended را با Googlebot اشتباه نگیرید. طبق مستندات گوگل، Google-Extended یک توکن کنترلی در robots.txt است و محدودسازی آن بهخودیخود مانع حضور سایت در Google Search نمیشود. :contentReference[oaicite:2]{index=2}
چرا وردپرس در برابر اسکرپینگ انبوه حساستر است؟
اگر صفحهای کاملاً Static باشد، خواندن هزار صفحه بیشتر به مصرف پهنای باند منجر میشود؛ اما در وردپرس درخواستهایی که از Cache عبور میکنند ممکن است PHP، دیتابیس، افزونهها و Theme را درگیر کنند. به همین دلیل فشار یک Scraper میتواند از تعداد بازدید ظاهری آن بسیار بیشتر باشد.
🔹 Crawl متوالی صدها نوشته قدیمی و صفحه آرشیو.
🔹 درخواست مستقیم به REST API مانند مسیرهای عمومی wp-json.
🔹 Crawl فیدها، دستهبندیها، برچسبها و صفحات Pagination.
🔹 افزودن Query Stringهای تصادفی برای ایجاد Cache MISS.
🔹 درخواستهای زیاد به جستوجوی داخلی وردپرس که میتواند Queryهای سنگین تولید کند.
🔹 دانلود انبوه تصاویر و فایلهای رسانهای و افزایش مصرف Traffic.
نشانههای اسکرپینگ AI در هاست وردپرس چیست؟
افزایش مصرف منابع همیشه به معنی حمله نیست. قبل از Block کردن باید Access Log، آمار CDN و الگوی درخواستها بررسی شود. اگر چند مورد زیر همزمان دیده شوند، احتمال Crawl سنگین یا اسکرپینگ خودکار بیشتر است:
🔹 افزایش CPU یا تعداد PHP Worker بدون رشد مشابه کاربران واقعی.
🔹 تعداد زیاد درخواست HTTP 200 از تعداد محدودی IP.
🔹 خواندن صفحات قدیمی با ترتیب ماشینی و فاصله زمانی کوتاه.
🔹 User-Agentهایی مانند GPTBot، ClaudeBot، CCBot یا Bytespider در لاگ.
🔹 تعداد زیاد Cache MISS یا URLهایی با پارامترهای متفاوت.
🔹 رشد پهنای باند بدون افزایش Conversion، Session یا بازدید انسانی.
نمونه بررسی User-Agentهای AI در Access Log
اگر به SSH سرور دسترسی دارید، میتوانید در لاگ Apache یا Nginx بهدنبال User-Agentهای شناختهشده بگردید. مسیر فایل لاگ بسته به کنترلپنل و سیستمعامل متفاوت است.
grep -Ei 'GPTBot|OAI-SearchBot|ClaudeBot|Claude-SearchBot|CCBot|Bytespider|meta-externalagent' access.log | tail -n 100برای پیدا کردن IPهایی که بیشترین درخواست را ثبت کردهاند نیز میتوان از نمونه زیر استفاده کرد:
awk '{print $1}' access.log | sort | uniq -c | sort -nr | head -n 20وقتی باتها منابع وردپرس را مصرف میکنند، زیرساخت هم مهم است
اگر سایت شما محتوای زیاد، بازدید بالا یا Crawl گسترده دارد، استفاده از زیرساخت مناسب در کنار WAF و Cache باعث میشود درخواستهای خودکار کمتر به PHP و دیتابیس فشار وارد کنند. ایرانیکاسرور برای سایتهای وردپرسی، هم هاست وردپرس و هم سرور مجازی ایران برای سناریوهایی که به کنترل بیشتر روی Nginx، فایروال، Rate Limit و منابع نیاز دارند ارائه میکند.
📞 تماس با پشتیبانی:
021-91302460
| ایرانیکاسرور
لایه اول دفاع: robots.txt برای کنترل کرالرهای خوشرفتار
سادهترین راه برای اعلام سیاست Crawl سایت، فایل robots.txt است. مزیت اصلی آن این است که میتوانید دسترسی هر ربات را جداگانه تعریف کنید. در WordPress نیز خروجی مجازی robots.txt قابل سفارشیسازی است.
نکته کلیدی این است که robots.txt یک درخواست و سیاست Crawl است، نه دیوار امنیتی. Cloudflare نیز صراحتاً توضیح میدهد که رعایت robots.txt داوطلبانه است و برای Enforcement واقعی باید از کنترل امنیتی مانند AI Crawl Control یا WAF استفاده شود. :contentReference[oaicite:3]{index=3}
نمونه robots.txt متعادل برای سایت محتوایی
در سناریوی زیر، باتهای مرتبط با Training محدود میشوند اما OAI-SearchBot و Claude-SearchBot اجازه Crawl دارند تا امکان دیدهشدن محتوا در جستوجوی AI حفظ شود:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: meta-externalagent
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /
⚠️
این فایل یک نسخه عمومی برای تمام سایتها نیست. اگر استراتژی محتوایی شما بر دیدهشدن در موتورهای AI متمرکز است، ممکن است سیاست متفاوتی انتخاب کنید. همچنین نام و کاربرد کرالرها در طول زمان تغییر میکند و بهتر است مستندات رسمی آنها دورهای بررسی شود.
افزودن قوانین AI به robots.txt مجازی وردپرس
توسعهدهندگان وردپرس میتوانند با فیلتر رسمی robots_txt محتوای robots.txt مجازی سایت را تغییر دهند:
add_filter('robots_txt', function ($output, $public) {

    $output .= "\nUser-agent: GPTBot\nDisallow: /\n";
    $output .= "\nUser-agent: ClaudeBot\nDisallow: /\n";
    $output .= "\nUser-agent: CCBot\nDisallow: /\n";
    $output .= "\nUser-agent: Bytespider\nDisallow: /\n";

    $output .= "\nUser-agent: OAI-SearchBot\nAllow: /\n";
    $output .= "\nUser-agent: Claude-SearchBot\nAllow: /\n";

    return $output;

}, 20, 2);
اگر در ریشه سایت یک فایل فیزیکی robots.txt وجود داشته باشد، باید همان فایل بررسی و ویرایش شود؛ بنابراین بعد از هر تغییر حتماً آدرس domain.com/robots.txt را مستقیماً باز کنید و خروجی واقعی را ببینید. وردپرس نیز فیلتر رسمی robots_txt را برای تغییر خروجی مجازی در اختیار توسعهدهندگان قرار داده است. :contentReference[oaicite:4]{index=4}
لایه دوم: چرا Block کردن بر اساس User-Agent کافی نیست؟
هدر User-Agent یک دادهای است که Client ارسال میکند و قابل جعل است. یک Scraper ناشناس میتواند خودش را Chrome، Googlebot یا حتی GPTBot معرفی کند. بنابراین قانون امنیتی که فقط عبارت GPTBot را جستوجو کند، صرفاً جلوی باتی را میگیرد که هویت خود را صادقانه اعلام کرده است.
برای رباتهای شناختهشده بهتر است در صورت امکان هویت شبکهای، IP Range رسمی، Bot Verification یا سرویس تشخیص بات در CDN نیز در تصمیم دخیل باشد. در مقابل، اسکرپرهای ناشناس بهتر است بر اساس رفتار شناسایی شوند: سرعت Crawl، تعداد URL، نرخ Cache MISS، تکرار درخواست، الگوی Header و Reputation آدرس IP.
لایه سوم: استفاده از Cloudflare برای کنترل AI Botها
قرار دادن کنترل در لبه شبکه مزیت بزرگی دارد: درخواست نامطلوب قبل از رسیدن به PHP، MySQL و WordPress متوقف میشود. Cloudflare در سرویس AI Crawl Control امکان مشاهده فعالیت کرالرهای AI و اعمال سیاست Allow یا Block برای رباتهای مختلف را فراهم کرده است.
🔹 مشاهده اینکه کدام AI Crawler صفحات سایت را درخواست کرده است.
🔹 Allow یا Block کردن کرالرها بهصورت مجزا.
🔹 بررسی تخلف احتمالی از robots.txt.
🔹 استفاده از WAF برای Enforcement واقعی.
🔹 مشاهده مسیرهایی که بیشترین Crawl را دریافت میکنند.
قابلیت دیگری با نام AI Labyrinth نیز برای شناسایی رباتهایی طراحی شده که دستورالعملهای Crawl را رعایت نمیکنند. این قابلیت لینکهای نامرئی مخصوص باتها ایجاد میکند و دنبالکردن آنها را ثبت میکند. نکته مهم اینکه طبق مستندات Cloudflare، AI Labyrinth بهتنهایی یک Action مسدودکننده نیست؛ بنابراین برای Block واقعی همچنان باید از Rule مناسب استفاده شود. :contentReference[oaicite:5]{index=5}
لایه چهارم: Hard Block در Apache برای اسکرپرهای مشخص
اگر کنترل CDN ندارید و مطمئن هستید که میخواهید چند User-Agent مشخص بهطور کامل Block شوند، میتوان این کار را پیش از قوانین اصلی وردپرس در فایل .htaccess انجام داد.
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|CCBot|Bytespider|meta-externalagent) [NC]
RewriteRule ^ - [F,L]
</IfModule>
⚠️
قبل از تغییر .htaccess نسخه پشتیبان بگیرید. همچنین این روش User-Agent جعلی را تشخیص نمیدهد و نباید الگوهای عمومی مانند bot یا crawler را Block کنید، زیرا ممکن است Googlebot، Bingbot، ابزارهای مانیتورینگ یا سرویسهای ضروری سایت نیز مسدود شوند.
Rate Limit بهتر است یا Block کامل؟
همیشه لازم نیست یک ربات را بهطور کامل مسدود کنید. اگر یک Crawler برای شما ارزش بالقوه دارد اما نرخ درخواست آن بالاست، Rate Limiting انتخاب منطقیتری است. برای مثال میتوان تعداد درخواستهای یک IP یا Bot Category را در یک بازه زمانی محدود کرد و در صورت Burst غیرعادی درخواست اضافی را Challenge یا Reject کرد.
| شرایط | راهکار مناسب | دلیل |
|---|---|---|
| Crawler مفید با درخواست منطقی | Allow | حفظ دسترسی و Referral |
| Crawler مفید ولی پرمصرف | Rate Limit | کاهش فشار بدون حذف کامل دسترسی |
| Training Bot بدون ارزش تجاری برای سایت | robots.txt یا Block | کاهش برداشت محتوا و منابع |
| Scraper ناشناس و تهاجمی | WAF + Challenge + Rate Limit | User-Agent قابل اعتماد نیست |
مسیرهای وردپرس که اسکرپرها بیشتر دوست دارند
REST API
مسیر wp-json میتواند دسترسی ساختاریافته به اطلاعات عمومی وردپرس ارائه کند. اما غیرفعالکردن کامل REST API معمولاً تصمیم خوبی نیست، زیرا Gutenberg، WooCommerce و بسیاری از افزونهها به آن وابستهاند. اگر Endpoint عمومی خاصی مورد سوءاستفاده قرار میگیرد، همان مسیر را Rate Limit یا محدود کنید.
فید RSS
Feedها نسخه بسیار سادهای از محتوا ارائه میکنند و برای Scraperها جذاب هستند. اگر RSS در استراتژی سایت کاربردی ندارد، میتوانید دسترسی آن را محدود کنید؛ در غیر این صورت بهتر است بهجای حذف کامل، Monitoring و Rate Limit داشته باشید.
جستوجوی داخلی
URLهای جستوجو میتوانند برخلاف صفحات Cache شده، Queryهای جدیدی به دیتابیس تحمیل کنند. درخواستهای مکرر با عبارتهای تصادفی به Search وردپرس یکی از الگوهایی است که باید در WAF و Access Log زیر نظر داشته باشید.
Query Stringهای تصادفی
یک Scraper میتواند یک صفحه را با پارامترهای مختلف درخواست کند؛ برای نمونه URL اصلی را بارها با مقادیر متفاوت به انتهای آن ارسال کند. اگر تنظیمات Cache بهدرستی انجام نشده باشد، این کار ممکن است باعث Cache MISS و اجرای مجدد PHP شود.
آیا llms.txt جلوی سرقت محتوا توسط AI را میگیرد؟
خیر. llms.txt ابزار امنیتی، فایروال یا مکانیزم جلوگیری از Scraping نیست. حتی اگر از آن برای معرفی ساختار محتوای سایت به سیستمهای AI استفاده شود، یک Scraper ناشناس هیچ اجبار فنی برای رعایت آن ندارد. در سال ۲۰۲۶ گوگل نیز تصریح کرده است که برای حضور در قابلیتهای AI Search نیازی به فایلهای ویژه AI مانند llms.txt نیست.
بنابراین اگر هدف شما جلوگیری از برداشت محتواست، تمرکز باید روی robots.txt، احراز هویت، WAF، Rate Limiting، Cache و تحلیل ترافیک باشد، نه ایجاد یک فایل متنی جدید.
Cache چگونه هزینه حملات Scraping را کاهش میدهد؟
یکی از موثرترین دفاعها در برابر Crawl پرتعداد این است که هر درخواست مجبور نباشد وردپرس را از ابتدا اجرا کند. Full Page Cache در سطح وبسرور یا Edge CDN میتواند درخواست صفحات عمومی را بدون اجرای PHP پاسخ دهد.
✅ فعالکردن Full Page Cache برای صفحات عمومی.
✅ استفاده از CDN برای فایلهای CSS، JavaScript و تصاویر.
✅ کنترل Query Stringهایی که بیدلیل Cache را دور میزنند.
✅ Object Cache برای سایتهای دیتابیسمحور و فروشگاهی.
✅ قرار دادن Rate Limit قبل از رسیدن درخواست به PHP.
محتوای پولی و خصوصی را چگونه از LLM Scraperها محافظت کنیم؟
هر محتوایی که بدون Login و از طریق یک URL عمومی قابل دریافت باشد، از نظر فنی قابل Scrape شدن است. robots.txt فقط اعلام میکند چه چیزی نباید Crawl شود؛ اما مانع HTTP Request نمیشود.
اگر مقاله، فایل، دیتاست، دوره آموزشی یا محتوای Premium واقعاً نباید برای کاربران ناشناس قابل دسترسی باشد، باید کنترل دسترسی در سمت سرور اعمال شود. یعنی سرور فقط پس از Session معتبر، Login، Token یا مجوز کاربر پاسخ کامل را برگرداند.
⚠️
هیچوقت URL محتوای خصوصی را عمومی نگه ندارید و صرفاً آن را در robots.txt قرار ندهید. robots.txt خودش عمومی است و حتی میتواند مسیرهایی را که نمیخواهید Crawl شوند به دیگران نشان دهد.
سیاست پیشنهادی برای انواع سایتهای وردپرسی
| نوع سایت | Training Bot | AI Search Bot | Scraper ناشناس |
|---|---|---|---|
| مجله و وبلاگ سئویی | بر اساس سیاست محتوا محدود | معمولاً Allow | Rate Limit / Block |
| سایت شرکتی | اختیاری | برای Visibility قابل Allow | محدود |
| فروشگاه WooCommerce | موردی | صفحات محصول قابل Allow | API و Search حتماً مانیتور شود |
| دوره و محتوای Premium | Block | فقط محتوای عمومی | احراز هویت + WAF |
برای کنترل کامل Botها به منابع و دسترسی سرور نیاز دارید؟
روی هاست اشتراکی معمولاً امکان تغییر مستقیم تنظیمات Nginx، Firewall، Fail2ban یا سیاستهای پیشرفته Rate Limit محدود است. اگر سایت پرترافیکی دارید که تحت Crawl مداوم قرار میگیرد، سرور مجازی امکان کنترل دقیقتر وبسرور، Cache، فایروال، لاگها و محدودسازی درخواستهای خودکار را فراهم میکند.
📞 تماس با پشتیبانی:
021-91302460
| ایرانیکاسرور
اشتباهات رایج هنگام مقابله با AI Crawlerها
⚠️ Block کردن تمام User-Agentهایی که کلمه Bot دارند.
⚠️ مسدود کردن Googlebot و آسیبزدن ناخواسته به SEO.
⚠️ تصور اینکه robots.txt یک فایروال است.
⚠️ غیرفعال کردن کامل REST API بدون بررسی وابستگی افزونهها.
⚠️ اعتماد کامل به User-Agent بدون بررسی IP و رفتار Request.
⚠️ مسدود کردن AI Search Botها بدون توجه به ترافیک ارجاعی احتمالی.
⚠️ تلاش برای محافظت از محتوای پولی صرفاً با robots.txt.
چکلیست پیشنهادی امنیت وردپرس در برابر AI Scraping
✅ Access Log و آمار CDN را قبل از ایجاد Rule بررسی کنید.
✅ Training Bot و Search Bot را از یکدیگر تفکیک کنید.
✅ robots.txt را برای اعلام سیاست Crawl تنظیم کنید.
✅ برای Scraperهای متخلف از WAF و Rate Limit استفاده کنید.
✅ Cache را طوری تنظیم کنید که Query Stringهای بیارزش منابع Origin را مصرف نکنند.
✅ REST API، Search، Feed و صفحات آرشیو را مانیتور کنید.
✅ محتوای خصوصی را پشت Login یا Authorization واقعی قرار دهید.
✅ بعد از هر Rule، Google Search و رباتهای مجاز را تست کنید.
باتها سایت وردپرسی شما را سنگین کردهاند و نمیدانید کدام Rule مناسب است؟
اگر با مصرف بالای CPU، درخواستهای مشکوک، Crawl انبوه، تنظیم Cloudflare، Rate Limit، Nginx، Apache یا مشکلات امنیتی وردپرس مواجه هستید، میتوانید درخواست کانفیگ و رفع مشکل خود را برای بررسی تخصصی ارسال کنید.
📞 تماس با پشتیبانی:
021-91302460
| ایرانیکاسرور
سوالات متداول درباره امنیت وردپرس و کرالرهای AI
آیا robots.txt جلوی اسکرپینگ محتوا را کاملاً میگیرد؟
خیر. robots.txt سیاست Crawl سایت را اعلام میکند اما مکانیزم فنی برای جلوگیری از HTTP Request نیست. برای جلوگیری واقعی از رباتهای متخلف باید از WAF، Rate Limit یا کنترل دسترسی در سرور استفاده شود.
آیا مسدود کردن GPTBot باعث حذف سایت از Google میشود؟
خیر. GPTBot مربوط به OpenAI است و ارتباطی با Googlebot ندارد. با این حال هنگام نوشتن Rule باید مطمئن شوید Googlebot به اشتباه در یک قانون عمومی مسدود نشده باشد.
آیا میتوان GPTBot را بست ولی سایت همچنان در ChatGPT Search دیده شود؟
بله. OpenAI کنترل GPTBot و OAI-SearchBot را مستقل اعلام کرده است؛ بنابراین میتوان GPTBot را برای Training محدود و OAI-SearchBot را برای قابلیتهای Search مجاز کرد. :contentReference[oaicite:6]{index=6}
ClaudeBot و Claude-SearchBot چه تفاوتی دارند؟
طبق توضیح Anthropic، ClaudeBot برای جمعآوری محتوایی استفاده میشود که میتواند در توسعه مدلها نقش داشته باشد؛ درحالیکه Claude-SearchBot برای بهبود نتایج جستوجوی Claude فعالیت میکند. Anthropic این Botها را بهصورت مجزا قابل کنترل کرده است. :contentReference[oaicite:7]{index=7}
آیا افزونه امنیتی وردپرس برای جلوگیری از AI Scraping کافی است؟
افزونه میتواند بخشی از دفاع باشد، اما بهترین محل برای متوقف کردن درخواستهای سنگین معمولاً قبل از اجرای WordPress است. اگر Request ابتدا PHP و افزونهها را اجرا کند و سپس Block شود، بخشی از منابع سرور از قبل مصرف شده است.
آیا Rate Limit روی سئو اثر منفی دارد؟
اگر Rule بیش از حد سختگیرانه باشد و Googlebot یا سرویسهای معتبر را محدود کند، میتواند مشکل ایجاد کند. Rate Limit باید با بررسی Log، Bot Verification و استثنا کردن رباتهای ضروری تنظیم شود.
بهترین روش برای جلوگیری از کپی شدن محتوای Premium چیست؟
محتوای Premium باید پشت Authentication و Authorization واقعی باشد. هیچ فایل robots.txt، meta tag یا User-Agent Filter جای کنترل دسترسی سمت سرور را نمیگیرد.
جمعبندی
امنیت وردپرس در برابر کرالرهای LLM با نصب یک افزونه یا اضافه کردن چند خط به robots.txt کامل نمیشود. ابتدا باید مشخص کنید کدام نوع Crawl برای کسبوکار شما مفید و کدام نوع نامطلوب است.
برای یک سایت محتوایی معمولاً ترکیبی از robots.txt تفکیکشده، Cache مناسب، WAF، Rate Limit، تحلیل Access Log و محافظت واقعی از محتوای خصوصی بهترین نتیجه را میدهد. هدف این نیست که اینترنت را از سایت خود بیرون کنید؛ هدف این است که ربات مفید بتواند با هزینه منطقی سایت را بخواند و Scraper پرمصرف نتواند منابع سرور یا محتوای ارزشمند شما را بدون کنترل مصرف کند.
منابع رسمی برای بررسی آخرین تغییرات کرالرها
🔹
مستندات رسمی OpenAI Crawlers
:contentReference[oaicite:8]{index=8}
🔹
راهنمای رسمی کرالرهای Anthropic
:contentReference[oaicite:9]{index=9}
🔹
راهنمای رسمی Cloudflare AI Crawl Control
:contentReference[oaicite:10]{index=10}
۳۰ برچسب پیشنهادی برای مقاله:
امنیت وردپرس، کرالر هوش مصنوعی، بات AI، اسکرپینگ محتوا، جلوگیری از اسکرپینگ، GPTBot، ClaudeBot، OAI-SearchBot، Google-Extended، CCBot، Bytespider، Meta External Agent، robots.txt وردپرس، WAF وردپرس، Cloudflare AI Crawl Control، AI Labyrinth، Rate Limit، محافظت محتوای وردپرس، سرقت محتوا، امنیت سایت، امنیت هاست وردپرس، کاهش مصرف CPU وردپرس، کاهش مصرف منابع هاست، فایروال وردپرس، باتهای مخرب، لاگ سرور وردپرس، REST API وردپرس، جلوگیری از کپی محتوا، امنیت سرور مجازی، سختسازی وردپرس

💬 دیدگاهها 0
هنوز دیدگاهی ثبت نشده است. اولین نفری باشید که نظر میدهید!
✍️ دیدگاه خود را بنویسید