
 Amir Jabbari
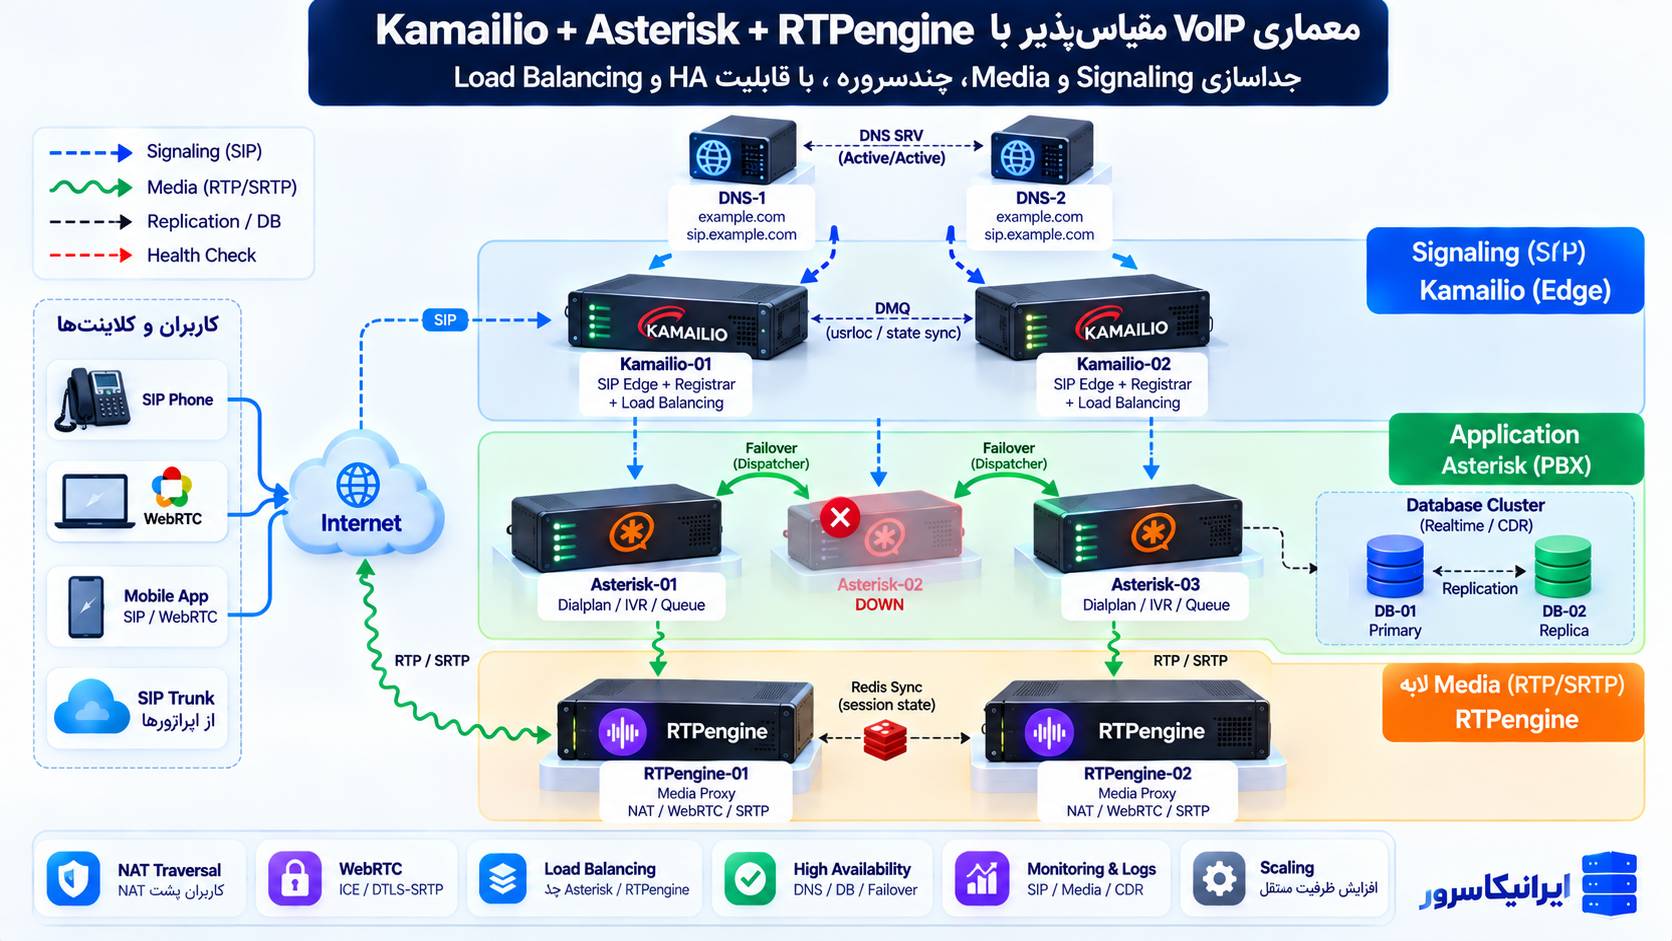
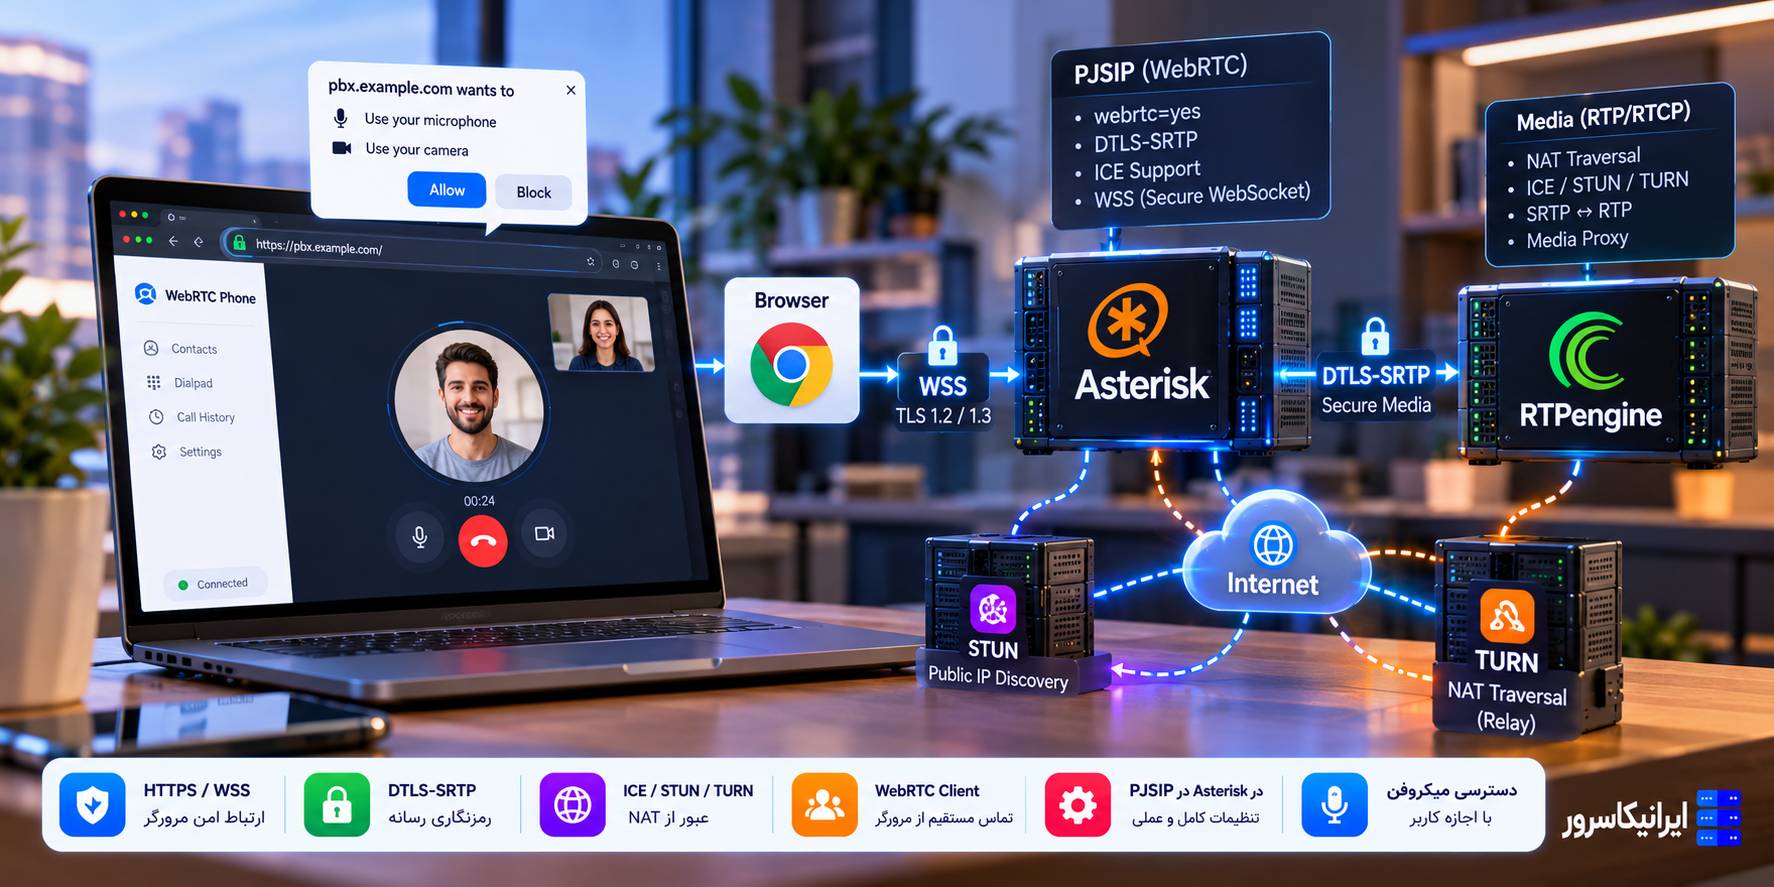
یکی از معماریهای رایج برای چنین کاری ترکیب Kamailio + Asterisk + RTPengine است. Kamailio در لبه شبکه SIP را دریافت و Route میکند، چند Asterisk منطق تماس را اجرا میکنند و RTPengine مسیر صوت، WebRTC، NAT و SRTP را مدیریت میکند.
اما قرار دادن این سه نرمافزار کنار یکدیگر هنوز به معنی High Availability نیست. باید مشخص کنیم Registration کجا ذخیره میشود، تماس جدید چگونه بین Asteriskها پخش میشود، اگر یک Media Node قطع شد چه اتفاقی میافتد، DNS چه نقشی دارد، Database چگونه Redundant میشود و در خرابی هر جزء چه بخشی از سرویس باید زنده بماند.
در این راهنما یک معماری Production را از پایه طراحی میکنیم و سپس سناریوهای خرابی واقعی را بررسی میکنیم.
نسخههای مبنای مقاله در ۱۷ اکتبر ۲۰۲۶: Kamailio 6.1.5 آخرین Stable شاخه 6.1 است. Asterisk 22.11.0 آخرین نسخه پایدار LTS فعلی است؛ Asterisk 24 هنوز در مرحله Pre-release قرار دارد. RTPengine نیز Release جدید mr26.2.1.5 و شاخه LTS فعال mr13.5.1.30 را دارد.
معماری VoIP مقیاسپذیر یعنی چه؟
مقیاسپذیری فقط یعنی «سرور قویتر بخریم» نیست.
دو روش کلی برای افزایش ظرفیت داریم:
Scale Up: CPU، RAM و Network همان سرور را بیشتر کنیم.
Scale Out: Nodeهای بیشتری اضافه کنیم و بار را بین آنها تقسیم کنیم.
برای یک سامانه VoIP بزرگ، Scale Out معمولاً معماری انعطافپذیرتری ایجاد میکند؛ زیرا Maintenance، Failover و افزایش ظرفیت به یک ماشین وابسته نمیماند.
مشکل معماری تکسروره چیست؟
فرض کنید همهچیز روی یک Asterisk اجرا میشود:
🔹 Registration
🔹 SIP Trunk
🔹 Dialplan
🔹 Queue
🔹 Recording
🔹 RTP
🔹 WebRTC
🔹 Database
اگر این سرور Restart شود، تمام لایههای سرویس همزمان از بین میروند.
حتی اگر سختافزار بسیار قوی باشد، همچنان یک:
Single Point of Failure یا SPOF
داریم.
راهحل: Signaling، Application و Media را جدا کنیم
معماری هدف ما سه لایه اصلی دارد.
لایه اول: Kamailio برای Signaling
وظایف اصلی:
🔹 دریافت SIP از کاربران و Carrierها
🔹 Registrar در صورت انتخاب این معماری
🔹 Authentication
🔹 NAT Signaling
🔹 Load Balancing
🔹 Health Check
🔹 SIP Firewall و Rate Limit
🔹 Topology Hiding
لایه دوم: Asterisk برای منطق تماس
وظایف اصلی:
🔹 Dialplan
🔹 IVR
🔹 Queue
🔹 Voicemail
🔹 Call Application
🔹 ARI/AMI Integration
🔹 Recording در صورت انتخاب این لایه
لایه سوم: RTPengine برای Media
وظایف اصلی:
🔹 RTP Relay
🔹 NAT Traversal
🔹 WebRTC
🔹 ICE
🔹 SRTP/DTLS
🔹 Media Topology Hiding
🔹 Transcoding در صورت نیاز
نمای کلی معماری پیشنهادی
                Phones / Softphones / Carriers
                           |
                       DNS / VIP
                     /           \
                    /             \
             Kamailio-01       Kamailio-02
                |                  |
                +------ DMQ -------+
                    |          |
                    |          |
             +------+----------+------+
             |             |          |
             v             v          v
         Asterisk-01   Asterisk-02  Asterisk-03
             |             |          |
             +-------------+----------+
                           |
                    Shared Services
                     DB / API / CDR

                     Media Plane
                    /           \
                   /             \
             RTPengine-01    RTPengine-02
چرا دو Kamailio؟
اگر پنج Asterisk داشته باشید اما فقط یک Kamailio در ورودی داشته باشید، مشکل Single Point of Failure فقط از Asterisk به Kamailio منتقل شده است.
حداقل دو Edge Node باعث میشود:
🔹 Maintenance یکی بدون توقف کامل سرویس انجام شود.
🔹 خرابی یک Edge تماسهای جدید را کاملاً متوقف نکند.
🔹 Registration بین چند Edge توزیع شود.
کاربر چطور بین دو Kamailio انتخاب میکند؟
چند روش وجود دارد.
روش اول: DNS SRV
برای SIP میتوان SRV Record ساخت.
مثلاً:
_sip._udp.example.com. 60 IN SRV 10 50 5060 sip1.example.com.
_sip._udp.example.com. 60 IN SRV 10 50 5060 sip2.example.com.
و سپس:
sip1.example.com. IN A 203.0.113.10
sip2.example.com. IN A 203.0.113.11
Priority و Weight در SRV چیست؟
Priority عدد کوچکتر را ترجیح میدهد.
Weight بین Recordهایی با Priority یکسان احتمال انتخاب را تقسیم میکند.
پس:
10 50 sip1
10 50 sip2
یعنی هر دو تقریباً همسطح هستند.
DNS SRV را با Load Balancer واقعی اشتباه نگیرید
DNS از CPU، تعداد تماس فعال یا وضعیت داخلی Kamailio خبر ندارد.
همچنین Endpointهای مختلف رفتار یکسانی در Cache و Failover DNS ندارند.
بنابراین SRV برای Discovery و Redundancy بسیار مفید است، اما بهتنهایی جای Health Check لحظهای را نمیگیرد.
روش دوم: Virtual IP
هر دو Kamailio میتوانند پشت یک VIP قرار بگیرند.
مثلاً:
sip.example.com
        |
    203.0.113.20
       VIP
     /     \
 Kam-01   Kam-02
Keepalived/VRRP یا زیرساخت Network Provider میتواند VIP را بین Nodeها منتقل کند.
VIP برای Active/Standby مناسب است
مزیت آن این است که Phone همیشه یک IP میبیند.
اما برای Active/Active باید طراحی Flow و State دقیقتری داشته باشید.
روش سوم: L4 Load Balancer
یک Load Balancer لایه 4 نیز میتواند UDP/TCP/TLS را بین Kamailioها تقسیم کند.
اما Load Balancer باید رفتار SIP Transport را درست پشتیبانی کند.
HTTP Load Balancer ساده را بدون بررسی برای SIP استفاده نکنید.
برای معماری Production کدام روش بهتر است؟
یک پاسخ ثابت وجود ندارد.
برای Hosted PBX کوچک تا متوسط:
DNS SRV + دو Kamailio
میتواند نقطه شروع خوبی باشد.
برای Operator یا سامانه با SLA سختتر:
VIP/L4 + DNS Redundancy
قابل بررسی است.
Kamailio Registration را کجا نگه داریم؟
این تصمیم معماری بسیار مهم است.
دو مدل اصلی داریم.
مدل اول: Phone روی خود Asterisk Register شود
Kamailio فقط REGISTER را Forward میکند.
در این مدل Registration State داخل Asterisk قرار دارد.
مشکل این است که User به یک Backend وابسته میشود.
مدل دوم: Kamailio خودش Registrar باشد
Phone مستقیماً روی Edge ثبت میشود.
Kamailio Contact را داخل:
usrloc
نگه میدارد.
Asteriskها بیشتر Application Server میشوند.
برای Scale بزرگ کدام مدل تمیزتر است؟
در بسیاری از معماریهای چندنودی، Registrar مرکزی روی Kamailio جداسازی بهتری ایجاد میکند؛ چون Asterisk Backend به Registration همان User وابسته نیست.
اما اگر از FreePBX یا Applicationی استفاده میکنید که Presence، BLF و Extension State را مستقیماً از Registrationهای Asterisk انتظار دارد، انتقال Registrar به Kamailio باید با دقت انجام شود.
دو Kamailio چگونه Location کاربران را Share میکنند؟
یکی از روشها:
dmq_usrlocاست.
این Module رکوردهای User Location را از طریق:
DMQبین Kamailioها Replicate میکند.
چرا این مهم است؟
Phone ممکن است REGISTER خود را به Kamailio-01 بفرستد.
تماس ورودی بعدی ممکن است از Kamailio-02 وارد شود.
Node دوم باید بداند User در چه Contactی قابل دسترسی است.
DMQ Network را Private نگه دارید
Replication داخلی نباید بدون نیاز روی اینترنت عمومی قابل دسترسی باشد.
بهتر است Kamailioها یک شبکه خصوصی مخصوص:
🔹 DMQ
🔹 Database
🔹 Monitoring
داشته باشند.
مرحله بعدی: Load Balancing چند Asterisk
فرض کنیم سه Application Node داریم.
Asterisk-01  10.20.10.11:5060
Asterisk-02  10.20.10.12:5060
Asterisk-03  10.20.10.13:5060
Dispatcher برای این کار ساخته شده است
در Kamailio میتوان این Nodeها را داخل یک Dispatcher Set قرار داد.
مثال:
1 sip:10.20.10.11:5060 0 0 duid=ast01;weight=50;rweight=50
1 sip:10.20.10.12:5060 0 0 duid=ast02;weight=50;rweight=50
1 sip:10.20.10.13:5060 0 0 duid=ast03;weight=50;rweight=50
کدام الگوریتم Dispatcher؟
چند انتخاب مهم داریم.
| Algorithm | کاربرد |
|---|---|
| 4 | Round Robin ساده |
| 5 | Hash روی Authorization Username |
| 9 | Weight-based |
| 10 | Call Load Distribution |
| 11 | Relative Weight / Congestion |
| 13 | Latency Optimized |
برای Application Pool، Algorithm 10 جذاب است
Algorithm 10 تعداد Callهای مرتبط با هر Destination را با یک ساختار سبک مبتنی بر Call-ID دنبال میکند.
در نتیجه Node با تعداد تماس کمتر شانس بیشتری برای تماس جدید دارد.
برای فعالشدن این الگوریتم:
modparam("dispatcher", "ds_hash_size", 9)لازم است.
نمونه Selection
if (is_method("INVITE") && !has_totag()) {

    if (!ds_select_dst("1", "10")) {
        send_reply("503", "No Asterisk Available");
        exit;
    }

    t_on_failure("ASTERISK_FAILOVER");
    t_relay();
    exit;
}
این فقط Skeleton آموزشی است؛ Production Route باید Authentication، NAT، Route Set، ACL و Transaction Logic کامل داشته باشد.
Call Load را باید هنگام Reply و BYE هم Update کنیم
برای Algorithm 10 فقط انتخاب Destination کافی نیست.
وقتی INVITE با 2xx تأیید میشود، State باید Confirm شود و هنگام BYE یا CANCEL Load آزاد شود.
از:
ds_load_update()
ds_load_unset()
برای این کار استفاده میشود.
اگر BYE هیچوقت نرسید چه؟
Kamailio برای Call Load Hash زمان Expire دارد.
مثلاً:
modparam("dispatcher", "ds_hash_expire", 7200)Default مستند فعلی نیز 7200 ثانیه است.
این مقدار باید با Duration واقعی تماسهای شما بررسی شود.
Health Check روی Asteriskها
Load Balancing بدون Health Check خطرناک است.
اگر Asterisk-02 Down شود، Kamailio باید آن را از Selection خارج کند.
نمونه:
modparam("dispatcher", "ds_ping_method", "OPTIONS")
modparam("dispatcher", "ds_ping_interval", 10)
modparam("dispatcher", "ds_probing_mode", 1)
modparam("dispatcher", "ds_probing_threshold", 2)
modparam("dispatcher", "ds_inactive_threshold", 2)
این تنظیمات چه میکنند؟
`ds_ping_interval` هر ۱۰ ثانیه Health Probe ارسال میکند.
`ds_probing_mode=1` تمام Gatewayها را Probe میکند.
`ds_probing_threshold=2` اجازه میدهد چند Failure قبل از Inactive شدن رخ دهد.
`ds_inactive_threshold=2` نیز برای بازگرداندن Node چند پاسخ موفق میخواهد.
مقادیر مثال هستند و باید با SLA و Network شما تنظیم شوند.
چرا با اولین Packet Loss سرور را Down نکنیم؟
اگر یک OPTIONS بهعلت Packet Loss گم شود و Node فوراً Down شود، ممکن است Flapping ایجاد کنید.
یعنی Backend دائماً:
UP → DOWN → UP → DOWN
شود.
Threshold کوچک اما غیرصفر معمولاً رفتار پایدارتری دارد.
Failover INVITE چگونه انجام میشود؟
اگر Asterisk انتخابشده پاسخ نداد، Destination بعدی را امتحان میکنیم.
failure_route[ASTERISK_FAILOVER] {

    if (t_is_canceled()) {
        exit;
    }

    if (t_check_status("408|500|502|503|504")) {

        if (ds_next_dst()) {
            t_on_failure("ASTERISK_FAILOVER");
            t_relay();
            exit;
        }
    }
}
هر 503 را به معنی Crash ندانید
503 میتواند به معنی:
🔹 Overload
🔹 Maintenance
🔹 Downstream Failure
باشد.
Policy Failover و Policy Disabled کردن دائمی Node را از هم جدا طراحی کنید.
Media را از Asterisk جدا کنیم
حالا RTPengine وارد معماری میشود.
فرض کنیم دو Media Node داریم:
RTPengine-01 10.20.20.11:2223
RTPengine-02 10.20.20.12:2223
Kamailio میتواند چند RTPengine داشته باشد
نمونه:
modparam("rtpengine", "rtpengine_sock",
"1 == udp:10.20.20.11:2223=1 udp:10.20.20.12:2223=1")
ساختار دقیق Config را با نسخه Module و Syntax مستند همان Release بررسی کنید؛ مفهوم اصلی این است که چند RTPengine در یک Set قرار میگیرند و Weight میگیرند.
Selection RTPengine باید در طول تماس ثابت بماند
این نکته حیاتی است.
نباید Offer روی RTPengine-01 ایجاد شود ولی Answer همان Dialog به RTPengine-02 برود.
Media Session State باید به Node صحیح همان تماس برگردد.
RTPengine Offer و Answer
در مسیر INVITE دارای SDP:
rtpengine_offer()و در پاسخ حاوی SDP:
rtpengine_answer()استفاده میشود.
در بسیاری از Routing Scriptها `rtpengine_manage()` میتواند Logic را سادهتر کند.
بعد از BYE Media Session را پاک کنید
rtpengine_delete()Session را آزاد میکند.
چرا Media Layer را جدا Scale کنیم؟
Kamailio ممکن است میلیونها SIP Message را با CPU نسبتاً کم Route کند، اما RTPengine با:
🔹 هزاران Packet در ثانیه
🔹 Encryption
🔹 WebRTC
🔹 Transcoding
درگیر است.
بنابراین ظرفیت موردنیاز این دو لایه یکسان نیست.
مثال Scale مستقل
ممکن است معماری شما این باشد:
2 x Kamailio
3 x Asterisk
4 x RTPengine
یا برعکس.
تعداد Nodeها باید از Benchmark واقعی بیاید، نه از نسبت ثابت.
Database در این معماری چه چیزی را نگه میدارد؟
باید دو نوع State را از هم جدا کنیم.
Configuration State
مثل:
🔹 User
🔹 Extension
🔹 Password Hash
🔹 Route
🔹 Queue Configuration
🔹 Caller ID
Runtime State
مثل:
🔹 Contact فعلی User
🔹 SIP Dialog
🔹 Media Session
🔹 Queue Agent State
🔹 Active Call
Shared Database به معنی Shared Runtime State نیست
این یکی از بزرگترین اشتباهها در معماری HA است.
ممکن است سه Asterisk به یک Database مشترک وصل باشند، اما اگر تماس فعال روی Asterisk-01 بوده و آن Node Crash کند، صرف وجود Database تماس فعال را به Asterisk-02 منتقل نمیکند.
Memory، Channel، RTP State و Application State روی Node اول بودهاند.
Asterisk Realtime برای چه چیزی خوب است؟
PJSIP Realtime اجازه میدهد Objectهایی مانند:
🔹 Endpoint
🔹 Auth
🔹 AOR
🔹 Identify
🔹 Contact
در Database ذخیره شوند.
این قابلیت برای Shared Configuration بسیار مفید است.
آیا همه Asteriskها باید از یک DB بخوانند؟
اگر Backendها Configuration مشابه دارند، بله؛ میتوانید Realtime را برای منابع مشترک استفاده کنید.
اما Database باید خودش HA باشد.
یک Database روی همان Asterisk قرار ندهید
اگر تمام سه Asterisk به Database موجود روی Asterisk-01 وابسته باشند، خرابی Node اول عملاً همه Backendها را ناقص میکند.
Database باید Failure Domain جدا داشته باشد.
معماری Database پیشنهادی
مثلاً:
Kamailio / Asterisk
        |
   DB Endpoint
        |
   +----+----+
   |         |
 DB-01     DB-02
 Primary   Replica
یا Cluster متناسب با Database انتخابی.
Kamailio خودش db_cluster دارد
ماژول:
db_clusterمیتواند چند Database Connection را پشت یک Cluster URL قرار دهد.
برای Read میتواند:
🔹 Serial
🔹 Round Robin
و برای Write حتی Parallel Policy داشته باشد.
اما db_cluster خودش Database Replication نیست
این نکته مهم است.
اگر دو Database مستقل و ناسازگار داشته باشید، صرف Parallel Write از Kamailio آنها را به یک Cluster Consistent واقعی تبدیل نمیکند.
Replication، Conflict Handling و Consistency باید در Database Architecture نیز طراحی شوند.
DNS هم باید HA باشد
اگر کل SIP Infrastructure شما به:
sip.example.comوابسته است ولی فقط یک Authoritative DNS Server دارید، یک SPOF جدید ساختهاید.
حداقل دو DNS Node یا DNS Provider Redundant استفاده کنید.
TTL خیلی بالا Failover را کند میکند
اگر Record یک ساعت Cache شود، تغییر Emergency DNS ممکن است یک ساعت یا بیشتر برای برخی Clientها باقی بماند.
TTL کوتاهتر انعطاف بیشتری دارد، اما Query Load و Cache Behavior نیز باید در نظر گرفته شود.
TTL صفر هم راهحل جادویی نیست
Client، Resolver و SIP Deviceها همیشه DNS را دقیقاً مطابق انتظار شما Cache نمیکنند.
پس DNS Emergency Failover باید قبل از Production با Deviceهای واقعی تست شود.
حالا سناریوهای خرابی را بررسی کنیم
یک معماری HA فقط با دیاگرام زیبا سنجیده نمیشود.
باید بدانیم وقتی اجزا واقعاً خراب شدند چه رخ میدهد.
سناریو ۱: Asterisk-02 کاملاً Down میشود
وضعیت:
Kamailio        UP
Asterisk-01     UP
Asterisk-02     DOWN
Asterisk-03     UP
RTPengine       UP
Dispatcher با OPTIONS باید Node را Inactive کند.
تماسهای جدید به 01 و 03 میروند.
اما تماسهای فعال روی Asterisk-02 معمولاً قطع میشوند.
چرا تماس فعال منتقل نمیشود؟
چون Asterisk دارای:
🔹 Channel State
🔹 Dialplan State
🔹 Bridge State
🔹 Application State
بوده است.
Kamailio نمیتواند این State را ناگهان داخل Asterisk دیگری بسازد.
هدف HA در این لایه چیست؟
معمولاً:
کاهش زمان اختلال تماسهای جدید
نه تضمین انتقال زنده هر تماس موجود.
سناریو ۲: Kamailio-01 Down میشود
تماسهای جدید باید از:
🔹 DNS SRV
🔹 VIP
🔹 L4 Load Balancer
به Kamailio-02 برسند.
تماس فعال چه میشود؟
اگر Dialog Route Set شامل Kamailio-01 باشد، Request بعدی مثل BYE یا re-INVITE ممکن است به Node ازکارافتاده برود.
پس Failover تماس فعال در Edge به نوع Transport، DNS، Record-Route و State Replication شما بستگی دارد.
HA تماس جدید بسیار سادهتر از Mid-Dialog Failover است.
سناریو ۳: RTPengine-01 Down میشود
Kamailio باید برای Sessionهای جدید RTPengine-02 را انتخاب کند.
اما تماسهایی که Media آنها روی RTPengine-01 بوده معمولاً صدا را از دست میدهند.
Redis میتواند به RTPengine کمک کند
RTPengine میتواند Call State را در Redis ذخیره کند.
در Startup نیز Stateهای قبلی را Restore کند.
قابلیتهایی مثل:
--redis
--redis-write
--redis-subscribe
--active-switchover
برای Persistence و Takeover وجود دارند.
اما Redis مساوی Failover بدون قطعی نیست
برای انتقال واقعی Media باید موارد زیر هم درست باشند:
🔹 IP Routing
🔹 Advertised Address
🔹 Interface Alias
🔹 SRTP State
🔹 Network Reachability
بنابراین Redis بخشی از HA است، نه کل HA.
سناریو ۴: Database اصلی قطع میشود
اثر آن بستگی دارد چه چیزی از DB خوانده میشود.
ممکن است تماسهای فعال ادامه پیدا کنند، چون State آنها در Memory است.
اما عملیات جدید مثل:
🔹 Authentication
🔹 Endpoint Lookup
🔹 Routing Query
🔹 CDR Write
ممکن است Fail شود.
DB HA باید جداگانه تست شود
فقط داشتن Replica کافی نیست.
باید واقعاً Database Primary را خاموش کنید و ببینید:
Application چه مدت طول میکشد تا به Node جایگزین متصل شود؟
سناریو ۵: Redis قطع میشود
اگر Redis فقط برای RTPengine Persistence استفاده شود، Media Sessionهای موجود ممکن است روی Node فعلی ادامه پیدا کنند؛ اما State جدید برای Recovery ذخیره نمیشود.
اگر سرویسهای دیگر نیز به Redis وابستهاند، اثر متفاوت است.
Dependency Map را از قبل بنویسید.
سناریو ۶: یک دیتاسنتر کامل قطع میشود
این سناریو از خرابی یک Server جدیتر است.
اگر Kamailio، Asterisk، RTPengine و Database Backup همه در یک Datacenter باشند، چندسروره بودن شما در برابر قطع کامل آن مرکز داده کمکی نمیکند.
Multi-Region واقعی یعنی Failure Domain مستقل
مثلاً:
Region A
Kamailio-A
Asterisk-A1/A2
RTPengine-A

Region B
Kamailio-B
Asterisk-B1/B2
RTPengine-B
Media را بین قارهها بیدلیل جابهجا نکنید
اگر User و PBX هر دو در Region A هستند، فرستادن RTP از Region B فقط Latency و Jitter اضافه میکند.
SIP و Media Region Selection بهتر است هماهنگ باشند.
Geo DNS برای Multi-Region
میتوانید کاربر را به Region نزدیکتر هدایت کنید.
اما Geo DNS نیز Health State و Cache محدودیتهای خودش را دارد.
برای سرویس حساس، DNS باید فقط یکی از لایههای Failover باشد.
سناریو ۷: یک Network Link بین Kamailio و Asterisk قطع میشود
ممکن است هر دو Server کاملاً سالم باشند اما Route شبکه بین آنها خراب باشد.
OPTIONS Health Check باید این وضعیت را از دید Kamailio Down تشخیص دهد.
Health Check باید مسیر واقعی سرویس را بسنجد، نه فقط وضعیت Process.
سناریو ۸: Asterisk Process سالم است ولی Database خراب است
SIP OPTIONS شاید همچنان 200 OK بگیرد.
پس Dispatcher Backend را Healthy میداند.
ولی تماس واقعی ممکن است در Dialplan Fail شود.
Health Check چندسطحی لازم است
سه سطح Monitoring مفید است:
سطح ۱: Network Reachability
سطح ۲: SIP OPTIONS
سطح ۳: Synthetic Call Test
در Synthetic Test واقعاً یک تماس آزمایشی دورهای ایجاد میشود تا Routing، Dialplan و Media بررسی شوند.
Monitoring معماری باید چه چیزهایی را ببیند؟
| لایه | Metric مهم |
|---|---|
| Kamailio | SIP CPS، Transactions، 4xx/5xx، Dispatcher State، Registrations |
| Asterisk | Active Channels، Calls، CPU، Queue، ARI/AMI Health |
| RTPengine | Sessions، PPS، Bandwidth، Packet Loss، Jitter |
| Database | Connections، Replication Lag، Query Latency، Disk |
| DNS | Resolution، TTL، Authoritative Health |
| Network | Latency، Loss، Jitter، Route Changes |
Logها را مرکزی کنید
وقتی شش یا ده Node دارید، SSH زدن به تکتک Serverها برای پیدا کردن یک Call مشکلساز مناسب نیست.
Logهای:
🔹 Kamailio
🔹 Asterisk
🔹 RTPengine
🔹 Database
را به یک Log Platform مرکزی ارسال کنید.
Call-ID بهترین کلید Correlation است
وقتی یک تماس از:
Kamailio → Asterisk → RTPengine
عبور میکند، Call-ID را در Logهای مختلف قابل جستوجو نگه دارید.
این کار Troubleshooting را بسیار سریعتر میکند.
Tracing SIP را هم جدا داشته باشید
برای Production میتوانید HEP/HOMER یا راهکار مشابه برای ذخیره SIP Trace در نظر بگیرید.
هدف این است که بتوانید بدون فعالکردن Debug سنگین روی تمام Nodeها، Flow تماس را ببینید.
امنیت در معماری چندلایه
جداکردن سرویسها به معنی اضافهشدن Network Interface و Port بیشتر است.
اگر Firewall درست طراحی نشود، Scale کردن میتواند Attack Surface را افزایش دهد.
Internet فقط باید Edge را ببیند
یک طراحی مناسب:
Internet
   |
Kamailio
   |
Private Network
   |
Asterisk / DB / RTP Control
Asterisk فقط از Kamailio SIP بگیرد
روی Firewall Asteriskها، Source SIP را به IPهای Kamailio محدود کنید.
اگر Carrier نباید مستقیم به Asterisk برسد، Port Public آن را اصلاً باز نکنید.
RTPengine Control Port خصوصی باشد
NG Control Protocol را فقط برای Kamailio/OpenSIPS مجاز کنید.
Media UDP Port Range طبیعتاً باید از Endpointهای لازم قابل دسترسی باشد، اما Control Port نباید Public باشد.
Database فقط از Application Network قابل دسترسی باشد
پورت MySQL/PostgreSQL را برای اینترنت عمومی باز نکنید.
حتی Admin Access Database بهتر است از VPN یا Management Network انجام شود.
TLS کجا قرار میگیرد؟
یک معماری متداول:
Phone
  |
SIP TLS
  |
Kamailio
  |
Private SIP
  |
Asterisk
در محیط حساس میتوانید Internal TLS هم داشته باشید.
SRTP کجا Terminate میشود؟
اگر RTPengine Media Edge است، میتواند DTLS-SRTP یا SRTP را Terminate و در سمت Backend Profile دیگری تولید کند.
اما این تصمیم باید با Security Policy و Compliance هماهنگ باشد، چون Media در Relay قابل پردازش میشود.
Maintenance بدون Downtime چگونه انجام شود؟
یکی از بزرگترین مزایای Scale-out همین است.
Maintenance Asterisk
مرحله ۱: Node را از Dispatcher خارج کنید.
مرحله ۲: تماس جدید به آن ندهید.
مرحله ۳: Active Callها را Drain کنید.
مرحله ۴: Upgrade/Restart.
مرحله ۵: Health Check.
مرحله ۶: Node را دوباره وارد Pool کنید.
Maintenance RTPengine
همان منطق:
Session جدید به Node ندهید، Media Sessionهای قبلی تمام شوند و سپس سرویس Update شود.
Maintenance Kamailio
Traffic ورودی را به Edge دیگر منتقل کنید، Registration و تماسهای جدید را بررسی کنید و سپس Node را Upgrade کنید.
Rolling Upgrade بسازید
در معماری چندنودی هرگز همه Nodeها را همزمان Update نکنید.
مدل مناسب:
Drain Node 1
Upgrade
Test
Return to Pool

Drain Node 2
Upgrade
Test
Return to Pool
برای Version Compatibility Matrix داشته باشید
قبل از Upgrade ثبت کنید:
🔹 Kamailio Version
🔹 Asterisk Version
🔹 RTPengine Version
🔹 Database Version
🔹 OS Version
و این ترکیب را ابتدا روی Staging آزمایش کنید.
برای Production فعلی چه نسخهای انتخاب کنیم؟
در زمان نگارش:
Kamailio: 6.1.5 Stable
Asterisk: 22.11.0 LTS Stable
RTPengine: برای Featureهای جدید شاخه mr26.2 قابل بررسی است؛ برای محیط محافظهکارانه شاخه LTS `.5` را نیز بررسی کنید.
Asterisk 24 را صرفاً به دلیل شماره بزرگتر برای Production انتخاب نکنید؛ در تاریخ بررسی مقاله هنوز Pre-release است.
Capacity Planning را چگونه انجام دهیم؟
برای هر Layer Benchmark جدا داشته باشید.
Kamailio
معیار اصلی:
🔹 SIP Requests/sec
🔹 CPS
🔹 TLS Connections
🔹 Registration Count
Asterisk
معیار اصلی:
🔹 Concurrent Calls
🔹 CPS
🔹 Queue Load
🔹 Dialplan/API Processing
🔹 Recording
RTPengine
معیار اصلی:
🔹 Concurrent Media Sessions
🔹 Network PPS
🔹 Bandwidth
🔹 SRTP/WebRTC Percentage
🔹 Transcoding Sessions
یک عدد «تماس همزمان» برای کل معماری کافی نیست
ممکن است:
Kamailio هنوز 80 درصد ظرفیت آزاد داشته باشد،
Asterisk 50 درصد CPU داشته باشد،
ولی RTPengine به سقف Network PPS برسد.
Capacity Planning باید Bottleneck هر Layer را جدا ببیند.
Load Test را مرحلهای انجام دهید
مثلاً:
25 CPS
50 CPS
100 CPS
150 CPS
200 CPS
و در هر مرحله Call Duration را هم افزایش دهید.
Test Profileهای مختلف بسازید
Profile A: SIP Signaling بدون Media سنگین
Profile B: RTP/G.711 بدون Transcoding
Profile C: WebRTC + Opus + DTLS-SRTP
Profile D: Recording
Profile E: Transcoding
Winner و Bottleneck ممکن است در هر Profile متفاوت باشد.
Failure Injection را جزو تست قرار دهید
هنگام Load Test عمداً:
🔹 یک Asterisk را خاموش کنید.
🔹 یک Kamailio را Restart کنید.
🔹 یک RTPengine را قطع کنید.
🔹 Database Primary را Fail کنید.
🔹 Packet Loss مصنوعی ایجاد کنید.
معماری HA باید در شرایط واقعی آزمایش شود.
جدول سناریوهای خرابی
| خرابی | تماس جدید | تماس فعال | راهکار |
|---|---|---|---|
| یک Asterisk | به Node دیگر Route میشود | معمولاً تماس همان Node قطع میشود | Dispatcher + Health Check |
| یک Kamailio | Edge دوم باید بگیرد | Mid-dialog ممکن است متاثر شود | SRV/VIP/L4 + State Design |
| یک RTPengine | Media Node دیگر انتخاب میشود | Media Session روی Node خراب ممکن است قطع شود | RTPEngine Set + Redis/HA Design |
| DB Primary | بسته به Query ممکن است Fail شود | بسیاری از تماسهای موجود ادامه مییابند | DB Replication/Failover |
| DNS Node | Resolver باید DNS دیگر را ببیند | معمولاً تاثیری روی Media موجود ندارد | Authoritative DNS Redundancy |
| Datacenter کامل | Region دوم | تماسهای Region از دسترفته غالباً قطع میشوند | Multi-Region Architecture |
RPO و RTO برای VoIP هم تعریف کنید
فقط Backup کافی نیست.
RTO یعنی سرویس بعد از خرابی چه مدت میتواند Down باشد.
RPO یعنی چه مقدار Data Loss قابل قبول است.
برای مثال:
آیا از دست رفتن ۱۰ دقیقه CDR قابل قبول است؟
آیا Configuration جدید داخلیها باید فوراً Replica شود؟
آیا Voicemail و Recording باید خارج از Region دوم نیز Backup شوند؟
Backup چه چیزهایی را شامل شود؟
🔹 Kamailio Config
🔹 Dispatcher Data
🔹 Asterisk Config
🔹 Database
🔹 Recording
🔹 TLS Certificate
🔹 Firewall Policy
🔹 DNS Configuration
Configuration as Code ارزش زیادی دارد
بهتر است Configهای:
🔹 Kamailio
🔹 Asterisk
🔹 RTPengine
🔹 Firewall
در Git یا سیستم Version Control نگهداری شوند.
در نتیجه اگر Node جدید لازم شد، Configuration آن از حافظه Administrator ساخته نمیشود.
Automation اضافه کنید
برای بیش از چند Node استفاده از:
🔹 Ansible
🔹 Terraform
🔹 CI/CD Configuration
مدیریت نسخهها و Rollback را سادهتر میکند.
Rollback را قبل از Upgrade طراحی کنید
اگر Kamailio 6.1.5 Upgrade شد و مشکل خاصی با Script شما پیدا شد، باید بدانید چطور به Release قبلی برگردید.
همین موضوع برای Asterisk و RTPengine هم صدق میکند.
از Upgrade همزمان سه Layer خودداری کنید
اگر در یک Maintenance Window:
Kamailio + Asterisk + RTPengine
همه تغییر کنند و بعد تماس خراب شود، پیدا کردن عامل اصلی بسیار دشوار است.
تغییرها را مرحلهای انجام دهید.
Minimum Production Architecture پیشنهادی
برای پروژهای که واقعاً HA برایش مهم است، یک نقطه شروع منطقی:
2 x Kamailio
2-3 x Asterisk
2 x RTPengine
2 x Database Node
2 x DNS Endpoint / redundant provider
1 x Monitoring platform
است.
این اعداد قانون نیستند؛ معماری نهایی باید از SLA و Load Test بیاید.
آیا همه اینها را روی VPS اجرا کنیم؟
برای بسیاری از پروژهها بله.
اما بهتر است Failure Domainها را جدا کنید.
مثلاً اگر همه VPSها روی یک Physical Host باشند، خرابی Host تمام Cluster شما را یکجا از بین میبرد.
از Provider درباره Anti-Affinity سؤال کنید
اگر سرویس برایتان حیاتی است، Nodeهای HA بهتر است تا حد امکان روی Host یا Zoneهای متفاوت باشند.
HA نرمافزاری بدون HA زیرساختی ناقص است.
Network Quality برای RTP مهمتر از RAM اضافه است
Media Node ممکن است RAM آزاد زیادی داشته باشد اما Packet Loss یا Jitter کیفیت تماس را خراب کند.
برای RTPengine به:
🔹 Packet Loss پایین
🔹 Jitter پایین
🔹 CPU پایدار
🔹 Network PPS مناسب
نیاز دارید.
چه زمانی این معماری بیش از حد پیچیده است؟
اگر ۲۰ داخلی و یک SIP Trunk دارید، راهاندازی:
دو Kamailio + سه Asterisk + دو RTPengine + Database Cluster
احتمالاً هیچ توجیه عملی ندارد.
یک Asterisk یا PBX درست کانفیگشده سادهتر و قابل نگهداریتر است.
چه زمانی این معماری ارزش دارد؟
🔹 Hosted PBX
🔹 سرویس VoIP چندشرکتی
🔹 Contact Center بزرگ
🔹 Voice API Platform
🔹 WebRTC Service
🔹 Voice AI
🔹 Carrier Interconnect
🔹 سامانه با SLA بالا
چکلیست ساخت معماری مرحلهبهمرحله
مرحله ۱: Peak CPS و Concurrent Call را اندازه بگیرید.
مرحله ۲: مشخص کنید Registrar کجا باشد.
مرحله ۳: دو Kamailio Edge طراحی کنید.
مرحله ۴: DNS SRV یا VIP را انتخاب کنید.
مرحله ۵: DMQ/usrloc Replication را در صورت Registrar بودن Kamailio فعال کنید.
مرحله ۶: Asterisk Pool را بسازید.
مرحله ۷: Dispatcher Health Check را فعال کنید.
مرحله ۸: Load Distribution را Benchmark کنید.
مرحله ۹: RTPengine Pool را اضافه کنید.
مرحله ۱۰: NAT و SDP Rewrite را تست کنید.
مرحله ۱۱: WebRTC/SRTP را در صورت نیاز تست کنید.
مرحله ۱۲: Database HA را مستقل طراحی کنید.
مرحله ۱۳: Monitoring و Central Logging بسازید.
مرحله ۱۴: Failure Injection انجام دهید.
مرحله ۱۵: Rolling Upgrade و Rollback را مستند کنید.
پرسشهای رایج
معماری VoIP مقیاسپذیر چیست؟
معماریای است که Signaling، منطق تماس، Media و Data را تا حد ممکن از هم جدا میکند تا ظرفیت با اضافهکردن Node افزایش پیدا کند و خرابی یک Server کل سرویس را متوقف نکند.
Kamailio در معماری چندسروره چه نقشی دارد؟
Kamailio معمولاً SIP Edge، Registrar، Load Balancer، NAT Signaling Layer و Security Proxy است و تماسهای جدید را بین Asteriskها Route میکند.
Asterisk چه کاری انجام میدهد؟
Asterisk Application Server تماس است و Dialplan، IVR، Queue، Voicemail، Recording و Integrationهای ARI/AMI را اجرا میکند.
RTPengine چرا لازم است؟
RTPengine Media را از Signaling جدا میکند و برای NAT، WebRTC، SRTP، ICE، Media Topology Hiding و Scale مستقل RTP استفاده میشود.
آیا DNS SRV برای HA کافی است؟
خیر. SRV برای معرفی چند SIP Server و Priority/Weight مفید است، اما Health Check لحظهای، Cache Behavior و Failover Session را بهتنهایی حل نمیکند.
چطور تماسها بین چند Asterisk تقسیم میشوند؟
Kamailio Dispatcher میتواند از الگوریتمهایی مانند Round Robin، Weight، Call Load یا Latency-aware برای انتخاب Backend استفاده کند.
اگر یک Asterisk وسط تماس Crash کند، تماس به Node دیگر منتقل میشود؟
معمولاً خیر. تماسهای جدید Failover میشوند، اما State تماس فعال روی Asterisk قبلی بوده و انتقال زنده آن ساده نیست.
اگر RTPengine خراب شود چه میشود؟
تماسهای جدید میتوانند به Media Node دیگری بروند، اما تماسهای فعال روی Node خراب ممکن است Media خود را از دست بدهند. Redis و طراحی Active Switchover میتوانند Recovery پیشرفتهتری فراهم کنند ولی تضمین Failover بدون وقفه نیستند.
آیا Database مشترک باعث HA کامل Asterisk میشود؟
خیر. Database میتواند Configuration را Share کند، اما Channel، Dialog و Runtime Call State هنوز روی Asterisk مربوطه قرار دارند.
آیا Kamailio و RTPengine را روی یک VPS نصب کنیم؟
برای Lab یا بار کم ممکن است، اما در Production پرترافیک جداسازی Signaling و Media امکان Scale و Monitoring مستقلتری میدهد.
چند Kamailio برای Production لازم است؟
اگر High Availability واقعاً نیاز است، یک Kamailio کافی نیست. حداقل دو Edge Node نقطه شروع منطقیتری است، اما معماری نهایی به SLA و Traffic بستگی دارد.
برای این معماری VPS ایران مناسب است؟
اگر کاربران و SIP Provider عمدتاً داخل ایران هستند، قرارگیری SIP و Media Node نزدیک کاربران میتواند Latency را کاهش دهد. برای کاربران چندمنطقهای معماری Multi-Region مناسبتر است.
جمعبندی
معماری VoIP مقیاسپذیر با Kamailio، Asterisk و RTPengine زمانی موفق است که هر Component مسئولیت مشخصی داشته باشد.
Kamailio باید Signaling Edge را مدیریت کند، Asterisk منطق تماس را اجرا کند و RTPengine مسئول Media باشد.
اما Scale-out فقط اضافهکردن Node نیست. DNS، Registrar State، Dispatcher، Database، Media Session، Monitoring و Failure Domain همگی باید Redundant باشند.
در طراحی مناسب، خرابی یک Asterisk نباید تماسهای جدید کل سامانه را متوقف کند؛ خرابی یک Kamailio نباید تمام SIP Endpoint را از دسترس خارج کند و خرابی یک RTPengine نباید Media Sessionهای جدید را متوقف کند.
در مقابل، باید واقعبین بود: HA تماس جدید بسیار سادهتر از Failover بدون وقفه تماس فعال است. اگر Asterisk یا RTPengine وسط تماس Crash کند، حفظ کامل همان Session به طراحی State و Network بسیار پیشرفتهتری نیاز دارد.
بهترین معماری آنی نیست که بیشترین تعداد Server را داشته باشد؛ معماری درست، معماریای است که Failure Scenarioهای آن از قبل شناخته، آزمایش و مانیتور شده باشند.
قبل از انتقال تماسهای اصلی، Cluster را روی چند VPS مستقل بسازید و عمداً خرابش کنید
برای معماری Kamailio + Asterisk + RTPengine، مهمتر از تعداد Core این است که Nodeها شبکه پایدار، IP ثابت، منابع قابل پیشبینی و امکان جداسازی Failure Domain داشته باشند. Media Node نیز باید Packet Loss و Jitter پایینی داشته باشد.
میتوانید ابتدا دو Kamailio، دو Asterisk و دو RTPengine آزمایشی روی سرورهای مجازی ایرانیکاسرور راهاندازی کنید، DNS و Private Network را تنظیم کنید و سپس با SIPp تماس ایجاد کنید. بعد یک Node را عمداً خاموش کنید و بررسی کنید تماسهای جدید، Media و Registration دقیقاً چگونه Failover میشوند.
مشاوره معماری Kamailio، Asterisk و RTPengine: 021-91302467

دیدگاهها (۰)