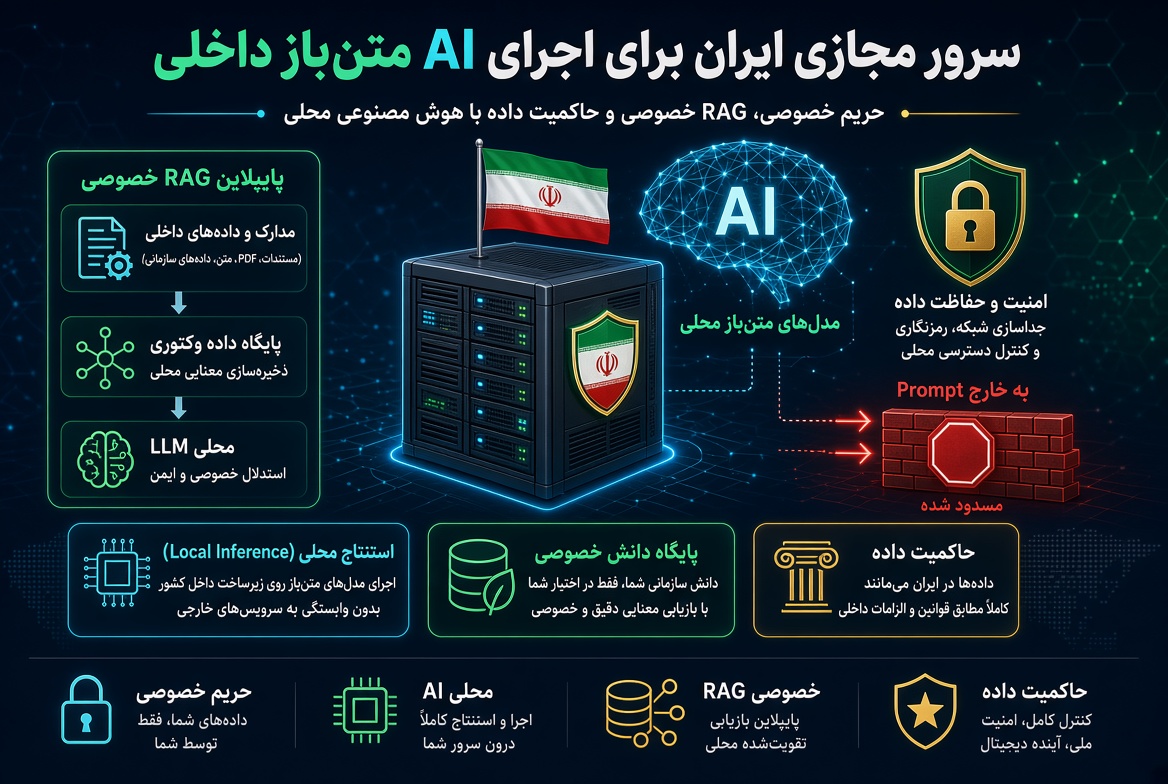
اگر دادههای سازمان شما شامل اطلاعات مشتریان، اسناد مالی، قراردادها، تیکتهای پشتیبانی، مکاتبات داخلی یا دانش اختصاصی شرکت باشد، ارسال مستقیم این اطلاعات به APIهای خارجی همیشه بهترین معماری نیست. یکی از راهکارهای عملی این است که یک مدل زبانی متنباز یا وزنباز را روی سرور تحت کنترل خودتان اجرا کنید تا Prompt، فایلهای RAG، Embeddingها، Vector Database و Logها تا جای ممکن در زیرساخت داخلی باقی بمانند.
📌 خلاصه کاربردی: سرور مجازی ایران میتواند برای اجرای مدلهای کوچک و Quantized، سرویس RAG داخلی، Embedding، خلاصهسازی متن، طبقهبندی، چتبات سازمانی و API خصوصی AI مناسب باشد؛ اما برای مدلهای بزرگ یا پردازش همزمان سنگین، RAM زیاد و معمولاً GPU اهمیت جدی پیدا میکند.
🔹 مدلهای 1B تا 4B روی CPU و RAM مناسب قابلاستفادهتر هستند.
🔹 مدلهای 7B تا 8B با Quantization روی CPU هم قابل اجرا هستند، اما سرعت پاسخ به قدرت پردازنده وابسته است.
🔹 برای RAG لازم نیست حتماً یک مدل بسیار بزرگ اجرا کنید؛ کیفیت Retrieval و داده سازمانی اهمیت زیادی دارد.
🔹 حاکمیت داده فقط محل VPS نیست؛ Backup، Log، API جانبی و Database هم باید بررسی شوند.
منظور از «AI داخلی» دقیقاً چیست؟
در این مقاله وقتی از AI داخلی صحبت میکنیم، منظور الزاماً یک مدل ساختهشده در ایران نیست. منظور مدلی است که Inference آن داخل زیرساخت تحت کنترل شما اجرا میشود؛ برای مثال یک مدل Qwen، Gemma، Mistral یا مدل دیگری که فایل وزن آن روی VPS یا سرور اختصاصی خودتان قرار دارد.
به این روش معمولاً Self-hosted AI، Private LLM یا On-premise AI نیز گفته میشود. در این معماری، برنامه شما بهجای اینکه Prompt را به یک API عمومی خارج از زیرساخت ارسال کند، درخواست را به Endpoint خصوصی خودتان تحویل میدهد.
⚠️
عبارت «متنباز» برای همه مدلها از نظر مجوز دقیقاً یکسان نیست. برخی مدلها Apache 2.0 هستند، برخی Terms اختصاصی دارند و برخی بهتر است «Open Weight» نامیده شوند. قبل از استفاده تجاری، مجوز همان نسخه مدل را بررسی کنید.
حاکمیت داده با حریم خصوصی چه تفاوتی دارد؟
حریم خصوصی داده بیشتر به این سؤال مربوط است که چه کسی اجازه مشاهده و استفاده از اطلاعات را دارد. حاکمیت داده مفهوم گستردهتری است و محل ذخیره و پردازش داده، قوانین حاکم بر آن، نحوه دسترسی، کنترل سازمان، Audit، Backup و انتقال بین سامانهها را نیز شامل میشود.
برای یک شرکت ایرانی، قرار دادن سرویس AI روی VPS داخل ایران میتواند به کنترل بیشتر روی محل پردازش و نگهداری داده کمک کند؛ اما صرفاً داخلی بودن IP یا دیتاسنتر به معنای کامل شدن حاکمیت داده نیست.
| مفهوم | تمرکز اصلی | نمونه در AI داخلی |
|---|---|---|
| Data Privacy | چه کسی داده را میبیند؟ | عدم ارسال Prompt مشتری به سرویس عمومی |
| Data Residency | داده در کجا نگهداری میشود؟ | ذخیره فایل و Database داخل ایران |
| Data Sovereignty | چه حوزه قانونی و مدیریتی بر داده حاکم است؟ | پردازش و نگهداری در زیرساخت داخلی با کنترل سازمان |
| Data Governance | چرخه عمر، دسترسی و سیاست داده | Retention، Backup، Audit و Role Management |
چرا کسبوکارها AI را روی سرور خودشان اجرا میکنند؟
🔹 کاهش ارسال داده محرمانه به سرویسهای شخص ثالث.
🔹 کنترل بیشتر روی Prompt Log و تاریخچه گفتگوها.
🔹 امکان اتصال مستقیم به CRM، ERP، Helpdesk و اسناد داخلی.
🔹 عدم وابستگی کامل به قیمتگذاری Token یک API خارجی.
🔹 امکان Fine-tune یا RAG اختصاصی متناسب با کسبوکار.
🔹 امکان محدود کردن API به شبکه، VPN یا IPهای مشخص.
آیا VPS ایران واقعاً برای اجرای LLM مناسب است؟
پاسخ بستگی به اندازه مدل و حجم درخواست دارد. یک اشتباه رایج این است که عبارت AI را فقط با GPUهای بسیار گرانقیمت مرتبط بدانیم. بسیاری از کاربردهای سازمانی به مدلهای کوچکتر، Embedding یا Reranker نیاز دارند و با CPU نیز قابل اجرا هستند.
ابزارهایی مانند llama.cpp برای اجرای LLM روی طیف وسیعی از سختافزارها طراحی شدهاند و از CPUهای x86، Quantizationهای مختلف و همچنین Backendهای GPU پشتیبانی میکنند. Quantization وزن مدل را با Precision کمتر ذخیره میکند و مصرف حافظه را کاهش میدهد.
مستندات رسمی پروژه:
llama.cpp در GitHub
Quantization چه تأثیری روی RAM دارد؟
مدلهای زبانی در Precision کامل میتوانند RAM بسیار زیادی نیاز داشته باشند. Quantization وزنها را مثلاً به 8bit یا 4bit تبدیل میکند و باعث میشود مدل بزرگتری در حافظه محدود جا شود. Hugging Face نیز Quantization را روشی برای کاهش هزینه حافظه و محاسبات معرفی میکند.
البته فایل مدل تنها مصرفکننده RAM نیست. Context، KV Cache، Runtime، Tokenizer، سیستمعامل و درخواستهای همزمان هم حافظه میخواهند؛ بنابراین حجم فایل مدل را مساوی RAM مورد نیاز در Production نگیرید.
| اندازه تقریبی مدل | RAM عملی پیشنهادی | کاربرد مناسب روی VPS CPU |
|---|---|---|
| 0.5B تا 1.5B | 4 تا 6GB | طبقهبندی، پاسخ کوتاه، استخراج داده |
| 2B تا 4B Quantized | 8 تا 12GB | چت داخلی، خلاصهسازی، RAG سبک |
| 7B تا 8B Quantized | 12 تا 16GB یا بیشتر | RAG سازمانی کمConcurrency؛ CPU کندتر از GPU |
| 12B تا 14B | 24 تا 32GB یا بیشتر | بهتر روی سرور پرمنبع یا GPU |
| 27B تا 32B | 32 تا 64GB+ | سرور اختصاصی یا GPU توصیه میشود |
| 70B | 64GB+ بسته به Quantization و Context | برای Production سریع معمولاً نیازمند زیرساخت قدرتمندتر |
اعداد جدول برای برنامهریزی تقریبی هستند و Benchmark قطعی محسوب نمیشوند. Context Window، Quantization، Batch Size و Runtime میتوانند مصرف واقعی را تغییر دهند.
AI خصوصی روی سرور مجازی ایران ایرانیکاسرور
اگر هدفتان اجرای Ollama، llama.cpp، RAG، Embedding Server یا API هوش مصنوعی داخلی است، VPS ایران به شما امکان میدهد سرویس را در دیتاسنتر داخل کشور و تحت کنترل Root خودتان راهاندازی کنید. این معماری برای پروژههایی که نمیخواهند Prompt و اسناد داخلی مستقیماً به APIهای خارجی ارسال شوند، انتخاب قابلتوجهی است.
در صفحه فعلی VPS ایران ایرانیکاسرور، پلنها از منابع سبک تا پلنهای قویتر ارائه میشوند و امکان انتخاب Linux و افزایش منابع نیز وجود دارد. برای مدلهای کوچک، RAG و سرویسهای API سبک میتوان از VPS شروع کرد و در صورت افزایش بار، منابع را ارتقا داد.
📌 تماس با پشتیبانی:
021-91302467
| ایرانیکاسرور
چه مدلهایی را میتوان روی VPS داخلی اجرا کرد؟
مدل مناسب برای VPS لزوماً مدلی نیست که بالاترین Benchmark را دارد. در بسیاری از کاربردهای سازمانی، مدل کوچکتر با Prompt درست و RAG مناسب نتیجه عملی بهتری از یک مدل بسیار بزرگ و کند میدهد.
| مدل نمونه | اندازه موجود | حجم نمونه در Ollama | سناریوی پیشنهادی |
|---|---|---|---|
| Qwen3 | 0.6B، 1.7B، 4B، 8B و بالاتر | حدود 523MB برای 0.6B و 2.5GB برای 4B | چت، RAG، Agent سبک و پردازش چندزبانه |
| Gemma 3 | 270M، 1B، 4B، 12B، 27B | حدود 815MB برای 1B و 3.3GB برای 4B | پرسشوپاسخ، خلاصهسازی، مدل سبک داخلی |
| Mistral 7B | 7B | حدود 4.4GB در Tag رایج Ollama | RAG و Chat روی سرور دارای RAM مناسب |
برای مشاهده نسخهها و حجمهای فعلی میتوانید به
کتابخانه رسمی Ollama
مراجعه کنید.
سناریوی بسیار مناسب برای VPS ایران: RAG داخلی
برای بسیاری از سازمانها لازم نیست مدل را با تمام دانش شرکت Fine-tune کنند. معماری Retrieval-Augmented Generation یا RAG معمولاً راه سادهتر و قابلکنترلتری است.
در RAG اسناد سازمان ابتدا Chunk میشوند، Embedding میگیرند و در Vector Database ذخیره میشوند. هنگام پرسش کاربر، مرتبطترین بخش اسناد بازیابی و همراه Prompt به مدل داخلی داده میشود.
🔹 کاربر سؤال را در پنل داخلی ثبت میکند.
🔹 Backend سؤال را به Embedding تبدیل میکند.
🔹 Vector Database بخشهای مرتبط اسناد را پیدا میکند.
🔹 فقط Context موردنیاز به LLM داخلی داده میشود.
🔹 پاسخ داخل همان زیرساخت تولید میشود.
چه دادههایی برای RAG داخلی مناسباند؟
🔹 مستندات فنی شرکت.
🔹 آییننامهها و فرآیندهای سازمان.
🔹 دانش پشتیبانی و FAQ داخلی.
🔹 کاتالوگ محصولات و مشخصات فنی.
🔹 Wiki و Knowledge Base سازمان.
🔹 قراردادها یا اسناد مجاز برای گروههای مشخص.
معماری پیشنهادی AI خصوصی روی VPS ایران
| لایه | نرمافزار نمونه | وظیفه |
|---|---|---|
| Reverse Proxy | Nginx | TLS، Authentication و محدودیت دسترسی |
| LLM Runtime | Ollama یا llama.cpp | Inference مدل |
| Backend | FastAPI، Node.js یا Laravel | Business Logic و Auth |
| Vector Store | Qdrant، PostgreSQL + pgvector | ذخیره Embedding |
| Data Store | PostgreSQL یا MariaDB | کاربران، Log و Metadata |
| Firewall | UFW یا nftables | محدود کردن سطح حمله |
نصب سریع Ollama روی سرور لینوکس ایران
Ollama یکی از سادهترین روشها برای راهاندازی مدلهای محلی روی Linux است. دستور نصب رسمی:
curl -fsSL https://ollama.com/install.sh | shسپس وضعیت سرویس را بررسی کنید:
sudo systemctl start ollama
sudo systemctl status ollama
برای تست یک مدل کوچک Qwen3:
ollama run qwen3:1.7bیا Gemma 3:
ollama run gemma3:1bراهنمای رسمی نصب:
Ollama Linux Documentation
⚠️
API مدل را بدون Authentication مستقیماً روی اینترنت عمومی قرار ندهید. بهتر است Runtime فقط از Backend داخلی قابل دسترسی باشد و API عمومی پشت Reverse Proxy، TLS، Token، VPN یا IP Allowlist قرار گیرد.
چرا CPU در انتخاب VPS AI مهمتر از چیزی است که تصور میشود؟
در مدلهایی که بدون GPU اجرا میشوند، سرعت تولید Token مستقیماً به قدرت CPU، تعداد Core، Instruction Set و پهنای باند حافظه وابسته است. بنابراین صرفاً بالا بردن RAM باعث سریعتر شدن مدل نمیشود.
برای مثال ممکن است یک مدل 4B بهراحتی در 8GB RAM جا شود، اما اگر CPU ضعیف باشد پاسخ طولانی با تأخیر تولید شود. برای API سازمانی بهتر است هم RAM و هم تعداد Core متناسب با تعداد کاربر همزمان انتخاب شود.
قبل از خرید VPS این دستور را روی سرور بررسی کنید
lscpu
free -h
nproc
df -h
آیا VPS هشت گیگ برای AI کافی است؟
برای مدلهای کوچک، Embedding، RAG سبک و توسعه میتواند کافی باشد. برای نمونه فایل Quantized برخی مدلهای 4B حدود چند گیگابایت است، اما باید RAM کافی برای Runtime و Context هم باقی بماند.
اگر قرار است چند کاربر بهصورت همزمان چت کنند، Context بسیار بلند داشته باشید یا چند سرویس مثل Qdrant، PostgreSQL و Backend نیز روی همان VPS اجرا شوند، 8GB سریعتر به محدودیت میرسد.
✅ 4GB: مدلهای Tiny و سرویس آزمایشی.
✅ 8GB: مدل کوچک 1B تا 4B و RAG سبک.
✅ 16GB: مدل Quantized بزرگتر و سرویس داخلی جدیتر.
✅ 32GB+: چند سرویس، Context بزرگتر یا مدلهای 12B+.
چه زمانی VPS دیگر گزینه مناسبی نیست؟
VPS برای شروع بسیار مناسب است، اما هر Workload هوش مصنوعی را نباید روی VPS CPU اجرا کرد. در شرایط زیر بهتر است سراغ سرور اختصاصی یا زیرساخت GPU بروید:
⚠️ مدل 14B، 30B یا 70B با پاسخ سریع میخواهید.
⚠️ دهها کاربر همزمان دارید.
⚠️ Contextهای بسیار بزرگ پردازش میکنید.
⚠️ Fine-tuning واقعی مدلهای بزرگ انجام میدهید.
⚠️ پردازش تصویر، صوت یا Video سنگین دارید.
برای AI سنگینتر، سرور اختصاصی ایران را هم بررسی کنید
وقتی مدل از محدوده VPS خارج میشود، RAM بیشتر و منابع اختصاصی اهمیت پیدا میکند. ایرانیکاسرور در بخش سرور اختصاصی ایران پلنهایی با منابع سختافزاری اختصاصی ارائه میدهد؛ در صفحه فعلی نمونهای با 64GB RAM نیز وجود دارد.
برای Workloadهای LLM بزرگ، قبل از سفارش حتماً درباره نوع CPU و در صورت نیاز وجود GPU مناسب با پشتیبانی استعلام کنید؛ چون RAM زیاد بهتنهایی جای GPU را برای Inference سریع مدلهای بزرگ نمیگیرد.
📌 تماس با پشتیبانی:
021-91302467
| ایرانیکاسرور
حاکمیت داده فقط با خرید VPS حل نمیشود
فرض کنید LLM روی تهران میزبانی میشود، اما Application برای Logging از یک SaaS خارجی استفاده میکند یا Backup دیتابیس روی فضای ابری خارج از کشور میرود. در این صورت بخشی از داده هنوز از معماری داخلی خارج میشود.
زنجیرهای که باید بررسی شود
🔹 Prompt و پاسخ مدل کجا Log میشود؟
🔹 فایلهای ورودی کاربر کجا ذخیره میشوند؟
🔹 Vector Database در همان کشور قرار دارد؟
🔹 Backup به کدام Location ارسال میشود؟
🔹 سرویس Monitoring متن Request را ثبت میکند؟
🔹 Application همچنان به API خارجی Fallback دارد؟
🔹 چه افرادی SSH و Root Access دارند؟
مدل Hybrid؛ راهحل واقعبینانه برای بسیاری از شرکتها
لازم نیست انتخاب شما فقط «کاملاً داخلی» یا «کاملاً Cloud خارجی» باشد. یک معماری Hybrid میتواند داده حساس را داخل زیرساخت نگه دارد و فقط درخواستهای عمومی یا فاقد اطلاعات محرمانه را به مدل قویتر خارجی بفرستد.
| نوع درخواست | محل پیشنهادی پردازش | دلیل |
|---|---|---|
| سند محرمانه مشتری | LLM داخلی | حفظ کنترل داده |
| پرسش عمومی بدون داده شخصی | داخلی یا API خارجی | انعطاف هزینه و کیفیت |
| RAG روی Knowledge Base شرکت | ترجیحاً داخلی | اسناد سازمانی خارج نمیشوند |
| ترجمه متن عمومی | Hybrid | امکان انتخاب بهترین مدل |
امنیت API مدل داخلی
اجرای مدل داخل ایران زمانی ارزش امنیتی دارد که Endpoint آن نیز درست محافظت شود. قرار دادن API مدل بدون Authentication روی Public IP میتواند باعث سوءاستفاده، مصرف CPU، DoS یا دسترسی اشخاص ناشناس به مدل شود.
✅ Port Runtime را مستقیماً Public نکنید.
✅ TLS را روی Reverse Proxy فعال کنید.
✅ API Key یا JWT برای کاربران تعریف کنید.
✅ Rate Limit برای هر کاربر داشته باشید.
✅ SSH Password Login را محدود و ترجیحاً Key-based کنید.
✅ Firewall فقط Portهای موردنیاز را باز نگه دارد.
✅ Prompt Logهای حساس را محدود یا Mask کنید.
نمونه پایه UFW
sudo ufw default deny incoming
sudo ufw default allow outgoing
sudo ufw allow 22/tcp
sudo ufw allow 80/tcp
sudo ufw allow 443/tcp
sudo ufw enable
⚠️
قبل از فعالکردن Firewall مطمئن شوید Port واقعی SSH شما Allow شده است؛ در غیر این صورت ممکن است دسترسی به سرور قطع شود.
چگونه مصرف RAM مدل را مانیتور کنیم؟
free -h
htop
ps -eo pid,comm,%cpu,%mem,rss --sort=-rss | head -n 20
در Ollama میتوانید مدلهای Load شده را نیز بررسی کنید:
ollama psدیسک SSD هم در AI اهمیت دارد
فایل مدلها میتوانند چندین گیگابایت حجم داشته باشند. اگر چند نسخه مختلف یک مدل یا چند Quantization نگهداری شود، فضای دیسک بهسرعت پر میشود. علاوه بر فایل مدل، Vector Database، Document Store، Log و Backup نیز فضای ذخیرهسازی میخواهند.
🔹 فایل Weight مدل.
🔹 نسخههای Quantized متعدد.
🔹 Docker Imageها در صورت استفاده.
🔹 Vector Database.
🔹 فایلهای PDF و Knowledge Base.
🔹 Backupهای دورهای.
کاربردهای واقعی AI داخلی روی سرور ایران
| کاربرد | مدل بزرگ لازم است؟ | مناسب VPS؟ |
|---|---|---|
| چتبات دانش داخلی شرکت | معمولاً خیر؛ RAG مهمتر است | بله، برای بار محدود |
| خلاصهسازی تیکت پشتیبانی | خیر | بله |
| استخراج نام، کد، تاریخ و فیلد | خیر | بسیار مناسب |
| طبقهبندی ایمیل و تیکت | خیر | بله |
| Code Assistant چندکاربره | اغلب مدل قویتر مفید است | برای تیم کوچک |
| Fine-tune مدل بزرگ | بله | معمولاً خیر؛ GPU مناسبتر است |
مزیت تأخیر شبکه برای کاربران داخل ایران
اگر Application، Database و کاربران سازمان داخل ایران باشند، قرار دادن Backend AI داخل همان جغرافیا میتواند زمان رفتوبرگشت شبکه را کاهش دهد. البته بخش اصلی Latency LLM معمولاً زمان Inference است؛ بنابراین پینگ پایین نمیتواند CPU ضعیف را جبران کند.
مزیت اصلی VPS ایران در این سناریو بیشتر نزدیکی سرویس به Backend و Data Store داخلی، IP ایران و کنترل مسیر داده است.
هزینه Self-hosted AI در برابر API خارجی
هزینه این دو مدل را نباید فقط با قیمت ماهانه VPS و قیمت Token مقایسه کرد. Self-hosting هزینه مدیریت سیستم، Backup، Security، Monitoring و Capacity Planning دارد؛ در مقابل API خارجی مدیریت زیرساخت را ساده میکند ولی هزینه با تعداد درخواست رشد میکند.
| معیار | AI روی VPS ایران | API خارجی |
|---|---|---|
| کنترل داده | بیشتر | وابسته به ارائهدهنده |
| نیاز به مدیریت سرور | بله | کمتر |
| مقیاس ناگهانی | نیازمند ارتقا منابع | معمولاً سادهتر |
| هزینه درخواست زیاد | هزینه منابع ثابتتر | اغلب وابسته به Token |
| مدلهای بسیار قوی | نیازمند سختافزار قوی | دسترسی سادهتر |
اشتباهات رایج در راهاندازی LLM روی VPS
⚠️ انتخاب مدل بر اساس تعداد پارامتر بدون توجه به RAM.
⚠️ تصور اینکه فایل 4GB دقیقاً فقط 4GB RAM لازم دارد.
⚠️ اجرای مدل 70B روی CPU و انتظار پاسخ سریع.
⚠️ باز کردن مستقیم Port مدل روی Public Internet.
⚠️ نگهداری Promptهای حساس در Log بدون Retention Policy.
⚠️ انتقال Backup به خارج بدون توجه به سیاست داده.
⚠️ نصب مدل بسیار بزرگ به جای طراحی RAG مناسب.
چکلیست انتخاب VPS ایران برای AI
✅ مدل و Quantization را قبل از خرید مشخص کنید.
✅ حداقل 25 تا 40 درصد RAM آزاد برای Runtime و سیستم در نظر بگیرید.
✅ تعداد کاربر همزمان را تخمین بزنید.
✅ Context Length موردنیاز را واقعی انتخاب کنید.
✅ SSD کافی برای Model، Vector DB و Backup تهیه کنید.
✅ CPU مناسب برای Inference داشته باشید.
✅ API را پشت HTTPS و Authentication قرار دهید.
✅ محل Backup و Logging را در سیاست حاکمیت داده لحاظ کنید.
برای Ollama، RAG یا AI داخلی به کانفیگ سرور نیاز دارید؟
اگر در انتخاب مدل، نصب Ollama، Reverse Proxy، Firewall، بهینهسازی RAM، Docker، Vector Database یا امنسازی API مشکل دارید، میتوانید از خدمات کانفیگ ایرانیکاسرور استفاده کنید. در پروژههای AI، انتخاب اشتباه مدل یا تنظیمات Runtime میتواند حتی یک سرور پرمنبع را هم بهشدت کند کند.
📌 تماس با پشتیبانی:
021-91302467
| ایرانیکاسرور
سوالات متداول اجرای AI متنباز روی سرور ایران
آیا میتوان ChatGPT مانند را روی VPS ایران ساخت؟
میتوان یک Chat UI و مدل متنباز داخلی ساخت، اما کیفیت و سرعت دقیقاً برابر سرویسهای بزرگ تجاری نخواهد بود. مدلهای کوچکتر مانند Qwen3، Gemma یا Mistral برای بسیاری از کارهای سازمانی قابل استفاده هستند.
حداقل RAM برای Ollama چقدر است؟
Ollama بهتنهایی معیار اصلی نیست؛ اندازه مدل تعیینکننده است. مدلهای حدود 1B را میتوان روی RAM پایینتر اجرا کرد، اما برای مدلهای 4B، 7B و بالاتر باید حافظه بیشتری برای وزن مدل، KV Cache و Runtime در نظر گرفت.
آیا بدون GPU هم میتوان LLM اجرا کرد؟
بله. llama.cpp و Ollama میتوانند مدلها را روی CPU اجرا کنند. تفاوت اصلی در سرعت است؛ GPU برای مدلهای بزرگتر و تعداد کاربر بیشتر مزیت زیادی دارد.
آیا سرور ایران باعث میشود داده صددرصد داخل کشور بماند؟
فقط در صورتی که تمام اجزای زنجیره شامل Application، Database، Vector Store، Log، Backup و سرویسهای جانبی نیز مطابق همان سیاست طراحی شوند. استفاده از VPS ایران بهتنهایی تضمین کامل حاکمیت داده نیست.
برای RAG مدل 70B لازم است؟
خیر. در بسیاری از پروژههای RAG، کیفیت Chunking، Embedding، Retrieval و Prompt اهمیت زیادی دارد و یک مدل 3B تا 8B ممکن است برای نیاز سازمان کافی باشد.
برای مدل 7B چند گیگ RAM مناسب است؟
برای نسخه Quantized بهتر است معمولاً حداقل حدود 12 تا 16GB RAM یا بیشتر در نظر گرفته شود تا سیستمعامل، Runtime و Context نیز فضای کافی داشته باشند. مقدار دقیق به Quantization و طول Context بستگی دارد.
VPS بهتر است یا سرور اختصاصی برای AI؟
برای مدلهای کوچک، توسعه، Embedding و RAG کمترافیک VPS اقتصادیتر است. برای مدلهای بزرگ، کاربران همزمان زیاد یا نیاز به منابع کاملاً اختصاصی، سرور اختصاصی یا زیرساخت GPU انتخاب مناسبتری است.
جمعبندی؛ چه زمانی VPS ایران برای AI انتخاب خوبی است؟
اگر هدف شما ساخت یک چتبات سازمانی، سیستم RAG، خلاصهساز، طبقهبندی متن، استخراج اطلاعات یا API AI خصوصی است، سرور مجازی ایران میتواند نقطه شروع مناسبی باشد؛ بهخصوص زمانی که میخواهید بخش بیشتری از مسیر Prompt و اسناد تحت کنترل خودتان باقی بماند.
برای مدلهای کوچک و Quantized، CPU نیز قابل استفاده است. اما هرچه اندازه مدل، Context و تعداد کاربران افزایش پیدا کند، نیاز به RAM، CPU و در نهایت GPU بیشتر میشود.
مهمتر از نام مدل، طراحی صحیح معماری است: VPS داخلی + مدل مناسب + RAG + Vector Database + TLS + Authentication + Backup داخلی + Logging کنترلشده. این ترکیب میتواند هم حریم داده را بهتر مدیریت کند و هم وابستگی مستقیم کسبوکار به APIهای خارجی را کاهش دهد.
منابع رسمی و فنی
🔹
Microsoft Learn؛ Data Sovereignty و Data Residency
🔹
llama.cpp؛ اجرای LLM روی CPU و GPU و Quantization
۳۰ برچسب پیشنهادی:
سرور مجازی هوش مصنوعی، سرور مجازی ایران، AI روی VPS، اجرای LLM روی سرور، مدل متن باز هوش مصنوعی، مدل زبانی داخلی، حاکمیت داده، حریم خصوصی داده، Data Sovereignty، Data Residency، Private LLM، Self Hosted AI، Ollama، llama.cpp، Qwen3، Gemma 3، Mistral، RAG، RAG داخلی، Vector Database، AI سازمانی، چت بات داخلی، هوش مصنوعی خصوصی، Quantization مدل زبانی، اجرای LLM بدون GPU، سرور AI ایران، خرید VPS ایران، امنیت هوش مصنوعی، API هوش مصنوعی داخلی، ایرانیکاسرور

💬 دیدگاهها 0
هنوز دیدگاهی ثبت نشده است. اولین نفری باشید که نظر میدهید!
✍️ دیدگاه خود را بنویسید