
 Amir Jabbari
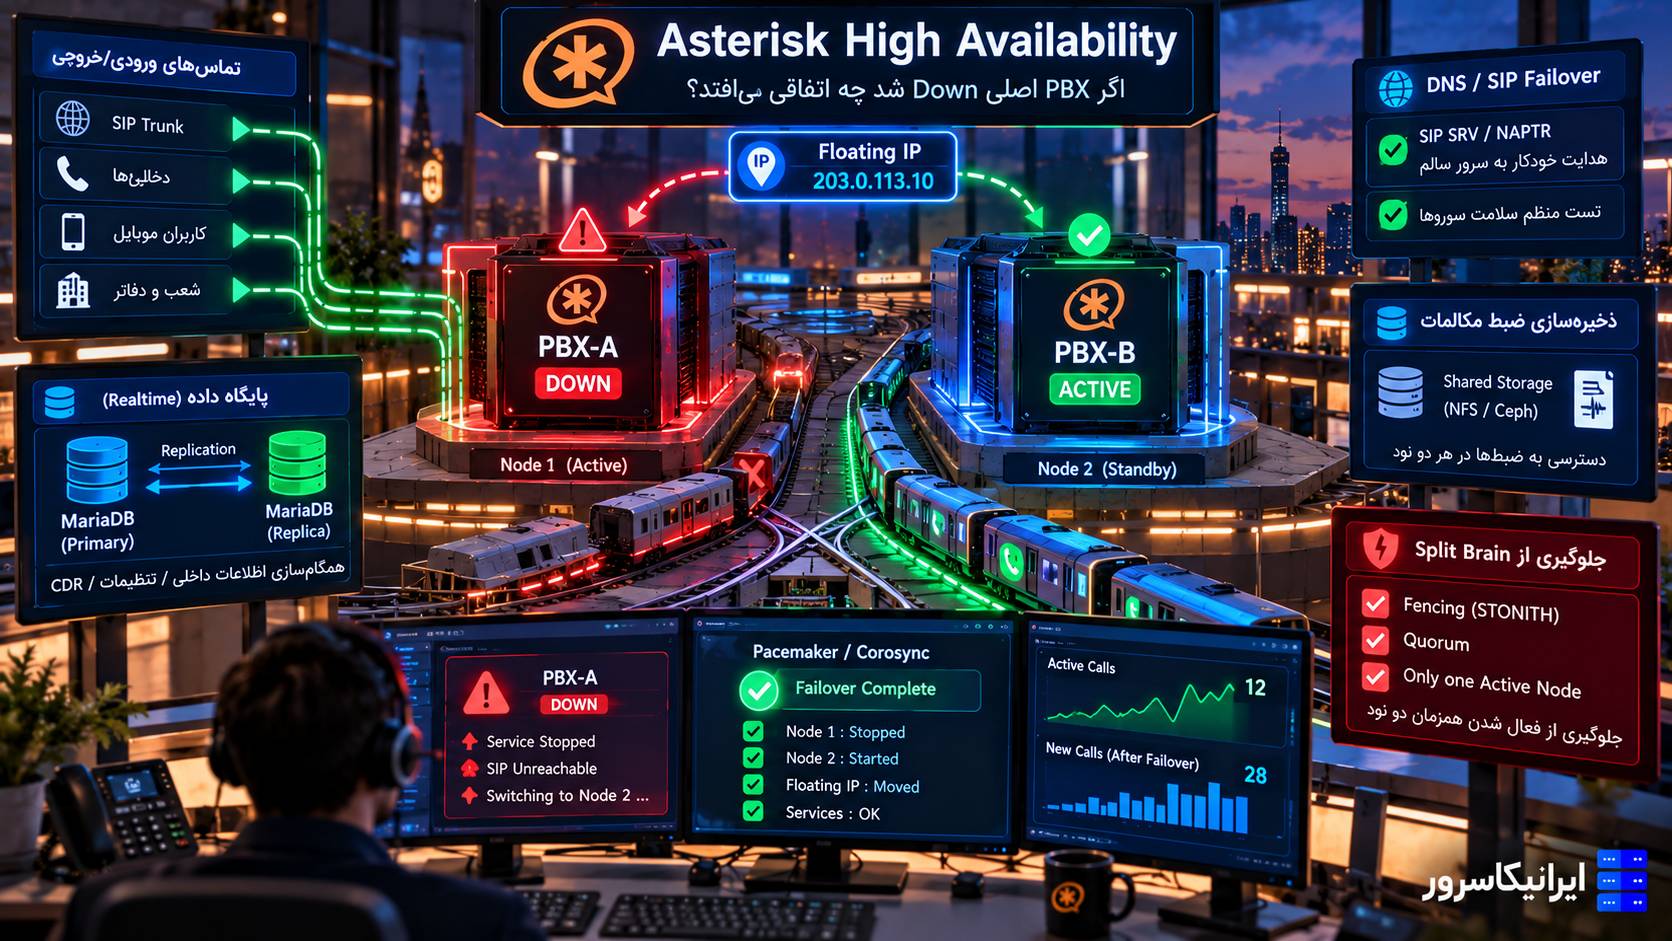
High Availability در Asterisk یعنی اگر PBX اصلی از دسترس خارج شد، تماسهای جدید بتوانند با کمترین وقفه به یک نود سالم منتقل شوند؛ اما تماسهای در حال مکالمه معمولاً روی سرور دوم «ادامه پیدا نمیکنند». Asterisk بهصورت پیشفرض یک Cluster آماده با Replication کامل Session، Registration، RTP و فایلهای ضبطشده نیست. برای HA واقعی باید چند بخش مستقل را طراحی کنید: سرویس Asterisk، آدرس دسترسی، دیتابیس، Registrationها، فایلهای ضبط مکالمه، SIP/RTP و مکانیزم جلوگیری از Split Brain.
در سادهترین معماری Production، دو Asterisk بهصورت Active/Passive داریم؛ فقط یکی در هر لحظه سرویس اصلی را ارائه میدهد و یک Cluster Manager مانند Pacemaker/Corosync سلامت آن را بررسی میکند. اگر نود Active واقعاً Fail شود، نود Standby پس از Fencing، سرویس و آدرس مجازی را تحویل میگیرد. برای معماریهای بزرگتر میتوان SIP Proxy/SBC را جلوی چند PBX قرار داد و Failover را در لایه Signaling انجام داد.
جواب کوتاه: اگر PBX اصلی ناگهان Down شود، تماسهایی که Media و Session آنها روی همان Asterisk بوده معمولاً قطع میشوند. HA قرار نیست Call State زنده را جادووار به نود دوم منتقل کند؛ هدف اصلی این است که تماسهای جدید، Registrationها و سرویس تلفنی در چند ثانیه یا چند ده ثانیه دوباره قابلاستفاده شوند.
اول مشخص کنیم High Availability در VoIP دقیقاً چه چیزی را باید نجات دهد
در یک PBX فقط یک Process به نام Asterisk نداریم. چند نوع State و Data داریم که رفتار آنها هنگام Failover متفاوت است:
| جزء | در زمان Failover چه میشود؟ |
|---|---|
| Asterisk Service | روی نود Standby Start میشود |
| Floating/Service IP | به نود سالم منتقل میشود |
| تماسهای در حال مکالمه | معمولاً قطع میشوند |
| Registrationهای SIP | ممکن است نیاز به Re-register داشته باشند |
| Realtime Config / CDR | باید از دیتابیس HA یا Replicated استفاده کنند |
| Voicemail / Recordings | باید Shared یا Replicated Storage داشته باشند |
| RTP State | بهصورت پیشفرض به نود دوم منتقل نمیشود |
| AMI/ARI App State | باید در سطح Application برای Failover طراحی شود |
بنابراین عبارت «دو سرور Asterisk دارم» بهتنهایی HA نیست. اگر هر دو سرور Config متفاوت، دیتابیس محلی جدا، ضبطهای محلی و IP مستقل داشته باشند، فقط دو PBX جدا دارید.
RTO و RPO را قبل از انتخاب معماری مشخص کنید
دو عدد باید از ابتدا مشخص باشند:
🔹 RTO: بعد از خرابی، حداکثر چند ثانیه یا دقیقه قطعی قابلقبول است؟
🔹 RPO: چه مقدار Data Loss قابلقبول است؟ صفر، چند ثانیه یا چند دقیقه؟
مثلاً اگر میگویید «در ۱۵ ثانیه تماسهای جدید دوباره برقرار شوند و هیچ CDR از دست نرود»، معماری شما باید بسیار جدیتر از یک Script ساده برای Restart کردن Asterisk باشد.
معماری ۱: Active/Passive با Pacemaker و Corosync
برای بیشتر PBXهای سازمانی که یک نقطه سرویس واحد میخواهند، Active/Passive سادهترین الگوی قابلفهم است.
             Service IP
          192.0.2.50
                |
        +-------+-------+
        |               |
        v               v
 PBX-01 ACTIVE      PBX-02 PASSIVE
 Asterisk ON        Asterisk OFF
        |               |
        +------ HA ------+
          Corosync
          Pacemaker
          Fencing
Corosync لایه Membership/Quorum و پیامرسانی Cluster را فراهم میکند و Pacemaker تصمیم میگیرد Resourceها روی کدام نود اجرا شوند. Asterisk خودش هم ماژول res_corosync دارد، اما مستند رسمی Asterisk روشن میکند این Integration برای اشتراک Eventهایی مثل Device State و MWI است؛ جای Cluster Manager و Service Failover کامل را نمیگیرد.
Resourceهای اصلی در Active/Passive
🔹 Asterisk Service.
🔹 Virtual/Floating IP.
🔹 Storage Mount اگر Shared Storage دارید.
🔹 Database VIP یا DB Proxy در صورت نیاز.
🔹 Fencing Resource.
Floating IP چه کاری انجام میدهد؟
تلفنها و Provider نباید مجبور باشند بدانند کدام نود Active است. یک Service IP ثابت جلوی Cluster قرار میگیرد.
در Pacemaker، Resource رایج برای این کار IPaddr2 است:
pcs resource create ClusterIP \
  ocf:heartbeat:IPaddr2 \
  ip=192.0.2.50 \
  cidr_netmask=24 \
  op monitor interval=30s
ClusterLabs در مستند «Clusters from Scratch» از همین Resource برای Service Address استفاده میکند تا کاربران همیشه به یک آدرس ثابت وصل شوند.
محدودیت مهم: Floating IP کلاسیک معمولاً به شبکه و Subnet مشترک یا پشتیبانی زیرساخت نیاز دارد. در بعضی Cloudها نمیتوانید یک IP را مثل LAN عادی بین دو VM جابهجا کنید و باید از Floating IP خود Provider، API Route، Load Balancer یا طراحی DNS/SIP Proxy استفاده کنید.
Split Brain؛ خطرناکترین خرابی در Cluster دو نودی
فرض کنید PBX-01 و PBX-02 ارتباط Cluster با هم را از دست بدهند اما هر دو هنوز سالم باشند. اگر هر دو تصور کنند طرف مقابل Down شده و هر دو Service IP و Asterisk را Active کنند، Split Brain رخ میدهد.
Network partition

PBX-01: "PBX-02 is dead"
PBX-02: "PBX-01 is dead"

Both become ACTIVE
        |
        +--> duplicate IP
        +--> duplicate SIP responses
        +--> conflicting database writes
        +--> recording/storage corruption risk
Pacemaker روی مفهوم Fencing یا STONITH تأکید میکند. مستند رسمی ClusterLabs توضیح میدهد Fencing نود نامطمئن را واقعاً از اجرای Resourceها ناتوان میکند و برای جلوگیری از Split Brain ضروری است.
Fencing یعنی چه؟
مثلاً Cluster از IPMI، iLO، iDRAC، Watchdog، Cloud API یا یک روش قابلاعتماد دیگر استفاده میکند تا قبل از Active کردن نود دوم، مطمئن شود نود قبلی دیگر نمیتواند Resource را اجرا کند.
قاعده عملی:
Failover without fencing:
"Maybe node A is dead"

Failover with fencing:
"Node A is guaranteed unable to run the service"
دو نود کافی است یا نود سوم لازم داریم؟
برای Asterisk Active/Passive معمولاً دو نود Voice داریم، اما برای تصمیمگیری Quorum بهتر است یک رأی سوم یا مکانیزم Witness/QDevice/Fencing مستقل داشته باشید. مسئله این است که در Partition دو نودی، هر نود بهتنهایی نمیتواند با اطمینان بفهمد «من سالمم و دیگری مرده» یا فقط لینک بین ما قطع شده است.
در لایه دیتابیس نیز MariaDB Galera برای Quorum معماری سه عضو یا بیشتر را توصیه میکند. MariaDB برای سناریوی دو Data Node امکان استفاده از garbd بهعنوان رأی سوم را هم مستند کرده است.
دیتابیس را چطور High Available کنیم؟
اگر PJSIP Realtime، CDR، CEL، Userها یا تنظیمات PBX در SQL هستند، Failover Asterisk بدون HA دیتابیس ناقص است.
Asterisk Realtime Architecture و res_odbc اجازه میدهند بخشهایی از تنظیمات و دادهها از Database Backend خوانده شوند. مستند رسمی Asterisk توضیح میدهد Realtime مستقل از Storage طراحی شده و ODBC یکی از Backendهای اصلی آن است.
سه الگوی معمول:
| روش | مزیت | ریسک/محدودیت |
|---|---|---|
| Primary + Replica | سادهتر | Failover DB باید جدا مدیریت شود |
| MariaDB Galera | Multi-primary و Quorum | نیاز به طراحی درست Quorum و Network |
| DB HA Service خارجی | سادگی در PBX | وابستگی به سرویس خارجی |
Galera مشکل Split Brain را چطور کنترل میکند؟
MariaDB Galera فقط Component دارای اکثریت را Primary نگه میدارد. مستند رسمی میگوید Quorum زمانی برقرار است که بیش از ۵۰٪ اعضای آخرین Membership با هم ارتباط داشته باشند. Partition بدون اکثریت Non-Primary میشود تا دو سمت مستقل همزمان Write نکنند.
برای مانیتورینگ:
SHOW GLOBAL STATUS LIKE 'wsrep_%';اما Galera فقط دیتابیس را HA میکند؛ RTP، SIP Dialog و فایلهای ضبط Asterisk را Replicate نمیکند.
Registration داخلیها بعد از Failover چه میشود؟
این بخش به طراحی شما بستگی دارد. Contactهای PJSIP شامل اطلاعاتی مثل URI، زمان Expire، وضعیت و حتی reg_server هستند. اگر State روی دیتابیس مشترک/Realtime نگهداری شود، بخشی از اطلاعات قابلاشتراک است؛ با این حال Failover واقعی را باید با Endpointهای خودتان تست کنید.
در طراحی Active/Passive ساده، بهتر است انتظار داشته باشید بعضی Endpointها بعد از جابهجایی IP یا بازگشت سرویس Re-register شوند.
برای کاهش زمان بازیابی:
🔹 Registration Expiry بسیار طولانی انتخاب نکنید.
🔹 SIP OPTIONS/Qualify را فعال کنید.
🔹 تلفنها قابلیت Reconnect سریع داشته باشند.
🔹 در معماری بزرگتر، Registrar/SIP Proxy را از Media PBX جدا کنید.
DNS و SIP Failover چه زمانی بهتر از Floating IP هستند؟
RFC 3263 مکانیزمهای DNS برای پیدا کردن SIP Server را تعریف میکند و از NAPTR و SRV برای انتخاب Transport، Port و Server استفاده میکند. این استاندارد همچنین امکان تلاش روی Server جایگزین در صورت Fail شدن Primary را توضیح میدهد.
نمونه مفهومی SRV:
_sip._udp.example.com.

10 10 5060 pbx-a.example.com.
20 10 5060 pbx-b.example.com.
اما سه نکته مهم وجود دارد:
🔹 همه تلفنها و Providerها رفتار SRV یکسانی ندارند.
🔹 DNS Cache و TTL میتواند Failover را کند کند.
🔹 DNS Failover تماس در حال مکالمه را حفظ نمیکند.
برای محیطهای بزرگ معمولاً SIP Proxy/SBC جلوی چند Asterisk از DNS-only قابلپیشبینیتر است.
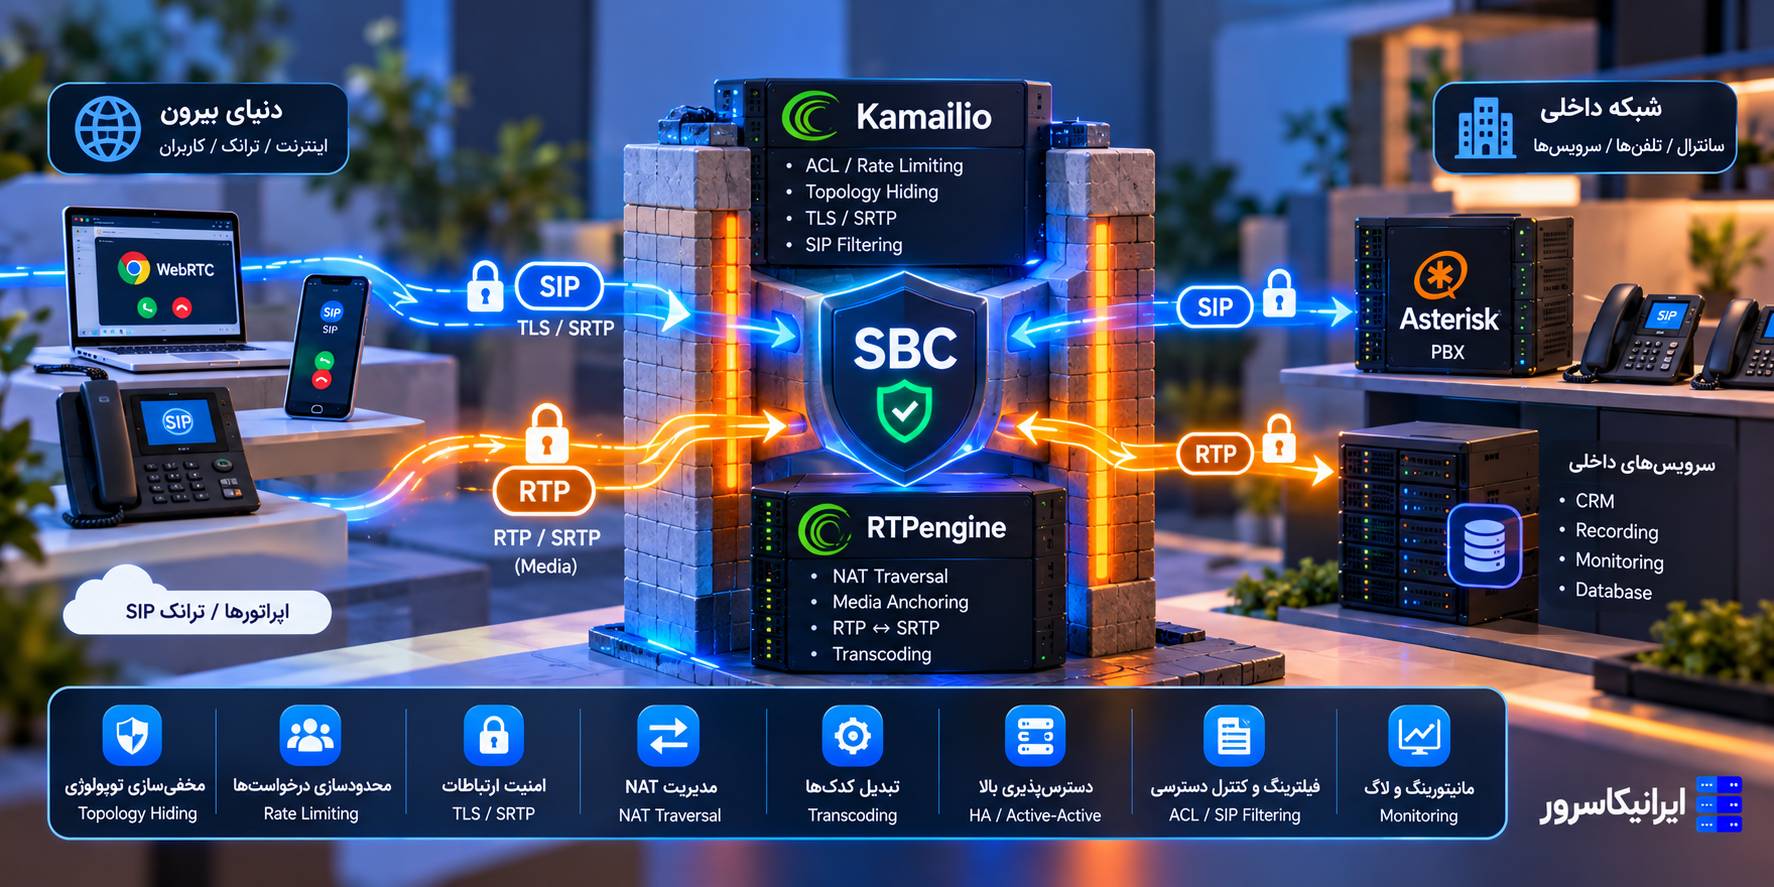
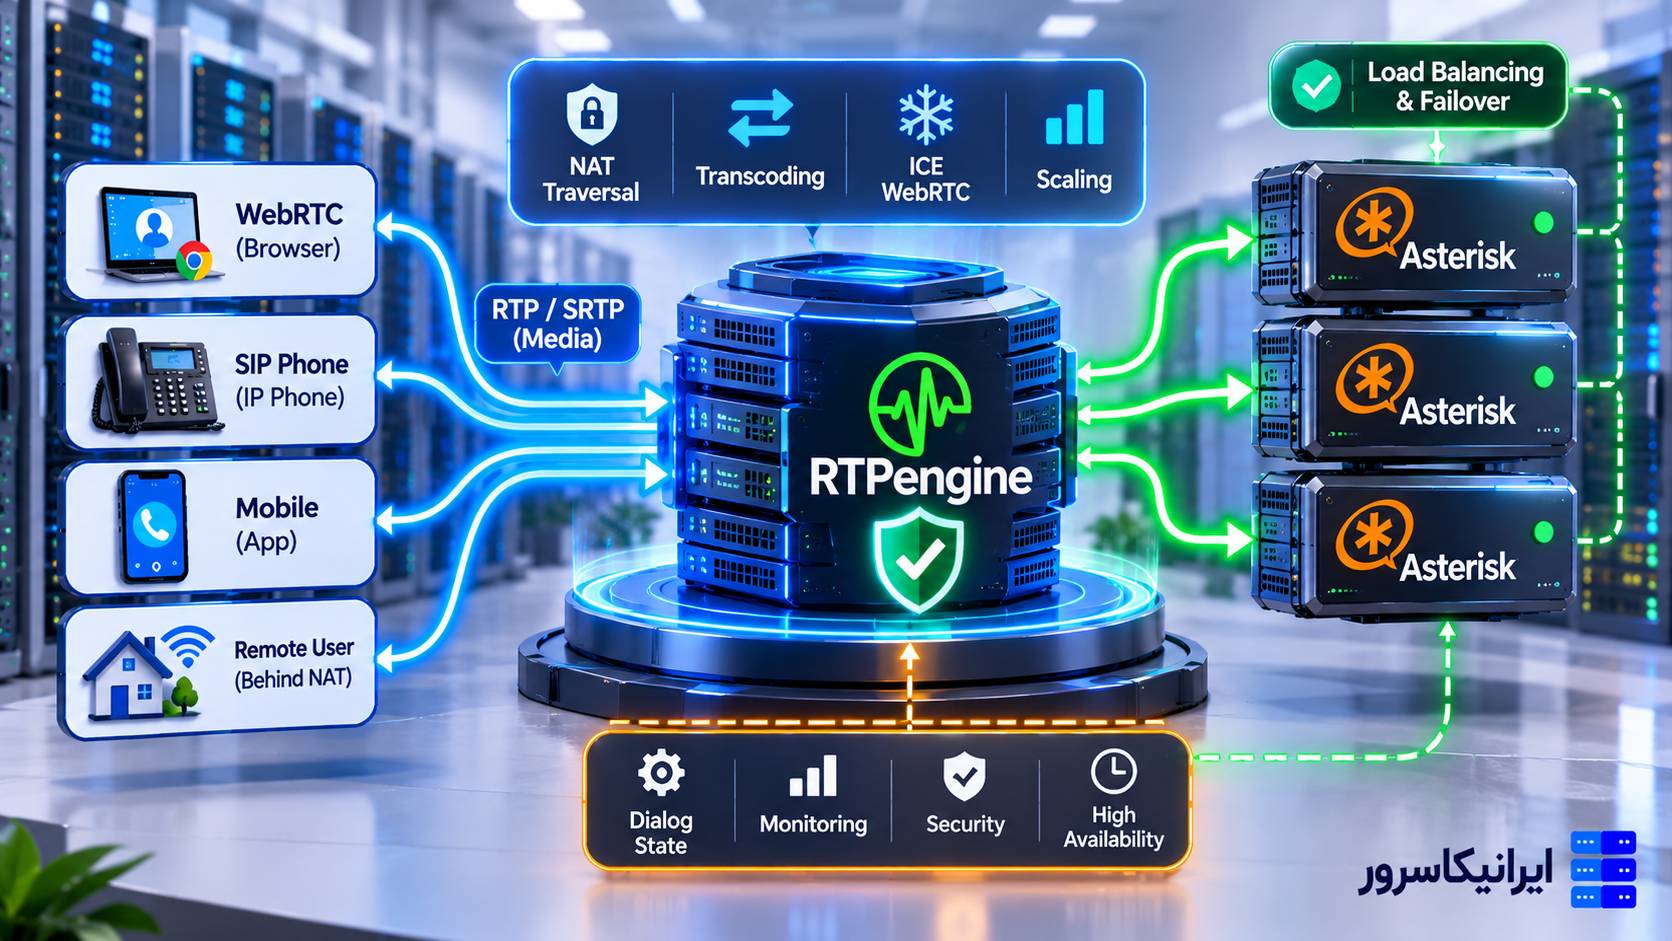
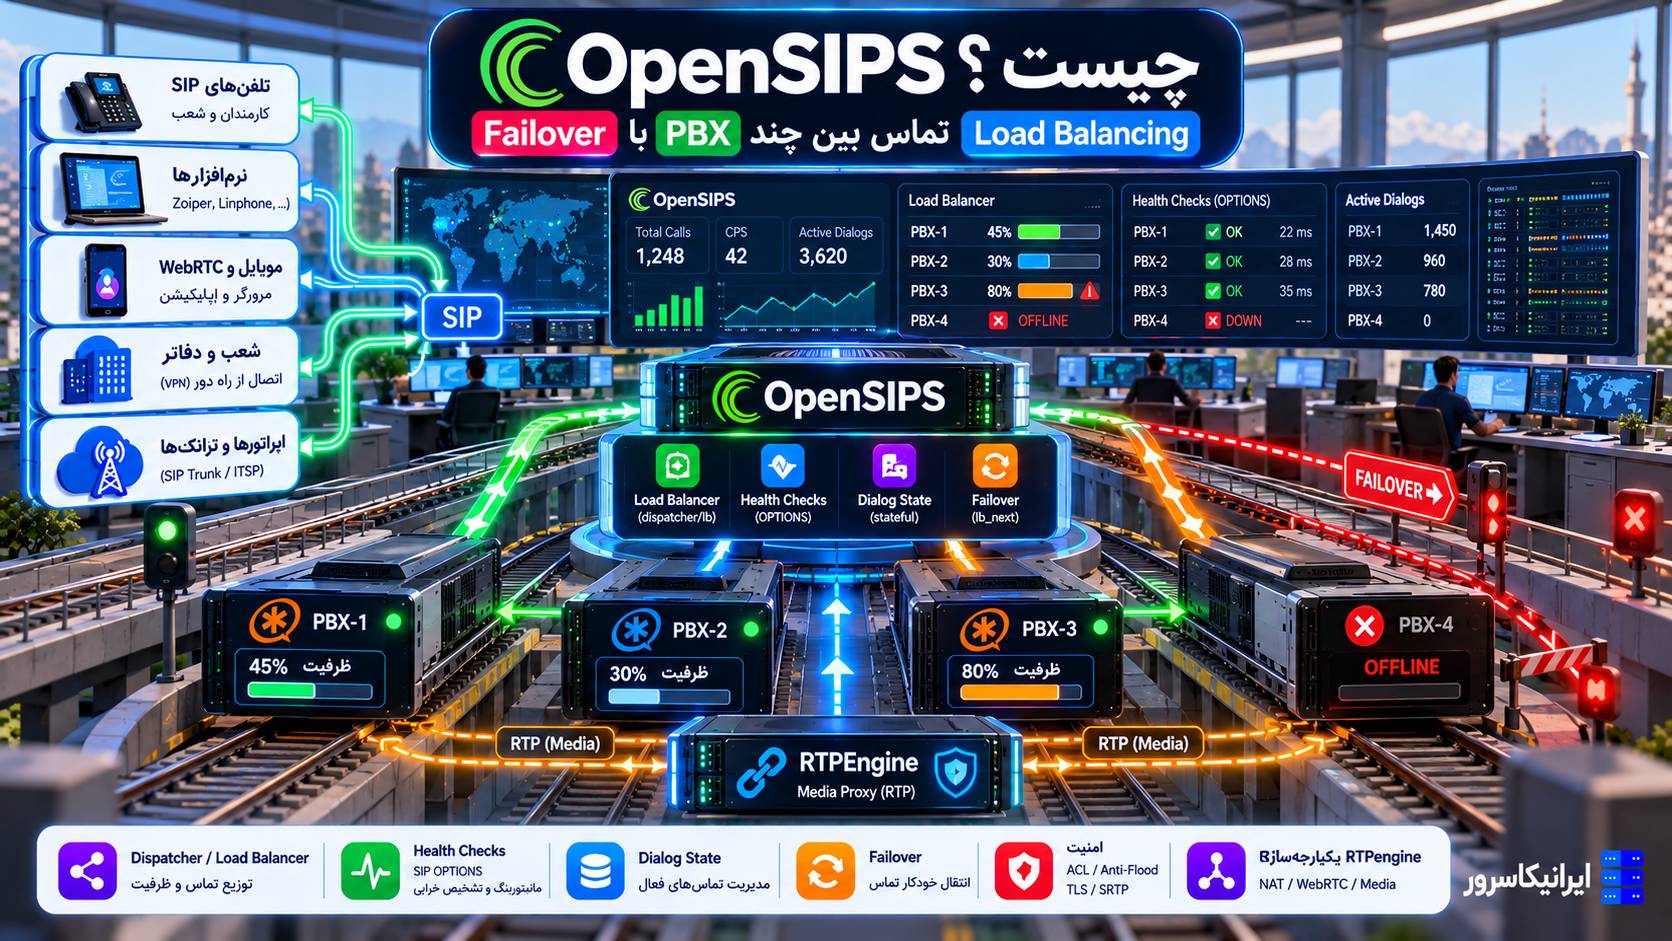
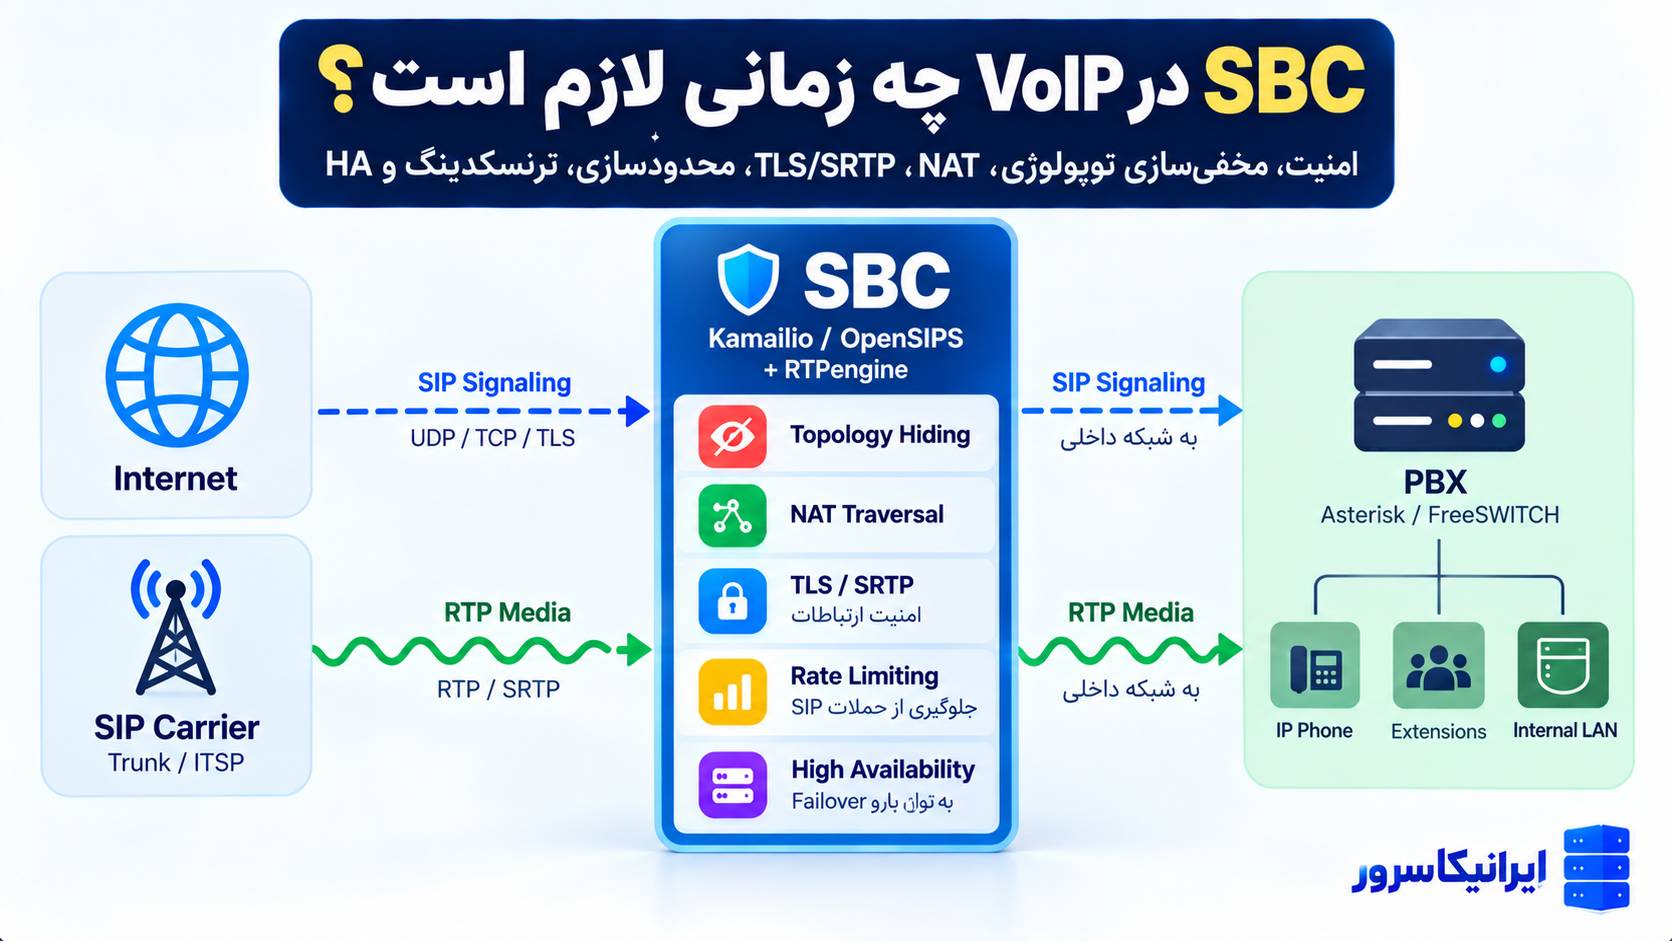
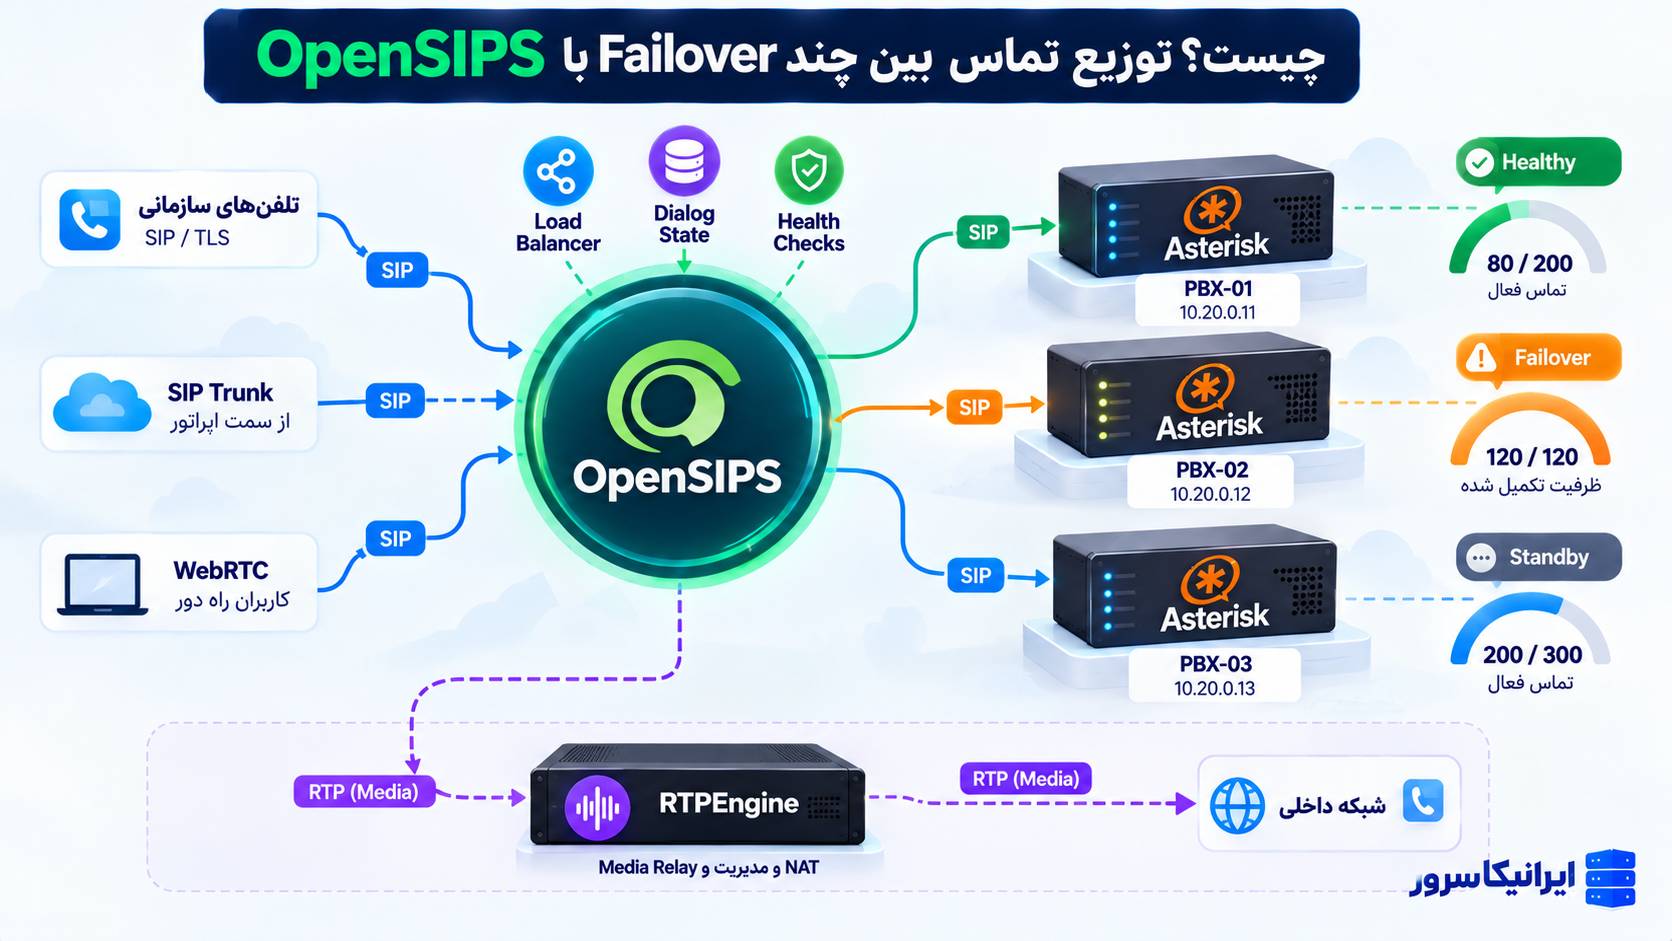
معماری ۲: SIP Proxy/SBC جلوی چند Asterisk
بهجای اینکه Endpointها مستقیماً به Asterisk وصل شوند، Kamailio/OpenSIPS/SBC در لایه Edge قرار میگیرد و Health Check انجام میدهد.
Phones / Provider
        |
        v
   SIP Proxy / SBC
     /         \
    v           v
Asterisk-A   Asterisk-B
   ACTIVE      STANDBY
   or both in controlled pools
مزیت این معماری این است که Registration، Routing و Provider Edge از PBX Media Node جدا میشود. در نتیجه میتوانید Asterisk را Maintenance کنید یا Backend را عوض کنید بدون اینکه Endpointها IP سرور جدیدی یاد بگیرند.
اما اگر تماس جاری روی Asterisk-A و RTP آن Anchor شده باشد، Down شدن همان Backend باز هم تماس را قطع میکند؛ مگر اینکه Application/Media Architecture شما بهطور خاص Session Continuity را طراحی کرده باشد.
فایلهای ضبط مکالمه؛ بخش فراموششده HA
MixMonitor() فایل ضبط را روی Path تعیینشده مینویسد و اگر Path مطلق ندهید، از Monitoring Directory تنظیمشده در Asterisk استفاده میکند. یعنی در حالت پیشفرض Recording روی Disk همان نود است.
اگر PBX-01 Down شود و PBX-02 Active شود:
PBX-01:
/var/spool/asterisk/monitor/call-001.wav

PBX-02:
file does not existراهحلهای رایج:
🔹 Shared HA Storage.
🔹 NFS فقط در صورتی که خود NFS نیز HA باشد.
🔹 Object Storage و Upload پس از پایان ضبط.
🔹 Async Replication با پذیرش RPO مشخص.
اشتباه رایج: اگر هر دو Asterisk به یک NFS تکسروره وصل باشند، فقط Single Point of Failure را از PBX به NFS منتقل کردهاید.
تماس جاری هنگام Down شدن Active Node دقیقاً چه میشود؟
این سناریو را صریح طراحی کنید:
Caller ---- SIP/RTP ---- Asterisk-A ---- SIP/RTP ---- Callee
                            |
                            X power failure

Asterisk-B becomes active
نود B اطلاعات کامل Dialog، RTP Socket، Sequence State، Bridge State و Application Execution نود A را بهصورت پیشفرض در اختیار ندارد. بنابراین تماس جاری معمولاً قطع میشود.
بعد از Failover، نود B برای تماسهای جدید آماده میشود. HA را با «Live Call Migration» اشتباه نگیرید.
Failover باید بر اساس Health واقعی باشد، نه فقط ping
اگر فقط Ping نود را مانیتور کنید، ممکن است سرور Alive باشد اما Asterisk Hang کرده باشد یا SIP Socket کار نکند.
Health Check خوب چند لایه است:
🔹 OS/Node reachable است.
🔹 Process Asterisk Running است.
🔹 CLI پاسخ میدهد.
🔹 SIP Port Bind شده است.
🔹 DB Connection سالم است.
🔹 Storage قابل Write است.
🔹 در سناریوهای حساس، Synthetic SIP OPTIONS یا Test Call اجرا میشود.
یک Health Check بسیار ساده:
asterisk -rx "core show uptime"
asterisk -rx "pjsip show endpoints"
asterisk -rx "odbc show"اینها فقط اجزای Test هستند؛ Cluster باید Health Agent قابلاعتماد خودش را داشته باشد.
Config دو نود باید واقعاً یکسان بماند
اگر Config فایلمحور دارید، تغییر روی PBX-01 باید به PBX-02 هم برسد. روشها:
🔹 Git + Deployment Pipeline.
🔹 Ansible.
🔹 Shared Realtime Database برای بخشهای مناسب.
🔹 Configuration Management استاندارد.
کپی دستی فایلها در Production HA دیر یا زود باعث Drift میشود.
Active/Passive یا Active/Active؟
| ویژگی | Active/Passive | Active/Active |
|---|---|---|
| پیچیدگی | کمتر | بیشتر |
| Failover IP | معمولاً ساده | اغلب Proxy/Load Balancer |
| Registration State | قابلکنترلتر | نیازمند طراحی Registrar/DB |
| ظرفیت | Standby بلااستفاده | هر دو میتوانند Load بگیرند |
| Split Brain | باید جدی کنترل شود | طراحی پیچیدهتر |
| مناسب برای | PBX سازمانی معمول | پلتفرم بزرگ چندنودی |
برای بیشتر تیمهایی که اولین HA Asterisk را میسازند، Active/Passive انتخاب منطقیتر است. Active/Active زمانی ارزش دارد که Registration/Routing/Media و دیتابیس از ابتدا برای چند Backend طراحی شده باشند.
یک معماری پیشنهادی Production
                     SIP Provider
                          |
                          v
                 Public SBC / VIP
                          |
                 +--------+--------+
                 |                 |
                 v                 v
            Asterisk-A         Asterisk-B
             ACTIVE             PASSIVE
                 |                 |
                 +--------+--------+
                          |
                     DB HA Layer
                 MariaDB / Proxy
                          |
                     HA Storage
                  recordings / VM
اگر معماری کوچکتر است، SBC جدا ممکن است لازم نباشد و VIP مستقیماً روی دو Asterisk باشد. اما اگر چند Provider، چند Site یا تعداد زیاد Endpoint دارید، جداکردن Edge SIP از PBX Backend مزیت بزرگی دارد.
برای Asterisk یک معماری Active/Passive یا چندنودی میخواهید؟
اگر تعداد داخلیها، Trunkها، میزان تماس همزمان، RTO/RPO و محل ذخیره Recordings مشخص باشد، میتوان معماری مناسب را بین VIP، SBC، Database HA و Shared Storage انتخاب کرد.
ایرانیکاسرور میتواند زیرساخت VPS، شبکه خصوصی، IP عمومی و سرویسهای لازم برای پیادهسازی Asterisk High Availability را فراهم کند.
تماس با پشتیبانی ایرانیکاسرور: 021-91302467
سناریوهای Failure که حتماً باید تست شوند
| تست | انتظار |
|---|---|
| Stop کردن Asterisk | Failover سرویس بدون Reboot Node |
| خاموش کردن Active Node | Fencing و انتقال Resource |
| قطع Network Cluster | عدم Active شدن همزمان دو نود |
| قطع DB Primary | DB Failover بدون از دسترفتن Config/CDR فراتر از RPO |
| قطع Storage | رفتار Fail-safe و عدم Corruption |
| برگشت نود قدیمی | عدم Preempt ناخواسته یا Split Brain |
| تماس در حین Failover | ثبت رفتار واقعی Call Drop |
| Re-registration Endpointها | اندازهگیری زمان برگشت سرویس |
اشتباههای رایج در HA Asterisk
🔹 نصب Asterisk روی دو VPS و تصور اینکه HA ساخته شده است.
🔹 Shared Storage بدون HA.
🔹 دو نود بدون Fencing واقعی.
🔹 Replicate کردن DB ولی فراموشکردن Recordings.
🔹 اعتماد کامل به DNS Failover بدون تست Clientها.
🔹 Health Check فقط با Ping.
🔹 انتظار حفظ تماس جاری بعد از Crash PBX.
🔹 Sync دستی Configها.
🔹 نداشتن Runbook برای Failback.
پرسشهای رایج
اگر Asterisk اصلی Down شود تماس در حال مکالمه ادامه پیدا میکند؟
معمولاً خیر. Session، Bridge و RTP State بهصورت پیشفرض به Standby منتقل نمیشوند و تماس جاری قطع میشود. HA بیشتر برای بازیابی سریع تماسهای جدید است.
Floating IP برای HA کافی است؟
خیر. VIP فقط Entry Point را ثابت میکند. Config، Database، Registration، Recording، Health Check و Fencing هم باید طراحی شوند.
Split Brain در Asterisk HA چیست؟
حالتی است که دو نود ارتباطشان را از دست میدهند و هر دو خودشان را Active میدانند. نتیجه میتواند Duplicate IP، SIP Responseهای متناقض و Corruption داده باشد. Fencing برای جلوگیری از این وضعیت حیاتی است.
Corosync خود Asterisk را High Available میکند؟
نه بهتنهایی. Asterisk با res_corosync میتواند بعضی Eventها مثل Device State و MWI را بین Nodeها Share کند؛ Service Failover کامل نیاز به Cluster Manager و طراحی منابع دارد.
DNS SRV میتواند جای Floating IP را بگیرد؟
در بعضی معماریها بله، اما رفتار Clientها، TTL و DNS Cache باید تست شود. DNS Failover نیز تماس جاری را حفظ نمیکند.
Recordings را چطور بین دو PBX نگه داریم؟
از Shared HA Storage، Object Storage یا Replication با RPO مشخص استفاده کنید. فایل MixMonitor روی Disk محلی Node دیگر خودکار ظاهر نمیشود.
برای MariaDB دو Node کافی است؟
برای Galera بهتر است Quorum با سه عضو یا رأی سوم طراحی شود. MariaDB برای دو Data Node استفاده از Galera Arbitrator را بهعنوان یکی از الگوها مستند کرده است.
Active/Passive بهتر است یا Active/Active؟
برای بیشتر PBXهای سازمانی Active/Passive سادهتر و قابلپیشبینیتر است. Active/Active برای پلتفرمهای بزرگ ارزش دارد، اما Registrar، Routing، Database و Media باید از ابتدا چندنودی طراحی شوند.
جمعبندی
Asterisk High Availability یعنی سرویس بعد از خرابی سریع برگردد، نه اینکه تماس جاری بدون وقفه از یک Process به Process دیگر مهاجرت کند.
برای یک طراحی Active/Passive واقعی حداقل به دو Asterisk، Cluster Manager، Service IP یا Edge ثابت، Fencing، دیتابیس مناسب و راهکار HA برای Recordingها نیاز دارید.
اگر مقیاس بزرگتر است، SIP Proxy/SBC را از PBX Backend جدا کنید. DNS SRV میتواند بخشی از Failover را انجام دهد، اما رفتار Client و Cache باید آزمایش شود.
مهمتر از همه، Failure را عمداً ایجاد کنید: Asterisk را Kill کنید، Node را خاموش کنید، لینک Cluster را قطع کنید و ببینید سیستم واقعاً چه میکند. HAای که فقط روی Diagram کار میکند، HA نیست.
برای طراحی Asterisk High Availability کمک میخواهید؟
با مشخصبودن تعداد داخلیها، تماس همزمان، دیتابیس، Storage و RTO/RPO میتوان تعیین کرد Active/Passive با VIP کافی است یا باید SBC، Database Cluster و Storage HA هم اضافه شوند.
تماس با پشتیبانی ایرانیکاسرور: 021-91302467
دیدگاهها (۰)