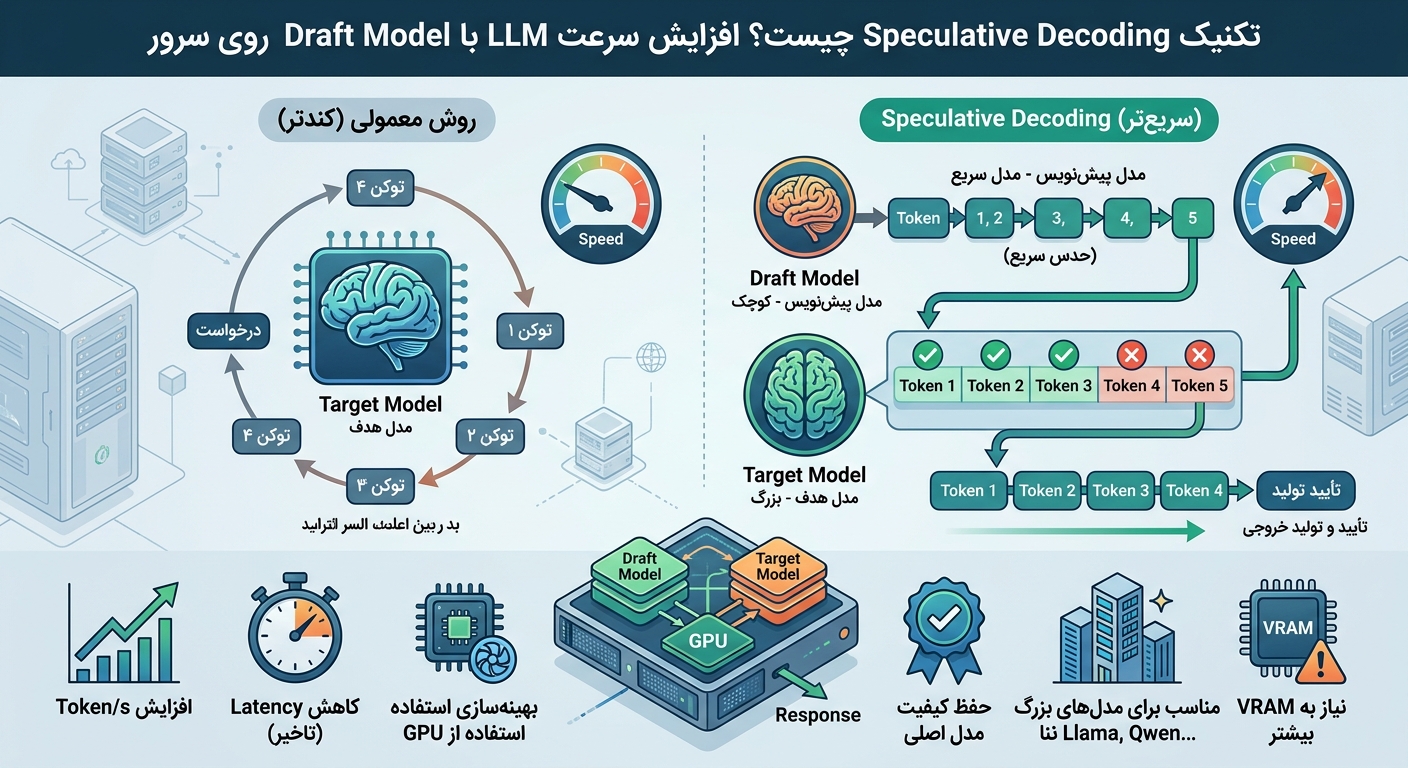
آموزشی 📅 8 مهر 1405 Speculative Decoding چیست؟ راهنمای عملی افزایش سرعت LLM روی سرور GPU اگر روی سرور خود یک مدل زبانی بزرگ مثل Llama 70B یا Qwen 32B اجرا میکنید، احتمالاً با این مشکل...