
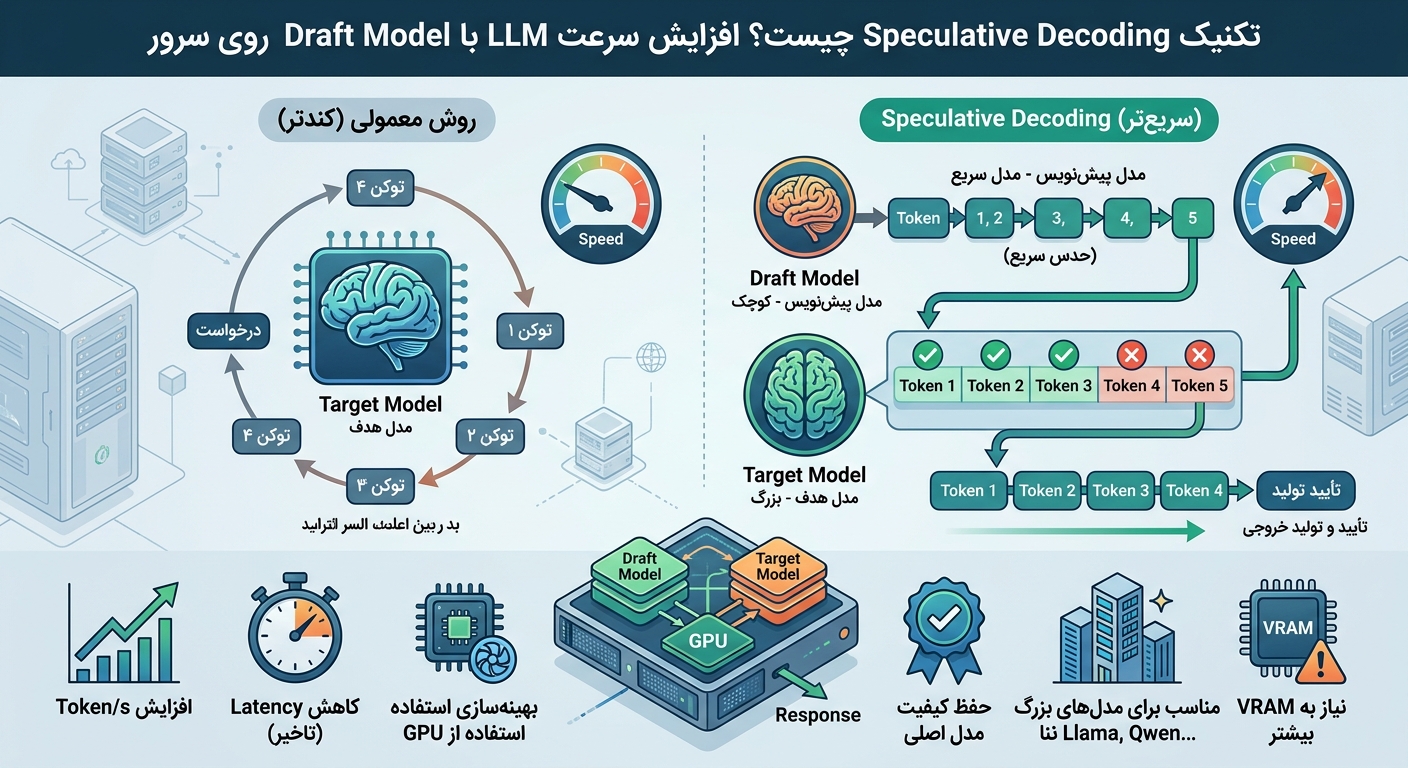
در این مقاله یک تکنیک بهینهسازی مهم به نام Speculative Decoding را بررسی میکنیم؛ روشی که بدون تغییر مدل اصلی، میتواند سرعت Inference را بهطور محسوسی افزایش دهد. سپس یاد میگیرید چگونه آن را روی سرور GPU خود اجرا کنید و منابع مورد نیاز را درست تخمین بزنید.
📌 آنچه در این راهنما میخوانید:
🔹 Speculative Decoding چیست و چرا سرعت را بالا میبرد
🔹 Draft Model و Target Model چه نقشی دارند
🔹 Acceptance Rate چیست و چگونه روی سرعت اثر میگذارد
🔹 محاسبه VRAM مورد نیاز برای اجرای همزمان دو مدل
🔹 فعالسازی Speculative Decoding در vLLM
🔹 جدول مقایسه و نکات انتخاب Draft Model مناسب
Speculative Decoding دقیقاً چیست؟
در حالت معمول، یک LLM برای تولید هر Token باید یک Forward Pass کامل انجام دهد. چون هر Token به Token قبلی وابسته است، این فرآیند قابل موازیسازی نیست و Latency بالا میرود.
Speculative Decoding یک ایده ساده اما مؤثر دارد: یک مدل کوچک و سریع چند Token آینده را حدس میزند، سپس مدل بزرگ آن حدسها را در یک مرحله موازی بررسی و تأیید میکند. اگر حدسها درست باشند، چند Token با هزینه محاسباتی یک Token تولید میشوند[citation:6].
مهمترین ویژگی این تکنیک این است که خروجی نهایی دقیقاً با توزیع مدل اصلی مطابقت دارد — یعنی کیفیت پایین نمیآید. این یک تضمین ریاضی است، نه یک تقریب[citation:6].
روش معمولی (Autoregressive):
Prompt → Target Model → Token 1 → Target Model → Token 2 → Target Model → Token 3

Speculative Decoding:
Prompt → Draft Model → [Token 1, 2, 3, 4] → Target Model → Verification → Accepted Tokens
Draft Model و Target Model: دو بازیگر اصلی
Draft Model چیست؟
Draft Model یک نسخه کوچکتر از مدل زبانی است که وظیفهاش تولید سریع چند Token پیشنهادی است. مثلاً اگر Target Model شما Qwen 32B باشد، میتوانید از Qwen 1.5B به عنوان Draft استفاده کنید.
Draft Model قرار نیست پاسخ نهایی را بسازد. فقط باید رفتار Target را حدس بزند و این کار را سریع انجام دهد[citation:2].
Target Model چیست؟
Target Model همان مدل اصلی و بزرگ است که کیفیت نهایی خروجی به آن وابسته است. Target Model همچنان مرجع اصلی تأیید است و Speculative Decoding آن را حذف نمیکند؛ فقط تعداد دفعات اجرای آن را کاهش میدهد[citation:6].
⚠️ نکته مهم: Draft و Target باید از نظر Tokenizer و Vocabulary سازگار باشند. اگر Tokenizerها متفاوت باشند، فرآیند تأیید پیچیده و کند میشود. خوشبختانه vLLM از قابلیت use_heterogeneous_vocab پشتیبانی میکند که امکان استفاده از مدلهایی با Tokenizer متفاوت را فراهم میکند[citation:2].
Acceptance Rate: قلب سرعت Speculative Decoding
Acceptance Rate نشان میدهد چند درصد از Tokenهای پیشنهادی Draft Model توسط Target Model پذیرفته میشوند. هرچه این نرخ بالاتر باشد، سرعت بیشتر میشود.
فرمول تجربی سرعت تقریبی این است:
Speedup ≈ 1 / (1 - α)
که در آن α نرخ پذیرش است. مثلاً اگر α = 0.8 باشد، سرعت تقریباً ۵ برابر میشود. اگر α = 0.5 باشد، سرعت ۲ برابر خواهد بود[citation:6].
البته این یک تخمین ساده است. در عمل، هزینه اجرای Draft Model و سربارههای سیستم هم اثر میگذارند. Draft Model باید آنقدر سریع باشد که هزینه حدس زدن، از صرفهجویی تأیید بیشتر نباشد.
جدول مقایسه: Speculative Decoding با سایر روشهای بهینهسازی
| ویژگی | Speculative Decoding | Quantization | Distillation |
|---|---|---|---|
| هدف اصلی | کاهش تعداد Forward Pass | کاهش دقت عددی و حافظه | آموزش مدل کوچکتر |
| تغییر کیفیت | ✅ بدون تغییر (Exact) | ⚠️ ممکن است تغییر کند | ⚠️ نیاز به ارزیابی |
| نیاز به آموزش | ❌ خیر (Draft آماده) | ❌ خیر (Post-training) | ✅ بله |
| مصرف VRAM اضافه | ✅ بله (Draft Model) | ❌ کاهش مییابد | ❌ مدل جداگانه |
| امکان ترکیب | ✅ هر سه را میتوان همزمان استفاده کرد | ||
محاسبه VRAM مورد نیاز برای Speculative Decoding
یکی از اشتباهات رایج این است که تصور شود فقط باید VRAM مدل اصلی و Draft را جمع کرد. اما واقعیت این است که KV Cache و Runtime Overhead هم بخش قابل توجهی از حافظه را اشغال میکنند.
VRAM Total = Target Model Weights
           + Draft Model Weights
           + KV Cache (Context Length × Batch Size)
           + Runtime Overhead (CUDA, cuBLAS, etc.)
           + Temporary Buffers
به عنوان مثال، اگر Target Model حدود 40GB VRAM و Draft Model حدود 4GB مصرف کند:
🔹 حداقل تئوری: 44GB
🔹 واقعی با KV Cache و Overhead: معمولاً 48 تا 52GB بسته به Context Length
🔹 توصیه: GPU با حداقل 80GB VRAM مثل A100 یا H100 برای مدلهای بزرگ
بر اساس دادههای عملی، Draft Model نباید بیش از 15 درصد از کل VRAM موجود را اشغال کند[citation:10]. اگر بیش از این باشد، احتمال Out of Memory یا کاهش سرعت به دلیل Spill شدن به CPU وجود دارد.
راهاندازی Speculative Decoding در vLLM
vLLM یکی از محبوبترین Runtimeهای Inference است که از Speculative Decoding پشتیبانی میکند. تنظیمات از طریق –speculative-config انجام میشود[citation:2].
حالت آفلاین (Python API)
from vllm import LLM, SamplingParams

llm = LLM(
    model="Qwen/Qwen3-8B",
    speculative_config={
        "method": "draft_model",
        "model": "Qwen/Qwen2.5-0.5B-Instruct",
        "num_speculative_tokens": 5,
    },
    gpu_memory_utilization=0.85,
)

outputs = llm.generate(prompts, sampling_params)
حالت آنلاین (Server)
vllm serve Qwen/Qwen3-8B \
    --speculative-config '{"method": "draft_model", "model": "Qwen/Qwen2.5-0.5B-Instruct", "num_speculative_tokens": 5}' \
    --gpu-memory-utilization 0.85
پارامتر num_speculative_tokens تعداد Tokenهایی است که Draft Model در هر مرحله پیشنهاد میدهد. مقادیر بین 3 تا 8 معمولاً بهترین تعادل بین سرعت و نرخ پذیرش را میدهند[citation:3].
⚠️ هشدار: اگر Draft Model بسیار ضعیف باشد یا Acceptance Rate پایین بیاید، Speculative Decoding میتواند کندتر از حالت عادی شود. حتماً قبل و بعد از فعالسازی Benchmark بگیرید.
⚡ زیرساخت GPU مناسب برای Speculative Decoding
اگر قصد دارید Speculative Decoding را روی سرور خود اجرا کنید، به GPU با VRAM کافی و Memory Bandwidth بالا نیاز دارید. ایرانیکاسرور سرورهای مجازی با پشتیبانی از GPUهای حرفهای و منابع اختصاصی CPU/RAM ارائه میدهد — مناسب برای اجرای همزمان Target و Draft Model بدون نگرانی از کمبود منابع.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
انتخاب Draft Model مناسب: چه معیارهایی مهم است؟
انتخاب Draft Model صرفاً به «کوچک بودن» خلاصه نمیشود. یک Draft Model خوب باید:
🔹 سریع باشد — اگر Draft Model کند باشد، مزیت کل روش از بین میرود
🔹 رفتار مشابه Target داشته باشد — هرچه توزیع احتمالاتی Draft به Target نزدیکتر باشد، Acceptance Rate بالاتر میرود
🔹 Tokenizer سازگار داشته باشد — مگر اینکه از قابلیت heterogeneous vocab استفاده کنید
🔹 کمترین مصرف VRAM را داشته باشد — حداکثر 15 درصد کل VRAM[citation:10]
آیا مدل خیلی کوچک همیشه بهتر است؟
خیر. یک Draft Model خیلی کوچک (مثل 0.5B) سریع است اما ممکن است Acceptance Rate پایینی داشته باشد. یک Draft Model بزرگتر (مثل 3B) پیشنهادهای دقیقتری میدهد اما کندتر اجرا میشود. بهترین گزینه معمولاً Draft از همان خانواده Target با اندازه 1/20 تا 1/10 است[citation:2][citation:9].
مشکلات رایج و راهحلها
🔹 مشکل: Acceptance Rate پایین است
Draft Model را با Target سازگارتر کنید. از همان خانواده مدل استفاده کنید یا Draft را روی دادههای دامنه خود Fine-tune کنید.
🔹 مشکل: VRAM کافی نیست
Draft Model را کوچکتر کنید، از Quantization استفاده کنید یا GPU با VRAM بیشتر انتخاب کنید.
🔹 مشکل: سرعت حتی کاهش یافته
Draft Model بیش از حد کند است یا Overhead سیستم بالاست. تعداد num_speculative_tokens را کاهش دهید و Benchmark دقیق بگیرید.
آیا Speculative Decoding برای سرور شما ارزش دارد؟
این تکنیک در شرایط زیر بیشترین سود را دارد:
🔹 Target Model بزرگ (بالای 13B پارامتر) باشد
🔹 Latency برای شما اهمیت داشته باشد
🔹 پاسخهای تولیدی طولانی باشند (نه فقط چند Token)
🔹 GPU شما VRAM اضافی برای Draft Model داشته باشد
🔹 Draft Model سازگاری در دسترس باشد
در مقابل، اگر مدل شما کوچک است (مثل 7B)، پاسخها کوتاه هستند یا VRAM محدودی دارید، ممکن است سود چندانی از این تکنیک نبرید.
جمعبندی
Speculative Decoding یک تکنیک Exact است: یک Draft Model کوچک چند Token را حدس میزند و Target Model آنها را در یک مرحله موازی تأیید میکند. اگر Acceptance Rate بالا باشد، سرعت تولید Token چند برابر میشود بدون هیچ کاهشی در کیفیت خروجی.
برای اجرای آن به VRAM اضافی نیاز دارید (معمولاً 10-15 درصد بیشتر از مدل اصلی). vLLM از این قابلیت پشتیبانی میکند و با یک کانفیگ ساده میتوانید آن را فعال کنید. حتماً قبل از استقرار نهایی، روی Workload واقعی خود Benchmark بگیرید.
🛠 نیاز به راهنمایی برای کانفیگ دارید؟
اگر مطمئن نیستید چه GPU یا چه Draft Model برای Workload شما مناسب است، تیم فنی ایرانیکاسرور میتواند بر اساس مدل، حجم کاربران و بودجه شما، بهترین کانفیگ سرور را پیشنهاد دهد.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.