آموزشی 📅 9 مهر 1405 آموزش نصب ComfyUI روی سرور GPU؛ ساخت خط تولید تصویر هوش مصنوعی با Linux، مدلهای AI و Workflow اگر تولید تصویر با هوش مصنوعی را از کامپیوتر شخصی به یک سرور قدرتمند منتقل کنید، ComfyUI میتواند به یک...
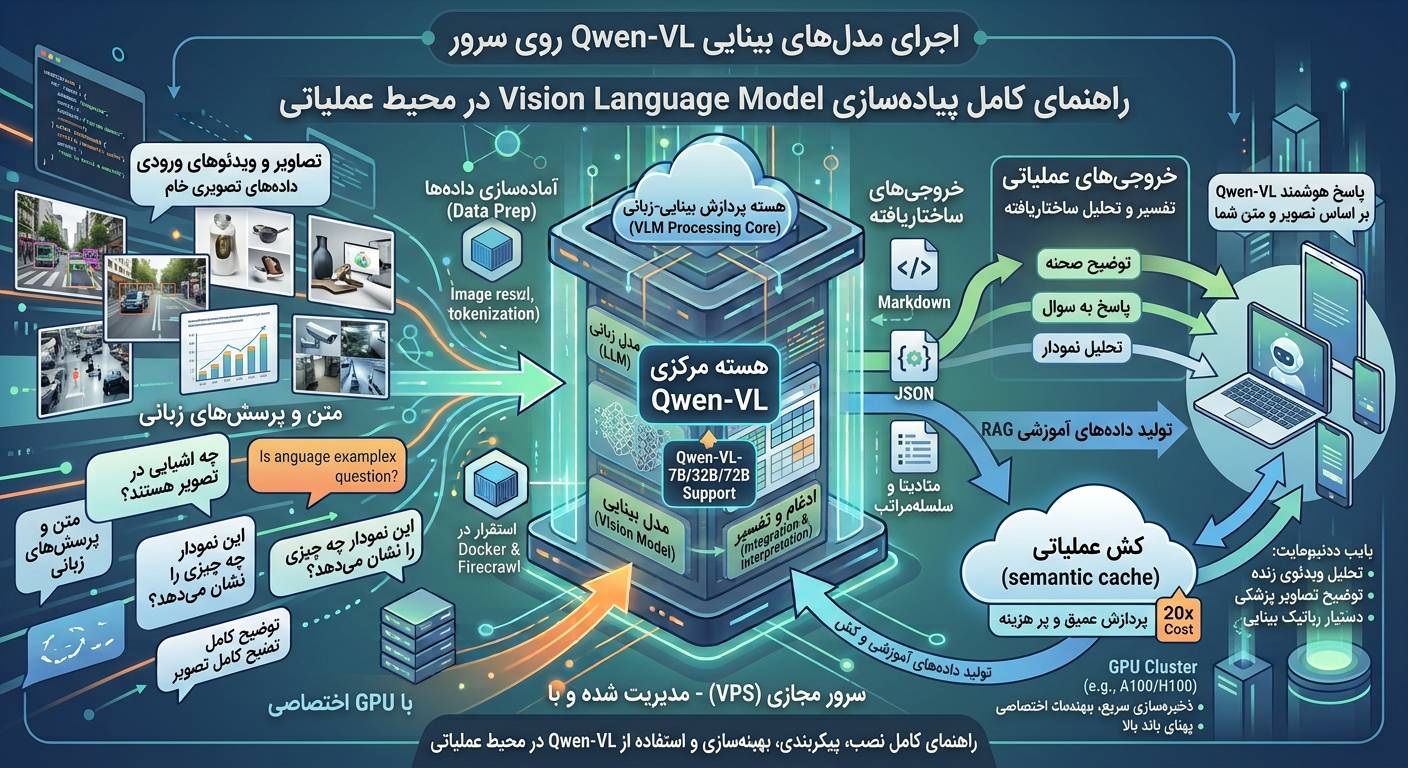
آموزشی 📅 9 مهر 1405 اجرای مدلهای بینایی Qwen-VL روی سرور: راهنمای کامل پیادهسازی Vision Language Model در محیط عملیاتی تا چند سال پیش، تصور اینکه یک ماشین بتواند تصویر ببیند، متن داخل آن را بخواند و دربارهاش استدلال کند،...
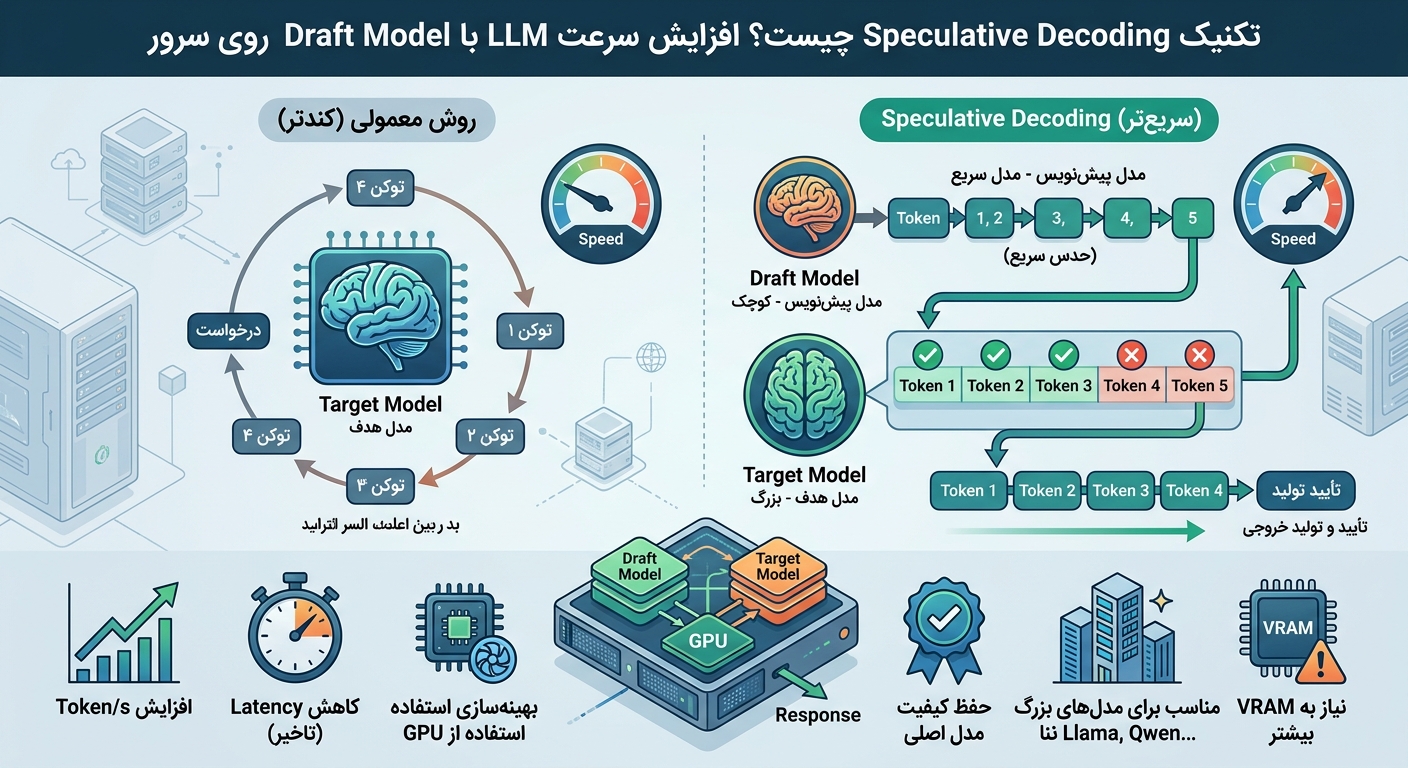
آموزشی 📅 8 مهر 1405 Speculative Decoding چیست؟ راهنمای عملی افزایش سرعت LLM روی سرور GPU اگر روی سرور خود یک مدل زبانی بزرگ مثل Llama 70B یا Qwen 32B اجرا میکنید، احتمالاً با این مشکل...
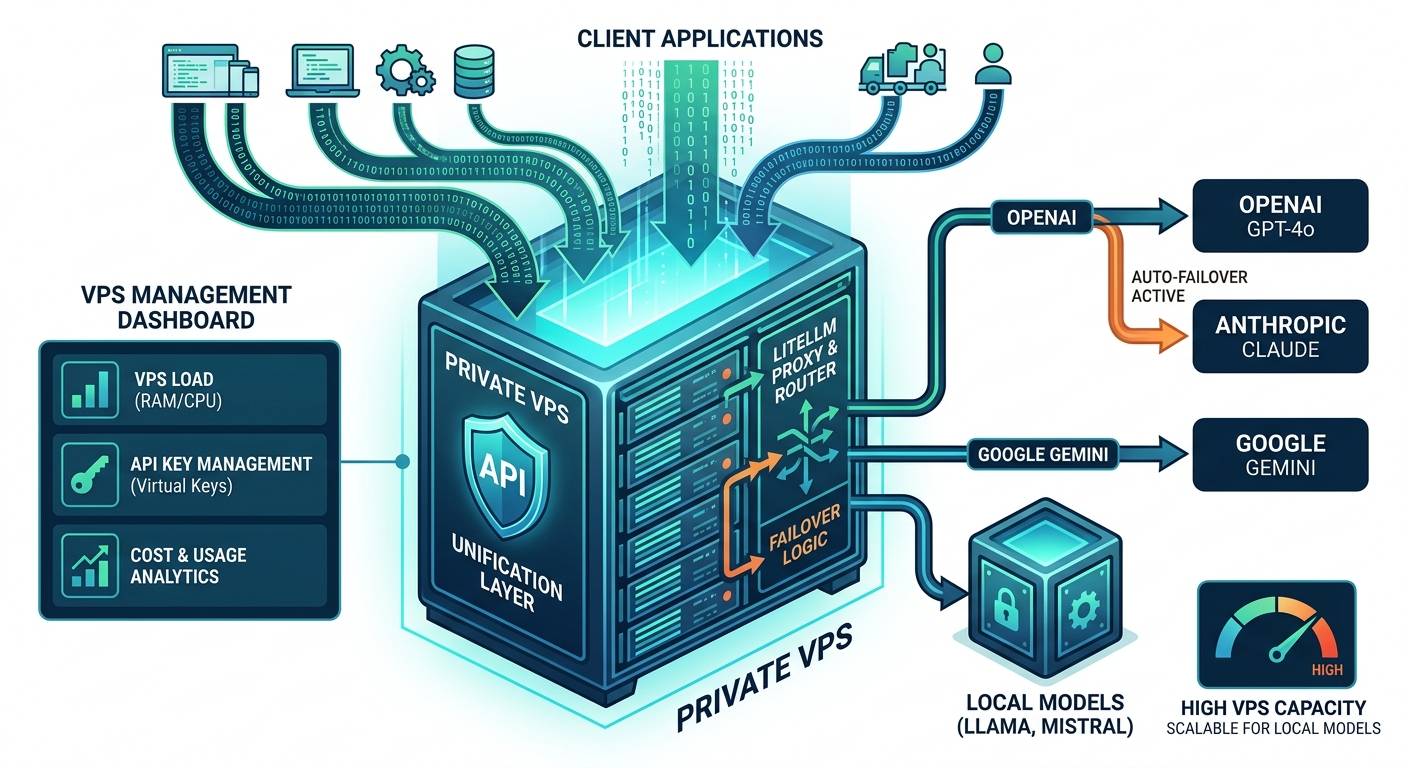
آموزشی 📅 6 مهر 1405 راهاندازی AI Gateway روی VPS؛ چگونه چند مدل هوش مصنوعی را از یک API مدیریت کنیم؟ اگر برای پروژههای مختلف از چند سرویس هوش مصنوعی استفاده میکنید، حتماً این درد را تجربه کردهاید: کلید API برای...
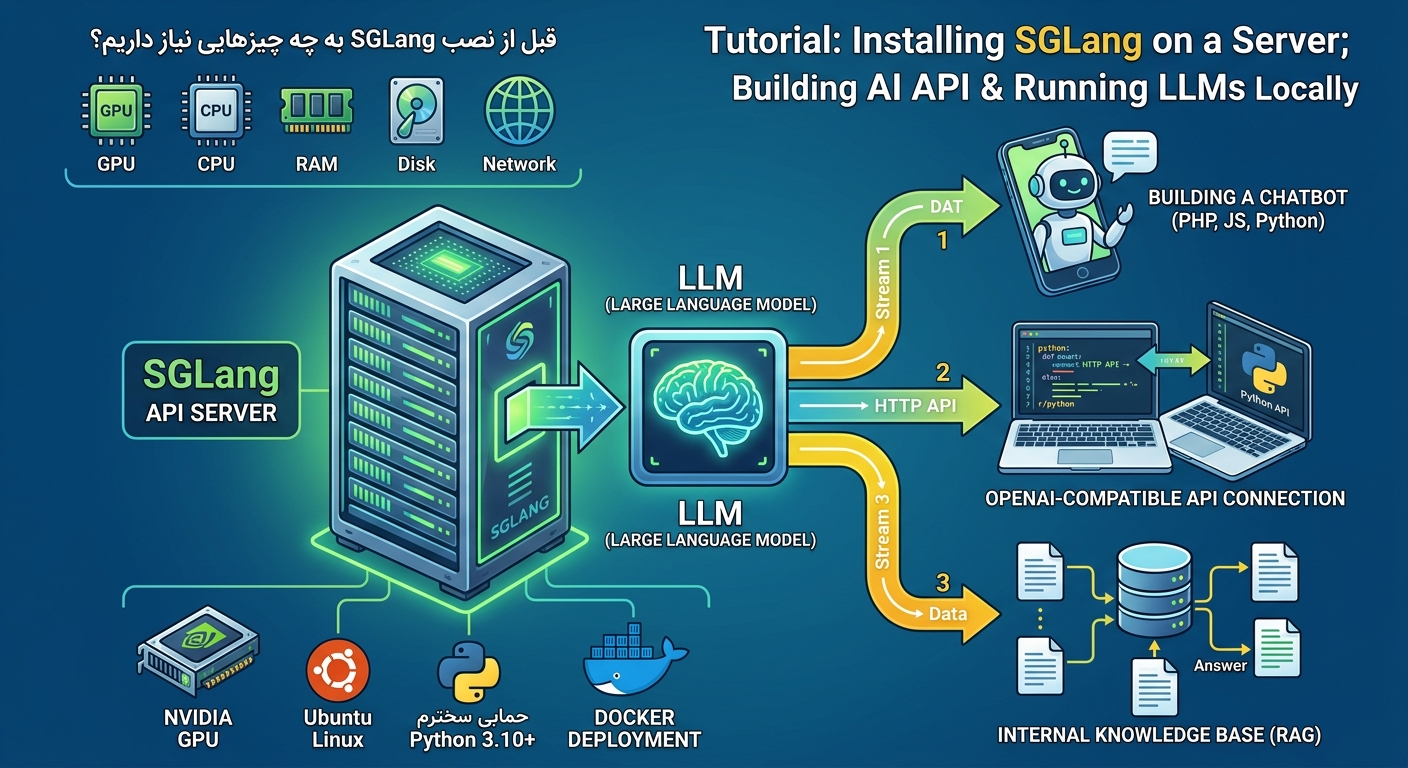
آموزشی 📅 6 مهر 1405 آموزش راهاندازی و اجرای SGLang روی سرور مجازی؛ ساخت API هوش مصنوعی اختصاصی اگر بهدنبال راهی برای اجرای مدلهای زبانی بزرگ (LLM) روی زیرساخت شخصی خودتان هستید و میخواهید یک API مشابه سرویسهای...
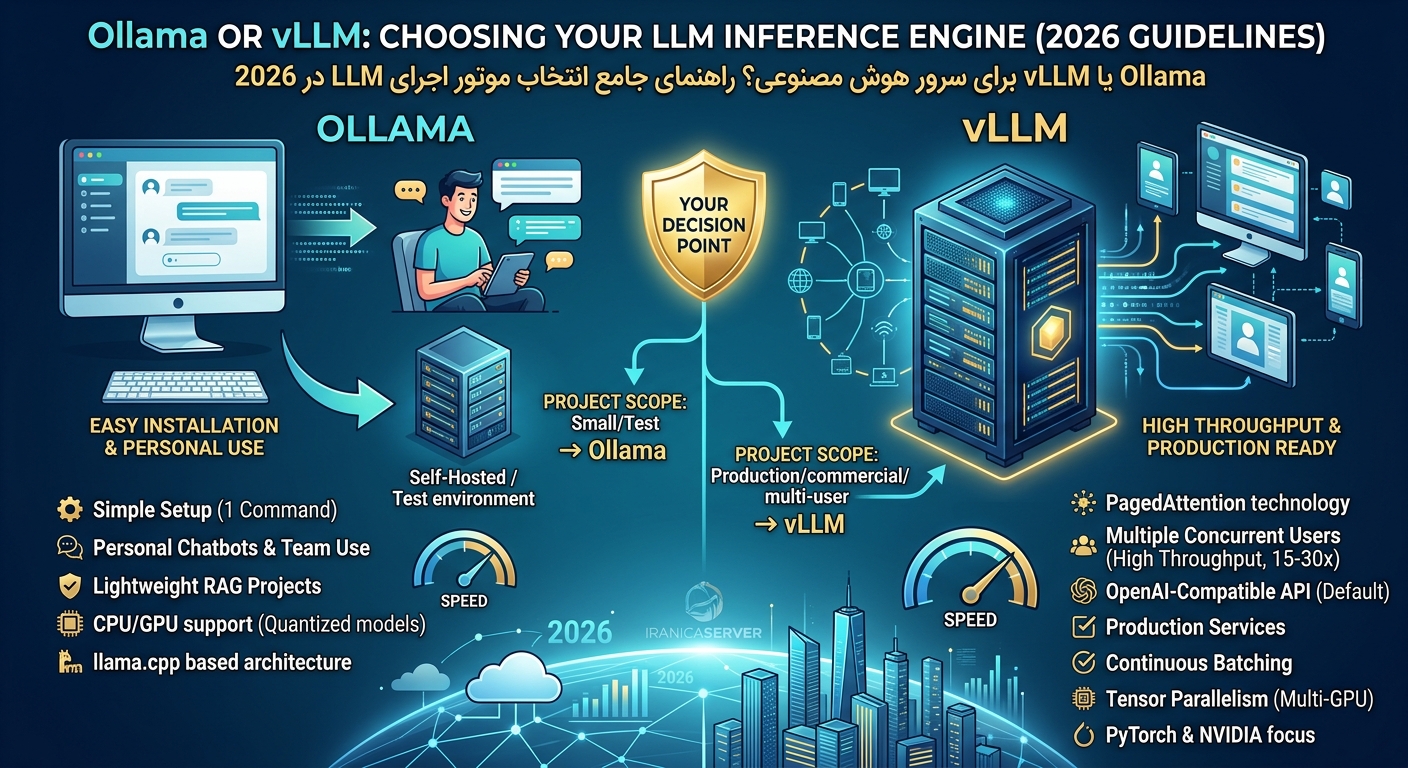
آموزشی 📅 5 مهر 1405 Ollama یا vLLM برای سرور هوش مصنوعی؟ راهنمای جامع انتخاب موتور اجرای LLM در 2026 اگر قصد راهاندازی سرور هوش مصنوعی شخصی یا سرویس API مبتنی بر LLM دارید، احتمالاً با دو نام آشنا روبرو...
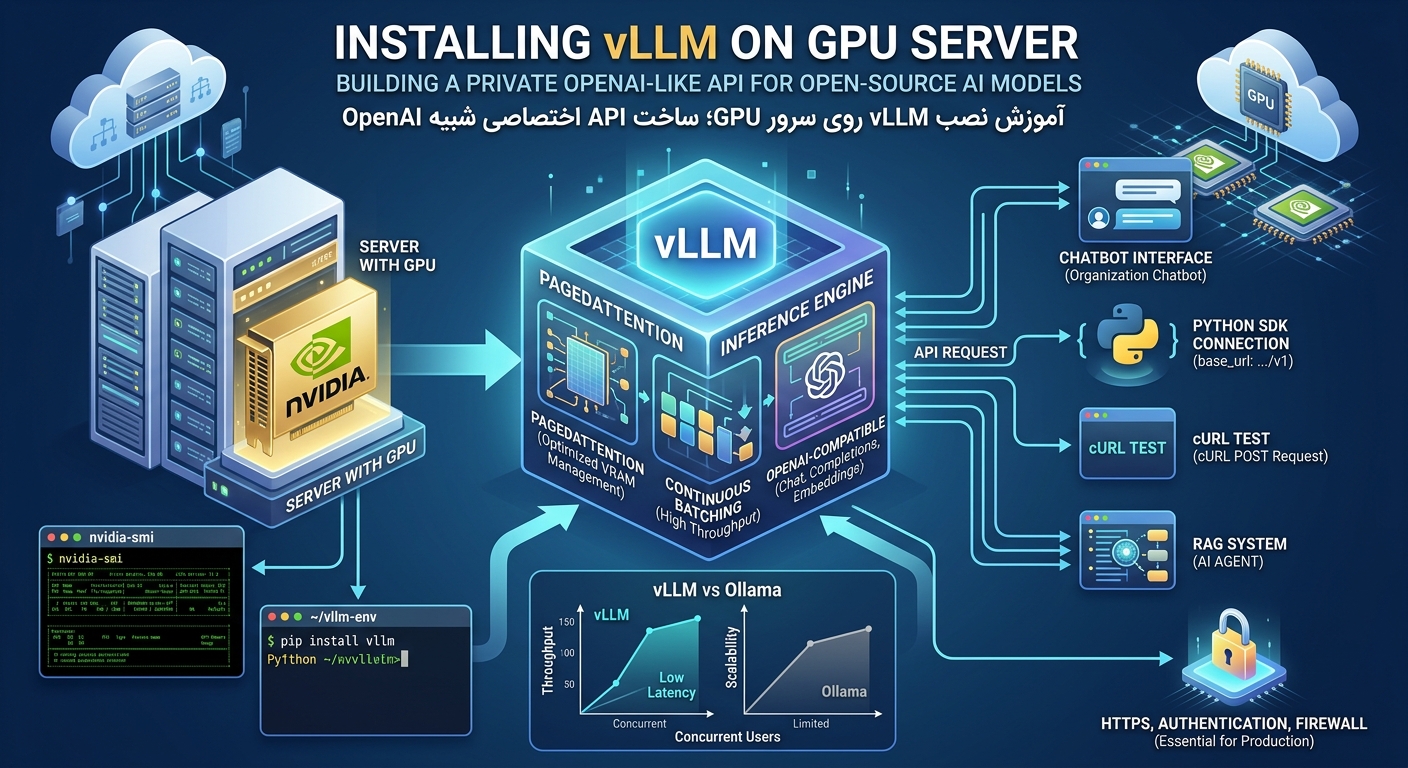
آموزشی 📅 5 مهر 1405 آموزش نصب vLLM روی سرور GPU؛ ساخت API اختصاصی شبیه OpenAI برای مدلهای هوش مصنوعی متنباز اگر قصد دارید یک مدل زبانی بزرگ متنباز را روی سرور خودتان اجرا کنید و بهجای وابستگی به APIهای خارجی،...