
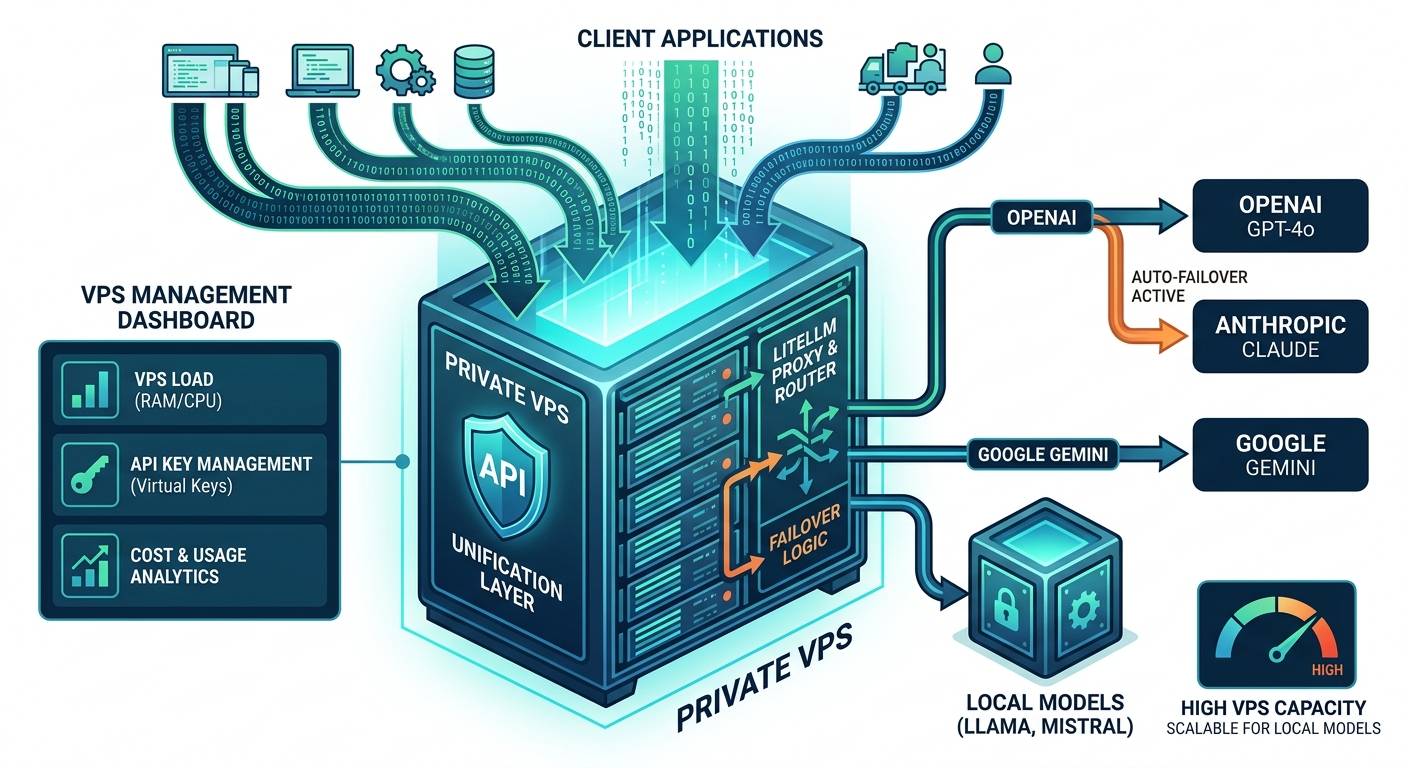
اگر برای پروژههای مختلف از چند سرویس هوش مصنوعی استفاده میکنید، حتماً این درد را تجربه کردهاید: کلید API برای OpenAI، یکی برای Claude، یکی برای Gemini و شاید یک مدل لوکال روی سرور دیگر. مدیریت این کلیدها، هزینهها، محدودیت نرخ درخواست و امنیت آنها بهسرعت تبدیل به یک کابوس میشود.
راهحل این مشکل یک مفهوم ساده اما قدرتمند است: AI Gateway. یک لایه واسط که همه درخواستهای هوش مصنوعی شما را دریافت میکند و آنها را به مدل مناسب میفرستد؛ بدون اینکه برنامههای شما بدانند پشت صحنه چه خبر است.
در این راهنما، به شما نشان میدهم چطور با LiteLLM یک AI Gateway اختصاصی روی VPS ایرانیکاسرور راهاندازی کنید، چند مدل را پشت یک API واحد قرار دهید و از مزایای امنیتی و کنترلی آن بهره ببرید.
📌 در این مقاله میآموزید:
🔹 AI Gateway چیست و چرا به آن نیاز دارید
🔹 چرا اجرای آن روی VPS اختصاصی بهتر از سرویسهای ابری است
🔹 راهاندازی گامبهگام LiteLLM با Docker روی VPS
🔹 اتصال OpenAI، Claude، Gemini و مدلهای لوکال به یک API واحد
🔹 مدیریت کاربران، کلیدها و بودجه از طریق Virtual Keys
🔹 رفع خطاهای رایج و نکات امنیتی برای محیط Production
AI Gateway چیست و چه کاری انجام میدهد؟
AI Gateway یک سرویس واسط است که بین اپلیکیشنهای شما و سرویسهای هوش مصنوعی قرار میگیرد. بهجای اینکه هر پروژه مستقیماً به OpenAI، Claude یا هر سرویس دیگری وصل شود، همه درخواستها ابتدا به Gateway میروند. Gateway تصمیم میگیرد کدام مدل مناسب است، درخواست را به آن میفرستد و پاسخ را برمیگرداند.
ساختار ساده آن به این صورت است:
Application / Chatbot / CRM
         |
         v
    AI Gateway (LiteLLM)
         |
   ------+------
   |      |      |
 OpenAI  Claude  Local LLM
 GPT-4   Sonnet  Llama
نکته کلیدی اینجاست: برنامه شما فقط با یک API صحبت میکند. نیازی نیست بدانید پشت صحنه از GPT-4 استفاده میشود یا Claude یا یک مدل لوکال. اگر فردا تصمیم بگیرید مدل را عوض کنید، فقط تنظیمات Gateway را تغییر میدهید؛ نه یک خط کد در اپلیکیشن.
چرا AI Gateway را روی VPS ایرانیکاسرور اجرا کنید؟
سرویسهای ابری متعددی AI Gateway ارائه میدهند، اما برای تیمهای توسعه و کسبوکارهایی که با دادههای حساس کار میکنند، اجرای نسخه اختصاصی روی VPS مزایای غیرقابلانکاری دارد:
۱. کنترل کامل روی دادهها
اسناد داخلی، اطلاعات مشتریان و کدهای نرمافزاری شما دیگر از زیرساخت شرکت خارج نمیشوند. Gateway روی VPS خودتان اجرا میشود و شما مسیر داده را کنترل میکنید.
۲. مدیریت متمرکز چندین مدل
همه پروژهها فقط یک Endpoint میشناسند. تغییر مدل پشت صحنه، نیازی به تغییر کد اپلیکیشن ندارد.
۳. کاهش هوشمندانه هزینهها
سوالات ساده را به مدل ارزانتر بفرستید و درخواستهای پیچیده را به مدل قدرتمندتر. این یعنی پرداخت هزینه کمتر برای همان کیفیت خروجی.
LiteLLM؛ بهترین ابزار متنباز برای ساخت AI Gateway
برای ساخت AI Gateway گزینههای مختلفی وجود دارد، اما LiteLLM محبوبترین و کاملترین آنهاست. این پروژه متنباز که توسط تیم BerriAI توسعه داده شده، یک API سازگار با OpenAI ارائه میدهد و از بیش از ۱۰۰ مدل زبانی پشتیبانی میکند .
مهمترین ویژگیهای LiteLLM:
🔹 پشتیبانی از OpenAI، Anthropic، Google Gemini، Azure، Groq و دهها سرویس دیگر
🔹 قابلیت اتصال به مدلهای لوکال از طریق Ollama یا vLLM
🔹 مدیریت کلیدهای مجازی (Virtual Keys) با بودجه و محدودیت نرخ درخواست
🔹 داشبورد تحت وب برای مدیریت مدلها و مشاهده مصرف
🔹 Fallback خودکار؛ اگر یک سرویس خطا داد، درخواست به سرویس پشتیبان میرود
نکته جالب توجه این است که LiteLLM بهصورت پیشفرض از قابلیت Load Balancing هم پشتیبانی میکند. اگر چند کلید API از OpenAI دارید یا میخواهید درخواستها را بین چند سرویس تقسیم کنید، LiteLLM بهصورت خودکار این کار را انجام میدهد .
پیشنیازهای سختافزاری برای اجرای AI Gateway روی VPS
میزان منابع موردنیاز به کاربرد شما بستگی دارد. برای یک Gateway ساده که فقط درخواستها را مسیریابی میکند، منابع متوسط کافی است. اما اگر قصد اجرای مدل لوکال روی همان سرور را دارید، به سختافزار قویتری نیاز خواهید داشت.
| کاربرد | CPU | RAM | GPU |
|---|---|---|---|
| Gateway ساده (فقط مسیریابی) | 2 Core | 4 GB | — |
| تیم کوچک (چند کاربر همزمان) | 4 Core | 8 GB | — |
| سازمانی (ترافیک بالا) | 8 Core | 16 GB | — |
| اجرای مدل لوکال (Llama, Mistral) | 8+ Core | 32+ GB | RTX / Tesla |
⚠️ نکته مهم درباره منابع
اگر قصد اجرای مدل لوکال روی همان VPS را دارید، حتماً از یک سرور GPU اختصاصی استفاده کنید. اجرای همزمان Gateway و مدل روی یک VPS معمولی باعث کمبود RAM و کندی شدید پاسخها میشود. توصیه ما: Gateway روی یک VPS و مدل لوکال روی یک سرور GPU جداگانه.
راهاندازی گامبهگام LiteLLM روی VPS
در این بخش، LiteLLM را با Docker Compose راهاندازی میکنیم. این روش استاندارد و توصیهشده برای محیط Production است .
گام ۱: نصب Docker روی VPS
ابتدا از طریق SSH به VPS خود متصل شوید و Docker را نصب کنید:
apt update
apt install docker.io docker-compose -y
docker --version
گام ۲: ساخت پوشه پروژه و فایلهای تنظیمات
یک پوشه برای پروژه ایجاد کنید و فایل تنظیمات LiteLLM را بسازید:
mkdir ai-gateway
cd ai-gateway
nano config.yaml
محتوای فایل config.yaml را به این صورت تنظیم کنید. این فایل مشخص میکند کدام مدلها از طریق Gateway در دسترس باشند:
model_list:
  - model_name: gpt-4o
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY

  - model_name: claude-sonnet
    litellm_params:
      model: anthropic/claude-sonnet-4-20250514
      api_key: os.environ/ANTHROPIC_API_KEY

  - model_name: gemini-flash
    litellm_params:
      model: gemini/gemini-2.0-flash
      api_key: os.environ/GEMINI_API_KEY

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
در این فایل، هر مدل یک model_name دارد. اپلیکیشن شما با این نام با Gateway صحبت میکند و LiteLLM آن را به سرویس واقعی مسیریابی میکند .
گام ۳: تنظیم متغیرهای محیطی
یک فایل .env بسازید و کلیدهای API خود را در آن قرار دهید:
OPENAI_API_KEY=sk-your-openai-key
ANTHROPIC_API_KEY=sk-ant-your-claude-key
GEMINI_API_KEY=your-gemini-key
LITELLM_MASTER_KEY=sk-$(openssl rand -hex 32)
⚠️ هشدار امنیتی
هرگز کلیدهای API را مستقیم در فایل config.yaml قرار ندهید. استفاده از متغیرهای محیطی (Environment Variables) روش استاندارد و امن است .
گام ۴: ساخت فایل Docker Compose
فایل docker-compose.yml را ایجاد کنید. این فایل LiteLLM و یک دیتابیس PostgreSQL برای ذخیره کلیدها و گزارش مصرف راهاندازی میکند:
services:
  litellm:
    image: ghcr.io/berriai/litellm:main-stable
    ports:
      - "4000:4000"
    env_file:
      - .env
    volumes:
      - ./config.yaml:/app/config.yaml
    command: ["--config", "/app/config.yaml", "--port", "4000"]
    depends_on:
      - db
    restart: unless-stopped

  db:
    image: postgres:16
    environment:
      POSTGRES_DB: litellm
      POSTGRES_USER: litellm
      POSTGRES_PASSWORD: strong-password
    volumes:
      - postgres_data:/var/lib/postgresql/data
    restart: unless-stopped

volumes:
  postgres_data:
گام ۵: اجرا و تست Gateway
حالا سرویسها را اجرا کنید:
docker compose up -d
docker ps
بعد از چند ثانیه، Gateway روی پورت 4000 فعال میشود. برای تست، یک درخواست ساده بفرستید:
curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer sk-your-master-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4o",
    "messages": [{"role": "user", "content": "سلام، حالت چطوره؟"}]
  }'
اگر پاسخ دریافت کردید، Gateway شما با موفقیت کار میکند. حالا اپلیکیشنهای شما میتوانند با یک API واحد به همه مدلها دسترسی داشته باشند .
🚀 زیرساخت هوش مصنوعی خود را روی VPS ایرانیکاسرور بسازید
برای اجرای AI Gateway، نیاز به یک سرور مجازی پایدار با منابع اختصاصی و آپتایم بالا دارید. VPS ایرانیکاسرور با دیسک NVMe، پهنای باند مناسب و پشتیبانی ۲۴/۷، انتخابی مطمئن برای زیرساخت هوش مصنوعی شماست.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
مدیریت کاربران و کلیدهای API با Virtual Keys
در یک محیط سازمانی، نباید همه کاربران از یک کلید API مشترک استفاده کنند. LiteLLM قابلیت Virtual Keys را ارائه میدهد که به شما اجازه میدهد برای هر کاربر یا اپلیکیشن یک کلید مجزا با محدودیتهای مشخص بسازید .
مزایای Virtual Keys:
🔹 تعیین بودجه مشخص برای هر کلید (مثلاً حداکثر ۲۰ دلار در ماه)
🔹 محدود کردن دسترسی به مدلهای خاص
🔹 تنظیم تاریخ انقضا برای کلیدها
🔹 مشاهده گزارش مصرف به تفکیک هر کلید
نمونه ایجاد یک Virtual Key با بودجه ۲۰ دلار و دسترسی فقط به دو مدل:
docker exec litellm litellm_manage --createkey \
  --alias dev-team \
  --models gpt-4o,claude-sonnet \
  --budget 20.0 \
  --expires 30d
این کلید را به اعضای تیم بدهید. حالا میتوانید دقیقاً ببینید هر نفر چقدر مصرف کرده و در صورت نیاز دسترسیاش را قطع کنید .
اتصال مدلهای لوکال به AI Gateway
یکی از قدرتمندترین قابلیتهای LiteLLM، امکان ترکیب مدلهای ابری و لوکال در یک Gateway است. اگر روی سرور GPU خود مدلهایی مثل Llama، Mistral یا Qwen اجرا میکنید، میتوانید آنها را هم به Gateway اضافه کنید .
برای این کار کافی است بخشی به config.yaml اضافه کنید:
  - model_name: llama-local
    litellm_params:
      model: ollama/llama3.2:3b
      api_base: http://your-gpu-server:11434
حالا اپلیکیشن شما میتواند با نام llama-local به مدل لوکال درخواست بفرستد. این یعنی میتوانید برای پردازش دادههای حساس از مدل لوکال استفاده کنید و برای کارهای عمومی به مدلهای ابری متصل شوید .
مشکلات رایج و راهحل آنها
مشکل ۱: خطای 401 Unauthorized
این خطا معمولاً به دلیل استفاده از کلید اشتباه یا منقضیشده رخ میدهد. بررسی کنید که در هدر Authorization از Virtual Key معتبر استفاده میکنید .
مشکل ۲: خطای Model Not Found
نام مدلی که در درخواست میفرستید باید دقیقاً با model_name در config.yaml مطابقت داشته باشد. به حروف بزرگ و کوچک دقت کنید .
مشکل ۳: مصرف بالای RAM
اگر مدل لوکال روی همان VPS اجرا میکنید، این مشکل طبیعی است. راهحل: Gateway و مدل را روی دو سرور جداگانه اجرا کنید یا منابع VPS را افزایش دهید.
مشکل ۴: امنیت API
چون Gateway یک API عمومی است، حتماً از HTTPS استفاده کنید، Rate Limit فعال کنید و پورتهای غیرضروری را ببندید .
امنیت AI Gateway در محیط Production
اگر قصد دارید Gateway را در محیط واقعی استفاده کنید، این نکات امنیتی را جدی بگیرید:
✅ فعالسازی HTTPS با Nginx و Let’s Encrypt
✅ عدم قرار دادن کلیدهای API در کد یا فایلهای قابل دسترس عمومی
✅ تنظیم Rate Limit برای جلوگیری از سوءاستفاده
✅ مانیتورینگ مداوم مصرف CPU و RAM
✅ تهیه نسخه پشتیبان از تنظیمات و دیتابیس
✅ استفاده از Firewall و محدود کردن IPهای مجاز
برای محیط Production توصیه میشود از یک Reverse Proxy مثل Nginx یا Traefik استفاده کنید تا SSL بهصورت خودکار مدیریت شود .
کاربردهای تجاری AI Gateway برای کسبوکارها
یک AI Gateway اختصاصی فقط یک ابزار فنی نیست؛ میتواند پایهای برای خدمات جدید کسبوکار شما باشد:
🔹 چتبات سازمانی
اتصال CRM، سیستم پشتیبانی و سایت به یک چتبات هوشمند که از چند مدل بهره میبرد.
🔹 دستیار برنامهنویسی داخلی
تیم توسعه میتواند از یک API واحد برای بررسی کد، تولید کد و رفع خطا استفاده کند.
🔹 پردازش اسناد داخلی
اتصال به فایلهای PDF، قراردادها و اسناد داخلی و ایجاد سیستم پرسش و پاسخ هوشمند.
جمعبندی
راهاندازی AI Gateway اختصاصی روی VPS یکی از هوشمندانهترین کارهایی است که یک تیم توسعه یا کسبوکار میتواند انجام دهد. با LiteLLM میتوانید OpenAI، Claude، Gemini و حتی مدلهای لوکال را پشت یک API واحد قرار دهید.
مزایای کلیدی این معماری:
🔹 امنیت بیشتر با کنترل کامل روی مسیر داده
🔹 مدیریت متمرکز کاربران و بودجه
🔹 کاهش هزینه با مسیریابی هوشمند درخواستها
🔹 انعطافپذیری بالا برای تغییر مدل بدون تغییر کد
برای شروع، یک VPS مناسب از ایرانیکاسرور تهیه کنید و LiteLLM را روی آن نصب کنید. در کمتر از یک ساعت، زیرساخت هوش مصنوعی اختصاصی شما آماده کار خواهد بود.
🛠 راهاندازی AI Gateway نیاز به تنظیمات اختصاصی دارد؟
اگر در تنظیم LiteLLM، اتصال مدلها یا امنیت Gateway به کمک نیاز دارید، تیم فنی ایرانیکاسرور آماده راهنمایی شماست. کافیست درخواست خود را ارسال کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
منابع خارجی: LiteLLM Official Website | LiteLLM Documentation







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.