
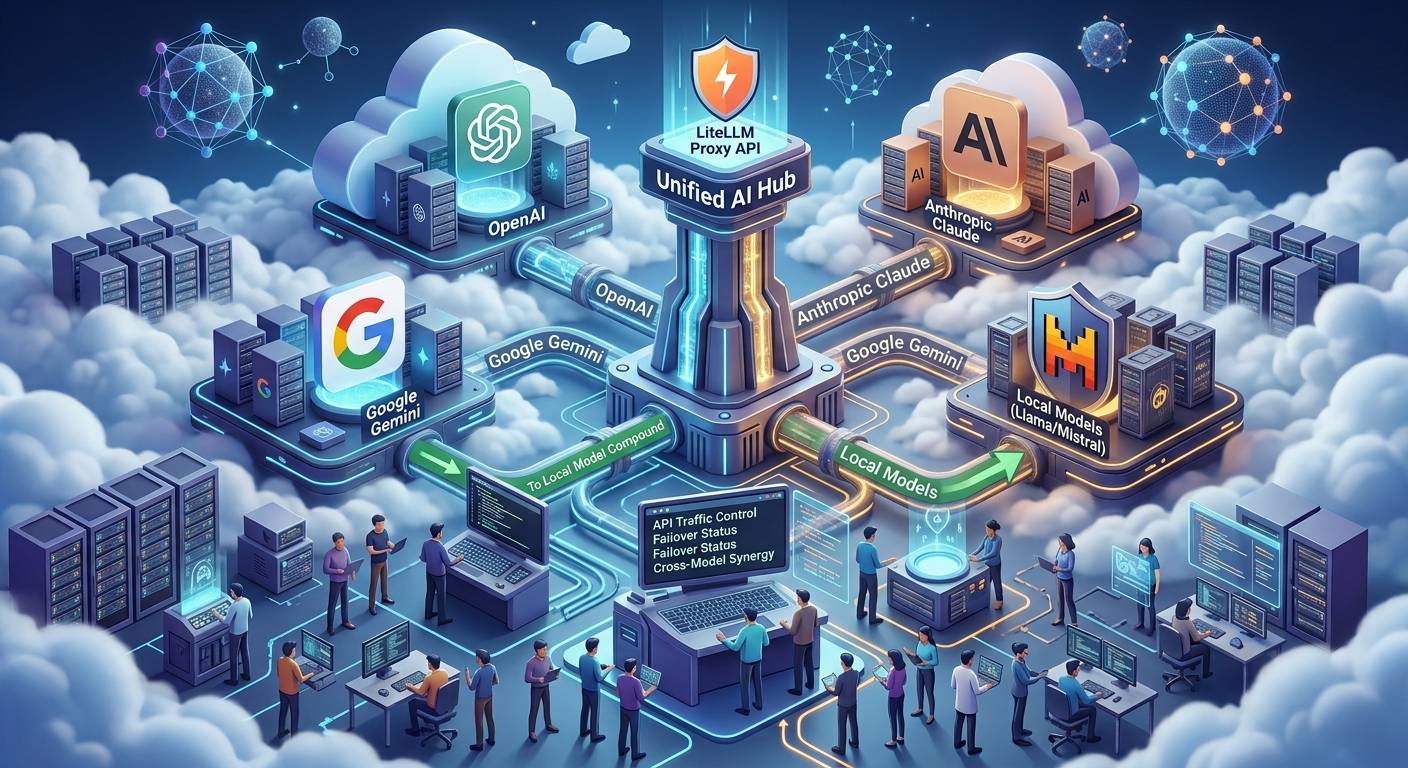
اگر روی پروژهای کار میکنید که چندین مدل هوش مصنوعی را همزمان صدا میزند — یکی GPT، یکی Claude، یکی Gemini و شاید یک مدل لوکال روی سرور خودتان — حتماً این درد را میشناسید: مدیریت چندین API Key، چندین ساختار درخواست متفاوت، و هزینههایی که هیچوقت دقیق نمیدانید کجا خرج میشوند.
LiteLLM Proxy دقیقاً برای همین لحظه ساخته شده. یک لایه واسط سبک و متنباز که همه مدلها را پشت یک API سازگار با OpenAI قرار میدهد. در این راهنما، از صفر تا صد راهاندازی این Gateway را روی یک سرور مجازی یاد میگیرید — با Docker، پیکربندی امن و تست عملی.
🔹 در این مقاله یاد میگیرید:
🔹 LiteLLM Proxy چیست و چرا به آن نیاز دارید
🔹 پیشنیازهای سختافزاری و انتخاب VPS مناسب
🔹 نصب گامبهگام با Docker Compose
🔹 اتصال به OpenAI، Claude، Gemini و Ollama
🔹 مدیریت کلیدها و محدودیت مصرف
🔹 رفع خطاهای رایج
LiteLLM Proxy دقیقاً چه کاری انجام میدهد؟
LiteLLM یک پروژه متنباز است که به عنوان یک Gateway هوش مصنوعی عمل میکند. به جای اینکه اپلیکیشن شما مستقیماً به OpenAI وصل شود، یک بار به LiteLLM وصل میشود و LiteLLM بقیه کارها را انجام میدهد .
مزیت اصلی این معماری سادگی است: API آن دقیقاً با OpenAI سازگار است. یعنی اگر کد فعلی شما با OpenAI SDK کار میکند، فقط base_url را عوض میکنید و همان کد به دهها مدل دیگر هم وصل میشود .
علاوه بر این، LiteLLM امکاناتی فراتر از یک Proxy ساده ارائه میدهد:
🔹 مدیریت کلید مجازی — به هر تیم یا پروژه یک کلید جداگانه با محدودیت مشخص بدهید
🔹 رهگیری هزینه — دقیقاً بدانید هر مدل چقدر خرج برمیدارد
🔹 Load Balancing — درخواستها را بین چند deployment از یک مدل پخش کنید
🔹 Fallback خودکار — اگر OpenAI قطع شد، درخواست به Claude منتقل شود
قبل از شروع: چه سروری نیاز دارید؟
LiteLLM خودش سبک است، اما اگر قصد اجرای مدل لوکال (مثل Ollama یا vLLM) را هم دارید، باید منابع را جدی بگیرید. جدول زیر بر اساس مستندات رسمی و تجربه عملی تهیه شده :
| سناریو | CPU | RAM | Storage |
|---|---|---|---|
| فقط Gateway (OpenAI, Claude, Gemini) | 2 Core | 4 GB | 30 GB SSD |
| Gateway + Ollama (مدل 7B) | 4 Core | 8-16 GB | 50+ GB NVMe |
| Gateway + vLLM روی GPU | GPU Server | 16+ GB | 100+ GB NVMe |
توصیه عملی: اگر فقط میخواهید APIها را مدیریت کنید، یک VPS با ۴ هسته و ۸ گیگ رم کاملاً کافی است. دیسک NVMe و پهنای باند پایدار تفاوت را در تجربه روزمره ایجاد میکند .
⚠️ نکته مهم: اگر قصد اتصال به مدلهای Local دارید، حتماً از قبل فضای دیسک کافی برای دانلود مدلها در نظر بگیرید. یک مدل 7B معمولاً ۴ تا ۵ گیگابایت فضا میگیرد.
مرحله ۱: آمادهسازی سرور
با SSH وارد سرور شوید و سیستم را بروز کنید:
ssh root@SERVER_IP
apt update && apt upgrade -y
مرحله ۲: نصب Docker
LiteLLM به صورت رسمی از Docker پشتیبانی میکند و این بهترین روش برای محیط Production است .
apt install docker.io docker-compose-plugin -y
docker --version
اگر نسخه Docker نمایش داده شد، نصب موفق بوده است.
مرحله ۳: ساخت ساختار پروژه
mkdir /opt/litellm && cd /opt/litellm
مرحله ۴: فایل Docker Compose
این فایل سرویس LiteLLM را روی پورت ۴۰۰۰ اجرا میکند. نسخه image را حتماً pin کنید (مثل v1.97.0) تا در آپدیتهای ناخواسته با مشکل مواجه نشوید :
nano docker-compose.yml
version: "3.9"
services:
  litellm:
    image: ghcr.io/berriai/litellm:v1.97.0
    ports:
      - "4000:4000"
    volumes:
      - ./config.yaml:/app/config.yaml
    env_file:
      - .env
    command: ["--config", "/app/config.yaml"]
    restart: always
توجه: استفاده از env_file امنتر از نوشتن مستقیم کلیدها در فایل Compose است.
مرحله ۵: فایل تنظیمات LiteLLM
این فایل مشخص میکند کدام نام مدل (model_name) به کدام سرویس واقعی (litellm_params) وصل شود :
nano config.yaml
model_list:
  - model_name: gpt
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY

  - model_name: claude
    litellm_params:
      model: anthropic/claude-3-5-sonnet-20241022
      api_key: os.environ/ANTHROPIC_API_KEY

  - model_name: gemini
    litellm_params:
      model: gemini/gemini-2.0-flash
      api_key: os.environ/GEMINI_API_KEY

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
نکته: پیشوند os.environ/ به LiteLLM میگوید مقدار کلید را از متغیر محیطی بخواند، نه از خود فایل .
مرحله ۶: فایل محیطی (.env)
nano .env
OPENAI_API_KEY=sk-your-openai-key
ANTHROPIC_API_KEY=sk-ant-your-claude-key
GEMINI_API_KEY=AIza-your-google-key
LITELLM_MASTER_KEY=sk-your-secret-master-key
مقدار LITELLM_MASTER_KEY را با یک رشته تصادفی امن جایگزین کنید. این کلید، رمز ادمین پنل LiteLLM هم خواهد بود.
⚠️ هشدار امنیتی: هرگز فایل .env را در Git commit نکنید. این فایل شامل کلیدهای حساس شماست.
مرحله ۷: اجرا و تست
docker compose up -d
docker ps
اگر همه چیز درست باشد، یک کانتینر با نام litellm در حال اجرا خواهید دید. حالا مدلها را تست کنید:
curl http://localhost:4000/models \
  -H "Authorization: Bearer sk-your-secret-master-key"
باید لیست مدلهای تعریفشده (gpt، claude، gemini) را ببینید. حالا یک درخواست چت واقعی بفرستید:
curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer sk-your-secret-master-key" \
  -H "Content-Type: application/json" \
  -d '{"model": "claude", "messages": [{"role": "user", "content": "سلام"}]}'
🚀 زیرساخت هوش مصنوعیتان را روی سرور مجازی ایرانیکاسرور بالا بیاورید
LiteLLM به تنهایی سبک است، اما وقتی پای مدلهای لوکال، Ollama یا vLLM به میان میآید، منابع اختصاصی CPU و RAM تفاوت را در سرعت پاسخدهی ایجاد میکند. سرورهای مجازی ایرانیکاسرور با دیسک NVMe، پهنای باند پایدار و آپتایم ۹۹.۹٪ بستر مناسبی برای اجرای AI Gateway شما فراهم میکنند .
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
اتصال به مدلهای Local با Ollama
یکی از قویترین قابلیتهای LiteLLM، اتصال به Ollama است. کافیست Ollama را روی سرور نصب و اجرا کنید :
curl https://ollama.ai/install.sh | sh
ollama run llama3
حالا در فایل config.yaml یک مدل لوکال اضافه کنید:
  - model_name: llama-local
    litellm_params:
      model: ollama/llama3
      api_base: http://localhost:11434
اکنون مدل لوکال شما هم از طریق همان API واحد قابل دسترسی است.
اتصال به vLLM برای GPU Server
اگر روی سرور GPU از vLLM استفاده میکنید، LiteLLM میتواند آن را به عنوان یک endpoint سازگار با OpenAI مدیریت کند :
  - model_name: local-gpu
    litellm_params:
      model: openai/your-model-name
      api_base: http://localhost:8000/v1
مدیریت کلیدها و محدودیت مصرف
برای محیط سازمانی، میتوانید برای هر تیم یا پروژه یک Virtual Key با بودجه مشخص بسازید. این کار از طریق پنل ادمین (/ui) یا API انجام میشود .
مثلاً یک کلید با محدودیت ۵۰ دلار در ماه برای تیم محتوا:
curl http://localhost:4000/key/generate \
  -H "Authorization: Bearer sk-your-master-key" \
  -H "Content-Type: application/json" \
  -d '{"models": ["claude"], "max_budget": 50, "budget_duration": "30d"}'
پاسخ شامل یک کلید با پیشوند sk- خواهد بود که میتوانید به تیم مربوطه بدهید.
استفاده از Nginx و SSL برای Production
در محیط واقعی، LiteLLM را مستقیم روی اینترنت expose نکنید. یک Reverse Proxy مثل Nginx جلوی آن بگذارید و از HTTPS استفاده کنید :
server {
    listen 443 ssl;
    server_name ai.yourdomain.com;

    location / {
        proxy_pass http://localhost:4000;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
حالا اپلیکیشنها به آدرس https://ai.yourdomain.com وصل میشوند، نه IP خام.
رفع خطاهای رایج
کانتینر اجرا نمیشود
لاگ را بررسی کنید:
docker logs litellm
دلایل رایج: خطای سینتکس در config.yaml، API Key اشتباه، یا کمبود RAM.
خطای Invalid API Key
مقدار کلیدها را در .env دوباره چک کنید و سرویس را ریاستارت کنید: docker compose restart
مدل Local پاسخ نمیدهد
اتصال Ollama را تست کنید: curl localhost:11434. اگر پاسخ نداد، سرویس Ollama در حال اجرا نیست.
Timeout در درخواستها
معمولاً به دلیل منابع کم سرور یا کندی شبکه است. request_timeout را در تنظیمات افزایش دهید یا منابع VPS را ارتقا دهید .
مشکل دیتابیس در راهاندازی
اگر PostgreSQL اضافه کردهاید و کانتینر LiteLLM به دیتابیس وصل نمیشود، حتماً healthcheck و depends_on را در Compose تنظیم کنید .
🔧 در راهاندازی LiteLLM یا هر سرویس دیگر روی VPS به مشکل خوردید؟
تیم پشتیبانی ایرانیکاسرور آماده کمک به شماست. از کانفیگ اولیه سرور تا رفع خطاهای Docker و شبکه، میتوانید درخواست خود را ثبت کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
استفاده از LiteLLM در برنامههای پایتون
چون API با OpenAI سازگار است، فقط base_url را عوض کنید :
from openai import OpenAI

client = OpenAI(
    api_key="sk-your-virtual-key",
    base_url="http://SERVER_IP:4000"
)

response = client.chat.completions.create(
    model="claude",
    messages=[{"role": "user", "content": "Explain VPS"}]
)
print(response.choices[0].message.content)
کاربردهای عملی LiteLLM Proxy
✅ ساخت پلتفرم AI داخلی سازمان با کنترل دسترسی
✅ ارائه سرویس API هوش مصنوعی به مشتریان
✅ مدیریت چند مدل AI در یک پروژه
✅ کنترل و رهگیری دقیق هزینههای API
✅ اتصال نرمافزارهای داخلی به مدلهای متنوع
منابع رسمی برای مطالعه بیشتر
🔹 مستندات LiteLLM — docs.litellm.ai
🔹 مخزن GitHub — github.com/BerriAI/litellm
🔹 مستندات OpenAI API — platform.openai.com/docs
📌 جمعبندی
LiteLLM Proxy یک راهکار بالغ و سبک برای یکپارچهسازی دسترسی به مدلهای هوش مصنوعی است. با نصب آن روی یک سرور مجازی مناسب، به جای مدیریت چندین API جداگانه، یک endpoint واحد با کنترل کامل روی هزینه، دسترسی و routing خواهید داشت. برای پروژههای شخصی، تیمهای توسعه و حتی سرویسهای سازمانی، این Gateway میتواند اولین قطعه زیرساخت AI شما باشد.
📌 لینکهای مرتبط ایرانیکاسرور
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.