
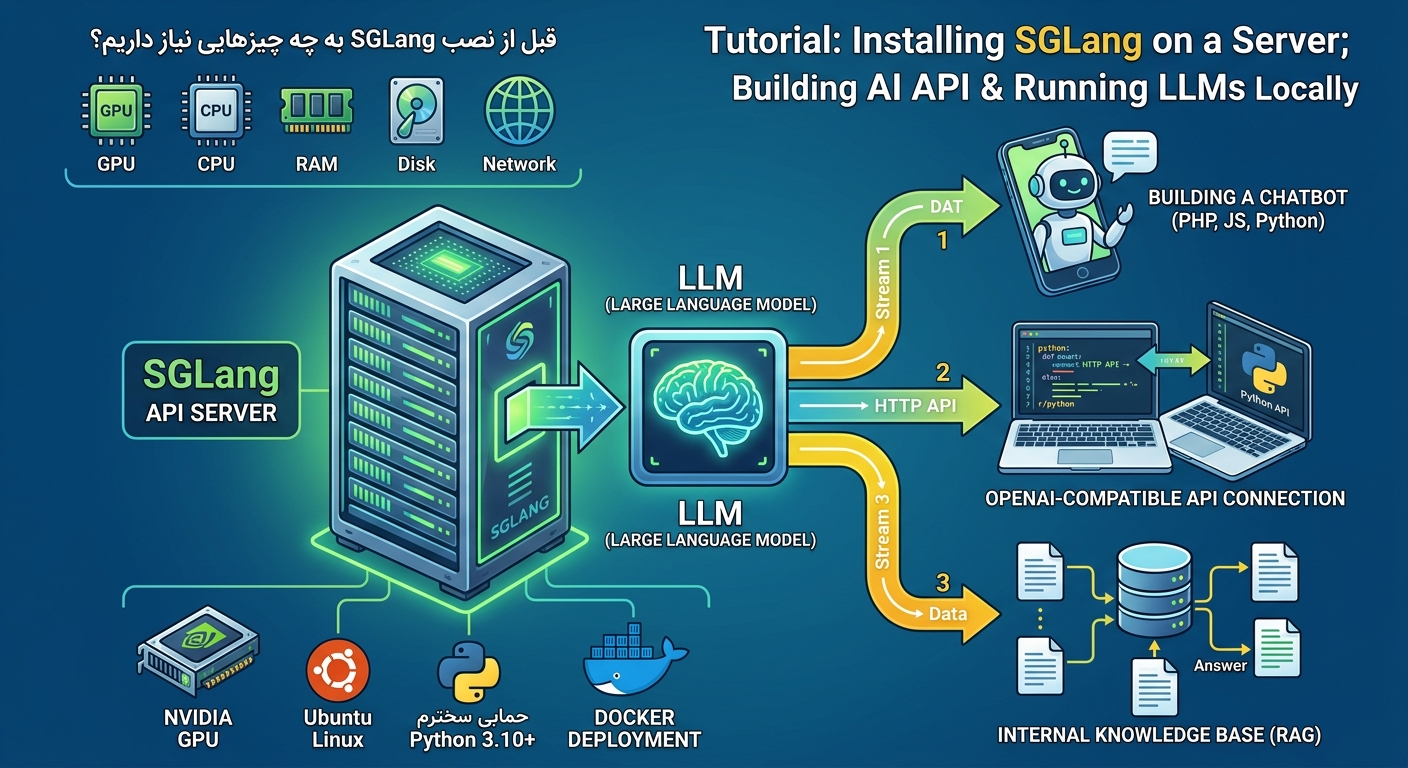
اگر بهدنبال راهی برای اجرای مدلهای زبانی بزرگ (LLM) روی زیرساخت شخصی خودتان هستید و میخواهید یک API مشابه سرویسهای هوش مصنوعی آنلاین بسازید، SGLang یک انتخاب حرفهای و کارآمد است. این فریمورک متنباز که توسط تیم LMSYS توسعه یافته، بهجای اینکه صرفاً یک ابزار ساده باشد، بهعنوان یک موتور سرویسدهی (Serving Engine) طراحی شده تا بتواند پاسخدهی به درخواستهای همزمان را با بالاترین کارایی ممکن مدیریت کند.
در این مقاله، از صفر تا صد نصب SGLang روی یک سرور مجازی (VPS) یا سرور اختصاصی با کارت گرافیک NVIDIA را بررسی میکنیم. فرقی نمیکند که سرور شما لینوکس باشد یا ویندوز؛ تمرکز ما روی محیط لینوکس (اوبونتو) است که پایدارترین بستر برای این کار محسوب میشود. اگر قصد دارید یک دستیار هوشمند اختصاصی، یک ربات پشتیبانی یا یک سیستم RAG راهاندازی کنید، این راهنما دقیقاً همان چیزی است که نیاز دارید.
چرا SGLang و نه سایر فریمورکها؟
شاید بپرسید تفاوت SGLang با گزینههای محبوبی مثل vLLM در چیست. هر دو ابزارهای قدرتمندی هستند، اما SGLang روی یک نوآوری کلیدی به نام RadixAttention تمرکز دارد. این مکانیزم بهصورت هوشمندانهای پیشوندهای تکراری در پرامپتها را در یک درخت رادیکسی ذخیره میکند. تصور کنید یک ربات چت دارید که در هر درخواست، یک دستور سیستمی طولانی (مثلاً ۲۰۰۰ توکن) را برای مدل میفرستد. در فریمورکهای سنتی، این ۲۰۰۰ توکن هر بار از نو پردازش میشوند، اما SGLang آنها را کش میکند و فقط بخش جدید را محاسبه میکند.
📌 مزیتهای کلیدی SGLang که آن را متمایز میکند:
🔹 RadixAttention: افزایش سرعت تا ۶.۴ برابر در کارهای با پیشوند تکراری (مثل چتهای چند مرحلهای یا ایجنتها).
🔹 Zero-Overhead Scheduler: سربار زمانبندی CPU را به کمتر از ۲٪ میرساند تا GPU مشغول کار مفید باشد.
🔹 Compressed FSM: تولید خروجیهای ساختاریافته مثل JSON را تا ۳ برابر سریعتر میکند.
🔹 OpenAI-Compatible API: نیازی به یادگیری API جدید نیست؛ همان کدهایی که برای OpenAI نوشتهاید با تغییر آدرس Base URL کار میکنند.
پیشنیازهای سختافزاری و نرمافزاری
قبل از هر چیز، باید مطمئن شوید که سرور شما توانایی اجرای یک LLM را دارد. برخلاف تصور عموم، برای اجرای SGLang همیشه به کارت گرافیکهای چند هزار دلاری نیاز نیست. اگر مدلهای کوچک (مثل Qwen 0.6B یا Gemma 2B) را هدف بگیرید، یک VPS یا سرور مجازی با یک GPU مقرونبهصرفه مثل NVIDIA T4 یا L4 هم کار را راه میاندازد. اما برای مدلهای بزرگتر (70B به بالا)، باید سراغ A100 یا H100 بروید.
| سناریو | پیشنهاد GPU | حداقل RAM |
|---|---|---|
| تست و توسعه (مدلهای کوچک زیر 3B) | NVIDIA T4 (16GB) یا L4 (24GB) | 16 GB |
| استقرار محصول (مدلهای 7B تا 13B) | NVIDIA A10G یا L40S | 32 GB |
| مدلهای سنگین (70B و بالاتر) | NVIDIA A100 (80GB) یا H100 | 64 GB به بالا |
از نظر نرمافزاری، به اوبونتو ۲۰.۰۴ یا بالاتر، درایورهای NVIDIA، CUDA 13 (نسخههای قدیمیتر ممکن است پشتیبانی نشوند) و Python 3.10+ نیاز دارید. اگر از Docker استفاده میکنید، باید NVIDIA Container Toolkit را هم نصب کنید.
مرحله ۱: بررسی سلامت GPU و درایورها
پس از اتصال SSH به سرور، اولین دستوری که باید اجرا کنید nvidia-smi است. این دستور اطلاعات حیاتی مثل نام کارت گرافیک، نسخه درایور و نسخه CUDA را نشان میدهد. اگر خروجی این دستور با خطا مواجه شد، یعنی یا درایور نصب نیست یا کارت گرافیک توسط سیستم شناسایی نشده است. در این صورت، قبل از هر اقدامی باید مشکل درایور را حل کنید.
$ nvidia-smi
خروجی باید چیزی شبیه به این باشد: Driver Version: 550.xx و CUDA Version: 12.4. (توجه داشته باشید که SGLang نسخههای اخیر به CUDA 13 نیاز دارد، پس در صورت امکان درایور خود را بهروز کنید.)
مرحله ۲: نصب SGLang (روش پیشنهادی با uv)
تیم SGLang بهجای pip معمولی، استفاده از uv را پیشنهاد میکند که سرعت نصب را بهطرز چشمگیری افزایش میدهد. ابتدا باید ابزارهای پایه را نصب کرده و یک محیط مجازی (Virtual Environment) بسازید تا با سایر پروژههای سرور تداخل نداشته باشید.
$ sudo apt update
$ sudo apt install -y python3 python3-venv git curl
$ mkdir -p ~/sglang && cd ~/sglang
$ python3 -m venv venv
$ source venv/bin/activate
پس از فعالسازی محیط مجازی (که با نمایش (venv) در ابتدای خط فرمان مشخص میشود)، uv را نصب کرده و سپس SGLang را با دستور زیر نصب کنید:
$ pip install –upgrade pip
$ pip install uv
$ uv pip install –prerelease=allow sglang
⚠️ هشدار فنی: گزینه –prerelease=allow در مستندات رسمی برای مدیریت برخی وابستگیهای پیشانتشار توصیه شده است. همچنین SGLang نسخههای جدید (بالاتر از 0.5.19) فقط از CUDA 13 پشتیبانی میکنند. اگر سرور شما CUDA 12 دارد، باید از یک نسخه قدیمیتر SGLang استفاده کنید یا درایور خود را ارتقا دهید.
مرحله ۳: اجرای اولین مدل و تست API
برای اینکه مطمئن شویم همهچیز درست کار میکند، ابتدا یک مدل بسیار سبک مثل Qwen/Qwen3-0.6B را اجرا میکنیم. این مدل آنقدر کوچک است که روی هر GPU قدیمی هم بالا میآید.
$ python3 -m sglang.launch_server \
–model-path Qwen/Qwen3-0.6B \
–host 0.0.0.0 \
–port 30000
در اجرای اول، SGLang فایلهای مدل را از Hugging Face دانلود میکند، پس ممکن است کمی طول بکشد. پس از اتمام دانلود، سرویس روی پورت 30000 بالا میآید. حالا از یک ترمینال دیگر (یا از داخل همان سرور) با curl تست میکنیم:
$ curl http://127.0.0.1:30000/v1/chat/completions \
-H “Content-Type: application/json” \
-d ‘{
“model”: “Qwen/Qwen3-0.6B”,
“messages”: [{“role”: “user”, “content”: “سلام، خودت را معرفی کن.”}],
“max_tokens”: 100
}’
اگر پاسخ JSON مدل را دریافت کردید، تبریک میگویم! شما یک سرور هوش مصنوعی اختصاصی راهاندازی کردهاید. از این لحظه، هر برنامهای که بتواند درخواست HTTP بفرستد، میتواند از این مدل استفاده کند.
🚀 سرور مجازی GPU ایرانیکاسرور؛ زیرساخت ایدهآل برای پروژههای هوش مصنوعی
اگر بهدنبال یک سرور مجازی یا سرور اختصاصی با کارت گرافیک قدرتمند برای اجرای مدلهای LLM هستید، ایرانیکاسرور با ارائه منابع اختصاصی CPU و RAM، دیسکهای NVMe پرسرعت برای رفع گلوگاه I/O و پهنای باند مطمئن، میتواند میزبان پروژه هوش مصنوعی شما باشد. تیم پشتیبانی فنی ما در تمام ساعات شبانهروز آماده کمک به شما در راهاندازی و کانفیگ سرور است.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
مرحله ۴: اتصال به برنامهها (پایتون، وردپرس و…)
یکی از جذابترین ویژگیهای SGLang، سازگاری کامل با API شرکت OpenAI است. این یعنی شما میتوانید کتابخانههای رسمی OpenAI را نصب کنید و فقط آدرس Base URL را تغییر دهید. بهعنوان مثال، در پایتون کافی است:
from openai import OpenAI
client = OpenAI(base_url=”http://127.0.0.1:30000/v1″, api_key=”EMPTY”)
response = client.chat.completions.create(
model=”Qwen/Qwen3-0.6B”,
messages=[{“role”: “user”, “content”: “یک متن کوتاه درباره سرور مجازی بنویس.”}]
)
print(response.choices[0].message.content)
همین موضوع برای وردپرس هم صادق است. اگر یک سایت وردپرسی دارید و میخواهید یک چتبات هوشمند به آن اضافه کنید، میتوانید از کد PHP زیر استفاده کنید تا درخواست را به API سرور SGLang خود بفرستید:
<?php
$url = “http://YOUR_SERVER_IP:30000/v1/chat/completions”;
$data = [
“model” => “Qwen/Qwen3-0.6B”,
“messages” => [[“role” => “user”, “content” => “سلام!”]],
“max_tokens” => 200
];
$ch = curl_init($url);
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
curl_setopt($ch, CURLOPT_POST, true);
curl_setopt($ch, CURLOPT_HTTPHEADER, [“Content-Type: application/json”]);
curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode($data));
$response = curl_exec($ch);
curl_close($ch);
echo $response;
?>
مرحله ۵: امنیت و اجرای دائمی سرویس (Production)
اگر API را روی 0.0.0.0 اجرا کنید و فایروال سرور باز باشد، هر کسی میتواند از GPU شما استفاده کند! این یعنی هزینه برق و منابع سرور شما هدر میرود. برای محیط عملیاتی، دو کار ضروری است:
۱. استفاده از Reverse Proxy (مثل Nginx): بهجای باز کردن پورت 30000 روی اینترنت، سرویس SGLang را روی 127.0.0.1 (لوکال) اجرا کنید و Nginx را طوری تنظیم کنید که با HTTPS و احراز هویت، درخواستها را به آن پاس بدهد.
۲. ساخت سرویس Systemd: اگر SSH را ببندید، سرویس SGLang هم متوقف میشود. برای اجرای دائمی، یک فایل سرویس در systemd بسازید:
[Unit]
Description=SGLang LLM Server
After=network.target
[Service]
User=root
WorkingDirectory=/root/sglang
Environment=”PATH=/root/sglang/venv/bin”
ExecStart=/root/sglang/venv/bin/python3 -m sglang.launch_server –model-path Qwen/Qwen3-0.6B –host 127.0.0.1 –port 30000
Restart=always
[Install]
WantedBy=multi-user.target
سپس با دستورات systemctl daemon-reload، systemctl enable sglang و systemctl start sglang سرویس را فعال کنید.
🛠 با مشکلی در کانفیگ سرور مواجه شدهاید؟
اگر در مراحل نصب SGLang، کانفیگ GPU، تنظیمات Nginx یا اتصال به دیتابیس به مشکل خوردهاید، نگران نباشید. تیم فنی ایرانیکاسرور آماده است تا سرور شما را برای اجرای پروژههای هوش مصنوعی بهینه کند. کافیست درخواست خود را از طریق صفحه کانفیگ سرور برای ما ارسال کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
خطاهای رایج و راهحلهای سریع
حتی حرفهایها هم ممکن است با خطا مواجه شوند. در اینجا دو خطای رایج را بررسی میکنیم:
⚠️ خطای CUDA_HOME: اگر با پیام OSError: CUDA_HOME environment variable is not set مواجه شدید، کافیست مسیر CUDA را بهصورت دستی تنظیم کنید. دستور export CUDA_HOME=/usr/local/cuda معمولاً مشکل را حل میکند. همچنین میتوانید ابتدا FlashInfer را نصب کنید تا وابستگیها بهدرستی شناسایی شوند.
⚠️ خطای کمبود حافظه (CUDA Out of Memory): اگر مدل در حین اجرا با خطای کمبود VRAM مواجه شد، چند راهحل دارید: از یک مدل کوچکتر استفاده کنید، نسخه Quantized (مثلاً 4-bit یا 8-bit) مدل را دانلود کنید، یا پارامتر –mem-fraction-static را به مقدار پایینتری (مثل 0.7) تنظیم کنید تا SGLang فضای کمتری از حافظه GPU را رزرو کند.
جمعبندی
SGLang یک پل ارتباطی قدرتمند بین مدلهای زبانی متنباز و برنامههای کاربردی شماست. با استفاده از آن، میتوانید بدون وابستگی به سرویسهای ابری خارجی، یک API هوش مصنوعی امن و پرسرعت روی زیرساخت خودتان داشته باشید. اگر زیرساخت مناسبی دارید، SGLang میتواند هزینههای شما را نسبت به استفاده از APIهای تجاری بهشدت کاهش دهد و کنترل کامل روی دادهها را به شما بدهد. برای پروژههایی مثل چتباتهای سازمانی، سیستمهای RAG یا دستیارهای کدنویسی، این انتخاب میتواند یک سرمایهگذاری بلندمدت عالی باشد.
🔗 لینکهای مرتبط با این آموزش:
🔹 مستندات رسمی SGLang (منبع اصلی برای آخرین تغییرات)
🔹 مستندات Hugging Face Token (برای دانلود مدلهای خصوصی)
🔹 مخزن GitHub پروژه SGLang







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.