
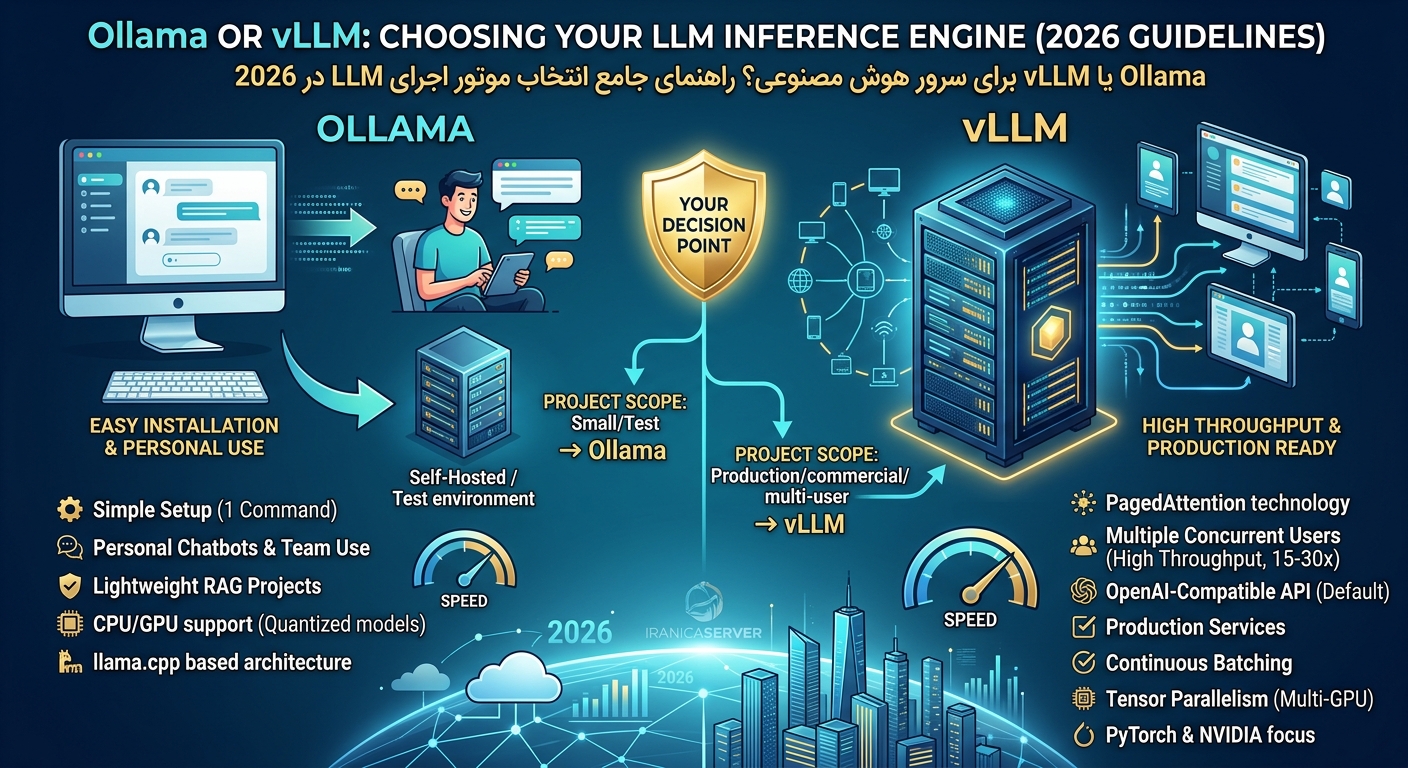
اگر قصد راهاندازی سرور هوش مصنوعی شخصی یا سرویس API مبتنی بر LLM دارید، احتمالاً با دو نام آشنا روبرو شدهاید: Ollama و vLLM. هر دو ابزار مدلهای زبانی بزرگ را روی زیرساخت شما اجرا میکنند، اما فلسفه طراحی، معماری و کاربرد آنها کاملاً متفاوت است. انتخاب اشتباه میتواند به هدر رفتن منابع GPU، تجربه کاربری ضعیف یا هزینههای غیرضروری منجر شود.
در این مقاله، تفاوتهای کلیدی Ollama و vLLM را از منظر معماری، کارایی، مقیاسپذیری، مصرف منابع و سناریوهای واقعی بررسی میکنیم تا بتوانید بر اساس نیاز پروژه خود، انتخاب درستی داشته باشید.
📌 خلاصه تصمیم:
🔹 اگر میخواهید سریع شروع کنید، مدل را تست کنید یا یک Chatbot شخصی بسازید → Ollama
🔹 اگر هدف شما سرویسدهی به چندین کاربر، ساخت API حرفهای یا استفاده تجاری است → vLLM
Ollama چیست؟ سادگی در اجرای مدلهای زبانی
Ollama یک ابزار Self-Hosted برای اجرای مدلهای زبانی بزرگ است که هدف اصلی آن سادهسازی فرآیند نصب و اجرا است. به جای درگیری با وابستگیها، نسخههای CUDA و تنظیمات پیچیده، Ollama یک محیط آماده ارائه میدهد که در آن با چند دستور ساده میتوانید مدل موردنظر را دانلود و اجرا کنید.
در واقع Ollama بر پایه llama.cpp ساخته شده است؛ موتوری که به دلیل پشتیبانی گسترده از سختافزار (CPU، GPU، Apple Silicon) و فرمت GGUF شهرت دارد [مرجع رسمی llama.cpp]. اما Ollama یک لایه راحتی روی آن اضافه کرده که مدیریت مدل، API ساده و تجربه کاربری یکپارچه را فراهم میکند.
ollama pull llama3.1

ollama run llama3.1
با این دو دستور، مدل روی سرور شما اجرا میشود و آماده گفتگو است. برای شروع، هیچ دانش تخصصی از CUDA یا پیکربندی GPU لازم نیست.
Ollama برای چه کسانی مناسب است؟
🔹 توسعهدهندگانی که میخواهند سریع مدل را تست کنند
🔹 ساخت Chatbot خصوصی برای استفاده شخصی یا تیمی
🔹 آزمایش Prompt و مقایسه مدلهای مختلف
🔹 پروژههای RAG سبک تا متوسط
🔹 اجرای مدل روی لپتاپ یا VPS بدون GPU قدرتمند
vLLM چیست؟ موتور سروینگ حرفهای برای Production
vLLM یک موتور inference است که از ابتدا برای کارایی بالا، Throughput زیاد و سرویسدهی همزمان به کاربران متعدد طراحی شده است. این ابزار از فناوری PagedAttention استفاده میکند؛ تکنیکی برای مدیریت بهینه حافظه KV Cache که امکان پردازش همزمان درخواستهای بیشتر را فراهم میکند.
vLLM به طور پیشفرض یک API سازگار با OpenAI ارائه میدهد. این یعنی اگر برنامهای دارید که با APIهای OpenAI کار میکند، میتوانید با تغییر Endpoint آن را به سرور vLLM خود متصل کنید [مستندات vLLM].
بر اساس مقایسههای مستقل، vLLM در سناریوهای سروینگ با بار بالا، 15 تا 30 برابر Throughput بیشتری نسبت به Ollama ارائه میدهد [Shattered.io 2026]. این تفاوت زمانی اهمیت پیدا میکند که چندین کاربر یا برنامه به صورت همزمان از مدل استفاده میکنند.
جدول مقایسه فنی Ollama و vLLM
| ویژگی | Ollama | vLLM |
|---|---|---|
| نصب و راهاندازی | بسیار ساده (یک دستور) | نیازمند دانش CUDA، Python و سازگاری نسخهها |
| معماری پایه | llama.cpp | PyTorch + PagedAttention |
| هدف اصلی | سادگی اجرا، استفاده شخصی | Throughput بالا، سرویسدهی چندکاربره |
| OpenAI-Compatible API | دارد (محدودتر) | دارد (استاندارد اصلی) |
| Continuous Batching | ندارد | دارد |
| Tensor Parallelism | ندارد | دارد (چند GPU) |
| Throughput (بار بالا) | پایین | بسیار بالا |
| مناسب برای Production | پروژههای کوچک و متوسط | بله، طراحیشده برای این کار |
| پیشنیاز GPU | اختیاری (CPU هم کار میکند) | تقریباً الزامی |
🚀 سرور هوش مصنوعی خود را حرفهای راهاندازی کنید
اگر قصد دارید Ollama یا vLLM را روی زیرساخت پایدار اجرا کنید، به سرور مجازی با منابع اختصاصی CPU و RAM، دیسک NVMe برای بارگذاری سریع مدل و پهنای باند مناسب نیاز دارید. ایرانیکاسرور سرورهای مجازی ایران و خارج را با منابع واقعی و آپتایم بالا ارائه میدهد.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
نصب و راهاندازی: تفاوت در تجربه
نصب Ollama
Ollama برای سادهترین تجربه نصب ممکن طراحی شده است. در لینوکس، با یک اسکریپت میتوانید آن را راهاندازی کنید:
curl -fsSL https://ollama.com/install.sh | sh
پس از نصب، سرویس به طور خودکار اجرا میشود. برای بررسی وضعیت:
systemctl status ollama
سپس مدل موردنظر را دانلود و اجرا کنید. کل فرآیند معمولاً کمتر از ۱۰ دقیقه طول میکشد.
نصب vLLM
vLLM نیازمند محیط Python با نسخههای سازگار CUDA، PyTorch و درایور NVIDIA است. نصب پایه با pip انجام میشود:
pip install vllm
اما در عمل، قبل از نصب باید موارد زیر را بررسی و تطبیق دهید:
⚠️ نکات مهم قبل از نصب vLLM:
🔹 مدل GPU و مقدار VRAM
🔹 نسخه درایور NVIDIA
🔹 نسخه CUDA (معمولاً 12.x)
🔹 نسخه Python (3.9 تا 3.12)
🔹 نسخه PyTorch سازگار
🔹 نسخه vLLM متناسب با مدل
اگر تجربه کافی با محیطهای GPU و Linux ندارید، راهاندازی vLLM میتواند چالشبرانگیز باشد. اما اگر هدف شما ساخت یک سرویس حرفهای است، این پیچیدگی اولیه ارزش سرمایهگذاری را دارد.
مقایسه کارایی: کدام سریعتر است؟
پاسخ این سؤال به نوع بار کاری بستگی دارد. مقایسه سرعت یک درخواست واحد معیار مناسبی نیست.
در سروینگ حرفهای، عوامل زیر بر عملکرد نهایی تأثیر میگذارند:
🔹 تعداد کاربران همزمان
🔹 اندازه مدل و طول ورودی/خروجی
🔹 نوع GPU و مقدار VRAM
🔹 Quantization و تنظیمات سروینگ
🔹 تعداد درخواستها در ثانیه
vLLM با استفاده از PagedAttention و Continuous Batching، حافظه GPU را بهینه مدیریت میکند و امکان پردازش همزمان درخواستهای بیشتر را فراهم میآورد. Ollama فاقد این مکانیزمهاست و برای بارهای بالا به سرعت اشباع میشود [تحلیل فنی 2026].
در یک مقایسه عملی با مدل Llama 3.1 8B روی GPU H100، vLLM توانست بیش از ۱۵ برابر Throughput بیشتری در سناریوهای چندکاربره ارائه دهد. در مقابل، Ollama برای یک کاربر تجربهای روان و بدون تأخیر محسوس فراهم میکند.
PagedAttention در vLLM: چرا مهم است؟
مدلهای زبانی هنگام پردازش درخواستها از حافظه GPU برای نگهداری KV Cache استفاده میکنند. در سروینگ همزمان، مدیریت این حافظه به گلوگاه اصلی تبدیل میشود.
PagedAttention ایدهای مشابه حافظه مجازی در سیستمعاملها را به کار میگیرد: KV Cache را به بلوکهای کوچک تقسیم میکند و آنها را به صورت پویا تخصیص میدهد. نتیجه، کاهش چشمگیر هدر رفتن حافظه و امکان سرویسدهی به درخواستهای بیشتر با همان مقدار VRAM است.
این تکنیک یکی از دلایل اصلی برتری vLLM در سناریوهای Production است.
مصرف RAM و VRAM: چه چیزی را باید در نظر بگیرید؟
هنگام انتخاب سرور برای هوش مصنوعی، فقط تعداد هسته CPU مهم نیست. حافظه RAM و بهویژه VRAM کارت گرافیک نقش تعیینکنندهای دارند.
برای مثال، یک مدل 7B با دقت FP16 حدود 14 گیگابایت VRAM نیاز دارد. با Quantization به 4-bit، این مقدار به 4 تا 5 گیگابایت کاهش مییابد. اگر VRAM کافی نباشد، با خطای Out of Memory، افت شدید سرعت یا اجبار به استفاده از CPU روبرو میشوید.
⚠️ توصیه: قبل از خرید سرور، مدل موردنظر و حالت Quantization آن را مشخص کنید. سپس VRAM موردنیاز را از مستندات مدل یا با ابزارهایی مانند LLMFit تخمین بزنید.
آیا Ollama روی GPU کار میکند؟
بله. Ollama از GPU برای اجرای سریعتر مدلها پشتیبانی میکند. اگر سرور شما GPU مناسب داشته باشد، مدلهای بزرگتر با عملکرد بهتری اجرا میشوند.
اما صرف داشتن GPU کافی نیست. زنجیره زیر باید کامل باشد:
GPU → VRAM → Driver → CUDA Runtime → Model
اگر یکی از این حلقهها ناسازگار باشد، Ollama به CPU برمیگردد و سرعت به شدت کاهش مییابد.
vLLM و نیاز به GPU
vLLM برای اجرای مدلهای LLM روی شتابدهندههای مناسب طراحی شده است. اگرچه نسخههایی از آن روی CPU قابل اجرا هستند، اما کاربرد اصلی آن روی GPU است.
در یک معماری سرویس حرفهای، vLLM لایهای بین API و مدل است:
Client → Nginx → API Gateway → vLLM → GPU → LLM
برای پروژههای بزرگتر، میتوان چندین نمونه vLLM را پشت Load Balancer قرار داد و از چند GPU استفاده کرد.
مقایسه API: Ollama در برابر vLLM
هر دو ابزار API ارائه میدهند، اما رویکرد آنها متفاوت است.
Ollama API برای توسعهدهندهای طراحی شده که میخواهد سریع یک مدل را در اختیار برنامه قرار دهد. API آن ساده و مستندات آن روان است.
vLLM API به طور کامل با استاندارد OpenAI سازگار است. این یعنی برنامههایی که برای کار با OpenAI نوشته شدهاند، با تغییر base_url به سرور vLLM متصل میشوند. این قابلیت برای مهاجرت از سرویسهای ابری به Self-Hosted حیاتی است.
سناریوهای واقعی: کدام ابزار برای کدام پروژه؟
| نوع پروژه | ابزار پیشنهادی | دلیل |
|---|---|---|
| یادگیری و آزمایش Local AI | Ollama | سادگی، نصب سریع، بدون نیاز به GPU |
| Chatbot شخصی یا تیمی | Ollama | کافی برای چند کاربر محدود، راهاندازی آسان |
| API هوش مصنوعی برای اپلیکیشن | vLLM | Throughput بالا، API استاندارد OpenAI |
| سرویسدهی به کاربران همزمان | vLLM | PagedAttention و Continuous Batching |
| پروژه تجاری بزرگ | vLLM | مقیاسپذیری، مدیریت حرفهای GPU |
| RAG سبک و شخصی | Ollama | سادگی، کافی برای بار کم |
| RAG سازمانی با بار بالا | vLLM | توان پردازشی بالا، پایداری در Production |
🛠 مشکل در راهاندازی سرور هوش مصنوعی دارید؟
اگر در نصب Ollama یا vLLM، پیکربندی GPU، بهینهسازی منابع یا انتخاب مشخصات سرور به کمک نیاز دارید، کارشناسان ایرانیکاسرور آماده راهنمایی شما هستند. از طریق صفحه کانفیگ درخواست خود را ثبت کنید یا با پشتیبانی تماس بگیرید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
آیا Ollama برای Production مناسب است؟
Production فقط به معنای «کار کردن مدل» نیست. در یک سرویس واقعی باید موارد زیر را مدیریت کنید:
🔹 احراز هویت و API Key
🔹 Rate Limiting و کنترل مصرف
🔹 مانیتورینگ و Logging
🔹 امنیت API و HTTPS
🔹 مدیریت خطا و بازیابی خودکار
🔹 Reverse Proxy و محدودیت دسترسی
Ollama برای یک سرویس داخلی کوچک یا تیم محدود کافی است. اما برای API عمومی با ترافیک بالا، به معماری گستردهتری نیاز دارید که vLLM در آن نقش کلیدی دارد.
انتخاب VPS مناسب برای Ollama
اگر هدف شما اجرای مدلهای کوچک و آزمایشی است، یک VPS لینوکسی با CPU و RAM مناسب نقطه شروع خوبی است. برای مدلهای بزرگتر و پاسخدهی سریعتر، VPS GPU انتخاب بهتری خواهد بود.
هنگام انتخاب VPS موارد زیر را بررسی کنید:
🔹 مقدار RAM (حداقل ۸ گیگابایت برای مدلهای 7B)
🔹 تعداد هسته CPU (برای پردازشهای جانبی)
🔹 نوع دیسک (SSD/NVMe برای بارگذاری سریع مدل)
🔹 GPU و مقدار VRAM (در صورت نیاز)
🔹 پهنای باند و ترافیک
🔹 موقعیت دیتاسنتر
انتخاب سرور برای vLLM
برای vLLM، ابتدا مدل موردنظر را مشخص کنید، سپس منابع را انتخاب کنید. ترتیب صحیح تصمیمگیری:
Model → Size → Quantization → VRAM → GPU → CPU/RAM → Users → Server
این روش بهتر از خرید یک سرور و سپس تلاش برای اجرای هر مدلی روی آن است.
آیا میتوان Ollama و vLLM را همزمان استفاده کرد؟
بله. در یک زیرساخت میتوان از ابزارهای مختلف برای کاربردهای مختلف بهره برد:
Development → Ollama (سادگی و سرعت تست)
Production API → vLLM (Throughput و مقیاسپذیری)
این الگو به تیم توسعه اجازه میدهد فرآیند آزمایش را ساده نگه دارد و برای سرویس Production از معماری تخصصیتر استفاده کند.
جمعبندی: کدام را انتخاب کنیم؟
Ollama و vLLM رقیب مستقیم نیستند. هر کدام برای هدف متفاوتی طراحی شدهاند.
Ollama مسیر سریع و ساده برای اجرای مدل، تست، توسعه و استفاده شخصی است.
vLLM برای سرویسدهی حرفهای، API با Throughput بالا و استفاده همزمان چندین کاربر طراحی شده است.
انتخاب نهایی به مدل، تعداد کاربران، نوع درخواستها و معماری سرویس شما بستگی دارد. اگر هنوز مطمئن نیستید، با کارشناسان ما مشورت کنید تا بر اساس نیاز پروژه، بهترین گزینه را انتخاب کنید.
سوالات متداول
آیا Ollama روی VPS معمولی بدون GPU اجرا میشود؟
بله، برای مدلهای کوچک (۷B یا کمتر) با Quantization، CPU یک VPS معمولی میتواند کافی باشد. اما سرعت به مراتب کمتر از GPU خواهد بود.
آیا vLLM روی CPU کار میکند؟
نسخههایی از vLLM روی CPU قابل اجرا هستند، اما کاربرد اصلی آن GPU است. برای CPU، llama.cpp یا Ollama انتخابهای منطقیتری هستند.
کدام ابزار برای ساخت ChatGPT خصوصی بهتر است؟
برای یک Chatbot شخصی یا تیمی کوچک، Ollama سادهتر است. برای سرویسدهی به کاربران متعدد یا ساخت API، vLLM انتخاب حرفهایتری است.
آیا میتوان از هر دو در یک زیرساخت استفاده کرد؟
بله. الگوی رایج این است که Ollama برای محیط Development و vLLM برای Production استفاده شود.
آیا vLLM برای پروژههای کوچک مناسب است؟
اگر فقط میخواهید مدل را تست کنید، vLLM ممکن است بیش از نیاز شما پیچیده باشد. اما اگر از ابتدا هدف ساخت سرویس است، سرمایهگذاری اولیه منطقی است.







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.