آموزشی 📅 9 مهر 1405 آموزش نصب ComfyUI روی سرور GPU؛ ساخت خط تولید تصویر هوش مصنوعی با Linux، مدلهای AI و Workflow اگر تولید تصویر با هوش مصنوعی را از کامپیوتر شخصی به یک سرور قدرتمند منتقل کنید، ComfyUI میتواند به یک...
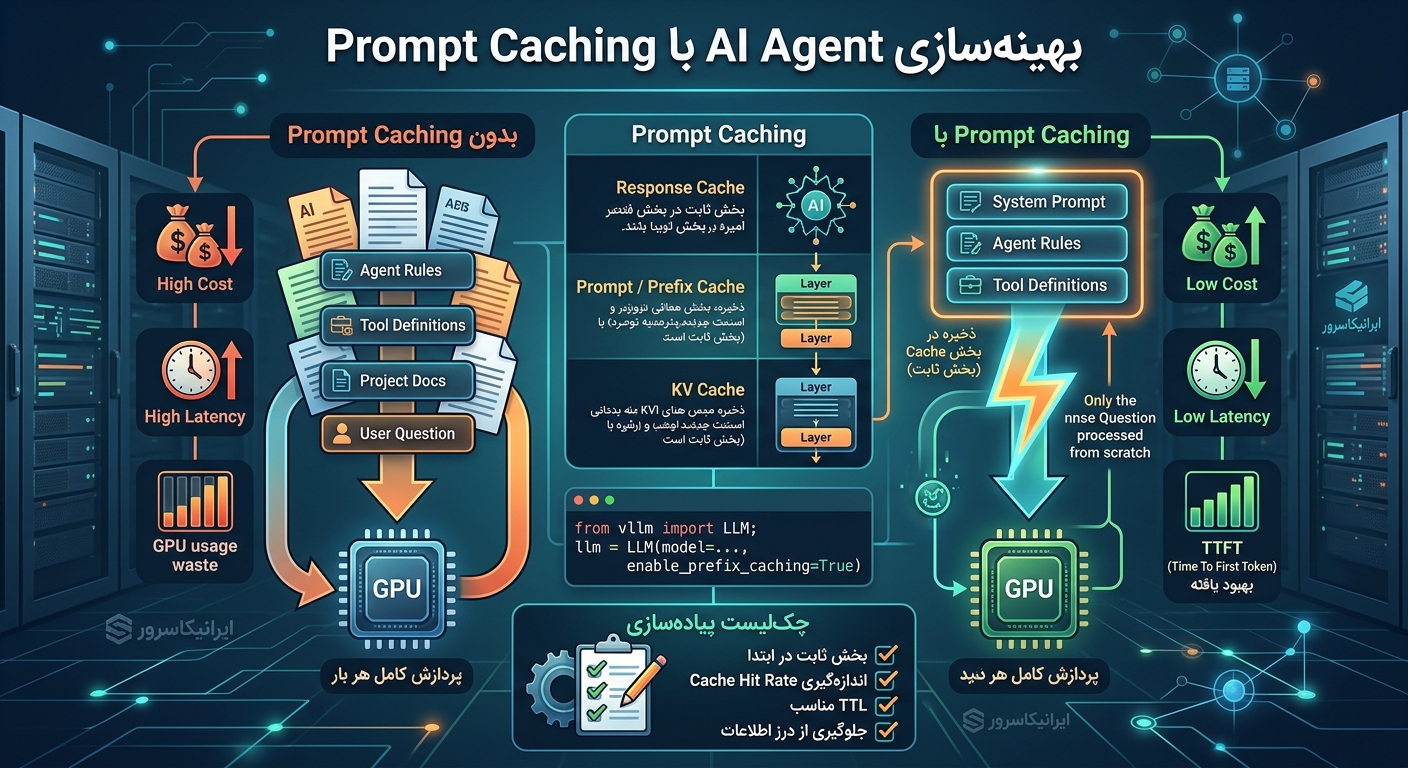
آموزشی 📅 8 مهر 1405 Prompt Caching چیست؟ راهنمای کامل کاهش هزینه و زمان پاسخ AI Agentها با کش کردن Context تصور کنید یک AI Agent سازمانی دارید که روزانه هزاران درخواست دریافت میکند. هر درخواست شامل یک System Prompt بزرگ،...
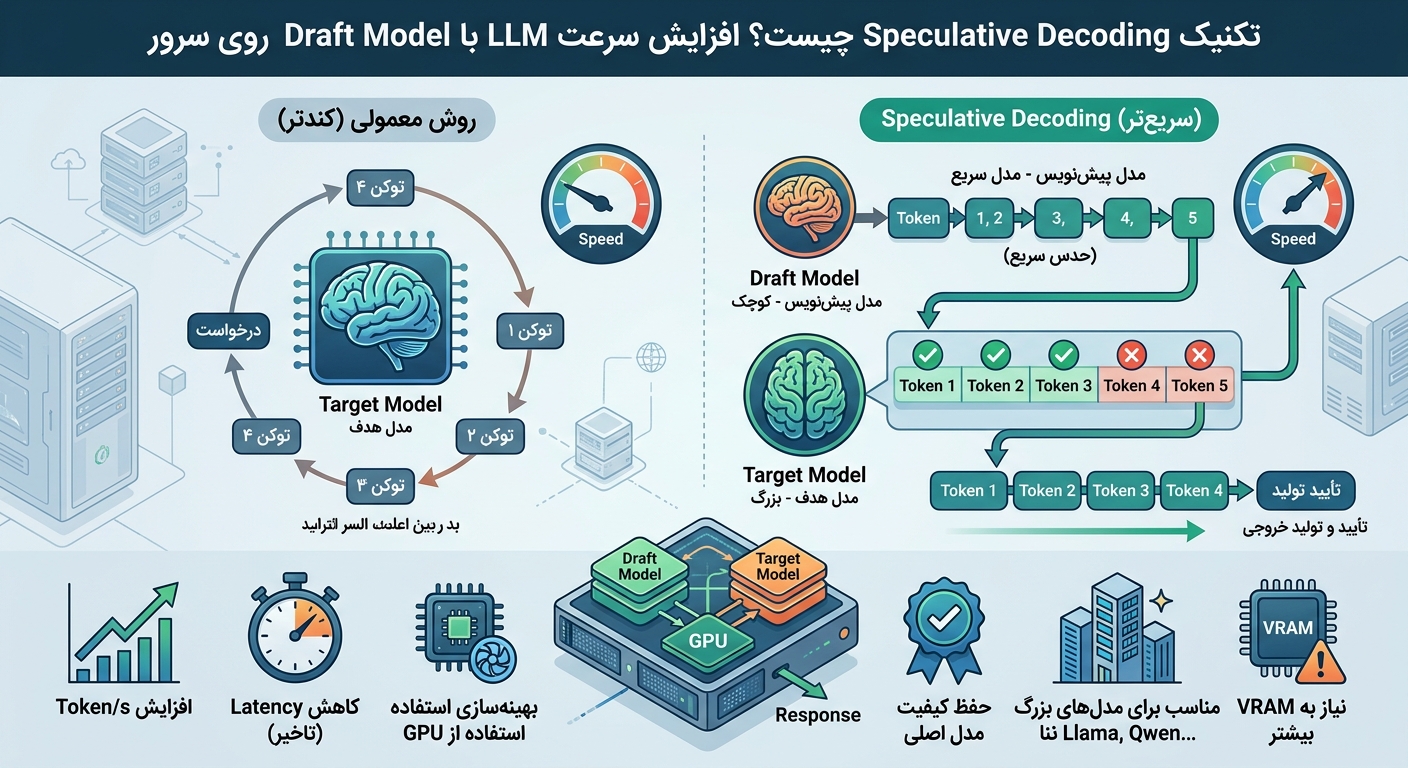
آموزشی 📅 8 مهر 1405 Speculative Decoding چیست؟ راهنمای عملی افزایش سرعت LLM روی سرور GPU اگر روی سرور خود یک مدل زبانی بزرگ مثل Llama 70B یا Qwen 32B اجرا میکنید، احتمالاً با این مشکل...
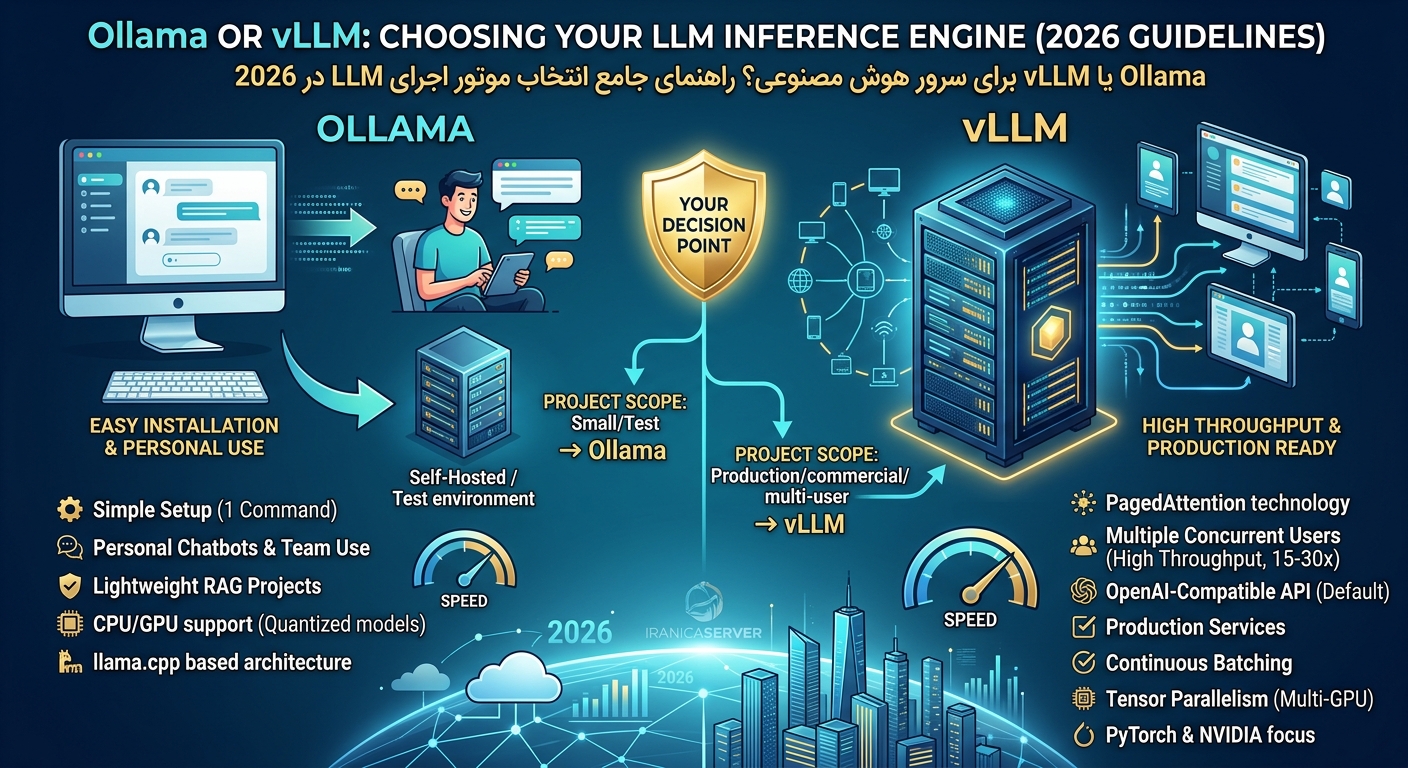
آموزشی 📅 5 مهر 1405 Ollama یا vLLM برای سرور هوش مصنوعی؟ راهنمای جامع انتخاب موتور اجرای LLM در 2026 اگر قصد راهاندازی سرور هوش مصنوعی شخصی یا سرویس API مبتنی بر LLM دارید، احتمالاً با دو نام آشنا روبرو...