
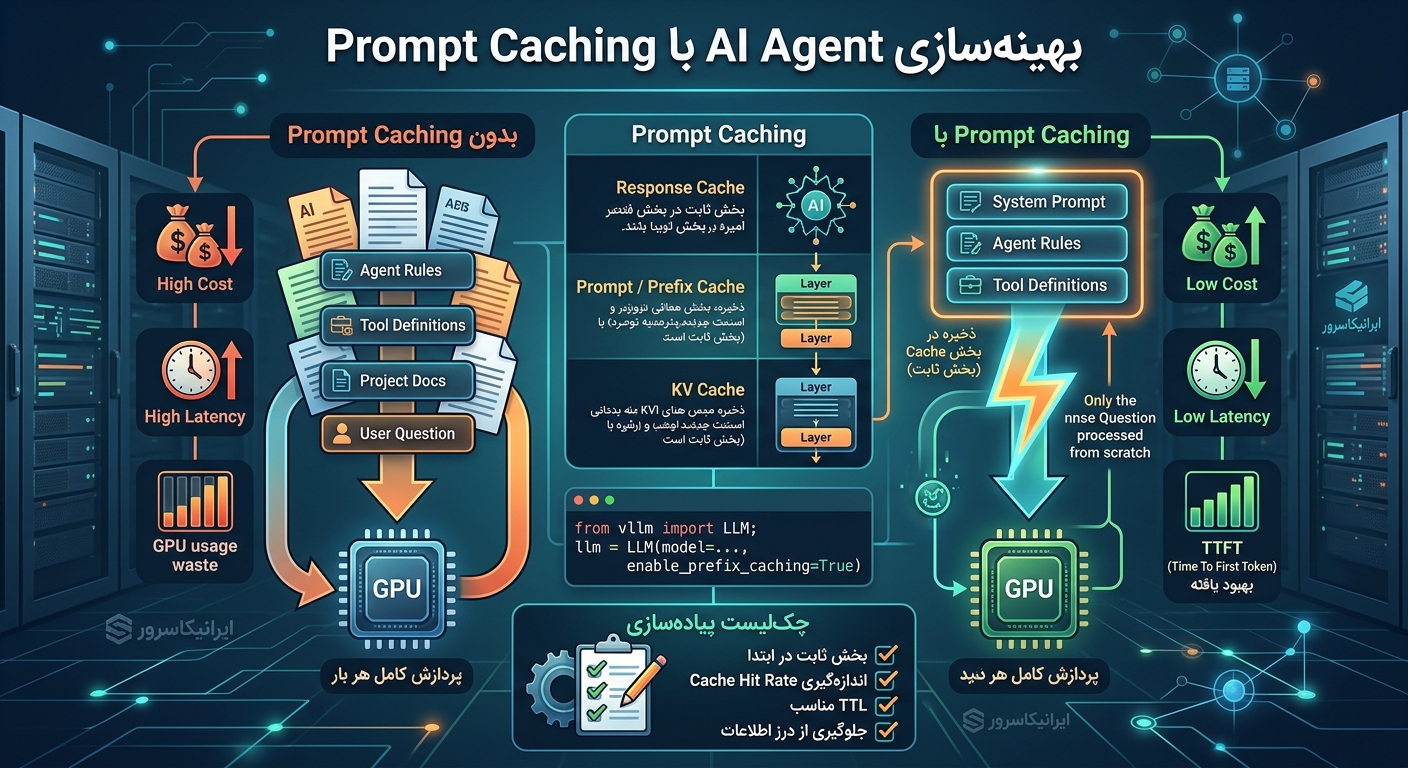
تصور کنید یک AI Agent سازمانی دارید که روزانه هزاران درخواست دریافت میکند. هر درخواست شامل یک System Prompt بزرگ، تعریف ابزارها، قوانین شرکت و دستورالعملهای ثابت است. حالا اگر همین بخش ثابت در هر درخواست دوباره از ابتدا پردازش شود، چه اتفاقی میافتد؟ هزینه سرسامآور، تأخیر بالا و هدر رفتن منابع GPU. اینجاست که Prompt Caching وارد میشود و معادله را کاملاً تغییر میدهد.
Prompt Caching دقیقاً چیست و چه مشکلی را حل میکند؟
Prompt Caching یک تکنیک بهینهسازی است که به مدل زبانی اجازه میدهد بخشهای تکراری ورودی را یک بار پردازش کند و در درخواستهای بعدی از نتیجه ذخیرهشده استفاده کند. به زبان ساده، اگر بخش ابتدایی Prompt شما در چندین درخواست یکسان باشد، سیستم آن را Cache میکند و برای درخواستهای بعدی دوباره از صفر پردازش نمیکند [citation:13].
تحقیقات آکادمیک نشان میدهد Prompt Caching میتواند هزینه API را بین ۴۱ تا ۸۰ درصد کاهش دهد و زمان تا اولین توکن (TTFT) را ۱۳ تا ۳۱ درصد بهبود بخشد [citation:17]. این اعداد در مقیاس سازمانی تفاوت بین یک سرویس مقرونبهصرفه و یک پروژه ورشکسته است.
🔹 بدون Prompt Caching: هر درخواست = پردازش کامل Context (مثلاً ۲۰,۰۰۰ توکن) از ابتدا
🔹 با Prompt Caching: درخواست اول = پردازش + ذخیره | درخواستهای بعدی = فقط پردازش بخش جدید
🔹 نتیجه: کاهش چشمگیر بار Prefill روی GPU و آزاد شدن ظرفیت برای کاربران بیشتر
چرا AI Agentها بدون Prompt Caching عملاً غیراقتصادی میشوند؟
یک AI Agent معمولی بسیار سنگینتر از یک چتبات ساده است. فرض کنید یک Agent برنامهنویسی دارید که در هر درخواست این اطلاعات را ارسال میکند:
System Prompt + Agent Rules + Tool Definitions + Project Documentation
+ Coding Standards + Security Guidelines + Conversation History
+ User Question
واقعیت این است که در ۹۰ درصد موارد، تنها بخش کوچکی از این Context — یعنی سؤال کاربر — تغییر میکند. اگر تمام این حجم عظیم در هر درخواست دوباره پردازش شود، شما در واقع دارید برای یک کار تکراری پول و منابع پرداخت میکنید.
خوشبختانه Prompt Caching دقیقاً برای همین سناریو طراحی شده است. تحقیقات نشان میدهد System Prompt پایدارترین بخش یک Agent است و بهترین کاندید برای Cache شدن. در مقابل، تاریخچه مکالمه و نتایج Toolها معمولاً Dynamic هستند و برای Cache مناسب نیستند [citation:2].
⚠️ نکته حیاتی: اگر یک timestamp یا session ID در ابتدای System Prompt قرار دهید، هر درخواست یک Prefix متفاوت ایجاد میکند و Cache هرگز فعال نمیشود. محتوای Dynamic را همیشه در انتهای Prompt قرار دهید [citation:18].
🚀 سرور مجازی ایرانیکاسرور؛ زیرساخت بهینه برای AI Agent و LLM
اگر قصد دارید AI Agent یا سرویس LLM خود را روی سرور اختصاصی اجرا کنید، منابع سختافزاری نقش تعیینکنندهای دارند. سرور مجازی ایرانیکاسرور با منابع اختصاصی CPU و RAM، دیسک NVMe پرسرعت برای جلوگیری از I/O Wait در بارگذاری مدل و پهنای باند پایدار، بستر ایدهآلی برای اجرای vLLM، Prefix Caching و سرویسهای هوش مصنوعی فراهم میکند. آپتایم بالا و پشتیبانی ۲۴/۷ تضمین میکند Agent شما همیشه در دسترس باشد.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
تفاوت Prompt Caching با KV Cache و Response Cache چیست؟
یکی از رایجترین اشتباهات، یکسان فرض کردن این سه مفهوم است. در حالی که هر کدام در لایه متفاوتی از معماری عمل میکنند و هدف متفاوتی دارند.
| نوع Cache | هدف اصلی | لایه عملکرد |
|---|---|---|
| Response Cache | ذخیره پاسخ کامل برای سؤال یکسان | سطح Application |
| Prompt / Prefix Cache | استفاده مجدد از Context یا Prefix تکراری | سطح Request |
| KV Cache | کاهش محاسبات Attention در زمان Generation | سطح Inference Engine |
نکته کلیدی این است که Prompt Caching و KV Cache مکمل یکدیگرند، نه جایگزین. در معماریهای مدرن مثل vLLM، Prefix Caching به KV Cache متصل میشود تا پردازش مجدد Prefix جلوگیری شود [citation:3].
Prefix Caching در vLLM چگونه کار میکند؟
اگر مدل را به صورت Local روی سرور خود اجرا میکنید، vLLM یکی از محبوبترین موتورهای Inference است. vLLM قابلیتی به نام Automatic Prefix Caching (APC) دارد که به صورت خودکار KV Cache مربوط به Prefix مشترک را بین درخواستها به اشتراک میگذارد [citation:3].
برای فعالسازی این قابلیت، فقط کافی است هنگام راهاندازی vLLM پارامتر مربوطه را فعال کنید:
from vllm import LLMllm = LLM(
model=”meta-llama/Llama-3.2-3B-Instruct”,
enable_prefix_caching=True
)
وقتی این قابلیت فعال باشد، vLLM محاسبه KV Cache برای Prefix مشترک را ذخیره میکند و برای درخواستهای بعدی فقط بخش جدید (مثلاً سؤال جدید کاربر) را پردازش میکند [citation:3]. این یعنی GPU شما به جای پردازش ۲۰,۰۰۰ توکن تکراری، فقط ۵۰ توکن جدید را پردازش میکند.
🔹 Long Document Q&A: پرسیدن سؤالات متعدد از یک سند طولانی
🔹 Multi-turn Conversations: تاریخچه مکالمهای که به تدریج رشد میکند
🔹 System Prompts سنگین: دستورالعملهای ثابت در تمام درخواستها
🔹 Tool Definitions: Schema ثابت برای Function Calling
آیا Prompt Caching واقعاً به کاهش هزینه کمک میکند؟
بله، اما میزان صرفهجویی به Provider و نحوه قیمتگذاری بستگی دارد. در OpenAI، توکنهای Cache شده با تخفیف تا ۹۵ درصد نسبت به توکنهای ورودی عادی محاسبه میشوند [citation:13]. در Fireworks AI، این تخفیف پیشفرض ۵۰ درصد است و در استقرارهای Dedicated، توکنهای Cache شده تقریباً رایگان محسوب میشوند [citation:18].
اما یک نکته مهم وجود دارد: در مدلهای جدیدتر مثل GPT-5.6 و پس از آن، نوشتن در Cache ممکن است هزینه اضافی داشته باشد [citation:1]. بنابراین باید مطمئن شوید که بخش ثابت Prompt واقعاً بین درخواستها یکسان باقی میماند، وگرنه هزینه Cache Write بدون سود Cache Read پرداخت میکنید.
⚠️ هشدار: اگر Prompt شما کمتر از ۱۰۲۴ توکن باشد، معمولاً واجد شرایط Cache شدن نیست. حداقل طول Cacheable در Providerهای مختلف بین ۱,۰۲۴ تا ۴,۰۹۶ توکن متغیر است [citation:2][citation:9].
بهترین ساختار Prompt برای بیشترین Cache Hit
رعایت یک اصل ساده میتواند تفاوت بین ۲۰٪ و ۸۰٪ Cache Hit Rate باشد: محتوای ثابت را در ابتدا، محتوای متغیر را در انتها قرار دهید.
[STATIC CONTENT — CACHEABLE]
System Instructions
Agent Rules
Tool Definitions
Company Policies
Few-shot Examples[DYNAMIC CONTENT — PROCESSED FRESH]
User Question
Current Date/Time
RAG Results
Tool Outputs
این ساختار به سیستم اجازه میدهد بزرگترین Prefix ممکن را Cache کند. اگر ترتیب را برعکس کنید و timestamp را در ابتدا بگذارید، هر درخواست یک Prefix کاملاً جدید ایجاد میکند و Cache Hit Rate به صفر میرسد [citation:6][citation:18].
Cache Hit Rate را چگونه اندازهگیری کنیم؟
بدون اندازهگیری، نمیتوانید مطمئن شوید Prompt Caching واقعاً کار میکند. خوشبختانه اکثر سرویسها فیلد cached_tokens را در پاسخ API برمیگردانند [citation:6][citation:14].
معیارهای کلیدی که باید رصد کنید:
🔹 Cache Hit Rate: درصد درخواستهایی که بخشی از Prompt را از Cache خواندهاند
🔹 Cached Tokens: تعداد توکنهایی که از Cache سرو شدهاند
🔹 Input Tokens (Uncached): توکنهایی که به صورت تازه پردازش شدهاند
🔹 TTFT (Time to First Token): زمان تا اولین توکن پاسخ
🔹 Request Latency: زمان کل پاسخدهی
چالشهای امنیتی و مدیریت Cache
Prompt Caching قدرتمند است، اما بدون طراحی مناسب میتواند به یک خطر امنیتی تبدیل شود. بزرگترین ریسک زمانی رخ میدهد که اطلاعات خصوصی یک کاربر به اشتباه در Cache مشترک قرار بگیرد.
تصور کنید User A یک سند محرمانه را در Context خود دارد و User B بعداً درخواستی با Prefix مشابه ارسال میکند. اگر سیستم به اشتباه Cache User A را به User B سرو کند، اطلاعات محرمانه به بیرون درز کرده است.
⚠️ راهکار: Context را به لایههای جداگانه تقسیم کنید:
🔹 Public Static Context: قابل Cache برای همه کاربران
🔹 Private User Context: فقط برای یک کاربر، هرگز در Cache مشترک قرار نگیرد
🔹 Private Organization Context: مخصوص سازمان، با سیاست Cache جداگانه
🔹 Dynamic Context: همیشه تازه پردازش شود
آیا Prompt Caching روی مصرف VRAM تأثیر دارد؟
Prompt Caching مصرف VRAM را حذف نمیکند، بلکه آن را مدیریت میکند. Cache خودش به حافظه نیاز دارد و اگر بخواهید TTL طولانیتر داشته باشید، باید منابع بیشتری اختصاص دهید.
در Azure OpenAI، قابلیت Extended Cache Retention تا ۲۴ ساعت، از تکنیک offload کردن تنسورهای KV به حافظه محلی GPU استفاده میکند تا فضای بیشتری برای Cache فراهم شود [citation:1]. این یعنی Cache نه تنها VRAM را حذف نمیکند، بلکه میتواند مصرف را افزایش دهد — اما در عوض پردازش تکراری GPU را به شدت کاهش میدهد.
Prompt Caching در مقابل افزایش سختافزار
وقتی AI Agent کند میشود، دو راه پیش رو دارید: خرید GPU قویتر یا بهینهسازی نرمافزاری. Prompt Caching یکی از مؤثرترین راههای دسته دوم است.
تحقیقات نشان میدهد در بسیاری از موارد، گلوگاه اصلی کمبود قدرت GPU نیست، بلکه پردازش تکراری یک Context بسیار بزرگ است. با Cache کردن بخش ثابت، همان GPU میتواند چندین برابر درخواست بیشتری را سرو کند [citation:2].
🔧 مشکل در کانفیگ سرور یا اجرای AI Agent دارید؟
تیم فنی ایرانیکاسرور آماده کمک به شماست. اگر در راهاندازی vLLM، فعالسازی Prefix Caching، یا بهینهسازی مصرف VRAM به مشکل خوردهاید، درخواست خود را از طریق صفحه کانفیگ و رفع مشکل ارسال کنید. کارشناسان ما در کمترین زمان پاسخگوی شما خواهند بود.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
چکلیست پیادهسازی Prompt Caching
قبل از اینکه Prompt Caching را در محیط Production فعال کنید، این موارد را بررسی کنید:
🔹 اندازه System Prompt و Context را دقیقاً میدانید؟
🔹 بخش ثابت و Dynamic را از هم جدا کردهاید؟
🔹 محتوای ثابت در ابتدای Prompt قرار دارد؟
🔹 هیچ timestamp یا session ID در ابتدای Prompt نیست؟
🔹 Tool Definitions بین درخواستها ثابت میمانند؟
🔹 Cache Hit Rate را اندازهگیری میکنید؟
🔹 استراتژی Cache Invalidation دارید؟
🔹 اطلاعات خصوصی در Cache مشترک قرار نمیگیرد؟
🔹 TTL مناسب برای بار کاری خود تعیین کردهاید؟
جمعبندی: Prompt Caching یک انتخاب لوکس نیست، یک ضرورت است
Prompt Caching دیگر یک تکنیک اختیاری نیست؛ برای هر سازمانی که AI Agent یا سرویس LLM را در مقیاس واقعی اجرا میکند، یک ضرورت است. با کاهش ۴۱ تا ۸۰ درصدی هزینهها و بهبود ۱۳ تا ۳۱ درصدی TTFT [citation:17]، این تکنیک میتواند تفاوت بین یک پروژه موفق و یک پروژه شکستخورده باشد.
نکته کلیدی این است که Prompt Caching جایگزین سایر تکنیکهای بهینهسازی مثل Quantization، KV Cache و Batching نیست، بلکه در کنار آنها قرار میگیرد. ترکیب این تکنیکها میتواند یک سرور GPU را به یک ماشین سروینگ بسیار کارآمد تبدیل کند.
اگر قصد دارید AI Agent خود را روی زیرساخت پایدار و اختصاصی اجرا کنید، سرور مجازی ایرانیکاسرور با منابع اختصاصی و پشتیبانی فنی ۲۴/۷ آماده همکاری با شماست.
سوالات متداول درباره Prompt Caching
آیا Prompt Caching به صورت خودکار فعال است؟
در اکثر سرویسهای ابری مثل OpenAI و Fireworks AI، Prompt Caching به صورت پیشفرض برای مدلهای پشتیبانیشده فعال است [citation:13][citation:18]. در vLLM باید به صورت دستی با پارامتر enable_prefix_caching فعال شود [citation:3].
آیا Prompt Caching با Quantization قابل ترکیب است؟
بله. این دو تکنیک اهداف متفاوتی دارند. Quantization اندازه وزنهای مدل را کاهش میدهد، در حالی که Prompt Caching پردازش تکراری ورودی را کاهش میدهد. میتوانید از هر دو به صورت همزمان استفاده کنید.
حداقل طول Prompt برای Cache شدن چقدر است؟
در OpenAI حداقل ۱۰۲۴ توکن است [citation:13][citation:9]. در سایر Providerها این عدد بین ۱,۰۲۴ تا ۴,۰۹۶ توکن متغیر است [citation:2]. اگر Prompt شما کوتاهتر باشد، معمولاً Cache نمیشود.
آیا Prompt Caching برای RAG هم مفید است؟
بله، اما با یک شرط: بخش ثابت RAG (دستورالعملها، قوانین پاسخدهی، فرمت خروجی) را جدا از نتایج Dynamic بازیابی کنید. اگر هر بار اسناد کاملاً متفاوتی بازیابی شوند، Cache Hit Rate پایین خواهد بود [citation:2].
آیا Cache شدن اطلاعات حساس خطر امنیتی دارد؟
بله، اگر بدون طراحی مناسب پیادهسازی شود. اطلاعات خصوصی یک کاربر هرگز نباید در Cache مشترک قرار بگیرد. Context را به لایههای Public، Private و Dynamic تقسیم کنید و برای هر لایه سیاست Cache جداگانه تعریف کنید.







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.