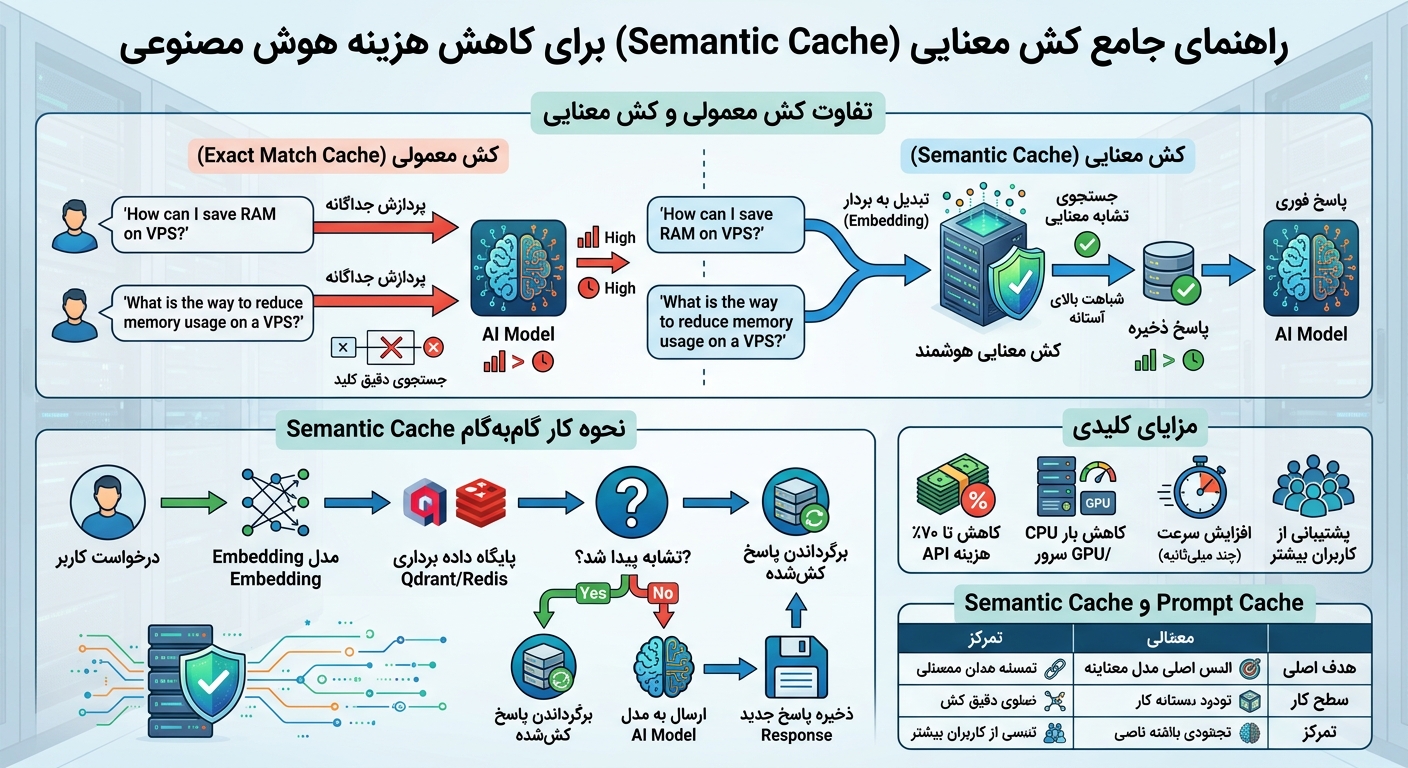
آموزشی 📅 8 مهر 1405 Semantic Cache چیست؟ راهنمای کامل ساخت کش معنایی برای API هوش مصنوعی و کاهش هزینه و زمان پاسخ اگر یک چتبات، AI Agent، سیستم RAG یا API هوش مصنوعی دارید، احتمالاً بخشی از درخواستهای کاربران از نظر معنا...
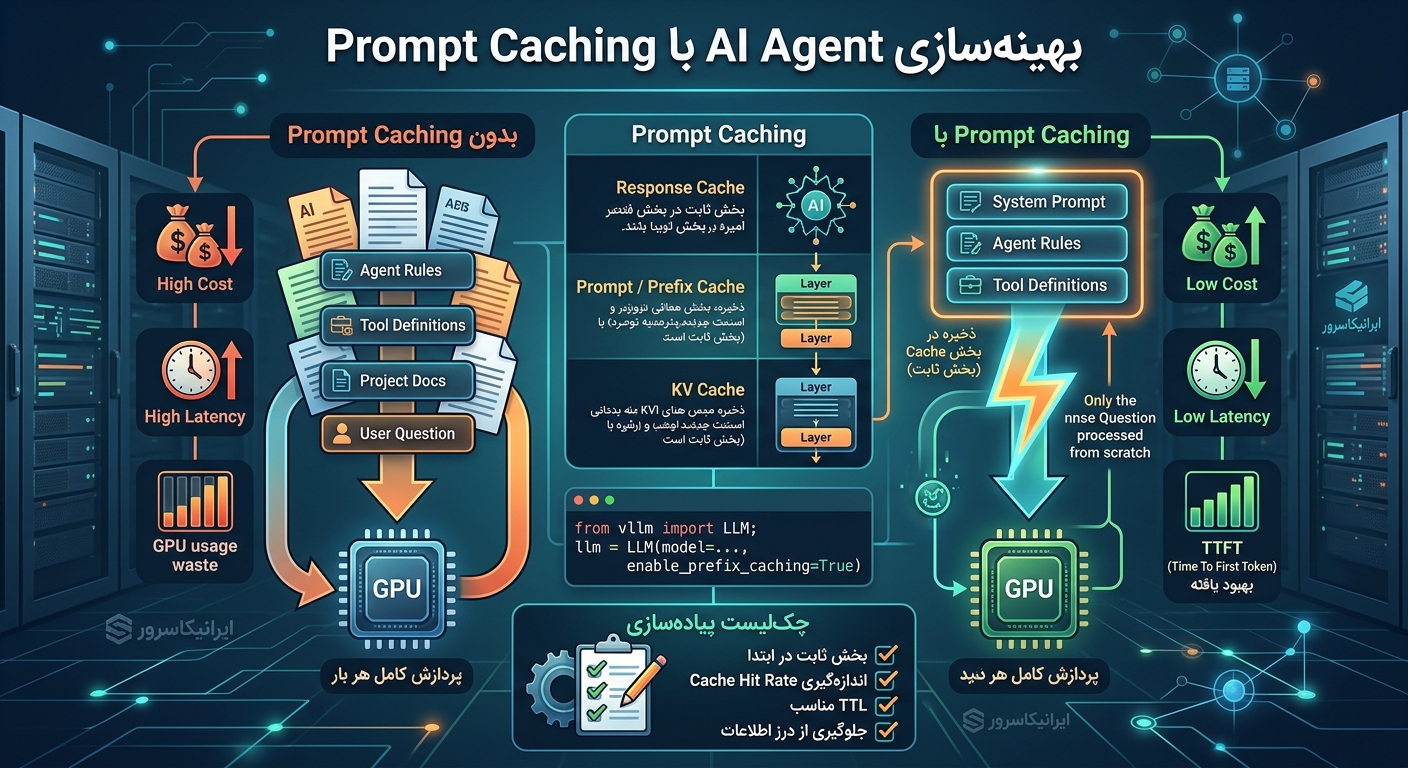
آموزشی 📅 8 مهر 1405 Prompt Caching چیست؟ راهنمای کامل کاهش هزینه و زمان پاسخ AI Agentها با کش کردن Context تصور کنید یک AI Agent سازمانی دارید که روزانه هزاران درخواست دریافت میکند. هر درخواست شامل یک System Prompt بزرگ،...
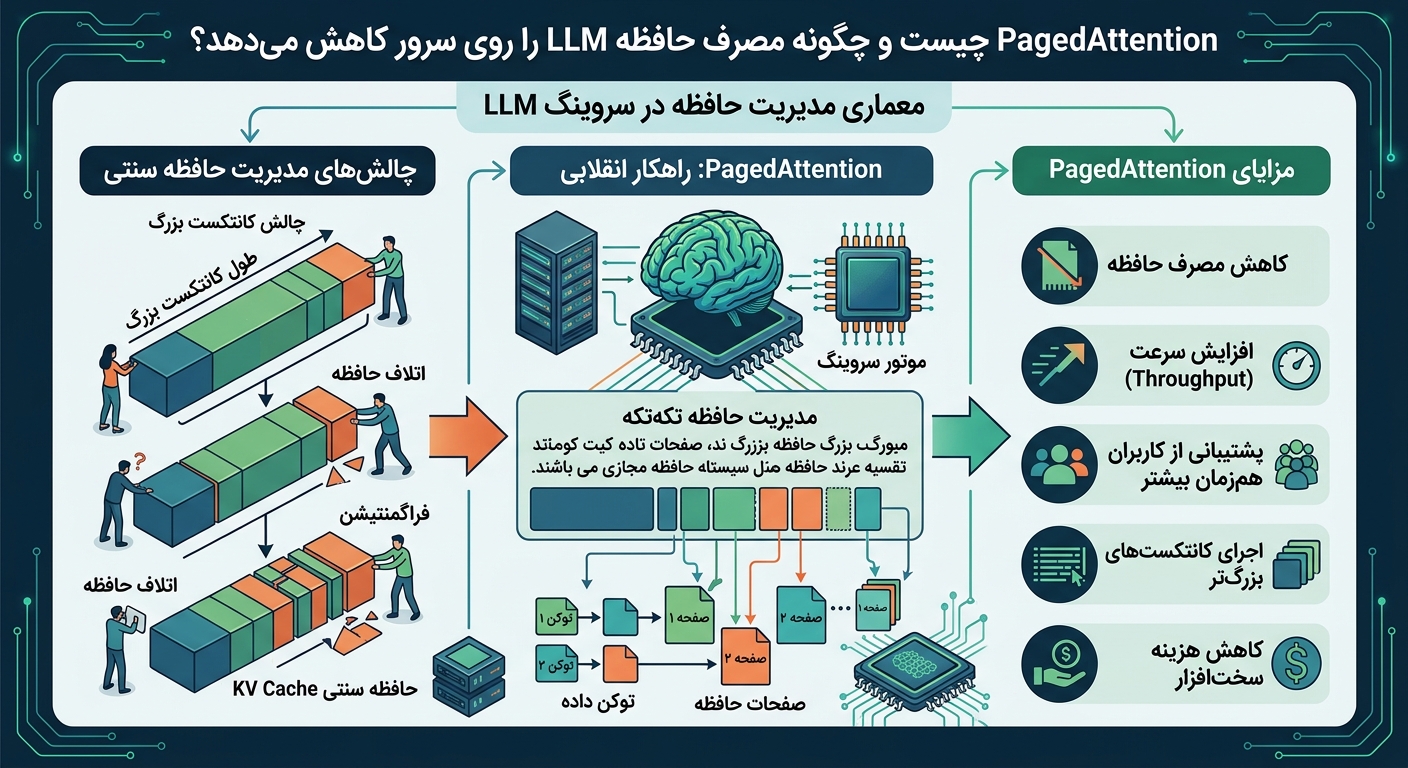
آموزشی 📅 8 مهر 1405 PagedAttention چیست؟ راهنمای کامل کاهش مصرف حافظه LLM روی سرور GPU اگر روی یک سرور GPU مدل زبانی بزرگ سرو میکنید، احتمالاً با این واقعیت روبهرو شدهاید که با وجود VRAM...
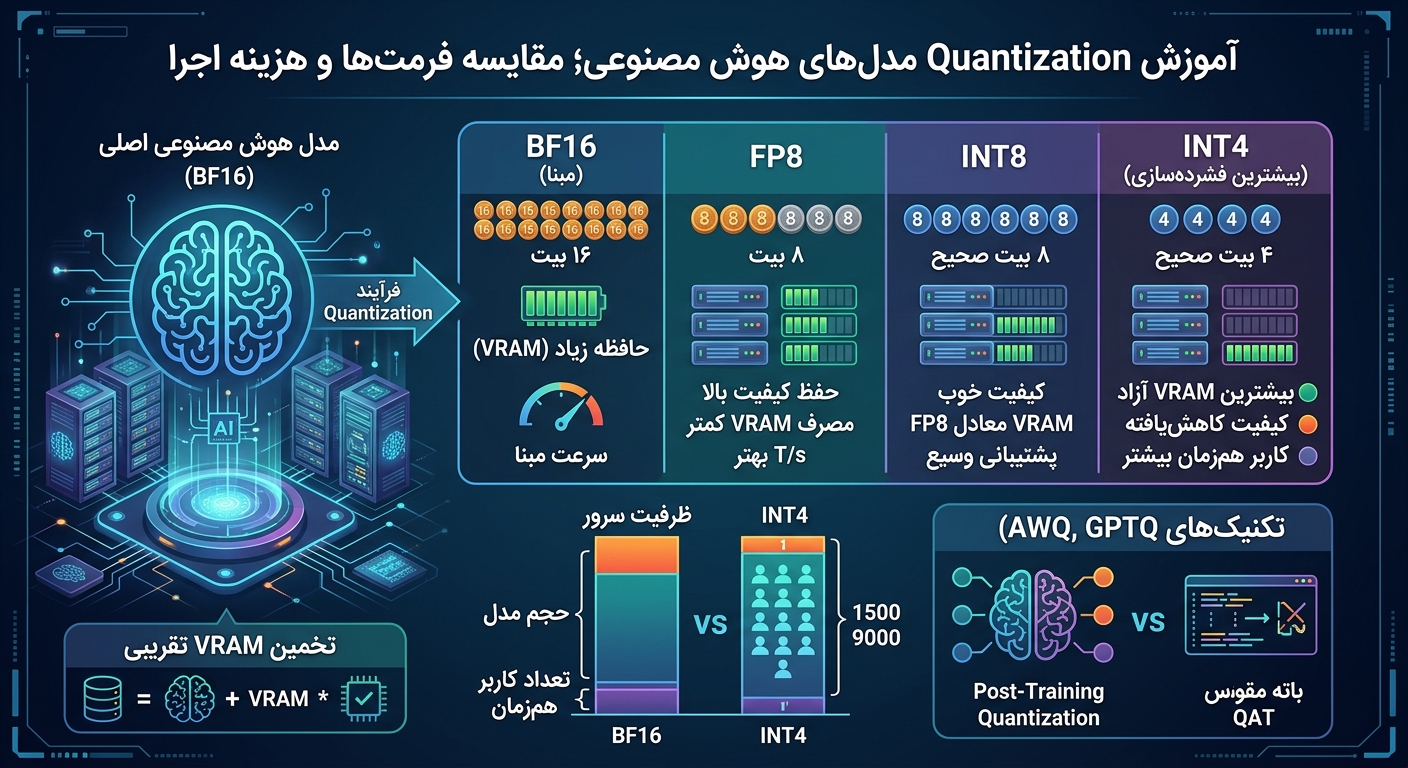
آموزشی 📅 8 مهر 1405 Quantization مدلهای هوش مصنوعی: تفاوت INT4، INT8، FP8 و BF16 در مصرف منابع سرور اجرای مدلهای زبانی بزرگ روی سرور شخصی، یکی از جذابترین روشها برای ساخت سرویسهای AI خصوصی، چتبات، RAG و API...
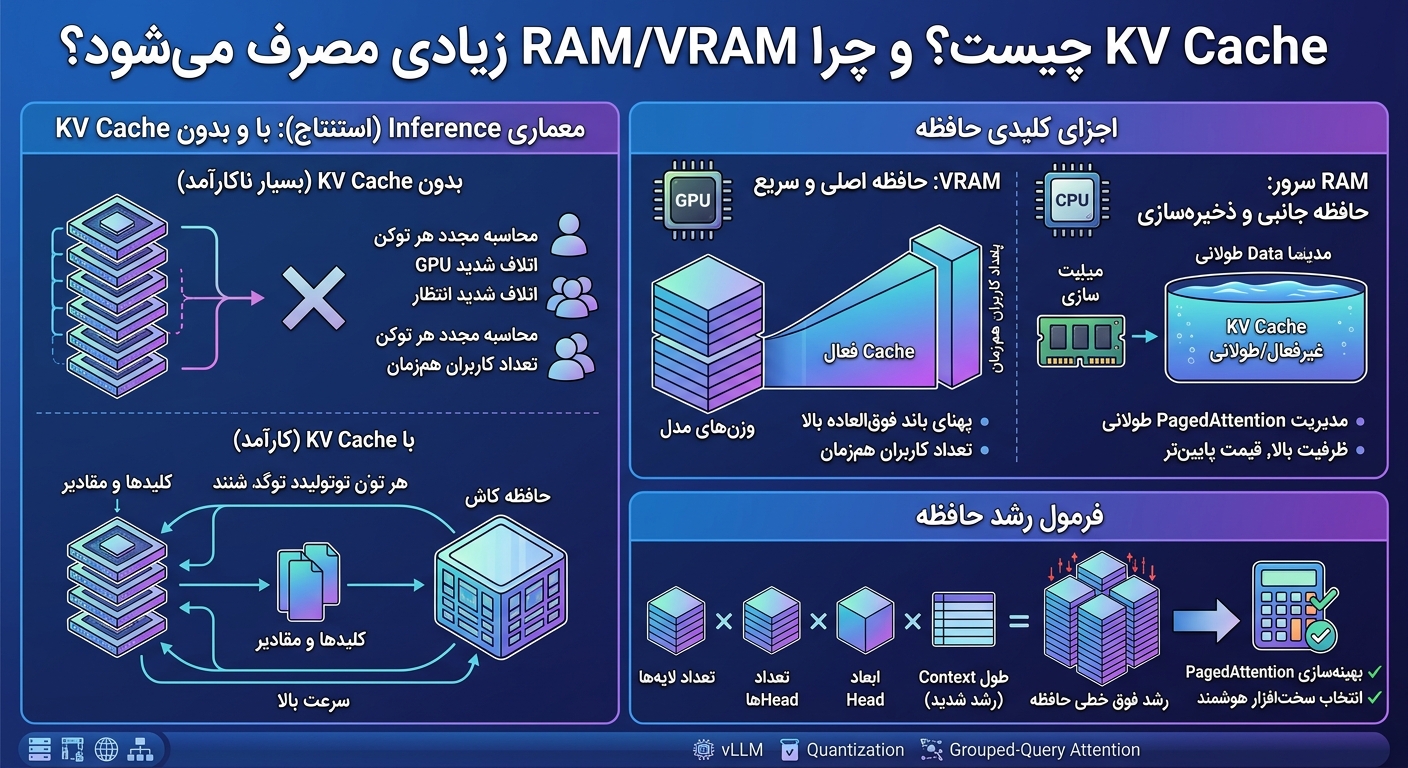
آموزشی 📅 8 مهر 1405 KV Cache و بحران حافظه در سرورهای هوش مصنوعی: چرا VRAM شما کافی نیست؟ تصور کنید یک سرور مجازی قدرتمند با یک کارت گرافیک حرفهای اجاره کردهاید. همهچیز طبق محاسبات شما پیش میرود: حجم...
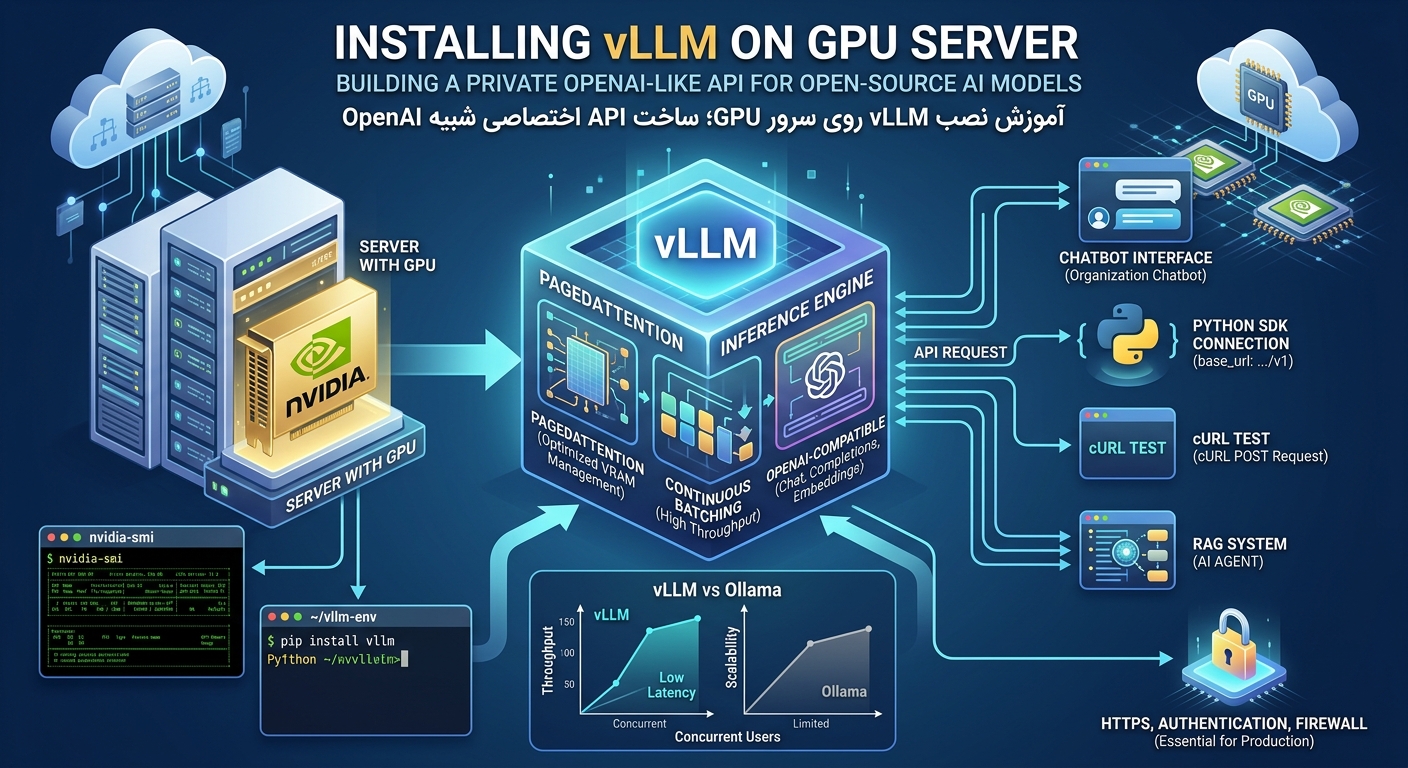
آموزشی 📅 5 مهر 1405 آموزش نصب vLLM روی سرور GPU؛ ساخت API اختصاصی شبیه OpenAI برای مدلهای هوش مصنوعی متنباز اگر قصد دارید یک مدل زبانی بزرگ متنباز را روی سرور خودتان اجرا کنید و بهجای وابستگی به APIهای خارجی،...