
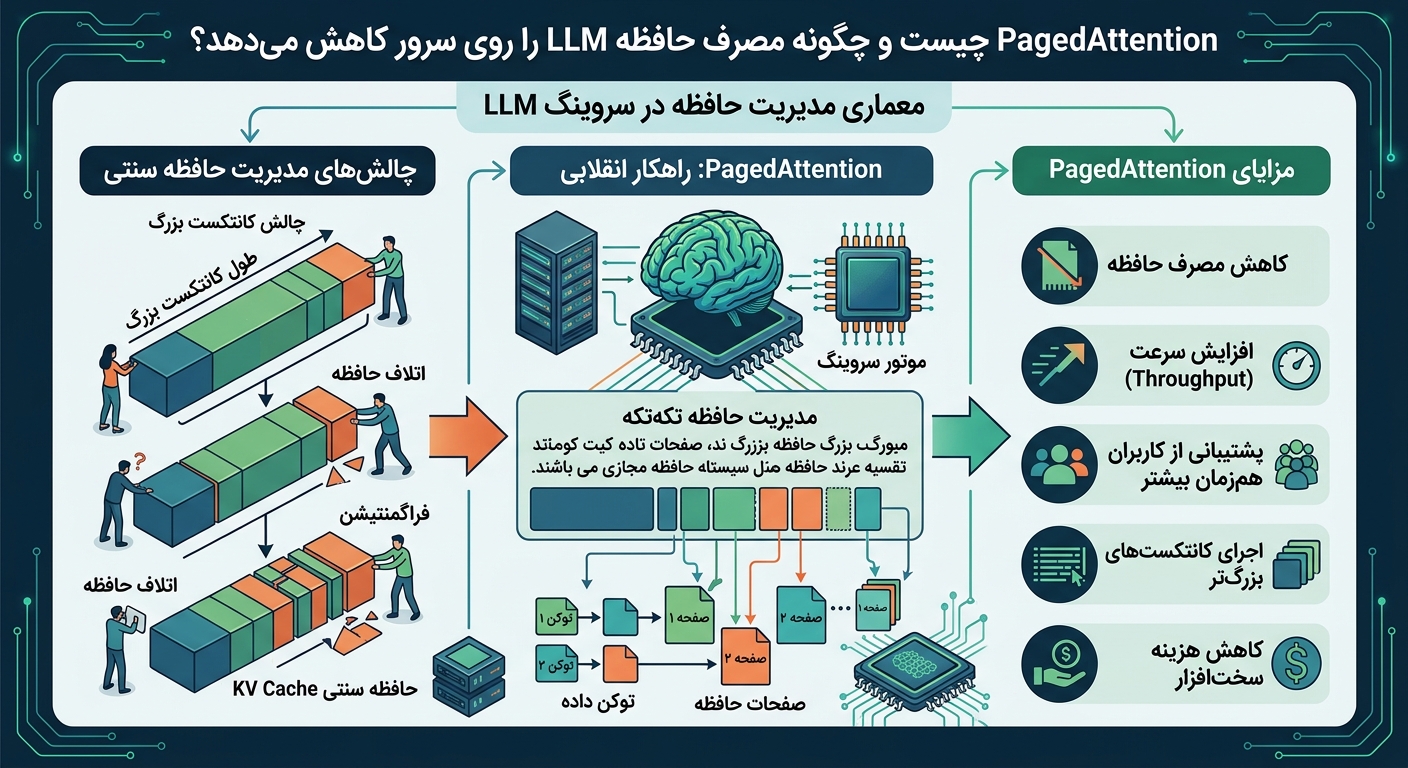
اگر روی یک سرور GPU مدل زبانی بزرگ سرو میکنید، احتمالاً با این واقعیت روبهرو شدهاید که با وجود VRAM کافی، تعداد کاربران همزمان پایینتر از انتظار است. ریشه این مشکل در بخشی از حافظه به نام KV Cache نهفته است که به شکل سنتی مدیریت میشود.
در این مقاله، هم مفهوم PagedAttention را دقیق توضیح میدهیم، هم نشان میدهیم که چرا این تکنیک مسیر سروینگ LLM را تغییر داده است. اگر به فکر راهاندازی سرویس هوش مصنوعی چندکاربره یا انتخاب سرور مناسب برای اجرای مدل هستید، این مطلب برای شماست.
🔹 PagedAttention یک تکنیک مدیریت KV Cache است که ایده آن از حافظه مجازی سیستمعامل گرفته شده.
🔹 این تکنیک ابتدا در پروژه vLLM معرفی شد و امروزه به استانداردی در موتورهای سروینگ LLM تبدیل شده است.
🔹 با تقسیم KV Cache به بلوکهای کوچک، هدررفت حافظه GPU از ۶۰–۸۰٪ به کمتر از ۵٪ کاهش مییابد.
چرا مدیریت KV Cache به گلوگاه اصلی سروینگ LLM تبدیل شده است؟
هنگام اجرای یک مدل زبانی بزرگ روی GPU، حافظه به چند بخش تقسیم میشود:
├── Model Weights
├── KV Cache
├── Activations
└── سایر بافرها
وزنهای مدل ثابت هستند، اما KV Cache پویا است و با هر درخواست جدید رشد میکند. در سرویسهای چندکاربره، همین بخش پویا به گلوگاه اصلی تبدیل میشود.
محاسبه سرانگشتی: چرا VRAM زود تمام میشود؟
فرض کنید یک مدل ۱۳B روی GPU با ۸۰GB VRAM سرو میکنید. پس از کسر وزنهای مدل و بافرهای اجرایی، حدود ۴۰GB برای KV Cache باقی میماند. اگر هر درخواست بخواهد فضایی معادل ۱۶,۳۸۴ توکن رزرو کند، با فرض ۳۲۰KB حافظه برای هر توکن، هر درخواست حدود ۵GB اشغال میکند.
یعنی تنها ۸ درخواست همزمان در GPU جا میشوند — در حالی که اکثر مکالمات واقعی بسیار کوتاهتر هستند و هرگز به ۱۶K توکن نمیرسند.
⚠️ نکته مهم: در روشهای سنتی تخصیص حافظه، فقط ۲۰.۴٪ تا ۳۸.۲٪ از حافظه تخصیصیافته به KV Cache واقعاً استفاده میشود. باقی آن هدر میرود.
سه منبع اصلی هدررفت حافظه
🔹 رزرو برای توکنهایی که هرگز تولید نمیشوند — سیستم فضایی را برای طول حداکثری خروجی کنار میگذارد، حتی اگر پاسخ واقعی کوتاه باشد.
🔹 تکهتکه شدن داخلی — فضای خالی باقیمانده در انتهای تخصیصها.
🔹 تکهتکه شدن خارجی — فضای آزادی که به دلیل پراکندگی درخواستهای با طول متغیر قابل استفاده نیست.
PagedAttention چگونه کار میکند؟ الهام از سیستمعامل
ایده اصلی PagedAttention مستقیماً از حافظه مجازی سیستمعامل گرفته شده است. در یک سیستمعامل، فرایندها تصور میکنند حافظهای پیوسته در اختیار دارند، اما مدیر حافظه در واقع صفحات فیزیکی را در نقاط مختلف RAM قرار میدهد. PagedAttention همین کار را با KV Cache انجام میدهد.
تقسیم KV Cache به بلوکهای کوچک
بهجای اینکه KV Cache یک درخواست، فضایی بزرگ و پیوسته اشغال کند، آن را به KV Blockهای کوچک تقسیم میکنیم. اندازه پیشفرض این بلوکها در vLLM معمولاً ۱۶ توکن است.
Block 0 → توکن 1 تا 16
Block 1 → توکن 17 تا 32
Block 2 → توکن 33 تا 48
جدول نگاشت: حافظه منطقی در مقابل حافظه فیزیکی
هر درخواست یک Block Table دارد که مشخص میکند هر بلوک منطقی در کدام بلوک فیزیکی حافظه GPU قرار گرفته است. این بلوکها لازم نیست پشت سر هم باشند.
Logical Block 1 → Physical Block 1
Logical Block 2 → Physical Block 3
این معماری به vLLM اجازه میدهد تا حافظه را بهصورت دقیقاً بر اساس نیاز تخصیص دهد. وقتی توکن جدیدی تولید میشود، فقط در صورت پر شدن بلوک فعلی، یک بلوک فیزیکی جدید اختصاص مییابد.
برای اجرای سرویس هوش مصنوعی چندکاربره، به زیرساخت درست نیاز دارید
اگر قصد راهاندازی API هوش مصنوعی، چتبات سازمانی یا سرویس LLM چندکاربره دارید، یک سرور مجازی با منابع اختصاصی میتواند تفاوت چشمگیری در پایداری و Throughput ایجاد کند. ایرانیکاسرور با ارائه سرورهای مجازی ایران و خارج، بستر مناسب برای اجرای موتورهای سروینگ مدرن مانند vLLM را فراهم میکند.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
نتایج عملی: چند برابر شدن ظرفیت سروینگ
تأثیر این تغییر در معماری، چند برابر است. یک تحلیل جامع روی GPU A100-80GB نشان میدهد که در حالی که تخصیص سنتی در Batch Size حدود ۱۶ به سقف حافظه میخورد و حدود ۴۲۰ توکن بر ثانیه پردازش میکند، PagedAttention میتواند تا Batch Size ۱۲۸ پیش برود و به ۶,۸۰۰ توکن بر ثانیه برسد — رشدی معادل ۱۶.۲ برابر.
| معیار | تخصیص سنتی (پیوسته) | PagedAttention |
|---|---|---|
| نرخ هدررفت حافظه | ۶۰–۸۰٪ | کمتر از ۵٪ |
| حداکثر Batch Size روی A100-80GB | حدود ۱۶ | تا ۱۲۸ |
| Throughput (Llama 3.1 8B) | حدود ۴۲۰ توکن/ثانیه | تا ۶,۸۰۰ توکن/ثانیه |
| اشتراکگذاری KV Cache | غیرممکن | در سطح بلوک |
قابلیت اشتراکگذاری بلوکها
یکی از مزایای کلیدی معماری بلوکی، امکان اشتراکگذاری KV Cache بین درخواستها است. وقتی چند درخواست یک Prefix مشترک دارند — مثلاً یک System Prompt یکسان برای همه کاربران یک سازمان — بلوکهای مربوط به آن Prefix میتوانند در حافظه مشترک باشند.
vLLM برای مدیریت این اشتراکگذاری از Reference Counting و Copy-on-Write استفاده میکند. هر بلوک فیزیکی یک شمارنده دارد که تعداد بلوکهای منطقی اشارهکننده به آن را نشان میدهد. وقتی یکی از درخواستها بخواهد در بلوک مشترک بنویسد، vLLM یک بلوک جدید تخصیص میدهد و محتوا را کپی میکند.
این مکانیزم در سناریوهایی مانند Beam Search و Parallel Sampling که چند دنباله خروجی از یک ورودی مشترک تولید میشوند، صرفهجویی حافظه قابلتوجهی ایجاد میکند.
PagedAttention در برابر تکنیکهای دیگر
PagedAttention را نباید با Quantization اشتباه گرفت. این دو تکنیک دو مشکل متفاوت را حل میکنند:
| تکنیک | هدف اصلی |
|---|---|
| Quantization | کاهش حجم و دقت وزنهای مدل |
| PagedAttention | مدیریت بهینه KV Cache و حافظه سروینگ |
| Prefix Caching | استفاده مجدد از KV Cache مشترک |
| Continuous Batching | افزایش بهرهوری پردازش درخواستها |
همچنین PagedAttention با FlashAttention که یک تکنیک بهینهسازی محاسبه Attention است، تفاوت دارد. این دو میتوانند در کنار یکدیگر استفاده شوند.
محدودیتها و ملاحظات
PagedAttention راهحل تمام مشکلات حافظه LLM نیست. حجم وزنهای مدل همچنان به قوت خود باقی است و PagedAttention آن را کاهش نمیدهد. برای مدلهای بسیار بزرگ، همچنان به Tensor Parallelism یا Quantization نیاز خواهید داشت. همچنین Context بسیار طولانی همچنان پرهزینه است و مدیریت بلوکها سربار اجرایی خاص خود را دارد.
⚠️ توجه: PagedAttention حجم مدل را کاهش نمیدهد. اگر مدل ۷۰B دارید، همچنان به GPU با VRAM کافی یا Tensor Parallelism نیاز دارید.
جایگاه vLLM در اکوسیستم سروینگ
PagedAttention و vLLM یکی نیستند. PagedAttention یک تکنیک مدیریت KV Cache است، در حالی که vLLM یک موتور سروینگ کامل است که از این تکنیک استفاده میکند. vLLM امروزه بهعنوان گزینه پیشفرض برای سروینگ تولیدی LLM شناخته میشود و علاوه بر PagedAttention، قابلیتهایی مانند Continuous Batching، Prefix Caching و Chunked Prefill را ارائه میدهد.
برای تیمهایی که به فکر سروینگ چندکاربره LLM روی سرور مجازی GPU هستند، درک PagedAttention فقط یک بحث دانشگاهی نیست. این تکنیک مستقیماً روی تعداد کاربران همزمان، Throughput و ظرفیت واقعی سرور تأثیر میگذارد.
سوالات متداول
PagedAttention دقیقاً چه کاری انجام میدهد؟
KV Cache هر درخواست را به بلوکهای کوچک (معمولاً ۱۶ توکن) تقسیم میکند و امکان ذخیره غیرپیوسته آنها در حافظه GPU را فراهم میسازد.
آیا PagedAttention حجم مدل را کاهش میدهد؟
خیر. این تکنیک فقط KV Cache را مدیریت میکند و تأثیری بر حجم وزنهای مدل ندارد.
PagedAttention چقدر Throughput را افزایش میدهد؟
در آزمایشها، افزایش تا ۱۶ برابر در Throughput گزارش شده است (از ۴۲۰ به ۶,۸۰۰ توکن بر ثانیه روی A100-80GB).
آیا PagedAttention فقط در vLLM استفاده میشود؟
مفهوم PagedAttention ابتدا در vLLM معرفی شد، اما امروزه موتورهای دیگر نیز از مفاهیم مشابه استفاده میکنند.
آیا PagedAttention برای سروینگ روی CPU هم کاربرد دارد؟
خیر. این تکنیک برای سروینگ GPU طراحی شده است، جایی که مدیریت VRAM و KV Cache حیاتی است.
آیا PagedAttention با Quantization قابل ترکیب است؟
بله. این دو تکنیک مشکلات متفاوتی را حل میکنند و میتوانند همزمان استفاده شوند.
جمعبندی
PagedAttention با الهام از حافظه مجازی سیستمعامل، مشکل دیرینه هدررفت حافظه در سروینگ LLM را حل میکند. با تقسیم KV Cache به بلوکهای کوچک و غیرپیوسته، هدررفت حافظه از ۶۰–۸۰٪ به زیر ۵٪ کاهش مییابد و ظرفیت سروینگ GPU چند برابر میشود.
این تکنیک که در vLLM پیادهسازی شده، امروزه به استانداردی در موتورهای سروینگ LLM تبدیل شده است. اگر به فکر راهاندازی سرویس هوش مصنوعی چندکاربره هستید، PagedAttention یکی از مفاهیمی است که باید در طراحی زیرساخت خود مدنظر قرار دهید.
پستهای مرتبط
با مشکل کانفیگ سرور روبهرو شدهاید؟
اگر در فرایند نصب یا کانفیگ سرور برای اجرای مدلهای زبانی به مشکل خوردهاید، تیم پشتیبانی ایرانیکاسرور آماده کمک است. کافیست درخواست خود را از طریق صفحه کانفیگ ارسال کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
📌 منابع برای مطالعه بیشتر:







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.