
رفع خطای CUDA Out of Memory در vLLM؛ آموزش عیبیابی و کاهش مصرف GPU Memory
اگر هنگام اجرای یک مدل زبانی با vLLM با پیام CUDA out of memory مواجه شدهاید، احتمالاً اولین راهحلی که پیدا میکنید…
مجموعه آموزشها و راهنماهای مرتبط با این موضوع را در این صفحه دنبال کنید.
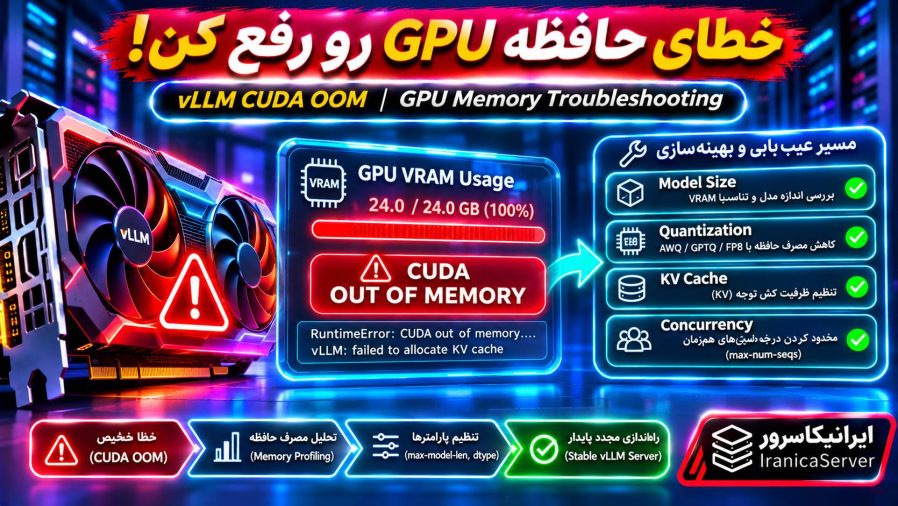
اگر هنگام اجرای یک مدل زبانی با vLLM با پیام CUDA out of memory مواجه شدهاید، احتمالاً اولین راهحلی که پیدا میکنید…
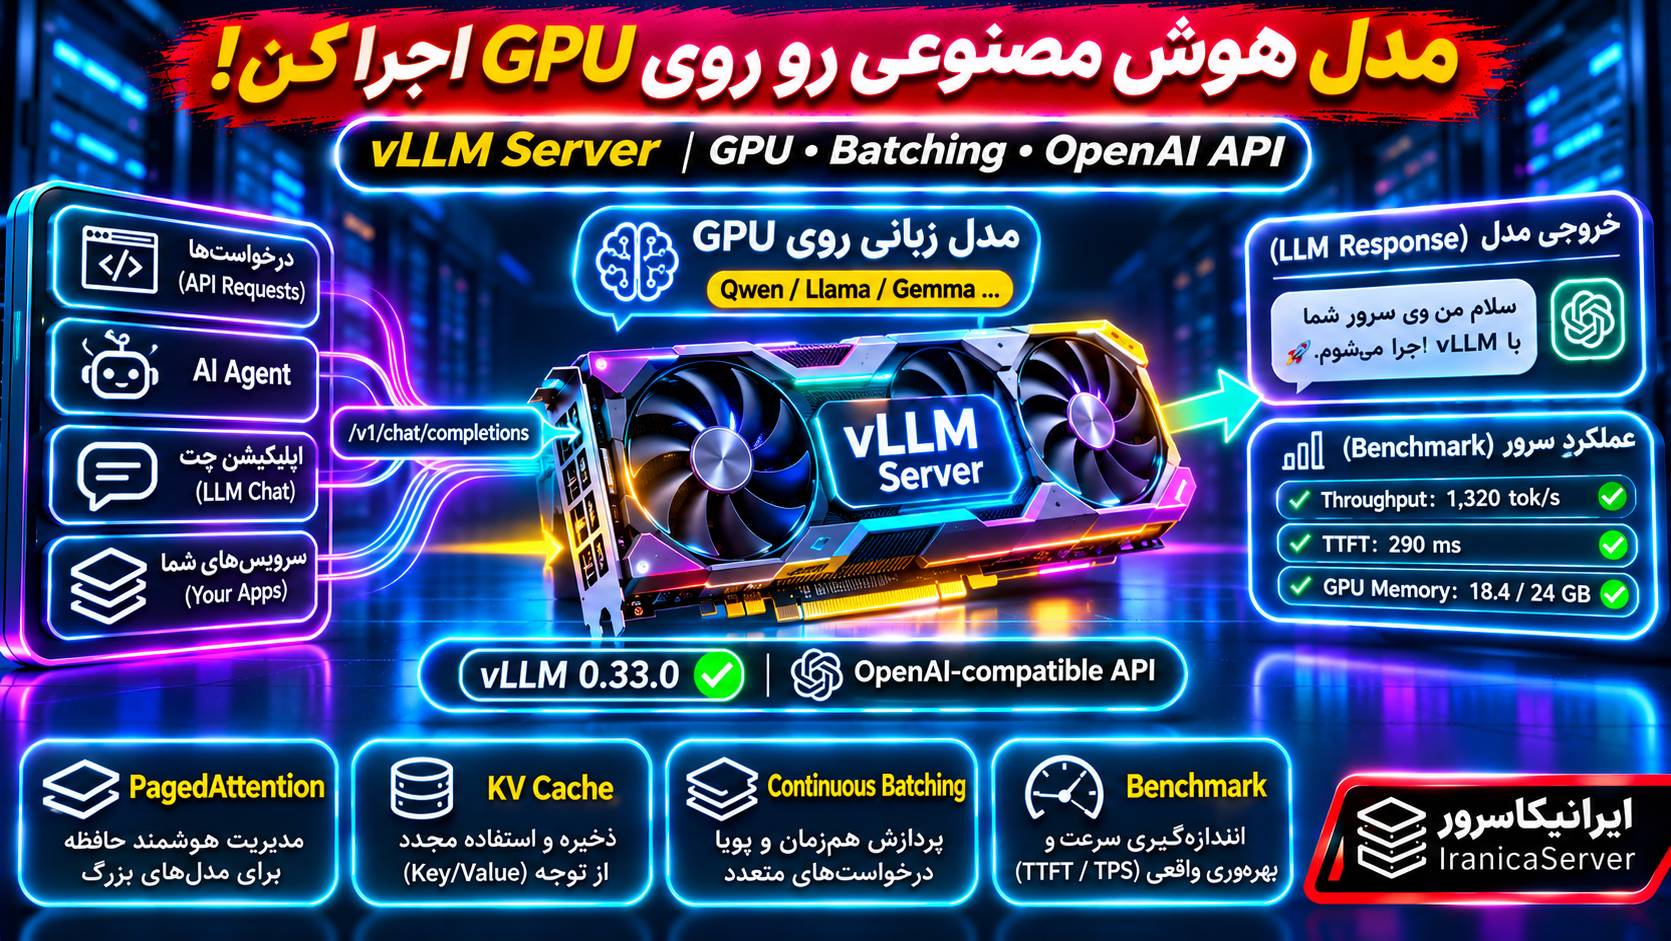
اگر بخواهید یک مدل هوش مصنوعی متنباز را روی سرور خود اجرا کنید و از طریق وبسایت، نرمافزار یا Agent به آن…
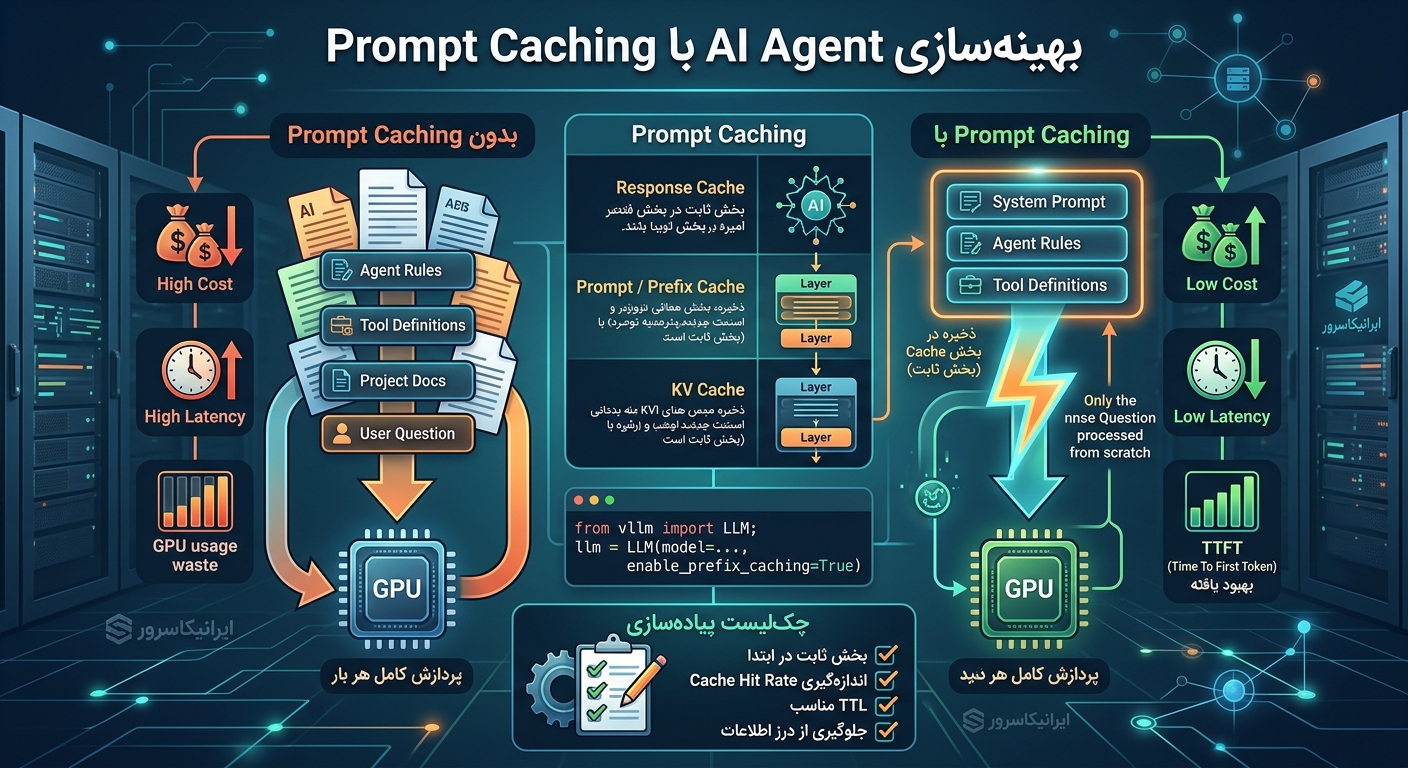
تصور کنید یک AI Agent سازمانی دارید که روزانه هزاران درخواست دریافت میکند. هر درخواست شامل یک System Prompt بزرگ، تعریف ابزارها،…
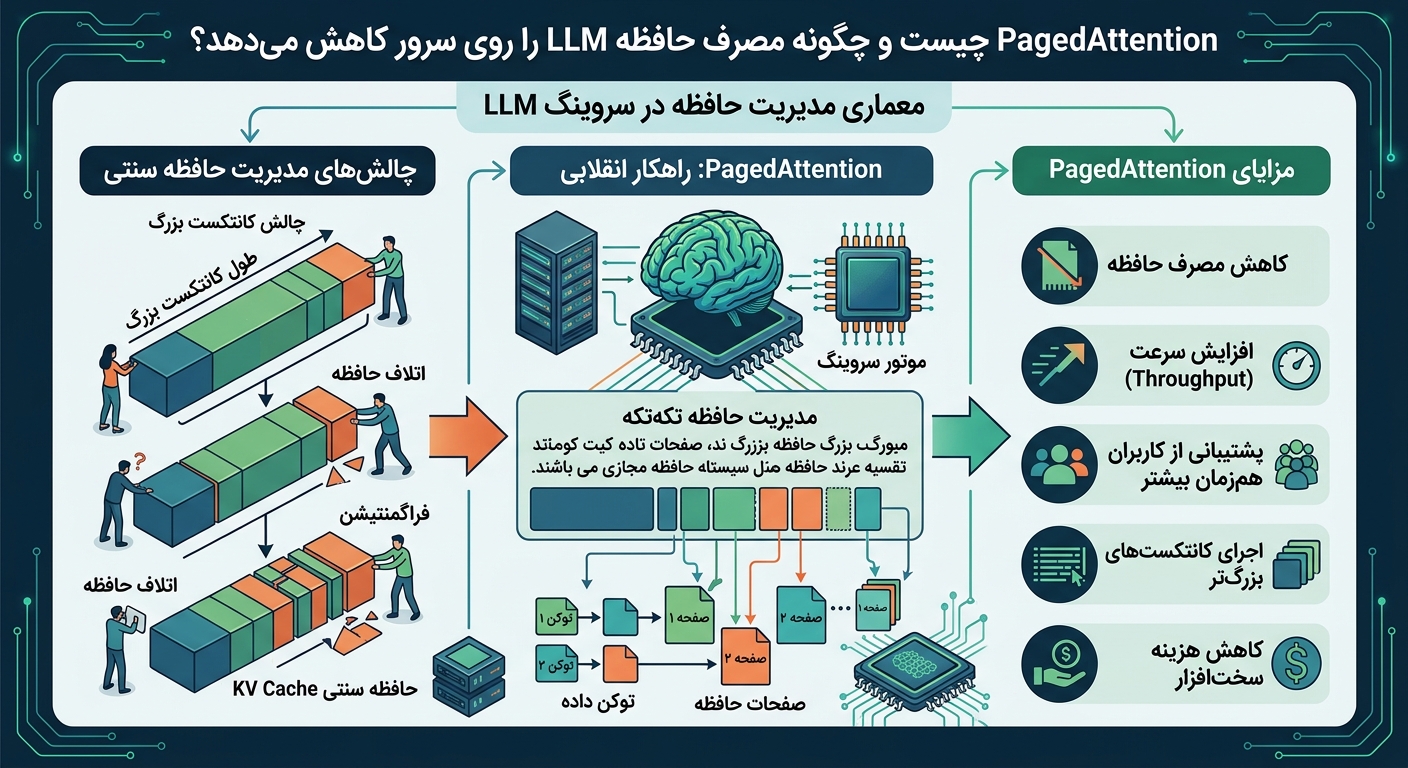
اگر روی یک سرور GPU مدل زبانی بزرگ سرو میکنید، احتمالاً با این واقعیت روبهرو شدهاید که با وجود VRAM کافی، تعداد…
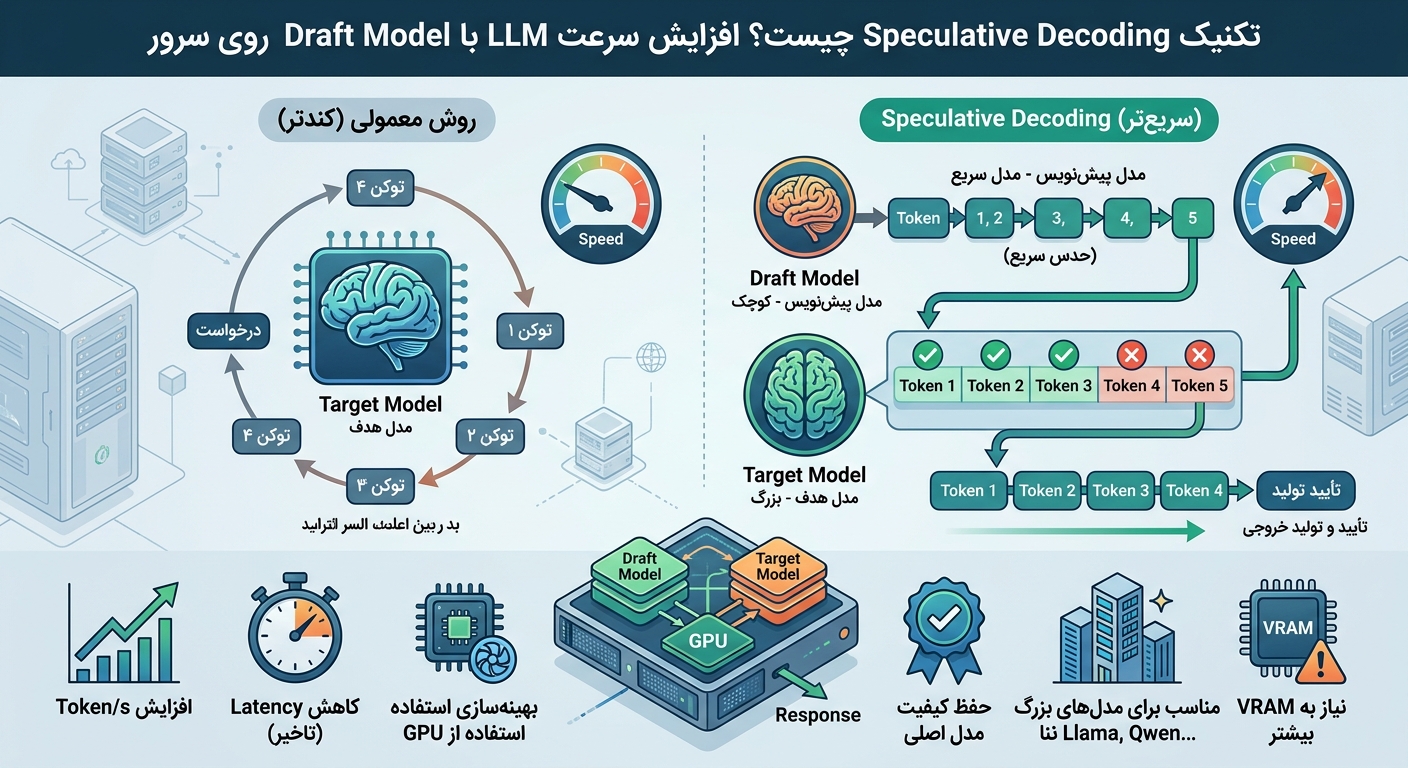
اگر روی سرور خود یک مدل زبانی بزرگ مثل Llama 70B یا Qwen 32B اجرا میکنید، احتمالاً با این مشکل آشنا هستید:…
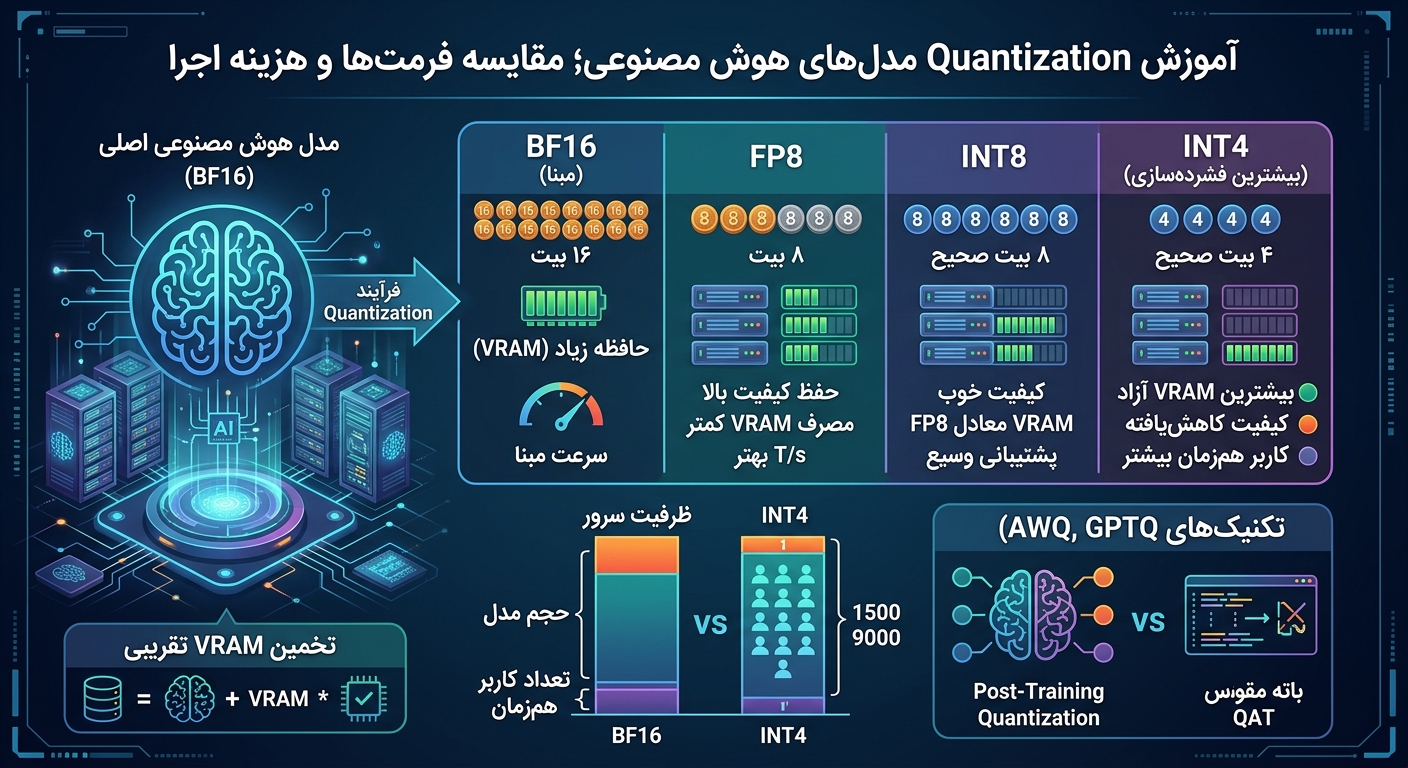
اجرای مدلهای زبانی بزرگ روی سرور شخصی، یکی از جذابترین روشها برای ساخت سرویسهای AI خصوصی، چتبات، RAG و API اختصاصی است.…
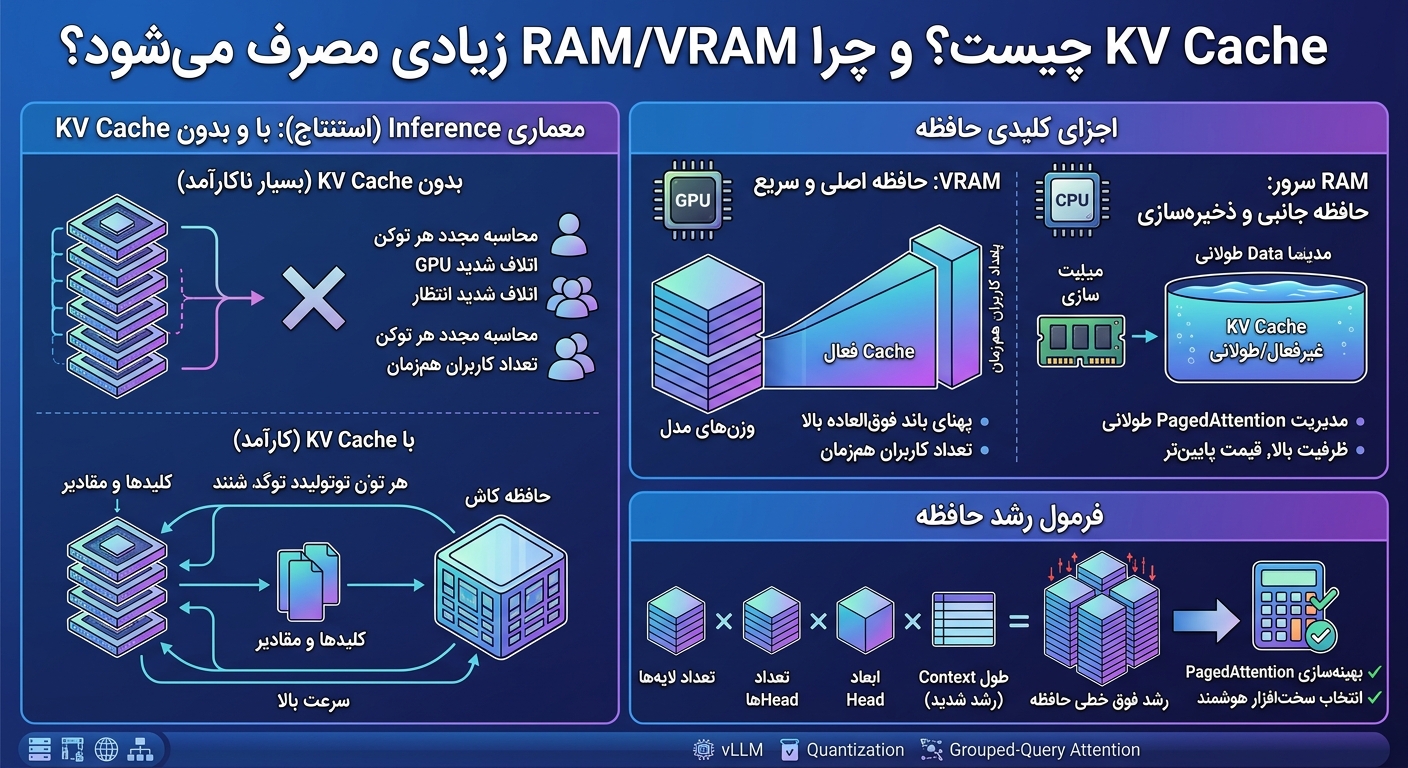
تصور کنید یک سرور مجازی قدرتمند با یک کارت گرافیک حرفهای اجاره کردهاید. همهچیز طبق محاسبات شما پیش میرود: حجم فایل مدل…
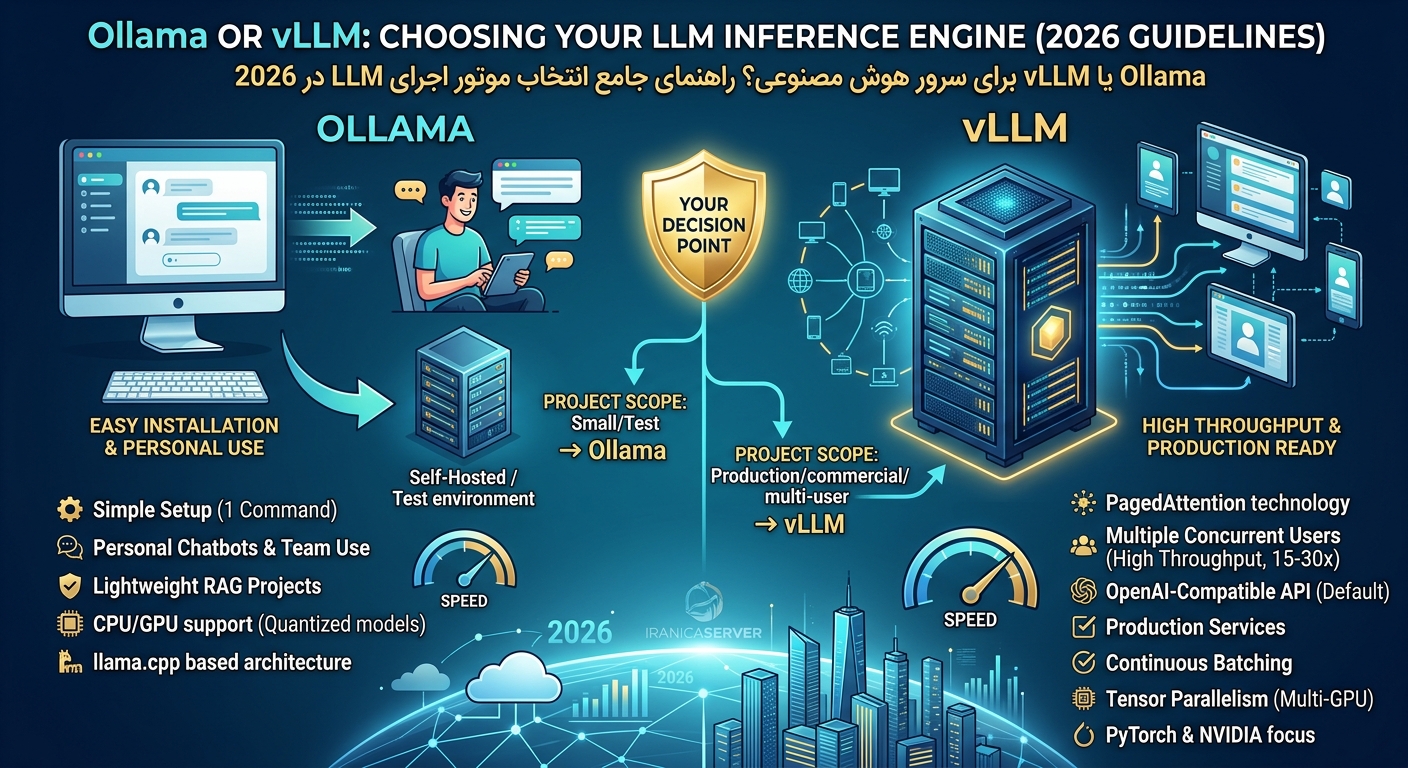
اگر قصد راهاندازی سرور هوش مصنوعی شخصی یا سرویس API مبتنی بر LLM دارید، احتمالاً با دو نام آشنا روبرو شدهاید: Ollama…