
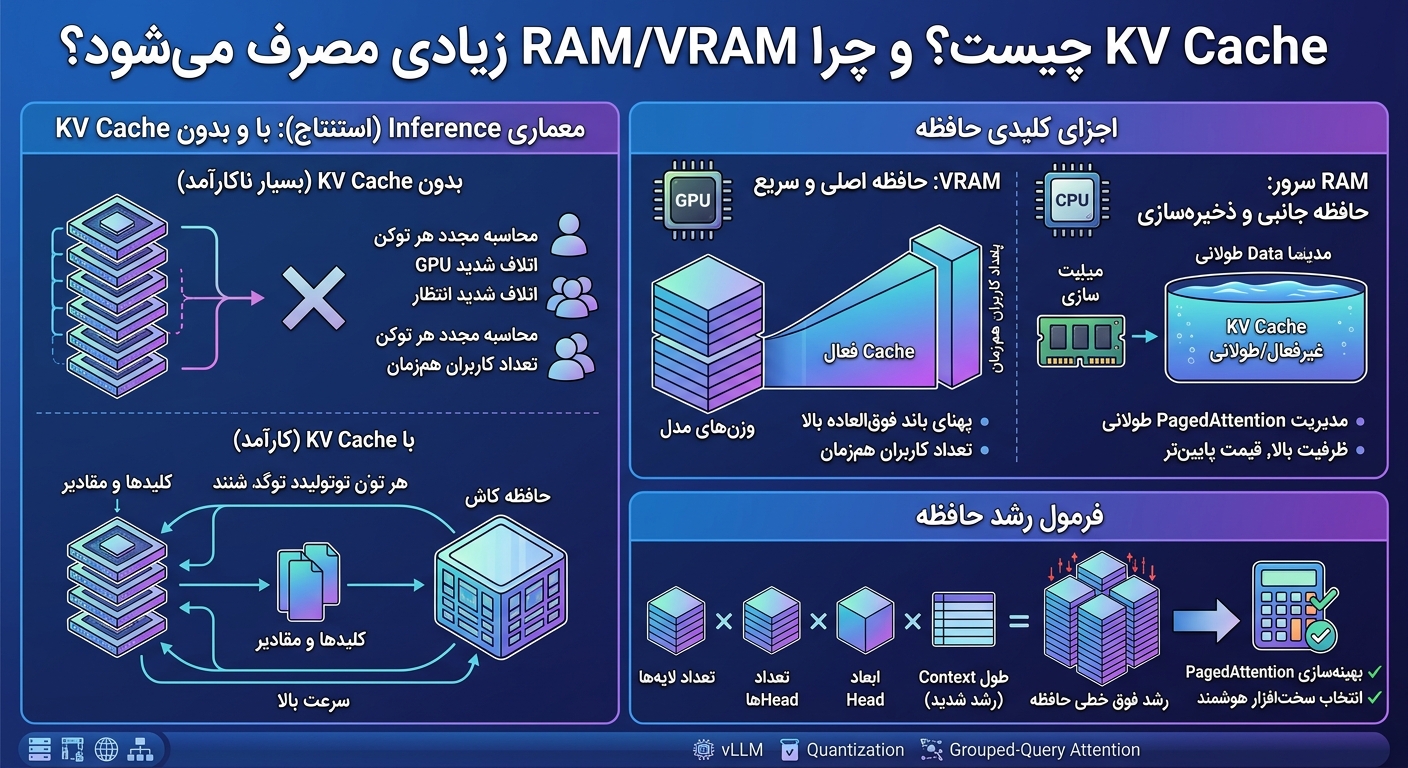
تصور کنید یک سرور مجازی قدرتمند با یک کارت گرافیک حرفهای اجاره کردهاید. همهچیز طبق محاسبات شما پیش میرود: حجم فایل مدل را دقیق محاسبه کردهاید و VRAM کارت گرافیک شما حتی فضای خالی هم دارد. اما با ارسال اولین درخواست جدی، ناگهان با خطای CUDA Out of Memory مواجه میشوید. این سناریو برای بسیاری از توسعهدهندگان و مدیران سرور آشناست. راز این ناکامی در یک عامل پنهان اما حیاتی نهفته است: KV Cache.
KV Cache قطعهای از پازل است که شاید در بروشورهای تبلیغاتی کارتهای گرافیک نبینید، اما در دنیای واقعی اجرای مدلهای زبانی بزرگ، نقشی تعیینکننده دارد. این فناوری است که مرز بین یک سرور قابل استفاده و یک سرور ناکارآمد را مشخص میکند. در این مقاله، از یک وبسایت هاستینگ با تخصص در ارائه سرور مجازی ایران، قصد داریم پرده از این راز برداریم. ما بررسی میکنیم که چرا مدلهای هوش مصنوعی تا این حد به RAM و VRAM وابسته هستند و چگونه میتوانید بدون هدر دادن هزینه، یک بستر پایدار برای پروژههای هوش مصنوعی خود بسازید.
چرا محاسبه حجم مدل، معادله را اشتباه حل میکند؟
اکثر افراد هنگام انتخاب سرور، فقط به یک عدد نگاه میکنند: حجم فایل مدل. به عنوان مثال، یک مدل 7B پارامتره با دقت FP16 حدود 14 گیگابایت فضا اشغال میکند. بنابراین یک GPU با 16 گیگابایت VRAM باید کافی به نظر برسد. اما واقعیت این است که در لحظه اجرا (Inference)، وزنهای مدل تنها بخشی از معادله هستند.
مصرف واقعی حافظه تابعی از چند متغیر پویا است:
🔹 وزنهای مدل (Model Weights): بخش ثابت و قابل پیشبینی که با کوانتایز کردن (Quantization) قابل کاهش است.
🔹 مقدار KV Cache: بخش پویا که با طول مکالمه و تعداد کاربران همزمان رشد میکند.
🔹 فعالسازیها (Activations): حافظه موقت برای محاسبات لایههای میانی.
🔹 سربارهی نرمافزاری (Runtime Overhead): حافظهای که موتورهای اجرایی مثل PyTorch یا vLLM برای مدیریت خود مصرف میکنند.
⚠️ نکته کلیدی: اگر یک GPU با 24 گیگابایت VRAM دارید و مدل شما 14 گیگابایت است، هرگز 10 گیگابایت فضای آزاد نخواهید داشت. KV Cache و سایر اجزا میتوانند به راحتی چندین گیگابایت دیگر را اشغال کنند و شما را با کمبود حافظه مواجه کنند.
KV Cache به زبان ساده: حافظهی پنهانی که سرعت را نجات میدهد
برای درک KV Cache، باید بدانیم مدلهای Transformer چگونه یک جمله را پردازش میکنند. وقتی جملهای مثل «پایتخت فرانسه» را وارد میکنید، مدل برای تولید کلمه بعدی («پاریس»)، باید به تکتک کلمات قبلی توجه کند. مکانیزمی که این توجه را ممکن میسازد، Attention نام دارد.
در این فرآیند، برای هر کلمه سه بردار ساخته میشود: Query (پرسش)، Key (کلید) و Value (مقدار). اگر مدل برای تولید هر کلمه جدید مجبور باشد دوباره از صفر این بردارها را برای تمام کلمات قبلی محاسبه کند، سرعت پردازش به شدت افت میکند.
اینجاست که KV Cache وارد میشود. مدل بردارهای Key و Value را برای تمام کلماتی که تاکنون دیده است، در حافظه نگه میدارد. دفعه بعد که نیاز باشد به کلمه قبلی توجه کند، به جای محاسبه مجدد، از حافظه میخواند. این کار باعث میشود Inference بسیار سریعتر شود، اما هزینهای دارد: حافظه.
📌 رابطهی طلایی: هرچه متن طولانیتر (Context Length بیشتر) باشد، تعداد بردارهای Key و Value بیشتری باید ذخیره شوند. نتیجه؟ KV Cache بزرگتر = مصرف VRAM بیشتر.
تحقیقات علمی نیز این موضوع را تأیید میکنند. در یک مطالعه روی مدل LLaMA-2 70B، محققان نشان دادند که برای یک Batch Size مشخص، حجم KV Cache میتواند به تنهایی به 80 گیگابایت برسد؛ یعنی چیزی بیشتر از ظرفیت یک کارت A100 80GB. این یعنی حتی اگر وزنهای مدل را روی یک کارت جا دهید، خود KV Cache میتواند گلوگاه اصلی باشد.
چرا Batch Size و کاربران همزمان، قاتل خاموش VRAM هستند؟
فرض کنید یک چتبات روی سرور مجازی هوش مصنوعی خود راهاندازی کردهاید و 10 نفر همزمان با آن کار میکنند. هر کاربر یک مکالمه مجزا دارد و برای هر مکالمه، یک KV Cache مستقل باید در VRAM ذخیره شود.
حالا تصور کنید هر کاربر یک متن 4000 کلمهای را وارد کرده باشد. مدل باید برای هر کاربر، بردارهای Key و Value هزاران کلمه را در حافظه نگه دارد. با 10 کاربر، فقط حجم KV Cache ده برابر میشود. اینجاست که یک GPU که برای یک کاربر کاملاً مناسب به نظر میرسید، برای 10 کاربر به شدت ناکافی میشود.
این مشکل در موتورهای Inference سنتی بسیار جدی بود، تا اینکه فناوریهایی مثل PagedAttention در موتورهایی مانند vLLM معرفی شدند. این فناوری حافظه KV Cache را به بلوکهای کوچک و قابل مدیریت تقسیم میکند و از هدر رفتن فضا جلوگیری میکند. در واقع، این تکنیک باعث میشود همان سختافزار بتواند تعداد کاربران بیشتری را با Contextهای طولانی پشتیبانی کند.
📌 پیشنهاد عملی: اگر میخواهید بدانید چه مقدار VRAM برای LLM شما لازم است، فقط به حجم مدل اکتفا نکنید. این فرمول ذهنی را در نظر بگیرید:
VRAM موردنیاز ≈ وزن مدل + KV Cache (برای تمام کاربران فعال) + سرباره Runtime
برای انتخاب دقیق منابع و اطمینان از پایداری، توصیه میکنیم با کارشناسان ما مشورت کنید.
RAM سرور: نقش فراموششده در معادلهی هوش مصنوعی
ممکن است تصور کنید وقتی مدل روی GPU اجرا میشود، فقط VRAM اهمیت دارد و RAM سیستم نقشی ندارد. این تصور در بسیاری از سناریوهای واقعی کاملاً غلط است.
RAM سرور در معماری یک AI Server نقشی چندوجهی دارد:
🔹 بارگذاری مدل (Model Loading): قبل از اینکه وزنها به VRAM منتقل شوند، باید در RAM بارگذاری شوند.
🔹 CPU Offloading: اگر VRAM کافی نباشد، بخشی از لایههای مدل یا حتی KV Cache را میتوان به RAM منتقل کرد.
🔹 سرویسهای جانبی: در یک سیستم RAG، دیتابیس برداری (Vector Database)، مدل Embedding و API همگی RAM مصرف میکنند.
🔹 پیشپردازش داده: پردازش اسناد و توکنایز کردن متون طولانی نیاز به حافظه موقت دارد.
تحقیقات آکادمیک نشان میدهد که تکنیکهایی مانند CPU Offloading هوشمند KV Cache میتوانند به طور مؤثری مصرف VRAM را کاهش دهند. در روشهایی مثل SpeCache، کل KV Cache در RAM سیستم ذخیره میشود و تنها بخشهای ضروری در هر لحظه به VRAM منتقل میشوند. این یعنی RAM با ظرفیت بالا میتواند به عنوان یک لایهی میانی، عمر GPU شما را افزایش دهد.
جدول مقایسه: چه مقدار RAM و VRAM برای چه سناریویی؟
انتخاب سرور مناسب برای هوش مصنوعی، فرآیندی مهندسیشده است. جدول زیر یک راهنمای عملی برای تخمین منابع موردنیاز بر اساس سناریوهای رایج ارائه میدهد:
| سناریو | VRAM پیشنهادی | RAM پیشنهادی | توضیحات |
|---|---|---|---|
| تست مدلهای کوچک (7B کوانتایز) | 8-12 GB | 16-32 GB | تککاربره، Context کوتاه |
| چتبات سازمانی سبک | 16-24 GB | 32-64 GB | چند کاربر محدود، Context متوسط |
| سیستم RAG با Vector DB | 24-48 GB | 64-128 GB | پردازش اسناد طولانی، دیتابیس برداری |
| سرویسدهی حرفهای LLM | 48-80 GB | 128-256 GB | چند کاربر همزمان، Context طولانی، Batch بالا |
| مدلهای بزرگ (70B+) | 80 GB+ (چند GPU) | 256 GB+ | نیازمند معماری چند-GPU و CPU Offloading |
نکته مهم این است که اعداد جدول فوق حداقلهای محافظهکارانه هستند. همیشه باید فضای خالی برای رشد پروژه و درخواستهای غیرمنتظره در نظر بگیرید.
راهکارهای عملی برای کاهش مصرف VRAM
اگر با خطای کمبود حافظه مواجه شدهاید، چند استراتژی اثباتشده میتواند به شما کمک کند:
🔹 کوانتایز کردن وزنها: استفاده از دقتهای پایینتر مثل INT8 یا INT4 میتواند حجم مدل را تا 75٪ کاهش دهد. اما توجه داشته باشید که کوانتایز کردن KV Cache نیز به همان اندازه مهم است.
🔹 مدیریت Context Length: اگر نیازی به پردازش 128K توکن ندارید، تنظیمات Context را کاهش دهید. رابطهی بین طول Context و مصرف حافظه تقریباً خطی است.
🔹 استفاده از موتورهای Inference مدرن: موتورهایی مثل vLLM و SGLang با تکنیکهایی مثل PagedAttention و مدیریت بلوکی KV Cache، به طور چشمگیری بهرهوری VRAM را افزایش میدهند.
🔹 CPU Offloading هوشمند: همانطور که اشاره شد، میتوان بخشی از KV Cache را در RAM نگه داشت و تنها بخشهای فعال را به GPU آورد.
🔹 محدود کردن Concurrency: اگر سرویس شما عمومی است، با تعیین یک سقف برای تعداد درخواستهای همزمان، از اشباع شدن حافظه جلوگیری کنید.
✅ توصیه کاربردی: اگر بودجه محدودی دارید و میخواهید یک سرور مجازی برای هوش مصنوعی راهاندازی کنید، به جای خرید یک GPU گرانقیمت با VRAM محدود، یک سرور با RAM بالا و GPU متعادل انتخاب کنید. RAM بالا به شما امکان میدهد از تکنیکهای Offloading استفاده کنید و پروژه خود را مقیاسپذیرتر بسازید.
آیا CPU میتواند جایگزین GPU شود؟
پاسخ کوتاه: برای Inference سریع، نه. اما برای سناریوهای خاص، CPU میتواند یک راهحل عملی باشد.
تحقیقات جدید نشان میدهد که اجرای مدلهای زبانی روی CPU با تکنیکهای کوانتایزیشن پیشرفته، به ویژه برای محیطهای حساس به حریم خصوصی یا منابع محدود، در حال پیشرفت است. برای مثال، یک مطالعه توانست زمان Fine-tuning یک مدل را از 17 ساعت به 50 دقیقه روی CPU کاهش دهد، بدون افت قابل توجه در کیفیت.
با این حال، برای سرویسدهی به چند کاربر همزمان با Context طولانی، GPU همچنان انتخاب برتر است. پهنای باند حافظه (Memory Bandwidth) در GPU بسیار بالاتر از RAM معمولی است و همین موضوع، سرعت تولید توکن را تعیین میکند.
📌 جمعبندی نهایی
KV Cache یک فناوری ضروری برای سرعتبخشی به Inference است، اما هزینهی حافظهای آن میتواند یک سرور قدرتمند را ناکارآمد کند. کلید موفقیت در انتخاب سرور مجازی هوش مصنوعی، درک این نکته است که معادلهی حافظه چندوجهی است: وزنها + KV Cache + Context Length + Batch Size + Runtime. قبل از خرید سرور، این عوامل را مدنظر قرار دهید و در صورت نیاز، با کارشناسان ما برای یک کانفیگ اختصاصی مشورت کنید.
سوالات متداول درباره KV Cache و منابع سرور
آیا میتوانم KV Cache را غیرفعال کنم؟
از نظر فنی خیر. KV Cache جزء جداییناپذیر مکانیزم Attention در Transformer است. اما میتوانید با تکنیکهایی مثل Eviction (حذف بلوکهای کماهمیت) یا Quantization، حجم آن را کاهش دهید.
چرا یک مدل 7B روی GPU 16GB با خطای OOM مواجه میشود؟
چون وزنهای مدل تنها بخشی از مصرف هستند. KV Cache برای Context طولانی یا چند کاربر، Activations، و سرباره Runtime میتوانند به راحتی چندین گیگابایت اضافه کنند.
آیا RAM بیشتر میتواند کمبود VRAM را جبران کند؟
تا حدی. با تکنیک CPU Offloading، بخشی از KV Cache یا وزنها میتواند در RAM نگهداری شود. اما پهنای باند RAM بسیار کمتر از VRAM است و این کار باعث افت سرعت میشود.
موتور vLLM چه مزیتی نسبت به استفاده مستقیم از PyTorch دارد؟
vLLM با تکنیک PagedAttention، حافظه KV Cache را به شکل بهینهتری مدیریت میکند. این باعث میشود هم VRAM کمتری مصرف شود و هم تعداد کاربران بیشتری در یک GPU پشتیبانی شوند.
برای شروع یک پروژه RAG چه مشخصاتی از سرور مناسب است؟
حداقل 64GB RAM (برای Vector DB و پردازش اسناد)، 16-24GB VRAM (برای LLM و Embedding Model)، و یک CPU چند هستهای. بسته به حجم اسناد و تعداد کاربران، این مشخصات میتواند افزایش یابد.
🛠 نیاز به یک سرور اختصاصی برای پروژه هوش مصنوعی دارید؟
تیم فنی ایرانیکاسرور آماده است تا بر اساس نوع مدل، حجم Context و تعداد کاربران شما، یک کانفیگ بهینه پیشنهاد دهد. از مشاوره رایگان تا راهاندازی کامل، در کنار شما هستیم.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
📚 مقالات مرتبط







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.