
 Amir Jabbari
راهاندازی سرور هوش مصنوعی دقیقاً یعنی چه؟
وقتی درباره راهاندازی سرور هوش مصنوعی صحبت میکنیم، منظور فقط نصب یک مدل زبانی نیست. یک AI Server واقعی باید بتواند مدل را اجرا کند، API در اختیار برنامهها قرار دهد، دسترسی کاربران را کنترل کند، مصرف CPU و RAM یا GPU را مانیتور کند و در صورت نیاز به ابزارهایی مثل RAG، دیتابیس برداری و AI Agent متصل شود.
این راهنما از سادهترین سناریو شروع میکند: یک سرور لینوکسی برای اجرای مدل با Ollama. سپس به سناریوی حرفهایتر با vLLM، API سازگار با OpenAI، GPU، RAG و در نهایت Coding Agent خصوصی میرسیم. بنابراین اگر هدفتان فقط تست یک مدل 7B است یا میخواهید یک Agent سازمانی 24/7 بسازید، مسیر مناسب را در همین صفحه پیدا میکنید.
پاسخ کوتاه: برای شروع سبک، Ubuntu + Docker + Ollama کافی است. برای چند کاربر همزمان و API Production معمولاً vLLM و GPU انتخاب بهتری است. اگر قرار است Agent به Git، دیتابیس یا ابزارهای داخلی دسترسی داشته باشد، باید Sandbox، احراز هویت، محدودیت دسترسی و ثبت لاگ را از روز اول جدی بگیرید.
قبل از نصب: VPS معمولی کافی است یا GPU لازم داریم؟
اولین تصمیم، انتخاب نوع پردازش است. مدلهای کوچک و Quantized را میتوان با CPU اجرا کرد، اما سرعت پاسخ معمولاً پایینتر است. هرچه مدل بزرگتر، Context طولانیتر یا تعداد کاربران بیشتر شود، GPU اهمیت بیشتری پیدا میکند.
| سناریو | RAM پیشنهادی شروع | GPU | مناسب برای |
|---|---|---|---|
| آزمایش شخصی | 16 تا 32GB | اختیاری | مدل کوچک Quantized، تست Ollama |
| API سبک | 32 تا 64GB | 16 تا 24GB VRAM مفید | مدلهای کوچک تا متوسط، یک یا چند کاربر |
| تیم توسعه / RAG | 64 تا 128GB | 24 تا 48GB VRAM | Agent، RAG، چند سرویس همزمان |
| Production سنگین | 128GB+ | 48 تا 80GB+ یا چند GPU | مدلهای بزرگ، Context بلند، چند کاربر همزمان |
اعداد بالا نقطه شروعاند، نه قانون ثابت. مصرف واقعی به مدل، Quantization، طول Context، Batch Size و تعداد درخواستهای همزمان وابسته است. قبل از خرید سرور بزرگ، مدل واقعی خودتان را روی بار آزمایشی Benchmark کنید.
معماری پیشنهادی یک AI Server؛ از ساده تا سازمانی
بهجای اینکه از روز اول همه سرویسها را روی یک سرور نصب کنید، معماری را مرحلهای جلو ببرید:
- مرحله سبک: Ubuntu + Ollama + یک مدل محلی.
- مرحله API: Reverse Proxy + TLS + Authentication + API.
- مرحله GPU Production: vLLM + GPU + مانیتورینگ.
- مرحله RAG: Embedding + Qdrant + Pipeline بازیابی.
- مرحله Agent: ابزارها، MCP، Git، Sandbox و Policy.
مرحله ۱: آمادهسازی Ubuntu و Docker
برای سرور جدید، ابتدا سیستم را بهروز کنید. دستورات زیر را با کاربری اجرا کنید که دسترسی sudo دارد.
sudo apt update
sudo apt upgrade -y
sudo apt install -y curl ca-certificates git htop
اگر میخواهید سرویسهای جانبی مثل Qdrant یا Gateway را Containerize کنید، Docker را از روش رسمی نصب کنید. بعد از نصب با دستور زیر سالم بودن آن را بررسی کنید:
docker --version
docker compose version
مرحله ۲: راهاندازی سریع مدل با Ollama
Ollama برای شروع، تست مدل و پروژههایی که پیچیدگی کم میخواهند مناسب است. نصب رسمی لینوکس با این دستور انجام میشود:
curl -fsSL https://ollama.com/install.sh | shپس از نصب:
ollama --version
systemctl status ollama
حالا یک مدل مناسب سختافزار خود انتخاب و اجرا کنید. اسم مدل را از Library رسمی Ollama بردارید؛ مدل بزرگتر الزاماً انتخاب بهتر برای سرور شما نیست.
اشتباه رایج: پورت API مدل را مستقیم روی اینترنت باز نکنید. ابتدا آن را روی localhost نگه دارید و دسترسی بیرونی را از Reverse Proxy، VPN یا Gateway کنترل کنید.
اگر آموزش کاملاً مرحلهبهمرحله Ollama را میخواهید، راهنمای نصب Ollama روی سرور مجازی لینوکس را هم ببینید.
مرحله ۳: چه زمانی از vLLM استفاده کنیم؟
اگر API سریعتر، پردازش همزمان چند درخواست و استفاده جدیتر از GPU میخواهید، vLLM انتخاب مهمی است. مستندات رسمی فعلی vLLM برای نصب روی Linux استفاده از محیط Python و uv را پیشنهاد میکنند.
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
vllm download-kernels
برای بالا آوردن یک مدل بهصورت API:
vllm serve MODEL_NAME --host 127.0.0.1 --port 8000 --api-key "CHANGE_THIS_KEY"MODEL_NAME را با مدل سازگار با GPU خود جایگزین کنید. vLLM یک API سازگار با OpenAI ارائه میدهد و میتوانید endpoint مدلها را تست کنید:
curl http://127.0.0.1:8000/v1/models \
  -H "Authorization: Bearer CHANGE_THIS_KEY"
برای سناریوی GPU، راهنمای مرتبط نصب vLLM روی سرور GPU نیز میتواند مسیر تخصصیتری به شما بدهد.
Ollama یا vLLM؟ کدام برای سرور هوش مصنوعی بهتر است؟
| معیار | Ollama | vLLM |
|---|---|---|
| شروع سریع | بسیار ساده | نیازمند تنظیم بیشتر |
| تست شخصی | عالی | ممکن است اضافهکاری باشد |
| چند کاربر همزمان | برای بار سبک | مناسبتر برای Serving |
| OpenAI-compatible API | پشتیبانی دارد | هسته اصلی سناریوی Serving |
| Production GPU | ممکن است کافی باشد | برای بار جدی معمولاً گزینه قویتر |
مرحله ۴: RAG و دیتابیس برداری؛ چه زمانی Qdrant لازم میشود؟
اگر مدل باید روی اسناد، دانش سازمانی یا Repository بزرگ پاسخ دهد، فرستادن همه دادهها داخل Prompt منطقی نیست. RAG ابتدا بخشهای مرتبط را پیدا میکند و فقط همان Context را به مدل میدهد.
Qdrant یک دیتابیس برداری متنباز است. برای تست محلی میتوانید آن را با Docker اجرا کنید:
docker run -d \
  --name qdrant \
  -p 127.0.0.1:6333:6333 \
  -p 127.0.0.1:6334:6334 \
  -v "$(pwd)/qdrant_storage:/qdrant/storage" \
  qdrant/qdrant
امنیت Qdrant مهم است: مستندات رسمی هشدار میدهند که نمونه پیشفرض بدون Encryption و Authentication بالا میآید. در Production پورتها را عمومی نکنید و TLS/API Key یا شبکه خصوصی را پیادهسازی کنید.
برای معماری RAG کاملتر، مقاله راهاندازی Qdrant برای RAG روی VPS را بخوانید.
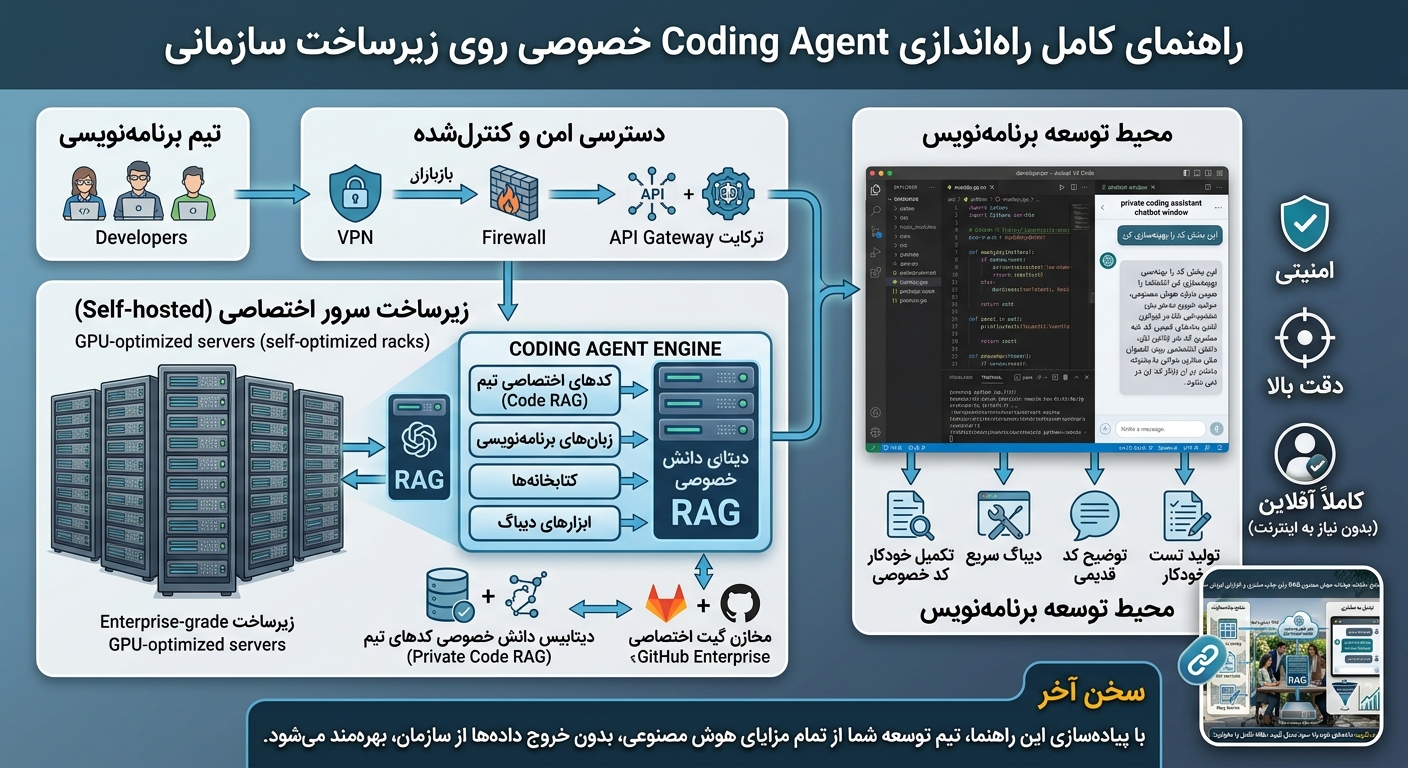
مرحله ۵: سرور AI را به Coding Agent خصوصی تبدیل کنیم
تا اینجا یک AI Server داریم که مدل و API را اجرا میکند. مرحله بعدی زمانی است که مدل فقط پاسخدهنده نباشد و بتواند با Git، فایلها، Terminal، CI/CD یا سرویسهای داخلی کار کند. این همان جایی است که بخش تخصصی Coding Agent خصوصی مقاله شروع میشود.
امروزه تیمهای توسعه نرمافزار بهشدت به ابزارهای هوش مصنوعی وابسته شدهاند. از تولید کد و رفع خطا تا بررسی Pull Request و مستندسازی، همه این کارها میتوانند با کمک یک دستیار هوشمند سریعتر انجام شوند. اما یک سؤال جدی همیشه مطرح است: آیا امن است که سورسکد محرمانه شرکت را به سرویسهای ابری عمومی بسپاریم؟
پاسخ این سؤال، ما را به سمت معماری Coding Agent خصوصی روی سرور اختصاصی هدایت میکند. در این رویکرد، مدل زبانی، ابزارهای توسعه و کل چرخه پردازش کد، روی زیرساخت خود شرکت اجرا میشوند. نه فقط امنیت بالاتر میرود، بلکه کنترل کامل روی دادهها، دسترسیها و هزینهها نیز در اختیار سازمان باقی میماند.
📌 در این راهنما میآموزید: چرا تیمهای برنامهنویسی به سرور AI اختصاصی نیاز دارند، چه سختافزاری برای Coding Agent کافی است، چگونه معماری امن طراحی کنید و چطور روی یک سرور مجازی یا اختصاصی ایرانیکاسرور این سیستم را راهاندازی کنید.
Coding Agent خصوصی چیست و چه تفاوتی با چتبات معمولی دارد؟
یک Coding Agent فقط یک مدل زبانی که چند خط کد تولید میکند نیست. این سیستم میتواند فایلهای پروژه را بخواند، ساختار Repository را تحلیل کند، خطاهای منطقی را پیدا کند، تست بنویسد و حتی با ابزارهایی مثل Git و Terminal تعامل داشته باشد.
تفاوت اصلی اینجاست: در یک چتبات ساده، شما باید بخشی از کد را کپی کنید و بپرسید «مشکل کجاست؟» اما یک Agent متصل به محیط توسعه، خودش فایلهای مرتبط را پیدا میکند، وابستگیها را بررسی میکند و یک تصویر کامل از پروژه ارائه میدهد.
وظایف قابل واگذاری به Coding Agent
🔹 بررسی ساختار پروژه و شناسایی فایلهای کلیدی
🔹 توضیح منطق بخشهای پیچیده کد
🔹 پیدا کردن خطاهای احتمالی قبل از اجرا
🔹 تولید Unit Test برای توابع و ماژولها
🔹 بررسی Pull Request و پیشنهاد اصلاح
🔹 جستوجو در کدبیس با زبان طبیعی
🔹 مستندسازی خودکار APIها و ماژولها
🔹 اجرای ابزارهای توسعه و دستورات Git
چرا Self-Hosted؟ امنیت کدهای شرکت در اولویت است
وقتی کد شرکت شما شامل API Key، اطلاعات اتصال دیتابیس، الگوریتمهای اختصاصی یا منطق تجاری حساس باشد، ارسال آن به سرویسهای بیرونی ریسک بزرگی محسوب میشود. یک سرور AI خصوصی، این نگرانیها را بهطور ریشهای حل میکند.
مزیت کلیدی: در معماری Self-hosted، هیچ دادهای از شبکه داخلی شرکت خارج نمیشود. مدل، Embeddingها، Vector Database و ابزارهای Agent همه روی زیرساخت خودتان اجرا میشوند.
⚠️ هشدار مهم: Self-hosted بودن بهتنهایی امنیت نمیآورد. اگر احراز هویت، فایروال و سطح دسترسیها درست تنظیم نشوند، سرور خصوصی هم میتواند آسیبپذیر باشد. امنیت یک فرآیند است، نه یک ویژگی.
اجزای اصلی یک سرور AI برای تیم توسعه
یک Coding Agent حرفهای از چند لایه تشکیل میشود که هر کدام نقش مشخصی دارند.
1. مدل زبانی (LLM)
مدل زبانی مغز سیستم است. برای Coding Agent، مدلهایی که روی درک کد و استدلال منطقی بهینه شدهاند عملکرد بهتری دارند. انتخاب مدل مستقیماً روی نیاز سختافزاری، سرعت پاسخ و کیفیت خروجی تأثیر میگذارد.
نکته مهم در انتخاب مدل: مقدار VRAM مورد نیاز تعیینکنندهترین مشخصه سختافزاری است. مدلهای کدنویسی امروزی مثل Qwen3 Coder یا Devstral 2 بسته به اندازه و Quantization، از حدود ۱۵GB تا بیش از ۱۰۰GB VRAM نیاز دارند .
2. موتور اجرای مدل (Inference Server)
مدل باید توسط یک Runtime اجرا شود. دو گزینه اصلی برای محیط سازمانی:
🔹 Ollama — برای شروع سریع، آزمایش مدل و استفادههای سبکتر
🔹 vLLM — برای API با کارایی بالا، پردازش همزمان چند کاربر و محیطهای Production
vLLM یک سرور HTTP با API سازگار با OpenAI ارائه میدهد که برای تیمهایی که چند توسعهدهنده همزمان به مدل درخواست میفرستند، انتخاب منطقیتری است .
3. لایه Agent و ابزارها
Agent لایهای است که درخواست برنامهنویس را به مراحل قابل اجرا تبدیل میکند و در صورت نیاز از ابزارهای مجاز استفاده میکند.
درخواست: "ماژول پرداخت را بررسی کن و تستهای ناقص را پیدا کن"
↓
Agent → بررسی ساختار پروژه
↓
پیدا کردن فایلهای Payment
↓
تحلیل کد و شناسایی Testهای موجود
↓
تولید Test جدید برای توابع بدون پوشش
4. Vector Database برای RAG
قرار دادن کل Repository داخل Context مدل راهکار مناسبی نیست. برای پروژههای بزرگ، از معماری RAG استفاده میشود: کد به Chunkهای کوچک تقسیم میشود، Embedding هر بخش ذخیره میشود و هنگام پرسش، فقط بخشهای مرتبط بازیابی و به مدل داده میشوند.
Qdrant یکی از گزینههای متنباز قدرتمند برای این کار است که هم بهصورت Docker و هم در محیط Kubernetes قابل استقرار است .
MCP؛ پل ارتباطی Agent با ابزارهای داخلی
MCP یا Model Context Protocol به Agent اجازه میدهد با ابزارها و سرویسهای مختلف ارتباط برقرار کند. یک MCP Server داخلی میتواند دسترسی کنترلشده به Git، GitLab، دیتابیس، سیستم Ticketing و مستندات را فراهم کند.
نتیجه این معماری: Agent از یک چتبات ساده به یک دستیار توسعه متصل به اکوسیستم ابزارهای شرکت تبدیل میشود.
سرور AI اختصاصی خود را روی زیرساخت ایرانیکاسرور راهاندازی کنید
برای اجرای Coding Agent، RAG و مدلهای کدنویسی به سروری با منابع پایدار، دیسک NVMe و پهنای باند مطمئن نیاز دارید. سرور مجازی ایران ایرانیکاسرور با منابع اختصاصی، آپتایم ۹۹.۹٪ و پشتیبانی ۲۴/۷، زیرساخت ایدهآل برای تیم توسعه شماست.
📞 تماس با پشتیبانی: 021-91302467 | ایرانیکاسرور
سختافزار مورد نیاز برای Coding Agent
انتخاب سختافزار به سه فاکتور اصلی بستگی دارد: اندازه مدل، تعداد کاربران همزمان و طول Context مورد نیاز.
جدول مقایسه GPU بر اساس کاربرد
نکته کلیدی: برای تیمهای چند نفره، توان پردازشی و پهنای باند حافظه GPU بهاندازه ظرفیت VRAM اهمیت دارد. مدلهای MoE مثل Qwen3 Coder فقط بخش کوچکی از پارامترها را در هر مرحله فعال میکنند و همین موضوع آنها را برای محیطهای چند کاربره کارآمدتر میکند .
RAM و Storage
🔹 RAM: حداقل ۶۴GB برای تیم کوچک، ۱۲۸GB یا بیشتر برای محیط چند سرویسه
🔹 Storage: حتماً NVMe SSD — مدلها، Docker Images، Embeddingها و Vector Database فضای قابل توجهی اشغال میکنند
🔹 CPU: حداقل ۸ هسته برای پردازش درخواستها، اجرای Agent و عملیات جانبی
امنیت Coding Agent؛ چه کارهایی باید انجام دهید
وقتی Agent به سورسکد شرکت دسترسی دارد، امنیت از یک «گزینه خوب» به یک «ضرورت» تبدیل میشود.
۱. احراز هویت قوی
دسترسی به Agent باید از طریق SSO، OAuth، LDAP یا VPN کنترل شود. هیچ کاربری نباید بدون احراز هویت به سیستم دسترسی داشته باشد.
۲. محدود کردن دسترسی شبکه
سرور AI نباید مستقیماً روی اینترنت عمومی قابل دسترسی باشد. معماری امنتر: VPN → شبکه خصوصی → سرور AI.
۳. سطحبندی دسترسی Agent
در مراحل اولیه، Agent فقط باید Repository را Read-Only ببیند. بعد از بررسی رفتار آن، میتوان دسترسیهای بیشتری اضافه کرد.
🔹 سطح ۱: خواندن کد
🔹 سطح ۲: تولید Patch
🔹 سطح ۳: اجرای تست
🔹 سطح ۴: ایجاد Commit در Branch جداگانه
🔹 سطح ۵: ایجاد Pull Request
⚠️ هرگز Agent را با دسترسی Root اجرا نکنید. یک دستور اشتباه میتواند فایلهای حیاتی را نابود کند. همیشه از User محدود، Sandbox و لیست دستورات مجاز استفاده کنید.
معماری پیشنهادی برای یک تیم ۱۰ نفره
Developers

/      |      \

IDE     Terminal   Web UI

\      |      /

▼     ▼     ▼

Coding Agent

│

┌─────────┴─────────┐

│                   │

▼                   ▼

AI Gateway          RAG System

│                   │

▼                   ▼

vLLM/LLM             Qdrant

│                   │

└─────────┬─────────┘

│

▼

MCP Tools

│

┌────────────┼────────────┐

▼            ▼            ▼

Git         CI/CD       Internal APIs
برای شروع، میتوانید همه سرویسها را روی یک سرور قدرتمند اجرا کنید. با افزایش بار کاری، هر بخش را به سرور جداگانه منتقل کنید: سرور GPU برای Inference، سرور CPU/RAM برای Vector Database و سرور مجزا برای Agent و Gateway.
مشکلات رایج و راهحلها
مدل کند پاسخ میدهد
دلایل: GPU ضعیف، VRAM کم، Context بیش از حد بزرگ، تعداد درخواست همزمان بالا. راهکار: مدل کوچکتر را با Quantization تست کنید و مصرف منابع را مانیتور کنید.
Agent کد اشتباه تولید میکند
مشکل الزاماً ضعف مدل نیست. اغلب Context مناسبی به مدل داده نشده. راهکار: RAG بهتر، System Prompt دقیقتر و تست خودکار.
مصرف VRAM بیش از حد
موارد بررسی: اندازه مدل، Quantization، طول Context، Batch Size، تعداد درخواست همزمان.
نقشه راه مرحلهای راهاندازی
لازم نیست از روز اول یک زیرساخت پیچیده بسازید.
🔹 مرحله ۱: Ubuntu + Docker + Ollama + مدل کدنویسی سبک
🔹 مرحله ۲: اتصال Agent به Git و Repository خصوصی
🔹 مرحله ۳: راهاندازی Qdrant و RAG برای جستوجو در کدبیس
🔹 مرحله ۴: افزودن MCP Server و اتصال به ابزارهای داخلی
🔹 مرحله ۵: مهاجرت به vLLM + GPU برای محیط Production
جمعبندی
ساخت Coding Agent خصوصی برای تیم برنامهنویسی، یک پروژه چندلایه است: مدل زبانی، Inference Server، RAG، Vector Database، MCP و لایه امنیت. مزیت اصلی این معماری، حفظ کنترل کامل روی کد، داده و زیرساخت است. برای شروع، یک سرور مجازی قدرتمند با دیسک NVMe و منابع پایدار کافی است. با رشد تیم، منابع GPU و سرویسهای جانبی را افزایش دهید. و مهمتر از همه: امنیت را جدی بگیرید، چون یک Agent ناامن میتواند به یک در پشتی خطرناک تبدیل شود.
نیاز به مشاوره یا کانفیگ اختصاصی دارید؟
تیم فنی ایرانیکاسرور میتواند بر اساس اندازه تیم، نوع مدل و نیاز پردازشی شما، بهترین پیکربندی سرور AI را پیشنهاد دهد. از انتخاب GPU تا تنظیمات شبکه و امنیت، همراه شما هستیم.
📞 تماس با پشتیبانی: 021-91302467 | ایرانیکاسرور
امنیت AI Server؛ چکلیست Production
Self-hosted بودن به معنی امن بودن نیست. اگر API مدل، Qdrant یا Agent مستقیماً روی اینترنت باز باشند، مهاجم ممکن است به داده، Context یا ابزارهای داخلی دسترسی بگیرد.
- API مدل و Qdrant را روی
127.0.0.1یا Private Network نگه دارید. - برای دسترسی بیرونی از TLS و Authentication استفاده کنید.
- Agent را با کاربر محدود اجرا کنید، نه Root.
- Git Token و API Key را داخل Prompt یا فایل عمومی قرار ندهید.
- دسترسی Agent به Shell را Allowlist کنید.
- Repository اصلی را ابتدا Read-only در اختیار Agent قرار دهید.
- Logهای ابزارها، درخواستها و تغییرات را نگه دارید.
- برای اجرای کد نامطمئن از Sandbox یا Container جدا استفاده کنید.
اگر Agent قرار است کد یا فرمان اجرا کند، راهنمای Sandbox برای AI Agent را نیز در معماری خود در نظر بگیرید.
مانیتورینگ سرور هوش مصنوعی؛ چه چیزهایی را باید ببینیم؟
وقتی مدل کند میشود، فقط CPU را نگاه نکنید. حداقل این شاخصها را ثبت کنید:
- CPU Usage و Load Average
- RAM و Swap
- GPU Utilization و VRAM
- Temperature و Power GPU
- Disk I/O و فضای آزاد
- Latency هر Request
- Tokens per second
- تعداد Request همزمان و Queue
- Error Rate و Timeout
روی سرور NVIDIA معمولاً nvidia-smi اولین ابزار بررسی GPU است:
watch -n 1 nvidia-smiBackup و Rollback؛ قبل از ارتقای مدل چه کار کنیم؟
آپدیت مدل، Runtime یا Driver میتواند رفتار سیستم را تغییر دهد. قبل از تغییر Production:
- فایل Compose، Environment و Reverse Proxy را نسخهبندی کنید.
- از دادههای Qdrant و فایلهای تنظیمات Backup بگیرید.
- نسخه Driver/CUDA و Runtime فعلی را ثبت کنید.
- مدل جدید را کنار مدل فعلی تست کنید.
- معیارهای Latency، VRAM و کیفیت پاسخ را مقایسه کنید.
- مسیر بازگشت به نسخه قبلی را قبل از Deploy آماده کنید.
سرور ایران یا خارج برای AI بهتر است؟
انتخاب موقعیت سرور به محل کاربران، منبع دانلود مدلها، APIهای بیرونی و حساسیت داده بستگی دارد. اگر کاربران و سرویسهای اصلی شما داخل ایران هستند، Latency داخلی و کنترل زیرساخت اهمیت بیشتری پیدا میکند. اگر مدل یا سرویسهای مکمل به منابع بینالمللی وابستهاند، کیفیت مسیر خارجی نیز مهم میشود.
برای یک پروژه Self-hosted، قبل از خرید فقط به مقدار RAM نگاه نکنید؛ نوع CPU، NVMe، امکان ارتقا، پهنای باند، محدودیت ترافیک و در سناریوی GPU مقدار VRAM را هم بررسی کنید.
FAQ؛ سؤالهای رایج درباره راهاندازی سرور هوش مصنوعی
آیا برای راهاندازی سرور هوش مصنوعی حتماً GPU لازم است؟
خیر. مدلهای کوچک و Quantized را میتوان روی CPU اجرا کرد، اما برای سرعت بالاتر، مدل بزرگتر یا چند کاربر همزمان GPU بسیار مهم میشود.
Ollama بهتر است یا vLLM؟
برای شروع سریع و تست، Ollama سادهتر است. برای Serving حرفهای، GPU و بار همزمان، vLLM معمولاً کنترل و Throughput بیشتری ارائه میدهد.
حداقل RAM برای AI Server چقدر است؟
عدد ثابت ندارد. برای تست مدل کوچک میتوان از حدود 16 تا 32GB شروع کرد؛ مدلهای بزرگ، RAG و چند سرویس همزمان RAM بیشتری نیاز دارند.
آیا میتوان API شبیه OpenAI روی سرور شخصی ساخت؟
بله. vLLM یک OpenAI-compatible server ارائه میدهد و Ollama نیز سازگاری API برای سناریوهای مختلف دارد؛ ولی دسترسی عمومی را حتماً با Authentication و TLS محافظت کنید.
برای RAG حتماً Qdrant لازم است؟
خیر؛ Qdrant یکی از گزینههاست. انتخاب دیتابیس برداری به حجم داده، الگوی جستوجو، معماری و نیاز عملیاتی پروژه بستگی دارد.
Coding Agent خصوصی چه مزیتی دارد؟
کنترل بیشتر روی سورسکد، داده، دسترسیها و مسیر پردازش. با این حال باید امنیت، Sandbox و سطح دسترسی ابزارها را خودتان درست طراحی کنید.
آیا AI Agent را میتوان 24 ساعته روی VPS اجرا کرد؟
بله، اگر Runtime، مدیریت Process، Logging، محدودیت منابع و بازیابی پس از Crash را تنظیم کنید. برای Agentهایی که ابزار اجرا میکنند، Sandbox را هم اضافه کنید.
منابع و مستندات رسمی
جمعبندی
برای راهاندازی سرور هوش مصنوعی از معماری ساده شروع کنید: سیستمعامل پایدار، Runtime مناسب و مدلی که با منابع شما همخوان باشد. وقتی نیاز واقعی ایجاد شد، GPU، vLLM، RAG، Qdrant، MCP و Agent را مرحلهبهمرحله اضافه کنید. مهمتر از تعداد سرویسها، داشتن امنیت، Benchmark، Monitoring و مسیر Rollback است. اگر هدف شما Coding Agent خصوصی است، این زیرساخت باید علاوه بر مدل، دسترسی کنترلشده به Repository و ابزارهای توسعه را هم پوشش دهد.
برای انتخاب منابع یا کانفیگ سرور نیاز به راهنمایی دارید؟
مدل، تعداد کاربران، اندازه Context و اینکه GPU لازم دارید یا نه را مشخص کنید تا انتخاب سرور دقیقتر شود.
تماس با پشتیبانی ایرانیکاسرور: 021-91302467
دیدگاهها (۰)