
 Amir Jabbari
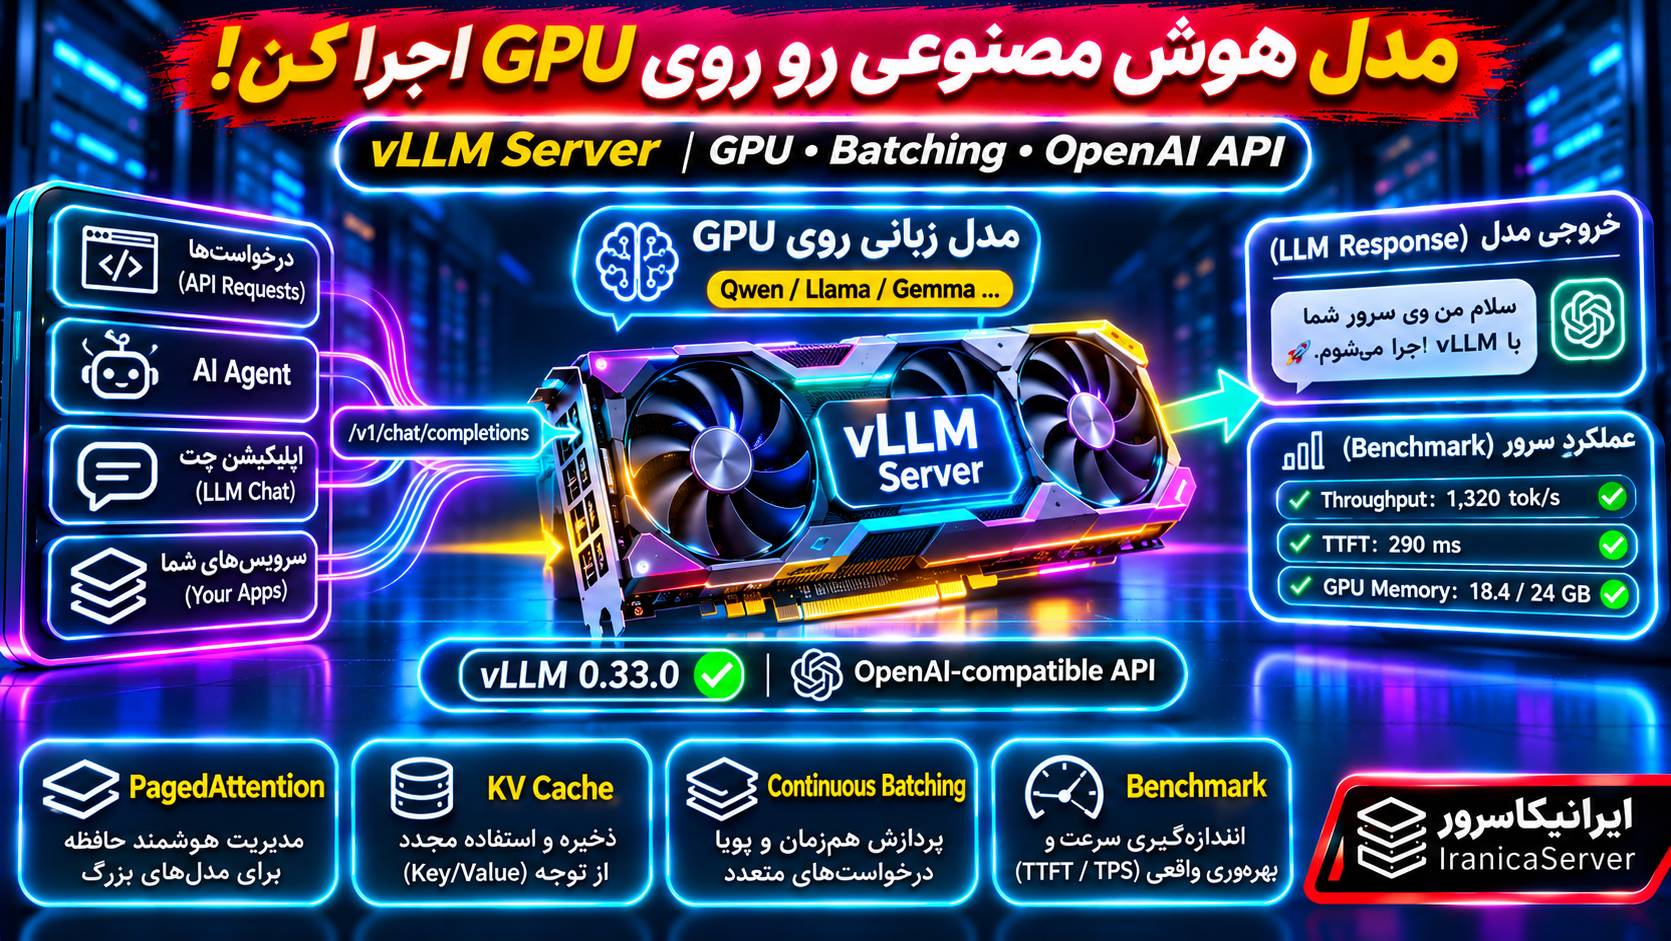
یکی از گزینههای مهم برای این کار vLLM است. vLLM یک موتور متنباز برای اجرای مدلهای زبانی بزرگ یا LLMها است که با استفاده از تکنیکهایی مانند Continuous Batching و PagedAttention تلاش میکند توان پردازشی GPU را هنگام پاسخگویی به درخواستهای همزمان بهتر استفاده کند.
برای مثال، فرض کنید یک نرمافزار پشتیبانی هوشمند ساختهاید و میخواهید مدل زبانی آن روی سرور GPU اختصاصی خودتان اجرا شود. با راهاندازی vLLM Server میتوانید یک API سازگار با بخشهایی از OpenAI API ایجاد کنید تا برنامه شما بهجای ارسال درخواست به یک ارائهدهنده خارجی، به سرور مدل خودتان متصل شود.
البته اجرای محلی مدل همیشه ارزانتر یا سریعتر نیست. برای انتخاب درست باید اندازه مدل، ظرفیت VRAM، تعداد درخواستهای همزمان، طول Context و معیارهایی مانند Throughput و Latency را بررسی کنید.
در این آموزش، vLLM را از پایه معرفی میکنیم و سپس نحوه نصب نسخه 0.33.0 روی سرور GPU با Ubuntu 24.04، اجرای یک مدل آموزشی، ساخت OpenAI-compatible API، اتصال Python، مدیریت حافظه GPU و انجام Benchmark واقعی را توضیح میدهیم.
همچنین تفاوت vLLM با Ollama، مفهوم KV Cache، روش انتخاب GPU، مشکلات Out of Memory و نکات امنیتی راهاندازی API در محیط Production را بررسی خواهیم کرد.
vLLM چیست و چه کاربردی دارد؟
vLLM یک موتور Inference و Serving برای مدلهای زبانی است. منظور از Inference، اجرای یک مدل آموزشدیده برای تولید خروجی است؛ برای مثال، دریافت سؤال و تولید پاسخ متنی.
وقتی از vLLM برای ارائه سرویس استفاده میکنید، مدل در حافظه GPU بارگذاری میشود و یک سرور API درخواستهای ورودی را به موتور پردازش ارسال میکند.
این موتور با مدیریت حافظه و زمانبندی اجرای درخواستها تلاش میکند نسبت به پیادهسازیهای سادهتر، از منابع محاسباتی بهرهوری بهتری داشته باشد.
vLLM چه کارهایی انجام میدهد؟
- اجرای مدلهای زبانی پشتیبانیشده روی GPU یا Backendهای سازگار دیگر.
- دریافت همزمان درخواستهای متعدد.
- تولید خروجی متنی معمولی یا Streaming.
- ارائه API سازگار با برخی Endpointهای OpenAI.
- مدیریت حافظه Attention با KV Cache.
- پشتیبانی از روشهای مختلف Quantization و Parallelism متناسب با مدل و سختافزار.
- ارائه Metrics برای مانیتورینگ عملکرد Inference.
آیا vLLM خودش مدل هوش مصنوعی است؟
خیر. vLLM موتور اجرای مدل است و باید یک مدل سازگار مانند مدلهای پشتیبانیشده از خانواده Qwen، Llama یا Gemma را جداگانه انتخاب کنید.
به بیان ساده، مدل نقش بخش تولیدکننده متن را دارد و vLLM وظیفه اجرای آن و مدیریت درخواستها را بر عهده میگیرد.
آیا vLLM برای آموزش مدل استفاده میشود؟
تمرکز اصلی vLLM روی Inference و Model Serving است؛ نه آموزش مدل از صفر. برای Training یا Fine-tuning معمولاً از ابزارها و فریمورکهای دیگری استفاده میشود و سپس میتوان مدل سازگار را با vLLM ارائه کرد.
آخرین نسخه vLLM چیست؟
در زمان بررسی این مقاله، یعنی ۴ نوامبر ۲۰۲۶، آخرین نسخه پایدار منتشرشده vLLM برابر 0.33.0 است که در ۲ نوامبر ۲۰۲۶ منتشر شده است.
این نسخه از طریق صفحه رسمی Releases و PyPI قابل بررسی است:
مشاهده نسخه vLLM 0.33.0 در GitHub
مشاهده بسته vLLM 0.33.0 در PyPI
نکته درباره نسخههای قدیمی
vLLM بهسرعت توسعه پیدا میکند. ممکن است گزینههای خط فرمان، Backendهای Attention یا تنظیمات Scheduling در نسخههای مختلف تغییر کنند.
بنابراین بهتر است قبل از کپی کردن دستور یک آموزش قدیمی، نسخه نصبشده و راهنمای همان نسخه را بررسی کنید.
vllm --version

vllm serve --help=all
در این مقاله از دستورهای مربوط به سری جدید vLLM استفاده میکنیم، اما سازگاری نهایی به مدل، GPU و محیط نصب شما نیز بستگی دارد.
معماری vLLM Server چگونه است؟
در سادهترین حالت، یک سرور GPU میزبان مدل و vLLM است و برنامههای دیگر از طریق HTTP به آن متصل میشوند.
Website / AI Agent / Application
                |
         Authenticated Gateway
                |
        OpenAI-compatible API
                |
            vLLM Server
                |
        Request Scheduler
                |
      Continuous Batching
                |
       GPU Model Execution
                |
       Model Weights + KV Cache
                |
          Generated Tokens
وقتی درخواست جدید وارد میشود، vLLM آن را برای پردازش زمانبندی میکند. بسته به وضعیت GPU و ظرفیت حافظه، ممکن است چند درخواست همزمان در یک چرخه پردازش شوند.
نتیجه نهایی در قالب پاسخ API به برنامه درخواستکننده بازگردانده میشود.
چرا به API نیاز داریم؟
چون معمولاً نمیخواهیم هر نرمافزار جداگانه مدل چندگیگابایتی را داخل حافظه بارگذاری کند.
با ساخت یک سرویس مرکزی، برنامههای مختلف میتوانند از یک موتور Inference استفاده کنند؛ البته برای محیط چندکاربره به کنترل دسترسی، ظرفیتسنجی و مدیریت صف درخواستها نیاز داریم.
Continuous Batching در vLLM چیست؟
یکی از قابلیتهای مهم vLLM، زمانبندی درخواستهای همزمان با استفاده از Continuous Batching است.
برای درک این مفهوم، فرض کنید سه کاربر همزمان درخواست تولید متن ارسال کردهاند.
روش ساده بدون Batching پویا
یک موتور ساده ممکن است درخواستها را تقریباً پشت سر هم اجرا کند یا برای تکمیل یک Batch ثابت منتظر بماند.
در این شرایط، ظرفیت GPU ممکن است بهینه استفاده نشود.
Continuous Batching چگونه کمک میکند؟
در Continuous Batching، Scheduler میتواند درخواستهای آماده را در مراحل مختلف تولید Token مدیریت کند و پس از پایان یک درخواست، ظرفیت آزادشده را به درخواستهای دیگر اختصاص دهد.
برای مثال، اگر یکی از سه درخواست زودتر تمام شود، لازم نیست موتور تا پایان همه درخواستهای دیگر منتظر بماند تا کار جدیدی وارد کند.
آیا Continuous Batching همیشه سرعت هر درخواست را بیشتر میکند؟
خیر. این روش غالباً برای افزایش بهرهوری و Throughput در بار همزمان مفید است، اما ممکن است تحت بار زیاد، زمان انتظار برخی درخواستها افزایش پیدا کند.
به همین دلیل هنگام Benchmark باید هم تعداد Token تولیدشده در ثانیه و هم Latency کاربران بررسی شود.
تفاوت Throughput و Latency
| معیار | معنا |
|---|---|
| Throughput | حجم کار انجامشده در واحد زمان |
| Latency | مدت پاسخگویی به یک درخواست |
| TTFT | زمان رسیدن اولین Token خروجی |
| TPOT | زمان متوسط تولید هر Token خروجی پس از اولین Token |
| Concurrency | تعداد درخواستهایی که به شکل همزمان در جریان هستند |
ممکن است یک تنظیم باعث افزایش Throughput کل شود، ولی TTFT یا تأخیر صدک ۹۵ کاربران را بیشتر کند. بنابراین «سرعت بهتر» باید براساس هدف واقعی سرویس تعریف شود.
PagedAttention چیست و چه ارتباطی با سرعت vLLM دارد؟
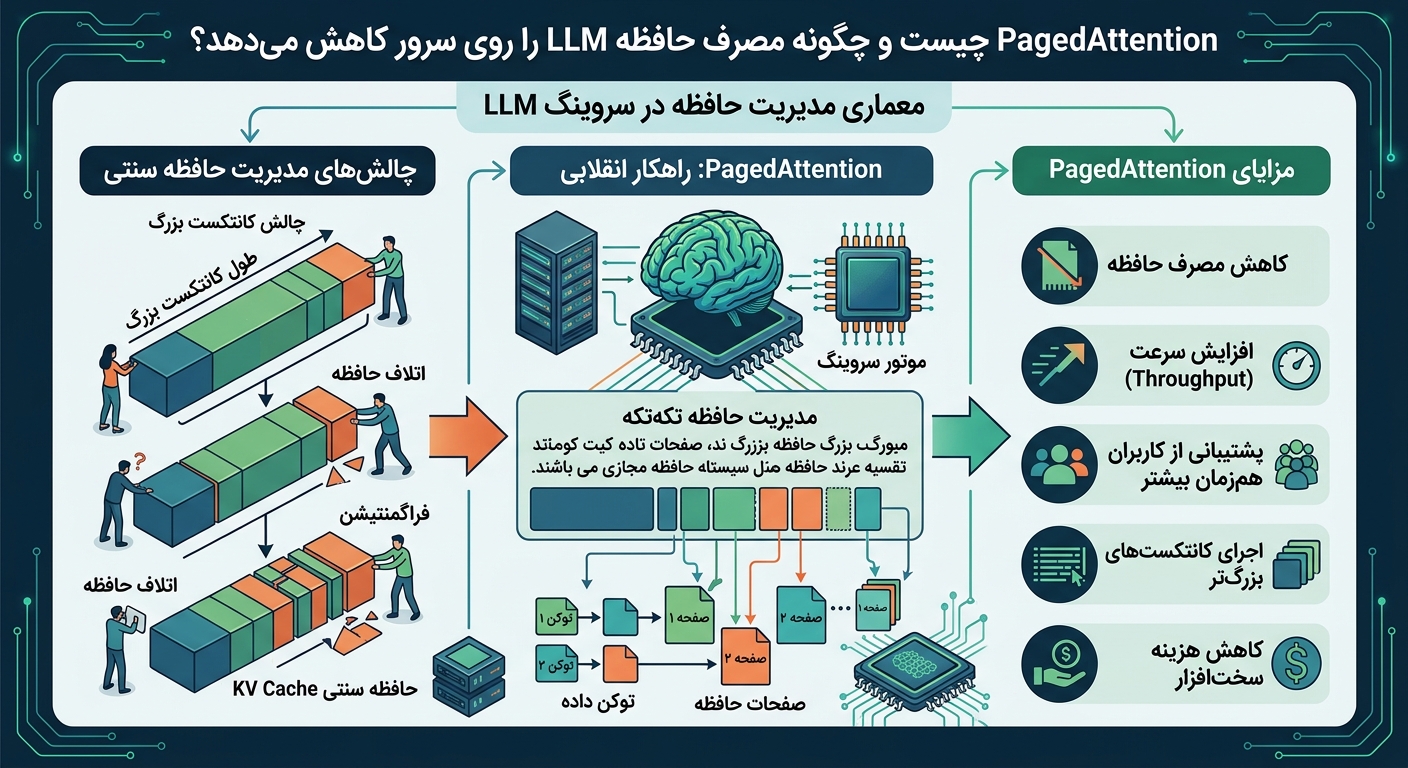
PagedAttention یکی از ایدههای کلیدی معماری vLLM برای مدیریت کارآمدتر حافظه Attention است.
در مدلهای Transformer، هنگام تولید Tokenهای جدید، مقادیر Key و Value مراحل قبلی برای استفاده در Attention نگهداری میشوند.
این دادهها بخشی از KV Cache هستند و با افزایش طول گفتگو یا تعداد درخواستها، فضای بیشتری مصرف میکنند.
مشکل مدیریت سنتی حافظه
اگر برای هر درخواست یک ناحیه حافظه بزرگ و پیوسته رزرو شود، ممکن است بخشی از حافظه بدون استفاده باقی بماند یا Fragmentation ایجاد شود.
راهکار PagedAttention
در PagedAttention، KV Cache به Blockهای کوچکتر تقسیم میشود و مدیریت آنها میتواند بدون نیاز به تخصیص یک ناحیه پیوسته بزرگ انجام شود.
این روش امکان استفاده کارآمدتر از حافظه موجود را فراهم میکند.
آیا PagedAttention باعث میشود مدل بدون VRAM کافی اجرا شود؟
خیر. این تکنیک مشکل نیاز اساسی مدل به حافظه را حذف نمیکند.
وزنهای مدل، KV Cache، حافظه اجرای Kernelها و دیگر بخشهای پردازش همچنان به VRAM نیاز دارند.
PagedAttention بیشتر به مدیریت بهتر بخش KV Cache کمک میکند.
KV Cache چیست و چرا حافظه GPU را مصرف میکند؟
وقتی مدل Transformer متن تولید میکند، برای هر Token جدید به اطلاعات Attention مربوط به Tokenهای قبلی نیاز دارد.
محاسبه دوباره تمام این اطلاعات در هر مرحله میتواند پرهزینه باشد؛ بنابراین بخشی از اطلاعات بهصورت Key و Value ذخیره میشوند.
به این حافظه موقت، KV Cache گفته میشود.
چه عواملی اندازه KV Cache را تغییر میدهند؟
- تعداد درخواستهای همزمان.
- تعداد Tokenهای Context هر درخواست.
- معماری مدل و تعداد لایههای Attention.
- تعداد KV Headها و اندازه هر Head.
- نوع داده مورد استفاده برای KV Cache.
- نوع Attention، Sliding Window یا معماریهای خاص مدل.
فرمول تقریبی KV Cache در Transformerهای معمولی
برای یک معماری استاندارد با KV Cache متراکم میتوان اندازه حافظه را بهصورت تقریبی محاسبه کرد:
KV Bytes ≈ 2 × Layers × KV Heads × Head Dimension × Cached Tokens × Bytes per Element
ضریب ۲ به دلیل نگهداری Key و Value است.
این فرمول برای همه معماریهای جدید، از جمله بعضی مدلهای دارای MLA یا Attention ترکیبی، الزاماً دقیق نیست.
چرا طول Context مهم است؟
اگر Context یا تعداد درخواستهای همزمان افزایش پیدا کند، تعداد Tokenهای ذخیرهشده در KV Cache نیز ممکن است بیشتر شود.
بنابراین داشتن VRAM کافی برای وزن مدل بهتنهایی تضمین نمیکند سرور بتواند تعداد زیادی گفتگوی طولانی را همزمان پاسخ دهد.
برای نصب vLLM چه GPU لازم است؟
vLLM از چند Backend سختافزاری پشتیبانی میکند؛ اما مسیر نصب و قابلیتها برای NVIDIA CUDA، AMD ROCm و دیگر Backendها یکسان نیست.
در این مقاله مسیر NVIDIA CUDA را انتخاب میکنیم، چون برای آموزش اولیه و اجرای مدل روی Linux مسیر مستند و رایجی است.
حداقل سازگاری CUDA
طبق مستندات رسمی فعلی، برای مسیر NVIDIA CUDA به GPU دارای Compute Capability برابر 7.5 یا بالاتر نیاز دارید.
همچنین Driver باید با Runtime و PyTorch نصبشده سازگار باشد.
انتخاب GPU براساس ظرفیت VRAM
| ظرفیت VRAM | کاربرد اولیه | نکته |
|---|---|---|
| ۸ گیگابایت | مدلهای بسیار کوچک و آزمایش | محدودیت شدید برای Context و Concurrency |
| ۱۲ تا ۱۶ گیگابایت | برخی مدلهای کوچک یا Quantized | معماری و Precision مدل تعیینکنندهاند |
| ۲۴ گیگابایت | مدلهای متوسط با تنظیم مناسب | تعداد کاربران همزمان باید آزمایش شود |
| ۴۸ گیگابایت | مدلهای بزرگتر یا ظرفیت KV بیشتر | همچنان به تناسب وزن مدل و VRAM وابسته است |
| ۸۰ گیگابایت و بیشتر | سرویسهای سنگینتر | برای مدلهای بسیار بزرگ احتمال نیاز به چند GPU وجود دارد |
این جدول راهنمای مفهومی است و تضمین اجرای یک مدل مشخص روی هر GPU نیست. مدل Quantized، معماری MoE، Precision و طول Context میتوانند مصرف حافظه را به شکل قابل توجهی تغییر دهند.
آیا GPU قدرتمندتر همیشه به معنی پاسخ سریعتر است؟
نه در تمام سناریوها. علاوه بر توان محاسباتی GPU، پهنای باند حافظه، معماری مدل، طول Prompt، Scheduler و تعداد درخواستهای همزمان نیز روی عملکرد تأثیر دارند.
بهتر است GPUها با یک مدل و Workload یکسان Benchmark شوند.
چگونه مقدار تقریبی VRAM موردنیاز مدل را محاسبه کنیم؟
قبل از خرید یا انتخاب سرور GPU، باید بدانید وزن مدل تقریباً چه مقدار حافظه اشغال میکند.
تخمین اولیه وزن مدل
برای یک مدل Dense، میتوان یک تقریب ساده به کار برد:
Memory for Weights ≈ Parameters × Bytes per Parameter
مثلاً مدل ۷ میلیارد پارامتری با ذخیرهسازی FP16 یا BF16 بهصورت نظری حدود ۱۴ میلیارد بایت حافظه فقط برای وزنها نیاز دارد؛ یعنی تقریباً ۱۳ گیبیبایت.
برای مدل ۷ میلیارد پارامتری با وزن ۴ بیت، حجم نظری وزنها حدود ۳٫۵ میلیارد بایت است؛ اما Metadata، Scaleها و سربار روش Quantization نیز باید محاسبه شوند.
| مدل Dense فرضی | FP16/BF16 تقریبی | ۴ بیت نظری وزنها |
|---|---|---|
| ۳ میلیارد پارامتر | ۶ GB | ۱٫۵ GB |
| ۷ میلیارد پارامتر | ۱۴ GB | ۳٫۵ GB |
| ۱۴ میلیارد پارامتر | ۲۸ GB | ۷ GB |
| ۳۲ میلیارد پارامتر | ۶۴ GB | ۱۶ GB |
| ۷۰ میلیارد پارامتر | ۱۴۰ GB | ۳۵ GB |
این اعداد فقط وزنهای نظری را نشان میدهند، نه نیاز واقعی VRAM برای اجرای vLLM.
چه حافظه دیگری لازم است؟
- KV Cache برای درخواستهای فعال.
- حافظه اجرای Kernelها و بافرهای پردازشی.
- CUDA Graphها و حافظه Runtime.
- سربار Quantization و ساختار مدل.
- فضای آزاد برای مدیریت پایدار GPU.
به همین دلیل ممکن است مدل از نظر حجم فایل در حافظه GPU جا شود، اما در زمان راهاندازی یا افزایش درخواستها با خطای Out of Memory مواجه شود.
پیشنیازهای نصب vLLM روی Ubuntu 24.04
در این آموزش فرض میکنیم یک سرور GPU اختصاصی یا VPS دارای GPU سازگار در اختیار دارید.
GPU باید واقعاً در اختیار سیستمعامل مهمان قرار گرفته باشد. صرف داشتن VPS با CPU و RAM بالا به معنی دسترسی به GPU نیست.
بررسی سیستمعامل
cat /etc/os-release

uname -r
بررسی GPU و Driver
nvidia-smi

nvidia-smi --query-gpu=name,memory.total,driver_version \
--format=csv
اگر دستور nvidia-smi کار نمیکند، قبل از نصب vLLM باید وضعیت Driver، GPU Passthrough و سازگاری سختافزار بررسی شود.
دستور nvidia-smi نسخه CUDA قابل پشتیبانی توسط Driver را گزارش میکند؛ این عدد لزوماً به معنی نصب بودن همان نسخه CUDA Toolkit نیست.
بررسی فضای ذخیرهسازی
df -h

free -h
فایل وزن مدل، Cache دانلود و پکیجهای Python ممکن است فضای قابل توجهی مصرف کنند؛ بنابراین قبل از نصب مدلهای بزرگ، فضای دیسک را بررسی کنید.
مرحله اول: نصب vLLM 0.33.0 روی سرور GPU
طبق مستندات فعلی vLLM، استفاده از محیط Python مستقل و ابزار uv برای نصب پیشنهاد میشود.
در این مقاله Python 3.12 را انتخاب میکنیم تا محیط نصب مشخص و قابل بازتولید باشد.
نصب uv
ابتدا uv را مطابق راهنمای رسمی پروژه نصب کنید:
پس از نصب:
uv --versionساخت پوشه پروژه
mkdir -p ~/iranica-vllm

cd ~/iranica-vllm
ایجاد محیط Python 3.12
uv venv --python 3.12 --seed --managed-python

source .venv/bin/activate
نصب vLLM
uv pip install 'vllm==0.33.0' --torch-backend=autoگزینه torch-backend=auto به uv کمک میکند Backend مناسب PyTorch را با توجه به محیط CUDA انتخاب کند.
این کار جایگزین بررسی سازگاری GPU و Driver نیست. اگر Driver یا سختافزار با Wheel انتخابشده سازگار نباشد، نصب یا اجرای vLLM ممکن است با خطا مواجه شود.
دریافت Kernelهای آماده
vllm download-kernelsدر نسخههای جدید، این مرحله میتواند Kernelهای از پیش کامپایلشده سازگار را آماده کند و بخشی از تأخیر دانلود یا کامپایل در اولین Startup را کاهش دهد.
بررسی نسخه نصبشده
vllm --version

python -m pip check
اگر pip داخل محیط انتخابشده در دسترس نیست، میتوانید بررسی وابستگیها را با uv pip check انجام دهید.
مرحله دوم: انتخاب مدل مناسب برای آموزش vLLM
برای تست اولیه بهتر است از یک مدل کوچک استفاده کنیم تا بتوانیم قبل از اجرای مدلهای بزرگ، سلامت محیط GPU و API را بررسی کنیم.
در این آموزش مدل زیر را انتخاب میکنیم:
Qwen/Qwen3-0.6B
صفحه مدل Qwen3-0.6B در Hugging Face
این مدل برای آزمایش اولیه مناسب است؛ اما کیفیت و توانایی آن را نباید با مدلهای چنددهمیلیاردپارامتری یکسان دانست.
قبل از انتخاب مدل چه چیزهایی را بررسی کنیم؟
- مجوز استفاده تجاری و شرایط License.
- سازگاری معماری مدل با نسخه vLLM.
- حجم وزنها و نوع Precision.
- پشتیبانی از Chat Template.
- طول Context و تنظیمات Tokenizer.
- پشتیبانی از زبان فارسی در کاربرد موردنظر.
- نیاز احتمالی به تأیید دسترسی به مدل در Hugging Face.
اگر مدل نیازمند دسترسی تأییدشده باشد، باید مجوز لازم را در Hugging Face دریافت کنید. برای مدلهای عمومی که نیازی به Token ندارند، بهتر است Secret اضافی در محیط تنظیم نشود.
مرحله سوم: اجرای vLLM Server روی GPU
پس از نصب کتابخانه و انتخاب مدل میتوان API Server را اجرا کرد.
در اولین مرحله، سرور را فقط روی Loopback فعال میکنیم تا از اینترنت عمومی قابل دسترسی نباشد.
تعریف API Key آزمایشی
یک Secret طولانی و تصادفی ایجاد کنید و آن را در متغیر محیطی قرار دهید. مقدار زیر فقط جایگزین آموزشی است و نباید در Production استفاده شود:
export VLLM_API_KEY='REPLACE_WITH_RANDOM_SECRET'اجرای مدل و سرور API
vllm serve Qwen/Qwen3-0.6B \
  --host 127.0.0.1 \
  --port 8000 \
  --served-model-name iranica-llm \
  --api-key "$VLLM_API_KEY" \
  --dtype auto \
  --max-model-len 2048 \
  --gpu-memory-utilization 0.80
در این دستور مدل از Hugging Face دریافت میشود، روی GPU بارگذاری خواهد شد و در صورت موفقیت Startup، API در آدرس محلی 127.0.0.1:8000 آماده پاسخگویی میشود.
زمان آماده شدن به سرعت شبکه، اندازه مدل، GPU و وضعیت Kernelها بستگی دارد.
پارامترهای اصلی چه معنایی دارند؟
| پارامتر | کاربرد |
|---|---|
| –host | آدرس شبکهای که سرور روی آن گوش میدهد |
| –port | پورت HTTP API |
| –served-model-name | نام مدل برای درخواستهای API |
| –api-key | احراز هویت Endpointهای تحت پوشش |
| –dtype | نوع داده مورد استفاده برای اجرای مدل |
| –max-model-len | حداکثر طول Sequence قابل پشتیبانی در این پیکربندی |
| –gpu-memory-utilization | سهم هدف حافظه GPU برای Executor |
در نسخه 0.33.0 نباید فرض کرد API Key بهتنهایی تمام Endpointهای موجود در سرور را محافظت میکند. برای استفاده عمومی باید علاوه بر آن، دسترسی شبکه و مسیرهای HTTP را محدود کرد.
مرحله چهارم: تست OpenAI-compatible API در vLLM
یکی از ویژگیهای کاربردی vLLM این است که میتواند تعدادی از Endpointهای مشابه OpenAI API را ارائه کند.
در نتیجه بسیاری از نرمافزارهایی که امکان تنظیم Base URL دارند، میتوانند با تغییر تنظیمات به vLLM متصل شوند.
دریافت فهرست مدلها
در یک ترمینال دوم روی همان سرور، با همان API Key اجرا کنید:
curl --fail \
http://127.0.0.1:8000/v1/models \
-H "Authorization: Bearer $VLLM_API_KEY"
ارسال اولین درخواست Chat Completion
curl --fail \
http://127.0.0.1:8000/v1/chat/completions \
-H "Authorization: Bearer $VLLM_API_KEY" \
-H "Content-Type: application/json" \
-d '{
  "model": "iranica-llm",
  "messages": [
    {
      "role": "user",
      "content": "سلام، vLLM را در دو جمله معرفی کن."
    }
  ],
  "max_tokens": 128,
  "temperature": 0
}'
اگر مدل، Chat Template و سرویس درست آماده شده باشند، باید یک پاسخ JSON شامل خروجی مدل دریافت کنید.
مقدار temperature برابر صفر برای کاهش تصادفی بودن خروجی انتخاب شده است؛ اما این تنظیم تضمین نمیکند پاسخ همیشه یکسان یا کاملاً صحیح باشد.
آیا vLLM کاملاً با تمام OpenAI API سازگار است؟
خیر. vLLM مجموعهای از Endpointهای سازگار را پیادهسازی میکند، اما همه قابلیتها و پارامترها الزاماً با سرویس OpenAI یکسان نیستند.
همچنین پشتیبانی از Tool Calling، Structured Outputs و Responses API ممکن است به نسخه vLLM و توانایی مدل انتخابی وابسته باشد.
بنابراین قبل از مهاجرت یک برنامه Production، قابلیتهای موردنیاز آن را بهصورت مستقل آزمایش کنید.
مرحله پنجم: اتصال Python و OpenAI SDK به vLLM Server
اگر برنامه شما با OpenAI Python SDK نوشته شده است، میتوانید برای Endpointهای سازگار، Base URL را به آدرس سرور vLLM تغییر دهید.
نصب OpenAI SDK در محیط کلاینت
python -m pip install openaiاگر برنامه کلاینت داخل یک Virtual Environment ساخته شده است، نصب را در همان محیط انجام دهید.
نمونه کد Python
import os
from openai import OpenAI
client = OpenAI(
base_url="http://127.0.0.1:8000/v1",
api_key=os.environ["VLLM_API_KEY"],
)
response = client.chat.completions.create(
model="iranica-llm",
messages=[
{
"role": "system",
"content": "پاسخها را واضح و فارسی بنویس.",
},
{
"role": "user",
"content": "یک سرور GPU چه کاربردی دارد؟",
},
],
max_tokens=256,
temperature=0.2,
)
print(response.choices[0].message.content)این نمونه فرض میکند برنامه Python روی همان سرور یا از طریق یک تونل امن به Loopback سرور متصل است.
اگر کلاینت در سرور دیگری قرار دارد، باید یک مسیر شبکهای امن یا Gateway احراز هویتشده طراحی کنید.
چگونه خروجی مدل را بهصورت Streaming دریافت کنیم؟
در پاسخ معمولی، کلاینت تا آماده شدن نتیجه درخواست منتظر میماند.
اما برای محیط چت، میتوان با Streaming متن را بهصورت تدریجی دریافت کرد تا کاربر زودتر بخشهای اولیه پاسخ را ببیند.
نمونه Streaming با Python
stream = client.chat.completions.create(
    model="iranica-llm",
    messages=[
        {
            "role": "user",
            "content": "مفهوم GPU را توضیح بده.",
        },
    ],
    max_tokens=256,
    stream=True,
)

for chunk in stream:
    if not chunk.choices:
        continue

    text = chunk.choices[0].delta.content

    if text:
        print(text, end="", flush=True)

print()
برای یک رابط وب واقعی باید مدیریت قطع اتصال، Timeout، لغو درخواست و محدودیت طول خروجی نیز طراحی شود.
چگونه Batching و مصرف VRAM را در vLLM تنظیم کنیم؟
بعد از راهاندازی اولیه میتوان تنظیمات حافظه و Scheduler را برای Workload واقعی بهبود داد.
هدف این نیست که همه پارامترها را روی بیشترین مقدار قرار دهیم؛ بلکه باید تعادل مناسبی میان Throughput، تأخیر و پایداری ایجاد شود.
gpu-memory-utilization
این گزینه سهم هدف حافظه GPU برای موتور vLLM را مشخص میکند.
در مثال اولیه مقدار 0.80 استفاده کردیم تا بهجای اختصاص بسیار تهاجمی حافظه، فضای بیشتری برای Runtime و شرایط محیط باقی بماند.
مقدار مناسب باید با توجه به GPU، سایر فرآیندهای فعال و مصرف واقعی مدل آزمایش شود.
max-model-len
این پارامتر طول Sequence قابل پردازش را محدود میکند. کاهش آن میتواند برای شروع و ظرفیتسنجی مفید باشد، اما اندازه واقعی KV Cache به Scheduler و تعداد درخواستهای همزمان نیز وابسته است.
max-num-seqs
این گزینه ظرفیت تعداد Sequenceهایی را که موتور میتواند در یک Iteration پردازش کند محدود میکند.
تنظیم بیشازحد بالا ممکن است سربار حافظه یا رقابت بین درخواستها را افزایش دهد.
max-num-batched-tokens
این گزینه تعداد Tokenهایی را که در یک Iteration قابل زمانبندی هستند کنترل میکند.
تنظیم آن روی زمان Prefill، Throughput و رفتار درخواستهای کوتاه و بلند تأثیر میگذارد.
نمونه تنظیم محافظهکارانه برای آزمایش
vllm serve Qwen/Qwen3-0.6B \
  --host 127.0.0.1 \
  --port 8000 \
  --served-model-name iranica-llm \
  --api-key "$VLLM_API_KEY" \
  --gpu-memory-utilization 0.80 \
  --max-model-len 2048 \
  --max-num-seqs 8 \
  --max-num-batched-tokens 2048
این مقادیر صرفاً نقطه شروع هستند. برای بعضی GPUها و مدلها ممکن است تنظیمات پیشفرض نتیجه بهتری داشته باشند.
بنابراین هر تغییر باید با همان Workload، شرایط و معیارهای Benchmark مقایسه شود.
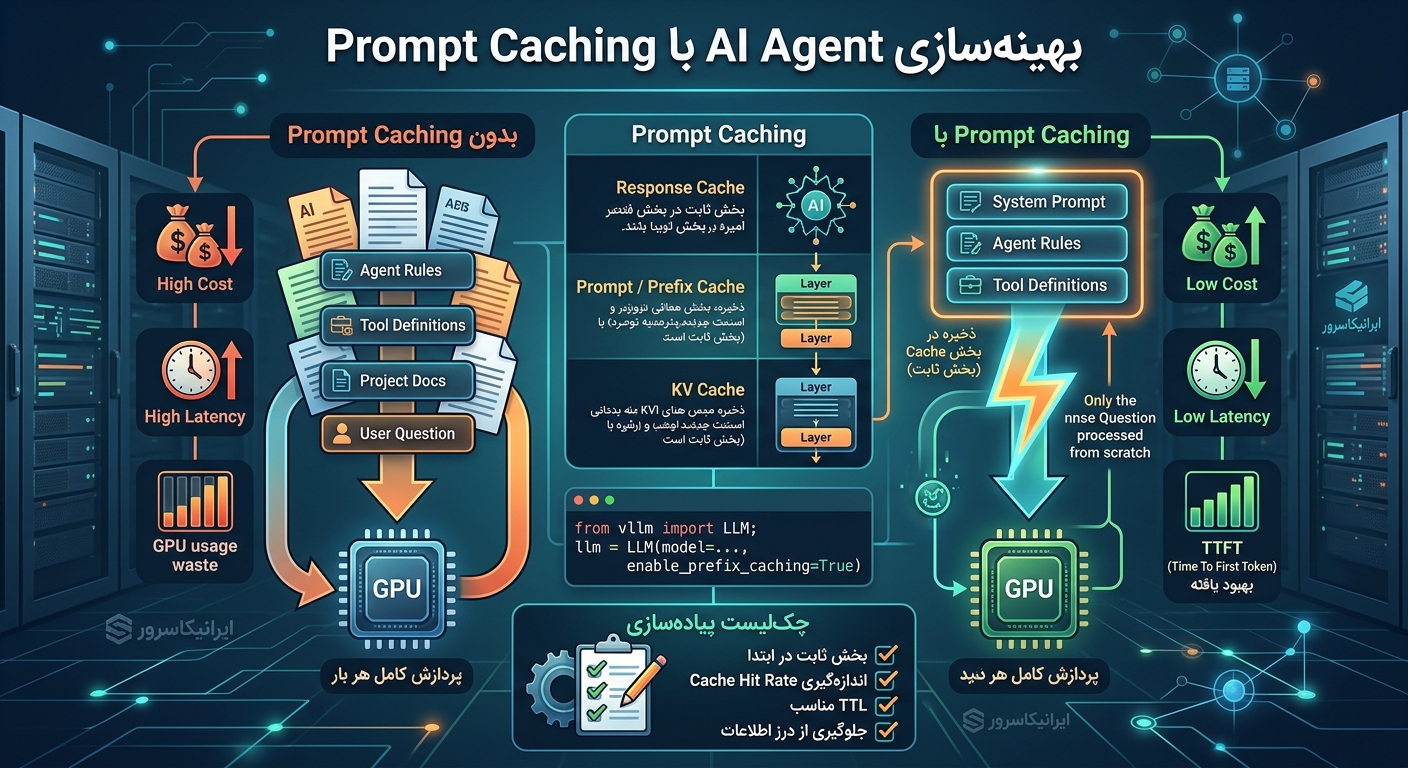
Automatic Prefix Caching چیست؟
بعضی درخواستها بخش ابتدایی مشترکی دارند؛ برای مثال، یک System Prompt طولانی یا دستورالعمل ثابت که برای تمام درخواستهای یک برنامه استفاده میشود.
اگر این بخش از نظر Token یکسان باشد، Prefix Caching میتواند بخشهایی از KV Cache محاسبهشده را دوباره استفاده کند.
مزیت Prefix Caching
در شرایط مناسب، میتواند نیاز به محاسبه مجدد بخشی از Prompt مشترک را کاهش دهد و زمان Prefill را بهبود دهد.
چه زمانی Prefix Caching کمک نمیکند؟
اگر درخواستها Prefix مشترک مؤثری نداشته باشند یا ترتیب Tokenها تغییر کند، ممکن است سود کمی داشته باشد.
همچنین Prefix Caching مستقیماً هزینه Decode کردن Tokenهای جدید را حذف نمیکند.
نکته امنیتی در محیط چندکاربره
اشتراک Cache بین کاربران غیرقابل اعتماد میتواند خطرهای جانبی مانند افشای اطلاعات از طریق تفاوت زمان پاسخ ایجاد کند.
در نسخههای جدید vLLM، مکانیزم cache_salt برای محدودسازی اشتراک Prefix Cache وجود دارد؛ اما این قابلیت جایگزین جداسازی واقعی Tenantها نیست.
برای کاربران یا سازمانهای غیرقابل اعتماد، معماری Gateway و جداسازی Instance باید براساس نیاز امنیتی بررسی شود.
Quantization چه نقشی در اجرای مدلهای بزرگتر دارد؟
Quantization روشی برای نمایش یا محاسبه بعضی بخشهای مدل با Precision پایینتر است.
برای مثال، ذخیره وزنها با تعداد بیت کمتر میتواند حجم حافظه لازم برای وزن مدل را کاهش دهد.
مزایای احتمالی
- کاهش مصرف حافظه وزن مدل.
- امکان اجرای بعضی مدلهای بزرگتر روی GPU محدودتر.
- بهبود عملکرد در ترکیبهای سازگار مدل و سختافزار.
محدودیتها
- احتمال افت کیفیت خروجی نسبت به مدل اصلی.
- سازگاری متفاوت Quantization با GPUها.
- سربار Metadata و Kernelهای اختصاصی.
- لزوم آزمایش عملکرد واقعی به جای تکیه صرف بر حجم فایل.
آیا هر مدل ۴ بیتی روی vLLM کار میکند؟
خیر. فرمت Quantization، معماری مدل و Backend انتخابشده باید توسط vLLM و سختافزار پشتیبانی شوند.
پیش از انتخاب مدل Quantized، مستندات مدل و جدول سازگاری vLLM را بررسی کنید.
مستندات رسمی Quantization در vLLM
چگونه vLLM را روی چند GPU اجرا کنیم؟
اگر وزن مدل یا بار پردازشی آن برای یک GPU مناسب نباشد، میتوان از روشهای Parallelism استفاده کرد.
Tensor Parallelism چیست؟
در Tensor Parallelism، محاسبات بخشهایی از مدل میان چند GPU تقسیم میشوند.
برای مثال، در یک سرور دارای دو GPU سازگار میتوان تنظیم زیر را بررسی کرد:
vllm serve MODEL_ID \
  --tensor-parallel-size 2 \
  --host 127.0.0.1 \
  --port 8000 \
  --api-key "$VLLM_API_KEY"
عبارت MODEL_ID باید با شناسه یک مدل پشتیبانیشده جایگزین شود.
آیا دو GPU با حافظه ۲۴ گیگابایت دقیقاً معادل یک GPU دارای ۴۸ گیگابایت هستند؟
خیر. ممکن است وزن مدل تقسیم شود، اما هر GPU سربار حافظه، KV Cache و محدودیتهای ارتباطی خودش را دارد.
همچنین سرعت ارتباط میان GPUها میتواند روی نتیجه نهایی تأثیر بگذارد.
Data Parallelism چه زمانی کاربرد دارد؟
برای افزایش ظرفیت پاسخگویی به درخواستها میتوان در معماری مناسب از چند Replica یا Data Parallelism استفاده کرد.
انتخاب Tensor Parallelism، Pipeline Parallelism یا Data Parallelism باید براساس اندازه مدل، نوع GPU و هدف Throughput یا Latency باشد.
چگونه سرعت واقعی vLLM Server را Benchmark کنیم؟
هیچ عدد ثابتی برای سرعت تمام مدلها و GPUها وجود ندارد. یک مدل کوچک با Prompt کوتاه ممکن است نتیجه بسیار متفاوتی نسبت به مدل بزرگ با Context چند هزار Token داشته باشد.
برای مقایسه درست، باید Workload مشخص و قابل بازتولید تعریف کنیم.
معیارهای اصلی Benchmark
| شاخص | کاربرد |
|---|---|
| Request Throughput | تعداد درخواست کامل در ثانیه |
| Output Token Throughput | تعداد Token خروجی تولیدشده در ثانیه |
| TTFT | زمان دریافت اولین Token |
| TPOT | زمان تولید Tokenهای بعدی |
| P50 Latency | تأخیر میانه درخواستها |
| P95 Latency | تأخیر صدک ۹۵ درخواستها |
| Error Rate | درصد درخواستهای ناموفق |
| GPU Memory | مصرف حافظه در حین تست |
نصب وابستگیهای بنچمارک
uv pip install 'vllm[bench]==0.33.0' \
  --torch-backend=auto
اجرای Benchmark اولیه
با فرض فعال بودن API روی Loopback، همان Secret و مدل آموزشی، میتوانید یک تست محدود اجرا کنید:
vllm bench serve \
  --backend vllm \
  --base-url http://127.0.0.1:8000 \
  --model iranica-llm \
  --header "Authorization=Bearer ${VLLM_API_KEY}" \
  --dataset-name random \
  --random-input-len 128 \
  --random-output-len 64 \
  --num-prompts 100 \
  --request-rate 2 \
  --max-concurrency 4
این تست از دادههای تصادفی با طول مشخص استفاده میکند. نتیجه آن برای مقایسه آزمایشگاهی مفید است، اما الزاماً رفتار کاربران واقعی را نشان نمیدهد.
چگونه تأثیر Concurrency را مقایسه کنیم؟
میتوانید آزمایشهای جداگانه با همزمانی ۱، ۴، ۸ و ۱۶ درخواست اجرا کنید و نتیجه را ثبت کنید.
توجه داشته باشید که Request Rate نیز باید متناسب با هدف تست تنظیم شود. افزایش سقف Concurrency بهتنهایی تضمین نمیکند تعداد بیشتری درخواست همزمان وارد سرور شوند.
چه چیزهایی را ثابت نگه داریم؟
- مدل و نسخه دقیق فایل وزن.
- نسخه vLLM و Driver.
- نوع GPU و تعداد آن.
- طول Prompt و خروجی.
- Request Rate و تعداد درخواستها.
- تنظیمات Scheduler و Context.
- وضعیت Prefix Cache.
- گرم بودن مدل و محیط اجرا.
آیا باید Benchmark را روی همان سرور GPU اجرا کنیم؟
برای تست اولیه ممکن است کافی باشد، اما ابزار Benchmark خودش CPU و منابع شبکه مصرف میکند.
برای ظرفیتسنجی Production بهتر است از کلاینت بارگذاری جداگانه با شبکه کنترلشده استفاده کنید تا سربار تولید درخواست با منابع خود مدل تداخل نداشته باشد.
آیا نتیجه Benchmark فقط با Tokens/sec مشخص میشود؟
خیر. اگر Throughput بالا باشد اما P95 Latency از حد قابل قبول سرویس عبور کند، تنظیمات برای تجربه کاربران مناسب نخواهد بود.
بهتر است معیارهای پذیرش را پیش از تست تعریف کنید؛ مثلاً حداکثر زمان اولین Token، تعداد کاربران همزمان و نرخ خطای مجاز.
مانیتورینگ عملکرد vLLM با Prometheus Metrics
vLLM برای بسیاری از شاخصهای عملیاتی، Metrics قابل استفاده در مانیتورینگ ارائه میکند.
از جمله شاخصهای قابل بررسی میتوان به زمان اولین Token، زمان صف درخواست، میزان Cache Hit و تعداد Tokenهای پردازششده اشاره کرد.
مشاهده Metrics محلی
curl --fail --silent \
http://127.0.0.1:8000/metrics
این Endpoint نباید بدون محدودیت روی اینترنت عمومی در دسترس باشد.
چه شاخصهایی را مانیتور کنیم؟
- TTFT و تأخیر کلی درخواستها.
- زمان انتظار در Queue.
- تعداد درخواستهای موفق و ناموفق.
- Throughput Tokenهای Prompt و خروجی.
- استفاده از KV Cache و Prefix Cache.
- تعداد Preemptionهای درخواست.
- مصرف واقعی VRAM از طریق ابزارهای GPU.
نام دقیق Metricها ممکن است بین نسخهها تغییر کند. برای داشبورد Production، فهرست Metricهای منتشرشده توسط نسخه نصبشده را مبنا قرار دهید.
مستندات Production Metrics در vLLM
امنیت vLLM Server؛ چرا API Key بهتنهایی کافی نیست؟
اگر vLLM را روی یک GPU Server راهاندازی میکنید، امنیت API به اندازه سرعت مدل اهمیت دارد.
دسترسی غیرمجاز میتواند باعث مصرف VRAM و GPU، افزایش هزینه زیرساخت، اختلال سرویس یا افشای اطلاعات حساس شود.
۱. API را بدون ضرورت عمومی نکنید
در نمونه آموزشی، vLLM فقط روی 127.0.0.1 گوش میدهد.
این تنظیم برای آزمایش محلی مناسب است؛ زیرا کاربران اینترنت نمیتوانند مستقیماً به پورت سرویس متصل شوند.
۲. محدودیت API Key داخلی
در مستندات امنیتی vLLM مشخص شده که –api-key همه Endpointها را محافظت نمیکند و برخی مسیرهای دیگر میتوانند همچنان قابل دسترسی باشند.
بنابراین برای انتشار اینترنتی باید یک Gateway یا Reverse Proxy امن با Allowlist مسیرها، احراز هویت و کنترل دسترسی طراحی شود.
۳. Rate Limiting
بدون محدودیت نرخ درخواست، یک کلاینت میتواند تعداد زیادی Request ارسال کند و ظرفیت GPU را اشغال کند.
بهتر است محدودیت تعداد درخواست، طول Prompt، Token خروجی، تعداد درخواستهای همزمان و Timeout در Gateway اعمال شود.
۴. عدم فعالسازی قابلیتهای توسعه در Production
حالتهای توسعه و Endpointهای مدیریتی اضافی نباید در یک سرویس عمومی فعال شوند.
برخی Endpointهای توسعه میتوانند عملیات بسیار حساسی روی موتور Inference انجام دهند.
۵. کنترل اجرای کد مدل
گزینههایی مانند trust-remote-code نباید بدون بررسی مدل و منبع آن فعال شوند؛ زیرا ممکن است امکان اجرای کد ارائهشده توسط مخزن مدل را فراهم کنند.
۶. حفاظت از Hugging Face Token
اگر مدل به Token نیاز دارد، آن را در فایل عمومی، Repository یا Log قرار ندهید.
بهتر است Secretها با ابزار مناسب مدیریت شوند و مجوز خواندن آنها محدود باشد.
۷. جداسازی Tenantها
اگر چند سازمان غیرقابل اعتماد از یک موتور استفاده میکنند، اشتراک Cache و منابع نیازمند بررسی امنیتی دقیق است.
قابلیت cache_salt برای کاهش برخی ریسکهای مرتبط با Prefix Cache مفید است، اما جایگزین ایزولهسازی کامل Tenantها نیست.
۸. محدودسازی دسترسی GPU Server
سرویس مدل بهتر است با حساب غیرمدیریتی اجرا شود و دسترسی به فایلها، مدلها، شبکه و منابع موردنیاز محدود باشد.
نتیجه: vLLM باید پشت مرز امنیتی مورد اعتماد قرار گیرد. API Key داخلی فقط بخشی از دفاع است.
راهاندازی vLLM در Production چه تفاوتی با تست اولیه دارد؟
اجرای موفق یک فرمان vllm serve فقط نشان میدهد مدل در شرایط فعلی آماده ارائه API شده است.
برای استفاده عملیاتی باید مسئله مدیریت فرآیند، ظرفیت، امنیت، مانیتورینگ و بازیابی پس از خطا نیز حل شود.
مدیریت فرآیند
میتوان سرویس را با systemd یا زیرساخت Container مدیریت کرد. حساب سرویس باید محدود باشد و فایلهای مدل و Cache مجوز مناسبی داشته باشند.
Health Check
بررسی سلامت باید شامل آماده بودن API و توانایی پاسخگویی مدل باشد؛ صرف فعال بودن فرآیند کافی نیست.
GPU Capacity
در صورت نزدیک شدن مصرف VRAM یا صف درخواستها به ظرفیت، Gateway باید محدودیت ورود درخواست اعمال کند.
Rolling Upgrade
قبل از تغییر نسخه vLLM، مدل یا Driver، باید تست سازگاری و Benchmark روی محیط جداگانه انجام شود.
یک ارتقای ناموفق میتواند باعث توقف سرویس یا تغییر کیفیت خروجی مدل شود.
Backup چه چیزی را باید حفظ کند؟
برای یک سرویس Model Serving، نگهداری تنظیمات، نسخه مدل، ساختار Deploy، Secretها و اطلاعات عملیاتی موردنیاز از Backup کردن بیهدف کل Cache دانلود مهمتر است.
اگر مدل Fine-tune شده یا وزنهای اختصاصی دارید، فایلهای آن نیز باید در نسخه پشتیبان امن نگهداری شوند.
استقرار چند Replica
اگر بار درخواست زیاد شود، میتوان از چند Instance با Load Balancer مناسب استفاده کرد.
البته تعداد GPU و هزینه زیرساخت افزایش پیدا میکند و باید با بهبود واقعی Throughput و Latency توجیه شود.
مقایسه vLLM، Ollama و Hugging Face TGI
برای اجرای مدلهای زبانی روی سرور، ابزارهای مختلفی وجود دارند. انتخاب ابزار به هدف پروژه و سطح کنترل موردنیاز بستگی دارد.
| معیار | vLLM | Ollama | TGI |
|---|---|---|---|
| تمرکز اصلی | Model Serving با Throughput بالا | تجربه ساده اجرای مدل | Serving مدلهای زبانی |
| مناسب برای شروع سریع | متوسط | معمولاً سادهتر | وابسته به محیط |
| مدیریت Batching | قابلیتهای پیشرفته | متناسب با موتور و نسخه | قابلیتهای Serving |
| OpenAI-compatible API | بله، برای Endpointهای پشتیبانیشده | بله، در محدوده پشتیبانیشده | بسته به API و نسخه |
| تنظیمات GPU و Scheduler | انعطافپذیر | معمولاً سادهتر | دارای تنظیمات Serving |
| کاربرد رایج | خدمات Inference با بار همزمان | توسعه و اجرای محلی مدل | استقرار سرویس مدل |
این جدول به معنی سریعتر بودن همیشگی یک ابزار نیست. برای تصمیم نهایی باید همان مدل، همان GPU و همان Workload را روی ابزارهای موردنظر آزمایش کنید.
همچنین وضعیت توسعه، سازگاری مدل و پشتیبانی ویژگیها میتواند با گذشت زمان تغییر کند.
چه زمانی vLLM انتخاب مناسبتری است؟
اگر هدف اصلی ساخت یک API مدل زبانی با تعداد درخواستهای همزمان، مدیریت دقیق حافظه GPU و اندازهگیری عملکرد است، vLLM گزینه مهمی برای بررسی محسوب میشود.
چه زمانی ابزار سادهتر کافی است؟
اگر فقط میخواهید یک مدل کوچک را برای آزمایش شخصی اجرا کنید، پیچیدگی راهاندازی یک سرویس با ظرفیت بالا ممکن است ضروری نباشد.
آیا اجرای مدل روی سرور GPU از API آماده ارزانتر است؟
این موضوع به مقدار استفاده واقعی بستگی دارد.
در سرویس API آماده، معمولاً هزینه براساس Token یا مدل مصرفشده محاسبه میشود؛ اما در سرور GPU اختصاصی، حتی وقتی درخواست کمی دارید، هزینه زمان اجاره GPU همچنان وجود دارد.
هزینههای اجرای اختصاصی
- اجاره یا خرید GPU Server.
- فضای ذخیرهسازی وزن مدلها.
- پهنای باند و انتقال داده.
- مانیتورینگ و نگهداری.
- نیروی فنی و مدیریت زیرساخت.
- ظرفیت رزرو برای ساعات اوج بار.
فرمول محاسبه تقریبی هزینه بهازای درخواست
برای یک بازه زمانی مشخص:
Cost per Completed Request = Total Infrastructure Cost / Successfully Completed Requests
برای هزینه بهازای هر میلیون Token خروجی نیز باید تعداد واقعی Tokenهای خروجی تولیدشده را در همان بازه اندازهگیری کنید.
این محاسبه باید هزینه بیکاری سرور، ظرفیت رزرو و درخواستهای ناموفق را نیز در نظر بگیرد.
آیا GPU قویتر همیشه بهصرفهتر است؟
نه لزوماً. GPU قدرتمندتر ممکن است Throughput بیشتری داشته باشد، اما هزینه اجاره آن نیز بالاتر است.
برای انتخاب اقتصادی بهتر است هزینه را نسبت به Throughput تحت Latency قابل قبول مقایسه کنید.
خطاهای رایج نصب و اجرای vLLM Server
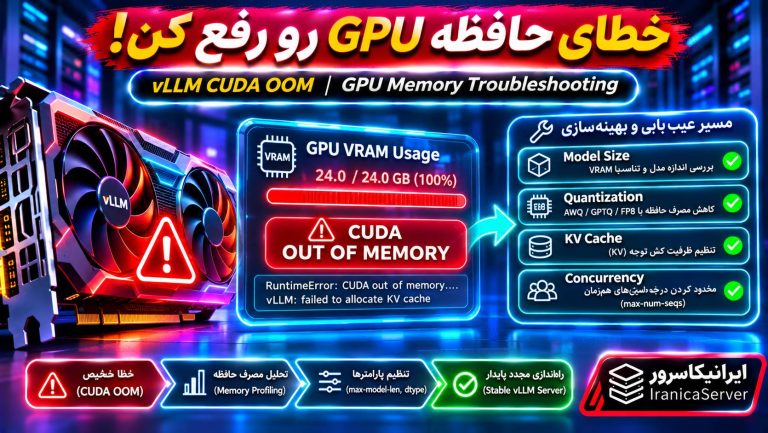
۱. خطای CUDA Out of Memory
ممکن است وزن مدل، KV Cache یا سربار Runtime از ظرفیت GPU بیشتر شده باشد.
اندازه مدل، max-model-len، تعداد درخواستهای همزمان و GPU Memory Utilization را بررسی کنید.
۲. دستور nvidia-smi کار نمیکند
این مشکل ممکن است به Driver، عدم اختصاص GPU به VPS یا ناسازگاری محیط مربوط باشد. قبل از بررسی vLLM، باید GPU در سیستمعامل بهدرستی قابل شناسایی باشد.
۳. خطای مربوط به CUDA Runtime یا PyTorch
ممکن است نسخههای Driver، PyTorch و Wheel نصبشده سازگار نباشند. بهتر است نصب را داخل یک محیط Python تازه و طبق مستندات همان نسخه انجام دهید.
۴. خطای مربوط به Compute Capability
ممکن است GPU قدیمیتر از حداقل پشتیبانیشده مسیر CUDA باشد یا Kernel موردنیاز آن موجود نباشد.
مدل GPU و جدول سازگاری سختافزار را بررسی کنید.
۵. مدل بارگذاری نمیشود
ابتدا شناسه مدل، مجوز Hugging Face، دسترسی شبکه، فضای دیسک و سازگاری معماری مدل را بررسی کنید.
۶. خطای Chat Template
بعضی مدلها Chat Template مناسب ندارند. در این حالت Chat Completions ممکن است خطا بدهد.
از مدل سازگار یا Chat Template معتبر و مناسب همان مدل استفاده کنید.
۷. API خطای 401 برمیگرداند
برای مسیرهای محافظتشده، مقدار Authorization Header و API Key را بررسی کنید.
اما دقت کنید موفق بودن احراز هویت در /v1 به معنی محافظت شدن تمام Endpointهای دیگر نیست.
۸. خطای Connection Refused
ممکن است سرویس هنوز آماده نشده، فرآیند متوقف شده یا کلاینت به آدرس نادرستی متصل شده باشد.
وضعیت فرآیند، پورت و لاگ راهاندازی را بررسی کنید.
۹. پاسخدهی کند با وجود GPU قوی
طول Prompt، تعداد درخواستهای همزمان، زمان Queue، KV Cache، Scheduler و نرخ ورود درخواستها را اندازهگیری کنید.
بدون تفکیک TTFT و TPOT نمیتوان علت کندی را دقیق تشخیص داد.
۱۰. افزایش Concurrency باعث افت شدید Latency میشود
ممکن است موتور به ظرفیت GPU یا KV Cache نزدیک شده باشد. تعداد Sequenceهای فعال و محدودیت صف را متناسب با SLO تنظیم کنید.
۱۱. بنچمارک نتایج غیرقابل مقایسه میدهد
احتمالاً مدل، طول ورودی، تعداد درخواستها، Warm-up یا وضعیت Cache میان تستها متفاوت بوده است.
شرایط آزمایش را ثبت و ثابت نگه دارید.
۱۲. Prefix Cache تأثیر کمی دارد
ممکن است درخواستها Prefix مشترک کافی نداشته باشند یا بیشتر زمان درخواست صرف Decode شود.
برای نتیجهگیری، نسبت Cache Hit و TTFT را بررسی کنید.
۱۳. مدل Quantized اجرا نمیشود
فرمت Quantization ممکن است با معماری مدل، GPU یا Backend انتخابشده سازگار نباشد.
۱۴. خروجی مدل فارسی کیفیت کافی ندارد
مشکل لزوماً مربوط به vLLM نیست. کیفیت تولید فارسی به خود مدل، Prompt، Tokenizer و تنظیمات تولید بستگی دارد.
۱۵. سرویس پس از Restart سرور اجرا نمیشود
اگر vLLM فقط داخل یک Terminal اجرا شده باشد، پس از Restart باید دوباره راهاندازی شود. برای Production از مدیریت فرآیند و Health Check مناسب استفاده کنید.
۱۶. API روی اینترنت بدون محدودیت قرار گرفته است
این وضعیت میتواند باعث سوءاستفاده از GPU و دسترسی ناخواسته شود. اتصال عمومی را محدود کنید و Gateway امن با احراز هویت و کنترل مسیرها ایجاد کنید.
سؤالات متداول درباره vLLM Server
vLLM چیست؟
یک موتور متنباز برای اجرای مدلهای زبانی و ارائه API با تمرکز بر بهرهوری پردازش و مدیریت حافظه است.
آیا vLLM یک مدل هوش مصنوعی است؟
خیر. vLLM موتور اجرای مدل است و باید مدل سازگار جداگانه انتخاب شود.
آخرین نسخه vLLM چیست؟
در تاریخ بررسی مقاله، ۴ نوامبر ۲۰۲۶، آخرین نسخه پایدار 0.33.0 است.
آیا vLLM روی Ubuntu 24.04 نصب میشود؟
بله، در صورت داشتن GPU و محیط نرمافزاری سازگار میتوان آن را نصب کرد.
آیا برای vLLM حتماً GPU لازم است؟
vLLM Backendهای دیگری نیز دارد، اما تمرکز این آموزش روی اجرای شتابیافته با NVIDIA GPU است.
آیا vLLM روی VPS معمولی کار میکند؟
برای روش این مقاله باید GPU سازگار به VPS اختصاص داده شده باشد؛ CPU و RAM معمولی جایگزین VRAM نیستند.
چگونه GPU مناسب انتخاب کنیم؟
با بررسی اندازه مدل، نوع Precision، ظرفیت KV Cache، همزمانی درخواستها و سازگاری GPU.
KV Cache چیست؟
حافظهای برای نگهداری اطلاعات Key و Value مراحل قبلی تولید متن است تا محاسبات Attention تکراری کاهش یابند.
PagedAttention چیست؟
روشی برای مدیریت بلوکی KV Cache است که به استفاده کارآمدتر از حافظه کمک میکند.
Continuous Batching چیست؟
روشی برای زمانبندی پویا و پردازش همزمان درخواستهای متعدد هنگام تولید Token است.
آیا Continuous Batching همیشه Latency را کاهش میدهد؟
خیر. ممکن است Throughput را افزایش دهد، اما تأخیر تحت بار زیاد باید جداگانه اندازهگیری شود.
آیا vLLM با OpenAI API سازگار است؟
از چند Endpoint سازگار مانند Chat Completions پشتیبانی میکند؛ اما لزوماً همه قابلیتها و پارامترها یکسان نیستند.
چگونه Python را به vLLM وصل کنیم؟
برای Endpointهای سازگار میتوان OpenAI SDK را با Base URL سرور محلی vLLM تنظیم کرد.
آیا vLLM از Streaming پشتیبانی میکند؟
بله. میتوان خروجی متن را بهصورت تدریجی دریافت کرد.
چرا مدل روی GPU Out of Memory میشود؟
چون علاوه بر وزنها، KV Cache و حافظه Runtime نیز به VRAM نیاز دارند.
آیا Quantization مصرف VRAM را کاهش میدهد؟
در بسیاری از مدلها میتواند مصرف حافظه وزنها را کاهش دهد، اما سربار و سازگاری آن باید بررسی شود.
آیا هر مدل ۴ بیتی قابل اجرا است؟
خیر. نوع Quantization و معماری مدل باید توسط vLLM و GPU پشتیبانی شوند.
آیا vLLM از چند GPU پشتیبانی میکند؟
بله، با روشهایی مانند Tensor Parallelism و دیگر سازوکارهای Parallelism متناسب با محیط.
TTFT چیست؟
زمان سپریشده از آغاز درخواست تا دریافت اولین Token خروجی است.
TPOT چیست؟
شاخص زمان تولید Tokenهای خروجی پس از اولین Token است.
بهترین معیار سرعت vLLM چیست؟
یک معیار واحد کافی نیست. باید Throughput، TTFT، TPOT، P95 Latency و نرخ خطا با هم بررسی شوند.
چگونه Benchmark انجام دهیم؟
با ابزار vllm bench serve و تعریف مدل، طول Prompt، طول خروجی، نرخ درخواست و Concurrency مشخص.
آیا API Key داخلی vLLM برای امنیت کافی است؟
خیر. همه Endpointها را پوشش نمیدهد و باید از کنترل شبکه و Gateway امن نیز استفاده کرد.
آیا میتوان vLLM را پشت Nginx قرار داد؟
بله، به شرط طراحی درست TLS، احراز هویت، محدودیت مسیرها، Timeout و کنترل نرخ درخواست.
آیا vLLM برای AI Agent مناسب است؟
بله. Agent میتواند از API مدل میزبانیشده با vLLM استفاده کند، مشروط به اینکه مدل قابلیتهای موردنیاز آن را پشتیبانی کند.
آیا vLLM برای پشتیبانی فارسی مناسب است؟
به کیفیت مدل انتخابی بستگی دارد. باید پاسخگویی فارسی با مجموعه تست واقعی ارزیابی شود.
تفاوت vLLM و Ollama چیست؟
vLLM بر Serving و کارایی پردازش همزمان تمرکز دارد؛ Ollama معمولاً تجربه سادهتری برای دریافت و اجرای محلی مدل فراهم میکند.
آیا سرور GPU همیشه از API آماده ارزانتر است؟
خیر. هزینه به نرخ استفاده، قیمت GPU، بهرهوری و هزینه نگهداری زیرساخت بستگی دارد.
آیا افزایش RAM سرور کمبود VRAM را حل میکند؟
خیر. ممکن است بعضی روشهای Offload کمک کنند، اما RAM معمولی جایگزین مستقیم حافظه GPU با همان عملکرد نیست.
آیا میتوان یک vLLM Server را به چند برنامه متصل کرد؟
بله، اما باید ظرفیت GPU، محدودیت همزمانی، امنیت و کنترل دسترسی برنامهها مدیریت شوند.
جمعبندی
vLLM Server یکی از ابزارهای مهم برای ساخت API مدل زبانی روی سرور GPU است. این موتور با استفاده از مدیریت کارآمد KV Cache، PagedAttention و Continuous Batching تلاش میکند درخواستهای همزمان را با بهرهوری مناسب پردازش کند.
در این آموزش نسخه 0.33.0 را بررسی کردیم و روش نصب روی Ubuntu 24.04، راهاندازی مدل Qwen3-0.6B، ساخت OpenAI-compatible API و اتصال برنامه Python را توضیح دادیم.
همچنین دیدیم که ظرفیت VRAM فقط به حجم وزن مدل بستگی ندارد و عواملی مانند طول Context، KV Cache و تعداد کاربران همزمان نیز اهمیت دارند.
برای بهینهسازی واقعی، باید Throughput و Latency را با ابزارهای Benchmark اندازهگیری کنیم و به جای انتخاب تنظیمات براساس حدس، از نتایج آزمایش استفاده کنیم.
از نظر امنیتی نیز نباید API مدل را بدون Gateway مناسب در اینترنت منتشر کرد. در نسخههای فعلی vLLM، API Key داخلی تمام Endpointها را محافظت نمیکند و جداسازی Tenantها نیازمند طراحی مستقل است.
نتیجه نهایی: اگر میخواهید یک مدل زبانی را روی GPU اختصاصی اجرا کنید و از طریق نرمافزار یا Agent به آن دسترسی داشته باشید، vLLM گزینهای جدی برای بررسی است؛ اما انتخاب GPU و تنظیمات باید براساس مدل واقعی، Benchmark و نیاز امنیتی پروژه انجام شود.
برای آشنایی با کاربرد این API در یک سیستم چندAgent میتوانید مقاله ساخت تیم چند Agent با AutoGen را مطالعه کنید. همچنین راهنمای ساخت AI Support Agent با بررسی صحت پاسخ نمونهای از کاربرد مدل زبانی در یک محصول عملی است.
منابع و مستندات رسمی
۱. وبسایت رسمی vLLM
معرفی موتور Inference، Continuous Batching و قابلیتهای اصلی.
۲. vLLM GitHub Releases
نسخههای منتشرشده و یادداشت تغییرات رسمی.
۳. vLLM 0.33.0 در PyPI
اطلاعات بسته نسخه 0.33.0 و فایلهای نصب.
۴. نصب vLLM روی GPU
سازگاری سختافزار، Python، CUDA و روش نصب.
۵. OpenAI-Compatible Server
Endpointها، نحوه اتصال کلاینت و محدودیتهای API.
۶. vLLM Serve CLI
پارامترهای Scheduler، GPU Memory و اجرای سرور.
۷. Automatic Prefix Caching
روش استفاده مجدد از KV Cache برای Prefixهای مشترک.
۸. Benchmark Serving
پارامترهای vllm bench serve و روش اندازهگیری عملکرد.
۹. Production Metrics
شاخصهای TTFT، KV Cache، Queue و Throughput.
۱۰. امنیت vLLM
محدودیتهای احراز هویت، Multi-tenancy و Cache Salting.
۱۱. مقاله اصلی PagedAttention
مبانی پژوهشی مدیریت حافظه مدلهای زبانی.
Efficient Memory Management for Large Language Model Serving with PagedAttention
۱۲. مستندات Qwen3-0.6B
مشخصات مدل نمونه و شرایط استفاده.
۱۳. راهنمای رسمی uv
نصب و مدیریت محیط Python.
دیدگاهها (۰)