
 Amir Jabbari
این مشکلات همیشه به معنی کمبود حافظه GPU نیستند. وقتی یک مدل با vLLM روی چند GPU اجرا میشود، کارتهای گرافیک باید در مراحل مختلف محاسبات با یکدیگر ارتباط برقرار کنند. اگر GPUها روی Nodeهای متفاوت قرار داشته باشند، کیفیت شبکه، انتخاب Interface، تنظیمات NCCL و هماهنگی فرآیندها نیز اهمیت پیدا میکند.
برای راهاندازی صحیح vLLM Multi GPU NCCL باید چهار بخش را جداگانه بررسی کنیم: تقسیم مدل با Tensor و Pipeline Parallelism، مدیریت Workerها با Ray یا Multiprocessing، ارتباط بین GPUها با NCCL و اندازهگیری واقعی پهنای باند و تأخیر.
در این آموزش، ابتدا تفاوت اجرای چند GPU داخل یک سرور و اجرای Multi-Node را توضیح میدهیم. سپس روش نصب و آمادهسازی محیط، راهاندازی Ray Cluster، انتخاب Network Interface، تنظیم NCCL، استفاده از nccl-tests و اجرای Benchmark بین سرورها را بررسی میکنیم.
همچنین یاد میگیریم چگونه خطاهای ncclCommInitRank، مشکل شناسایی GPU در Ray، Timeout ارتباط بین Nodeها و افت عملکرد ناشی از شبکه را مرحلهبهمرحله عیبیابی کنیم.
این مقاله براساس مستندات vLLM 0.33.0 در نوامبر ۲۰۲۶ تهیه شده است. ازآنجاکه عملکرد اجرای توزیعشده به GPU، Driver، نسخه نرمافزار، معماری مدل و شبکه بستگی دارد، دستورهای چندسروری باید ابتدا در محیط آزمایشی و شبکه خصوصی اجرا شوند.
فهرست مطالب
چرا اجرای vLLM روی چند GPU ضروری میشود؟
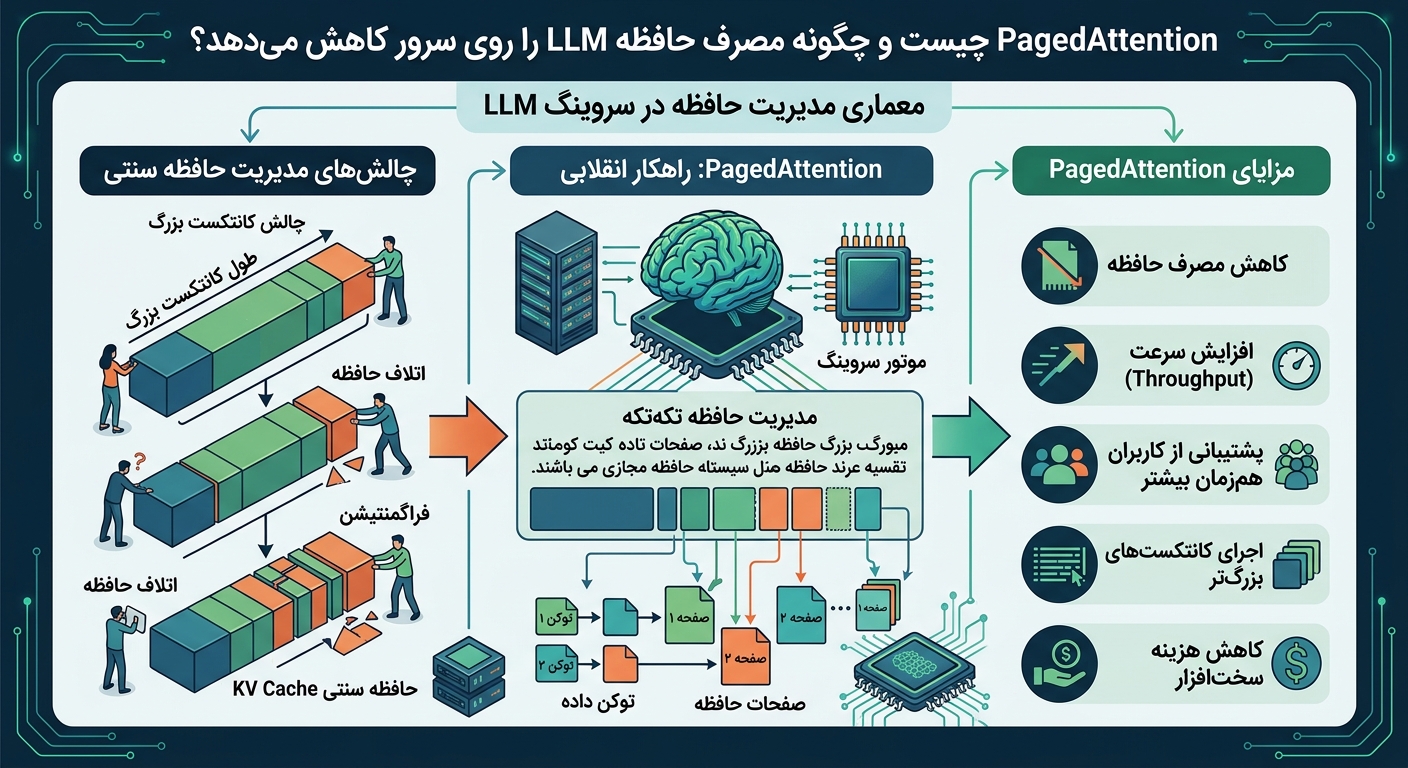
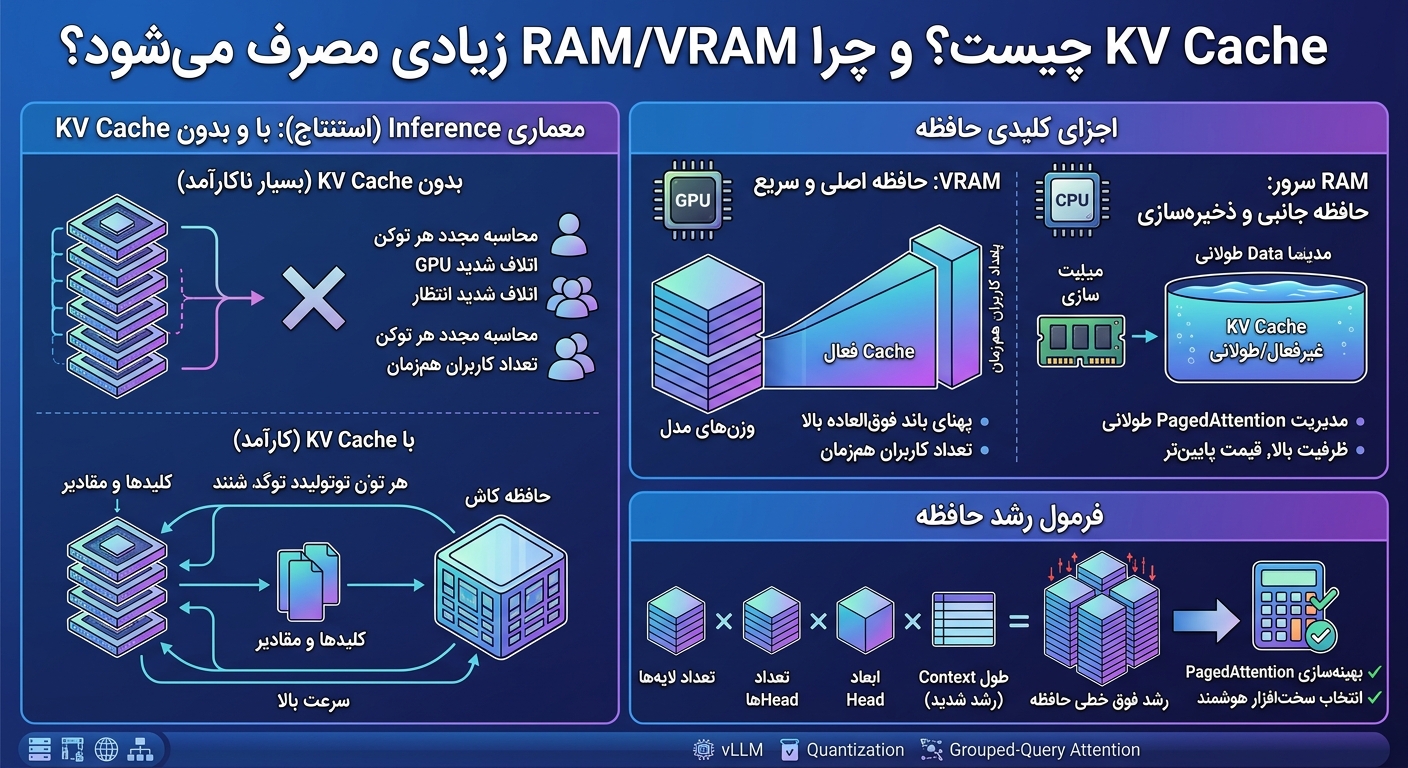
هنگام اجرای یک مدل زبانی، حافظه GPU فقط برای نگهداری وزنهای مدل استفاده نمیشود. بخشی از VRAM برای KV Cache، Activationها، CUDA Graphها و سایر بافرهای موتور Inference مصرف میشود.
اگر مدل یا حجم درخواستها از ظرفیت یک GPU فراتر برود، چند انتخاب پیش رو داریم:
- استفاده از مدل کوچکتر.
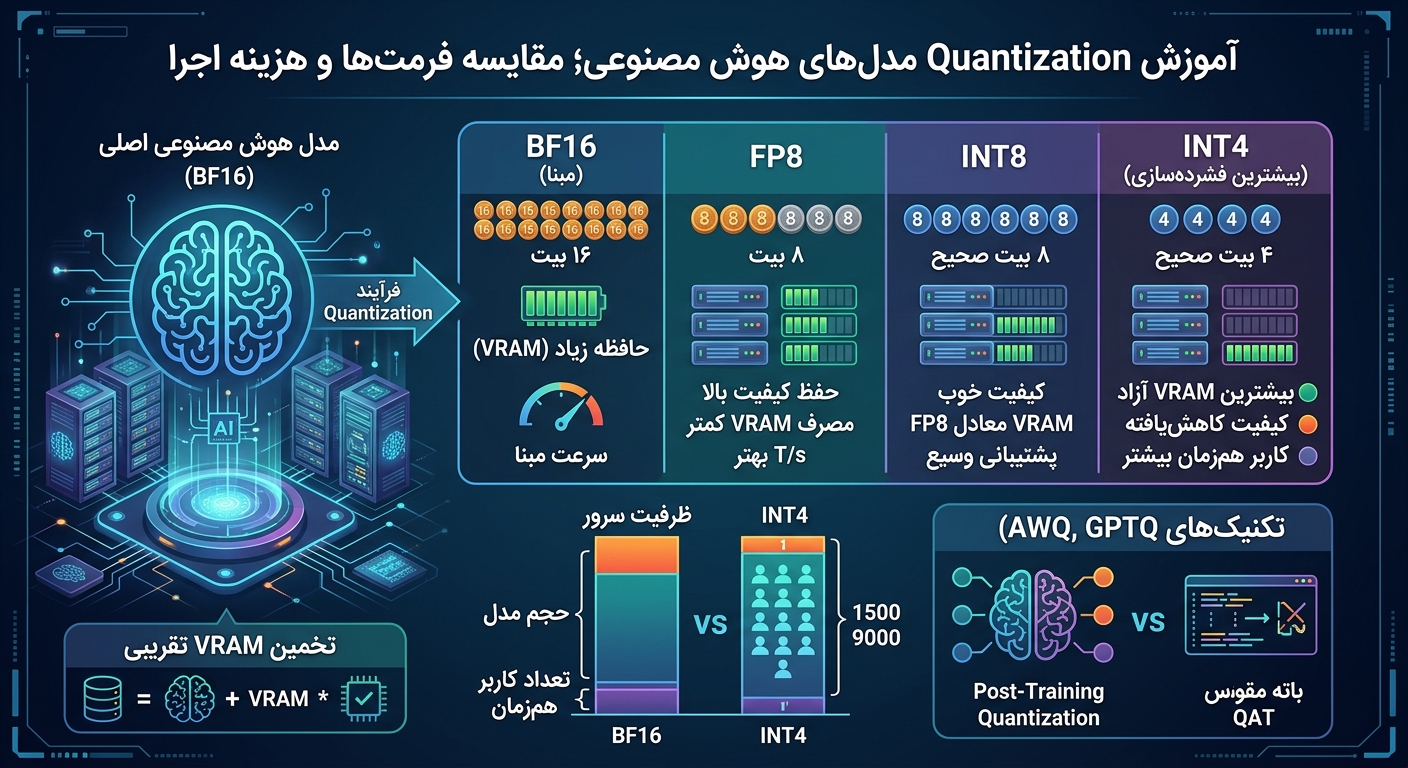
- استفاده از Quantization سازگار برای کاهش مصرف حافظه وزنها.
- کاهش طول Context یا تعداد درخواستهای همزمان.
- استفاده از GPU با VRAM بیشتر.
- تقسیم مدل یا بار پردازشی بین چند GPU.
انتخاب آخر زمانی اهمیت بیشتری پیدا میکند که بخواهیم مدل بزرگی را اجرا کنیم و کاهش اندازه یا Precision مدل برای نیاز پروژه مناسب نباشد.
Model Parallelism و Data Parallelism چه تفاوتی دارند؟
در Model Parallelism یک مدل میان چند GPU تقسیم میشود. هدف میتواند اجرای مدل بزرگتر یا موازیسازی بخشی از محاسبات باشد.
در Data Parallelism معمولاً چند Replica یا گروه پردازشی، درخواستهای مستقل را پردازش میکنند تا ظرفیت پاسخگویی افزایش یابد.
اگر مدل بهراحتی روی یک GPU جا میشود و فقط به کاربران بیشتری پاسخ میدهید، افزایش Tensor Parallelism لزوماً بهترین انتخاب نیست. گاهی چند Replica مستقل با Load Balancing مناسب، کارایی بهتری دارند.
آیا دو GPU همیشه دو برابر سریعتر هستند؟
خیر. اجرای موازی هزینه ارتباطی دارد. بعضی محاسبات باید میان GPUها هماهنگ شوند و این هماهنگی زمان مصرف میکند.
بنابراین تعداد GPU، سرعت حافظه، نوع ارتباط بین کارتها و معماری مدل باید با هم بررسی شوند.
تفاوت Single Node Multi GPU و Multi Node Multi GPU
قبل از انتخاب پارامترهای vLLM باید مشخص کنیم GPUها در یک ماشین فیزیکی قرار دارند یا بین چند سرور مستقل توزیع شدهاند.
حالت اول: چند GPU داخل یک سرور
در معماری Single Node، چند GPU از طریق PCIe یا ارتباطات داخلی سازگار مانند NVLink به یکدیگر متصل هستند.
GPU SERVER - NODE A

GPU 0 ─┐
GPU 1 ─┤
GPU 2 ─┤── One vLLM Engine
GPU 3 ─┘

Tensor Parallel Size = 4
در چنین سناریویی میتوان ابتدا از Backend داخلی Multiprocessing استفاده کرد و نیازی به ایجاد Ray Cluster چندسروری نیست.
حالت دوم: GPUها بین چند Node توزیع شدهاند
در این معماری، سرورها از طریق یک شبکه به یکدیگر متصل میشوند. ارتباط بین GPUهای داخل یک Node و ارتباط بین Nodeها ممکن است سرعت و تأخیر متفاوتی داشته باشند.
NODE A                       NODE B
10.10.0.11                   10.10.0.12

GPU 0   GPU 1                GPU 0   GPU 1
   \     /                      \     /
    TP Group A                   TP Group B
        |                            |
        +---- Private Network -------+
                 Pipeline

TP = 2
PP = 2
Total GPUs = 4
در این مثال، Tensor Parallelism داخل هر Node انجام میشود و Pipeline Parallelism مراحل مدل را بین دو Node تقسیم میکند.
این ترکیب نقطه شروع مناسبی برای معماری چندسروری است؛ البته مدل و GPUها باید با چنین تقسیمبندیای سازگار باشند.
Tensor Parallelism در vLLM چیست؟
Tensor Parallelism یا TP روشی برای تقسیم بعضی Tensorها و محاسبات مدل میان چند GPU است.
در این روش، GPUها ممکن است برای اجرای یک لایه یا مرحله محاسباتی، دادههایی را با یکدیگر مبادله کنند.
این ارتباطات میتوانند از عملیات جمعی مانند AllReduce استفاده کنند؛ عملیاتی که NCCL برای اجرای کارآمد آن طراحی شده است.
نمونه اجرای چهار GPU با TP=4
vllm serve MODEL_ID \
  --tensor-parallel-size 4 \
  --host 127.0.0.1 \
  --port 8000
این فرمان برای یک سرور دارای چهار GPU سازگار است. عبارت MODEL_ID باید با شناسه یک مدل پشتیبانیشده جایگزین شود.
مزایای Tensor Parallelism
- تقسیم بخشی از وزنها و محاسبات مدل.
- امکان اجرای بعضی مدلهای بزرگتر از ظرفیت یک GPU.
- استفاده از ارتباط داخلی پرسرعت GPUها در سرورهای مناسب.
محدودیتهای Tensor Parallelism
GPUها برای بعضی محاسبات باید بهصورت مکرر هماهنگ شوند. اگر ارتباط بین GPUها کند باشد، هزینه ارتباطی ممکن است بخش قابل توجهی از زمان Inference را مصرف کند.
بنابراین اجرای TP روی چند GPU داخل یک سرور مجهز به ارتباط سریع، میتواند رفتاری بسیار متفاوت از اجرای همان TP روی شبکه بین دو سرور داشته باشد.
Pipeline Parallelism در vLLM چیست؟
Pipeline Parallelism یا PP بهجای تقسیم Tensorهای یک لایه، مراحل یا گروههایی از لایههای مدل را میان GPUها تقسیم میکند.
برای مثال، ممکن است مجموعهای از لایهها روی Node اول و بخش دیگری از لایهها روی Node دوم اجرا شوند.
خروجی یک مرحله به مرحله بعدی انتقال پیدا میکند.
نمونه ترکیب Tensor و Pipeline Parallelism
vllm serve MODEL_ID \
  --tensor-parallel-size 2 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray
این نمونه برای چهار GPU در مجموع طراحی شده است و قبل از اجرای Multi-Node، به Cluster آماده، مدل سازگار و ارتباط شبکه مناسب نیاز دارد.
مزیت PP بین Nodeها چیست؟
در بعضی مدلها و توپولوژیها میتواند میزان ارتباط مکرر Tensor Parallelism در شبکه بین Nodeها را کاهش دهد.
آیا PP همیشه بهتر است؟
خیر. Pipeline Parallelism ممکن است باعث نامتوازن شدن پردازش مراحل یا ایجاد زمانهای انتظار شود.
عملکرد نهایی به تعداد لایههای مدل، تعداد GPUها، اندازه Batch و نوع شبکه وابسته است.
Tensor Parallel یا Pipeline Parallel؛ کدام را انتخاب کنیم؟
| سناریو | انتخاب اولیه | نکته مهم |
|---|---|---|
| مدل روی یک GPU جا میشود | تک GPU | ابتدا Baseline بسازید |
| چهار GPU با ارتباط سریع در یک سرور | TP=4 | سازگاری مدل و GPU بررسی شود |
| دو Node با دو GPU در هر Node | TP=2 و PP=2 | شبکه بین Nodeها مهم است |
| دو Node با چهار GPU در هر Node | TP=4 و PP=2 | هشت GPU در مجموع |
| GPUهای بدون ارتباط داخلی سریع | بررسی PP | با TP بنچمارک مقایسه شود |
| مدل روی هر GPU جا میشود و هدف افزایش کاربران است | بررسی Data Parallelism | Replica و Load Balancing مناسبتر هم ممکن است باشد |
این جدول نقطه شروع تصمیمگیری است، نه قانون قطعی برای تمام مدلها.
برای مدلهای MoE و معماریهای جدید، روشهای دیگری مانند Expert Parallelism نیز ممکن است اهمیت داشته باشند.
NCCL چیست و چرا در اجرای چند GPU اهمیت دارد؟
NVIDIA Collective Communications Library یا NCCL کتابخانهای برای ارتباطات جمعی پرسرعت بین GPUها است.
در یک برنامه توزیعشده، بعضی عملیات به همکاری چند GPU نیاز دارند. NCCL میتواند چنین ارتباطاتی را از طریق مسیرهای مناسب سختافزار و شبکه اجرا کند.
عملیات AllReduce چیست؟
در AllReduce، دادههای چند مشارکتکننده با یک عملیات مشخص ترکیب میشوند و نتیجه جمعی در اختیار مشارکتکنندههای گروه قرار میگیرد.
برای مثال، بخشهایی از محاسبات Tensor Parallel ممکن است به تجمیع نتایج میان GPUها نیاز داشته باشند.
Rank در NCCL به چه معناست؟
Rank شناسه یک عضو گروه ارتباطی است.
اگر چهار GPU در یک گروه همکاری کنند، معمولاً چهار Rank مرتبط با همان گروه وجود دارد.
اعضای گروه باید در عملیات ارتباطی موردنیاز هماهنگ باشند. اگر یکی از Rankها متوقف شود یا نتواند به مرحله مورد انتظار برسد، سایر Rankها نیز ممکن است منتظر بمانند.
چرا NCCL گاهی Hang میکند؟
- انتخاب IP یا Network Interface اشتباه.
- مسدود بودن ارتباطات لازم توسط Firewall.
- مشکل Driver، CUDA یا ارتباط GPU.
- ناسازگاری محیط نرمافزاری Nodeها.
- قطع شدن Worker به دلیل CUDA OOM.
- مشکل RDMA یا تنظیمات InfiniBand.
- عدم هماهنگی Rankها در عملیات Collective.
بنابراین یک Hang در NCCL الزاماً به معنی خراب بودن شبکه نیست.
پیشنیازهای اجرای vLLM روی چند GPU و چند Node
در این آموزش، دو سرور Ubuntu دارای GPU NVIDIA و یک شبکه خصوصی فرض میکنیم.
قبل از هر نصب، موارد زیر باید بررسی شوند:
- GPU سازگار با نسخه vLLM.
- Driver NVIDIA مناسب روی هر دو Node.
- نسخه یکسان vLLM و وابستگیهای Python.
- نسخه سازگار PyTorch، CUDA و NCCL.
- فایل مدل و Tokenizer یکسان در هر دو Node.
- VRAM کافی برای سهم هر GPU از مدل و KV Cache.
- دسترسی شبکهای پایدار بین Nodeها.
- مسیرهای ارتباط داخلی و مجوزهای لازم برای Runtime توزیعشده.
نسخه vLLM را چگونه بررسی کنیم؟
vllm --version

python -c "import torch; print(torch.__version__)"
در زمان تهیه این مقاله نسخه 0.33.0 مبنا بوده است. بهتر است روی هر Node از یک محیط Python یکسان و قابل بازتولید استفاده کنید.
آیا Container ضروری است؟
خیر، اما استفاده از Image یکسان میتواند اختلاف محیطهای نرمافزاری را کاهش دهد.
مستندات رسمی vLLM نیز برای Multi-Node استفاده از Container را بهعنوان روشی مناسب برای همسانسازی محیط پیشنهاد میکنند.
مرحله اول: بررسی GPU و ارتباط شبکه سرورها
۱. بررسی مشخصات GPU
روی هر دو Node اجرا کنید:
nvidia-smi

nvidia-smi --query-gpu=index,name,memory.total,driver_version \
  --format=csv
اگر GPU در سیستمعامل شناسایی نمیشود، ابتدا Driver یا GPU Passthrough را اصلاح کنید.
۲. بررسی ارتباط داخلی GPUها
nvidia-smi topo -mاین دستور توپولوژی ارتباط GPUها و برخی ارتباطات میان کارتها و CPU را نمایش میدهد.
خروجی آن برای بررسی مسیرهای PCIe و NVLink مفید است، اما بهتنهایی سرعت واقعی ارتباط را مشخص نمیکند.
۳. بررسی Network Interfaceها
ip -br addr

ip route

ip link show
ممکن است نام کارت شبکه ens18، eth0 یا مقدار دیگری باشد. نام واقعی باید از خروجی همین دستورها استخراج شود.
۴. تست مسیر Node A به Node B
فرض کنیم IP خصوصی Nodeها به شکل زیر است:
| Node | IP آزمایشی | GPU |
|---|---|---|
| Head | 10.10.0.11 | ۲ عدد |
| Worker | 10.10.0.12 | ۲ عدد |
روی Node اول اجرا کنید:
ip route get 10.10.0.12

ping -c 4 10.10.0.12
روی Node دوم نیز مسیر برگشت به 10.10.0.11 را بررسی کنید.
این IPها صرفاً نمونه هستند و باید با آدرسهای واقعی شبکه خصوصی خود جایگزین شوند.
آیا موفق بودن Ping کافی است؟
خیر. Ping معمولاً ارتباط ICMP را بررسی میکند؛ درحالیکه Ray و NCCL ممکن است برای ارتباط بین Workerها و Rankها به مسیرهای دیگری نیاز داشته باشند.
حتی اتصال TCP موفق نیز لزوماً سلامت عملیات GPU-to-GPU را اثبات نمیکند.
مرحله دوم: اجرای vLLM روی چند GPU داخل یک سرور
قبل از راهاندازی Multi-Node بهتر است ثابت کنیم چند GPU داخل یک Node بهدرستی با یکدیگر همکاری میکنند.
برای یک سرور دارای چهار GPU و مدل سازگار:
export CUDA_VISIBLE_DEVICES=0,1,2,3

vllm serve MODEL_ID \
  --tensor-parallel-size 4 \
  --distributed-executor-backend mp \
  --host 127.0.0.1 \
  --port 8000
پارامتر --distributed-executor-backend mp استفاده از Multiprocessing داخلی را مشخص میکند.
در این مرحله هنوز Ray یا شبکه بین دو سرور را وارد آزمایش نکردهایم.
اگر همین آزمایش شکست بخورد چه کنیم؟
ابتدا این موارد را بررسی کنید:
- آیا هر چهار GPU قابل مشاهده هستند؟
- آیا مدل با TP=4 سازگار است؟
- آیا هر GPU حافظه کافی دارد؟
- آیا نسخه Driver و CUDA با محیط vLLM سازگار است؟
- آیا ارتباط GPUها در تست NCCL محلی سالم است؟
تا زمانی که مشکل Single-Node حل نشده است، اضافه کردن Node دوم فقط عیبیابی را پیچیدهتر میکند.
مرحله سوم: راهاندازی Ray Cluster بین دو سرور GPU
Ray یک Runtime توزیعشده برای اجرای برنامهها و Workerها روی چند ماشین است.
در معماری Multi-Node، vLLM میتواند از Ray برای مدیریت محل اجرای Workerها و منابع GPU استفاده کند.
نصب Ray و بررسی نسخهها
نسخه Ray و سایر وابستگیها در دو Node باید با vLLM سازگار باشند.
اگر از محیط مجازی Python استفاده میکنید، ابتدا بررسی کنید Ray نصب شده است:
python -m pip show vllm ray torch

python -c "import vllm, ray, torch; print(vllm.__version__, ray.__version__, torch.__version__)"
اگر Ray موجود نیست، آن را در همان محیط با نسخه سازگار نصب کنید و مطمئن شوید نسخههای مورد استفاده در همه Nodeها یکساناند.
نکته امنیتی قبل از اجرای Ray
Ray باید در یک شبکه مورد اعتماد اجرا شود. ارتباطات داخلی Cluster را نباید در اینترنت عمومی آزاد بگذارید.
Ray علاوه بر پورت اصلی Head، برای Node Manager، Object Manager و Workerها از پورتهای دیگری استفاده میکند که برخی ممکن است بهصورت پویا انتخاب شوند.
برای محیط Production، پورتهای موردنیاز را در تنظیمات Ray مشخص و دسترسی آنها را فقط بین IPهای مجاز محدود کنید.
تنظیم Node اصلی
در شبکه آزمایشی محافظتشده، روی Node Head:
ray start --head \
  --node-ip-address=10.10.0.11 \
  --port=6379
اتصال Worker به Head
روی Node دوم:
ray start \
  --address=10.10.0.11:6379 \
  --node-ip-address=10.10.0.12
پورت 6379 در این مثال فقط پورت انتخابشده برای Ray GCS است و تمام ارتباطات Ray به آن محدود نمیشود.
بررسی وضعیت Ray Cluster
ray status

ray list nodes
فرمان دوم ممکن است به ابزارهای CLI تکمیلی Ray وابسته باشد.
باید دو Node و منابع GPU مورد انتظار را مشاهده کنید. اگر Ray نتواند Worker را ببیند، هنوز زمان اجرای vLLM Multi-Node نیست.
آیا بهتر نیست از اسکریپت رسمی vLLM استفاده کنیم؟
برای نصب واقعی، مخصوصاً زمانی که Ray داخل Container اجرا میشود، استفاده از اسکریپت رسمی examples/ray_serving/run_cluster.sh میتواند مناسبتر باشد.
مزیت این روش آن است که متغیرهای محیطی مانند VLLM_HOST_IP و NCCL_SOCKET_IFNAME هنگام راهاندازی Workerها تنظیم میشوند.
این نکته مهم است؛ زیرا اجرای یک دستور export در Terminal جدید، لزوماً متغیرهای موردنیاز را به تمام Workerهای از قبل فعال Ray منتقل نمیکند.
مرحله چهارم: انتخاب درست Network Interface برای NCCL
یکی از علتهای رایج خطای NCCL در سرورهای دارای چند کارت شبکه، انتخاب Interface اشتباه است.
برای مثال، ممکن است یک سرور دارای کارت شبکه عمومی، شبکه خصوصی و یک Interface مربوط به Docker باشد.
اگر Ray و NCCL از مسیرهای ناسازگار استفاده کنند، ممکن است Cluster ظاهراً متصل باشد اما اجرای مدل با Timeout مواجه شود.
VLLM_HOST_IP
این متغیر برای مشخص کردن IP مورد استفاده vLLM در همان Node کاربرد دارد.
NCCL_SOCKET_IFNAME
Interface مورد استفاده ارتباطات Socket در NCCL را مشخص میکند.
GLOO_SOCKET_IFNAME
این متغیر Interface مورد استفاده ارتباطات Gloo را تعیین میکند.
نمونه تنظیم Head
export VLLM_HOST_IP=10.10.0.11

export NCCL_SOCKET_IFNAME='=ens18'

export GLOO_SOCKET_IFNAME=ens18
نمونه تنظیم Worker
export VLLM_HOST_IP=10.10.0.12

export NCCL_SOCKET_IFNAME='=ens18'

export GLOO_SOCKET_IFNAME=ens18
مقادیر بالا مثال هستند. نام ens18 باید با Interface واقعی که شبکه خصوصی روی آن قرار دارد جایگزین شود.
تفاوت ens18 و =ens18 در NCCL
در NCCL، مقدار ens18 میتواند براساس Prefix تفسیر شود؛ اما قرار دادن علامت مساوی در ابتدای مقدار، انتخاب نام دقیق Interface را مشخص میکند.
بنابراین مقدار =ens18 برای محدود کردن انتخاب به همان Interface قابل استفاده است.
آیا NCCL_SOCKET_IFNAME برای RDMA هم کافی است؟
خیر. این گزینه عمدتاً انتخاب Interfaceهای IP Socket را کنترل میکند. اگر از InfiniBand یا RoCE استفاده میکنید، تنظیم و تشخیص مسیر RDMA نیز اهمیت دارد.
برای مثال، NCCL_IB_HCA و وضعیت NICهای RDMA میتوانند در چنین محیطهایی مؤثر باشند.
مهمترین نکته درباره Ray
در استقرار مبتنی بر Ray، متغیرهای ارتباطی باید به Workerهای واقعی برسند. بهتر است آنها هنگام ایجاد Cluster، در Container یا تنظیمات Runtime تعریف شوند.
صرف تنظیم متغیر در Terminalی که بعداً vllm serve را اجرا میکند، تضمین نمیکند Workerهای از قبل فعال همان تنظیم را دریافت کرده باشند.
مرحله پنجم: اجرای vLLM روی دو Node با Ray
پس از آماده شدن Ray Cluster و تأیید منابع GPU، میتوان یک Instance از vLLM را برای استفاده از کل Cluster اجرا کرد.
فرض کنیم هر Node دو GPU دارد و مدل با TP=2 و PP=2 سازگار است.
فرمان اجرای مدل روی Head
vllm serve MODEL_ID \
  --tensor-parallel-size 2 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray \
  --host 127.0.0.1 \
  --port 8000
این فرمان باید در محیطی اجرا شود که به Ray Cluster دسترسی دارد.
در حالت Ray معمولاً یک فرمان Serving روی Node اصلی کافی است و Ray Workerهای لازم را در Nodeهای دیگر مدیریت میکند.
چرا API فقط روی 127.0.0.1 اجرا شده است؟
چون در مرحله آزمایشی نمیخواهیم API مدل مستقیماً در اینترنت عمومی قابل دسترسی باشد.
برای Production میتوان از Gateway مناسب، TLS، احراز هویت و محدودسازی مسیرهای HTTP استفاده کرد.
اگر مدل روی Head بارگذاری شد ولی Worker دوم خطا داد
باید لاگ همان Worker را بررسی کنید. علت ممکن است مدل دانلودنشده، اختلاف محیط، انتخاب IP نادرست، کمبود VRAM یا مشکل ارتباط NCCL باشد.
همچنین باید مطمئن شوید مسیر مدل روی همه Nodeها به محتوای یکسان اشاره میکند.
مرحله ششم: اجرای Multi-Node بدون Ray با Multiprocessing
در نسخههای جدید vLLM امکان اجرای Multi-Node با Multiprocessing نیز وجود دارد.
در این روش، بهجای ساخت Ray Cluster، برای هر Node فرآیند متناسب با Rank آن راهاندازی میشود.
این روش را باید مستقل از روش Ray در نظر گرفت.
اجرای Head Node
روی Node دارای IP خصوصی 10.10.0.11:
vllm serve MODEL_ID \
  --tensor-parallel-size 2 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend mp \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr 10.10.0.11 \
  --master-port 29501 \
  --host 127.0.0.1 \
  --port 8000
اجرای Worker Node
روی Node دوم:
vllm serve MODEL_ID \
  --tensor-parallel-size 2 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend mp \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr 10.10.0.11 \
  --master-port 29501 \
  --headless
در این مثال، Node صفر نقش اصلی و Node یک نقش Worker را دارد.
هر دو Node باید به مدل، نسخههای یکسان کتابخانهها و شبکه ارتباطی موردنیاز دسترسی داشته باشند.
پورت 29501 برای ارتباط Master در این نمونه تعریف شده است. این پورت بهتنهایی تمام ارتباطات NCCL و Workerها را پوشش نمیدهد.
آیا روش MP همیشه بهتر از Ray است؟
خیر. انتخاب به نحوه استقرار، مدیریت Cluster، نیازهای Scaling و امکانات عملیاتی بستگی دارد.
اگر Ray Cluster از قبل وجود دارد، استفاده از Ray ممکن است مدیریت منابع را سادهتر کند. اگر به یک Job مشخص و ساختار سادهتر نیاز دارید، روش MP نیز ارزش بررسی دارد.
رفع خطاهای رایج NCCL و Ray در vLLM
خطای ۱: NCCL unhandled system error
این پیام بهتنهایی علت نهایی مشکل را مشخص نمیکند.
ابتدا لاگهای قبلی، وضعیت Workerها، ارتباط شبکه و سلامت GPUها را بررسی کنید.
برای مشاهده اطلاعات بیشتر، در محیط تست میتوانید NCCL Debug را فعال کنید:
export NCCL_DEBUG=INFO

export NCCL_DEBUG_SUBSYS=INIT,NET
در محیط توزیعشده باید این تنظیمات به همه فرآیندهای مرتبط برسند.
بعد از پایان عیبیابی، Debug پرحجم را غیرفعال کنید.
خطای ۲: ncclCommInitRank شکست میخورد
این خطا در مرحله آمادهسازی Communicator ممکن است رخ دهد.
موارد زیر را بررسی کنید:
- آیا همه Rankها اجرا شدهاند؟
- آیا IP و Interface صحیح انتخاب شده است؟
- آیا مسیرهای شبکه موردنیاز باز هستند؟
- آیا GPU در همه Nodeها سالم و قابل استفاده است؟
- آیا مسیر RDMA یا Socket بهدرستی انتخاب شده است؟
خطای ۳: NCCL Timeout یا Hang
اگر یکی از Rankها به دلیل CUDA OOM یا خطای برنامه متوقف شده باشد، سایر Rankها ممکن است منتظر همان عملیات Collective باقی بمانند.
بنابراین قبل از تغییر Network Interface، وضعیت تمام Workerها و پیامهای قبل از Hang را بررسی کنید.
خطای ۴: Ray همه GPUها را شناسایی نمیکند
ممکن است GPUها در سیستمعامل دیده شوند، اما Ray نتواند منابع مورد انتظار را ثبت کند.
با اجرای دستورهای زیر وضعیت را بررسی کنید:
nvidia-smi

ray status
اگر Ray داخل Container اجرا میشود، باید دسترسی GPU همان Container نیز بررسی شود.
خطای ۵: No available node types can fulfill resource request
این خطا ممکن است حتی زمانی رخ دهد که مجموع GPUهای Cluster کافی به نظر میرسد.
یکی از علتهای شناختهشده در محیطهای دارای چند IP، اختلاف آدرس انتخابی Ray و vLLM است.
مقدار VLLM_HOST_IP را برای هر Node و آدرسهای نمایشدادهشده در Ray بررسی کنید.
خطای ۶: مشکل RDMA یا InfiniBand
اگر سرور از InfiniBand یا RoCE استفاده میکند، ممکن است مشکل به تنظیمات RDMA، Driver، HCA یا شبکه مربوط باشد.
برای آزمایش موقت، میتوان استفاده از مسیر IB/RoCE را در NCCL غیرفعال کرد:
export NCCL_IB_DISABLE=1اگر ارتباط با این تغییر برقرار شود، مسیر RDMA نیازمند بررسی است؛ اما هنوز نمیتوان علت دقیق را قطعی دانست.
این تنظیم را بدون دلیل در Production نگه ندارید؛ زیرا ممکن است ارتباط پرسرعت RDMA را حذف و عملکرد را کاهش دهد.
خطای ۷: NCCL از کارت شبکه اشتباه استفاده میکند
اگر NCCL از Interface عمومی بهجای Interface خصوصی استفاده میکند، ابتدا مسیر شبکه را بررسی و سپس تنظیم NCCL_SOCKET_IFNAME را اصلاح کنید.
برای مثال:
ip route get 10.10.0.12

export NCCL_SOCKET_IFNAME='=ens18'
در این مثال ens18 فقط یک نام فرضی است.
خطای ۸: مدل روی یک Node کار میکند اما روی دو Node کند است
ممکن است شبکه بین دو Node به عامل محدودکننده تبدیل شده باشد.
برای تشخیص، باید عملکرد ارتباط NCCL و سرعت واقعی Inference را جداگانه اندازه بگیرید.
همچنین نوع TP و PP را متناسب با توپولوژی شبکه بررسی کنید.
مرحله هفتم: تست ارتباط GPUها با NVIDIA nccl-tests
برای بررسی ارتباط GPUها مستقل از مدل و موتور vLLM، از پروژه رسمی NVIDIA nccl-tests استفاده میکنیم.
این ابزار عملیات Collective مانند AllReduce را اجرا میکند و اطلاعاتی درباره صحت محاسبات و عملکرد ارتباطات ارائه میدهد.
دریافت سورس ابزار
git clone https://github.com/NVIDIA/nccl-tests.git

cd nccl-tests

make -j
برای Build موفق باید ابزارهای کامپایل و نسخههای مناسب CUDA و NCCL در دسترس باشند.
اگر CUDA و NCCL در مسیرهای غیرپیشفرض نصب شدهاند، باید CUDA_HOME و NCCL_HOME را مطابق مستندات تنظیم کنید.
تست چهار GPU داخل یک سرور
./build/all_reduce_perf \
  -b 8 \
  -e 128M \
  -f 2 \
  -g 4
این فرمان روی چهار GPU محلی، اندازههای مختلف داده را آزمایش میکند.
آمادهسازی تست بین دو Node
برای اجرای چند Node، ابزار باید با پشتیبانی MPI ساخته شود.
make MPI=1در بعضی محیطها لازم است مسیر MPI_HOME یا تنظیمات کامپایل را نیز مشخص کنید.
بنچمارک دو Node با چهار GPU در مجموع
اگر MPI روی هر دو Node نصب و ارتباط آن آماده شده است:
mpirun \
  --host 10.10.0.11:2,10.10.0.12:2 \
  -np 4 \
  ./build/all_reduce_perf \
  -b 8 \
  -e 128M \
  -f 2 \
  -g 1
در این مثال چهار Process وجود دارد و هر Process یک GPU را مدیریت میکند.
فایل اجرایی باید از مسیر مناسب روی هر Node قابل دسترسی باشد. ممکن است لازم باشد تنظیمات SSH، MPI و مسیر فایلها را برای محیط واقعی تغییر دهید.
خروجی NCCL Benchmark را چگونه بخوانیم؟
| معیار | کاربرد |
|---|---|
| Time | مدت اجرای عملیات Collective |
| algbw | پهنای باند الگوریتمی محاسبهشده |
| busbw | برآورد پهنای باند مؤثر متناسب با عملیات |
| Errors | خطاهای صحت نتیجه |
| Message Size | اندازه داده مورد استفاده در آزمایش |
برای مقایسه دو تست، باید تعداد Rankها، اندازه پیام، مدل GPU و نوع Collective یکسان باشد.
یک نتیجه خوب در AllReduce بهتنهایی تضمین نمیکند کل Inference مدل سریع خواهد بود؛ چون vLLM علاوه بر ارتباطات GPU، محاسبات و Scheduling نیز انجام میدهد.
تفاوت NVLink، PCIe، Ethernet و RDMA در vLLM
برای اجرای مدل روی چند GPU، نوع ارتباط میان کارتها اهمیت زیادی دارد.
| فناوری | کاربرد | نکته فنی |
|---|---|---|
| PCIe | ارتباط سختافزاری داخل سرور | به نسل و توپولوژی بستگی دارد |
| NVLink | ارتباط سریع میان GPUهای پشتیبانیشده | برای بعضی عملیات GPU-to-GPU مفید است |
| Ethernet | شبکه بین Nodeها | سرعت، تأخیر و تنظیمات NIC مهماند |
| InfiniBand | شبکه محاسباتی پرسرعت | نیازمند سختافزار و پیکربندی سازگار |
| RoCE | RDMA روی Ethernet | تنظیم درست Fabric و NIC اهمیت دارد |
آیا NVLink برای vLLM Multi GPU ضروری است؟
خیر. میتوان برخی مدلها را با GPUهایی که از طریق PCIe متصل هستند نیز اجرا کرد.
اما سرعت ارتباطات ممکن است متفاوت باشد و باید Benchmark انجام شود.
آیا Ethernet معمولی برای Multi-Node کافی است؟
به اندازه مدل، روش Parallelism و هدف عملکرد بستگی دارد.
اگر Tensor Parallelism نیازمند تبادل مکرر داده در شبکه باشد، پهنای باند یا تأخیر شبکه ممکن است عامل محدودکننده شود.
GPUDirect RDMA چیست؟
GPUDirect RDMA فناوریای است که در سختافزار و پیکربندی سازگار، امکان دسترسی مستقیمتر کارت شبکه به حافظه GPU را فراهم میکند.
این روش میتواند سربار انتقال داده از مسیر CPU را کاهش دهد.
اما فعال شدن آن نیازمند سازگاری GPU، کارت شبکه، Driver و تنظیمات محیط است.
چگونه مسیر ارتباط NCCL را تشخیص دهیم؟
در لاگهای تشخیصی NCCL میتوان بررسی کرد که ارتباط از مسیر Socket یا IB/GDRDMA انجام شده است.
برای مثال، مشاهده عبارتهای مرتبط با NET/Socket میتواند نشان دهد ارتباط شبکهای از مسیر Socket انجام شده است.
برای نتیجهگیری دقیقتر باید لاگ همان نسخه NCCL و مستندات سختافزار را بررسی کنید.
مرحله هشتم: بنچمارک واقعی vLLM بین Nodeها
پس از موفقیت تست NCCL، باید عملکرد خود vLLM را آزمایش کنیم.
برای این کار ابزار vllm bench serve مناسب است.
معیارهای اصلی
- Request Throughput: تعداد درخواستهای کاملشده در ثانیه.
- Output Tokens/sec: نرخ تولید Tokenهای خروجی.
- TTFT: زمان دریافت اولین Token.
- TPOT: زمان تولید Tokenهای بعدی.
- P95 Latency: تأخیر صدک ۹۵.
- Error Rate: درصد درخواستهای ناموفق.
نمونه Benchmark اولیه
vllm bench serve \
  --backend vllm \
  --base-url http://127.0.0.1:8000 \
  --model MODEL_ID \
  --dataset-name random \
  --random-input-len 256 \
  --random-output-len 128 \
  --num-prompts 100 \
  --request-rate 2 \
  --max-concurrency 4
اگر API با نام مدل متفاوتی ارائه میشود، مقدار MODEL_ID را با نام مدل ثبتشده در API جایگزین کنید.
همچنین اگر API دارای احراز هویت است، باید Header معتبر را برای Benchmark ارسال کنید.
چگونه TP و PP را منصفانه مقایسه کنیم؟
برای مقایسه علمی، تعداد GPU، مدل، نسخه vLLM، طول Prompt، خروجی و نرخ ورود درخواستها باید ثابت باشند.
برای مثال، میتوان دو پیکربندی با تعداد GPU یکسان ولی ساختار ارتباطی متفاوت را مقایسه کرد.
اما مقایسه چهار GPU روی یک سرور با هشت GPU روی دو سرور، بدون در نظر گرفتن تفاوت منابع، نتیجه دقیقی درباره کارایی Parallelism نمیدهد.
چرا فقط Tokens/sec کافی نیست؟
ممکن است یک تنظیم Throughput بالاتری ایجاد کند اما زمان پاسخ کاربران بیشتر شود.
برای سرویس چت و Agentهای تعاملی، TTFT و P95 Latency میتوانند بهاندازه Throughput اهمیت داشته باشند.
آیا بهتر است Benchmark از سرور جدا اجرا شود؟
برای تست ظرفیت Production بهتر است ابزار تولید بار روی ماشین مستقلی اجرا شود تا مصرف CPU و شبکه آن روی عملکرد موتور مدل تأثیر نگذارد.
نتایج Benchmark باید همراه مشخصات GPU، شبکه، تنظیمات TP/PP و نسخه مدل ثبت شوند.
امنیت Ray Cluster و ارتباط بین Nodeهای vLLM
یکی از خطرهای مهم اجرای Multi-Node، آزاد گذاشتن سرویسهای توزیعشده در اینترنت عمومی است.
Ray و بخشهای ارتباط داخلی موتور نباید بهعنوان سرویس عمومی بدون کنترل دسترسی ارائه شوند.
شبکه خصوصی و کنترل Firewall
بهتر است تمام ارتباطات میان Nodeها از یک شبکه خصوصی قابل اعتماد عبور کنند.
دسترسی Firewall باید فقط برای Nodeهای مجاز و پورتهای موردنیاز همان Cluster برقرار باشد.
چرا نباید تمام پورتها را باز کنیم؟
چون Ray ممکن است سرویسهای مدیریتی و ارتباطات داخلی مختلف داشته باشد. باز کردن همه پورتها در اینترنت عمومی سطح حمله را افزایش میدهد.
برای Production باید پورتهای Runtime مشخص و دسترسی آنها محدود شود.
امنیت API مدل
API عمومی vLLM بهتر است پشت یک Gateway دارای TLS، احراز هویت، Rate Limit و محدودیت مسیر قرار گیرد.
وجود API Key داخلی vLLM بهتنهایی تمام Endpointهای سرویس را محافظت نمیکند.
محافظت از مدل و Secretها
اگر برای دریافت وزن مدل از Hugging Face Token استفاده میکنید، Token نباید در Git Repository، لاگ عمومی یا اسکریپت قابل مشاهده برای همه کاربران ذخیره شود.
اجرای Worker با حداقل مجوز
بهتر است فرآیندهای مدل و Ray در محیطهای محافظتشده اجرا شوند و دسترسی غیرضروری به فایلها، شبکه و سرویسهای مدیریتی نداشته باشند.
نکته مهم: بعضی تنظیمات GPUDirect RDMA یا Container ممکن است به قابلیتهای سطح سیستم نیاز داشته باشند. چنین مجوزهایی باید متناسب با محیط و فقط در محدوده لازم اعطا شوند.
چکلیست استقرار vLLM Multi GPU در Production
| بخش | کنترل ضروری |
|---|---|
| GPU | بررسی Driver، VRAM و سلامت هر کارت |
| Topology | شناسایی ارتباط PCIe و NVLink |
| Software | یکسان بودن نسخه vLLM، PyTorch و Ray |
| Model | وزنها و Tokenizer یکسان روی تمام Nodeها |
| Network | IP خصوصی و Interface صحیح |
| NCCL | تست Collectiveها با nccl-tests |
| Ray | بررسی تعداد Nodeها و GPUهای قابل استفاده |
| Memory | اندازهگیری VRAM و KV Cache هر GPU |
| Performance | ثبت Throughput و Latency تحت بار |
| Security | محدودسازی پورتها و API عمومی |
| Recovery | برنامه Restart و بازیابی Cluster |
| Monitoring | پایش Workerها، صف و خطاهای ارتباطی |
در محیط Production، فعال بودن API Head بهتنهایی نشانه سلامت تمام GPUها یا Rankها نیست.
سیستم مانیتورینگ باید بتواند قطع Worker، کاهش ظرفیت GPU و خطاهای ارتباطی را نیز تشخیص دهد.
همچنین هنگام ارتقای Driver، CUDA یا vLLM، بهتر است ابتدا یک Cluster آزمایشی با همان توپولوژی بررسی شود.
سؤالات متداول درباره vLLM Multi GPU NCCL
آیا vLLM از چند GPU پشتیبانی میکند؟
بله. vLLM از روشهایی مانند Tensor Parallelism و Pipeline Parallelism برای اجرای مدل روی چند GPU استفاده میکند.
آیا Multi-Node همیشه به Ray نیاز دارد؟
خیر. در نسخههای جدید، Multiprocessing نیز برای اجرای Multi-Node پشتیبانی میشود.
Tensor Parallelism چه کاری انجام میدهد؟
بخشی از Tensorها و محاسبات یک مدل را میان چند GPU تقسیم میکند.
Pipeline Parallelism چه تفاوتی دارد؟
مراحل یا گروههایی از لایههای مدل را روی GPUها یا Nodeهای مختلف اجرا میکند.
برای دو Node با چهار GPU در هر Node چه تنظیمی مناسب است؟
TP=4 و PP=2 نقطه شروع رایج است؛ اما باید با مدل و شبکه واقعی آزمایش شود.
NCCL چیست؟
کتابخانه NVIDIA برای اجرای ارتباطات Collective پرسرعت میان GPUها است.
چرا NCCL هنگام Startup خطا میدهد؟
علت میتواند انتخاب Interface اشتباه، مشکل شبکه، GPU، Driver، RDMA یا عدم هماهنگی Rankها باشد.
آیا Ping موفق به معنی سالم بودن NCCL است؟
خیر. Ping فقط بخشی از دسترسپذیری شبکه را بررسی میکند و باید تست GPU-to-GPU نیز انجام شود.
NCCL_SOCKET_IFNAME چیست؟
متغیری برای مشخص کردن Interfaceهای IP Socket مورد استفاده NCCL است.
VLLM_HOST_IP چه کاربردی دارد؟
به vLLM کمک میکند IP صحیح همان Node را برای ارتباطات انتخاب کند.
آیا میتوان NCCL را روی Ethernet اجرا کرد؟
بله. مسیر Socket قابل استفاده است، اما کارایی به نوع شبکه و Workload بستگی دارد.
NCCL_IB_DISABLE=1 چه کاری انجام میدهد؟
استفاده از ارتباط IB/RoCE را در NCCL غیرفعال میکند تا مسیر دیگری مانند Socket استفاده شود.
آیا NCCL_IB_DISABLE را دائمی فعال کنیم؟
معمولاً خیر. این تنظیم برای عیبیابی مفید است، اما ممکن است عملکرد RDMA را کاهش دهد.
چرا Ray چهار GPU را میبیند اما vLLM اجرا نمیشود؟
ممکن است مشکل از Placement، IP، مدل، حافظه GPU یا ارتباط NCCL باشد.
چگونه خطای ncclCommInitRank را بررسی کنیم؟
با فعال کردن لاگ تشخیصی، بررسی Rankها، Network Interface و اجرای nccl-tests.
چرا vLLM روی یک Node سریع ولی روی دو Node کند است؟
ممکن است تأخیر و پهنای باند ارتباط بین Nodeها به عامل محدودکننده تبدیل شده باشد.
آیا NVLink برای اجرای چند GPU اجباری است؟
خیر. اما در سختافزارهای سازگار میتواند ارتباط داخلی پرسرعت فراهم کند.
آیا دو GPU با VRAM برابر معادل یک GPU با مجموع VRAM هستند؟
خیر. حافظه هر GPU جداست و تقسیم مدل سربار ارتباطی و حافظهای ایجاد میکند.
آیا Multi-GPU مشکل CUDA OOM را حل میکند؟
میتواند در بعضی مدلها کمک کند، اما مصرف KV Cache، Activationها و محدودیت حافظه هر GPU همچنان باید بررسی شود.
چگونه سرعت ارتباط بین Nodeها را اندازه بگیریم؟
با nccl-tests و ابزارهای مناسب شبکه، سپس Benchmark واقعی Inference.
آیا AllReduce Benchmark برای اندازهگیری عملکرد vLLM کافی است؟
خیر. باید TTFT، TPOT، Throughput و Latency خود مدل نیز اندازهگیری شوند.
آیا میتوان Ray را روی اینترنت عمومی اجرا کرد؟
پورتهای داخلی و مدیریتی Ray نباید بدون حفاظت در اینترنت عمومی در دسترس باشند.
برای افزایش تعداد کاربران TP بهتر است یا چند Replica؟
اگر مدل روی یک GPU جا میشود، چند Replica یا Data Parallelism نیز باید بررسی شود.
چطور از خطاهای تکراری NCCL جلوگیری کنیم؟
با محیط یکسان Nodeها، انتخاب صحیح Interface، تست ارتباطات، مانیتورینگ و مدیریت تغییرات.
جمعبندی
اجرای vLLM روی چند GPU و چند Node به شما امکان میدهد مدلهای بزرگتری را ارائه کنید یا ظرفیت پردازشی را متناسب با ساختار مدل افزایش دهید؛ اما موفقیت این معماری فقط به تعداد GPU یا مجموع VRAM بستگی ندارد.
در یک سرور دارای چند GPU، Tensor Parallelism میتواند گزینه مناسبی باشد. در معماری چندسروری، ترکیب TP داخل Node و PP بین Nodeها معمولاً نقطه شروع خوبی است، اما نتیجه نهایی باید با Benchmark بررسی شود.
Ray و Multiprocessing دو روش اجرای توزیعشده در نسخههای فعلی vLLM هستند. در هر دو روش، نسخههای نرمافزاری، آدرسهای شبکه، مدل و منابع GPU باید با یکدیگر سازگار باشند.
برای رفع خطاهای NCCL نیز بهتر است ابتدا ارتباط سختافزاری و شبکهای را بررسی کنید، سپس از nccl-tests برای آزمایش مستقل ارتباط GPUها استفاده کنید و در نهایت، عملکرد واقعی vLLM را تحت بار اندازه بگیرید.
اصل نهایی این است: پیش از تغییر تصادفی NCCL Flags یا افزایش تعداد GPUها، مسیر ارتباطات را مشخص، Rankها را بررسی و عملکرد را اندازهگیری کنید.
برای آشنایی با مبانی راهاندازی مدل، مقاله vLLM چیست و چگونه API مدل زبانی روی GPU بسازیم؟ را مطالعه کنید. اگر مشکل اصلی شما کمبود VRAM است، راهنمای رفع خطای CUDA Out of Memory در vLLM مکمل این آموزش خواهد بود.
منابع و مستندات رسمی
این مقاله بر اساس مستندات رسمی vLLM، NVIDIA و Ray تهیه شده است.
برای بررسی تنظیمات، محدودیتهای نسخههای جدید و عیبیابی تخصصی
میتوانید از منابع زیر استفاده کنید.
راهنمای Tensor Parallelism، Pipeline Parallelism، Ray و اجرای مدل روی چند Node.
بررسی ارتباطات توزیعشده، تنظیم IP و مشکلات شناسایی GPU در Ray.
مرجع عیبیابی خطاهای اجرای مدل، GPU و ارتباطات NCCL.
مستندات NCCL_SOCKET_IFNAME، NCCL_DEBUG و NCCL_IB_DISABLE.
تست صحت و سرعت ارتباط GPUها با AllReduce و سایر عملیات Collective.
آموزش ساخت Head Node، اتصال Workerها و مدیریت Ray Cluster.
اصول امنیت Cluster و محافظت از ارتباطات داخلی Ray.
روش اندازهگیری Throughput، TTFT، TPOT و Latency.
مانیتورینگ API، عملکرد Workerها و شاخصهای Inference.
بررسی GPU، حافظه VRAM و توپولوژی ارتباط کارتهای گرافیک.
دیدگاهها (۰)