
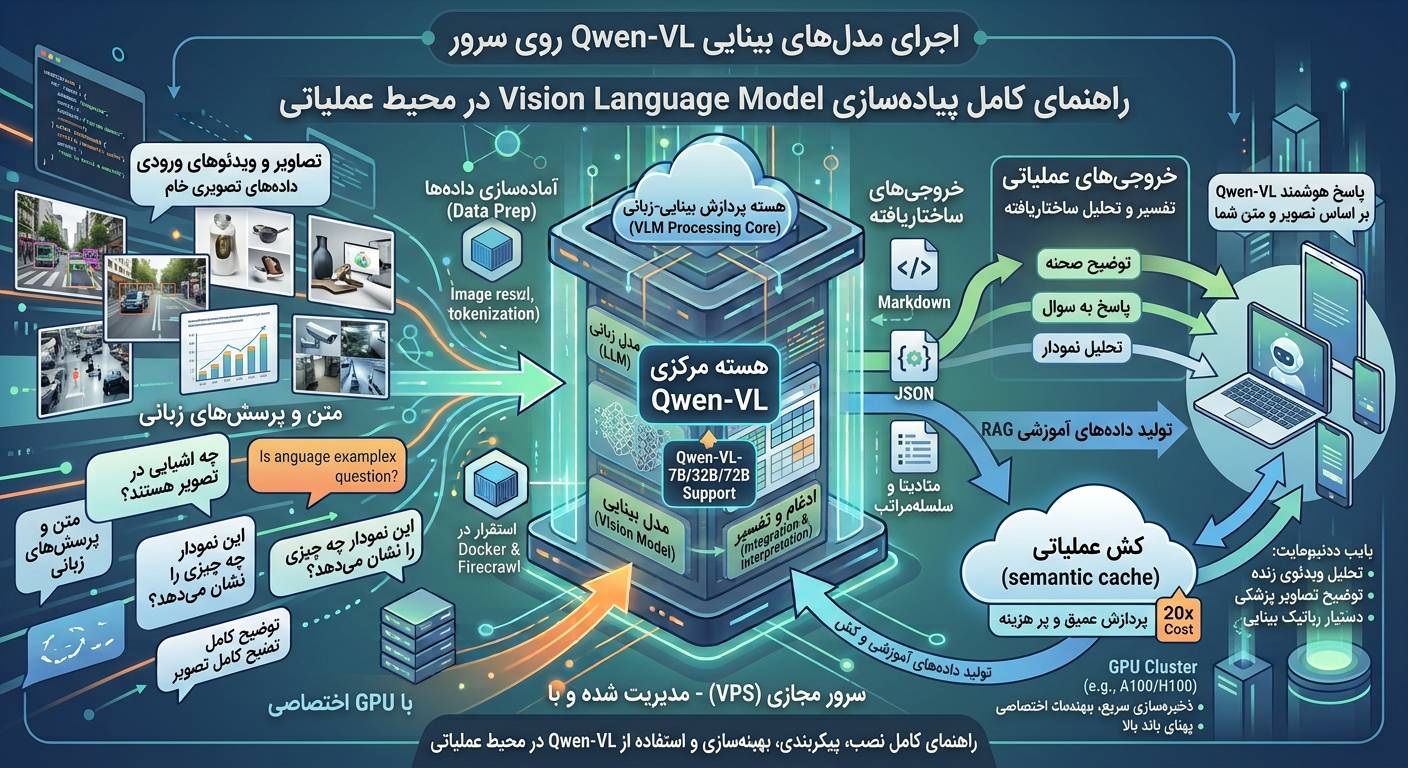
تا چند سال پیش، تصور اینکه یک ماشین بتواند تصویر ببیند، متن داخل آن را بخواند و دربارهاش استدلال کند، شبیه داستانهای علمی-تخیلی بود. اما امروز با ظهور مدلهای بینایی-زبانی یا Vision Language Model، این فناوری به نقطهای رسیده که میتوان آن را روی یک سرور مجازی راهاندازی کرد و در پروژههای واقعی از آن استفاده کرد. در این راهنما، از صفر تا صد اجرای Qwen-VL را بررسی میکنیم و نشان میدهیم چطور میتوانید یک pipeline بینایی-زبانی کامل را روی سرور خود داشته باشید.
🔹 آنچه در این مقاله میخوانید
🔹 Vision Language Model دقیقاً چیست و چه تفاوتی با مدلهای متنمحور دارد
🔹 چرا Qwen-VL انتخاب هوشمندانهای برای استقرار روی سرور است
🔹 مشخصات سختافزاری مورد نیاز برای اجرای مدلهای مختلف Qwen-VL
🔹 نصب گامبهگام vLLM و راهاندازی سرویس inference
🔹 تنظیمات بهینهسازی برای کاهش مصرف حافظه و افزایش throughput
🔹 رفع خطاهای رایج هنگام اجرای مدلهای بینایی روی GPU
Vision Language Model چیست و چرا به آن نیاز داریم؟
یک Vision Language Model (که گاهی Visual Language Model هم نوشته میشود) سیستمی است که دو دنیای متفاوت را به هم وصل میکند: پردازش تصویر و درک زبان طبیعی [citation:1]. برخلاف مدلهای زبانی معمولی مثل GPT که فقط با متن کار میکنند، یک VLM میتواند تصویر را «ببیند»، محتوای آن را تحلیل کند و با زبان انسانی دربارهاش صحبت کند [citation:11].
معماری داخلی این مدلها از سه بخش اصلی تشکیل شده:
🧱 اجزای اصلی یک Vision Language Model
🔹 Vision Encoder — تصویر را به بردارهای عددی تبدیل میکند (معمولاً مبتنی بر ViT یا CNN)
🔹 Alignment Module — فضای تصویر و متن را به یک زبان مشترک ترجمه میکند
🔹 Language Model — بردارهای ترکیبی را دریافت و متن پاسخ را تولید میکند
کاربردهای این مدلها امروز بسیار فراتر از پژوهشهای دانشگاهی رفته است. از تشخیص خودکار اشیاء در تصاویر صنعتی گرفته تا تحلیل اسکرینشاتهای نرمافزاری، پاسخ به سوالات درباره اسناد اسکنشده و حتی توصیف محتوای ویدیو، همگی با VLMها قابل انجام هستند [citation:6]. بازار هوش مصنوعی در حوزه بینایی ماشین از ۳۳.۴ میلیارد دلار در سال ۲۰۲۶ به ۸۸.۱ میلیارد دلار تا سال ۲۰۳۱ خواهد رسید که نشاندهنده رشد ۲۱.۴ درصدی سالانه است [citation:5].
چرا Qwen-VL برای اجرا روی سرور مجازی انتخاب مناسبی است؟
خانواده Qwen-VL که توسط تیم Qwen (وابسته به Alibaba Cloud) توسعه یافته، یکی از معدود مدلهای بینایی-زبانی است که هم متنباز است و هم میتواند روی سرورهای با GPU متوسط اجرا شود. این ترکیب، آن را برای کسبوکارهایی که نمیخواهند هزینههای سنگین APIهای خارجی را بپردازند، بسیار جذاب میکند.
جدیدترین نسخه این خانواده، Qwen3-VL است که در مقایسه با نسخههای قبلی، پیشرفتهای چشمگیری داشته:
📌 قابلیتهای کلیدی Qwen3-VL
🔹 درک متنی پیشرفته — پردازش اسناد چندزبانه، جداول، فرمولهای شیمیایی و دستنوشتهها
🔹 تشخیص دقیق اشیاء — شناسایی و شمارش اشیاء با فرمت مختصات دقیق و پشتیبانی از JSON
🔹 درک ویدیوی طولانی — پردازش ویدیوهای چندساعته و استخراج رویدادها در سطح ثانیه
🔹 عملکرد Agent — تعامل با رابط کاربری کامپیوتر و موبایل، تشخیص عناصر و اجرای وظایف
🔹 OCR گسترده — پشتیبانی از ۳۲ زبان با مقاومت بالا در شرایط نوری ضعیف و زاویهدار
نکته مهم این است که Qwen-VL در نسخههای مختلفی عرضه میشود: از مدل 2B برای لبههای شبکه و دستگاههای سبک، تا 72B و 235B برای سناریوهای سنگین سازمانی [citation:13]. این تنوع اندازه به شما اجازه میدهد بر اساس بودجه و سختافزار موجود، مناسبترین گزینه را انتخاب کنید.
جدول مقایسه مدلهای Qwen-VL و نیازمندیهای سرور
انتخاب مدل مناسب بدون درک دقیق از نیازمندیهای سختافزاری، میتواند به شکست پروژه منجر شود. جدول زیر راهنمای عملی برای انتخاب مدل و سختافزار متناسب است:
| مدل | حجم پارامتر | GPU پیشنهادی | حافظه GPU (حداقل) | مناسب برای |
|---|---|---|---|---|
| Qwen2.5-VL-7B | ۷ میلیارد | RTX 4090 / A10 | ۲۴ گیگابایت | پروژههای متوسط، شروع سریع |
| Qwen2.5-VL-72B | ۷۲ میلیارد | 4x A100 80GB | ۴x ۸۰ گیگابایت | تولید محتوای حرفهای، دقت بالا |
| Qwen3-VL-8B | ۸ میلیارد | RTX 4090 / L4 | ۲۴ گیگابایت | OCR، تحلیل اسناد، سبک |
| Qwen3-VL-32B | ۳۲ میلیارد | 2x A100 40GB | ۲x ۴۰ گیگابایت | تعادل بین دقت و هزینه |
| Qwen3-VL-235B (MoE) | ۲۳۵ میلیارد | 8x H100 / H200 | ۸x ۸۰ گیگابایت | سازمانی، سنگینترین وظایف |
برای اکثر کسبوکارهای ایرانی، مدل 7B یا 8B نقطه شروع منطقی است. این مدلها روی یک سرور مجازی با GPU واحد قابل اجرا هستند و کیفیت خروجیشان برای کارهای روزمره مثل تحلیل تصویر محصول، خواندن اسناد و پاسخ به سوالات تصویری کافی است.
⚠️ نکته حیاتی درباره حافظه GPU
مدلهای بینایی-زبانی علاوه بر وزنهای مدل زبانی، یک Vision Encoder اضافه هم دارند که چند صد مگابایت حافظه اشغال میکند. همیشه ۲ تا ۴ گیگابایت حافظه اضافی برای پردازش تصاویر و ویدیوها در نظر بگیرید. برای مثال، Qwen2.5-VL-72B روی 4x A100 80GB با TP=4 اجرا میشود [citation:4].
نصب و راهاندازی vLLM برای سرویسدهی Qwen-VL
برای استقرار Qwen-VL روی سرور، چند راهحل وجود دارد: vLLM، SGLang و Docker [citation:2][citation:7][citation:17]. در این راهنما از vLLM استفاده میکنیم چون هم پایداری بالایی دارد و هم API سازگار با OpenAI ارائه میدهد که کار را برای اتصال به اپلیکیشنها ساده میکند.
پیشنیازهای سرور
قبل از شروع، مطمئن شوید سرور شما این شرایط را دارد:
🔹 درایور NVIDIA نسخه ۵۲۵ یا بالاتر
🔹 CUDA 12+ برای پشتیبانی از FP8
🔹 Python 3.10+ و pip بهروز
🔹 حداقل ۳۲ گیگابایت رم برای مدلهای ۷B
نصب vLLM و کتابخانههای جانبی
ابتدا یک محیط مجازی بسازید و سپس بستههای مورد نیاز را نصب کنید:
python -m venv qwen-vl-env
source qwen-vl-env/bin/activate

pip install accelerate
pip install qwen-vl-utils==0.0.14
uv pip install -U vllm
نسخه vLLM باید ۰.۱۱.۰ یا بالاتر باشد تا از Qwen3-VL پشتیبانی کند [citation:2]. برای Qwen2.5-VL، نسخههای قدیمیتر هم کار میکنند اما توصیه میشود آخرین نسخه پایدار را نصب کنید.
راهاندازی سرویس inference
پس از نصب، میتوانید سرور vLLM را با دستور زیر راهاندازی کنید. این مثال برای مدل ۷B روی یک GPU است:
vllm serve Qwen/Qwen2.5-VL-7B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --max-model-len 65536 \
  --limit-mm-per-prompt '{"image":4,"video":0}'
پارامتر max-model-len را روی مقدار منطقی تنظیم کنید. مدلهای Qwen-VL بهطور پیشفرض context length بالایی دارند (۱۲۸K برای Qwen2.5-VL) اما کاهش آن به ۶۵۵۳۶ توکن، حافظه KV Cache را بهشدت کم میکند و امکان اجرا روی GPUهای کوچکتر را فراهم میسازد [citation:19].
برای مدلهای بزرگتر مثل ۷۲B که نیاز به چند GPU دارند، از tensor parallelism استفاده کنید:
export CUDA_VISIBLE_DEVICES=0,1,2,3
vllm serve Qwen/Qwen2.5-VL-72B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --mm-encoder-tp-mode data \
  --limit-mm-per-prompt '{"image":2,"video":0}'
پارامتر mm-encoder-tp-mode data باعث میشود Vision Encoder بهصورت Data Parallel اجرا شود. از آنجا که ViT فقط حدود ۶۷۵ میلیون پارامتر دارد در مقابل LM 72 میلیارد پارامتری، این تنظیمات کارایی بهتری ارائه میدهد و از overhead ارتباطی غیرضروری جلوگیری میکند [citation:4].
ارسال درخواست تصویری به سرور
پس از راهاندازی، سرور یک API سازگار با OpenAI در آدرس http://localhost:8000/v1 ارائه میدهد. میتوانید با کتابخانه رسمی OpenAI به آن متصل شوید:
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1"
)

response = client.chat.completions.create(
    model="Qwen/Qwen2.5-VL-7B-Instruct",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/receipt.png"
                    }
                },
                {
                    "type": "text",
                    "text": "تمام متن داخل این تصویر را بخوان و مبلغ نهایی را استخراج کن."
                }
            ]
        }
    ],
    max_tokens=1024
)

print(response.choices[0].message.content)
این ساختار به شما اجازه میدهد تصویر و متن را همزمان به مدل بفرستید و پاسخ متنی دریافت کنید. برای پردازش چند تصویر، کافی است چند آبجکت از نوع image_url در آرایه content قرار دهید.
🚀 زیرساخت GPU اختصاصی برای مدلهای بینایی-زبانی
اجرای Qwen-VL روی سرور به GPU قدرتمند، حافظه کافی و دیسک پرسرعت نیاز دارد. ایرانیکاسرور سرورهای مجازی مجهز به GPU و منابع اختصاصی CPU/RAM را با دیسک NVMe و پهنای باند نامحدود ارائه میدهد که برای inference مدلهای بینایی-زبانی بهینه شدهاند. اگر به دنبال زیرساختی پایدار برای پروژههای Multimodal خود هستید، گزینههای ما را بررسی کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
بهینهسازی عملکرد و رفع خطاهای رایج
اجرای مدلهای بینایی-زبانی روی سرور، چالشهای خاص خود را دارد. در این بخش، مهمترین تنظیمات و خطاهایی که ممکن است با آنها مواجه شوید را بررسی میکنیم.
کاهش مصرف حافظه
اگر با خطای Out of Memory مواجه شدید، این تنظیمات کمک میکنند:
🔹 max-model-len را کاهش دهید (مثلاً ۳۲۷۶۸ یا حتی ۱۶۳۸۴)
🔹 از gpu-memory-utilization=0.95 برای استفاده بهینه از حافظه موجود استفاده کنید
🔹 limit-mm-per-prompt را تنظیم کنید تا تعداد تصاویر هر درخواست محدود شود
خطای Flash Attention
vLLM بهطور پیشفرض از Flash Attention برای تسریع پردازش استفاده میکند. اگر GPU شما قدیمیتر از معماری Ampere باشد (مثل RTX 20 series یا Tesla V100)، ممکن است با خطا مواجه شوید. در این صورت یا به GPU جدیدتر ارتقا دهید یا از backendهای جایگزین استفاده کنید [citation:9].
نصب از طریق Docker (جایگزین)
اگر با مشکلات وابستگیهای پایتون مواجه شدید، استفاده از Docker سادهترین راه است. تیم Qwen ایمیج رسمی با تمام پیشنیازها منتشر کرده:
docker run --gpus all --ipc=host --network=host --rm -it \
  qwenllm/qwenvl:qwen3vl-cu128 bash
این ایمیج شامل CUDA 12.8، vLLM و تمام کتابخانههای لازم است. فقط کافی است درایور GPU روی host نصب باشد [citation:17].
سناریوهای عملی و کاربردهای واقعی
Qwen-VL در عمل چه کارهایی میتواند انجام دهد؟ در اینجا چند سناریوی واقعی که با یک سرور مجازی معمولی قابل پیادهسازی هستند را بررسی میکنیم:
🔹 تحلیل خودکار اسکرینشاتهای نرمافزاری — استخراج متن از رابط کاربری، تشخیص دکمهها و پاسخ به سوالات درباره workflow
🔹 پردازش فاکتور و اسناد اسکنشده — خواندن متن، جداول و مهرها از تصاویر با کیفیت پایین
🔹 تولید توضیحات محصول — نوشتن خودکار توضیحات برای تصاویر محصولات فروشگاهی
🔹 پایش محتوای ویدیویی — شناسایی رویدادهای خاص در ویدیوهای طولانی (مثل تشخیص خودرو یا افراد)
🔹 دستیار بصری برای Agentها — تعامل با مرورگر و رابطهای کاربری برای خودکارسازی وظایف
📖 مقاله مرتبط: پیشنیازهای اجرای مدلهای هوش مصنوعی روی سرور
اگر هنوز با مفاهیم پایهای مثل GPU مجازی، CUDA و تفاوت آن با CPU آشنا نیستید، پیشنهاد میکنیم ابتدا مقالات مقدماتی ما را مطالعه کنید. در بلاگ ایرانیکاسرور راهنماهای کاملی درباره انتخاب سرور مناسب برای پروژههای هوش مصنوعی منتشر شده است.
🛠 به کمک نیاز دارید؟
اگر در راهاندازی Qwen-VL روی سرور با مشکل مواجه شدید یا نیاز به کانفیگ اختصاصی برای GPU خود دارید، تیم فنی ایرانیکاسرور آماده کمک است. کافی است درخواست خود را ثبت کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
جمعبندی
Vision Language Modelها دیگر یک فناوری آینده نیستند. با مدلهایی مثل Qwen-VL که هم متنباز هستند و هم روی سختافزارهای متوسط اجرا میشوند، میتوانید قابلیت «دیدن» را به اپلیکیشنهای خود اضافه کنید.
نکات کلیدی که در این راهنما بررسی کردیم:
🔹 برای شروع، مدل ۷B یا ۸B روی یک GPU با ۲۴ گیگابایت حافظه کافی است
🔹 vLLM سادهترین و پایدارترین راه برای سرویسدهی است
🔹 تنظیم max-model-len و gpu-memory-utilization مصرف حافظه را بهشدت کاهش میدهد
🔹 برای مدلهای بزرگتر از tensor parallelism استفاده کنید
با یک سرور مجازی مناسب از ایرانیکاسرور، میتوانید این pipeline را امروز راهاندازی کنید و از قدرت مدلهای بینایی-زبانی در پروژههای واقعی بهره ببرید.







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.