
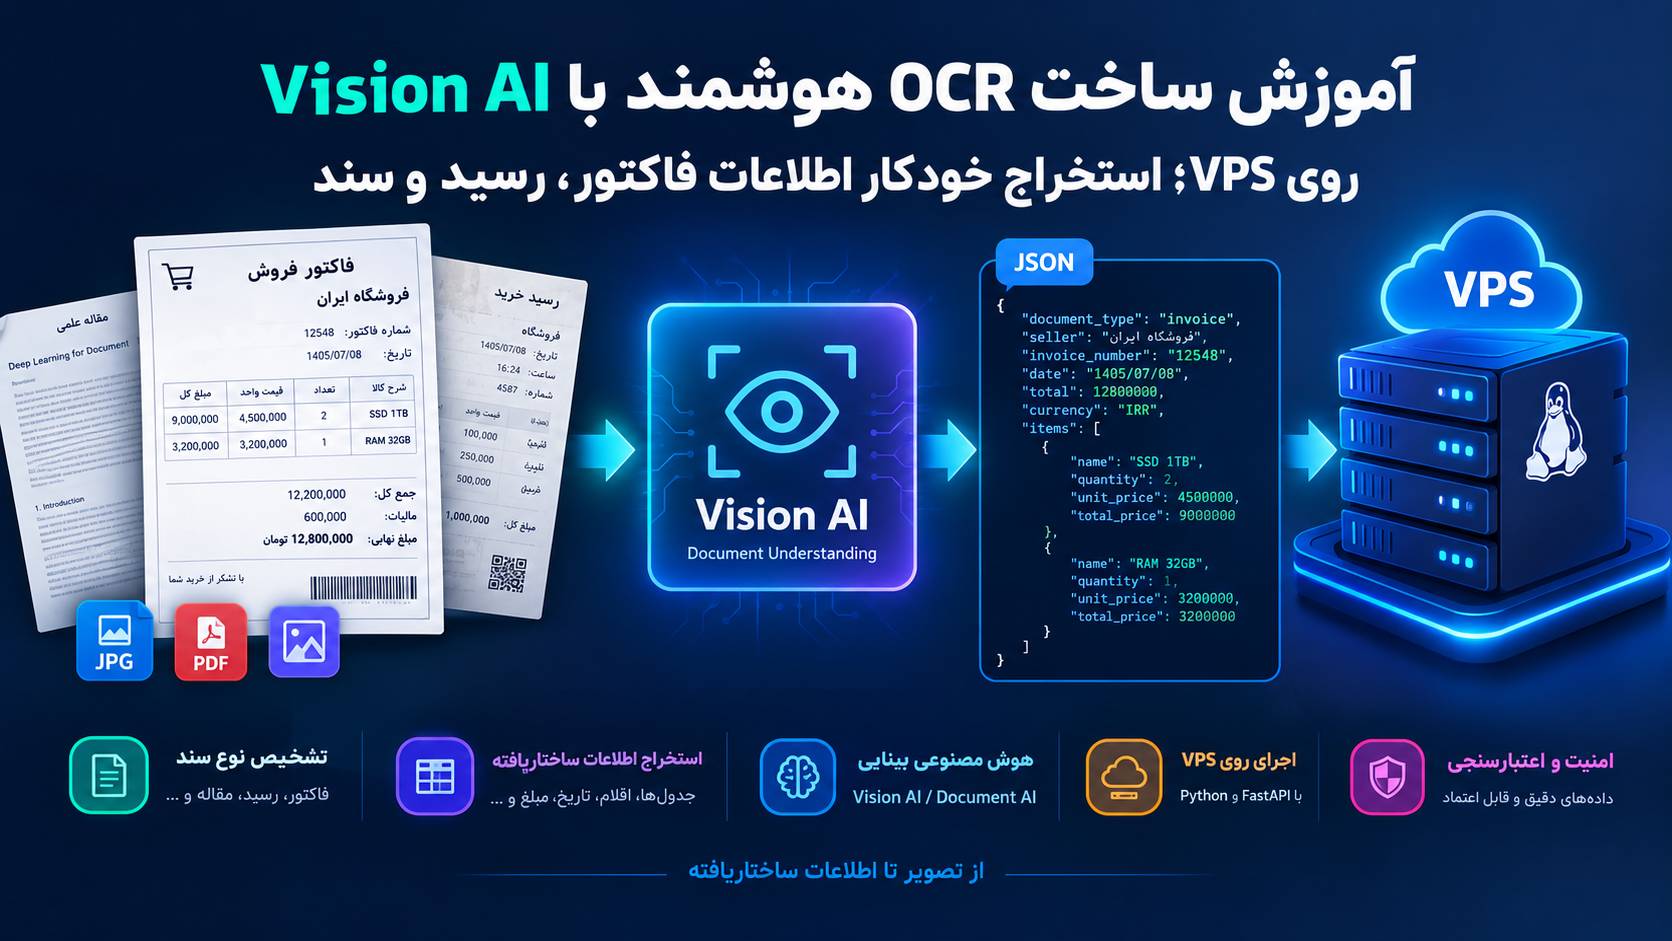
اگر کسبوکار شما هر ماه با انبوهی از فاکتور، رسید بانکی یا اسناد کاغذی سر و کله میزند، قطعاً میدانید که ورود دستی این اطلاعات چقدر زمانبر و پرهزینه است. یک اشتباه کوچک در خواندن یک رقم میتواند کل تراز مالی را به هم بریزد. اما راهحل مدرن این مشکل، ترکیب OCR (تشخیص نویسه نوری) با Vision AI یا مدلهای زبانی-تصویری است که نه فقط متن، بلکه ساختار سند را هم میفهمند. در این مقاله، به شما نشان میدهم چطور یک سیستم استخراج هوشمند اسناد را روی یک سرور مجازی راهاندازی کنید و از آن برای خودکارسازی فرآیندهای تجاری استفاده کنید.
چرا OCR سنتی برای اسناد تجاری کافی نیست؟
ابزارهای OCR قدیمی مثل Tesseract روی اسناد چاپی تمیز عملکرد خوبی دارند، اما وقتی پای فاکتورهای واقعی به میان میآید—با چیدمانهای مختلف، جدولهای تودرتو، مهر و امضا، یا عکسهای گرفتهشده با موبایل—دقتشان به شدت افت میکند. یک مطالعه مقایسهای نشان میدهد دقت Tesseract روی اسناد چاپی حدود ۹۷٪ است، اما روی عکسهای موبایلی به ۹۱٪ و روی دستنوشتهها به کمتر از ۳۵٪ سقوط میکند .
مشکل اصلی اینجاست که OCR سنتی فقط «کاراکتر» را میبیند، نه «معنا» را. برای یک ماشین OCR، عدد «۱,۰۰۰» و «۱۰,۰۰۰» تفاوتی ندارند جز در یک کاراکتر. اما برای کسبوکار شما، این تفاوت میتواند به معنای پرداخت اشتباه یا یک خطای حسابداری جدی باشد.
Vision AI چه فرقی ایجاد میکند؟
مدلهای Vision AI مثل olmOCR یا Chandra روی میلیونها سند واقعی آموزش دیدهاند و یاد گرفتهاند که «چیدمان» سند را درک کنند. این مدلها میتوانند تشخیص دهند که یک عدد در کنار کلمه «جمع کل» قرار دارد، یا اینکه یک جدول از چند ستون و سطر تشکیل شده است . نتیجه این است که خروجی، یک متن خام نیست؛ بلکه دادهای ساختاریافته (مثل JSON) است که مستقیماً قابل استفاده در نرمافزار حسابداری یا CRM شماست.
معماری پیشنهادی برای سیستم استخراج هوشمند اسناد
یک خط تولید (Pipeline) مؤثر برای استخراج اطلاعات از اسناد، معمولاً از سه مرحله تشکیل میشود:
🔹 مرحله ۱ — پیشپردازش تصویر: اصلاح نور، حذف نویز و یکسانسازی ابعاد تصویر. این کار دقت مرحله بعد را بهطور چشمگیری بالا میبرد.
🔹 مرحله ۲ — OCR و درک چیدمان: در اینجا از یک مدل Vision AI (مثل olmOCR یا Chandra) برای استخراج متن همراه با اطلاعات مکانی (مختصات) استفاده میشود.
🔹 مرحله ۳ — ساختاریسازی و اعتبارسنجی: خروجی OCR به یک LLM سبک داده میشود تا فیلدهای موردنظر شما (شماره فاکتور، تاریخ، مبلغ، نام فروشنده) را در قالب JSON استخراج کند. این LLM همچنین میتواند خطاهای رایج OCR مثل «0/O» یا «1/l» را تصحیح کند .
📌 نکته کلیدی درباره منابع سرور
خبر خوب این است که برای راهاندازی این سیستم، نیازی به سرورهای GPU گرانقیمت ندارید. یک تحقیق دانشگاهی نشان داده که یک خط تولید ترکیبی OCR+LLM میتواند روی یک VPS با تنها ۱ هسته CPU و ۱ گیگابایت رم بهصورت پایدار کار کند و هزینه هر استخراج را به کسری از سنت برساند .
انتخاب مشخصات سرور مجازی مناسب
مشخصات سرور شما مستقیماً به حجم و نوع اسنادی بستگی دارد که میخواهید پردازش کنید. جدول زیر یک راهنمای سریع برای انتخاب سرور مجازی ایران یا خارج ارائه میدهد:
| حجم پردازش روزانه | رم پیشنهادی | CPU پیشنهادی | نوع مدل مناسب |
|---|---|---|---|
| تا ۵۰ سند | ۲ گیگابایت | ۱ هسته | Tesseract + LLM ابری سبک |
| ۵۰ تا ۲۰۰ سند | ۴ گیگابایت | ۲ هسته | olmOCR کوانتیزه (GGUF) |
| بیش از ۲۰۰ سند | ۸ گیگابایت یا بیشتر | ۴ هسته | Chandra یا DeepSeek-OCR |
⚠️ هشدار مهم درباره انتخاب سرور: اگر میخواهید اسناد حساس یا محرمانه (مثل فاکتورهای مشتریان) را پردازش کنید، حتماً از سروری استفاده کنید که دادهها روی آن باقی بمانند. ارسال تصاویر اسناد به سرویسهای ابری خارجی میتواند ناقض سیاستهای حفظ حریم خصوصی کسبوکار شما باشد .
نصب و راهاندازی گامبهگام
گام اول: آمادهسازی سرور
پس از خرید سرور مجازی و اتصال از طریق SSH، ابتدا سیستم را بهروزرسانی کنید و ابزارهای ضروری را نصب نمایید:
sudo apt update && sudo apt upgrade -y
sudo apt install -y python3-pip python3-venv tesseract-ocr tesseract-ocr-fas
گام دوم: نصب مدل Vision AI
یکی از بهترین گزینههای متنباز برای شروع، مدل olmOCR است که هم دقت بالایی دارد و هم نسخه کوانتیزهشده آن (GGUF) روی سرورهای بدون GPU هم اجرا میشود. برای نصب آن از طریق Ollama:
curl -fsSL https://ollama.com/install.sh | sh
ollama run hf.co/richardyoung/olmOCR-2-7B-1025-GGUF
مدل olmOCR مخصوص استخراج متن ساختاریافته از اسناد طراحی شده و جداول و ستونها را بهخوبی تشخیص میدهد .
گام سوم: ساخت میکروسرویس استخراج
حالا یک اسکریپت ساده پایتون مینویسیم که تصویر سند را میگیرد، آن را به مدل میفرستد و خروجی JSON تحویل میدهد:
import base64
import json
import requests
from pathlib import Path
def extract_invoice(image_path):
b64 = base64.b64encode(Path(image_path).read_bytes()).decode()
prompt = """این تصویر یک فاکتور یا رسید است.
اطلاعات زیر را به صورت JSON استخراج کن:
- شماره فاکتور
- تاریخ
- نام فروشنده
- مبلغ کل
- اقلام (آرایهای از نام و قیمت)
"""
resp = requests.post(
"http://localhost:11434/api/generate",
json={
"model": "hf.co/richardyoung/olmOCR-2-7B-1025-GGUF",
"prompt": prompt,
"images": [b64],
"stream": False
}
)
return json.loads(resp.json()["response"])
# تست
result = extract_invoice("invoice_sample.jpg")
print(json.dumps(result, indent=2, ensure_ascii=False))
اگر میخواهید از یک مدل تخصصیتر برای اسناد تجاری استفاده کنید، پروژههایی مثل German-OCR-3 نشان دادهاند که با فاینتیون روی ۲۰۰ سند واقعی، میتوان به دقت ۱۰۰٪ در استخراج فیلدهای فاکتور رسید .
🚀 سیستم استخراج اسناد خود را روی سرور مجازی ایرانیکاسرور راهاندازی کنید
اگر به دنبال یک سرور مجازی پایدار با منابع اختصاصی CPU و رم، دیسک NVMe برای پردازش سریع I/O، و پهنای باند مناسب برای میزبانی سرویسهای هوش مصنوعی هستید، ایرانیکاسرور گزینهای مطمئن است. تیم پشتیبانی فنی ما در کنار شماست تا سرویس OCR خود را بدون دغدغه راهاندازی کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
مقایسه مدلهای Vision AI برای اسناد تجاری
چندین مدل متنباز و تجاری برای این کار وجود دارد. انتخاب درست به نوع اسناد و بودجه شما بستگی دارد. جدول زیر را ببینید:
| مدل | نوع | نیاز به GPU | مناسب برای |
|---|---|---|---|
| Tesseract | OCR سنتی | خیر | اسناد چاپی تمیز، بودجه محدود |
| olmOCR | Vision-Language | اختیاری (GGUF) | فاکتور، رسید، فرم |
| Chandra | Vision-Language | بله | جداول پیچیده، دستنوشته |
| Google Document AI | ابری | – | دقت بالا، بدون نگهداری |
| AWS Textract | ابری | – | فاکتور، فرم، جدول |
بر اساس مقایسههای انجامشده، سرویسهای ابری مثل Google Vision و Azure Read دقت بالاتری روی دستنوشته دارند (حدود ۷۸-۸۲٪ در مقابل ۳۴٪ برای Tesseract)، اما هزینه هر ۱۰۰۰ صفحه حدود ۱.۵ دلار است و وابستگی به ابر ایجاد میکند . اگر حجم اسناد شما متوسط است و میخواهید کنترل کامل روی دادهها داشته باشید، مدلهای متنباز روی VPS اختصاصی انتخاب هوشمندانهتری هستند.
بهینهسازی عملکرد روی سرور مجازی
وقتی سیستم را روی یک VPS معمولی (بدون GPU) اجرا میکنید، این نکات به شما کمک میکند تا سرعت و دقت را متعادل نگه دارید:
🔹 تصاویر را قبل از ارسال به مدل کوچک کنید. اکثر مدلهای Vision AI روی تصاویر با ابعاد بزرگتر از ۱۵۰۰ پیکسل کارایی بهتری دارند، اما بزرگتر از ۲۵۰۰ پیکسل باعث هدر رفتن حافظه میشود .
🔹 از صفبندی استفاده کنید. اگر حجم درخواستها بالا میرود، یک صف ساده (مثل Redis Queue) بین وبسرور و مدل قرار دهید تا از بار اضافی روی CPU جلوگیری شود.
🔹 مدل را کوانتیزه کنید. نسخههای GGUF مدلها با حفظ دقت قابل قبول، مصرف رم را تا ۶۰٪ کاهش میدهند و روی سرورهای ۴ تا ۸ گیگابایتی قابل اجرا هستند .
🔹 از LLM فقط برای ساختاریسازی استفاده کنید، نه برای خواندن تصویر. این کار مصرف توکن و زمان پردازش را به حداقل میرساند .
🛠️ مشکل فنی دارید یا به کانفیگ سرور نیاز دارید؟
اگر در راهاندازی سرویس OCR روی سرور مجازی به مشکل خوردهاید یا میخواهید تنظیمات بهینه را برای بار پردازشی خود دریافت کنید، تیم فنی ایرانیکاسرور آماده کمک است. کافی است درخواست خود را از طریق لینک زیر ثبت کنید تا کارشناسان ما در سریعترین زمان با شما تماس بگیرند.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
کاربردهای تجاری Document AI در کسبوکار
حالا که زیرساخت را دارید، بیایید ببینیم کجاها میتوانید از آن استفاده کنید:
🔹 حسابداری خودکار: استخراج مبلغ، تاریخ و شماره فاکتور از رسیدهای خرید و انتقال خودکار به نرمافزار حسابداری.
🔹 مدیریت قراردادها: شناسایی طرفین، تاریخ انقضا و مبالغ کلیدی از اسکن قراردادها و ایجاد یادآور خودکار.
🔹 ورود اطلاعات مشتریان: استخراج دادهها از فرمهای ثبتنام دستنویس یا اسکنشده و ذخیره در CRM.
🔹 پردازش انبوه اسناد: دستهبندی خودکار هزاران سند بر اساس نوع و محتوا بدون نیاز به نیروی انسانی.
برای مثال، یک کسبوکار کوچک با ۲۰۰ فاکتور در ماه میتواند با یک سرور مجازی ۴ گیگابایتی این فرآیند را خودکار کند و زمان ورود داده را از ۱۵ ساعت به کمتر از ۱ ساعت کاهش دهد. هزینه سرور در مقابل صرفهجویی در زمان کارمند، بسیار ناچیز است.
📌 پیشنهاد مطالعه مرتبط
اگر به تازگی تصمیم به خرید سرور مجازی گرفتهاید و نمیدانید از کجا شروع کنید، پیشنهاد میکنیم ابتدا راهنمای کامل انتخاب سرور مجازی مناسب را در صفحه محصولات سرور مجازی ایرانیکاسرور مطالعه کنید. در آنجا پلنهای مختلف با مشخصات دقیق مقایسه شدهاند.
جمعبندی
ترکیب OCR با Vision AI راهی عملی برای خودکارسازی استخراج اطلاعات از اسناد تجاری است. برخلاف تصور رایج، نیازی به سرورهای GPU گرانقیمت ندارید؛ یک سرور مجازی با مشخصات متوسط و مدلهای کوانتیزهشده مثل olmOCR میتواند کار شما را راه بیندازد. کلید موفقیت در انتخاب مدل مناسب، بهینهسازی پیشپردازش تصویر و ساختاردهی هوشمند خروجی است. اگر میخواهید این سیستم را روی زیرساختی پایدار و با پشتیبانی فنی راهاندازی کنید، ایرانیکاسرور با پلنهای متنوع سرور مجازی ایران و خارج، آماده همراهی شماست.







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.