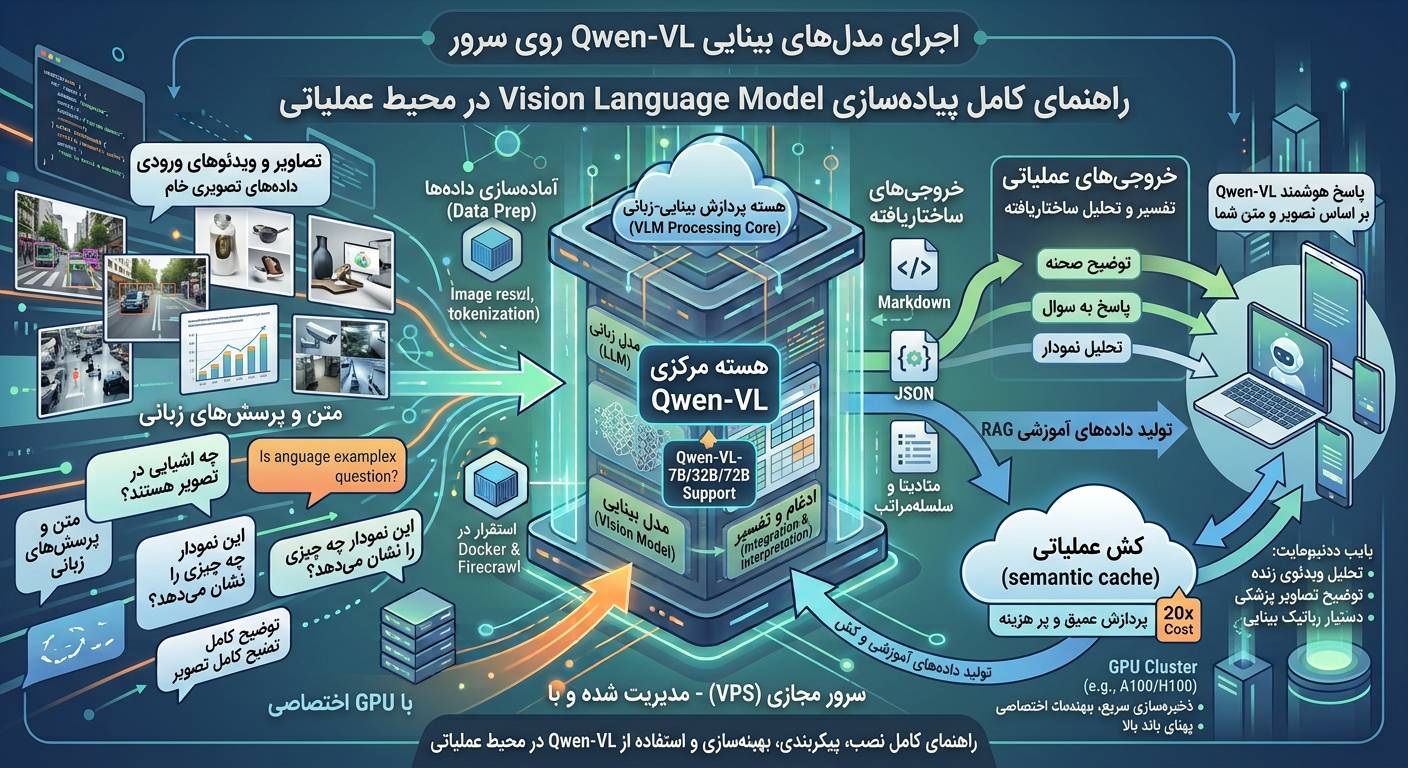
آموزشی 📅 9 مهر 1405 اجرای مدلهای بینایی Qwen-VL روی سرور: راهنمای کامل پیادهسازی Vision Language Model در محیط عملیاتی تا چند سال پیش، تصور اینکه یک ماشین بتواند تصویر ببیند، متن داخل آن را بخواند و دربارهاش استدلال کند،...
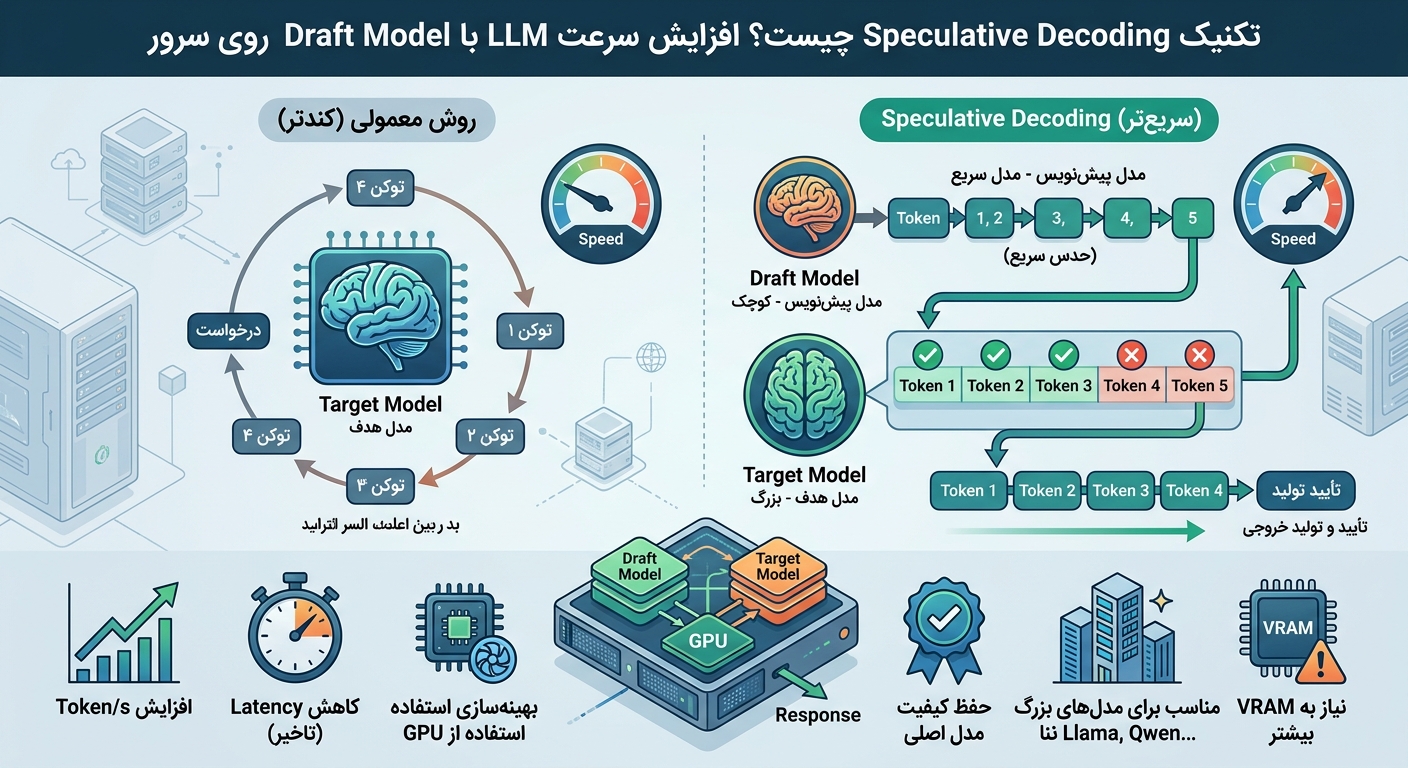
آموزشی 📅 8 مهر 1405 Speculative Decoding چیست؟ راهنمای عملی افزایش سرعت LLM روی سرور GPU اگر روی سرور خود یک مدل زبانی بزرگ مثل Llama 70B یا Qwen 32B اجرا میکنید، احتمالاً با این مشکل...