
Speculative Decoding چیست؟ راهنمای عملی افزایش سرعت LLM روی سرور GPU
اگر روی سرور خود یک مدل زبانی بزرگ مثل Llama 70B یا Qwen 32B اجرا میکنید، احتمالاً با این مشکل آشنا هستید:…
مجموعه آموزشها و راهنماهای مرتبط با این موضوع را در این صفحه دنبال کنید.
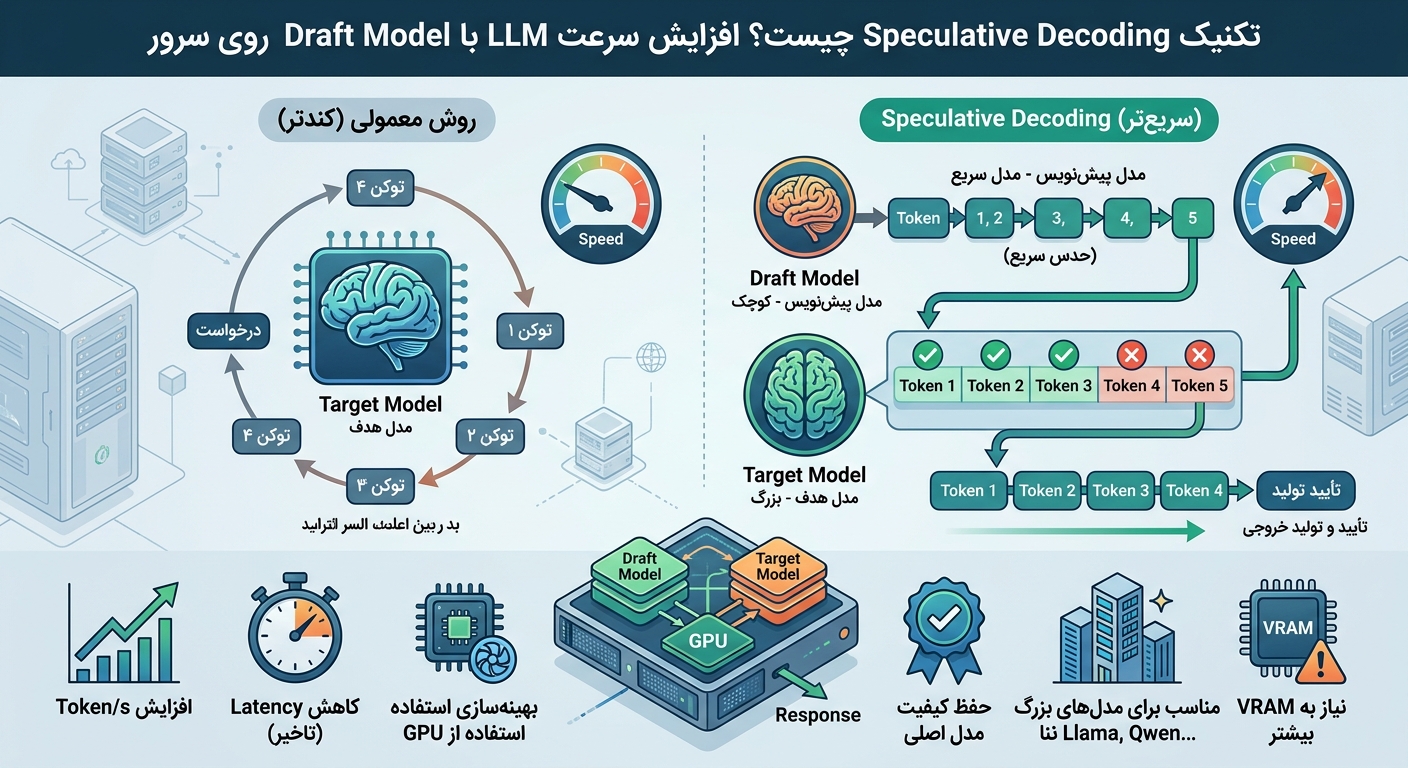
اگر روی سرور خود یک مدل زبانی بزرگ مثل Llama 70B یا Qwen 32B اجرا میکنید، احتمالاً با این مشکل آشنا هستید:…
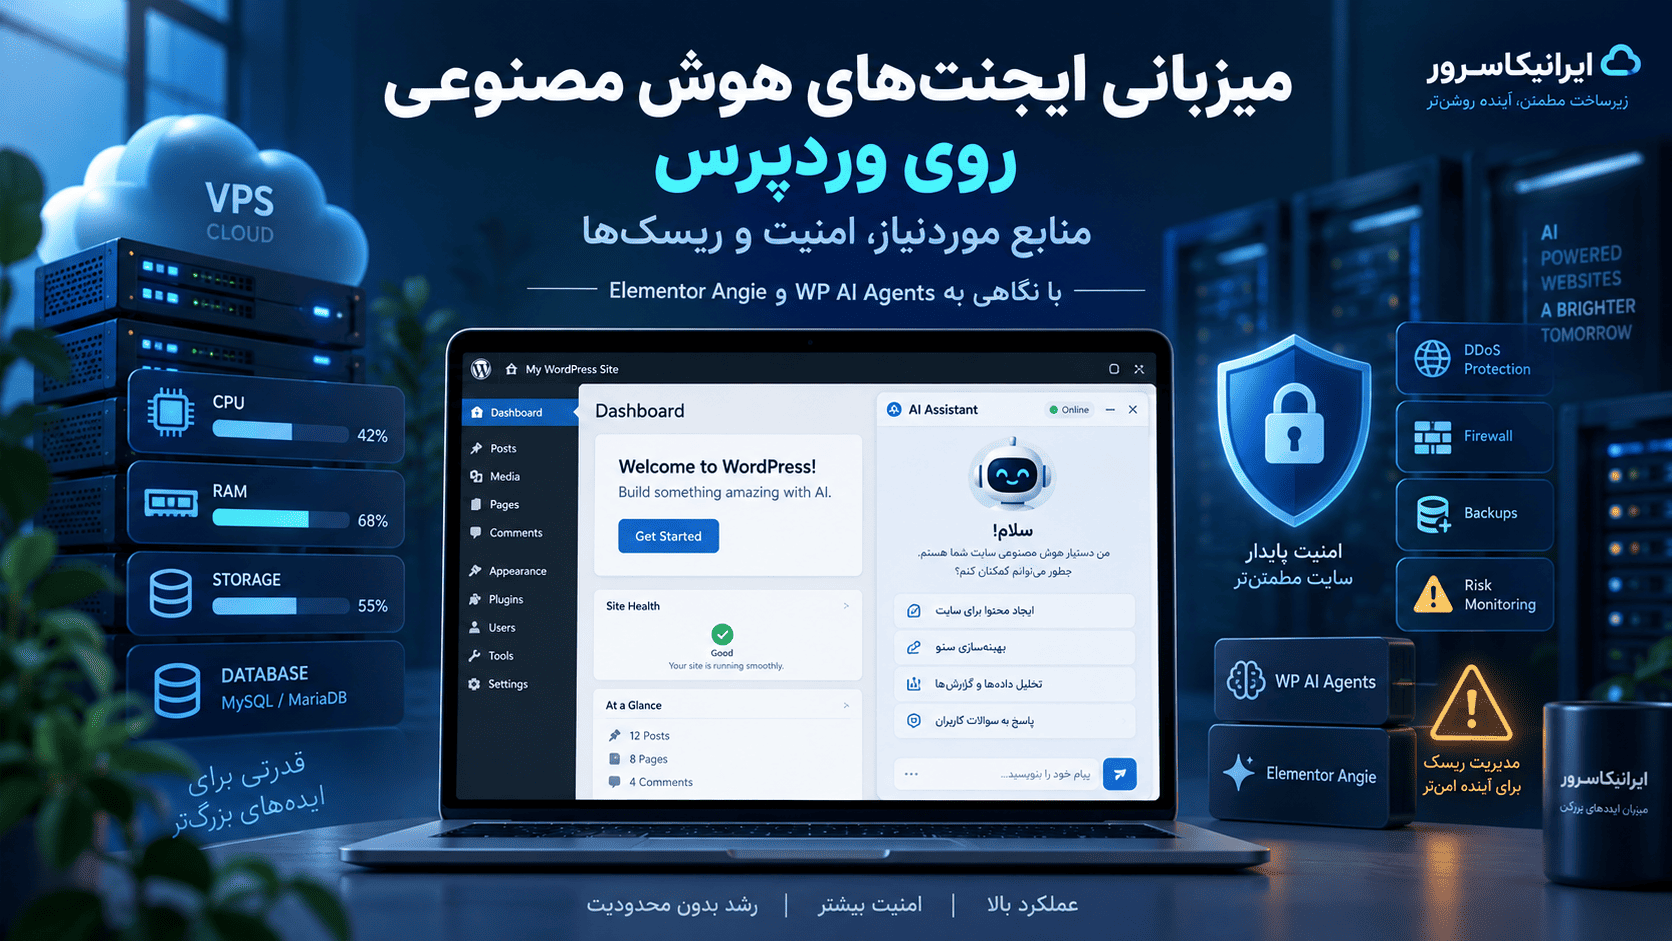
ایجنتهای هوش مصنوعی در حال تبدیل شدن از یک «چتبات ساده» به ابزارهایی هستند که میتوانند مستقیماً داخل وردپرس محتوا ایجاد کنند،…