
 Amir Jabbari
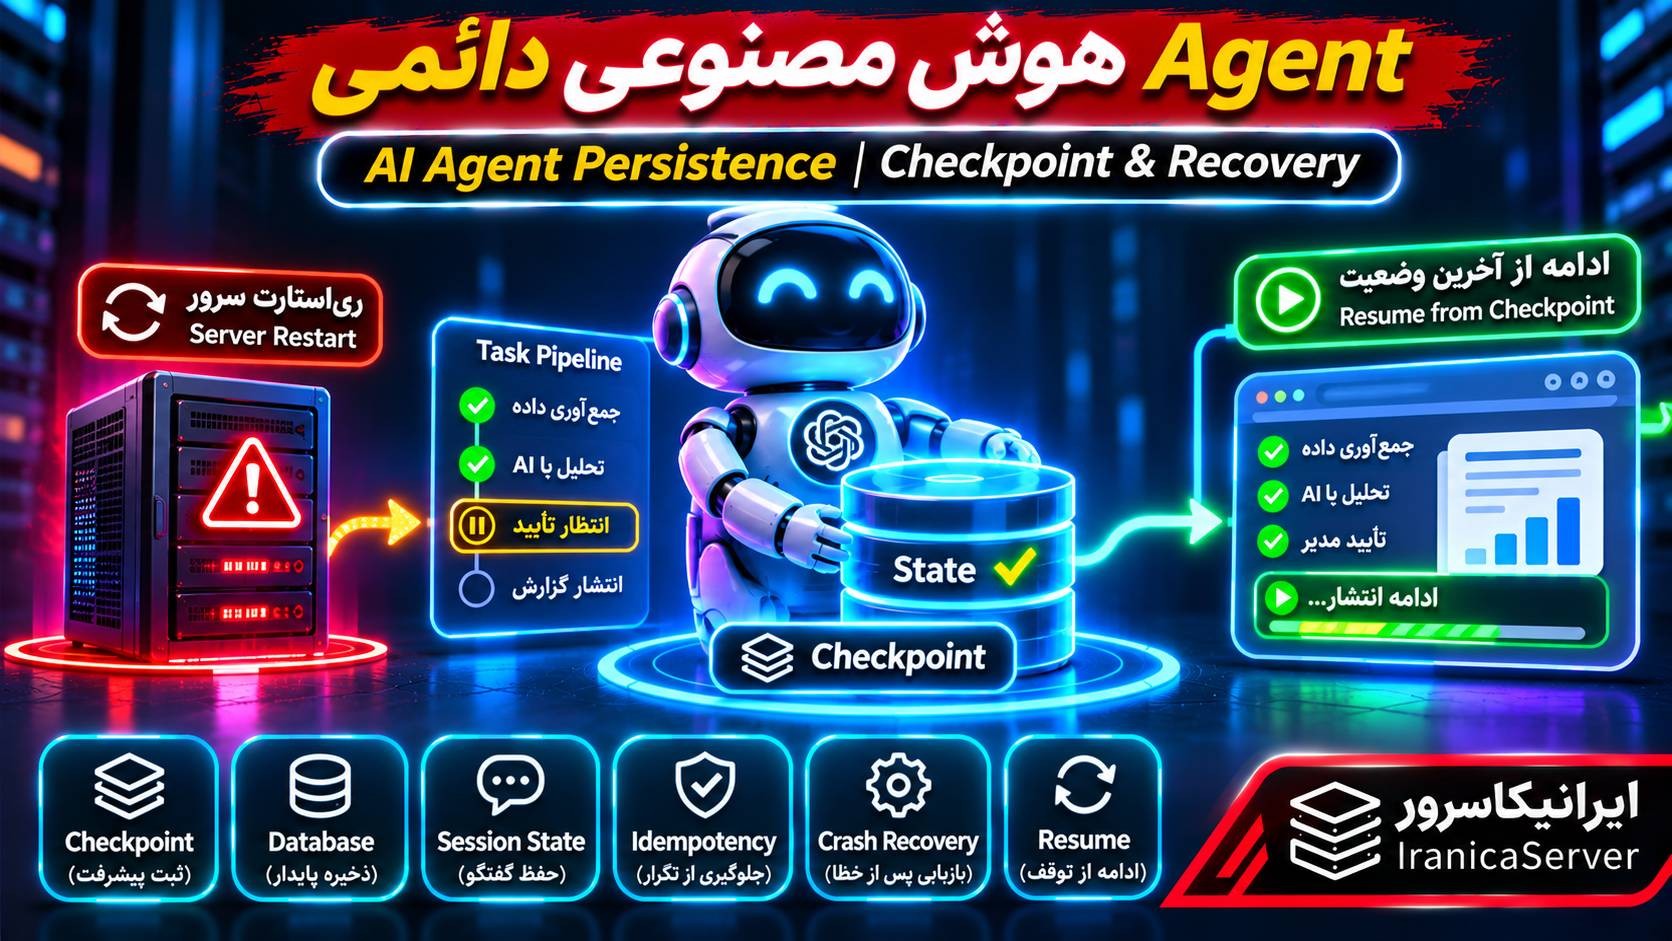
پاسخ به نحوه طراحی برنامه بستگی دارد. یک Agent معمولی که تمام اطلاعات خود را فقط در حافظه RAM نگهداری میکند، با بسته شدن فرآیند بخش زیادی از وضعیت اجراییاش را از دست میدهد. حتی اگر تاریخچه گفتگو را در یک دیتابیس ذخیره کرده باشید، این به معنی ذخیره وضعیت عملیات نیمهتمام نیست.
برای حل این مسئله از مفهومی به نام AI Agent Persistence استفاده میکنیم؛ یعنی نگهداری پایدار اطلاعات موردنیاز Agent برای ادامه گفتگو، پیگیری کارهای در حال اجرا، جلوگیری از عملیات تکراری و بازیابی پس از Crash یا Restart.
در این آموزش یک نمونه عملی با Python، OpenAI Agents SDK، SQLite و FastAPI روی Ubuntu VPS میسازیم. Agent ما یک گزارش آزمایشی تولید میکند، نتیجه را در پایگاه داده ذخیره میکند، برای تأیید مدیر متوقف میشود و سپس گزارش را بهصورت کنترلشده منتشر میکند. اگر سرور میان این مراحل خاموش شود، Worker پس از راهاندازی مجدد آخرین Checkpoint را بررسی میکند و از مرحله مناسب ادامه میدهد.
همچنین تفاوت Session و Checkpoint، سازوکار RunState در OpenAI Agents SDK، روشهای Idempotency، بازیابی Jobهای نیمهتمام، مدیریت اجرای همزمان، جلوگیری از تکرار عملیات مالی و انتخاب میان SQLite، PostgreSQL، Redis، LangGraph و Temporal را بررسی خواهیم کرد.
AI Agent Persistence چیست و چرا اهمیت دارد؟
AI Agent Persistence به توانایی حفظ اطلاعات و وضعیتهای موردنیاز Agent در یک محل پایدار گفته میشود؛ بهطوری که پس از بسته شدن برنامه، راهاندازی مجدد VPS یا قطع ارتباط کاربر، بتوان اطلاعات ذخیرهشده را بازیابی کرد.
یک Agent دائمی لزوماً به این معنی نیست که مدل هوش مصنوعی بهصورت پیوسته در حال پردازش باشد. در بسیاری از معماریها، Agent تنها هنگام دریافت درخواست یا رسیدن نوبت یک Job اجرا میشود. چیزی که باید دائمی باشد، امکان پیگیری و بازیابی وضعیت کار است.
مثال Agent تولید گزارش
فرض کنید Agent شما این مراحل را انجام میدهد:
- درخواست تولید گزارش دریافت میشود.
- اطلاعات موردنیاز از منبع مجاز خوانده میشوند.
- مدل هوش مصنوعی گزارش را تولید میکند.
- گزارش برای تأیید مدیر ذخیره میشود.
- مدیر گزارش را تأیید میکند.
- گزارش در سامانه مقصد ثبت میشود.
اگر فرآیند در مرحله چهارم متوقف شود، نباید پس از Restart دوباره اطلاعات را از ابتدا جمعآوری کند یا بدون دریافت تأیید، مستقیماً به مرحله انتشار برود.
برنامه باید بداند گزارش تولید شده، اما هنوز تأیید نشده است. این اطلاعات باید از RAM خارج و در یک محل پایدار ذخیره شده باشند.
چه پروژههایی به Persistence نیاز دارند؟
- Agent پشتیبانی با گفتگوهای چندمرحلهای.
- Agent تولید محتوا که منتظر بازبینی انسانی میماند.
- سیستم تحلیل اسناد و فایلهای حجیم.
- اتوماسیون ثبت گزارش و ارسال اعلان.
- Agent مدیریت سرویسها که تغییرات را مرحلهبهمرحله انجام میدهد.
- گردش کارهای دارای پرداخت، سفارش یا عملیات حساس.
- Agentهای زمانبندیشده که ممکن است هنگام اجرا با Restart سرور مواجه شوند.
یک Agent هوش مصنوعی چه نوع Stateهایی دارد؟
قبل از انتخاب دیتابیس باید بدانیم منظور از State دقیقاً چیست. معمولاً تمام وضعیتهای یک Agent را نباید در یک متغیر یا یک جدول ذخیره کرد.
| نوع State | اطلاعات نمونه | کاربرد |
|---|---|---|
| Conversation State | پیامهای کاربر و Agent | ادامه مکالمه |
| Workflow State | نام مرحله و نتیجه مراحل قبلی | ادامه کار نیمهتمام |
| Execution State | Toolهای در انتظار، تأییدها و اطلاعات Run | Resume اجرای متوقفشده |
| Business State | سفارش، گزارش یا تغییر ثبتشده | حفظ نتیجه واقعی عملیات |
| Operational State | وضعیت Worker، تلاشهای ناموفق و زمان اجرا | مدیریت بازیابی و مانیتورینگ |
| Idempotency State | کلید یکتای عملیات و نتیجه آن | جلوگیری از انجام دوباره کار |
برای مثال، اگر یک Agent به کاربر گفته باشد «گزارش شما آماده است»، این جمله در تاریخچه گفتگو ثبت میشود؛ اما سیستم انتشار همچنان باید مستقل بررسی کند آیا گزارش واقعاً در دیتابیس مقصد ثبت شده است یا خیر.
قاعده مهم: متن پاسخ مدل نباید منبع نهایی حقیقت درباره انجام یک عملیات خارجی باشد. منبع معتبر باید وضعیت واقعی ذخیرهشده در سیستم مقصد یا نتیجه تأییدشده عملیات باشد.
تفاوت Session، Checkpoint و RunState در Agent چیست؟
این سه مفهوم گاهی به جای یکدیگر استفاده میشوند، اما وظیفه یکسانی ندارند.
Session؛ حفظ حافظه گفتگو
Session اطلاعات مکالمه را نگهداری میکند تا Agent در پیام بعدی بتواند به اطلاعات قبلی مراجعه کند.
برای مثال، کاربر ابتدا میگوید «وضعیت سرور Minecraft را بررسی کن» و در پیام بعد میپرسد «پورت پیشفرض آن چیست؟». Session میتواند زمینه مکالمه قبلی را در دسترس قرار دهد.
در OpenAI Agents SDK میتوان از SQLiteSession، RedisSession، SQLAlchemySession و سایر Backendهای پشتیبانیشده استفاده کرد.
Checkpoint؛ ذخیره نقطه معتبر پیشرفت
Checkpoint ثبت میکند کدام مرحله از یک گردش کار به پایان رسیده و مرحله بعدی چیست.
بهعنوان مثال:
{
  "job_id": "job-1024",
  "status": "waiting_approval",
  "step": "await_approval",
  "analysis_saved": true,
  "published": false
}
اگر برنامه Restart شود، این اطلاعات به Worker میگویند نباید گزارش را بدون مجوز دوباره منتشر کند و باید همچنان در انتظار تأیید بماند.
RunState؛ وضعیت اجرایی خود Agents SDK
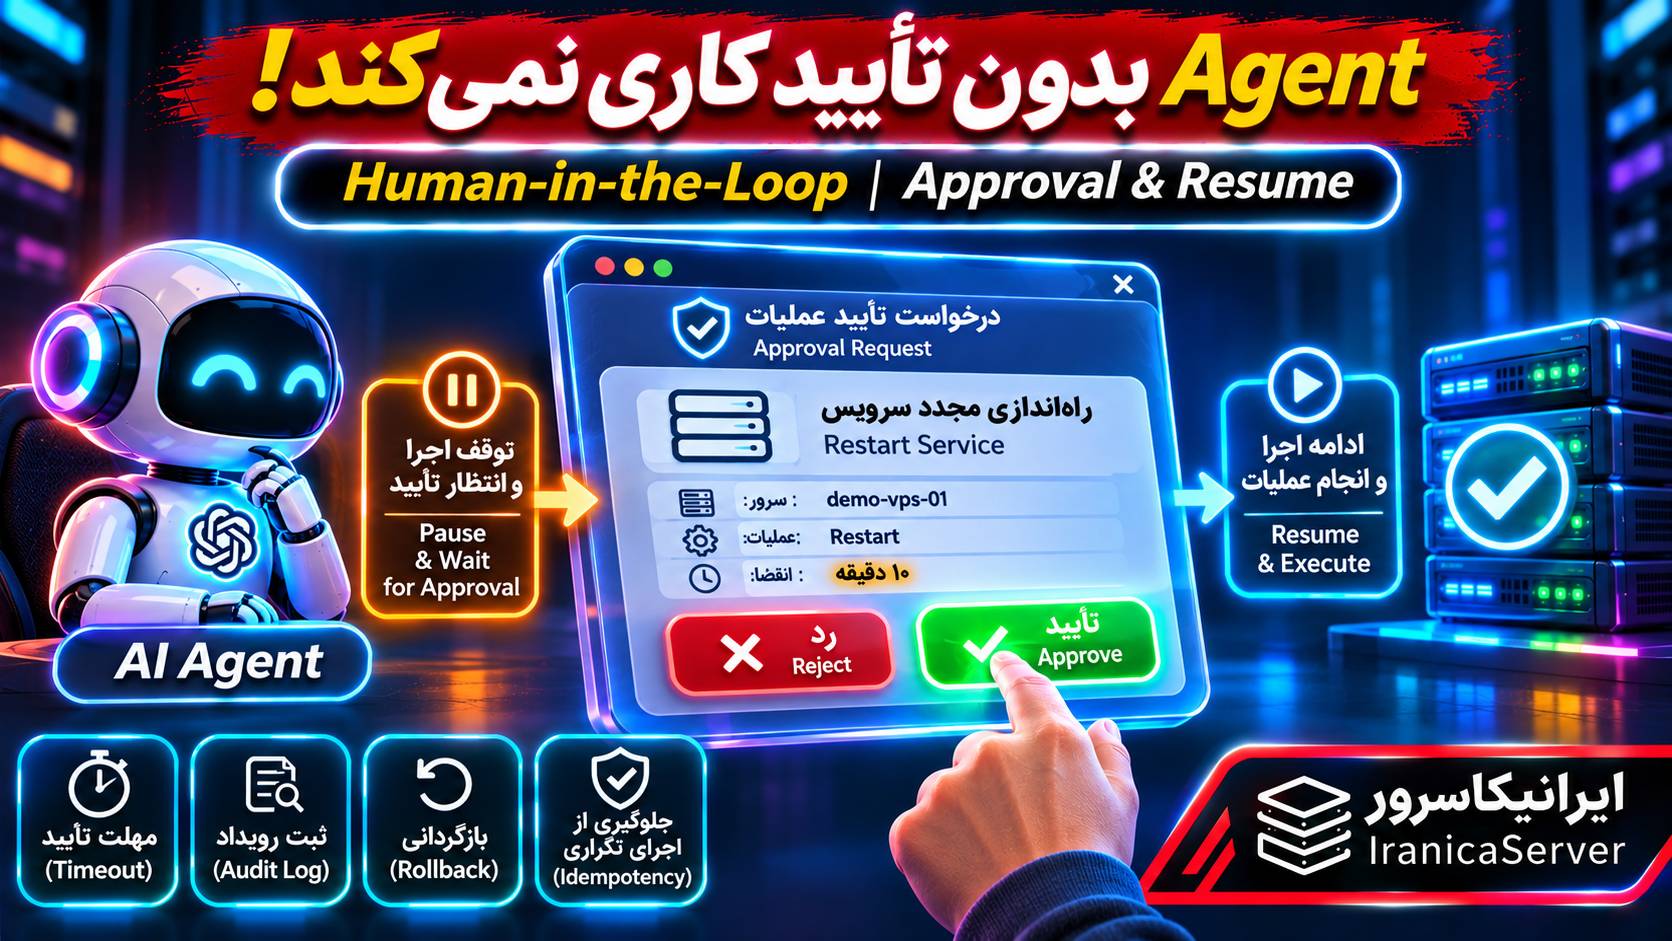
در نسخه فعلی OpenAI Agents SDK، ساختار RunState امکان ذخیره وضعیت اجرای متوقفشده، بهخصوص در فرآیندهای Human-in-the-loop را فراهم میکند.
برای مثال، اگر یک Tool نیازمند تأیید باشد، Runner میتواند اجرای Agent را متوقف کند. برنامه وضعیت را ذخیره میکند و بعداً با همان Agent و وضعیت بازیابیشده ادامه میدهد.
این قابلیت به معنی ذخیره خودکار تمام لحظات اجرای مدل یا امکان ادامه هر Tool خارجی از وسط یک دستور نیست.
| سؤال | راهکار |
|---|---|
| Agent پیام قبلی را به خاطر داشته باشد؟ | Session |
| بداند آخرین مرحله کاملشده کدام است؟ | Workflow Checkpoint |
| بعد از تأیید انسانی ادامه اجرای SDK را بازیابی کند؟ | RunState |
| یک سفارش یا پرداخت دوباره انجام نشود؟ | Destination Idempotency و Reconciliation |
| بعد از Restart سرویس دوباره فعال شود؟ | systemd یا زیرساخت مدیریت Worker |
یک نکته فنی دیگر: Checkpoint گردش کار با WAL Checkpoint در SQLite متفاوت است. اولی نقطه پیشرفت منطقی برنامه را ثبت میکند و دومی به مدیریت فایل Write-Ahead Log پایگاه داده مربوط میشود.
اگر Agent وسط کار Crash کند، چه اتفاقی باید بیفتد؟
برای طراحی صحیح Crash Recovery باید زمان توقف فرآیند را در نظر بگیریم.
حالت اول: توقف پس از ذخیره اطلاعات اولیه
اگر اطلاعات اولیه با موفقیت در دیتابیس ثبت شده باشند، Worker میتواند از مرحله تحلیل ادامه دهد.
حالت دوم: توقف هنگام فراخوانی مدل
ممکن است مدل پاسخ را تولید کرده باشد، اما برنامه قبل از ثبت نتیجه در دیتابیس متوقف شود. در چنین حالتی، اجرای دوباره مرحله تحلیل ممکن است یک درخواست تازه به API ایجاد کند.
بنابراین Checkpointهای برنامه بهتنهایی تضمین نمیکنند هزینه فراخوانی مدل هرگز تکرار نشود.
حالت سوم: توقف پس از ثبت گزارش و پیش از تأیید
اگر مرحله تولید گزارش و ثبت Checkpoint کامل شده باشد، وضعیت باید waiting_approval باقی بماند. Worker پس از Restart نباید بهصورت خودکار آن را تأیید کند.
حالت چهارم: توقف حین ثبت نتیجه در دیتابیس محلی
اگر اثر عملیات و تغییر وضعیت Job در یک تراکنش واحد انجام شوند، یا هر دو با موفقیت ثبت میشوند یا هر دو Rollback خواهند شد.
حالت پنجم: توقف پس از عملیات در سرویس خارجی
این حالت مهمتر و خطرناکتر است. فرض کنید API مقصد یک پرداخت را ثبت کرده، اما Agent قبل از ذخیره نتیجه در دیتابیس خودش متوقف شده است.
در این شرایط، درخواست مجدد بدون بررسی میتواند باعث پرداخت یا ثبت تکراری شود. برای پیشگیری به کلید Idempotency قابلاعمال در مقصد یا سازوکار Reconciliation نیاز داریم.
به همین دلیل در مثال عملی، مرحله انتشار را ابتدا در همان دیتابیس SQLite پیادهسازی میکنیم تا بتوانیم اثر جانبی و Checkpoint را در یک تراکنش کنترل کنیم.
معماری Agent قابلبازیابی روی VPS
برنامه ما سه بخش اصلی خواهد داشت: API برای ثبت درخواست، Worker برای انجام مراحل و Database برای نگهداری تمام وضعیتهای لازم.
User / Application
         |
      FastAPI
         |
    Durable Job DB
         |
    Single Worker
         |
   +-----+-----+
   |           |
Prepare      Checkpoint
   |
Analyze with OpenAI
   |
Checkpoint
   |
Waiting for Approval
   |
Trusted Operator Approval
   |
Publish to Local DB
   |
Atomic Commit + Done
مراحل اصلی Job
| Step | عملیات | وضعیت بعدی |
|---|---|---|
| prepare | آمادهسازی داده آزمایشی | queued / analyze |
| analyze | تولید گزارش با مدل | waiting_approval |
| await_approval | توقف برای تأیید اپراتور | بدون اجرای Worker |
| publish | ثبت گزارش در دیتابیس محلی | done |
بخش API مستقیماً درخواست OpenAI را اجرا نمیکند؛ بلکه Job را ثبت کرده و شناسه آن را برمیگرداند. Worker بهصورت مستقل Jobهای آماده را پردازش میکند.
مزیت این جداسازی آن است که قطع شدن اتصال HTTP کاربر باعث حذف Job نمیشود. همچنین وضعیت هر Job از طریق شناسه آن قابل بررسی است.
محدوده امنیتی نمونه
این پروژه آموزشی برای یک اپراتور مورد اعتماد، یک VPS و یک Worker طراحی شده است. API از یک توکن مشترک استفاده میکند و اطلاعات منابع نیز آزمایشی هستند.
برای محیط چندکاربره واقعی باید احراز هویت اختصاصی کاربران، مالکیت Job، مجوز تأییدکننده، Rate Limit و مدیریت Workerهای توزیعشده اضافه شود.
برای AI Agent Persistence از SQLite، PostgreSQL یا Redis استفاده کنیم؟
انتخاب دیتابیس به حجم درخواستها و معماری اجرای Agent بستگی دارد.
| فناوری | مزیت | محدودیت مهم |
|---|---|---|
| SQLite | ساده، سبک و مناسب یک VPS | یک Writer همزمان و مناسب نبودن WAL برای فایلسیستم شبکهای |
| PostgreSQL | تراکنشها، قفلگذاری و معماری چند Worker | نیازمند مدیریت سرویس دیتابیس |
| Redis | سرعت بالا و مناسب Queue و هماهنگی | نیاز به پیکربندی درست Persistence و تضمینهای مناسب دوام داده |
| Temporal | اجرای پایدار Workflow و بازیابی براساس Event History | زیرساخت و پیچیدگی عملیاتی بیشتر |
| LangGraph | Checkpoint در گردش کارهای Agentمحور | نیازمند انتخاب Checkpointer و طراحی ایمن عملیات جانبی |
برای یک نمونه کوچک روی یک VPS، SQLite انتخاب مناسبی است؛ زیرا نصب و مدیریت سادهای دارد. برای سامانه چندسروری و Workerهای متعدد، PostgreSQL همراه با Queue یا سیستم گردش کار پایدار انتخاب انعطافپذیرتری خواهد بود.
در این آموزش از SQLite در حالت WAL استفاده میکنیم و تغییرات حساس را با تراکنشهای کوتاه ثبت میکنیم.
مرحله اول: نصب Python و Agents SDK روی Ubuntu VPS
برای اجرای پروژه از Ubuntu 24.04 LTS استفاده میکنیم. دستورهای زیر برای نصب جدید نوشته شدهاند؛ اگر سرویس یا کاربر مشابهی از قبل روی سرور دارید، قبل از ایجاد آنها وضعیت موجود را بررسی کنید.
نصب بستههای موردنیاز
sudo apt update
sudo apt install -y python3 python3-venv python3-pip curl
ساخت کاربر غیر root
sudo useradd --system --create-home \
--home-dir /opt/iranica-agent-state \
--shell /usr/sbin/nologin agentstate
ساخت پوشه دادهها
sudo install -d -o agentstate -g agentstate -m 750 \
/var/lib/iranica-agent-state
ساخت محیط مجازی
sudo -u agentstate python3 -m venv \
/opt/iranica-agent-state/.venv

sudo -u agentstate /opt/iranica-agent-state/.venv/bin/python \
-m pip install --upgrade pip
نصب کتابخانهها
sudo -u agentstate /opt/iranica-agent-state/.venv/bin/pip install \
"openai-agents==0.24.0" fastapi uvicorn
در زمان تهیه این راهنما، نسخه 0.24.0 آخرین نسخه پایدار بررسیشده Agents SDK است. برای ارتقاهای بعدی، تغییرات نسخه و سازگاری Checkpointها را آزمایش کنید.
ساخت فایل تنظیمات محرمانه
sudo install -d -o root -g root -m 700 \
/etc/iranica-agent-state

sudo nano /etc/iranica-agent-state/agent.env
محتوای نمونه:
OPENAI_API_KEY=YOUR_OPENAI_API_KEY
AGENT_API_TOKEN=YOUR_LONG_RANDOM_OPERATOR_TOKEN
AGENT_MODEL=gpt-5.6-luna
AGENT_DB=/var/lib/iranica-agent-state/jobs.sqlite3
OPENAI_AGENTS_TRACE_INCLUDE_SENSITIVE_DATA=false
کلید OpenAI و توکن اپراتور باید دو مقدار متفاوت باشند. مدل را نیز میتوانید مطابق مدلهای فعال پروژه API خود تغییر دهید.
sudo chown root:root /etc/iranica-agent-state/agent.env
sudo chmod 600 /etc/iranica-agent-state/agent.env
این فایل بعداً از طریق EnvironmentFile توسط systemd در اختیار سرویسها قرار میگیرد.
مرحله دوم: ساخت پایگاه داده و Checkpoint با SQLite
برای پروژه سه جدول اصلی داریم: jobs برای وضعیت گردش کار، publications برای نتیجه نهایی انتشار و job_events برای ثبت تاریخچه مراحل.
فایل storage.py را در مسیر پروژه ایجاد کنید:
sudo nano /opt/iranica-agent-state/storage.pyکد کامل storage.py
import os
import sqlite3
from contextlib import contextmanager
from pathlib import Path

DB_PATH = Path(
    os.getenv(
        "AGENT_DB",
        "/var/lib/iranica-agent-state/jobs.sqlite3",
    )
)


@contextmanager
def connection():
    conn = sqlite3.connect(
        DB_PATH,
        timeout=15,
        isolation_level=None,
    )
    conn.row_factory = sqlite3.Row
    conn.execute("PRAGMA busy_timeout=5000")
    conn.execute("PRAGMA synchronous=FULL")

    try:
        yield conn
    finally:
        conn.close()


def initialize():
    DB_PATH.parent.mkdir(
        parents=True,
        exist_ok=True,
    )

    with connection() as conn:
        conn.execute("PRAGMA journal_mode=WAL")

        conn.executescript("""
        CREATE TABLE IF NOT EXISTS jobs (
          id TEXT PRIMARY KEY,
          idempotency_key TEXT NOT NULL UNIQUE,
          task TEXT NOT NULL,
          status TEXT NOT NULL DEFAULT 'queued',
          step TEXT NOT NULL DEFAULT 'prepare',
          source_json TEXT,
          analysis TEXT,
          attempts INTEGER NOT NULL DEFAULT 0,
          last_error TEXT,
          created_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP,
          updated_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP
        );

        CREATE TABLE IF NOT EXISTS publications (
          job_id TEXT PRIMARY KEY REFERENCES jobs(id),
          report TEXT NOT NULL,
          created_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP
        );

        CREATE TABLE IF NOT EXISTS job_events (
          id INTEGER PRIMARY KEY AUTOINCREMENT,
          job_id TEXT NOT NULL,
          event TEXT NOT NULL,
          created_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP
        );
        """)
چرا از WAL استفاده کردیم؟
در حالت Write-Ahead Logging یا WAL، SQLite میتواند در بسیاری از شرایط به خواندن اطلاعات هنگام نوشتن کمک کند و برای برنامهای با API و یک Worker محلی مناسب باشد.
با این حال، SQLite همچنان محدودیت یک Writer همزمان دارد. همچنین WAL نباید بهعنوان راهکاری برای استفاده مشترک از فایل SQLite میان چند ماشین روی فایلسیستم شبکهای در نظر گرفته شود.
وظیفه ستون step چیست؟
این ستون آخرین مرز ثبتشده گردش کار را نشان میدهد. برای مثال، اگر مقدار آن analyze باشد، Worker میداند مرحله آمادهسازی با موفقیت ثبت شده و نوبت تولید گزارش است.
چرا جدول publications کلید یکتا دارد؟
ستون job_id در این جدول PRIMARY KEY است؛ بنابراین یک Job نمیتواند دو رکورد انتشار مستقل با همان شناسه ایجاد کند.
در ادامه، ثبت انتشار و علامتگذاری Job بهعنوان done را داخل یک تراکنش انجام میدهیم.
مرحله سوم: ساخت API برای ثبت Job و مشاهده وضعیت آن
در این مرحله FastAPI را اضافه میکنیم. درخواست کاربر مستقیماً مدل را اجرا نمیکند؛ بلکه یک Job پایدار در پایگاه داده میسازد.
مزیت این روش آن است که حتی اگر مرورگر کاربر بسته شود، درخواست ثبتشده همچنان در دیتابیس باقی میماند.
کد کامل app.py
import os
import re
import secrets
import sqlite3
import uuid

from fastapi import (
    Depends,
    FastAPI,
    Header,
    HTTPException,
)
from pydantic import BaseModel, Field

from storage import connection, initialize


initialize()

TOKEN = os.environ["AGENT_API_TOKEN"]

app = FastAPI(
    title="Durable Agent Demo",
    docs_url=None,
    redoc_url=None,
)


class NewJob(BaseModel):
    task: str = Field(
        min_length=5,
        max_length=2000,
    )


def authorized(
    x_agent_token: str | None = Header(default=None),
):
    if not x_agent_token or not secrets.compare_digest(
        x_agent_token, TOKEN
    ):
        raise HTTPException(
            status_code=401,
            detail="Unauthorized",
        )


@app.post("/v1/jobs")
def create_job(
    data: NewJob,
    idempotency_key: str = Header(alias="Idempotency-Key"),
    _: None = Depends(authorized),
):
    if not re.fullmatch(
        r"[A-Za-z0-9_-]{8,80}",
        idempotency_key,
    ):
        raise HTTPException(
            status_code=422,
            detail="Invalid idempotency key",
        )

    job_id = str(uuid.uuid4())

    with connection() as conn:
        conn.execute("BEGIN IMMEDIATE")

        try:
            conn.execute(
                """INSERT INTO jobs
                   (id,idempotency_key,task)
                   VALUES(?,?,?)""",
                (job_id, idempotency_key, data.task),
            )

            conn.execute(
                """INSERT INTO job_events(job_id,event)
                   VALUES(?,?)""",
                (job_id, "created"),
            )

        except sqlite3.IntegrityError:
            row = conn.execute(
                """SELECT id,task FROM jobs
                   WHERE idempotency_key=?""",
                (idempotency_key,),
            ).fetchone()

            if row is None or row["task"] != data.task:
                raise HTTPException(
                    status_code=409,
                    detail="Key reused with another task",
                )

            job_id = row["id"]

        conn.commit()

    return {
        "job_id": job_id,
        "status_url": f"/v1/jobs/{job_id}",
    }


@app.get("/v1/jobs/{job_id}")
def job_status(
    job_id: str,
    _: None = Depends(authorized),
):
    with connection() as conn:
        row = conn.execute(
            """SELECT id,status,step,analysis,
                      attempts,last_error
               FROM jobs WHERE id=?""",
            (job_id,),
        ).fetchone()

        if row is None:
            raise HTTPException(
                status_code=404,
                detail="Job not found",
            )

        published = conn.execute(
            """SELECT report FROM publications
               WHERE job_id=?""",
            (job_id,),
        ).fetchone()

    return {
        **dict(row),
        "published_report": (
            published["report"] if published else None
        ),
    }


@app.post("/v1/jobs/{job_id}/approve")
def approve_job(
    job_id: str,
    _: None = Depends(authorized),
):
    # Trusted single-operator demo only.
    # Production requires reviewer identity and permissions.
    with connection() as conn:
        conn.execute("BEGIN IMMEDIATE")

        changed = conn.execute(
            """UPDATE jobs
               SET step='publish',
                   status='queued',
                   updated_at=CURRENT_TIMESTAMP
               WHERE id=?
                 AND status='waiting_approval'
                 AND step='await_approval'""",
            (job_id,),
        ).rowcount

        if changed != 1:
            raise HTTPException(
                status_code=409,
                detail="Not awaiting approval",
            )

        conn.execute(
            """INSERT INTO job_events(job_id,event)
               VALUES(?,?)""",
            (job_id, "approved"),
        )

        conn.commit()

    return {
        "job_id": job_id,
        "approved": True,
    }


@app.get("/v1/jobs/{job_id}/events")
def job_events(
    job_id: str,
    _: None = Depends(authorized),
):
    with connection() as conn:
        rows = conn.execute(
            """SELECT event,created_at
               FROM job_events
               WHERE job_id=?
               ORDER BY id""",
            (job_id,),
        ).fetchall()

    return [dict(row) for row in rows]
Idempotency-Key در ثبت Job چه کاری انجام میدهد؟
ممکن است کاربر روی دکمه ثبت دوبار کلیک کند یا برنامه به دلیل Timeout همان درخواست را دوباره ارسال کند.
اگر هر درخواست یک Job جدید ایجاد کند، Agent ممکن است یک کار را دو بار انجام دهد. در این نمونه، کلید Idempotency-Key برای هر درخواست منطقی ثابت میماند.
اگر همان کلید همراه همان متن درخواست دوباره ارسال شود، API شناسه Job قبلی را برمیگرداند. اگر همان کلید برای کار متفاوت استفاده شود، درخواست با خطای 409 رد میشود.
در محصول چندکاربره، این کلید باید در محدوده هویت کاربر یا سازمان مدیریت شود؛ در این نمونه به دلیل وجود فقط یک اپراتور، یکتایی آن در کل دیتابیس است.
چرا API یک Endpoint تأیید دارد؟
پس از تولید گزارش، Worker وضعیت waiting_approval را ثبت میکند. اپراتور میتواند نتیجه را ببیند و در صورت موافقت، Endpoint تأیید را فراخوانی کند.
محدودیت امنیتی: در این Demo هر دارنده توکن اپراتور میتواند تأیید کند. برای Production باید تأییدکننده واقعی احراز هویت شود و مجوز او برای همان Job بررسی شود. مدل هوش مصنوعی نباید به توکن تأیید یا قابلیت فراخوانی آزادانه این Endpoint دسترسی داشته باشد.
مرحله چهارم: ساخت Worker با Checkpoint و Crash Recovery
Worker مهمترین قسمت این پروژه است. وظیفه آن دریافت Jobهای آماده، انجام مرحله فعلی و ثبت نتیجه قبل از رفتن به مرحله بعدی است.
برای جلوگیری از دو اجرای همزمان در همین VPS، از قفل فرآیندی flock استفاده میکنیم. این قفل برای یک میزبان مناسب است، اما جایگزین Distributed Lock یا Lease در معماری چندسروری نیست.
کد کامل worker.py
import fcntl
import json
import logging
import os
import time

from agents import Agent, Runner

from storage import DB_PATH, connection, initialize


logging.basicConfig(level=logging.INFO)
logger = logging.getLogger("agent-worker")


agent = Agent(
    name="Durable Report Analyst",
    model=os.getenv("AGENT_MODEL", "gpt-5.6-luna"),
    instructions=(
        "Write a short Persian report. "
        "Use only the supplied demo data. "
        "Do not claim any real server was inspected. "
        "Do not perform external actions."
    ),
)


def recover():
    # Valid only with one worker on this VPS.
    with connection() as conn:
        conn.execute("BEGIN IMMEDIATE")

        rows = conn.execute(
            "SELECT id FROM jobs WHERE status='running'"
        ).fetchall()

        conn.execute(
            """UPDATE jobs SET status='queued'
               WHERE status='running'"""
        )

        for row in rows:
            conn.execute(
                """INSERT INTO job_events(job_id,event)
                   VALUES(?,?)""",
                (row["id"], "recovered"),
            )

        conn.commit()


def claim():
    with connection() as conn:
        conn.execute("BEGIN IMMEDIATE")

        job = conn.execute(
            """SELECT * FROM jobs
               WHERE status='queued'
               ORDER BY created_at,id
               LIMIT 1"""
        ).fetchone()

        if job:
            conn.execute(
                """UPDATE jobs SET status='running'
                   WHERE id=?""",
                (job["id"],),
            )

        conn.commit()
        return dict(job) if job else None


def checkpoint(
    job_id,
    previous_step,
    next_step,
    next_status,
    column=None,
    value=None,
):
    with connection() as conn:
        conn.execute("BEGIN IMMEDIATE")

        sql = (
            "UPDATE jobs SET step=?, status=?, "
            "updated_at=CURRENT_TIMESTAMP"
            + (f", {column}=?" if column else "")
            + " WHERE id=? AND status=? AND step=?"
        )

        params = [next_step, next_status]

        if column:
            params.append(value)

        params.extend(
            [job_id, "running", previous_step]
        )

        changed = conn.execute(
            sql, params
        ).rowcount

        if changed != 1:
            raise RuntimeError("Checkpoint conflict")

        conn.execute(
            """INSERT INTO job_events(job_id,event)
               VALUES(?,?)""",
            (job_id, f"checkpoint:{next_step}"),
        )

        conn.commit()


def handle(job):
    job_id = job["id"]
    step = job["step"]

    if step == "prepare":
        # Fixed read-only mock data.
        source = json.dumps(
            {
                "environment": "demo",
                "service": "minecraft-test",
                "status": "online",
                "players": 3,
            },
            ensure_ascii=False,
        )

        checkpoint(
            job_id,
            "prepare",
            "analyze",
            "queued",
            "source_json",
            source,
        )

    elif step == "analyze":
        result = Runner.run_sync(
            agent,
            (
                f"User task: {job['task']}\n"
                f"Verified demo data: {job['source_json']}"
            ),
            max_turns=3,
        )

        if (
            not isinstance(result.final_output, str)
            or not result.final_output.strip()
        ):
            raise ValueError("Empty model output")

        checkpoint(
            job_id,
            "analyze",
            "await_approval",
            "waiting_approval",
            "analysis",
            result.final_output,
        )

    elif step == "publish":
        # Effect and checkpoint are atomic in this DB.
        with connection() as conn:
            conn.execute("BEGIN IMMEDIATE")

            current = conn.execute(
                """SELECT analysis FROM jobs
                   WHERE id=?
                     AND step='publish'
                     AND status='running'""",
                (job_id,),
            ).fetchone()

            if current is None:
                raise RuntimeError("Unexpected job state")

            conn.execute(
                """INSERT OR IGNORE INTO publications
                   (job_id,report)
                   VALUES(?,?)""",
                (job_id, current["analysis"]),
            )

            conn.execute(
                """UPDATE jobs
                   SET step='done',
                       status='done',
                       updated_at=CURRENT_TIMESTAMP
                   WHERE id=?""",
                (job_id,),
            )

            conn.execute(
                """INSERT INTO job_events(job_id,event)
                   VALUES(?,?)""",
                (job_id, "published"),
            )

            conn.commit()

    else:
        raise RuntimeError(
            f"Unknown step: {step}"
        )


def handle_failure(job, exc):
    logger.exception(
        "Job failed: %s",
        job["id"],
    )

    with connection() as conn:
        conn.execute("BEGIN IMMEDIATE")

        row = conn.execute(
            """SELECT attempts FROM jobs
               WHERE id=?""",
            (job["id"],),
        ).fetchone()

        attempts = row["attempts"] + 1

        next_status = (
            "failed" if attempts >= 3 else "queued"
        )

        conn.execute(
            """UPDATE jobs
               SET attempts=?,
                   status=?,
                   last_error=?,
                   updated_at=CURRENT_TIMESTAMP
               WHERE id=?""",
            (
                attempts,
                next_status,
                type(exc).__name__,
                job["id"],
            ),
        )

        conn.execute(
            """INSERT INTO job_events(job_id,event)
               VALUES(?,?)""",
            (job["id"], f"error:{next_status}"),
        )

        conn.commit()

    time.sleep(min(2 ** attempts, 10))


def main():
    initialize()

    lock_path = DB_PATH.parent / "worker.lock"

    with open(lock_path, "a+") as lock_file:
        try:
            fcntl.flock(
                lock_file,
                fcntl.LOCK_EX | fcntl.LOCK_NB,
            )
        except BlockingIOError:
            raise SystemExit(
                "Another worker is already running"
            )

        recover()

        while True:
            job = claim()

            if not job:
                time.sleep(2)
                continue

            try:
                handle(job)
            except Exception as exc:
                handle_failure(job, exc)


if __name__ == "__main__":
    main()
تابع recover چه کاری انجام میدهد؟
اگر Worker هنگام اجرای یک مرحله متوقف شده باشد، وضعیت Job ممکن است running باقی مانده باشد.
در شروع Worker جدید، تابع recover این Jobها را دوباره به صف queued برمیگرداند. چون step و نتیجه مراحل قبلی در دیتابیس ثبت شدهاند، مرحله کاملشده از ابتدا تکرار نمیشود.
البته اگر توقف در وسط یک مرحله و پیش از Checkpoint رخ داده باشد، آن مرحله دوباره اجرا میشود. برای همین در این مثال، مرحله analyze صرفاً تولید متن است و اثر جانبی مدیریتی ندارد.
تابع checkpoint چه چیزی را تضمین میکند؟
این تابع نتیجه مرحله و وضعیت بعدی را در یک تراکنش ذخیره میکند. همچنین بررسی میکند Job هنوز در مرحله مورد انتظار قرار دارد.
در نتیجه، تغییر وضعیت تصادفی یا همزمان به مرحله دیگری کمتر احتمال دارد. اما این تابع بهتنهایی جایگزین هماهنگی چند Worker روی چند سرور نیست.
چرا انتشار با INSERT OR IGNORE انجام میشود؟
ستون job_id در جدول publications یکتا است. بنابراین اگر همان Job به هر دلیل دوباره وارد مرحله انتشار شود، تلاش برای ثبت رکورد تکراری اثر جدیدی ایجاد نمیکند.
مهمتر اینکه INSERT و UPDATE وضعیت Job داخل یک تراکنش هستند. این تضمین فقط برای عملیات داخل همین دیتابیس معتبر است و نباید آن را به تماسهای HTTP خارجی تعمیم داد.
چرا در این Worker از Session استفاده نکردیم؟
زیرا هر Job در این نمونه یک درخواست مستقل با مراحل مشخص است. اطلاعات موردنیاز اجرای بعدی در جدول jobs ذخیره میشود و برای این سناریو تاریخچه گفتگوی چندنوبتی ضروری نیست.
اگر پروژه شما علاوه بر Jobهای مستقل، دارای گفتگوهای متوالی باشد، میتوانید Session Persistence را بهصورت جداگانه اضافه کنید.
مرحله پنجم: تست Job، Checkpoint، Approval و Resume
پس از ذخیره فایلهای storage.py، app.py و worker.py، باید مالکیت فایلهای پروژه را برای کاربر سرویس تنظیم کنید.
sudo chown agentstate:agentstate \
/opt/iranica-agent-state/storage.py \
/opt/iranica-agent-state/app.py \
/opt/iranica-agent-state/worker.py

sudo chmod 640 \
/opt/iranica-agent-state/storage.py \
/opt/iranica-agent-state/app.py \
/opt/iranica-agent-state/worker.py
بررسی Syntax
sudo -u agentstate /opt/iranica-agent-state/.venv/bin/python \
-m py_compile \
/opt/iranica-agent-state/storage.py \
/opt/iranica-agent-state/app.py \
/opt/iranica-agent-state/worker.py
در این مرحله صرفاً ساختار کد بررسی میشود. برای تست عملی، متغیرهای محیطی و سرویسهای اجرایی نیز باید آماده باشند.
راهاندازی اولیه API و Worker
روش دائمی و مناسب اجرای این دو برنامه با systemd در بخش بعدی توضیح داده میشود. پس از فعال شدن هر دو سرویس، میتوانید از طریق Loopback یک Job ایجاد کنید.
ایجاد Job جدید
در دستور زیر مقدار توکن را با توکن واقعی اپراتور جایگزین کنید. از قرار دادن Secret واقعی داخل فایل عمومی یا History مشترک خودداری کنید.
curl -X POST http://127.0.0.1:8767/v1/jobs \
-H "Content-Type: application/json" \
-H "X-Agent-Token: YOUR_LONG_RANDOM_OPERATOR_TOKEN" \
-H "Idempotency-Key: demo-report-0001" \
-d '{
  "task": "یک گزارش کوتاه فارسی از سرویس آزمایشی تهیه کن"
}'
پاسخ شامل job_id و مسیر بررسی وضعیت خواهد بود.
پیگیری وضعیت Job
curl http://127.0.0.1:8767/v1/jobs/JOB_ID \
-H "X-Agent-Token: YOUR_LONG_RANDOM_OPERATOR_TOKEN"بهجای JOB_ID شناسه واقعی دریافتشده را وارد کنید.
بعد از تولید گزارش، در صورت موفقیت فراخوانی مدل، وضعیت باید waiting_approval و مرحله await_approval باشد.
تأیید و ادامه اجرا
پس از مشاهده و بررسی گزارش توسط اپراتور مجاز:
curl -X POST \
http://127.0.0.1:8767/v1/jobs/JOB_ID/approve \
-H "X-Agent-Token: YOUR_LONG_RANDOM_OPERATOR_TOKEN"
پس از تأیید، Job به مرحله publish منتقل میشود و Worker آن را پردازش میکند.
این Endpoint فقط برای اپراتور مورد اعتماد نمونه طراحی شده است. در نسخه واقعی نباید تأیید را به یک Tool قابل فراخوانی خودکار توسط Agent تبدیل کنید.
بررسی تاریخچه مراحل
curl http://127.0.0.1:8767/v1/jobs/JOB_ID/events \
-H "X-Agent-Token: YOUR_LONG_RANDOM_OPERATOR_TOKEN"
در اجرای موفق، انتظار داریم رویدادهایی مانند created، checkpoint:analyze، checkpoint:await_approval، approved و published ثبت شده باشند.
تست Idempotency
درخواست ساخت Job را با همان Idempotency-Key و همان متن دوباره ارسال کنید.
نتیجه مورد انتظار این است که API همان job_id قبلی را برگرداند و Job تازهای ساخته نشود.
اگر همان کلید را با متن متفاوت ارسال کنید، باید خطای HTTP 409 دریافت کنید.
تست بازیابی بعد از Restart
برای آزمایش، در محیط غیرعملیاتی Worker را هنگام اجرای یک Job متوقف کنید. پس از راهاندازی مجدد، وضعیت ذخیرهشده را بررسی کنید.
اگر مرحله قبلی کامل ثبت شده باشد، Job باید از همان Checkpoint ادامه پیدا کند. اگر Worker وسط فراخوانی مدل متوقف شده باشد، ممکن است آن فراخوانی دوباره انجام شود.
برای آزمایش قطع ناگهانی فرآیند، ابتدا مطمئن شوید فقط از داده آزمایشی استفاده میکنید و هیچ عملیات حساس خارجی در جریان نیست.
چگونه تاریخچه گفتگو را با SQLiteSession حفظ کنیم؟
تا اینجا یک Workflow پایدار ساختهایم. حالا اگر Agent شما با کاربران گفتگو میکند، علاوه بر Job Database به Session Persistence نیز نیاز دارید.
در OpenAI Agents SDK، SQLiteSession با مسیر فایل مشخص میتواند تاریخچه را روی دیسک نگهداری کند.
نمونه Session پایدار
from agents import Agent, Runner, SQLiteSession
agent = Agent(
name="Conversation Assistant",
model="gpt-5.6-luna",
instructions="Answer in Persian.",
)
session = SQLiteSession(
"conversation_001",
"/var/lib/iranica-agent-state/history.db",
)
first = Runner.run_sync(
agent,
"نام پروژه من Demo VPS است.",
session=session,
)
second = Runner.run_sync(
agent,
"نام پروژهای که گفتم چه بود؟",
session=session,
)
print(second.final_output)اگر برنامه بعداً دوباره با همان Session ID و همان فایل دیتابیس اجرا شود، میتواند تاریخچه قبلی را بازیابی کند.
آیا Session ID یک روش احراز هویت است؟
خیر. Session ID صرفاً انتخابکننده تاریخچه است. در برنامه چندکاربره باید مالکیت Session را با هویت واقعی کاربر بررسی کنید.
SQLiteSession یا RedisSession؟
برای یک Agent سبک روی یک VPS، SQLiteSession ساده است. برای چند Worker یا چند سرویس که باید تاریخچه مشترک داشته باشند، RedisSession یا SQLAlchemySession میتوانند مناسبتر باشند.
برای مثال، SQLAlchemySession امکان استفاده از PostgreSQL را فراهم میکند و برای پروژههایی که از قبل دیتابیس سازمانی دارند مفید است.
آیا previous_response_id همان Session است؟
خیر. در OpenAI Responses API میتوانید از previous_response_id یا conversation_id برای ادامه زمینه مکالمه در سمت OpenAI استفاده کنید.
اما بهتر است در هر Run یک راهبرد مشخص انتخاب کنید. ترکیب Session محلی با تنظیمات continuation سمت OpenAI در همان اجرای Agents SDK پشتیبانی نمیشود.
چگونه RunState را ذخیره و پس از Restart از همان نقطه Resume کنیم؟
OpenAI Agents SDK دارای قابلیت ذخیره وضعیت Runهای متوقفشده است. این ویژگی بهویژه برای ابزارهایی مفید است که قبل از اجرا نیاز به تأیید انسانی دارند.
نمونه تعریف Tool نیازمند تأیید
from agents import Agent
from agents.decorators import tool


@tool(needs_approval=True)
async def publish_demo_report(report: str) -> str:
    """Demonstrate a report publication after approval."""
    return f"Demo publication approved: {report}"


agent = Agent(
    name="Report Approval Agent",
    model="gpt-5.6-luna",
    instructions=(
        "Prepare a short Persian demo report. "
        "Use publish_demo_report when ready."
    ),
    tools=[publish_demo_report],
)
در این مثال، Tool هیچ انتشار خارجی واقعی انجام نمیدهد. هدف فقط نمایش مسیر تأیید و Resume است.
ذخیره وضعیت Run متوقفشده
import json
from pathlib import Path

from agents import Runner


STATE_PATH = Path(
    "/var/lib/iranica-agent-state/paused-run.json"
)


async def start_and_pause():
    result = await Runner.run(
        agent,
        "یک گزارش آزمایشی آماده و منتشر کن.",
    )

    if result.interruptions:
        state = result.to_state()

        STATE_PATH.write_text(
            json.dumps(
                state.to_json(),
                ensure_ascii=False,
            ),
            encoding="utf-8",
        )

        STATE_PATH.chmod(0o600)

        return "waiting_approval"

    return str(result.final_output)
پس از تولید درخواست تأیید توسط Tool، وضعیت اجرای Agent در فایل مشخصشده ذخیره میشود.
این مسیر فقط برای نشان دادن نحوه استفاده از SDK است. برای Production باید ذخیرهسازی اتمیک، کنترل مالکیت Snapshot و جلوگیری از استفاده همزمان از یک RunState را به برنامه اضافه کنید.
بازیابی RunState و ادامه اجرا
بعد از آنکه برنامه از طریق رابط مورد اعتماد، هویت و مجوز تأییدکننده را بررسی کرد، میتواند Snapshot ذخیرهشده را بارگذاری و تصمیم را اعمال کند.
import json
from agents import RunState, Runner


async def resume_after_verified_approval():
    stored = json.loads(
        STATE_PATH.read_text(encoding="utf-8")
    )

    state = await RunState.from_json(
        agent,
        stored,
    )

    pending = state.get_interruptions()

    if not pending:
        raise RuntimeError(
            "No pending tool approval"
        )

    # Only after trusted reviewer authorization.
    for interruption in pending:
        state.approve(
            interruption,
            always_approve=False,
        )

    result = await Runner.run(
        agent,
        state,
    )

    return result.final_output
در این نمونه، تابع resume_after_verified_approval فرض میکند بررسی هویت و تأیید واقعی قبلاً انجام شده است. این تابع نباید مستقیماً بهعنوان Endpoint عمومی بدون کنترلهای امنیتی منتشر شود.
در محیط عملیاتی، تصمیم هر Tool باید مستقل تأیید شود؛ نباید تمام درخواستهای معلق بهصورت خودکار پذیرفته شوند.
آیا میتوان Snapshot را به مرورگر کاربر ارسال کرد؟
بهتر است Snapshot کامل در حافظه ذخیرهسازی مورد اعتماد سرور باقی بماند. RunState ممکن است شامل پارامتر ابزارها، تصمیمهای تأیید و اطلاعات اجرایی حساس باشد.
برای رابط کاربری، شناسه غیرقابل حدس Job و جزئیات مجاز تأیید را ارسال کنید؛ نه تمام محتوای Serialized RunState.
یک هشدار درباره اجرای دوباره Tool
اگر Tool عملیاتی خارجی انجام دهد و فرآیند پیش از ذخیره وضعیت جدید متوقف شود، Resume از Snapshot قدیمی ممکن است Tool را دوباره اجرا کند.
بنابراین RunState و Approval جایگزین Idempotency در API مقصد نیستند.
Idempotency چیست و چگونه از عملیات تکراری جلوگیری میکند؟
Idempotency یعنی بتوان یک درخواست منطقی را چند بار دریافت کرد، بدون اینکه اثر نهایی آن بهصورت ناخواسته چند بار ایجاد شود.
برای مثال، اگر Agent درخواست ساخت یک گزارش را دوبار ارسال کند، بهتر است هر دو درخواست به همان Job منطقی اشاره کنند.
Idempotency در سطح ثبت Job
در API آموزشی ما، Idempotency-Key از ایجاد Job تکراری جلوگیری میکند.
اما جلوگیری از Job تکراری به معنی جلوگیری از اثر خارجی تکراری نیست. اگر Worker یک درخواست ثبت سفارش را دو بار به Backend بفرستد، خود Backend نیز باید از تکرار عملیات جلوگیری کند.
Idempotency در API مقصد
اگر API مقصد از کلید Idempotency پشتیبانی میکند، کلید مربوط به یک عملیات منطقی باید در تلاشهای مجدد ثابت بماند.
نمونه مفهومی برای درخواست HTTP:
import httpx


async def send_report(
    report_id: str,
    report_text: str,
    backend_token: str,
):
    async with httpx.AsyncClient(
        timeout=10.0,
        follow_redirects=False,
    ) as client:
        response = await client.post(
            "https://api.example.com/v1/reports",
            headers={
                "Authorization": f"Bearer {backend_token}",
                "Idempotency-Key": f"report:{report_id}",
            },
            json={
                "report_id": report_id,
                "text": report_text,
            },
        )

        response.raise_for_status()
        return response.json()
این کد فقط زمانی جلوی اثر تکراری را میگیرد که API مقصد واقعاً از Idempotency-Key پشتیبانی کند و آن را بهصورت اتمیک در سمت خودش اعمال کند.
اضافه کردن این Header به یک API که آن را نادیده میگیرد، هیچ تضمینی ایجاد نمیکند.
اگر API مقصد Idempotency نداشت چه کنیم؟
باید راهکاری برای بررسی نتیجه عملیات داشته باشید. برای مثال، یک شناسه درخواست خارجی ثبت کنید و پیش از Retry وضعیت آن را از API مقصد بررسی کنید.
اما حتی نبود نتیجه در یک جستوجوی معمولی همیشه اثبات نمیکند درخواست قبلی انجام نشده است؛ ممکن است نتیجه با تأخیر ثبت شود یا عملیات قبلی هنوز در حال اجرا باشد.
اگر نتیجه قطعی نیست، بهتر است وضعیت را unknown یا needs_reconciliation در نظر بگیرید و از Retry خودکار عملیات پرخطر خودداری کنید.
آیا Exactly Once همیشه امکانپذیر است؟
در محدوده یک تراکنش پایگاه داده میتوان تضمینهای قوی درباره ثبت یکباره تغییرات داشت. اما وقتی عملیات میان چند سرویس مستقل انجام میشود، تضمین اثر دقیقاً یکبار بدون همکاری مقصد و طراحی مناسب امکانپذیر نیست.
به همین دلیل معماریهای پایدار معمولاً اجرای حداقل یکبار همراه با ابزارهای Idempotency و Reconciliation را در نظر میگیرند.
Transactional Outbox چه زمانی لازم میشود؟
اگر Agent باید پس از ثبت نتیجه در دیتابیس، پیام یا درخواست دیگری به سرویس خارجی بفرستد، دو عمل جداگانه داریم: ثبت وضعیت داخلی و انجام عملیات خارجی.
اگر بین این دو مرحله Crash رخ دهد، ممکن است وضعیتها با یکدیگر سازگار نباشند.
الگوی Transactional Outbox
در این الگو، برنامه در یک تراکنش، تغییرات داخلی و یک پیام خروجیِ آماده ارسال را ثبت میکند.
سپس Worker جداگانهای پیام Outbox را به مقصد میفرستد و نتیجه را ثبت میکند.
BEGIN TRANSACTION

UPDATE jobs
SET status='ready_to_dispatch'
WHERE id='JOB_ID';

INSERT INTO outbox (
    operation_id,
    event_type,
    payload,
    status
) VALUES (
    'OPERATION_ID',
    'report.publish',
    '...',
    'pending'
);

COMMIT
این SQL ساختار مفهومی الگو را نشان میدهد. برای استفاده واقعی باید جدول outbox، مجوزها، انتخاب پیام توسط Worker و مدیریت نتیجه ارسال را پیادهسازی کنید.
نکته: Outbox احتمال گم شدن درخواست بعد از ثبت در دیتابیس را کاهش میدهد، اما بهتنهایی تضمین نمیکند مقصد پیام تکراری دریافت نکند. برای اثر یکباره، مقصد نیز باید از شناسه عملیات و Deduplication مناسب پشتیبانی کند.
چرا قفل Worker و مدیریت همزمانی مهم است؟
در نمونه عملی از flock استفاده کردیم تا فقط یک Worker روی همان VPS فعال باشد.
این کار مانع میشود دو فرآیند محلی همزمان Jobهای running را بازیابی کنند یا هر دو تصور کنند مالک اجرای کار هستند.
آیا flock برای چند VPS کافی است؟
خیر. flock در این مثال فقط هماهنگی همان میزبان را انجام میدهد. برای چند VPS و دیتابیس مشترک باید از قفلها یا Leaseهای مناسب در یک سامانه مشترک استفاده کنید.
Lease چیست؟
Lease حق موقت انجام یک Job است که معمولاً دارای مالک و زمان انقضاست.
Worker هنگام شروع، Lease را دریافت میکند و تا زمانی که فعال است آن را تمدید میکند. اگر Worker از کار بیفتد، پس از پایان Lease، Worker دیگری میتواند برای بازیابی اقدام کند.
اما زمان انقضای Lease بهتنهایی تضمین نمیکند Worker قبلی کاملاً متوقف شده باشد. برای عملیات حساس از Fencing Token، بررسی مالکیت در زمان Commit و Idempotency سمت مقصد استفاده میشود.
چرا از Lease در نمونه SQLite استفاده نکردیم؟
چون این پروژه عمداً برای یک Worker روی یک VPS طراحی شده است. افزودن Lease بدون نیاز، پیچیدگی را بیشتر میکرد.
در معماری چند Worker، بازیابی تمام Jobهای running در زمان شروع هر Worker دیگر روش امنی نیست و باید با Claim اتمیک و Lease مناسب جایگزین شود.
مرحله ششم: اجرای دائمی Agent و Worker با systemd
برای اجرای پایدار پروژه باید API و Worker دو سرویس مستقل داشته باشند.
API درخواستها را دریافت میکند و Worker در پسزمینه صف Jobها را پردازش میکند. اگر یکی متوقف شود، دیگری همچنان میتواند وضعیت ذخیرهشده را حفظ کند.
ساخت سرویس API
فایل زیر را ایجاد کنید:
sudo nano /etc/systemd/system/iranica-agent-api.serviceمحتوای سرویس:
[Unit]
Description=Iranica Durable Agent API
Wants=network-online.target
After=network-online.target

[Service]
Type=simple
User=agentstate
Group=agentstate
WorkingDirectory=/opt/iranica-agent-state
EnvironmentFile=/etc/iranica-agent-state/agent.env

ExecStart=/opt/iranica-agent-state/.venv/bin/uvicorn app:app --host 127.0.0.1 --port 8767 --workers 1

Restart=on-failure
RestartSec=5
UMask=0077

NoNewPrivileges=true
PrivateTmp=true
ProtectHome=true
ProtectSystem=strict
ReadWritePaths=/var/lib/iranica-agent-state

MemoryAccounting=true
CPUAccounting=true

[Install]
WantedBy=multi-user.target
ساخت سرویس Worker
sudo nano /etc/systemd/system/iranica-agent-worker.serviceمحتوا:
[Unit]
Description=Iranica Durable Agent Worker
Wants=network-online.target
After=network-online.target

[Service]
Type=simple
User=agentstate
Group=agentstate
WorkingDirectory=/opt/iranica-agent-state
EnvironmentFile=/etc/iranica-agent-state/agent.env

ExecStart=/opt/iranica-agent-state/.venv/bin/python /opt/iranica-agent-state/worker.py

Restart=on-failure
RestartSec=5
TimeoutStopSec=30
UMask=0077

NoNewPrivileges=true
PrivateTmp=true
ProtectHome=true
ProtectSystem=strict
ReadWritePaths=/var/lib/iranica-agent-state

MemoryAccounting=true
CPUAccounting=true
MemoryMax=1G

[Install]
WantedBy=multi-user.target
مقدار MemoryMax یک محدودیت نمونه است. اگر Toolهای محلی Agent پردازش سنگین انجام میدهند، باید متناسب با مصرف واقعی تغییر کند.
فعالسازی سرویسها
sudo systemctl daemon-reload

sudo systemctl enable --now iranica-agent-api
sudo systemctl enable --now iranica-agent-worker

sudo systemctl status iranica-agent-api --no-pager
sudo systemctl status iranica-agent-worker --no-pager
پس از Restart VPS، systemd سرویسهای فعالشده را دوباره راهاندازی میکند. Worker سپس کارهایی را که در زمان توقف، running باقی ماندهاند طبق منطق Recovery بررسی میکند.
مشاهده لاگ Worker
sudo journalctl -u iranica-agent-worker -n 100 --no-pagerآیا پورت 8767 باید در Firewall باز باشد؟
خیر. در این معماری FastAPI فقط روی 127.0.0.1 گوش میدهد. اگر لازم است یک وبسایت از راه دور به API متصل شود، بهتر است آن را پشت Nginx یا Reverse Proxy دارای HTTPS و کنترل دسترسی مناسب قرار دهید.
انتشار عمومی مستقیم API آزمایشی بدون احراز هویت چندکاربره، محدودیت درخواست و سیاست امنیتی مناسب توصیه نمیشود.
Backup و بازیابی دیتابیس State بدون خراب شدن Checkpointها
اگر دیتابیس State از بین برود، حتی اجرای سالم Worker و Agents SDK نیز نمیتواند وضعیت ذخیرهنشده را بازسازی کند.
بنابراین Backup باید بخشی از طراحی Persistence باشد.
چرا کپی ساده فایل SQLite هنگام اجرا کافی نیست؟
در حالت WAL ممکن است بخشی از تراکنشهای جدید هنوز در فایل WAL قرار داشته باشند. کپی کردن فقط فایل اصلی دیتابیس هنگام اجرای برنامه میتواند Backup ناقص ایجاد کند.
برای تهیه Backup سازگار میتوانید از SQLite Backup API استفاده کنید.
نمونه Backup با Python
import sqlite3
from pathlib import Path


source = Path(
    "/var/lib/iranica-agent-state/jobs.sqlite3"
)

destination = Path(
    "/var/lib/iranica-agent-state/jobs-backup.sqlite3"
)

with sqlite3.connect(source) as src:
    with sqlite3.connect(destination) as dst:
        src.backup(dst)
فایل Backup نباید تنها نسخه پشتیبان شما باشد و بهتر است به مقصدی مستقل از دیسک اصلی VPS منتقل شود.
چه اطلاعاتی باید Backup شوند؟
- Job Database و وضعیت مراحل.
- Session Database در صورت استفاده.
- Snapshotهای ذخیرهشده RunState.
- تنظیمات لازم برای اجرای برنامه.
- شناسههای عملیات خارجی و رکوردهای Reconciliation.
- کد و نسخه وابستگیهایی که با Checkpointها سازگار هستند.
Secrets باید طبق سیاست جداگانه و با رمزنگاری و کنترل دسترسی مناسب پشتیبانگیری شوند. نباید Credentialهای فعال در Backupهای عمومی یا قابل دانلود قرار بگیرند.
تست Restore ضروری است
داشتن فایل Backup کافی نیست. لازم است بهصورت دورهای روی محیط آزمایشی Restore انجام دهید و بررسی کنید Jobهای waiting_approval، done و failed بهدرستی بازسازی میشوند.
همچنین قبل از فعال کردن Worker روی نسخه Restoreشده، مطمئن شوید هیچ Worker دیگری روی همان Jobهای واقعی در حال اجرا نیست.
برای Agent دائمی در Production چه معماری مناسبتر است؟
نمونه این مقاله برای فهم اصول Persistence و اجرای محدود روی یک VPS طراحی شده است. برای سیستم پرترافیک یا چندسروری باید بعضی اجزا را تغییر دهید.
سناریوی اول: یک VPS و یک Worker
برای کارهای سبک، SQLite، Worker مستقل و systemd میتوانند نقطه شروع مناسبی باشند.
اما باید محدودیت منابع، پشتیبانگیری، کنترل خطا و تست بازیابی وجود داشته باشد.
سناریوی دوم: چند Worker روی یک یا چند VPS
در این حالت استفاده از PostgreSQL، Queue مشترک و Claim اتمیک مناسبتر است.
هر Worker باید مالکیت موقت Job را دریافت کند و قبل از ثبت نتایج، اعتبار مالکیت خود را بررسی کند. همچنین باید از اجرای موازی یک Conversation یا Resume همزمان یک RunState جلوگیری شود.
سناریوی سوم: Workflowهای طولانی با تأییدهای متعدد
اگر Agent قرار است روزها یا هفتهها منتظر تأیید، پیام یا نتیجه سرویس خارجی بماند، یک Workflow Engine تخصصی میتواند پیچیدگی مدیریت مراحل را کاهش دهد.
Temporal چه مزیتی دارد؟
Temporal با استفاده از Event History میتواند وضعیت منطقی Workflow را هنگام بازیابی بازسازی کند. عملیات خارجی در قالب Activity اجرا میشوند و نتایج موفق آنها در تاریخچه ثبت میشوند.
با این حال، Activity ممکن است در بعضی شرایط دوباره اجرا شود؛ بنابراین Idempotency همچنان برای عملیات خارجی اهمیت دارد.
LangGraph چه کاربردی دارد؟
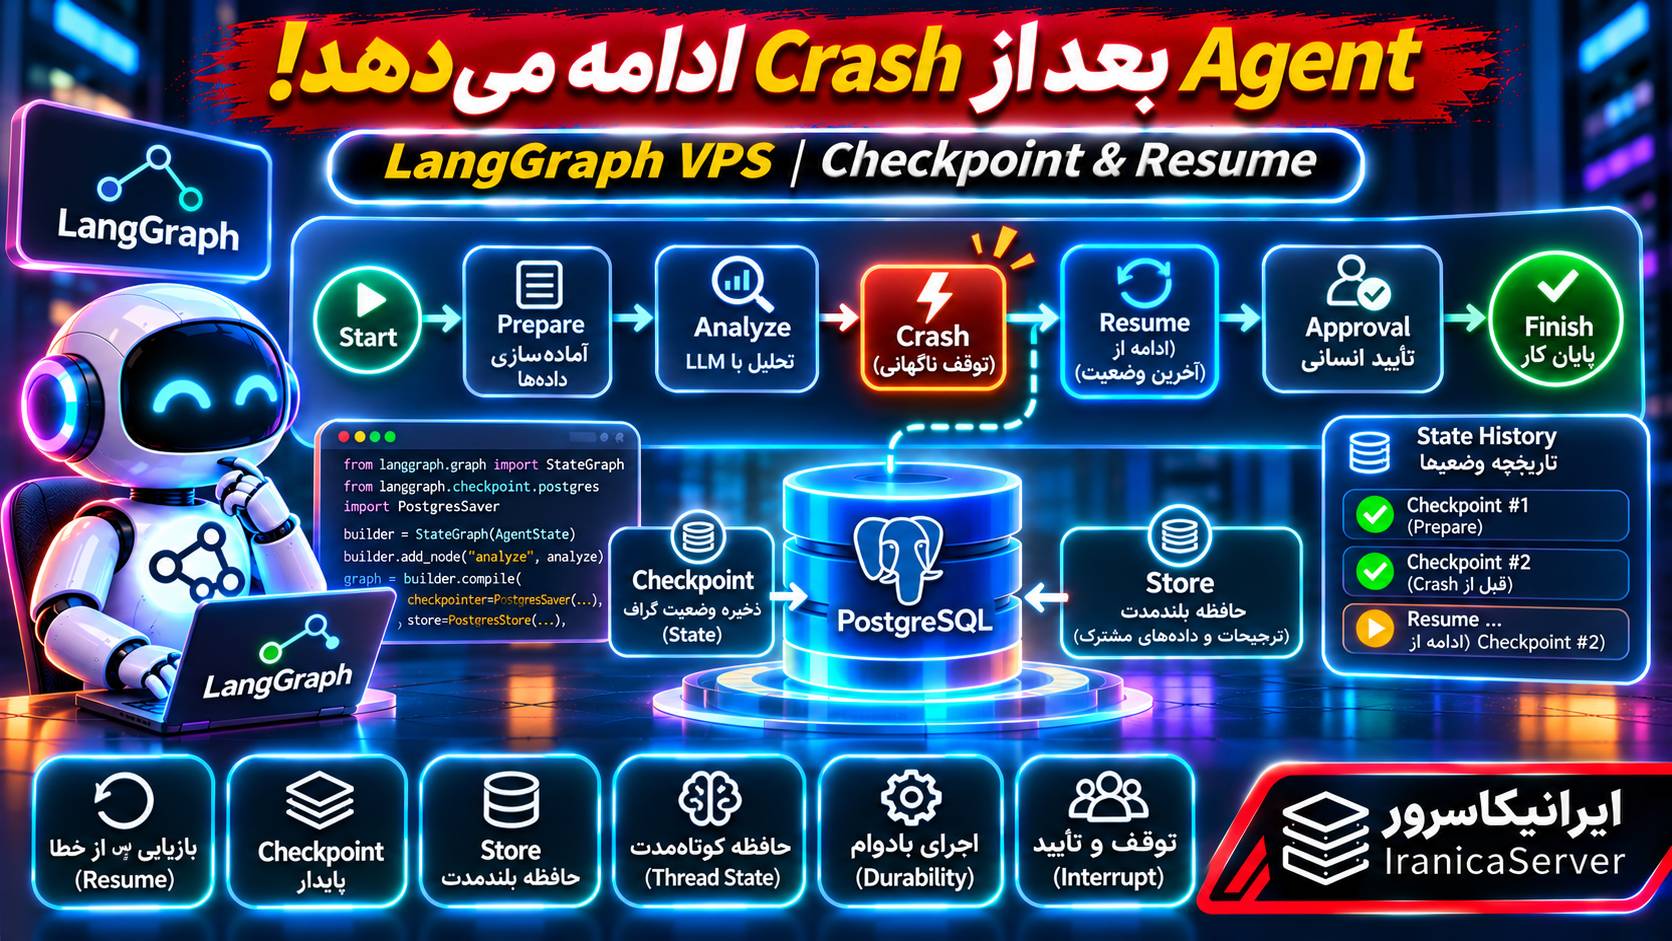
LangGraph از Checkpointer برای نگهداری وضعیت گردش کار در مراحل مشخص استفاده میکند. این قابلیت برای Agentهایی که دارای چند Node، توقف انسانی یا اجرای قابلبازیابی هستند مفید است.
در این معماری نیز عملیات خارجی باید جداگانه از نظر تکرارپذیری و آثار جانبی بررسی شوند.
آیا OpenAI Background Mode جایگزین Persistence است؟
خیر. Background Mode در Responses API به شما اجازه میدهد یک درخواست مدل را بهصورت غیرهمزمان اجرا و با شناسه پاسخ، وضعیت آن را بررسی کنید.
اما این قابلیت جایگزین Job Database، تأیید عملیات، مدیریت Toolهای خارجی یا دوام وضعیت کسبوکار شما نیست. همچنین باید محدودیتهای نگهداری داده و امکان بازیابی پاسخ را بررسی کنید.
چه زمانی VPS قویتر لازم است؟
اگر مدل از طریق API اجرا میشود، CPU و RAM بیشتر VPS لزوماً کیفیت پاسخ مدل را افزایش نمیدهند.
اما اگر Workerهای متعدد، پردازش فایل، دیتابیس محلی یا ابزارهای سنگین اجرا میکنید، منابع بیشتر میتوانند ظرفیت و پایداری برنامه را بهبود دهند.
خطاهای رایج AI Agent Persistence و راهحلها
۱. Agent بعد از Restart گفتگوهای قبلی را به خاطر ندارد
احتمالاً تاریخچه فقط در حافظه نگهداری شده یا فایل SQLiteSession با مسیر پایدار تنظیم نشده است.
مسیر دیتابیس و Session ID را بررسی کنید و مطمئن شوید برنامه بعد از Restart به همان منبع ذخیرهسازی متصل میشود.
۲. Job بعد از Restart دوباره از ابتدا اجرا میشود
ممکن است Checkpoint بعد از پایان هر مرحله ثبت نشده باشد یا Worker بهجای خواندن step ذخیرهشده، همیشه گردش کار را از اولین مرحله آغاز کند.
تاریخچه Job و مقدار step را در دیتابیس بررسی کنید.
۳. یک درخواست دو Job ایجاد میکند
احتمالاً برای تلاش مجدد از Idempotency-Key جدید استفاده شده یا در دیتابیس محدودیت یکتایی وجود ندارد.
برای یک درخواست منطقی، از کلید ثابت استفاده کنید و یکتایی آن را در محل ذخیرهسازی معتبر اعمال کنید.
۴. گزارش تولید شده ولی هنوز waiting_approval است
این وضعیت در نمونه ما طبیعی است. Worker پس از تولید گزارش باید متوقف شود تا اپراتور نتیجه را بررسی کند.
برای ادامه، تأیید معتبر از مسیر مورد اعتماد لازم است.
۵. خطای SQLite database is locked
ممکن است چند تراکنش نوشتنی طولانی اجرا شوند یا Workerهای بیشتری از ظرفیت طراحی فعال باشند.
تراکنشها را کوتاه نگه دارید، تنظیمات Busy Timeout را بررسی کنید و از اجرای چند Worker مستقل با منطق بازیابی تکWorker خودداری کنید.
۶. Worker بهدلیل flock اجرا نمیشود
ممکن است یک فرآیند دیگر همچنان قفل را نگه داشته باشد. ابتدا با systemctl و فهرست فرآیندها بررسی کنید آیا Worker قبلی فعال است.
صرف حذف فایل Lock در حالی که Worker دیگری فعال است، راهکار امنی برای حل مشکل نیست.
۷. Agent در مرحله analyze خطا میدهد
API Key، اعتبار مصرف، دسترسی به مدل و ارتباط شبکه را بررسی کنید.
در کد نمونه، خطاهای این مرحله ثبت میشوند و Job تا تعداد تلاش مشخص دوباره در صف قرار میگیرد.
۸. یک درخواست مدل دوباره محاسبه شده است
اگر Crash قبل از ذخیره خروجی مدل رخ داده باشد، فراخوانی دوباره ممکن است اتفاق بیفتد.
برای کاهش هزینه تکرار میتوانید از شناسه درخواست، Background Responses در سناریوهای پشتیبانیشده و روش بازیابی نتیجه استفاده کنید؛ اما تضمینهای آنها باید جداگانه بررسی شوند.
۹. RunState پس از آپدیت SDK بازیابی نمیشود
ممکن است تعریف Agent، Toolها یا ساختار Snapshot با نسخه جدید ناسازگار شده باشد.
نسخه کد، مدل و SDK را در کنار Snapshot نگهداری کنید و قبل از ارتقای Production، Resume کردن وضعیتهای معلق را آزمایش کنید.
۱۰. خطای Permission denied برای فایل دیتابیس
مالکیت و مجوز مسیر /var/lib/iranica-agent-state را بررسی کنید.
sudo ls -ld /var/lib/iranica-agent-state
sudo systemctl status iranica-agent-worker --no-pager
۱۱. سیستم گزارش done میدهد ولی مقصد خارجی تغییری نکرده است
ممکن است وضعیت Job بدون بررسی نتیجه واقعی API مقصد تغییر کرده باشد.
در طراحی Production، وضعیت موفق باید به نتیجه تأییدشده مقصد وابسته باشد. برای نتایج نامطمئن، وضعیت جداگانه reconciliation لازم است.
۱۲. Job چند بار عملیات پرداخت یا حذف را انجام داده است
این نشانه نبود Idempotency معتبر در مقصد یا استفاده نادرست از Retry است.
برای این عملیات، تکرار خودکار را متوقف کنید و وضعیت واقعی را از منبع معتبر بررسی کنید. سپس سازوکار شناسه یکتای عملیات و کنترل تکرار را اصلاح کنید.
۱۳. پس از Restore، دو Worker یک Job را اجرا میکنند
احتمالاً نسخه Restoreشده همزمان با پایگاه داده اصلی یا Workerهای قبلی فعال شده است.
قبل از Resume باید مالکیت Jobها و فعال نبودن اجرای دیگر بررسی شود. در معماری توزیعشده، Lease و Fencing اهمیت ویژهای دارند.
۱۴. سرویس systemd فعال است ولی هیچ Job پردازش نمیشود
وضعیت Worker، مسیر دیتابیس و محتوای صف را بررسی کنید. ممکن است Jobها waiting_approval یا failed باشند و هیچ Job با وضعیت queued وجود نداشته باشد.
سؤالات متداول درباره AI Agent Persistence
AI Agent Persistence چیست؟
روشی برای ذخیره پایدار تاریخچه، وضعیت گردش کار و اطلاعات موردنیاز Agent است تا پس از Restart یا Crash بتوان کار را پیگیری و در صورت امکان بازیابی کرد.
آیا Agent بعد از Restart VPS میتواند کار را ادامه دهد؟
بله، اگر وضعیت مراحل و دادههای ضروری در محل پایدار ذخیره شده باشند و برنامه منطق بازیابی مناسبی داشته باشد.
آیا ذخیره Session برای ادامه Job کافی است؟
خیر. Session معمولاً تاریخچه گفتگو را نگهداری میکند. برای ادامه گردش کار و کنترل عملیات نیمهتمام به Checkpoint و وضعیت Job نیز نیاز دارید.
Checkpoint در AI Agent چیست؟
نقطهای از پیشرفت کار است که پس از اتمام موفق یک مرحله ثبت میشود تا Worker بداند ادامه اجرا باید از کجا شروع شود.
RunState در OpenAI Agents SDK چه کاربردی دارد؟
برای ذخیره و بازیابی وضعیت اجرای Agent، از جمله اجرای متوقفشده در انتظار تأیید Tool، استفاده میشود.
آیا RunState تضمین Exactly Once میدهد؟
خیر. اگر Tool خارجی اجرا شده باشد اما نتیجه آن پیش از ذخیره Snapshot ثبت نشده باشد، ممکن است هنگام Resume دوباره اجرا شود.
آیا SQLite برای Agent دائمی مناسب است؟
برای پروژه کوچک، یک VPS و تعداد محدود Worker میتواند مناسب باشد. برای چند Worker توزیعشده معمولاً به دیتابیس و Queue اشتراکی نیاز دارید.
تفاوت SQLite و Redis برای Session چیست؟
SQLite ذخیرهسازی فایلمحور سادهای دارد؛ Redis برای دسترسی مشترک و سریع چند Worker مناسب است، اما پیکربندی دوام داده و سیاست نگهداری آن اهمیت دارد.
چه زمانی PostgreSQL انتخاب بهتری است؟
زمانی که به تراکنشهای بیشتر، Workerهای همزمان، قفلگذاری و معماری چندکاربره یا چندسروری نیاز دارید.
Idempotency-Key چیست؟
شناسهای ثابت برای یک درخواست منطقی است که به سیستم کمک میکند تلاشهای مجدد را از عملیات جدید تشخیص دهد.
آیا ارسال Idempotency-Key جلوی تمام تکرارها را میگیرد؟
خیر. مقصد باید آن را به شکل صحیح و اتمیک پشتیبانی کند. ارسال Header بهتنهایی کافی نیست.
Crash Recovery چیست؟
فرآیندی است که پس از توقف غیرمنتظره برنامه، وضعیت Jobها را بررسی میکند و کارهای قابلبازیابی را از مرحله مناسب دوباره فعال میکند.
Resume با Retry چه تفاوتی دارد؟
Resume معمولاً ادامه یک اجرای متوقفشده از وضعیت ذخیرهشده است؛ Retry تلاش مجدد برای عملیاتی است که نتیجه موفق آن ثبت نشده یا با خطا مواجه شده است.
آیا میتوان عملیات حساس را خودکار Retry کرد؟
فقط زمانی که سازوکار جلوگیری از اثر تکراری وجود داشته باشد یا وضعیت عملیات قبلی بهطور معتبر بررسی شده باشد.
اگر نتیجه عملیات خارجی نامشخص باشد چه کنیم؟
بهتر است از اجرای مجدد خودکار خودداری کنید و ابتدا Reconciliation با منبع معتبر انجام دهید.
Transactional Outbox چیست؟
الگویی است که پیام خروجی و تغییر وضعیت داخلی را در یک تراکنش ثبت میکند تا درخواست خروجی پس از Crash گم نشود.
آیا Outbox بهتنهایی Exactly Once است؟
خیر. مقصد همچنان ممکن است پیام را بیش از یک بار دریافت کند؛ بنابراین Deduplication یا Idempotency در سمت مقصد مهم است.
آیا برای Agent دائمی باید مدل همیشه فعال باشد؟
خیر. معمولاً Worker درخواستها را در زمان لازم پردازش میکند و وضعیت کار در دیتابیس باقی میماند.
آیا systemd برای پایداری Agent کافی است؟
systemd میتواند سرویس را دوباره اجرا کند، اما ذخیره State و جلوگیری از عملیات تکراری وظیفه معماری برنامه است.
آیا Agent میتواند چند روز منتظر تأیید بماند؟
بله. اگر وضعیت waiting_approval در محل پایدار ذخیره شود، برای انتظار نیازی به فعال ماندن همان فرآیند نیست.
تفاوت Temporal و LangGraph برای Persistence چیست؟
Temporal یک سیستم گردش کار پایدار مبتنی بر Event History است، درحالیکه LangGraph قابلیت Checkpoint و ادامه اجرای گردش کارهای Agentمحور را ارائه میکند.
آیا Background Mode در OpenAI جایگزین Job Queue است؟
خیر. این قابلیت برای درخواستهای غیرهمزمان مدل مفید است، اما مدیریت وضعیت کسبوکار، تأییدها و عملیات خارجی همچنان بر عهده برنامه است.
چگونه وضعیتهای ذخیرهشده را امن نگه داریم؟
با کنترل دسترسی به دیتابیس، احراز هویت کاربران، رمزنگاری در صورت نیاز، Backup محافظتشده و جلوگیری از ارسال Snapshot کامل به کلاینتهای غیرقابل اعتماد.
آیا میتوان چند Agent را روی یک VPS با Persistence اجرا کرد؟
بله. اما باید مالکیت Job، منابع CPU و RAM، دیتابیس و دسترسی همزمان به Sessionها و Checkpointها مدیریت شود.
جمعبندی
ساخت یک Agent هوش مصنوعی دائمی با AI Agent Persistence فقط به ذخیره پیامهای گفتگو محدود نمیشود. برای ادامه مطمئن کار بعد از Restart VPS باید مشخص باشد هر Job در چه مرحلهای قرار دارد، چه نتیجهای ذخیره شده، کدام عملیات تأیید شده و کدام اثر جانبی واقعاً انجام شده است.
در این آموزش با Python، OpenAI Agents SDK، SQLite و FastAPI یک گردش کار مرحلهای ساختیم که اطلاعات را آماده میکند، گزارش تولید میکند، برای تأیید متوقف میشود و سپس نتیجه را در یک تراکنش ثبت میکند.
همچنین دیدیم که Session برای حافظه گفتگو، Checkpoint برای پیشرفت Workflow و RunState برای ادامه بعضی اجراهای متوقفشده SDK به کار میروند. هیچکدام بهتنهایی جایگزین Idempotency و کنترل نتیجه عملیات خارجی نیستند.
برای پروژه کوچک، یک VPS به همراه Worker مستقل و SQLite میتواند نقطه شروع مناسبی باشد. با افزایش تعداد کاربران، ابزارها و سرورها، میتوانید به PostgreSQL، Queue مشترک یا سیستمهای گردش کار پایدار مانند Temporal و LangGraph مهاجرت کنید.
مهمترین اصل این است که Agent بعد از بازیابی، آخرین واقعیت ثبتشده را مبنای ادامه کار قرار دهد؛ نه صرفاً آخرین چیزی که مدل گفته است.
اگر هنوز خود Agent و ابزارهای آن را نساختهاید، ابتدا میتوانید راهنمای ساخت Agent روی VPS با OpenAI Agents SDK را مطالعه کنید. برای Agentهایی که در مرورگر کار میکنند نیز مقاله پیادهسازی AI Computer Use روی VPS به موضوع مدیریت مرورگر و عملیات حساس میپردازد.
منابع و مستندات رسمی
۱. OpenAI Agents SDK — Sessions
روشهای نگهداری تاریخچه گفتگو با SQLite، Redis و سایر Session Backendها.
۲. OpenAI Agents SDK — Human-in-the-loop
روش توقف اجرای Agent، ذخیره وضعیت تأییدها و ادامه اجرا پس از دریافت تصمیم معتبر.
۳. OpenAI Agents SDK — RunState Reference
مرجع توابع to_json، from_json و ذخیره وضعیت اجرایی Agent.
۴. OpenAI Agents SDK — Running Agents
توضیح روشهای مختلف نگهداری زمینه گفتگو و ادامه Run.
۵. OpenAI Agents SDK — SQLAlchemySession
استفاده از PostgreSQL، SQLite و سایر دیتابیسهای سازگار برای Session Persistence.
۶. OpenAI API — Background Mode
اجرای غیرهمزمان درخواستهای مدل و بازیابی نتیجه با شناسه پاسخ.
۷. Temporal — Workflows
نحوه بازیابی وضعیت گردش کار با Event History و Replay.
۸. Temporal — Activity Idempotency
توضیح اهمیت Idempotency و Retry ایمن در عملیات دارای اثر جانبی.
مستندات رسمی Temporal Activities
۹. LangGraph — Persistence
مفاهیم Checkpointer، Store، بازیابی گردش کار و ادامه اجرا.
۱۰. SQLite — Write-Ahead Logging
توضیح WAL، همزمانی، دوام داده و محدودیتهای فایلسیستم.
۱۱. SQLite — Transactions
مرجع رسمی تراکنشهای اتمیک و روشهای Commit و Rollback.
۱۲. systemd — Service Management
راهنمای مدیریت Worker، سیاست Restart و اجرای سرویس روی Linux.
۱۳. OpenAI Agents SDK — Releases
مرجع انتشار نسخههای SDK و بررسی تغییرات مرتبط با RunState و Sessions.
دیدگاهها (۰)