
 Amir Jabbari
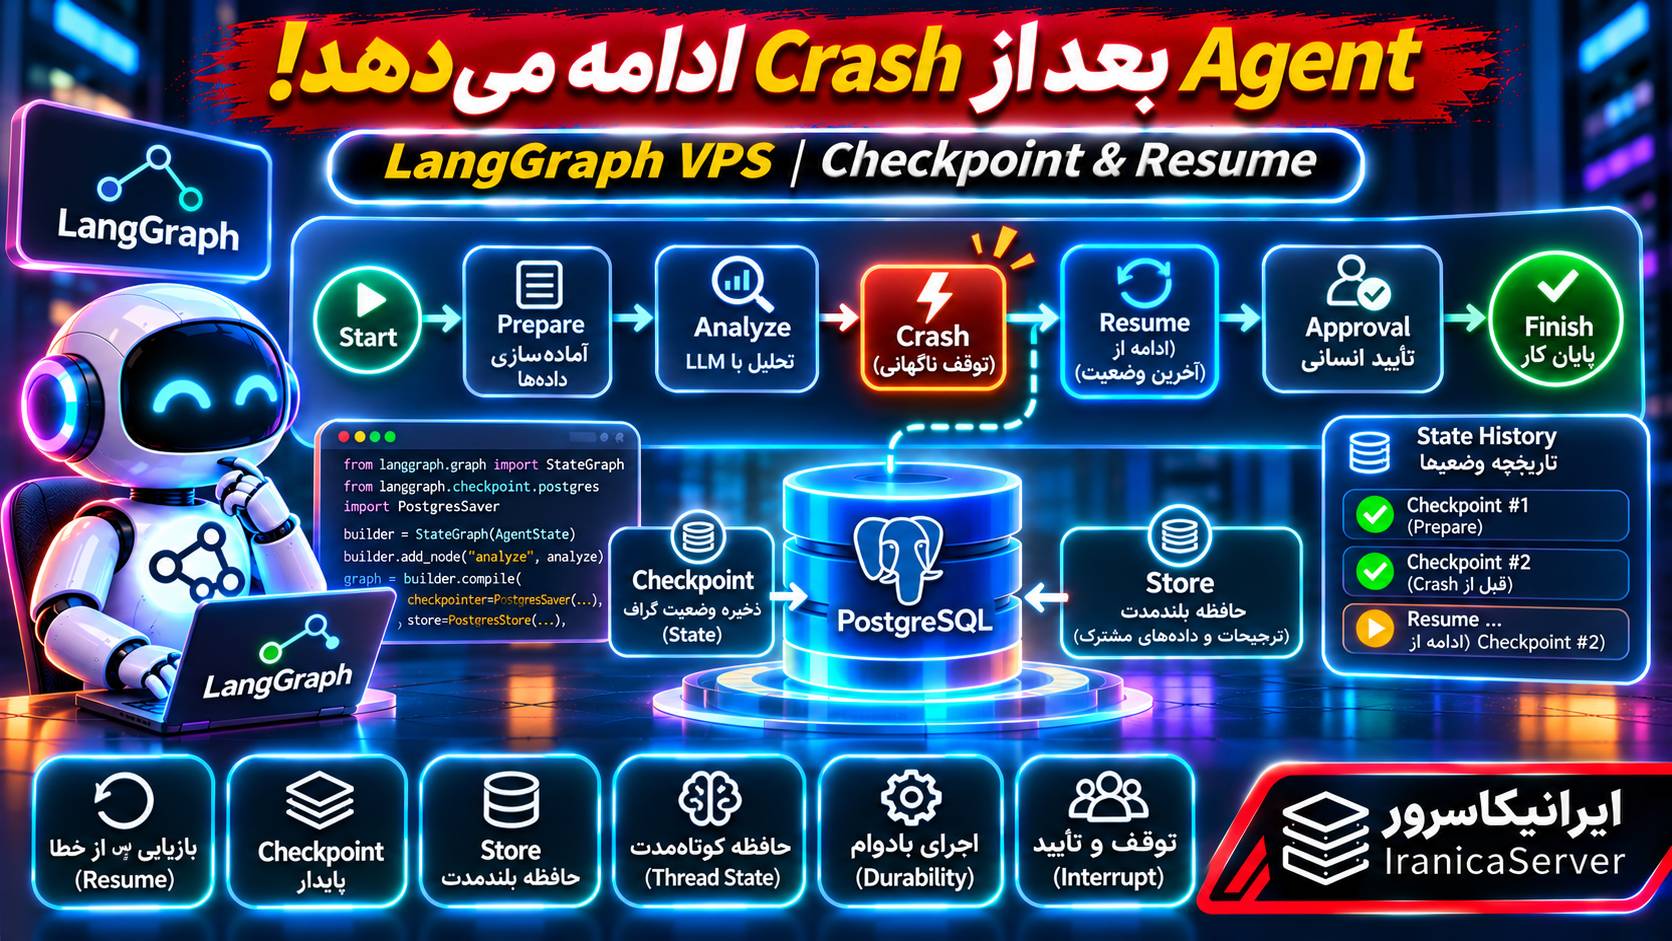
این یکی از مشکلات اصلی سیستمهای هوش مصنوعی چندمرحلهای است. اگر وضعیت اجرای Agent فقط در حافظه RAM قرار داشته باشد، بسته شدن فرآیند میتواند باعث از دست رفتن اطلاعات گردش کار شود. از طرف دیگر، ذخیره تاریخچه گفتگو بهتنهایی کافی نیست؛ برنامه باید بداند کدام مرحله کامل شده، کدام مرحله در حال اجرا بوده و آیا عملیات حساس واقعاً انجام شده است یا خیر.
LangGraph فریمورکی برای ساخت گردش کارهای Stateful و Agentهای هوش مصنوعی است که قابلیتهایی مانند Checkpoint، Durable Execution، Human-in-the-Loop و مدیریت حافظه را فراهم میکند.
با استفاده از LangGraph میتوان وضعیت اجرای یک Agent را در دیتابیس ذخیره کرد تا در صورت توقف برنامه، گردش کار از آخرین Checkpoint معتبر ادامه پیدا کند. همچنین میتوان اطلاعات ماندگار مانند ترجیحات کاربر یا دادههای مشترک را جدا از وضعیت هر گفتگو نگهداری کرد.
در این آموزش، پیادهسازی LangGraph روی VPS را با Ubuntu 24.04، Python و PostgreSQL بررسی میکنیم. ابتدا تفاوت Checkpointer و Store را توضیح میدهیم، سپس یک Agent آزمایشی میسازیم که وضعیت خود را در PostgreSQL ذخیره میکند، هنگام اجرای یک Node عمداً خطا میدهد و پس از اجرای مجدد برنامه از مرحله معتبر قبلی ادامه پیدا میکند.
در ادامه نیز حافظه کوتاهمدت و بلندمدت، مفهوم thread_id، روش Resume، تفاوت Interrupt و Crash، انتخاب حالت Durability، جلوگیری از عملیات تکراری، Backup دیتابیس و نکات مهم استقرار عملیاتی را بررسی خواهیم کرد.
LangGraph چیست و چه تفاوتی با یک Agent معمولی دارد؟
LangGraph یک فریمورک برای ساخت برنامههای مبتنی بر گراف و گردش کارهای دارای State است. در این معماری، هر مرحله میتواند بهصورت یک Node تعریف شود و ارتباط میان مراحل توسط Edgeها مشخص میشود.
برای مثال، یک Agent گزارشساز ممکن است از چهار مرحله تشکیل شده باشد:
- آمادهسازی اطلاعات.
- تحلیل داده توسط مدل هوش مصنوعی.
- دریافت تأیید انسانی.
- ثبت نتیجه نهایی.
در برنامه معمولی، این مراحل ممکن است پشت سر هم داخل یک تابع Python اجرا شوند. اما در LangGraph میتوان State مشترک مراحل را تعریف کرد و با استفاده از Checkpointer، وضعیت اجرای گراف را در نقاط مشخص ذخیره کرد.
StateGraph چیست؟
StateGraph یکی از ساختارهای اصلی LangGraph است. این کلاس امکان تعریف State، Nodeها و ارتباط میان آنها را فراهم میکند.
ساختار مفهومی یک گردش کار ساده:
START
  |
Prepare Data
  |
Analyze
  |
Human Approval
  |
Finalize
  |
 END
هر Node معمولاً بخشی از State را دریافت میکند و تغییرات همان State را برمیگرداند.
آیا LangGraph فقط برای برنامههای دارای LLM است؟
خیر. میتوان بخشهایی از یک گراف را با منطق قطعی Python اجرا کرد و فقط مراحل لازم را به مدل هوش مصنوعی سپرد.
این ویژگی برای پروژههایی مفید است که باید میان تصمیمگیری مدل و کنترل قابل پیشبینی برنامه تفاوت قائل شوند.
چه زمانی استفاده از LangGraph منطقی است؟
برای یک درخواست ساده به مدل که فقط یک پاسخ متنی تولید میکند، استفاده از LangGraph همیشه ضروری نیست.
اما برای گردش کارهای طولانی، چندمرحلهای و قابلبازیابی میتواند مزیت داشته باشد.
| نوع پروژه | کاربرد LangGraph |
|---|---|
| Agent پشتیبانی | حفظ Context گفتگو و پیگیری مراحل |
| تحلیل اسناد | ذخیره نتیجه پردازش مراحل مختلف |
| Agent گزارشساز | توقف برای تأیید و ادامه اجرا |
| دستیار مدیریت VPS | ردیابی مراحل و کنترل عملیات حساس |
| اتوماسیون چندAgent | هماهنگی Nodeها و مسیرهای شرطی |
| گردش کار طولانی | Checkpoint، Replay و بازیابی |
اگر تنها هدفتان حفظ تاریخچه پیامهای کاربر است، یک Session Database معمولی ممکن است نیاز شما را برطرف کند. اما اگر میخواهید بدانید کدام مرحله از یک فرآیند کامل شده و چگونه از نقطه ذخیرهشده ادامه پیدا کند، LangGraph ارزش بیشتری پیدا میکند.
معماری اجرای LangGraph روی VPS چگونه است؟
در این آموزش برنامه Python و PostgreSQL روی یک VPS اجرا میشوند. مدل هوش مصنوعی از طریق API فراخوانی میشود و نیازی به اجرای محلی مدل نیست.
معماری پیشنهادی:
User / Application
        |
   LangGraph App
        |
     StateGraph
        |
  +-----+-------+
  |             |
Checkpointer   Store
  |             |
Thread State   Long-term Memory
  |             |
  +------ PostgreSQL
        |
Resume / Recovery
در این معماری، Checkpointer و Store میتوانند از یک PostgreSQL استفاده کنند؛ اما نقش و شیوه دسترسی متفاوتی دارند.
برنامه نمونه شامل مرحله Prepare، مرحله Analyze، مرحله Approval و مرحله Finalize است.
در حالت آزمایشی، هیچ تغییر واقعی روی سرور یا سرویس خارجی انجام نمیشود. هدف این است که رفتار Checkpoint و بازیابی بهصورت ایمن بررسی شود.
Persistence در LangGraph چگونه کار میکند؟
Persistence در LangGraph به ذخیره وضعیت گراف و دادههای ماندگار برنامه گفته میشود.
در این معماری دو مفهوم اصلی داریم:
- Checkpointer: برای نگهداری State و تاریخچه اجرای یک Thread.
- Store: برای ذخیره اطلاعات مستقل از Thread و قابل استفاده میان اجراهای مختلف.
این دو بخش مکمل یکدیگر هستند؛ نه اینکه یکی جایگزین دیگری باشد.
یک مثال ساده
فرض کنید کاربر در یک گفتگو درخواست تهیه گزارش داده است. وضعیت جاری این درخواست باید داخل Checkpointer ذخیره شود.
همان کاربر ترجیح میدهد تمام گزارشها به زبان فارسی و بهصورت کوتاه نوشته شوند. این ترجیح ممکن است برای گفتگوهای آینده نیز مفید باشد؛ بنابراین میتوان آن را داخل Store ذخیره کرد.
اگر کاربر فردا با یک thread_id جدید گفتگو کند، State گفتگوی قبلی بهصورت خودکار به گفتگوی جدید منتقل نمیشود؛ اما برنامه میتواند ترجیح ذخیرهشده در Store را دوباره بخواند.
Checkpointer در LangGraph چیست؟
Checkpointer وضعیت گراف را در مرزهای اجرای مشخص ذخیره میکند.
در LangGraph، این مرزها معمولاً با مفهوم Super-step مرتبط هستند. پس از تکمیل مرحله مناسب، یک Snapshot از State ذخیره میشود.
مثال وضعیت ذخیرهشده
{
  "user_id": "demo-user",
  "task": "Analyze demo VPS",
  "facts": "Service: online",
  "report": null
}
در این مثال، اطلاعات آمادهسازی ذخیره شدهاند، اما مرحله تولید گزارش هنوز کامل نشده است.
اگر برنامه در مرحله Analyze متوقف شود، میتوان پس از بازیابی به دادههای ذخیرهشده مرحله قبل دسترسی داشت.
InMemorySaver و PostgresSaver چه تفاوتی دارند؟
| Checkpointer | محل ذخیره | مناسب برای |
|---|---|---|
| InMemorySaver | RAM فرآیند | تست و توسعه |
| SqliteSaver | فایل SQLite | پروژه سبک و توسعه |
| AsyncSqliteSaver | فایل SQLite با API غیرهمزمان | توسعه و نمونههای Async |
| PostgresSaver | PostgreSQL | اجرای پایدار با دیتابیس |
| AsyncPostgresSaver | PostgreSQL | برنامههای Async و سرویسهای عملیاتی |
در این مقاله از PostgresSaver استفاده میکنیم تا Checkpointها بعد از پایان فرآیند Python نیز باقی بمانند.
آیا Checkpoint دقیقاً در همان خطی که برنامه Crash کرده ذخیره میشود؟
خیر. در حالت معمول، بازیابی از مرز معتبر Checkpoint انجام میشود، نه لزوماً از همان خط Python که هنگام خطا در حال اجرا بوده است.
اگر Node در میانه اجرای خود متوقف شود، ممکن است هنگام بازیابی از ابتدای همان Node اجرا شود.
در گرافهایی که چند Node موازی در یک Super-step دارند، LangGraph میتواند Writeهای موفق بعضی Nodeها را نیز برای بازیابی ذخیره کند. بااینحال، این رفتار نباید با تضمین اجرای دقیقاً یکباره تمام اثرهای خارجی اشتباه گرفته شود.
Store چیست و چه تفاوتی با Checkpointer دارد؟
Store برای نگهداری اطلاعات ماندگار در خارج از State یک Thread طراحی شده است.
برای مثال، میتوان ترجیحات کاربر، اطلاعات مشترک یا دادههایی را که باید در گفتگوهای آینده استفاده شوند در Store ذخیره کرد.
ساختار Namespace و Key
Store معمولاً با یک Namespace و یک Key کار میکند.
مثال:
Namespace:
("users", "demo-user", "preferences")

Key:
"style"

Value:
{"style": "پاسخ کوتاه و دقیق"}
این داده میتواند توسط Threadهای مختلف همان کاربر خوانده شود.
آیا Store همان Vector Database است؟
خیر. Store یک رابط ذخیرهسازی داده است و میتواند بدون جستوجوی برداری نیز استفاده شود.
برای جستوجوی معنایی و Embedding ممکن است به تنظیمات اضافی مانند Index و pgvector نیاز داشته باشید. در پروژه این مقاله فقط از ذخیره و بازیابی معمولی استفاده میکنیم.
آیا میتوان تمام گفتگوها را در Store ذخیره کرد؟
از نظر فنی میتوان دادههای زیادی را در Store نگهداری کرد، اما بهتر است میان تاریخچه گفتگو، وضعیت اجرای گراف و اطلاعات بلندمدت تفاوت مشخصی وجود داشته باشد.
برای مدیریت Context گفتگو، Checkpointer معمولاً انتخاب طبیعیتری است.
thread_id چیست و چرا برای Resume ضروری است؟
هر گردش کار قابلبازیابی در LangGraph به یک شناسه Thread نیاز دارد.
این شناسه به Checkpointer کمک میکند وضعیت ذخیرهشده همان گردش کار را پیدا کند.
ساختار Config:
config = {
    "configurable": {
        "thread_id": "demo-thread-01"
    }
}
برای ادامه همان گردش کار باید همین Thread ID استفاده شود.
اگر Thread ID تغییر کند چه میشود؟
Checkpointer درخواست را به یک Thread دیگر نسبت میدهد و نمیتواند صرفاً با شناسه جدید، وضعیت Thread قبلی را بازیابی کند.
آیا Thread ID همان User ID است؟
خیر. ممکن است یک کاربر چند گردش کار یا چند گفتگو داشته باشد. User ID هویت یا مالکیت کاربر را نشان میدهد، اما Thread ID شناسه یک مسیر اجرایی است.
در سرویس چندکاربره، باید مالکیت Thread در Backend بررسی شود. داشتن یک Thread ID بهتنهایی نباید اجازه مشاهده یا Resume اطلاعات کاربر دیگر را ایجاد کند.
تفاوت durability=’sync’، ‘async’ و ‘exit’ در LangGraph
LangGraph چند حالت برای نحوه ذخیره Checkpointها فراهم میکند.
| حالت | رفتار اصلی | ملاحظه |
|---|---|---|
| sync | ذخیره همزمان Checkpoint پیش از ادامه مرحله بعد | دوام بیشتر با سربار نوشتن دیتابیس |
| async | ذخیره غیرهمزمان هنگام ادامه اجرا | ممکن است آخرین وضعیت در Crash از دست برود |
| exit | ذخیره هنگام پایان یا خروج از اجرای گراف | برای بازیابی خطا در میانه اجرای طولانی محدودتر است |
برای نمونه آموزشی که هدف اصلی آن بررسی بازیابی است، از sync استفاده میکنیم.
نمونه اجرای گراف با دوام همزمان
result = graph.invoke(
    input_data,
    config,
    durability="sync",
)
این تنظیم کمک میکند Checkpoint معتبر پیش از رفتن به مرحله بعدی در محل ذخیرهسازی ثبت شود.
البته دوام واقعی داده همچنان به سلامت PostgreSQL، تنظیمات دیسک و زیرساخت ذخیرهسازی نیز وابسته است.
پیشنیازهای اجرای LangGraph روی VPS
برای این آموزش از Ubuntu 24.04 و PostgreSQL استفاده میکنیم.
اجرای مدل از طریق API انجام میشود؛ بنابراین برای نمونه فعلی به GPU اختصاصی نیاز نداریم.
| سناریو | RAM اولیه پیشنهادی | CPU اولیه پیشنهادی |
|---|---|---|
| آزمایش و یک Agent | ۲ گیگابایت | ۱ تا ۲ vCPU |
| Agent همراه PostgreSQL و چند Job | ۴ گیگابایت | ۲ vCPU |
| چند Worker و حافظه گسترده | ۸ گیگابایت یا بیشتر | ۴ vCPU یا بیشتر |
| سامانه پرترافیک | طبق تست بار | طبق تعداد Workerها |
این مقادیر برآورد اولیه هستند و حداقل رسمی LangGraph محسوب نمیشوند. برای اجرای مدل محلی، پردازش فایلهای حجیم یا تعداد زیادی Worker ممکن است منابع بیشتری نیاز باشد.
مرحله اول: نصب PostgreSQL روی Ubuntu 24.04
در این آموزش PostgreSQL روی همان VPS نصب میشود و اتصال برنامه از طریق Unix Socket محلی انجام خواهد شد.
این روش برای یک نمونه تکسروری ساده است و نیازی ندارد پورت دیتابیس را در اینترنت باز کنید.
نصب PostgreSQL
sudo apt update

sudo apt install -y \
postgresql \
postgresql-contrib \
python3 \
python3-venv \
python3-pip
بررسی سرویس
sudo systemctl status postgresql --no-pager

pg_lsclusters
در Ubuntu ممکن است سرویس postgresql یک واحد کلی برای مدیریت Clusterها باشد. دستور pg_lsclusters وضعیت Cluster واقعی را نشان میدهد.
ایجاد کاربر اختصاصی Linux
sudo useradd --system --create-home \
--home-dir /opt/iranica-langgraph \
--shell /usr/sbin/nologin langgraph_app
این دستور برای نصب جدید است. اگر کاربر langgraph_app از قبل وجود دارد، نباید آن را بدون بررسی دوباره ایجاد کنید.
ایجاد Role و Database
sudo -u postgres createuser langgraph_app

sudo -u postgres createdb \
--owner=langgraph_app langgraph_app
در این روش فرض میکنیم PostgreSQL از احراز هویت Peer برای اتصال محلی پشتیبانی میکند؛ در نصب استاندارد Ubuntu معمولاً چنین تنظیمی برای اتصال Unix Socket وجود دارد.
حساب Linux و Role دیتابیس هر دو langgraph_app نام دارند.
تست دسترسی به دیتابیس
sudo -u langgraph_app psql \
-d langgraph_app \
-c 'SELECT current_user, current_database();'
اگر اتصال موفق باشد، نام کاربر و دیتابیس نمایش داده میشوند.
آدرس اتصال پروژه
DATABASE_URL=postgresql:///langgraph_app?host=/var/run/postgresqlاین آدرس برای اتصال محلی با Unix Socket است. اگر PostgreSQL روی میزبان دیگری قرار دارد، باید تنظیمات اتصال، TLS و احراز هویت آن جداگانه طراحی شوند.
مرحله دوم: نصب LangGraph و کتابخانههای Python
ایجاد محیط مجازی
sudo -u langgraph_app python3 -m venv \
/opt/iranica-langgraph/.venv
نصب بستهها
نسخههای اصلی نمونه بهصورت مشخص انتخاب شدهاند تا بازتولید پروژه سادهتر شود.
sudo -u langgraph_app \
/opt/iranica-langgraph/.venv/bin/python \
-m pip install --upgrade pip

sudo -u langgraph_app \
/opt/iranica-langgraph/.venv/bin/python \
-m pip install \
"langgraph==1.2.19" \
"langgraph-checkpoint-postgres==3.2.0" \
"psycopg[binary,pool]>=3.2,<4" \ "langchain-openai>=1.0,<2"
پس از نصب، برای استقرار Production بهتر است تمام نسخههای غیرمستقیم را نیز قفل و نتیجه را با pip check بررسی کنید.
بررسی سازگاری بستهها
sudo -u langgraph_app \
/opt/iranica-langgraph/.venv/bin/python \
-m pip checkآمادهسازی مسیر فایلهای آزمایشی
sudo install -d \
-o langgraph_app -g langgraph_app -m 750 \
/var/lib/iranica-langgraph/markers
این مسیر برای ثبت یک نشانگر خطای آزمایشی استفاده میشود و بخشی از Checkpointer اصلی LangGraph نیست.
مرحله سوم: ساخت Agent با Checkpointer و Store در PostgreSQL
پروژه عملی این مقاله شامل سه فایل است:
| فایل | کاربرد |
|---|---|
| agent.py | تعریف گراف، Memory، Checkpoint و فرمانهای اجرا |
| requirements.txt | وابستگیهای Python |
| README.md | راهنمای اجرا و تست بازیابی |
فایل agent.py در بسته سورس همراه مقاله قرار دارد. در ادامه بخشهای اصلی آن را بررسی میکنیم.
تعریف State
from typing import TypedDict

class AgentState(TypedDict, total=False):
    user_id: str
    task: str
    preference: str
    facts: str
    report: str
    approved: bool
    outcome: str
در این ساختار، اطلاعات مربوط به درخواست، دادههای آمادهشده، گزارش و نتیجه تأیید داخل State قرار میگیرند.
تعریف مرحله Prepare و خواندن حافظه بلندمدت
from langgraph.runtime import Runtime

def prepare(state: AgentState, runtime: Runtime) -> dict:
    item = runtime.store.get(
        ("users", state["user_id"], "preferences"),
        "style",
    )

    style = (
        item.value["style"]
        if item
        else "مختصر و دقیق"
    )

    return {
        "preference": style,
        "facts": (
            "سرویس آزمایشی demo-vps-01: "
            "online; players=4"
        ),
    }
این Node ترجیح ذخیرهشده کاربر را از Store میخواند و اطلاعات ثابت آزمایشی را به State اضافه میکند.
در اجرای واقعی، اطلاعات باید از یک Backend معتبر و با کنترل مجوز دریافت شوند.
تعریف مرحله Analyze
در نمونه کامل، Node تحلیل دو حالت دارد:
- حالت Offline برای تست Checkpoint بدون مصرف API.
- حالت واقعی که با ChatOpenAI گزارش تولید میکند.
بخش اصلی فراخوانی مدل:
from langchain_openai import ChatOpenAI

model = ChatOpenAI(
    model=os.getenv(
        "OPENAI_MODEL",
        "gpt-4.1-mini",
    ),
    timeout=30,
    max_retries=0,
)

response = model.invoke([
    (
        "system",
        "فقط براساس داده آزمایشی گزارش کوتاه فارسی بنویس.",
    ),
    (
        "human",
        f"درخواست: {state['task']}\n"
        f"داده: {state['facts']}\n"
        f"سبک: {state['preference']}",
    ),
])

report = str(response.content)
این بخش در تابع analyze پروژه قرار دارد. حالت Offline بدون API Key، یک گزارش متنی ثابت و مبتنی بر دادههای آزمایشی تولید میکند.
تعریف مرحله تأیید
from langgraph.types import interrupt

def approval(state: AgentState) -> dict:
    decision = interrupt({
        "action": "approve_demo_report",
        "report": state["report"],
    })

    if type(decision) is not bool:
        raise ValueError("Invalid approval value")

    return {"approved": decision}
این Node در یک نقطه مشخص متوقف میشود و منتظر مقدار Resume خواهد ماند.
در این نمونه، تأیید فقط نتیجه یک گزارش آزمایشی را تغییر میدهد و هیچ عملیات مدیریتی واقعی اجرا نمیشود.
ساخت Graph و اتصال Nodeها
from langgraph.graph import StateGraph, START, END

builder = StateGraph(AgentState)

builder.add_node("prepare", prepare)
builder.add_node("analyze", analyze)
builder.add_node("approval", approval)
builder.add_node("finish", finish)
builder.add_node("rejected", rejected)

builder.add_edge(START, "prepare")
builder.add_edge("prepare", "analyze")
builder.add_edge("analyze", "approval")

builder.add_conditional_edges(
    "approval",
    route_after_approval,
    {
        "finish": "finish",
        "rejected": "rejected",
    },
)

builder.add_edge("finish", END)
builder.add_edge("rejected", END)
توابع finish، rejected و route_after_approval نیز در سورس کامل پروژه تعریف شدهاند.
اتصال PostgreSQL Checkpointer و Store
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.store.postgres import PostgresStore

DB_URI = (
    "postgresql:///langgraph_app"
    "?host=/var/run/postgresql"
)

with (
    PostgresStore.from_conn_string(DB_URI) as store,
    PostgresSaver.from_conn_string(DB_URI) as checkpointer,
):
    store.setup()
    checkpointer.setup()

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )
فراخوانی setup برای ایجاد جدولها و اجرای Migrationهای اولیه لازم است. در نسخه عملی، فرمان init این کار را انجام میدهد.
در یک سرویس دائمی بهتر است عملیات Migration را در مرحله Deploy انجام دهید، نه اینکه برای هر درخواست کاربر اجرا شود.
مرحله چهارم: اجرای پروژه LangGraph روی VPS
ابتدا فایلهای پروژه را در مسیر /opt/iranica-langgraph قرار دهید و مالکیت آنها را تنظیم کنید.
سپس دستور Initialize را اجرا کنید:
cd /opt/iranica-langgraph

sudo -u langgraph_app \
.venv/bin/python agent.py init
اگر اتصال PostgreSQL برقرار باشد، جدولهای لازم برای Store و Checkpointer آماده میشوند.
ذخیره یک ترجیح بلندمدت
sudo -u langgraph_app \
.venv/bin/python agent.py remember \
--user demo-user \
--style 'پاسخ کوتاه و دقیق'
این مقدار داخل PostgresStore ذخیره میشود و میتواند برای Threadهای مختلف همین کاربر استفاده شود.
ایجاد یک Thread جدید در حالت Offline
sudo -u langgraph_app env DEMO_OFFLINE=1 \
.venv/bin/python agent.py start \
--thread demo-thread-01 \
--user demo-user \
--task 'گزارش وضعیت سرویس آزمایشی'
برنامه State را ایجاد میکند، اطلاعات آزمایشی را آماده میکند، یک گزارش تولید میکند و هنگام رسیدن به Node تأیید متوقف میشود.
مشاهده وضعیت ذخیرهشده
sudo -u langgraph_app \
.venv/bin/python agent.py status \
--thread demo-thread-01
خروجی شامل State ذخیرهشده و اطلاعات مرحله بعدی خواهد بود.
مرحله پنجم: شبیهسازی Crash و ادامه کار از Checkpoint
در این قسمت رفتار بازیابی را آزمایش میکنیم.
برای اینکه آزمایش به API Key وابسته نباشد، حالت Offline فعال میماند. همچنین یک گزینه آموزشی داریم که در اولین اجرای Node تحلیل برای هر Thread، خطای عمدی ایجاد میکند.
اجرای گردش کار دارای خطای عمدی
sudo -u langgraph_app env \
DEMO_OFFLINE=1 \
DEMO_FAIL_ONCE=1 \
.venv/bin/python agent.py start \
--thread crash-demo-01 \
--user demo-user \
--task 'گزارش آزمایشی بعد از خطا'
انتظار داریم برنامه در مرحله Analyze با RuntimeError آزمایشی متوقف شود.
این خطا عمدی است و نشان میدهد اجرای یک Node پیش از تکمیل قطع شده است.
آیا Checkpoint قبلی ذخیره شده است؟
از آنجا که گراف با durability=”sync” اجرا میشود، مرحله Prepare باید پیش از ورود به Analyze ثبت شده باشد.
میتوانید وضعیت Thread را بررسی کنید:
sudo -u langgraph_app \
.venv/bin/python agent.py status \
--thread crash-demo-01
ادامه گردش کار در یک فرآیند جدید
sudo -u langgraph_app env DEMO_OFFLINE=1 \
.venv/bin/python agent.py resume \
--thread crash-demo-01
در این مرحله LangGraph وضعیت Thread را از PostgreSQL میخواند و مرحله Analyze که کامل نشده بود دوباره اجرا میشود.
این آزمایش نشان میدهد برای ادامه کار، لازم نیست همان فرآیند Python قبلی همچنان فعال باشد.
تفاوت Crash واقعی با خطای آزمایشی
در مثال حاضر، خطای عمدی از نوع Exception است؛ بنابراین به معنی قطع برق یا خرابی سیستمعامل نیست.
اما هر دو سناریو برای بازیابی به Checkpoint ذخیرهشده وابسته هستند. برای تأیید دوام عملیاتی، باید آزمون توقف غیرمنتظره فرآیند و Restart VPS نیز در محیط آزمایشی انجام شود.
آیا LangGraph تمام کارهای Node قبلی را ذخیره میکند؟
خیر. اگر Analyze وسط فراخوانی مدل متوقف شده باشد و خروجی آن ثبت نشده باشد، ممکن است فراخوانی مدل در اجرای مجدد تکرار شود.
به همین دلیل برای عملیات خارجی، باید علاوه بر Checkpoint از Idempotency و ثبت نتیجه معتبر استفاده شود.
مرحله ششم: توقف Agent و Resume با Command
توقف برای تأیید انسانی با Crash تفاوت دارد.
در Crash، اجرای Node به شکل غیرمنتظره قطع میشود. اما در Human-in-the-Loop، برنامه عمداً در یک نقطه مشخص متوقف میشود و منتظر ورودی میماند.
تأیید یک اجرای معلق
پس از رسیدن Thread به مرحله Approval، میتوانید از CLI مورد اعتماد درخواست را تأیید کنید:
sudo -u langgraph_app \
.venv/bin/python agent.py approve \
--thread crash-demo-01 --yes
یا برای رد درخواست:
sudo -u langgraph_app \
.venv/bin/python agent.py approve \
--thread demo-thread-01 --no
Command(resume=…) چه کاری انجام میدهد؟
در کد Python، ادامه یک Interrupt با ساختار زیر انجام میشود:
from langgraph.types import Command

result = graph.invoke(
    Command(resume=True),
    config,
    durability="sync",
)
مقدار Resume به همان interrupt در Node بازگردانده میشود.
نکته مهم درباره اجرای مجدد Node
هنگام Resume یک Interrupt، اجرای Node مربوطه از ابتدای آن شروع میشود و مقدار Resume در نقطه interrupt استفاده میشود.
بنابراین بهتر است قبل از interrupt عملیات غیرقابل تکرار انجام ندهید یا آن عملیات را بهصورت مستقل و ضدتکرار طراحی کنید.
در مثال ما، Node تأیید فقط داده را بررسی میکند و هیچ اثر خارجی ندارد.
آیا این مثال یک سیستم تأیید امن برای کاربران عمومی است؟
خیر. CLI پروژه برای یک اپراتور مورد اعتماد طراحی شده است.
اگر بخواهید قابلیت تأیید را از طریق وبسایت در اختیار کاربران قرار دهید، باید احراز هویت، کنترل مالکیت Thread، مجوز تأییدکننده، انقضا و Audit مستقل اضافه کنید.
روش طراحی این کنترلها در مقاله ساخت Human-in-the-Loop برای AI Agent بررسی شده است.
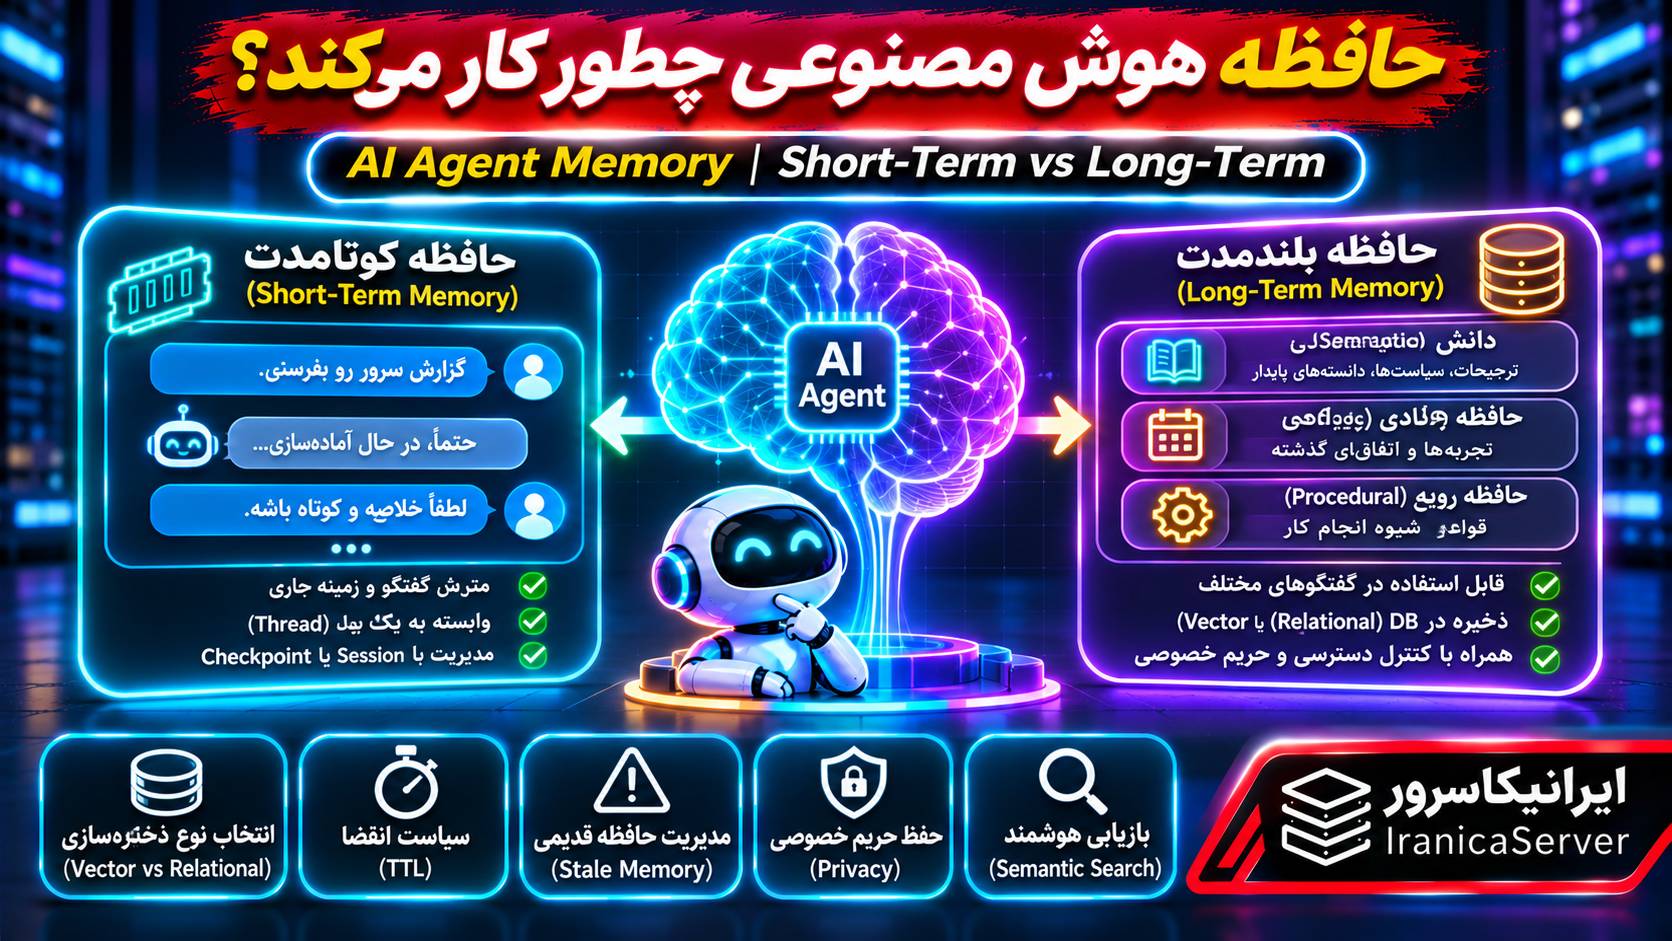
حافظه کوتاهمدت و بلندمدت در LangGraph چگونه پیاده میشوند؟
یکی از ویژگیهای مهم LangGraph، تفکیک حافظه یک گفتگو از اطلاعات ماندگار کاربر است.
حافظه کوتاهمدت یا Short-term Memory
حافظه کوتاهمدت در محدوده Thread نگهداری میشود.
برای یک Agent گفتگو، میتوان پیامها و وضعیت لازم را در State تعریف کرد و Checkpointer آنها را برای Thread مربوطه نگهداری کند.
اگر همان Thread در اجرای بعدی استفاده شود، برنامه میتواند اطلاعات ذخیرهشده را بازیابی کند.
حافظه بلندمدت یا Long-term Memory
حافظه بلندمدت اطلاعاتی است که مستقل از یک Thread مشخص نگهداری میشود.
برای مثال، ترجیح زبان پاسخ یا تنظیمات شخصی یک کاربر میتواند در Store باقی بماند.
ذخیره حافظه با PostgresStore
store.put(
    ("users", "demo-user", "preferences"),
    "style",
    {"style": "پاسخ کوتاه و دقیق"},
)
خواندن حافظه
item = store.get(
    ("users", "demo-user", "preferences"),
    "style",
)

if item:
    print(item.value)
در نمونه عملی، همین اطلاعات از طریق Runtime در Node Prepare خوانده میشوند.
تست حافظه در دو Thread متفاوت
ابتدا یک ترجیح برای demo-user ذخیره کنید. سپس دو اجرای مجزا با Thread IDهای متفاوت و همان User ID ایجاد کنید.
هر دو گردش کار باید بتوانند همان ترجیح را از Store دریافت کنند؛ درحالیکه وضعیت Checkpoint هر Thread مستقل باقی میماند.
آیا همه اطلاعات باید تا ابد ذخیره شوند؟
خیر. برای دادههای شخصی، تاریخچه گفتگو و Checkpointها باید سیاست نگهداری، حذف و حداقلسازی داده وجود داشته باشد.
همچنین اگر State شامل تصاویر، فایلهای بزرگ یا خروجی حجیم API است، بهتر است بهجای ذخیره تمام محتوا در هر Checkpoint، از شناسه یا ارجاع به محل ذخیرهسازی مناسب استفاده کنید.
چگونه تاریخچه Checkpointها را مشاهده کنیم؟
LangGraph امکان بررسی State فعلی و تاریخچه وضعیت یک Thread را فراهم میکند.
دریافت State فعلی
snapshot = graph.get_state(config)

print(snapshot.values)
print(snapshot.next)
مقدار values وضعیت ذخیرهشده و next اطلاعات مراحل برنامهریزیشده بعدی را نشان میدهد.
نمایش تاریخچه
for snapshot in graph.get_state_history(config):
    print(snapshot.metadata)
    print(snapshot.next)
در پروژه عملی، فرمان زیر تاریخچه را نمایش میدهد:
sudo -u langgraph_app \
.venv/bin/python agent.py history \
--thread crash-demo-01
Time Travel در LangGraph چیست؟
LangGraph امکان مراجعه به وضعیتهای تاریخی گراف و اجرای مجدد از Checkpointهای مشخص را نیز فراهم میکند.
این قابلیت برای Debugging و آزمایش مسیرهای جایگزین مفید است؛ اما اجرای دوباره از وضعیت گذشته ممکن است باعث اجرای مجدد بعضی Nodeها یا Toolها شود.
بنابراین Time Travel نباید بدون کنترل Idempotency روی عملیات حساس مالی یا مدیریتی استفاده شود.
Checkpoint چگونه از اجرای دوباره عملیات جلوگیری میکند؟
Checkpoint به بازیابی وضعیت کمک میکند، اما تضمین نمیکند تمام عملیات خارجی فقط یک بار اجرا شوند.
فرض کنید یک Node از طریق API درخواست Restart یک سرویس را ارسال میکند.
ممکن است API عملیات را انجام دهد، اما فرآیند Python قبل از ثبت Checkpoint بعدی متوقف شود.
اگر همان Node دوباره اجرا شود، احتمال ارسال مجدد درخواست وجود دارد.
راهکار اول: عملیات قابل تکرار
برای بعضی عملیاتها میتوان طراحیای داشت که اجرای تکراری، وضعیت نهایی ناخواسته ایجاد نکند.
برای مثال، تنظیم یک مقدار مشخص ممکن است از افزایش یا کاهش نسبی آن قابل پیشبینیتر باشد.
راهکار دوم: Idempotency Key
اگر API مقصد از Idempotency Key پشتیبانی میکند، همان کلید برای تلاشهای مجدد یک عملیات منطقی استفاده شود.
البته مقصد باید این کلید را واقعاً و بهصورت قابل اعتماد بررسی کند.
راهکار سوم: ثبت نتیجه و Reconciliation
اگر نتیجه یک عملیات خارجی نامعلوم است، برنامه باید وضعیت واقعی آن را بررسی کند.
برای مثال، قبل از ارسال مجدد یک درخواست ثبت سفارش باید مشخص شود سفارش قبلی ایجاد شده است یا خیر.
راهکار چهارم: تقسیم Nodeهای دارای اثر جانبی
بهتر است عملیات مهم در Node یا Task مستقل قرار بگیرند تا مرزهای ذخیره وضعیت واضحتر باشند.
در Functional API نیز LangGraph توصیه میکند عملیات غیرقطعی و اثرهای جانبی داخل Taskهای مشخص قرار بگیرند و برای Retry ایمن طراحی شوند.
نتیجه: LangGraph میتواند از تکرار بعضی مراحل کاملشده جلوگیری کند، اما برای عملیات خارجی همچنان به طراحی ضدتکرار در برنامه و Backend نیاز داریم.
استقرار LangGraph در محیط Production روی VPS
نمونه این مقاله یک برنامه CLI آموزشی است؛ یعنی برای اجرای یک گردش کار یا Resume، فرمان مشخصی فراخوانی میشود.
این نمونه بهتنهایی یک سرویس همیشهفعال یا Job Queue کامل نیست.
برای اجرای دائمی چه اجزایی لازم است؟
- یک API یا سرویس دریافت درخواست.
- Job Queue یا جدول پایدار برای کارهای جدید.
- Worker دارای مدیریت خطا و بازیابی.
- Checkpointer پایدار در PostgreSQL.
- Store برای اطلاعات بلندمدت.
- احراز هویت و کنترل مالکیت Thread.
- محدودیت تعداد Job همزمان.
- Audit و مانیتورینگ.
آیا systemd بهتنهایی کافی است؟
systemd میتواند فرآیند Worker را پس از Crash یا Restart دوباره فعال کند؛ اما باید برنامه شما بداند کدام Jobها آماده اجرا هستند و کدام Threadها باید بازیابی شوند.
صرف اجرای مجدد فایل Python به معنی Resume خودکار تمام Threadهای نیمهتمام نیست.
الگوی Worker قابلبازیابی
در یک محصول واقعی بهتر است ابتدا درخواست در جدول Job یا Queue ثبت شود. Worker هنگام دریافت Job، thread_id را میخواند و گراف را با State ذخیرهشده ادامه میدهد.
پس از موفقیت نیز وضعیت Job در یک محل معتبر ثبت میشود.
اجرای همزمان چند Worker
اگر چند Worker روی یک دیتابیس مشترک فعالیت دارند، باید از Claim اتمیک، Lock یا Lease مناسب استفاده کنید.
دو Worker نباید بدون هماهنگی، همزمان یک Thread دارای عملیات حساس را Resume کنند.
PostgreSQL امکان طراحی قفلگذاری مناسب را فراهم میکند؛ اما پیادهسازی سیاست Worker و جلوگیری از فراخوانی موازی یک گردش کار بر عهده برنامه شماست.
استفاده از AsyncPostgresSaver
اگر سرویس شما با FastAPI یا دیگر محیطهای Async ساخته شده است، میتوانید از AsyncPostgresSaver و AsyncPostgresStore استفاده کنید.
نمونه ساختار:
from langgraph.checkpoint.postgres.aio import (
    AsyncPostgresSaver,
)
from langgraph.store.postgres.aio import (
    AsyncPostgresStore,
)

async with (
    AsyncPostgresStore.from_conn_string(DB_URI) as store,
    AsyncPostgresSaver.from_conn_string(DB_URI) as checkpointer,
):
    await store.setup()
    await checkpointer.setup()

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    result = await graph.ainvoke(
        input_data,
        config,
        durability="sync",
    )
در این مثال فرض میشود builder، input_data و config از قبل تعریف شدهاند. برای Production، Connection Pool و مدیریت چرخه عمر اتصال نیز باید بررسی شوند.
بررسی مصرف منابع VPS
مصرف CPU و RAM برنامه به تعداد Workerها، حجم State و عملیات محلی بستگی دارد.
همچنین با افزایش تعداد Checkpointها، فضای دیتابیس و مدت زمان Backup افزایش پیدا میکند؛ بنابراین سیاست Retention و پاکسازی Threadهای قدیمی اهمیت دارد.
امنیت Checkpointها و اطلاعات ذخیرهشده در LangGraph
State یک Agent ممکن است شامل پیامهای کاربران، اطلاعات داخلی، پارامترهای Toolها یا خروجی سرویسهای خصوصی باشد.
بنابراین ذخیرهسازی پایدار باید همراه با کنترل دسترسی و حفاظت از اطلاعات انجام شود.
۱. دسترسی محدود PostgreSQL
حساب برنامه بهتر است فقط به دیتابیس و جدولهای موردنیاز خودش دسترسی داشته باشد.
استفاده از حساب مدیریتی PostgreSQL برای اجرای دائمی Agent توصیه نمیشود.
۲. محدود کردن دسترسی به Threadها
هر درخواست مشاهده یا Resume باید به کاربر یا سرویس مجاز مربوط باشد.
thread_id نباید بهعنوان رمز یا Token احراز هویت استفاده شود.
۳. محافظت از Secrets
API Key و رمز دیتابیس نباید داخل Git، Prompt عمومی یا Log قرار گیرند.
در محیط عملیاتی میتوان از Secret Manager یا قابلیتهای مدیریت Credential در systemd استفاده کرد.
۴. رمزنگاری دادههای حساس
اگر State شامل اطلاعات محرمانه است، میتوان از قابلیت رمزنگاری Checkpoint یا روشهای مناسب رمزنگاری در لایه ذخیرهسازی استفاده کرد.
LangGraph برای Checkpointerها امکان استفاده از EncryptedSerializer را فراهم میکند.
بااینحال باید مدیریت امن کلید رمزنگاری، نسخه پشتیبان کلید و بازیابی پس از خرابی نیز طراحی شود.
۵. حفاظت از اطلاعات موجود در Store
Store نیز ممکن است شامل اطلاعات شخصی یا محرمانه باشد. جداسازی Namespace بهتنهایی به معنی اعمال مجوز واقعی کاربر نیست.
Backend باید مشخص کند کدام هویت به کدام Namespace اجازه خواندن یا نوشتن دارد.
۶. جلوگیری از Prompt Injection
اگر Agent از منابع خارجی داده دریافت میکند، محتوای آن منابع نباید بهعنوان دستور مورد اعتماد تلقی شود.
این مسئله حتی هنگام استفاده از Checkpoint نیز اهمیت دارد؛ زیرا یک داده آلوده ممکن است در State ذخیره شود و در مراحل بعدی دوباره مورد استفاده قرار گیرد.
Backup و Restore از Checkpointهای LangGraph
اگر PostgreSQL از بین برود، Checkpointها و حافظه ذخیرهشده نیز ممکن است از دست بروند. بنابراین Backup جزئی از معماری Persistence است.
تهیه Backup منطقی PostgreSQL
برای نمونه محلی میتوانید از pg_dump استفاده کنید:
sudo -u postgres pg_dump \
-Fc \
-f /var/lib/postgresql/langgraph-backup.dump \
langgraph_app
پس از Backup باید فایل به محل امن و مستقل منتقل شود و دسترسی آن محدود گردد.
آیا Backup خودکار کافی است؟
خیر. باید قابلیت Restore بهصورت دورهای آزمایش شود.
همچنین لازم است نسخه LangGraph و ساختار Migrationهای دیتابیس با دادههای بازیابیشده سازگار باشند.
آیا پس از Restore باید Worker را بلافاصله فعال کنیم؟
بهتر است ابتدا وضعیت Jobها و عملیات خارجی بررسی شود.
اگر دیتابیس قدیمی بازیابی شود اما یک API خارجی قبلاً عملیاتی را انجام داده باشد، اجرای مجدد همان Node ممکن است اثر تکراری ایجاد کند.
برای عملیات حساس باید Reconciliation پیش از Resume انجام شود.
مدیریت رشد دیتابیس
در گردش کارهای طولانی ممکن است تعداد زیادی Checkpoint ایجاد شود.
برای جلوگیری از رشد نامحدود، باید سیاست نگهداری و حذف دادهها مشخص باشد. حذف Checkpointهای قدیمی نباید بدون بررسی نیازهای Audit، Resume و Time Travel انجام شود.
خطاهای رایج LangGraph روی VPS و روش رفع آنها
۱. خطای No module named langgraph
احتمالاً کتابخانه در محیط Python دیگری نصب شده است.
مسیر Virtual Environment را بررسی و نصب را با همان Python انجام دهید.
۲. خطای اتصال PostgreSQL
وضعیت PostgreSQL، نام دیتابیس، Role و روش Authentication را بررسی کنید.
اگر از Peer Authentication استفاده میکنید، نام کاربر Linux باید با Role مورد انتظار سازگار باشد.
۳. خطای relation does not exist
ممکن است setup مربوط به Checkpointer یا Store اجرا نشده باشد.
فرمان init پروژه را اجرا و لاگ خطای Migration را بررسی کنید.
۴. خطای Permission denied در دیتابیس
حساب برنامه احتمالاً مجوز لازم برای ایجاد یا استفاده از جدولها را ندارد.
مالکیت دیتابیس و مجوز Schema موردنیاز را بررسی کنید؛ بهجای اجرای برنامه با Superuser.
۵. State بعد از Restart پیدا نمیشود
ممکن است از InMemorySaver استفاده کرده باشید، اتصال به دیتابیس دیگری برقرار شده باشد یا thread_id متفاوتی ارسال شده باشد.
۶. خطای نبود thread_id
برای ذخیره و بازیابی وضعیت با Checkpointer، باید شناسه Thread در بخش configurable تنظیم شود.
۷. اجرای دوباره Node پس از Crash
این رفتار ممکن است طبیعی باشد؛ زیرا Node قبل از ثبت Checkpoint موفق خود متوقف شده است.
اگر Node دارای اثر خارجی است، از Idempotency و بررسی وضعیت واقعی مقصد استفاده کنید.
۸. Resume به نتیجه مورد انتظار نمیرسد
ابتدا بررسی کنید اجرای قبلی به دلیل Exception متوقف شده یا به دلیل interrupt در انتظار ورودی است.
برای بازیابی اجرای ناموفق معمولاً از ادامه همان Thread با ورودی None استفاده میشود؛ برای Interrupt باید مقدار Resume با Command ارسال شود.
۹. اطلاعات Store در Thread جدید دیده نمیشوند
Namespace، Key و User ID را بررسی کنید. همچنین مطمئن شوید گراف با همان Store معتبر Compile شده است.
۱۰. مصرف فضای PostgreSQL افزایش یافته است
احتمالاً تاریخچه Checkpointها و دادههای State در حال افزایش هستند.
حجم جدولها، سیاست Retention و حجم دادههایی را که داخل State قرار میدهید بررسی کنید.
۱۱. دو Worker یک Thread را همزمان Resume میکنند
این نشانه نبود هماهنگی در لایه Job و Worker است.
برای اجرای توزیعشده، Claim اتمیک، Lease و مدیریت مالکیت اجرای Thread لازم است.
۱۲. مدل دوباره هزینه API مصرف میکند
ممکن است فراخوانی قبلی مدل کامل شده اما خروجی آن در Checkpoint ثبت نشده باشد.
برای مراحل پرهزینه، مدیریت نتیجه و طراحی Taskهای قابلبازیابی را بررسی کنید.
۱۳. بعد از ارتقای LangGraph، State قبلی مشکل دارد
ممکن است تغییر ساختار State، Nodeها یا نسخه بستههای Checkpointer باعث ناسازگاری شده باشد.
قبل از ارتقای Production، Resume کردن چند Checkpoint واقعی را روی محیط آزمایشی بررسی کنید.
۱۴. توقف طولانی Agent باعث Timeout درخواست HTTP میشود
برای گردش کارهایی که ممکن است منتظر انسان بمانند، بهتر است Job ID به کاربر برگردانده شود و ادامه اجرا از طریق یک درخواست مستقل صورت گیرد.
نگه داشتن اتصال HTTP برای ساعتها جایگزین ذخیرهسازی پایدار نیست.
LangGraph، OpenAI Agents SDK و Temporal؛ کدام مناسبتر است؟
اگرچه هر سه فناوری میتوانند در بخشی از یک معماری Agentمحور کاربرد داشته باشند، اما تمرکز آنها یکسان نیست.
| فناوری | تمرکز اصلی | مناسب برای |
|---|---|---|
| LangGraph | گراف Stateful، Checkpoint و گردش کار Agent | Agentهای چندمرحلهای و قابلبازیابی |
| OpenAI Agents SDK | Agent، Tools، Handoffs و Sessions | ساخت Agent با ابزارها و هماهنگی نقشها |
| Temporal | Durable Workflow و Event History | گردش کارهای طولانی با نیاز به بازیابی عملیاتی |
| Queue + Database | ثبت Job و مدیریت Worker | اتوماسیونهای قطعی با پیچیدگی محدود |
اگر فقط میخواهید یک عملیات قطعی را بعد از خطا دوباره اجرا کنید، ممکن است یک Queue و دیتابیس ساده کافی باشند.
اگر نیاز به StateGraph، مسیرهای شرطی، حافظه چندسطحی و Human-in-the-Loop دارید، LangGraph گزینه مناسبی برای ارزیابی است.
اگر گردش کار شامل تعداد زیادی عملیات خارجی و الزامهای عملیاتی سختگیرانه است، استفاده از یک Workflow Engine تخصصی نیز ارزش بررسی دارد.
سؤالات متداول درباره LangGraph VPS و Checkpoint
LangGraph چیست؟
فریمورکی برای ساخت گردش کارهای Stateful و Agentهای هوش مصنوعی است که قابلیتهایی مانند Checkpoint، حافظه و اجرای قابلبازیابی را ارائه میکند.
آیا میتوان LangGraph را روی VPS نصب کرد؟
بله. میتوانید برنامه Python را روی VPS اجرا کنید و از PostgreSQL یا Backend ذخیرهسازی مناسب برای Persistence استفاده کنید.
آیا LangGraph به GPU نیاز دارد؟
اگر مدل از طریق API اجرا شود، معمولاً برای خود برنامه به GPU اختصاصی نیاز نیست.
Checkpointer در LangGraph چیست؟
بخشی است که State و تاریخچه اجرای یک Thread را بهصورت Checkpoint ذخیره میکند.
PostgresSaver چه کاربردی دارد؟
برای ذخیره Checkpointهای LangGraph در PostgreSQL استفاده میشود تا اطلاعات پس از پایان فرآیند نیز باقی بمانند.
Store با Checkpointer چه تفاوتی دارد؟
Checkpointer وضعیت یک Thread را حفظ میکند؛ Store دادههای بلندمدت و قابل استفاده میان Threadهای مختلف را نگهداری میکند.
thread_id چیست؟
شناسهای است که Checkpointer برای تشخیص و بازیابی وضعیت یک گردش کار استفاده میکند.
آیا thread_id همان شناسه کاربر است؟
خیر. یک کاربر میتواند چند Thread داشته باشد و مالکیت آنها باید جداگانه کنترل شود.
آیا InMemorySaver بعد از Restart اطلاعات را حفظ میکند؟
خیر. چون اطلاعات آن داخل RAM نگهداری میشوند، برای دوام داده بعد از Restart مناسب نیست.
آیا PostgreSQL برای LangGraph ضروری است؟
خیر. Backendهای دیگری نیز وجود دارند، اما PostgreSQL یکی از گزینههای مناسب برای اجرای پایدار است.
چگونه یک Agent را بعد از Crash ادامه دهیم؟
با Checkpointer پایدار، همان thread_id و منطق Resume متناسب با وضعیت آخرین اجرای ذخیرهشده.
آیا Node از همان خطی که Crash کرده ادامه پیدا میکند؟
خیر. ممکن است اجرای Node از ابتدا تکرار شود. بازیابی معمولاً از مرز Checkpoint معتبر انجام میشود.
durability=’sync’ چه مزیتی دارد؟
Checkpoint را پیش از ادامه مرحله بعدی بهصورت همزمان ذخیره میکند و برای گردش کارهایی که دوام وضعیت اهمیت دارد مفید است.
تفاوت sync و async چیست؟
در sync ذخیره Checkpoint پیش از ادامه مرحله بعد انتظار کشیده میشود؛ در async ذخیرهسازی میتواند همزمان با ادامه اجرا انجام شود و در Crash احتمال از دست رفتن آخرین وضعیت وجود دارد.
interrupt در LangGraph چه کاری انجام میدهد؟
اجرای گراف را در یک نقطه مشخص متوقف میکند تا بعداً با ورودی مناسب ادامه پیدا کند.
چگونه یک Interrupt را Resume کنیم؟
با استفاده از Command(resume=…) و همان thread_id مربوط به اجرای متوقفشده.
آیا Resume باعث اجرای دوباره Tool میشود؟
در بعضی شرایط بله. بهخصوص اگر Node پیش از ثبت Checkpoint کامل متوقف شده باشد. عملیات خارجی باید ضدتکرار طراحی شوند.
حافظه کوتاهمدت در LangGraph چیست؟
اطلاعات مربوط به وضعیت و پیامهای یک Thread است که توسط Checkpointer نگهداری میشود.
حافظه بلندمدت در LangGraph چیست؟
اطلاعات ماندگاری است که مستقل از یک Thread مشخص در Store نگهداری میشود.
آیا Store از جستوجوی معنایی پشتیبانی میکند؟
بسته به Backend و تنظیمات Index میتواند از قابلیت جستوجوی معنایی استفاده کند. برای PostgreSQL، پیکربندی مناسب Index و وابستگیهای موردنیاز لازم است.
آیا LangGraph امکان Time Travel دارد؟
بله. میتوان وضعیتهای تاریخی را بررسی و بعضی مسیرهای اجرا را از Checkpointهای مشخص بازسازی کرد.
آیا Time Travel برای عملیات مالی امن است؟
بهتنهایی خیر. بازاجرای Nodeهای دارای اثر جانبی ممکن است عملیات را تکرار کند؛ بنابراین Idempotency و کنترل مقصد ضروری است.
چگونه چند Worker را روی یک PostgreSQL اجرا کنیم؟
با طراحی Queue، مدیریت مالکیت Job، Lock یا Lease مناسب و جلوگیری از Resume همزمان یک گردش کار.
آیا LangGraph بهتنهایی سرویس دائمی ایجاد میکند؟
خیر. برای اجرای عملیاتی معمولاً به سرویس API، Worker، مدیریت فرآیند و سیاست بازیابی نیاز دارید.
چگونه از Checkpointها Backup بگیریم؟
با استفاده از روشهای مناسب Backup PostgreSQL و آزمایش دورهای Restore.
آیا افزایش RAM سرور باعث کاهش هزینه Token میشود؟
خیر. هزینه مدل API عمدتاً به مصرف مدل و Token بستگی دارد؛ RAM بیشتر VPS بیشتر به اجرای Workerها و زیرساخت محلی کمک میکند.
LangGraph برای چه پروژههایی ارزش بیشتری دارد؟
برای Agentهای چندمرحلهای، نیازمند Checkpoint، حافظه ماندگار، گردش کار شرطی، تأیید انسانی و بازیابی پس از توقف.
جمعبندی
اجرای LangGraph روی VPS امکان ساخت Agentهایی را فراهم میکند که وضعیت خود را در یک دیتابیس پایدار نگهداری کنند و پس از توقف برنامه یا Restart سرور، از آخرین Checkpoint معتبر ادامه دهند.
در این آموزش تفاوت Checkpointer و Store را بررسی کردیم و با PostgreSQL یک پروژه عملی ساختیم که State یک Thread را ذخیره میکند، حافظه بلندمدت کاربر را میخواند، هنگام اجرای یک Node خطای آزمایشی ایجاد میکند و سپس اجرای آن را از وضعیت ذخیرهشده ادامه میدهد.
همچنین یاد گرفتیم که برای Resume کردن یک Interrupt باید از Command(resume=…) استفاده کنیم و همان thread_id قبلی را حفظ کنیم.
بااینحال، Checkpoint بهتنهایی تضمین نمیکند عملیات خارجی دقیقاً یکبار اجرا شوند. اگر Agent قرار است درخواست مدیریتی، پرداخت، حذف داده یا ارسال پیام انجام دهد، باید Idempotency، بررسی مجوز و Reconciliation نیز در معماری وجود داشته باشند.
برای یک پروژه سبک، میتوانید LangGraph و PostgreSQL را روی یک VPS اجرا کنید. با افزایش تعداد کاربران و Workerها نیز باید مدیریت Queue، همزمانی، امنیت State، Backup و نظارت عملیاتی را توسعه دهید.
نتیجه اصلی: LangGraph ابزار قدرتمندی برای مدیریت State و بازیابی گردش کار است؛ اما ساخت یک Agent واقعاً مقاوم در برابر Crash به ترکیب درست Checkpoint، دیتابیس، کنترل عملیات خارجی و مدیریت Worker نیاز دارد.
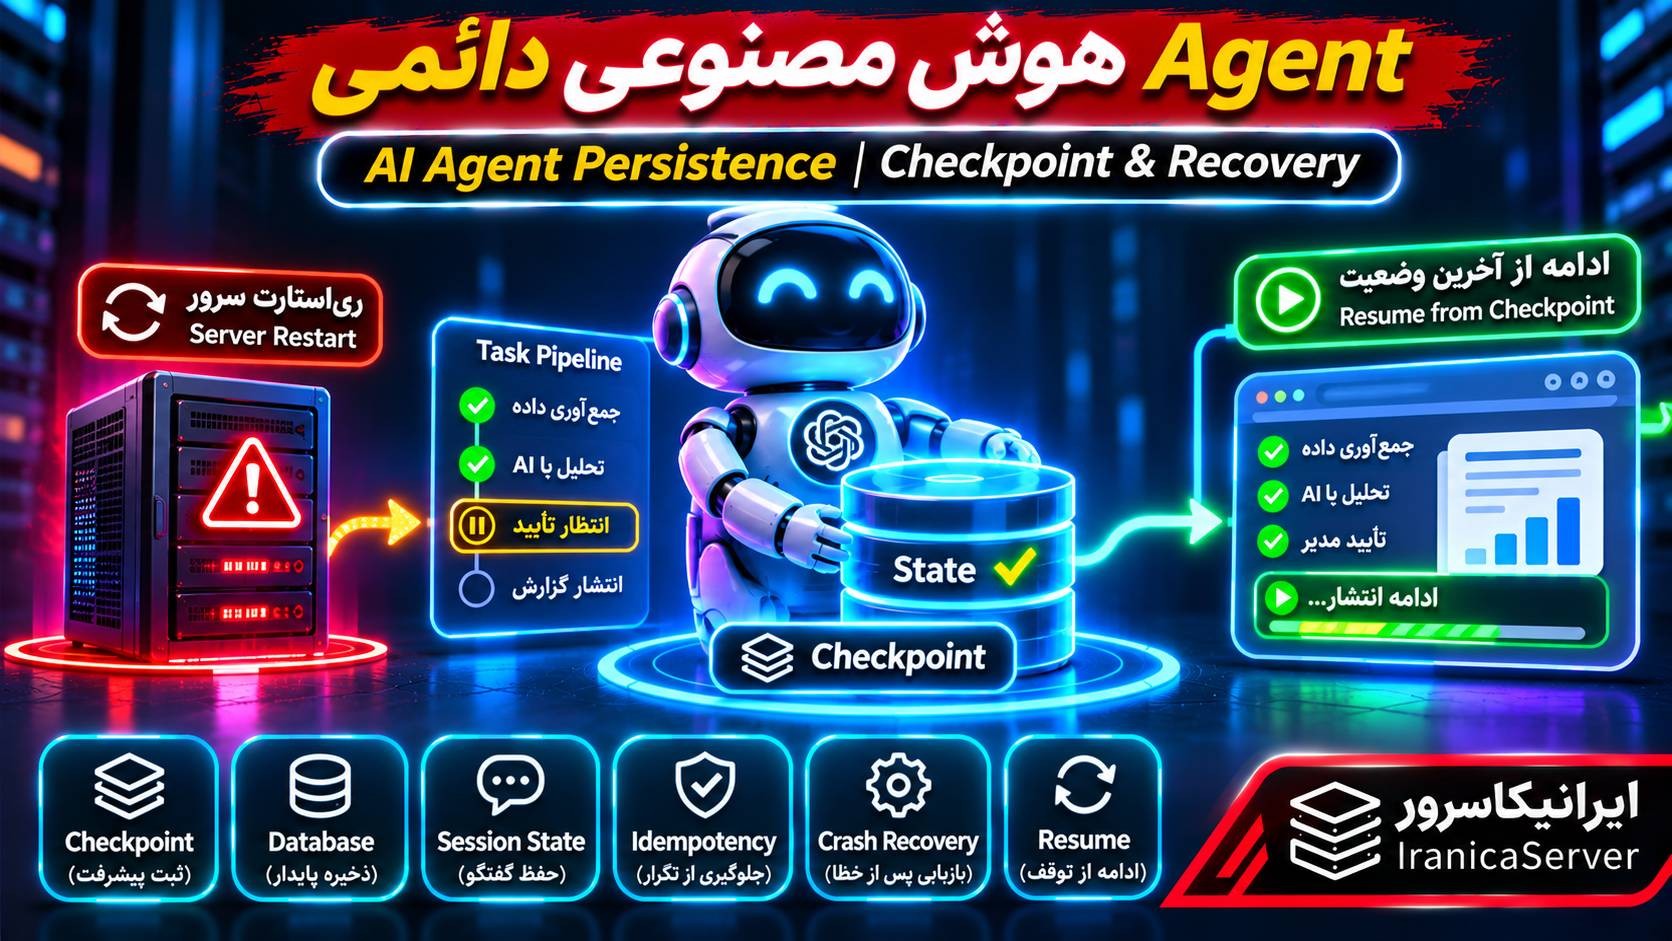
برای آشنایی بیشتر با مفاهیم پایه بازیابی Agent و جلوگیری از عملیات تکراری، راهنمای AI Agent Persistence و Crash Recovery را نیز مطالعه کنید.
منابع و مستندات رسمی
۱. LangGraph — Persistence
راهنمای رسمی تفاوت Checkpointer و Store و شیوه نگهداری وضعیت Agent.
مستندات رسمی LangGraph Persistence
۲. LangGraph — Checkpointers
مفاهیم Thread، Checkpoint، تاریخچه State و حالتهای Durability.
۳. LangGraph — Add Memory
نحوه استفاده از حافظه کوتاهمدت و بلندمدت با PostgreSQL.
۴. LangGraph — Durable Execution
روش بازیابی اجرای گراف، دوام مراحل و ملاحظات عملیات دارای اثر جانبی.
۵. LangGraph — Interrupts
توقف گردش کار و ادامه اجرا با Command(resume=…).
۶. LangGraph — PostgresSaver API
مرجع رسمی Checkpointer مبتنی بر PostgreSQL.
۷. LangGraph — PostgresStore
پیادهسازی رسمی Store با PostgreSQL و امکانات ذخیرهسازی و جستوجو.
۸. LangGraph — Functional API
راهنمای Taskها، Replay و طراحی عملیات ضدتکرار.
۹. LangGraph — PyPI
نسخههای منتشرشده و وابستگیهای کتابخانه.
۱۰. LangGraph Checkpoint PostgreSQL — GitHub
کد منبع و راهنمای بسته PostgreSQL Checkpointer.
۱۱. PostgreSQL — Backup and Restore
مستندات تهیه نسخه پشتیبان و بازیابی PostgreSQL.
راهنمای رسمی PostgreSQL Backup
۱۲. OWASP — AI Agent Security
نکات امنیتی مربوط به Agent، مجوز ابزارها و دادههای غیرقابل اعتماد.
دیدگاهها (۰)