
 Amir Jabbari
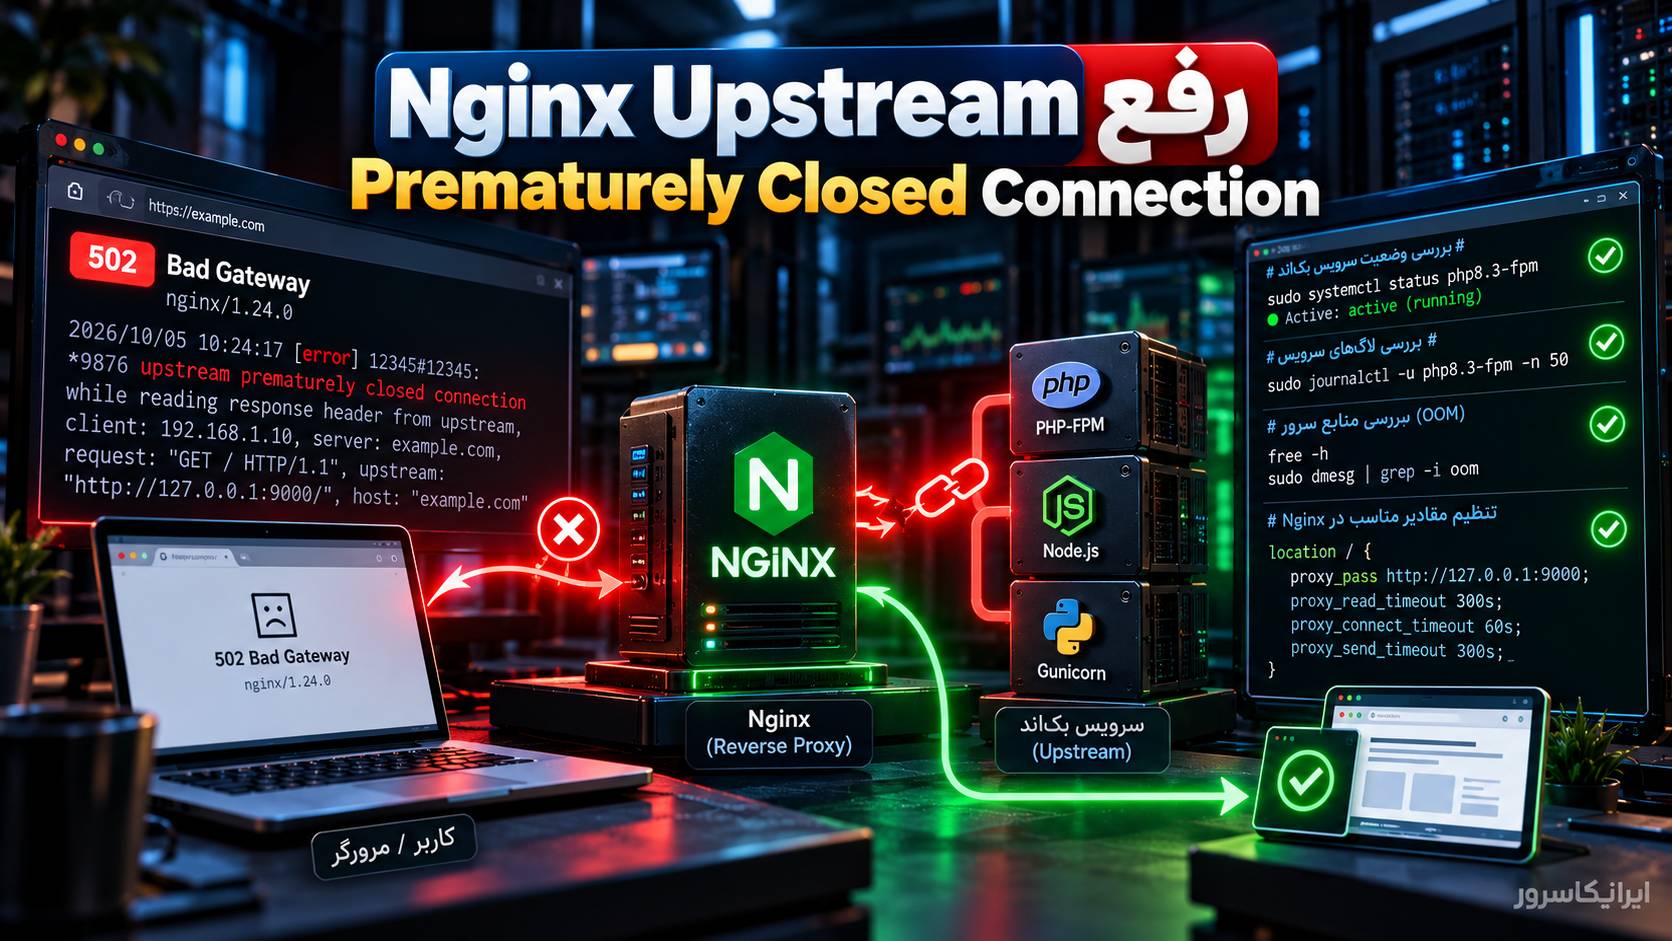
اگر در لاگ Nginx با خطایی شبیه upstream prematurely closed connection while reading response header from upstream روبهرو شدهاید، معنی ساده آن این است که Nginx درخواست را به Backend فرستاده، اما Upstream قبل از اینکه هدر کامل پاسخ را برگرداند اتصال را بسته است. این خطا معمولاً نشانه مشکل در خود Backend، Crash شدن Worker، Timeout، کمبود RAM، بستهشدن Connection در Docker یا تنظیمات ناسازگار Proxy است؛ نه اینکه الزاماً خود Nginx خراب باشد.
راهحل کوتاه: ابتدا همان Request را در /var/log/nginx/error.log پیدا کنید و همزمان لاگ سرویس Upstream را بخوانید. اگر Backend Crash یا Restart شده، مشکل را از همانجا رفع کنید. اگر Backend سالم است اما پاسخ طولانی یا سنگین دارد، تنظیماتی مثل proxy_read_timeout، fastcgi_read_timeout یا Timeout خود برنامه را بررسی کنید. زیاد کردن کورکورانه Timeout بدون بررسی لاگ Backend معمولاً فقط علامت را پنهان میکند.
خطای Upstream Prematurely Closed Connection یعنی چه؟
در معماری Reverse Proxy معمولاً Nginx جلوی یک سرویس Backend قرار میگیرد. برای مثال:
Client
  ↓
Nginx :443
  ↓
Node.js / Python / PHP-FPM / Docker App
  ↓
Response
Nginx درخواست کاربر را به Upstream میفرستد و منتظر Header پاسخ میماند. اگر Backend قبل از ارسال Header کامل Connection را ببندد، ممکن است چنین خطایی ثبت شود:
upstream prematurely closed connection while reading response header from upstreamدر بسیاری از موارد نتیجه برای کاربر یکی از این Statusهاست:
502 Bad Gateway504 Gateway Timeout- Connection reset
- صفحه ناقص یا درخواست شکستخورده
این خطا با Upstream Timed Out یکی نیست
دو پیام زیر شبیهاند اما علت یکسانی ندارند:
upstream timed out while reading response header from upstreamو:
upstream prematurely closed connection while reading response header from upstreamدر حالت Timed Out، Nginx بهاندازه Timeout تعیینشده منتظر مانده و داده لازم را دریافت نکرده است.
در حالت Prematurely Closed، Upstream خودش Connection را زودتر از انتظار بسته یا Connection به شکلی غیرعادی قطع شده است.
مرحله اول: خطای دقیق Nginx را پیدا کنید
در Ubuntu و Debian معمولاً Error Log اصلی Nginx اینجاست:
/var/log/nginx/error.logآخرین خطوط را ببینید:
sudo tail -n 100 /var/log/nginx/error.logبرای مشاهده زنده:
sudo tail -f /var/log/nginx/error.logمثال:
2026/10/05 10:32:15 [error] 1284#1284: *912
upstream prematurely closed connection while reading response header from upstream,
client: 203.0.113.10,
server: example.com,
request: "POST /api/report HTTP/1.1",
upstream: "http://127.0.0.1:3000/api/report",
host: "example.com"
این خط چند اطلاعات بسیار مهم دارد:
- مسیر Request:
/api/report - نوع Request:
POST - Upstream واقعی:
127.0.0.1:3000 - زمان دقیق وقوع خطا
- دامنه و Client
مرحله دوم: Upstream را بدون Nginx مستقیم تست کنید
اگر Backend روی 127.0.0.1:3000 اجرا میشود، همان Endpoint را مستقیم تست کنید:
curl -v http://127.0.0.1:3000/api/reportاگر Endpoint به POST نیاز دارد، Request مناسب همان API را تست کنید.
اگر Direct Request هم Fail میشود، مشکل تقریباً قطعاً در Backend یا وابستگیهای آن است، نه Nginx.
اگر Direct Request همیشه موفق است ولی از طریق Nginx شکست میخورد، تنظیمات Proxy، Headerها، Timeout، Buffer، Keepalive یا Protocol باید بررسی شود.
مطمئن شوید Backend واقعاً فعال است
پورت Backend را بررسی کنید:
sudo ss -ltnp 'sport = :3000'اگر خروجی خالی است، Backend دیگر Listen نمیکند.
برای دیدن Process:
sudo lsof -nP -iTCP:3000 -sTCP:LISTENمهمترین مرحله: لاگ Backend را همزمان بخوانید
یکی از رایجترین اشتباهها این است که فقط لاگ Nginx دیده شود. Nginx اغلب فقط میگوید Connection بسته شد؛ دلیل واقعی ممکن است در لاگ برنامه باشد.
اگر Backend یک systemd Service است
sudo systemctl status myapp
sudo journalctl -u myapp -n 200 --no-pager
برای مشاهده زنده:
sudo journalctl -u myapp -fاگر Backend داخل Docker است
docker ps
docker logs --tail=200 CONTAINER_NAME
برای Compose:
docker compose ps
docker compose logs --tail=200 app
سناریوی رایج: Backend Crash یا Restart میشود
اگر Worker هنگام پردازش Request Crash کند، Nginx ممکن است Connection زودهنگام دریافت کند.
وضعیت Restart در systemd:
systemctl status myappبه مواردی مثل این دقت کنید:
Main process exited
status=1/FAILURE
code=killed
signal=SEGV
Start request repeated too quickly
در Docker نیز Restart Count را بررسی کنید:
docker inspect -f '{{.RestartCount}}' CONTAINER_NAMEسناریوی مهم: OOM Killer پردازش Backend را کشته است
اگر RAM سرور کم باشد، Kernel ممکن است برای آزاد کردن حافظه یکی از Processها را Kill کند. در همان لحظه Nginx فقط قطع شدن Upstream را میبیند.
لاگ OOM را بررسی کنید:
dmesg -T | grep -Ei 'out of memory|oom|killed process'یا:
journalctl -k | grep -Ei 'out of memory|oom|killed process'RAM و Swap:
free -hاگر OOM دیده میشود، زیاد کردن proxy_read_timeout هیچ کمکی به علت اصلی نمیکند.
مقاله مرتبط
اگر Backend شما بهدلیل کمبود RAM Kill میشود، مقاله رفع Out of Memory و OOM Killer در VPS مسیر مناسب بعدی برای بررسی است.
proxy_read_timeout دقیقاً چه کاری انجام میدهد؟
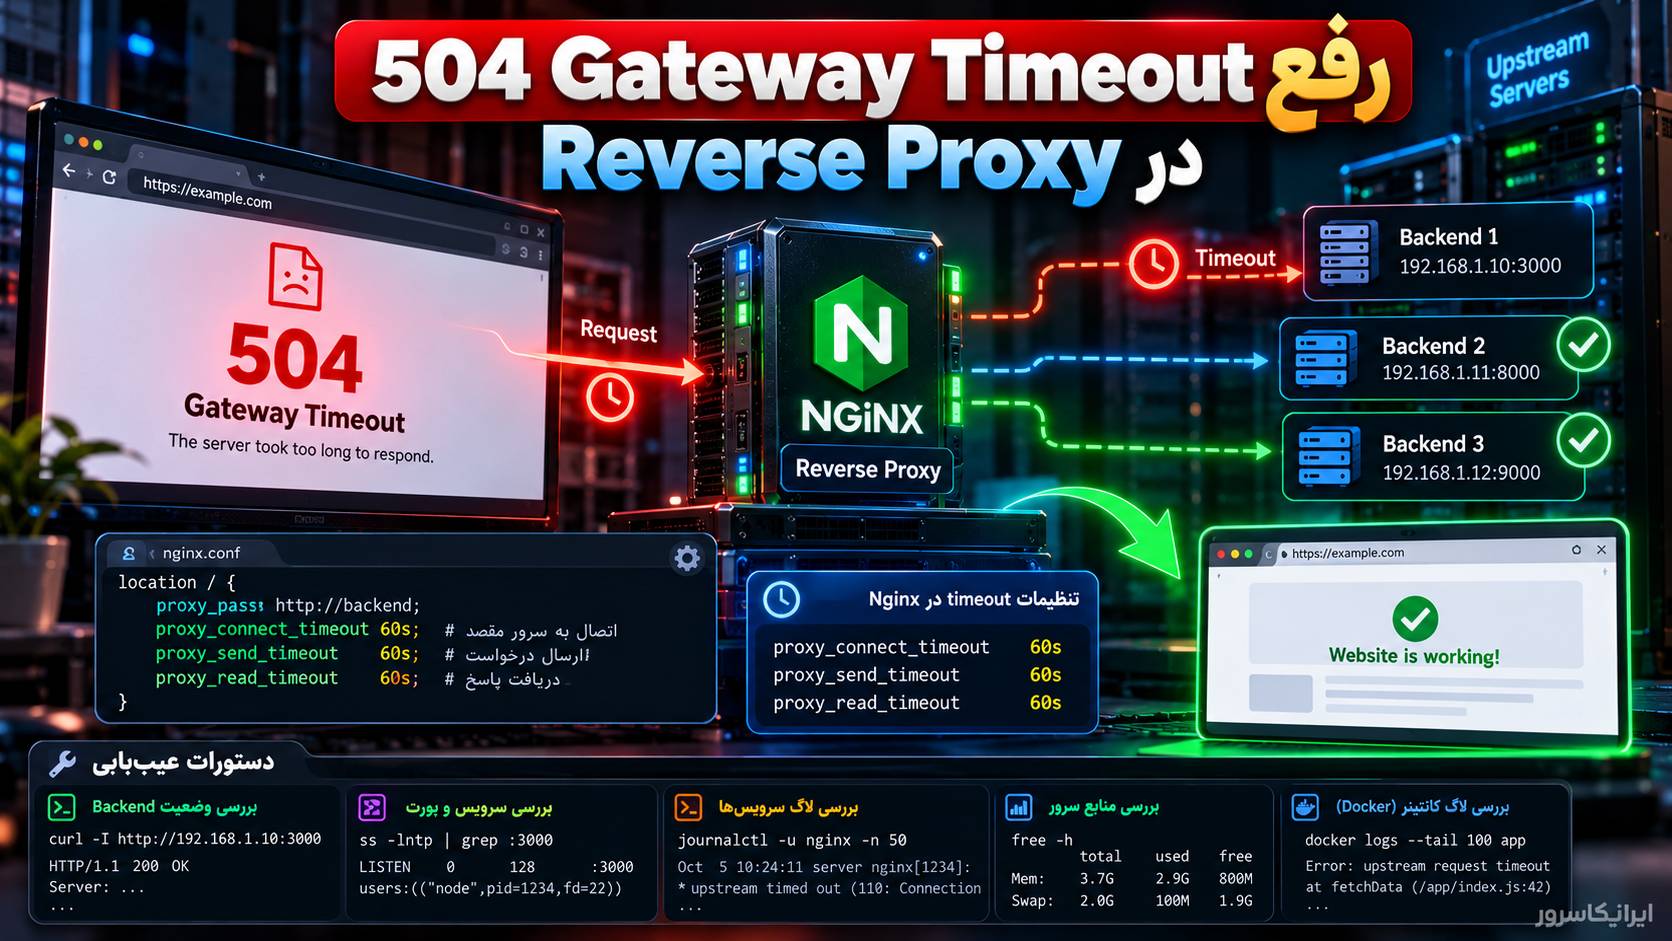
در Reverse Proxyهای HTTP، Nginx از Directive زیر استفاده میکند:
proxy_read_timeout 60s;این Timeout مدت کل Request نیست. Nginx مدت زمان بین دو عملیات خواندن متوالی از Upstream را اندازه میگیرد. اگر در این بازه هیچ دادهای از Backend نرسد، Nginx Connection را میبندد.
برای Endpointهای طولانی مانند Report، AI Inference، Export یا پردازش ویدئو ممکن است مقدار پیشفرض کم باشد.
مثال:
location /api/ {
    proxy_pass http://127.0.0.1:3000;

    proxy_connect_timeout 10s;
    proxy_send_timeout 60s;
    proxy_read_timeout 120s;
}
نکته: اگر پیام دقیق شما prematurely closed connection است و Backend Crash میکند، فقط بالا بردن proxy_read_timeout درمان نیست. Timeout زمانی مفید است که Backend سالم باشد اما پاسخ دیرتر از حد تنظیمشده برسد.
proxy_connect_timeout با proxy_read_timeout فرق دارد
proxy_connect_timeout مدت انتظار برای برقراری Connection با Backend است:
proxy_connect_timeout 10s;اما proxy_read_timeout مربوط به خواندن پاسخ بعد از برقراری Connection است.
پس اگر Nginx اصلاً نمیتواند به Backend وصل شود، بیشتر با خطاهایی شبیه زیر روبهرو میشوید:
connect() failed (111: Connection refused) while connecting to upstreamاین خطا با Prematurely Closed یکسان نیست.
نمونه تنظیم مناسب Reverse Proxy
یک تنظیم پایه برای Backend HTTP:
location / {
    proxy_pass http://127.0.0.1:3000;

    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Forwarded-Proto $scheme;

    proxy_connect_timeout 10s;
    proxy_send_timeout 60s;
    proxy_read_timeout 120s;
}
بعد از تغییر تنظیمات، اول Syntax را بررسی کنید:
sudo nginx -tاگر خروجی موفق بود:
sudo systemctl reload nginxسناریوی Node.js
در Node.js موارد زیر میتوانند باعث بستهشدن Connection شوند:
- Exception مدیریتنشده
- Promise Rejection
- Crash شدن Process
- Memory Leak و OOM
- Restart توسط PM2
- Timeout خود برنامه یا HTTP Server
اگر برنامه با PM2 اجرا میشود:
pm2 list
pm2 logs APP_NAME --lines 200
اگر Restart Count بالا میرود، اول دلیل Restart را پیدا کنید.
سناریوی Gunicorn
Gunicorn بهصورت پیشفرض Worker Timeout دارد. اگر Request بیش از Timeout طول بکشد، Worker ممکن است Kill شود و Nginx اتصال بستهشده را ببیند.
اگر Service دارید:
sudo journalctl -u gunicorn -n 200 --no-pagerبه پیامهایی مانند این دقت کنید:
WORKER TIMEOUT
Worker exiting
Worker was sent SIGKILL
اگر Endpoint واقعاً به زمان بیشتری نیاز دارد، Timeout Gunicorn و Nginx باید هماهنگ شوند. مثال:
gunicorn app:app --workers 4 --timeout 120اما اگر Request بهدلیل Query کند، Deadlock یا مشکل کد طول میکشد، فقط افزایش Timeout راهحل نهایی نیست.
سناریوی Uvicorn یا FastAPI
برای FastAPI معمولاً باید لاگ Uvicorn یا Process Manager را بررسی کنید:
sudo journalctl -u fastapi -fیا در Docker:
docker logs -f fastapiException برنامه، Restart، Timeout یا OOM میتواند Connection را قبل از Header ببندد.
سناریوی PHP-FPM
اگر Nginx با PHP-FPM کار میکند، Directiveهای Proxy معمولی استفاده نمیشوند و باید FastCGI را بررسی کنید.
نمونه خطا:
upstream prematurely closed FastCGI requestیا خطاهای مرتبط با Header.
وضعیت PHP-FPM:
sudo systemctl status php8.3-fpmلاگ:
sudo journalctl -u php8.3-fpm -n 200 --no-pagerدر تنظیم Nginx ممکن است نیاز باشد:
fastcgi_read_timeout 120s;اما همزمان باید تنظیمات PHP مثل max_execution_time و PHP-FPM Workerها بررسی شوند.
کمبود Worker در PHP-FPM
اگر Pool ظرفیت کافی نداشته باشد، درخواستها ممکن است صف شوند یا Workerها تحت فشار قرار بگیرند.
فایل Pool معمولاً چیزی شبیه این است:
/etc/php/8.3/fpm/pool.d/www.confپارامترهای مهم:
pm.max_children
pm.start_servers
pm.min_spare_servers
pm.max_spare_servers
request_terminate_timeout
مقدار pm.max_children را بدون محاسبه مصرف RAM بالا نبرید؛ افزایش بیش از حد میتواند خود باعث OOM شود.
سناریوی Nginx + Docker
اگر Nginx روی Host و Backend داخل Docker است، ابتدا Container را بررسی کنید:
docker ps
docker inspect CONTAINER_NAME
docker logs --tail=200 CONTAINER_NAME
Restart Count:
docker inspect -f '{{.RestartCount}}' CONTAINER_NAMEOOM وضعیت Container:
docker inspect -f '{{.State.OOMKilled}}' CONTAINER_NAMEاگر خروجی true باشد، علت اصلی احتمالاً محدودیت حافظه است.
Backend داخل Docker را مستقیم تست کنید
اگر Port روی Host Publish شده است:
docker ps --format 'table {{.Names}}\t{{.Ports}}'سپس Port Host را مستقیم تست کنید:
curl -v http://127.0.0.1:3000/healthاگر Nginx خودش داخل Compose است، بهتر است با نام Service در شبکه Docker ارتباط برقرار کند:
proxy_pass http://app:3000;در این حالت Healthy بودن DNS داخلی Docker و خود Container اهمیت دارد.
Keepalive ناسازگار یا Connection قدیمی
در بعضی معماریها Backend Connection را میبندد ولی Nginx یا Load Balancer انتظار ادامه استفاده از Connection را دارد. اگر خطا فقط بعد از Idle شدن Connectionها دیده میشود، Keepalive Upstream و Timeoutهای Backend را بررسی کنید.
نمونه Upstream:
upstream app_backend {
    server 127.0.0.1:3000;
    keepalive 32;
}
اگر از Keepalive استفاده میکنید، Timeoutهای Nginx، Backend و Load Balancer باید با هم سازگار باشند. حذف یا افزایش تصادفی Keepalive بدون تست Load توصیه نمیشود.
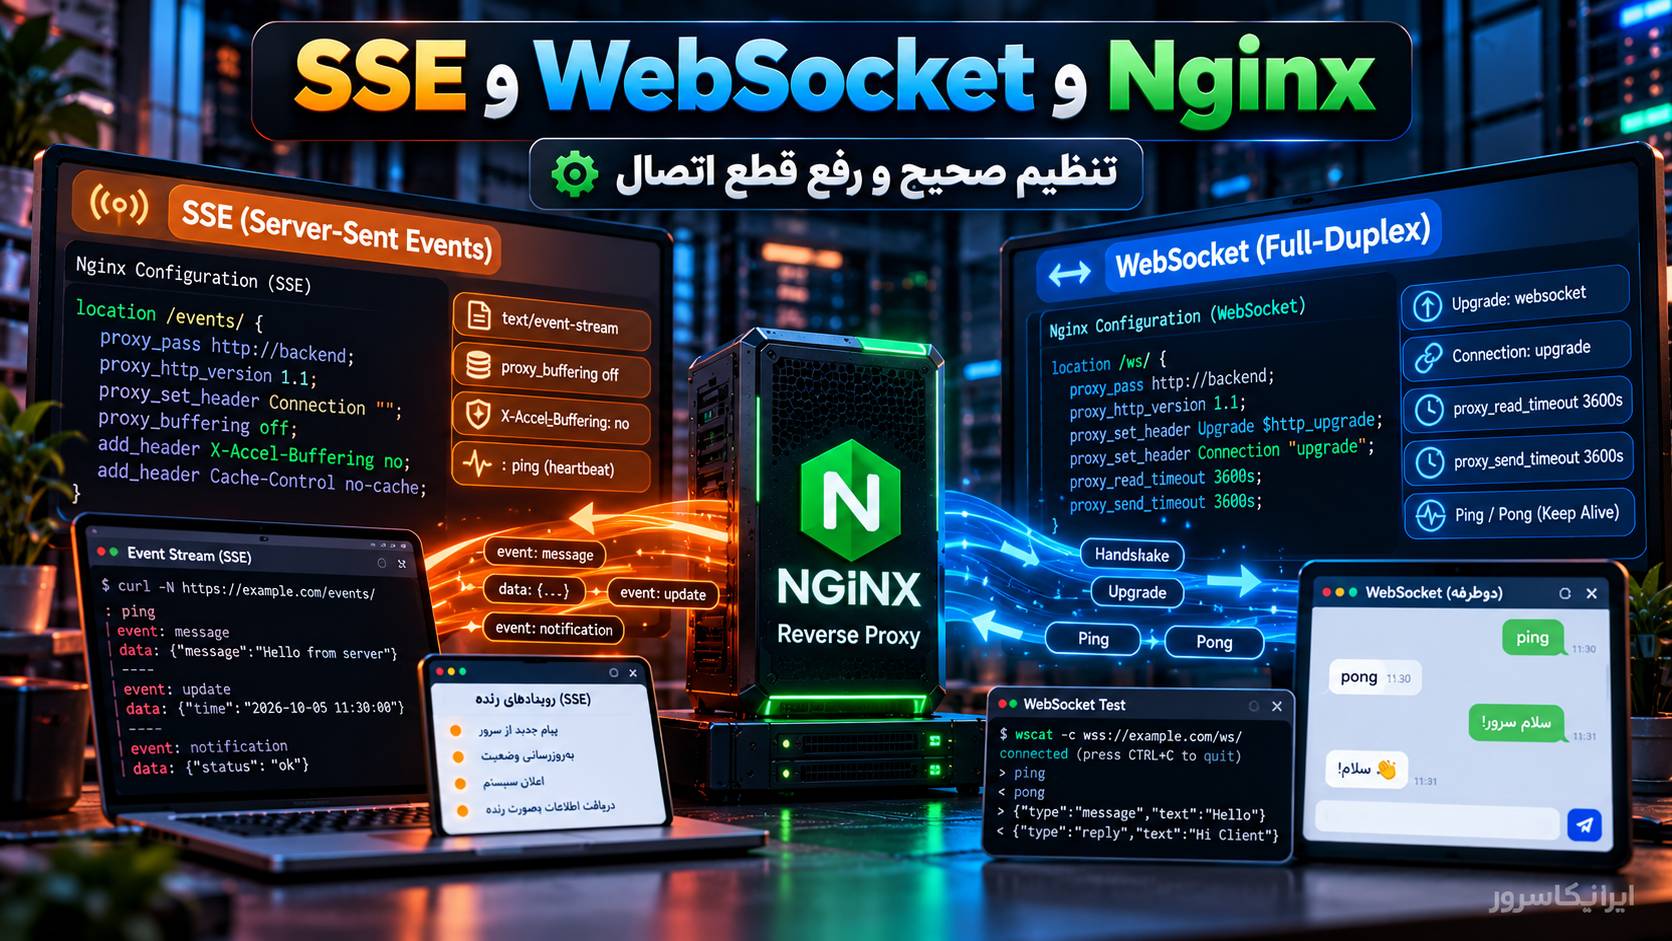
اگر سرویس WebSocket است
برای WebSocket باید Upgrade Headerها درست Forward شوند.
نمونه:
location /ws/ {
    proxy_pass http://127.0.0.1:3000;

    proxy_http_version 1.1;
    proxy_set_header Upgrade $http_upgrade;
    proxy_set_header Connection "upgrade";

    proxy_read_timeout 3600s;
}
اگر WebSocket برای مدتی هیچ دادهای ارسال نکند، Timeout خواندن میتواند Connection را ببندد. برای Connectionهای طولانی، Ping/Pong سمت برنامه نیز راهکار مناسبی است.
پاسخ سنگین یا پردازش طولانی
اگر خطا فقط در Export، Backup، گزارش سنگین یا APIهای AI رخ میدهد، موارد زیر را بررسی کنید:
- Timeout Nginx
- Timeout Backend
- محدودیت RAM
- Query دیتابیس
- Worker Timeout
- Crash هنگام Serialization پاسخ
- محدودیت Docker
زمان پاسخ مستقیم Backend را اندازه بگیرید:
curl -s -o /dev/null \
  -w 'connect=%{time_connect} starttransfer=%{time_starttransfer} total=%{time_total}\n' \
  http://127.0.0.1:3000/api/report
اگر time_starttransfer بسیار بالا باشد، Backend قبل از ارسال Header زمان زیادی مصرف میکند.
Health Endpoint بسازید
برای سرویسهای Production بهتر است یک Endpoint سبک داشته باشید:
GET /healthتست:
curl -i http://127.0.0.1:3000/healthاگر Health Endpoint هم Fail میشود، احتمال مشکل عمومی Backend بالاست. اگر Health سالم است اما فقط یک Endpoint خاص Fail میشود، باید همان مسیر را در کد و دیتابیس بررسی کنید.
تنظیمات فعال Nginx را ببینید
گاهی فایل اشتباهی را ویرایش میکنیم یا Directive در سطح دیگری Override شده است.
کل Configuration فعال:
sudo nginx -Tبرای جستوجوی Timeoutها:
sudo nginx -T 2>&1 | grep -E 'proxy_.*timeout|fastcgi_.*timeout'بعد از هر تغییر Nginx را تست کنید
قبل از Reload:
sudo nginx -tاگر موفق بود:
sudo systemctl reload nginxReload نسبت به Restart معمولاً برای اعمال تغییر Configuration مناسبتر است، چون Workerهای جدید با تنظیم جدید بالا میآیند و Connectionهای فعال کمتر مختل میشوند.
اگر چند Upstream Server دارید
ممکن است فقط یکی از Backendها خراب باشد.
مثال:
upstream api_backend {
    server 10.0.0.11:3000;
    server 10.0.0.12:3000;
    server 10.0.0.13:3000;
}
هر Backend را جدا تست کنید:
curl -v http://10.0.0.11:3000/health
curl -v http://10.0.0.12:3000/health
curl -v http://10.0.0.13:3000/health
اگر یکی Fail میشود، مشکل Load Balancer نیست؛ همان Node باید بررسی شود.
proxy_next_upstream چه کاربردی دارد؟
Nginx میتواند در برخی خطاها Request را به Upstream دیگری بفرستد:
proxy_next_upstream error timeout http_502 http_503 http_504;اما این Directive جای تعمیر Backend خراب را نمیگیرد. همچنین اگر بخشی از پاسخ قبلاً برای Client ارسال شده باشد، Nginx دیگر نمیتواند بهسادگی Request را از ابتدا روی Backend دیگری ادامه دهد.
CPU، RAM و Disk را هنگام خطا بررسی کنید
وضعیت کلی:
uptime
free -h
df -h
Processهای پرمصرف:
ps aux --sort=-%mem | head
ps aux --sort=-%cpu | head
اگر Disk پر شده باشد، Backend ممکن است نتواند فایل موقت، Log، Session یا دیتای لازم را بنویسد.
خطا را کنترلشده بازتولید کنید
برای Endpoint مشکلدار:
curl -vk https://example.com/api/reportهمزمان در Terminal دوم:
sudo tail -f /var/log/nginx/error.logو در Terminal سوم:
sudo journalctl -u myapp -fاین روش معمولاً سریعتر از تغییر تصادفی Configuration است؛ چون دقیقاً میبینید هنگام Request چه اتفاقی برای Backend میافتد.
ترتیب پیشنهادی عیبیابی
- زمان و Upstream خطا را از Nginx Error Log بردارید.
- Backend را مستقیم با
curlتست کنید. - مطمئن شوید Backend همچنان Listen میکند.
- لاگ Backend را در همان زمان بخوانید.
- Restart، Crash یا OOM را بررسی کنید.
- Timeout خود Backend را بررسی کنید.
- بعد از سالم بودن Backend، Timeoutهای Nginx را بررسی کنید.
- اگر Docker است، Restart Count و OOMKilled را بررسی کنید.
- اگر فقط یک Endpoint خراب است، همان Route یا Query را تحلیل کنید.
- پس از هر تغییر، با
nginx -tو تست مستقیم نتیجه را تأیید کنید.
اجرای Nginx و Backend روی VPS
اگر برای Reverse Proxy، Docker، Node.js، Python، PHP-FPM یا سرویس API به زیرساخت لینوکسی نیاز دارید، میتوانید پلنهای خرید سرور مجازی ایران ایرانیکاسرور را بررسی کنید. برای سرویسهای Production بهتر است Nginx، Backend، Monitoring و Backup با ساختار مشخص و قابلعیبیابی راهاندازی شوند.
تماس با پشتیبانی ایرانیکاسرور: 021-91302467
Rollback؛ اگر تغییر Timeout نتیجه بدتری داد
قبل از ویرایش فایل Nginx از آن بکاپ بگیرید:
sudo cp /etc/nginx/sites-available/example.com \
  /etc/nginx/sites-available/example.com.backup
برای بازگرداندن:
sudo cp /etc/nginx/sites-available/example.com.backup \
  /etc/nginx/sites-available/example.com
بعد:
sudo nginx -t
sudo systemctl reload nginx
اگر Backend بدون دلیل مشخص قطع میشود
اگر لاگ Nginx فقط قطعشدن Upstream را نشان میدهد و تشخیص Crash، OOM، Docker Restart، PHP-FPM یا systemd Service برایتان دشوار است، میتوانید از خدمات کانفیگ و عیبیابی سرور ایرانیکاسرور استفاده کنید.
تماس با پشتیبانی ایرانیکاسرور: 021-91302467
اشتباههای رایج
- زیاد کردن فوری
proxy_read_timeoutبدون خواندن لاگ Backend؛ - Restart کردن Nginx در حالی که Backend Crash میکند؛
- نادیده گرفتن OOM Killer؛
- بررسی نکردن Restart Count کانتینر؛
- بالا بردن تعداد PHP-FPM Workerها بدون محاسبه RAM؛
- یکی گرفتن
Connection refusedباprematurely closed connection؛ - استفاده از Timeout بسیار بزرگ برای پنهان کردن Query کند؛
- تست نکردن Upstream بهصورت مستقیم؛
- ویرایش فایل اشتباه Nginx بدون بررسی
nginx -T؛ - Reload کردن Configuration بدون اجرای
nginx -t.
سؤالات متداول
خطای upstream prematurely closed connection دقیقاً یعنی چه؟
یعنی Nginx در حال خواندن پاسخ از Upstream بوده اما Connection قبل از کاملشدن بخش مورد انتظار بسته شده است. علت معمولاً در Backend، Worker، Timeout، Crash یا لایه شبکه بین Nginx و Upstream است.
آیا افزایش proxy_read_timeout همیشه مشکل را حل میکند؟
خیر. اگر Backend Crash، Restart یا OOM شده باشد، افزایش Timeout اثری ندارد. این تنظیم زمانی مفید است که Backend سالم باشد اما بین دو بخش پاسخ بیش از Timeout تعیینشده فاصله بیفتد.
چطور بفهمیم مشکل از Nginx است یا Backend؟
Upstream را مستقیم با curl تست کنید و همزمان لاگ Backend را بخوانید. اگر Direct Request هم Fail میشود یا Backend Restart میشود، علت اصلی سمت Backend است.
چرا این خطا همراه 502 Bad Gateway دیده میشود؟
وقتی Nginx نتواند پاسخ معتبر و کامل از Upstream بگیرد، ممکن است برای Client پاسخ 502 برگرداند. خط دقیق داخل Error Log مشخص میکند مشکل Connection refused، Timeout یا بستهشدن زودهنگام بوده است.
در Docker چه چیزی را بررسی کنیم؟
لاگ Container، Restart Count، مقدار OOMKilled، Health Check و دسترسی شبکه بین Nginx و Service را بررسی کنید. اگر Container مرتب Restart میشود، ابتدا دلیل همان Restart را حل کنید.
برای PHP-FPM از proxy_read_timeout استفاده کنیم؟
خیر. ارتباط معمول Nginx با PHP-FPM از FastCGI استفاده میکند و Directive مرتبط fastcgi_read_timeout است. همزمان Timeoutهای PHP و PHP-FPM نیز باید بررسی شوند.
اگر فقط درخواستهای سنگین این خطا را میدهند چه کنیم؟
زمان پاسخ Backend، مصرف RAM، Queryهای دیتابیس، Worker Timeout و Timeout Nginx را بررسی کنید. اگر Endpoint چند دقیقه پردازش میکند، بهتر است در بعضی معماریها کار سنگین به Queue منتقل شود و Request وب سریعتر پاسخ دهد.
آیا Reload کردن Nginx Connectionهای فعال را قطع میکند؟
Reload معمولاً Workerهای جدید را با Configuration تازه راهاندازی میکند و Workerهای قبلی اجازه مییابند درخواستهای جاری را کامل کنند؛ به همین دلیل برای اعمال Configuration معمولاً از Reload استفاده میشود.
جمعبندی: خطای upstream prematurely closed connection را نباید صرفاً با افزایش Timeout درمان کرد. اول Request مشکلدار را از Error Log پیدا کنید، Upstream را مستقیم تست کنید و لاگ Backend را در همان لحظه بخوانید. Crash، OOM، Restart Worker، Timeout خود برنامه و مشکل Docker از علتهای مهم هستند. فقط وقتی مطمئن شدید Backend سالم اما کند است، Timeoutهای Nginx را متناسب با رفتار واقعی سرویس تنظیم کنید.
دیدگاهها (۰)