
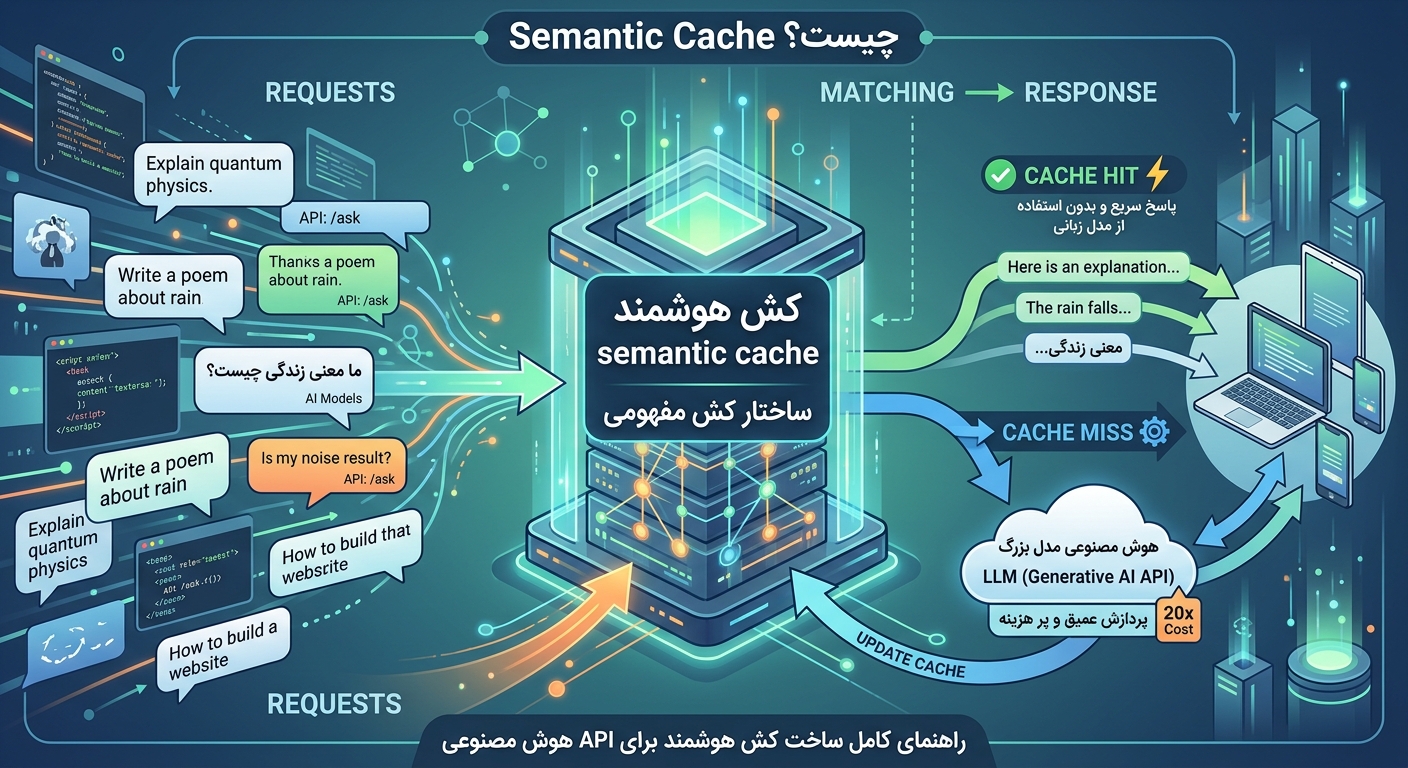
اگر از API هوش مصنوعی استفاده میکنید، احتمالاً با این مشکل آشنا هستید: کاربران سوالات تکراری میپرسند، اما با کلمات متفاوت. «چطور رمزمو عوض کنم؟» و «رمزمو فراموش کردم چیکار کنم؟» هر دو یک معنا دارند، ولی سیستم شما هر بار یک درخواست کامل به مدل زبانی میفرستد. نتیجه؟ هزینه بالا، تأخیر زیاد و مصرف بیرویه منابع سرور.
Semantic Cache (کش معنایی) دقیقاً برای حل همین مشکل طراحی شده است. برخلاف کشهای سنتی که فقط به تطابق دقیق متن پاسخ میدهند، کش معنایی مشابهت معنایی را تشخیص میدهد و پاسخهای قبلی را برای سوالات مشابه بازمیگرداند.
📌 در این مقاله یاد میگیرید:
🔹 Semantic Cache دقیقاً چیست و چه تفاوتی با Prompt Cache دارد
🔹 چطور با Redis و Embedding یک کش معنایی بسازید
🔹 تنظیم آستانه شباهت (Similarity Threshold) برای دقت و بازدهی بهینه
🔹 چه زمانی Semantic Cache مناسب است و چه زمانی خطرناک
🔹 چطور روی سرور مجازی ایرانیکاسرور این زیرساخت را راهاندازی کنید
Semantic Cache چیست؟ تعریف دقیق و تفاوت با کش سنتی
کش سنتی (Exact Match Cache) بر اساس تطابق دقیق رشته کار میکند. اگر دو درخواست حتی یک کاراکتر تفاوت داشته باشند، کش hit نمیشود. اما Semantic Cache از جستجوی شباهت برداری (Vector Similarity Search) استفاده میکند.
فرآیند کار به این صورت است: ابتدا درخواست کاربر به یک بردار عددی (Embedding) تبدیل میشود. سپس سیستم در پایگاه داده برداری جستجو میکند و اگر برداری با شباهت بالای آستانه تعیینشده پیدا شود، پاسخ ذخیرهشده بازگردانده میشود—بدون فراخوانی مدل زبانی.
این یعنی پاسخ در میلیثانیه برگردانده میشود، نه ثانیهها. و هزینه توکن مصرفی صفر است.
تفاوت کلیدی Semantic Cache با Prompt Cache
Prompt Cache یک قابلیت سمت ارائهدهنده مدل است (مثل Anthropic و OpenAI) که بخشهای ثابت پرامپت را کش میکند. در مقابل، Semantic Cache در لایه اپلیکیشن شما عمل میکند و کل پاسخ را برای سوالات مشابه کش میکند.
| معیار | Prompt Cache | Semantic Cache |
|---|---|---|
| چه چیزی کش میشود | پیشوندهای ثابت پرامپت | کل پاسخ برای سوالات مشابه |
| محل اجرا | سمت ارائهدهنده مدل | سمت اپلیکیشن شما |
| معیار hit | تطابق دقیق توکنها | شباهت معنایی بالای آستانه |
| صرفهجویی | تا ۹۰٪ تخفیف توکن ورودی | ۱۰۰٪ (بدون فراخوانی مدل) |
| ریسک کیفیت | تقریباً صفر | متوسط (بسته به آستانه) |
| نرخ hit در عمل | ۸۰-۹۵٪ | ۲۰-۴۵٪ |
نکته مهم: این دو جایگزین یکدیگر نیستند. بهترین استراتژی استفاده از هر دو به صورت همزمان است.
🚀 زیرساخت اجرای API هوش مصنوعی خود را روی سرور مجازی ایرانیکاسرور راهاندازی کنید
اگر قصد دارید Semantic Cache را برای API خود پیادهسازی کنید، به یک سرور مجازی با منابع اختصاصی CPU و RAM، دیسک NVMe پرسرعت برای Redis و پایگاه داده برداری، و پهنای باند پایدار نیاز دارید. سرورهای مجازی ایرانیکاسرور با آپتایم بالا و پشتیبانی ۲۴/۷، بستر ایدهآلی برای اجرای سرویسهای هوش مصنوعی و کش معنایی فراهم میکنند.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
Semantic Cache چطور کار میکند؟ گامبهگام
برای درک عمیقتر، بیایید چرخه کامل یک درخواست را بررسی کنیم.
گام ۱: دریافت و Embedding درخواست
کاربر سوالی میپرسد. سیستم این سوال را به یک مدل Embedding میفرستد (مثل all-MiniLM-L6-v2 یا مدلهای OpenAI). خروجی یک بردار عددی با ابعاد مشخص است (معمولاً ۳۸۴ یا ۱۵۳۶ بعد).
گام ۲: جستجوی شباهت برداری
بردار جدید در پایگاه داده برداری (مثل Redis با قابلیت Vector Search، Qdrant، یا Pinecone) جستجو میشود. سیستم نزدیکترین بردارهای ذخیرهشده را برمیگرداند و امتیاز شباهت هرکدام را محاسبه میکند.
گام ۳: تصمیمگیری بر اساس آستانه شباهت
اگر بالاترین امتیاز شباهت از آستانه تعیینشده (مثلاً ۰.۹۵) بیشتر باشد، Cache Hit رخ میدهد و پاسخ ذخیرهشده بازگردانده میشود. در غیر این صورت، Cache Miss رخ داده و سیستم به مدل زبانی اصلی درخواست میفرستد.
گام ۴: ذخیرهسازی پاسخ جدید
پس از دریافت پاسخ از مدل، جفت (بردار درخواست، پاسخ) در پایگاه داده ذخیره میشود تا در درخواستهای آینده قابل استفاده باشد.
تنظیم آستانه شباهت: حیاتیترین تصمیم پیادهسازی
آستانه شباهت (Similarity Threshold) تعیین میکند که چه چیزی به عنوان «مشابه» در نظر گرفته شود. این یک مبادله بنیادین بین دقت و بازدهی است.
| آستانه | رفتار | نرخ hit تقریبی | ریسک خطا |
|---|---|---|---|
| ۰.۹۹ | فقط تطابقهای تقریباً دقیق | کم | بسیار پایین |
| ۰.۹۵ | پارافرازهای نزدیک را میگیرد | ~۴۰٪ | پایین |
| ۰.۹۰ | تنوعهای گستردهتر | ~۵۵٪ | متوسط |
| ۰.۸۵ | سوالات متفاوت ممکن است match شوند | ~۷۵٪ | بالا |
⚠️ هشدار مهم: در کاربردهای حساس (پزشکی، حقوقی، مالی) از آستانه ۰.۹۵ به بالا استفاده کنید. در چتباتهای پشتیبانی عمومی، ۰.۹۰ معمولاً تعادل خوبی است. هرگز بدون ارزیابی مستمر، آستانه را پایین نیاورید.
پیادهسازی Semantic Cache با Redis و Python
Redis یکی از محبوبترین گزینهها برای پیادهسازی Semantic Cache است. دلیلش واضح است: جستجوی برداری درونساخت، تأخیر زیر میلیثانیه و اکوسیستم بالغ.
پیشنیازها
برای شروع به این موارد نیاز دارید:
🔹 یک سرور مجازی با حداقل ۴ گیگابایت RAM (برای Redis و مدل Embedding)
🔹 Redis Stack یا Redis با ماژول RediSearch نصبشده
🔹 پایتون ۳.۹ به بالا
🔹 کتابخانههای redis-py، sentence-transformers و numpy
نصب کتابخانهها
در ترمینال سرور خود اجرا کنید:
pip install redis openai sentence-transformers numpyساخت ایندکس برداری در Redis
ابتدا ایندکس برداری را ایجاد میکنیم. این ایندکس با الگوریتم HNSW کار میکند که جستجوی تقریبی نزدیکترین همسایه را با پیچیدگی O(log N) فراهم میکند:
import redis
import numpy as np
from sentence_transformers import SentenceTransformer

r = redis.Redis(host='localhost', port=6379, decode_responses=False)
embedder = SentenceTransformer('all-MiniLM-L6-v2')

# ساخت ایندکس برداری با HNSW
r.execute_command(
    'FT.CREATE', 'semantic_cache_idx',
    'ON', 'HASH',
    'PREFIX', '1', 'cache:sem:',
    'SCHEMA',
    'prompt', 'TEXT',
    'response', 'TEXT',
    'embedding', 'VECTOR', 'HNSW', '6',
    'TYPE', 'FLOAT32', 'DIM', '384',
    'DISTANCE_METRIC', 'COSINE'
)پیادهسازی تابع کش معنایی
حالا تابع اصلی که درخواستها را مدیریت میکند:
import hashlib
import json
import numpy as np
def embed_text(text: str) -> bytes:
"""تبدیل متن به بردار ۳۸۴ بعدی"""
vec = embedder.encode(text, normalize_embeddings=True)
return vec.astype(np.float32).tobytes()
SIMILARITY_THRESHOLD = 0.12 # فاصله کسینوسی؛ کمتر = سختگیرتر
def semantic_cache_lookup(prompt: str) -> str | None:
"""جستجوی پاسخ کششده بر اساس شباهت معنایی"""
query_vec = embed_text(prompt)
result = r.execute_command(
'FT.SEARCH', 'semantic_cache_idx',
'*=>[KNN 1 @embedding $vec AS score]',
'PARAMS', 2, 'vec', query_vec,
'RETURN', 3, 'prompt', 'response', 'score',
'SORTBY', 'score',
'DIALECT', 2
)
if result[0] > 0:
raw = result[2]
fields = {}
for j in range(0, len(raw), 2):
fields[raw[j].decode()] = raw[j+1].decode()
score = float(fields.get('score', 1.0))
if score < SIMILARITY_THRESHOLD:
return fields['response'] # Cache Hit
return None # Cache Missدر این کد، فاصله کسینوسی (Cosine Distance) معیار مقایسه است. هرچه مقدار کمتر باشد، شباهت بیشتر است. آستانه ۰.۱۲ در این مثال معادل شباهت حدود ۰.۸۸ است.
ذخیره پاسخ جدید در کش
def semantic_cache_store(prompt: str, response: str, ttl: int = 3600):
    """ذخیره جفت (پرامپت، پاسخ) در کش معنایی"""
    vec = embed_text(prompt)
    key = f"cache:sem:{hashlib.sha256(prompt.encode()).hexdigest()[:16]}"

    r.hset(key, mapping={
        'prompt': prompt,
        'response': response,
        'embedding': vec
    })
    r.expire(key, ttl)  # انقضای کش پس از یک ساعت
مدیریت TTL: پاسخها چقدر باید در کش بمانند؟
زمان انقضا (Time-To-Live) یکی دیگر از پارامترهای حیاتی است. پاسخهای ثابت میتوانند مدت طولانیتری در کش بمانند، اما دادههای پویا باید سریعتر منقضی شوند:
| نوع داده | TTL پیشنهادی | دلیل |
|---|---|---|
| مستندات و سیاستها | ۲۴ ساعت | تغییرات نادر |
| اطلاعات محصول | ۱۲-۲۴ ساعت | بروزرسانی روزانه |
| پاسخهای عمومی دستیار | ۱-۴ ساعت | تعادل تازگی و بازدهی |
| دادههای زنده (قیمت، موجودی) | ۵-۱۵ دقیقه | تغییرات سریع |
🛠️ باگ یا خطای پیادهسازی Semantic Cache دارید؟
تیم فنی ایرانیکاسرور آماده کمک به شماست. اگر در تنظیم Redis Vector Search، انتخاب مدل Embedding، یا هر مرحله دیگری از پیادهسازی کش معنایی به مشکل خوردهاید، درخواست خود را ثبت کنید. کارشناسان ما در سریعترین زمان ممکن پاسخگو خواهند بود.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
چه زمانی Semantic Cache مناسب است و چه زمانی خطرناک؟
Semantic Cache یک راهحل همهکاره نیست. در برخی سناریوها عالی عمل میکند و در برخی دیگر میتواند فاجعهبار باشد.
سناریوهای ایدهآل
🔹 چتباتهای پشتیبانی مشتری: کاربران یک سوال را به ۵۰ شکل مختلف میپرسند. کش معنایی ۵۰ رشته را به یک پاسخ تبدیل میکند. نرخ hit معمول: ۳۰-۴۵٪.
🔹 رباتهای پرسش و پاسخ مستندات: سوالات معتبر زیاد، پاسخهای معتبر محدود. اینجا کش معنایی فشردهسازی عالی انجام میدهد.
🔹 ابزارهای داخلی سازمانی: کارمندان سوالات مشابهی میپرسند («هفته پیش چند ثبتنام داشتیم؟» و «تعداد اکانتهای جدید ۷ روز گذشته؟»). هزینه پاسخ اشتباه پایین است.
سناریوهایی که باید از Semantic Cache اجتناب کنید
⚠️ در این موارد هرگز Semantic Cache را فعال نکنید:
🔹 تولید محتوای خلاقانه: «یک شعر درباره گربه بنویس» و «یک شعر درباره گربه من بنویس» شباهت بالایی دارند اما باید کاملاً متفاوت باشند.
🔹 تولید کد: «مرتبسازی صعودی آرایه» و «مرتبسازی نزولی آرایه» ۰.۹۴ مشابه هستند اما کد کاملاً متفاوتی نیاز دارند.
🔹 صنایع حساس (پزشکی، حقوقی، مالی): نرخ خطای ۳-۷٪ در این حوزهها غیرقابل قبول است.
🔹 محتوای شخصیسازیشده: پاسخهایی که به دادههای خصوصی کاربر وابسته هستند نباید هرگز کش شوند.
برای این سناریوها، Prompt Cache گزینه امنتری است. Prompt Cache ریسک پاسخ اشتباه ندارد چون تطابق دقیق پیشوند را بررسی میکند.
بهترین استراتژی: لایهبندی چندگانه کش
بهترین رویکرد ترکیب چند لایه کش است. هر لایه بخشی از تکرارها را شکار میکند:
📌 لایه ۱: Exact Match Cache — درخواستهای کاملاً یکسان را کش میکند. سریع، ساده، بدون ریسک. معمولاً ۵-۲۰٪ نرخ hit در چت عمومی.
📌 لایه ۲: Semantic Cache — درخواستهای مشابه معنایی را کش میکند. ۲۰-۴۵٪ نرخ hit اضافه.
📌 لایه ۳: Prompt Cache — پیشوندهای ثابت پرامپت را کش میکند. ۸۰-۹۵٪ توکنهای ورودی را پوشش میدهد.
با ترکیب این سه لایه، میتوانید تا ۷۰٪ کاهش هزینه در فراخوانیهای API هوش مصنوعی داشته باشید.
⚡ زیرساخت بهینه برای کش معنایی و هوش مصنوعی
برای اجرای Redis، مدلهای Embedding و APIهای هوش مصنوعی، به سروری با دیسک NVMe پرسرعت (برای I/O پایین Redis)، رم کافی (حداقل ۸ گیگ برای بار تولیدی) و پهنای باند پایدار نیاز دارید. سرورهای مجازی ایرانیکاسرور با منابع اختصاصی و آپتایم ۹۹.۹٪، انتخاب حرفهایها برای میزبانی سرویسهای AI است.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
ابزارها و کتابخانههای Semantic Cache
اگر نمیخواهید همهچیز را از صفر بسازید، این ابزارها آماده استفاده هستند:
🔹 GPTCache — محبوبترین کتابخانه متنباز Semantic Cache. جایگزین drop-in برای کلاینت OpenAI.
🔹 Redis LangCache — راهحل مدیریتشده Redis برای کش معنایی.
🔹 RedisVL — کتابخانه پایتون Redis برای جستجوی برداری و کش معنایی.
🔹 LangChain RedisSemanticCache — ادغام Redis با LangChain.
نکات عملیاتی برای تولید
پایش و اندازهگیری مداوم
بدون ارزیابی مستمر، Semantic Cache یک «سلاح پرخطا» است. حداقل کارهایی که باید انجام دهید:
🔹 نمونهگیری ۱-۵٪ از cache hitها و بررسی انسانی یا با LLM-as-Judge
🔹 محاسبه نرخ خطای مثبت کاذب (False Positive) به صورت هفتگی
🔹 ثبت لاگ کامل از امتیاز شباهت هر cache hit
🔹 A/B تست برای تنظیم دقیق آستانه شباهت
پارتیشنبندی کش
هرگز یک کش مشترک بدون پارتیشن برای همه کاربران استفاده نکنید. پاسخها را بر اساس این معیارها جدا کنید:
🔹 شناسه مستأجر (Tenant ID)
🔹 شناسه کاربر
🔹 نسخه مدل
🔹 نسخه قالب پرامپت
این کار از نشت داده بین کاربران و بازگشت پاسخهای ناسازگار جلوگیری میکند.
جمعبندی
Semantic Cache یک راهحل قدرتمند برای کاهش هزینه و تأخیر APIهای هوش مصنوعی است. با تبدیل درخواستها به بردار و جستجوی شباهت، میتوانید پاسخهای قبلی را برای سوالات مشابه بازگردانید—بدون فراخوانی مدل زبانی.
نکات کلیدی:
🔹 آستانه شباهت ۰.۹۵ برای کاربردهای حساس و ۰.۹۰ برای چتباتهای عمومی مناسب است
🔹 Semantic Cache برای سوالات تکراری عالی است، اما برای تولید محتوای خلاقانه خطرناک
🔹 بهترین استراتژی ترکیب Exact Match + Semantic + Prompt Cache است
🔹 Redis با قابلیت Vector Search بهترین انتخاب برای پیادهسازی است
🔹 پایش مستمر نرخ خطا برای استفاده تولیدی الزامی است
با پیادهسازی صحیح، میتوانید تا ۷۰٪ کاهش هزینه و پاسخهای زیر ۲۰۰ میلیثانیه برای درخواستهای تکراری داشته باشید. این یعنی تجربه کاربری بهتر و مصرف بهینهتر منابع سرور.
برای راهاندازی زیرساخت هوش مصنوعی خود روی سرور مجازی ایرانیکاسرور با منابع اختصاصی و پشتیبانی ۲۴/۷، همین حالا اقدام کنید. تیم فنی ما آماده مشاوره رایگان برای انتخاب پلن مناسب است.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.