
 Amir Jabbari
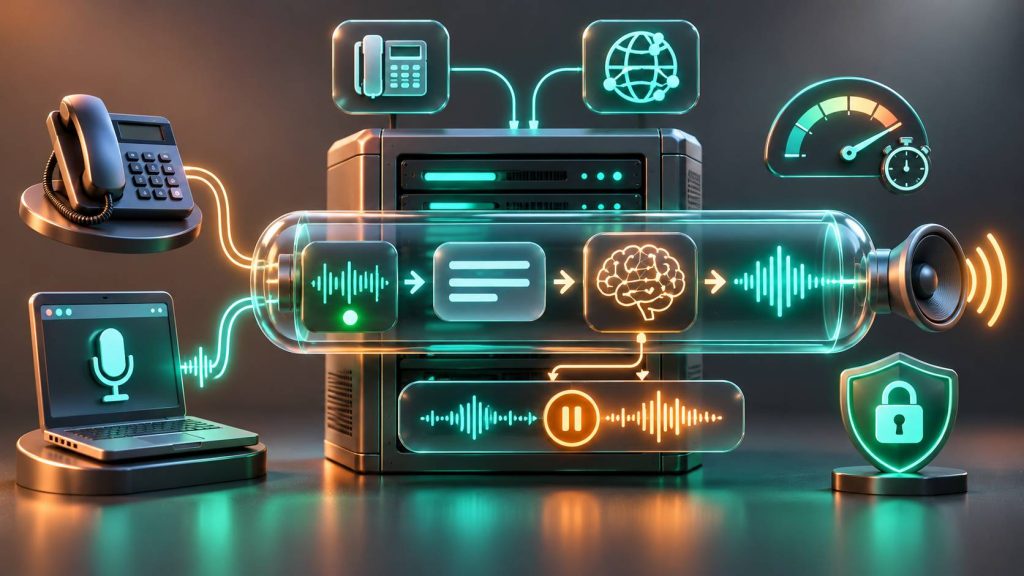
تصور کنید مشتری با شماره تلفن پشتیبانی یک شرکت تماس میگیرد و بهجای انتظار در صف، یک دستیار هوش مصنوعی به زبان طبیعی با او صحبت میکند. مشتری مشکل خود را توضیح میدهد، سیستم صدای او را تشخیص میدهد، اطلاعات لازم را بررسی میکند و با صدایی طبیعی پاسخ میدهد. اگر مشتری وسط پاسخ سؤال دیگری بپرسد، دستیار نیز باید صحبت خود را متوقف کند و به سؤال جدید گوش دهد.
ساخت چنین سیستمی فقط به اتصال یک مدل زبانی به میکروفون محدود نمیشود. برای راهاندازی Voice AI Agent Server یا سرور Agent صوتی، باید مجموعهای از فناوریهای پردازش صوت، ارتباط بلادرنگ، تشخیص پایان صحبت، مدیریت مکالمه و کنترل تأخیر با یکدیگر هماهنگ شوند.
در یک معماری رایج، صدای کاربر به کمک STT به متن تبدیل میشود، مدل زبانی یا LLM پاسخ را تولید میکند و موتور TTS متن پاسخ را دوباره به صوت تبدیل میکند. سپس خروجی از طریق WebRTC یا مسیر تماس تلفنی به کاربر بازگردانده میشود.
در این مقاله یاد میگیریم Agent صوتی چگونه کار میکند، چه تفاوتی با چتبات متنی دارد، معماری STT، LLM و TTS چگونه طراحی میشود و چه نقشی در آن VAD، Barge-in، Latency Budget، SIP، WebRTC و Privacy دارند. در ادامه نیز یک نمونه عملی Python بر پایه LiveKit Agents میسازیم.
Voice AI Agent چیست؟
Voice AI Agent یک دستیار نرمافزاری مبتنی بر هوش مصنوعی است که میتواند صدای انسان را دریافت کند، محتوای مکالمه را بفهمد، در صورت نیاز از ابزارها و دادههای دیگر استفاده کند و پاسخ را بهصورت صوتی برگرداند.
برخلاف چتبات متنی، کاربر در این سیستم منتظر تایپ یا نمایش متن نیست؛ بلکه انتظار دارد مکالمه مانند یک تماس طبیعی پیش برود.
برای مثال، یک Agent صوتی میتواند در شرایط مناسب وظایف زیر را انجام دهد:
- پاسخگویی به پرسشهای عمومی مشتریان.
- راهنمایی کاربران برای استفاده از خدمات.
- بررسی وضعیت سفارش از طریق یک API محدود و احراز هویتشده.
- راهنمایی اولیه در پشتیبانی فنی.
- رزرو یا ثبت درخواست با تأیید کاربر.
- انتقال تماس به اپراتور انسانی در شرایط مشخص.
نکته مهم این است که Voice Agent فقط صدای مصنوعی تولید نمیکند. باید وضعیت مکالمه، نوبت صحبت کاربران، وقفهها، زمان اجرا و مجوز اجرای ابزارها را نیز مدیریت کند.
اجزای اصلی معماری Agent صوتی روی سرور
یک سیستم تماس زنده با هوش مصنوعی معمولاً شامل اجزای زیر است:
| جزء | وظیفه |
|---|---|
| Audio Transport | انتقال صدای کاربر و پاسخ از طریق WebRTC، SIP یا Media Gateway |
| VAD | تشخیص وجود گفتار در سیگنال صوتی |
| Turn Detection | تشخیص اینکه کاربر حرف خود را تمام کرده است یا خیر |
| STT | تبدیل گفتار کاربر به متن |
| LLM | درک درخواست، مدیریت مکالمه و تولید پاسخ |
| Tool Gateway | دسترسی کنترلشده به اطلاعات و APIهای کسبوکار |
| TTS | تبدیل پاسخ متنی به گفتار |
| Playback Controller | پخش صوت، مدیریت بافر و قطع پاسخ هنگام ورود کاربر |
| Observability | ثبت تأخیر، خطا، مصرف منابع و وضعیت تماس |
در طراحی صحیح، هرکدام از این اجزا باید وظیفه مشخصی داشته باشند و خرابی یک سرویس نباید کل زیرساخت تماس را بدون کنترل درگیر کند.
معماری Realtime Pipeline با STT، LLM و TTS
در معماری Cascaded Pipeline، خروجی یک مرحله وارد مرحله بعدی میشود؛ اما برای کاهش تأخیر میتوان بخشهای مختلف را بهصورت Streaming پردازش کرد.
Caller / Browser Microphone
             |
             v
       SIP / WebRTC
             |
             v
       Audio Gateway
             |
             v
      Audio Frames + VAD
             |
             v
       Streaming STT
             |
             v
      Turn Detection
             |
             v
       LLM + Tools
             |
             v
       Streaming TTS
             |
             v
     Playback Controller
             |
             v
        Caller / User

Side channels:
- Barge-in detection
- Session state
- Latency metrics
- Privacy & consent
- Audit and monitoring
اگر تمام مراحل منتظر تکمیل مرحله قبلی بمانند، پاسخ میتواند بیش از حد کند شود.
برای مثال، Streaming STT ممکن است در طول صحبت کاربر متن موقت تولید کند. همچنین LLM میتواند متن را بهصورت تدریجی تولید کند و TTS، در صورت پشتیبانی، قبل از تکمیل کل پاسخ شروع به ساخت صوت کند.
بااینحال، باید بین متن موقت STT و متن نهایی تفاوت قائل شد. تصمیمگیری زودهنگام بر اساس متن ناپایدار میتواند پاسخ اشتباه تولید کند.
STT چیست و چه نقشی در Voice Agent دارد؟
Speech-to-Text یا STT وظیفه تبدیل صدای کاربر به متن را بر عهده دارد.
در تماس زنده، استفاده از Streaming STT معمولاً مناسبتر از ارسال یک فایل صوتی کامل بعد از پایان مکالمه است.
برای مثال، وقتی کاربر میگوید «میخواهم وضعیت سفارش قبلی را بدانم»، STT میتواند متن را تدریجی دریافت و بازسازی کند.
در انتخاب STT باید چند عامل بررسی شود:
- کیفیت تشخیص زبان فارسی و لهجه کاربران.
- تشخیص اصطلاحات فنی و نام محصولات.
- پشتیبانی از Streaming.
- زمان ارائه متن نهایی.
- پایداری در محیط شلوغ و تماس تلفنی.
- امکان تعیین زبان یا واژگان تخصصی.
- حفظ محرمانگی داده صوتی.
در تماس تلفنی، صدا معمولاً محدودیتهای بیشتری نسبت به میکروفون باکیفیت دارد؛ به همین دلیل کیفیت STT باید با نمونه تماس واقعی سنجیده شود.
LLM در Agent صوتی چه کاری انجام میدهد؟
مدل زبانی بخش تصمیمگیری مکالمه است. پس از دریافت متن کاربر، مدل میتواند پاسخ تولید کند یا برای انجام یک کار مشخص از ابزار مجاز استفاده کند.
برای مثال، اگر مشتری وضعیت سفارش خود را بپرسد، Agent باید پس از احراز هویت مناسب از یک ابزار محدود مانند get_order_status استفاده کند.
نباید شماره سفارش یا اطلاعات هویتی گفتهشده توسط تماسگیرنده را بدون کنترل کافی مبنای دسترسی به اطلاعات دیگران قرار داد.
در مکالمه زنده، پاسخهای کوتاه، روشن و مناسب گفتار معمولاً تجربه بهتری از پاسخهای طولانی و شبیه مقاله ایجاد میکنند.
همچنین بهتر است مدل برای مواردی مانند انجام عملیات مالی، تغییر اطلاعات حساب یا انتقال تماس از قواعد قطعی برنامه استفاده کند و تصمیمهای حساس تنها بر اساس متن تولیدی مدل اجرا نشوند.
TTS چیست و چگونه پاسخ را به صوت تبدیل میکند؟
Text-to-Speech یا TTS متن تولیدشده را به گفتار تبدیل میکند.
برای یک Agent زنده، کیفیت طبیعی بودن صدا تنها معیار انتخاب نیست. زمان تولید اولین بخش صوت یا Time to First Audio نیز اهمیت زیادی دارد.
موتوری که صدای بسیار طبیعی تولید کند اما آغاز پاسخ آن چند ثانیه طول بکشد، ممکن است برای مکالمه تلفنی مناسب نباشد.
در انتخاب TTS بهتر است موارد زیر بررسی شوند:
- کیفیت گفتار فارسی و تلفظ نامها.
- امکان تولید صوت بهصورت Streaming.
- زمان رسیدن اولین Chunk صوتی.
- فرمت و نرخ نمونهبرداری خروجی.
- امکان لغو تولید هنگام Barge-in.
- هزینه هر دقیقه یا کاراکتر.
- محدودیتهای مجوز تجاری و استفاده از صدا.
اگر خروجی TTS با فرمت تماس تلفنی سازگار نباشد، ممکن است نیاز به Transcoding باشد که خود میتواند مصرف CPU و تأخیر اضافی ایجاد کند.
Cascaded Pipeline بهتر است یا مدل صوتی Realtime؟
در سال ۲۰۲۶ تنها راه ساخت Agent صوتی، استفاده از سه مدل مستقل نیست. بعضی سرویسها ورودی صوتی را مستقیماً دریافت و خروجی صوتی تولید میکنند.
| معماری | مزیت | محدودیت |
|---|---|---|
| STT → LLM → TTS | قابلیت جایگزینی هر جزء، مشاهده متن و کنترل بیشتر | پیچیدگی هماهنگی و تأخیر چندمرحلهای |
| Realtime Speech-to-Speech | مسیر صوتی یکپارچهتر و امکان کاهش تأخیر | کنترل و مشاهده هر مرحله وابسته به ارائهدهنده |
| Full-Duplex Voice Model | امکان گوشدادن و صحبتکردن همزمان در مدلهای پشتیبانیشده | پیچیدگی مدیریت نوبت، هزینه و قابلیتهای مدل |
اگر پروژه به ثبت دقیق متن، کنترل ابزارها و جابهجایی آسان سرویس STT یا TTS نیاز دارد، معماری Cascaded انتخاب قابل دفاعی است.
اگر اولویت اصلی، مکالمه طبیعی با تأخیر بسیار کم باشد، بررسی مدلهای صوتی بلادرنگ نیز منطقی است.
منابع:
انواع Voice Pipeline در LiveKit و
مستندات Realtime API.
Latency Budget در تماس صوتی چیست؟
Latency Budget یعنی تعیین کنیم هر مرحله از مسیر مکالمه حداکثر چه سهمی از زمان پاسخ را میتواند مصرف کند.
در Agent صوتی، زمان بین پایان صحبت کاربر و شنیدن اولین صدای پاسخ اهمیت ویژهای دارد.
برای تحلیل این زمان، باید تأخیر انتقال صدا، تشخیص پایان نوبت، STT، اولین خروجی LLM، اولین خروجی TTS و بافر پخش را اندازهگیری کرد.
جدول زیر یک بودجه طراحی فرضی است و نتیجه اندازهگیری یک سرویس واقعی محسوب نمیشود.
| مرحله | بودجه فرضی |
|---|---|
| انتقال و دریافت صدا | ۶۰ میلیثانیه |
| تشخیص پایان صحبت | ۲۲۰ میلیثانیه |
| نهاییشدن متن STT | ۱۸۰ میلیثانیه |
| دریافت اولین خروجی LLM | ۲۵۰ میلیثانیه |
| تولید اولین Chunk صوت TTS | ۲۲۰ میلیثانیه |
| بافر و پخش خروجی | ۷۰ میلیثانیه |
| مجموع فرضی | ۱۰۰۰ میلیثانیه |
در معماری Streaming، مراحل ممکن است همپوشانی داشته باشند؛ بنابراین زمان واقعی پاسخ الزاماً برابر مجموع ساده این مقادیر نیست.
مهمترین معیار عملیاتی، اندازهگیری End-to-End روی تماس واقعی است، نه صرفاً جمع تأخیرهای گزارششده توسط ارائهدهندگان مدل.
چگونه تأخیر Voice Agent را کاهش دهیم؟
برای کاهش تأخیر باید تمام مسیر مکالمه بررسی شود.
- از Streaming STT و Streaming TTS در صورت پشتیبانی استفاده کنید.
- مدل و سرویس صوتی را در منطقه شبکهای مناسب مستقر کنید.
- اتصالهای پایدار و Warm Connection را در صورت امکان حفظ کنید.
- اولین پاسخ مدل را کوتاه و مناسب گفتار طراحی کنید.
- فراخوانی ابزارهای کند را محدود و دارای Timeout کنید.
- از ارسال تاریخچه بسیار طولانی مکالمه در هر Turn خودداری کنید.
- تعداد تبدیلهای غیرضروری Codec و Sample Rate را کاهش دهید.
- از بافرهای بزرگ و صف خروجی نامحدود استفاده نکنید.
- P50 و P95 زمان اولین صدای پاسخ را ثبت کنید.
کاهش بیش از حد زمان تشخیص پایان صحبت نیز میتواند باعث شود Agent وسط مکث طبیعی کاربر پاسخ دهد. بنابراین کاهش Latency باید همراه با آزمون کیفیت Turn Detection باشد.
VAD چیست و چگونه متوجه صحبت کاربر میشویم؟
Voice Activity Detection یا VAD روشی برای تشخیص وجود گفتار در سیگنال صوتی است.
VAD معمولاً بررسی میکند آیا در بازه زمانی مشخص، صدای انسان وجود دارد یا خیر.
این کار در Voice Agent برای موارد زیر مفید است:
- تشخیص شروع صحبت کاربر.
- تشخیص سکوت و مکث.
- کاهش پردازش بخشهای بدون گفتار.
- فعالکردن منطق Barge-in.
- کمک به تشخیص پایان نوبت مکالمه.
اما VAD بهتنهایی نمیداند که جمله کاربر از نظر معنایی تمام شده است.
برای مثال، کاربری ممکن است بگوید «میخواستم درباره سفارش…» و یک لحظه مکث کند. VAD ممکن است سکوت را تشخیص دهد، ولی کاربر هنوز حرفش را کامل نکرده باشد.
تفاوت VAD و Turn Detection چیست؟
Turn Detection مشخص میکند آیا نوبت صحبت کاربر واقعاً تمام شده و Agent میتواند پاسخ دهد.
در سادهترین روش، بعد از چند صد میلیثانیه سکوت، نوبت کاربر پایانیافته فرض میشود.
اما روشهای پیشرفتهتر از نشانههای صوتی و محتوای گفتار برای تخمین پایان نوبت استفاده میکنند.
این تفاوت در مکالمه طبیعی بسیار مهم است. کاربر ممکن است مکث کند، جمله خود را اصلاح کند یا پیش از پایان صحبت چند لحظه ساکت بماند.
در LiveKit، تنظیمات Turn Handling شامل Endpointing و Interruption است و میتوان شیوه تشخیص پایان صحبت را مطابق نیاز پروژه تنظیم کرد.
منبع:
LiveKit Turn-Taking Tuning.
Barge-in چیست و چرا برای تماس زنده ضروری است؟
Barge-in زمانی اتفاق میافتد که کاربر وسط صحبت Agent شروع به حرفزدن کند و انتظار داشته باشد سیستم فوراً به او گوش دهد.
برای مثال، Agent در حال توضیح شرایط یک سرویس است و کاربر میگوید «نه، منظورم پلن دیگری بود».
اگر سیستم فقط متن جدید را دریافت کند اما همچنان صدای قبلی را پخش کند، مکالمه غیرطبیعی و گیجکننده میشود.
یک پیادهسازی صحیح Barge-in باید بتواند:
- گفتار جدید کاربر را تشخیص دهد.
- پخش صوت پاسخ قبلی را متوقف کند.
- بافر خروجی قبلی را پاکسازی کند.
- تولید LLM یا TTS قبلی را در صورت امکان لغو کند.
- نسل یا شناسه پاسخ قبلی را نامعتبر کند.
- گفتار جدید کاربر را پردازش کند.
همچنین باید بین اعتراض واقعی کاربر و صداهای پسزمینه یا تأییدهای کوتاهی مانند «بله» تفاوت قائل شد.
مدیریت وضعیت هنگام قطع پاسخ Agent
یکی از روشهای ساده برای جلوگیری از پخش پاسخ قدیمی، استفاده از شناسه نسل پاسخ یا generation_id است.
هر زمان کاربر گفتار جدیدی را شروع میکند و وقفه معتبر تشخیص داده میشود، شناسه پاسخ فعلی تغییر میکند.
در این حالت، هر Chunk قدیمی که بعداً از TTS یا صف خروجی برسد، به دلیل نامعتبرشدن شناسه کنار گذاشته میشود.
Agent Speaking
      |
      v
User Speech Detected?
      |
      +--- No ---> Continue Playback
      |
      +--- Yes
              |
              v
      Validate Interruption
              |
              v
      Invalidate Generation
              |
              v
      Cancel LLM / TTS
              |
              v
      Clear Playback Buffer
              |
              v
      Listen to User
این معماری جلوی بخش مهمی از مشکلات Race Condition را میگیرد؛ زیرا امکان دارد خروجی یک پاسخ لغوشده، چند لحظه دیرتر از سرویس TTS برسد.
نمونه ساده مدیریت Barge-in با Python
کد زیر منطق پایه Cancel کردن پاسخ قبلی را با asyncio نشان میدهد.
این نمونه به تماس تلفنی یا سرویس TTS واقعی متصل نیست؛ هدف آن نمایش مدیریت Task و جلوگیری از انتشار خروجی قدیمی است.
import asyncio


class VoicePlaybackController:
    def __init__(self):
        self.generation_id = 0
        self.current_task = None

    async def play_response(self, chunks):
        self.generation_id += 1
        my_generation = self.generation_id

        async def worker():
            for chunk in chunks:
                await asyncio.sleep(0.2)

                if my_generation != self.generation_id:
                    return

                print("PLAY:", chunk)

        self.current_task = asyncio.create_task(
            worker()
        )

    async def interrupt(self):
        self.generation_id += 1

        task = self.current_task
        self.current_task = None

        if task is not None:
            task.cancel()

            try:
                await task
            except asyncio.CancelledError:
                pass

        print("Playback interrupted")


async def main():
    controller = VoicePlaybackController()

    await controller.play_response([
        "سلام",
        "در حال بررسی درخواست شما هستم",
        "نتیجه بررسی آماده شد",
    ])

    await asyncio.sleep(0.25)
    await controller.interrupt()


asyncio.run(main())
در یک سیستم واقعی، علاوه بر لغو Task برنامه، لازم است بافر پخش روی مرورگر، Media Gateway یا سرویس تماس تلفنی نیز پاک شود.
همچنین اگر یک درخواست خارجی پس از Cancel همچنان در حال اجرا باشد، ممکن است هزینه آن ادامه پیدا کند. بنابراین Cancel شدن Task محلی، تضمین توقف کامل پردازش در سرویس خارجی نیست.
تفاوت SIP و WebRTC در Voice AI Agent
برای اتصال Agent صوتی به کاربران، دو فناوری مهم وجود دارد: SIP و WebRTC.
SIP معمولاً برای برقراری و مدیریت تماسهای تلفنی در زیرساختهای VoIP استفاده میشود.
WebRTC برای ارتباط صوتی و تصویری بلادرنگ در مرورگر و اپلیکیشن کاربرد دارد.
| موضوع | SIP | WebRTC |
|---|---|---|
| کاربرد معمول | مرکز تماس، شماره تلفن و VoIP | مرورگر و اپلیکیشن |
| سیگنالینگ | SIP | سیگنالینگ برنامهمحور با SDP/ICE |
| انتقال رسانه | بسته به پیادهسازی RTP یا SRTP | رسانه رمزنگاریشده با SRTP |
| اتصال به PSTN | از طریق ارائهدهنده تلفنی یا Gateway | معمولاً نیازمند Gateway |
| چالش مهم | Codec، NAT، Trunk و امنیت تماس | ICE، STUN/TURN، مجوز میکروفون |
در یک مرکز تماس، شماره تلفن ممکن است از طریق SIP Trunk به سیستم برسد و سپس یک Media Bridge صوت را برای Agent پردازش کند.
در یک وبسایت، میتوان مستقیماً از WebRTC برای ارتباط مرورگر با سرور صوتی استفاده کرد.
باید توجه داشت که SIP و WebRTC دقیقاً جایگزین مستقیم یکدیگر نیستند؛ این دو فناوری در لایهها و کاربردهای متفاوتی قرار دارند و ممکن است در یک معماری مشترک استفاده شوند.
مسیر تماس تلفنی با SIP چگونه است؟
برای پاسخگویی به تماس تلفنی واقعی، معمولاً به یک ارائهدهنده تلفنی، SIP Trunk یا PBX نیاز داریم.
Phone Caller
     |
     v
Telecom Provider
     |
     v
SIP Trunk / PBX
     |
     v
SIP / Media Gateway
     |
     v
Voice Agent Session
     |
     +-- STT
     +-- LLM
     +-- TTS
     |
     v
Audio Back to Caller
در این معماری، PBX یا Gateway وظیفه مدیریت تماس و تبدیل فرمت رسانه را بر عهده دارد و Agent مسئول مکالمه است.
در سال ۲۰۲۶ سرویسهایی نیز وجود دارند که اتصال SIP را مستقیماً به نشستهای صوتی مدلهای بلادرنگ ارائه میکنند. بااینحال، انتخاب بین اتصال مستقیم و Media Gateway اختصاصی باید بر اساس نیاز به ضبط، کنترل تماس، انتقال به اپراتور و محرمانگی داده انجام شود.
منبع:
OpenAI Telephony and SIP.
اتصال مرورگر به Agent با WebRTC
در سناریوی وب، کاربر روی دکمه تماس صوتی کلیک میکند و مرورگر پس از دریافت مجوز میکروفون، صدا را از طریق WebRTC انتقال میدهد.
WebRTC برای برقراری ارتباط به مواردی مانند ICE و در بعضی شبکهها STUN یا TURN نیاز دارد.
طبق معماری امنیتی WebRTC، انتقال رسانه با مکانیزمهای رمزنگاری مانند DTLS-SRTP محافظت میشود.
بااینحال، رمزنگاری مسیر انتقال به معنی تضمین محرمانگی کامل محتوا در سرورهای پردازشکننده نیست؛ STT، TTS یا سرویس مدل همچنان ممکن است داده صوتی را برای پردازش دریافت کنند.
منبع:
RFC 8827 – WebRTC Security Architecture.
اتصال تماس تلفنی با Bidirectional Media Streams
یکی از روشهای اتصال تماس تلفنی به برنامه اختصاصی، استفاده از Media Streams دوطرفه است.
در این روش، سرویس تلفنی داده صوتی تماس را از طریق WebSocket به برنامه میفرستد و برنامه میتواند صوت تولیدشده را به تماس برگرداند.
برای مثال، Twilio در Media Streams دوطرفه از پیامهای media برای صوت خروجی و از clear برای پاککردن صوت بافرشده پشتیبانی میکند.
پیام نمونه پاککردن بافر:
{
  "event": "clear",
  "streamSid": "YOUR_ACTIVE_STREAM_SID"
}
شناسه Stream باید از نشست واقعی تماس گرفته شود و نباید یک مقدار ثابت برای تمام تماسها باشد.
در این API، صوت خروجی لازم است با قالب مشخصشده توسط ارائهدهنده سازگار باشد. برای Twilio، مستندات Media Streams قالب audio/x-mulaw با نرخ نمونهبرداری ۸۰۰۰ هرتز و Payload دارای Base64 را توضیح میدهند.
ارسال مستقیم PCM یا فایل WAV بدون تبدیل صحیح، در چنین مسیری میتواند باعث خطای پخش شود.
منابع:
Twilio Media Streams و
پیامهای WebSocket و Clear.
برای اجرای Agent صوتی چه سروری لازم است؟
نیاز سختافزاری به این بستگی دارد که مدلها روی خود سرور اجرا میشوند یا از APIهای خارجی استفاده میکنید.
اگر STT، LLM و TTS از طریق API ارائه شوند، سرور بیشتر مسئول ارتباط بلادرنگ، مدیریت نشستها، صفها و اجرای ابزارها خواهد بود.
اما اگر مدلهای صوتی و زبانی بهصورت محلی اجرا شوند، مصرف CPU، RAM و احتمالاً GPU بهطور قابل توجهی افزایش مییابد.
| نوع استقرار | منابع مهم | ملاحظات |
|---|---|---|
| مدلها از طریق API | CPU، RAM، شبکه پایدار | تأخیر شبکه و هزینه API |
| STT محلی | CPU/GPU متناسب با مدل | کیفیت تشخیص و ظرفیت همزمانی |
| TTS محلی | RAM و GPU احتمالی | زمان اولین صوت و کیفیت صدا |
| LLM محلی | RAM/VRAM و توان پردازشی | زمان اولین توکن و تعداد نشستها |
| Media Gateway | شبکه، CPU و کنترل بافر | Codec، Jitter و پایداری تماس |
برای شروع، استقرار مبتنی بر API در یک محیط آزمایشی معمولاً راه سادهتری برای سنجش تجربه مکالمه است.
اما نباید یک مقدار ثابت CPU یا RAM را بدون اندازهگیری برای تعداد مشخصی تماس تضمین کرد. ظرفیت واقعی باید با تست تماسهای همزمان و بررسی P95 Latency تعیین شود.
آموزش عملی ساخت Voice AI Agent Server با Python و LiveKit
در ادامه یک نمونه Voice Agent با اجزای مستقل STT، LLM و TTS میسازیم.
برای هماهنگسازی جلسه صوتی از LiveKit Agents استفاده میکنیم. این فریمورک بخشهایی مانند Session، Turn Detection و مدیریت مکالمه را در اختیار برنامه قرار میدهد.
نمونه از معماری و API مستند LiveKit استفاده میکند؛ اما سرویسهای مدل معرفیشده در کد نمونه انگلیسی هستند. برای ارائه خدمات فارسی باید STT، TTS و Turn Detection مناسب فارسی را انتخاب و جداگانه آزمایش کنید.
همچنین LiveKit Inference و بعضی امکانات پردازش صوت به تنظیمات حساب و ارائهدهنده نیاز دارند؛ اجرای این نمونه صرفاً با نصب کتابخانه و بدون پیکربندی سرویسها کامل نخواهد شد.
مرحله اول: آمادهسازی محیط
ابتدا Python و محیط مجازی را آماده کنید:
mkdir -p ~/voice-ai-agent
cd ~/voice-ai-agent

python3 -m venv .venv
source .venv/bin/activate

python -m pip install --upgrade pip
python -m pip install \
  "livekit-agents" \
  "python-dotenv"
این نصب، هسته SDK را آماده میکند. استفاده از مدلها و قابلیتهای وابسته به Provider ممکن است به پکیجها و تنظیمات تکمیلی نیاز داشته باشد.
برای شروع مطمئنتر میتوانید پروژه کامل رسمی را با LiveKit CLI ایجاد کنید؛ مستندات فعلی دستور lk agent init را برای ساخت Starter ارائه میکنند.
منبع:
LiveKit Voice AI Quickstart.
مرحله دوم: تنظیم اعتبارنامهها
در زمان اتصال به LiveKit باید آدرس سرور و اعتبارنامه معتبر را تنظیم کنید.
فایل محیطی را فقط در مسیر محافظتشده نگهداری کنید و هرگز آن را به مخزن عمومی Git یا Prompt مدل اضافه نکنید.
# .env.local

LIVEKIT_URL=wss://YOUR_LIVEKIT_ENDPOINT
LIVEKIT_API_KEY=YOUR_SERVER_KEY
LIVEKIT_API_SECRET=YOUR_SERVER_SECRET
این مقادیر نمایشی هستند و باید با اطلاعات واقعی محیط خود جایگزین شوند.
در Production بهتر است اعتبارنامهها با Secret Manager یا مکانیزم امن سرویس مدیریت شوند.
مرحله سوم: نوشتن Agent صوتی
فایل agent.py را ایجاد کنید:
from dotenv import load_dotenv

from livekit import agents
from livekit.agents import (
    Agent,
    AgentServer,
    AgentSession,
    TurnHandlingOptions,
    inference,
)

load_dotenv(".env.local")


class SupportAssistant(Agent):
    def __init__(self):
        super().__init__(
            instructions=(
                "You are a concise voice support assistant. "
                "Use short natural spoken sentences. "
                "Ask for clarification when needed. "
                "Never claim to have checked an order "
                "unless an authorized tool returned data. "
                "Do not invent account information."
            )
        )


server = AgentServer()


@server.rtc_session(agent_name="support-voice-agent")
async def entrypoint(ctx: agents.JobContext):
    session = AgentSession(
        stt=inference.STT(
            model="assemblyai/universal-3-6-pro",
            language="en",
        ),
        llm=inference.LLM(
            model="google/gemma-4-31b-it",
        ),
        tts=inference.TTS(
            model="fishaudio/s2.1-pro",
            voice="fa4c9eb3dccc4806b382b40d61c6b10a",
        ),
        turn_handling=TurnHandlingOptions(
            turn_detection=inference.TurnDetector(),
        ),
    )

    await session.start(
        room=ctx.room,
        agent=SupportAssistant(),
    )

    await session.generate_reply(
        instructions=(
            "Greet the caller briefly "
            "and ask how you can help."
        )
    )


if __name__ == "__main__":
    agents.cli.run_app(server)
این کد یک Agent Session ایجاد میکند که اجزای STT، LLM و TTS بهصورت مستقل در آن تعریف شدهاند.
مدلها و شناسه Voice بر اساس نمونههای مستند LiveKit انتخاب شدهاند. پشتیبانی عملی آنها به وضعیت سرویس، حساب و تنظیمات Provider وابسته است.
برای تماس فارسی: مدل STT در این مثال صریحاً روی زبان انگلیسی تنظیم شده است. برای تماس فارسی باید آن را به مدل دارای پشتیبانی معتبر فارسی تغییر دهید و یک صدای TTS فارسی مناسب نیز انتخاب کنید. صرفاً تغییر Prompt به فارسی، پشتیبانی گفتاری مدلها را تضمین نمیکند.
مرحله چهارم: اجرای Agent در محیط توسعه
بعد از آمادهسازی تنظیمات، میتوان برنامه را از مسیر رسمی پروژه LiveKit اجرا کرد.
در Starter رسمی، دستور توسعه معمولاً به شکل زیر است:
lk agent devاگر از فایل Python مستقل و CLI کتابخانه استفاده میکنید، اجرای آن به شکل زیر است:
python agent.py devروش دقیق اجرا باید با نسخه SDK و ساختار پروژه شما سازگار باشد. این نمونه در این مقاله روی سرویس زنده و اعتبارنامه واقعی اجرا نشده است.
برای آزمایش مکالمه، از محیط Agent Console یا یک Frontend متصل به همان LiveKit Server استفاده کنید.
چگونه VAD و Barge-in را در LiveKit تنظیم کنیم؟
تنظیمات Turn Handling تعیین میکنند Agent چگونه پایان صحبت را تشخیص دهد و در چه شرایطی صحبت خود را متوقف کند.
در مستندات فعلی LiveKit، تنظیمات Endpointing و Interruption برای کنترل این رفتار ارائه شدهاند.
نمونه پیکربندی زیر فقط بخش تنظیمات را نشان میدهد و باید در ساخت AgentSession استفاده شود:
turn_handling = TurnHandlingOptions(
    turn_detection=inference.TurnDetector(),
    endpointing={
        "min_delay": 0.5,
        "max_delay": 3.0,
    },
    interruption={
        "enabled": True,
        "min_duration": 0.5,
        "min_words": 0,
    },
)
این اعداد برای شروع آزمایش هستند. بهتر است آنها را روی مکالمات واقعی و با بررسی False Interruption تنظیم کنید.
بعضی روشهای Interruption Detection، مانند حالت Adaptive، به قابلیتهای Provider یا سهمیه مشخص وابستهاند. بنابراین قبل از استفاده عملیاتی باید محدودیت و هزینه آنها بررسی شود.
منبع:
تنظیم Turn Detection و Interruption در LiveKit.
اتصال Agent به شماره تلفن یا وبسایت
بعد از آنکه Agent در محیط توسعه پاسخ صوتی تولید کرد، باید مسیر اتصال کاربران مشخص شود.
برای وبسایت یا اپ موبایل، یک Frontend مبتنی بر WebRTC میتواند با Agent Session ارتباط برقرار کند.
برای شماره تلفن و مرکز تماس نیز باید مسیر SIP Trunk، PBX یا Gateway و تنظیمات ورودی تماس آماده شوند.
LiveKit امکان اتصال تلفنی از طریق SIP را در کنار معماری Agent ارائه میکند. بااینحال، خرید یا اختصاص شماره تلفن، تنظیم Trunk، سیاست مسیریابی تماس و تأمینکننده مخابراتی بخشهای جداگانه استقرار هستند.
منبع:
مستندات SIP در LiveKit.
امنیت Voice AI Agent روی سرور
Agent صوتی ممکن است در تماس زنده به اطلاعات مشتری، وضعیت سفارش، پرونده پشتیبانی یا سرویسهای داخلی دسترسی داشته باشد.
به همین دلیل، حفاظت از دادهها باید در چند سطح طراحی شود:
- احراز هویت کاربر یا تماسگیرنده قبل از نمایش اطلاعات خصوصی.
- محدودکردن دسترسی Toolها به عملیات مجاز.
- استفاده از ارتباط رمزنگاریشده و تنظیمات معتبر TLS.
- جلوگیری از قرارگرفتن API Key در کلاینت عمومی.
- اعمال محدودیت تعداد تماس و زمان مکالمه.
- محدودکردن درخواستهای خروجی و ابزارهای خارجی.
- ثبت رویدادها بدون ذخیره غیرضروری محتوای حساس.
- طراحی مسیر انتقال به اپراتور انسانی در وضعیتهای حساس.
همچنین اگر کاربر در تماس یک دستور غیرمعمول بدهد، Agent نباید بدون بررسی مجوز آن را به یک عملیات حساس تبدیل کند.
محتوای شنیدهشده از تماس، از نظر سطح اعتماد مشابه ورودی غیرقابل اعتماد کاربر است.
حریم خصوصی، رضایت کاربر و نگهداری صوت
در تماس صوتی، اطلاعات شخصی ممکن است در قالب صدا، متن تبدیلشده، تاریخچه مکالمه یا خروجی ابزارها پردازش شوند.
به همین دلیل بهتر است قبل از راهاندازی سرویس، سیاست مشخصی برای این موارد وجود داشته باشد:
- اطلاعرسانی روشن درباره استفاده از دستیار هوش مصنوعی.
- بررسی الزامات قانونی ضبط و پردازش مکالمه در حوزه قضایی مربوط.
- مشخصکردن اینکه آیا صدا ضبط میشود یا فقط بهصورت لحظهای پردازش میشود.
- تعیین مدت نگهداری فایل صوتی و Transcript.
- حذف یا پوشاندن اطلاعات حساس در Log.
- بررسی سیاست نگهداری و استفاده از داده توسط ارائهدهندگان STT، LLM و TTS.
- محدودکردن دسترسی کارکنان به داده تماسها.
- امکان حذف داده و اجرای سیاست نگهداری مطابق الزامات قانونی.
رمزنگاری انتقال صوت، بهتنهایی پاسخگوی تمام این الزامات نیست. اگر صوت یا Transcript به یک سرویس بیرونی ارسال شود، سیاستهای همان سرویس نیز اهمیت دارند.
چه معیارهایی را در Voice Agent مانیتور کنیم؟
برای یک Voice AI Agent Server پایدار، مانیتورینگ فقط به وضعیت CPU و RAM محدود نمیشود.
بهتر است معیارهای مرتبط با تجربه واقعی مکالمه نیز ثبت شوند.
| معیار | کاربرد |
|---|---|
| Time to First Audio | زمان تا آغاز صدای پاسخ |
| STT Finalization Delay | تأخیر نهاییشدن متن |
| Turn Detection Delay | زمان تشخیص پایان صحبت |
| LLM Time to First Token | سرعت آغاز پاسخ مدل |
| TTS First Chunk Latency | زمان تولید اولین بخش صوت |
| Interruption Detection Delay | زمان تشخیص ورود جدید کاربر |
| False Interruption Rate | تعداد قطع اشتباه Agent |
| Packet Loss / Jitter | کیفیت انتقال صدا |
| Call Failure Rate | نرخ شکست نشست یا تماس |
| Cost per Call Minute | هزینه پردازش هر دقیقه تماس |
بهتر است شاخصها به تفکیک Provider، زبان، نوع تماس و نسخه Agent ثبت شوند.
برای مثال، ممکن است تغییر مدل TTS زمان تولید صوت را کاهش دهد، اما کیفیت تلفظ فارسی را بدتر کند. بدون ثبت همزمان کیفیت و سرعت، تشخیص این مبادله دشوار میشود.
چگونه کیفیت Voice Agent را آزمایش کنیم؟
آزمایش Voice Agent باید شرایط واقعی گفتار را پوشش دهد. اجرای چند جمله کوتاه در محیط آرام کافی نیست.
سناریوهای پیشنهادی:
| سناریو | نتیجه مورد انتظار |
|---|---|
| کاربر مکث کوتاه میکند | Agent زودتر از موعد صحبت نکند |
| کاربر وسط پاسخ سؤال جدید میپرسد | پاسخ قبلی قطع و مکالمه جدید پردازش شود |
| صدای پسزمینه شنیده میشود | وقفه اشتباه تا حد امکان کاهش یابد |
| STT متن را اشتباه تشخیص میدهد | Agent در موارد حساس درخواست تأیید کند |
| سرویس TTS کند میشود | Timeout و Fallback کنترلشده فعال شود |
| تماس هنگام تولید پاسخ قطع میشود | Taskها و منابع نشست آزاد شوند |
| کاربر اطلاعات شخص دیگری را میخواهد | عدم افشای داده بدون مجوز |
| چند تماس همزمان برقرار میشود | عدم اختلاط صدای نشستها و حفظ کیفیت |
برای آزمایش عملی، بهتر است نمونه مکالمات فارسی با لهجهها، سرعت گفتار، کیفیت میکروفون و شرایط نویز متفاوت تهیه شود؛ مشروط به رعایت رضایت و محرمانگی دادهها.
مقیاسپذیری تماسهای همزمان روی سرور
هر تماس زنده یک نشست Stateful است و ممکن است اتصال صوتی، وضعیت مکالمه، بافر خروجی و درخواستهای مدل مخصوص خودش را داشته باشد.
برای مقیاسپذیری باید مشخص کنیم کدام اجزا Stateless و کدام اجزا Stateful هستند.
برای مثال، یک Media Gateway ممکن است چندین نشست را مدیریت کند، اما وضعیت هر تماس نباید با تماس دیگر ترکیب شود.
در محیط چندسروری بهتر است از موارد زیر استفاده شود:
- مسیریابی تماس به Worker مناسب.
- سقف تعداد نشست همزمان هر Worker.
- Health Check برای سرویسهای صوتی.
- Backpressure و صف کنترلشده برای درخواستهای مدل.
- Timeout و Circuit Breaker برای Providerهای خارجی.
- محدودیت هزینه هر تماس و هر حساب.
- حذف منابع نشست بعد از قطع تماس.
- Load Test با ترافیک صوتی واقعی.
برای مثال، اگر ۲۰ تماس همزمان برقرار باشند، تنها شمار تماسها معیار کافی برای ظرفیتسنجی نیست. باید طول پاسخها، تعداد Tool Callها، مصرف STT و TTS و نرخ وقفه کاربران را نیز در نظر گرفت.
اشتباههای رایج در ساخت Agent صوتی
۱. اجرای STT، LLM و TTS بهصورت کاملاً متوالی و بدون Streaming
این طراحی میتواند زمان آغاز پاسخ را افزایش دهد.
۲. استفاده از VAD بهعنوان تنها معیار پایان نوبت
سکوت کوتاه همیشه به معنی پایان جمله نیست و ممکن است Agent وسط صحبت کاربر وارد شود.
۳. قطعنکردن بافر پخش هنگام Barge-in
حتی اگر تولید TTS متوقف شده باشد، ممکن است صدای بافرشده همچنان برای کاربر پخش شود.
۴. بیتوجهی به Codec تماس تلفنی
عدم تطبیق فرمت صوت میتواند باعث سکوت، نویز یا خطای پخش شود.
۵. استفاده از یک Prompt متنی طولانی برای پاسخ صوتی
پاسخهای طولانی و ساختارمند همیشه برای شنیدن مناسب نیستند.
۶. ثبت تمام فایلهای صوتی بدون سیاست نگهداری
این کار میتواند ریسک حریم خصوصی و هزینه ذخیرهسازی را افزایش دهد.
۷. نداشتن محدودیت زمان و هزینه تماس
یک مکالمه طولانی یا Loop میتواند منابع و اعتبار API را بیش از حد مصرف کند.
۸. استفاده از یک Session مشترک برای چند تماس
این خطا ممکن است باعث اختلاط وضعیت مکالمه و افشای اطلاعات میان کاربران شود.
۹. انتخاب STT یا TTS صرفاً بر اساس عملکرد انگلیسی
کیفیت فارسی و لهجههای واقعی باید مستقل ارزیابی شود.
چکلیست راهاندازی Voice AI Agent Server در Production
- انتخاب معماری Cascaded یا Realtime بر اساس هدف پروژه.
- پشتیبانی معتبر STT و TTS از زبان کاربران.
- تعیین Transport مناسب: SIP، WebRTC یا Media Gateway.
- تنظیم VAD و Turn Detection با تست واقعی.
- پیادهسازی Barge-in و پاکسازی بافر صوتی.
- تعیین Latency Budget و ثبت P95.
- پشتیبانی از Streaming در بخشهای مناسب.
- اعمال Timeout، Retry محدود و Circuit Breaker.
- محدودیت تماس همزمان و مصرف منابع.
- احراز هویت و محدودکردن Toolهای حساس.
- مدیریت امن کلیدها و اعتبارنامهها.
- رمزنگاری مسیر انتقال صوت.
- سیاست ضبط، رضایت و نگهداری داده.
- مدیریت قطع تماس و آزادسازی منابع.
- آزمایش کیفیت صدا، نویز، Packet Loss و Jitter.
- تست مکالمه فارسی و سناریوهای وقفه.
- پیشبینی انتقال به اپراتور انسانی.
- اندازهگیری هزینه واقعی هر دقیقه مکالمه.
جمعبندی؛ چگونه Agent صوتی پایدار روی سرور بسازیم؟
ساخت یک Voice AI Agent Server فقط اتصال میکروفون به یک مدل هوش مصنوعی نیست. یک سیستم مکالمه زنده باید انتقال صوت، تشخیص گفتار، مدیریت نوبت مکالمه، تصمیمگیری مدل و تولید صوت را بهصورت هماهنگ اجرا کند.
معماری STT، LLM و TTS برای پروژههایی که به کنترل و مشاهده هر مرحله نیاز دارند، انتخاب مناسبی است. در مقابل، مدلهای صوتی Realtime نیز برای کاهش پیچیدگی بعضی مسیرهای مکالمه و رسیدن به تعامل طبیعیتر قابل بررسی هستند.
برای دستیابی به تجربه مناسب، باید Latency Budget واقعی، تنظیمات VAD، تشخیص پایان صحبت و Barge-in بهدقت طراحی شوند. همچنین انتخاب SIP یا WebRTC باید براساس مسیر اتصال کاربران و نیازهای مرکز تماس انجام شود.
در نهایت، امنیت، محرمانگی داده و هزینه تماسها بهاندازه کیفیت صدای مصنوعی اهمیت دارند.
اصل نهایی: یک Agent صوتی موفق باید علاوه بر پاسخ درست، بهموقع گوش دهد، بهموقع صحبت کند، هنگام ورود کاربر متوقف شود و در تمام مراحل از دادهها و منابع سرور محافظت کند.
سؤالات متداول درباره Voice AI Agent Server
Voice AI Agent Server چیست؟
سروری است که ارتباط صوتی کاربر را دریافت میکند و با کمک اجزایی مانند STT، LLM و TTS یا مدل صوتی Realtime پاسخ گفتاری تولید میکند.
آیا برای ساخت Agent صوتی به GPU نیاز داریم؟
اگر مدلها از طریق API اجرا شوند، ممکن است GPU اختصاصی روی سرور برنامه لازم نباشد؛ اما اجرای محلی بعضی مدلهای STT، LLM و TTS میتواند به GPU نیاز داشته باشد.
تفاوت STT، LLM و TTS چیست؟
STT گفتار را به متن تبدیل میکند، LLM پاسخ را تولید میکند و TTS متن پاسخ را به صدا تبدیل میکند.
VAD در Agent صوتی چیست؟
VAD روشی برای تشخیص وجود گفتار در سیگنال صوتی است و به شناسایی شروع صحبت و سکوت کمک میکند.
Barge-in چه کاربردی دارد؟
اجازه میدهد کاربر وسط صحبت Agent وارد مکالمه شود و سیستم پاسخ در حال پخش را متوقف کند.
برای تماس تلفنی SIP بهتر است یا WebRTC؟
SIP معمولاً در زیرساخت تلفنی و VoIP استفاده میشود، درحالیکه WebRTC برای ارتباط صوتی مستقیم مرورگر یا اپلیکیشن مناسب است. این دو میتوانند در یک سیستم مشترک استفاده شوند.
چگونه تأخیر پاسخ Agent صوتی را کاهش دهیم؟
با Streaming، تنظیم Turn Detection، کاهش تأخیر STT و TTS، نزدیککردن سرویسها از نظر شبکه و حذف پردازشهای غیرضروری میتوان Latency را کنترل کرد.
آیا تماس کاربران با Voice AI Agent محرمانه است؟
محرمانگی به تنظیمات انتقال، پردازش، ذخیرهسازی و ارائهدهندگان سرویس وابسته است. باید سیاست ضبط، دسترسی و نگهداری داده بهصورت مشخص طراحی شود.
دیدگاهها (۰)