
 Amir Jabbari
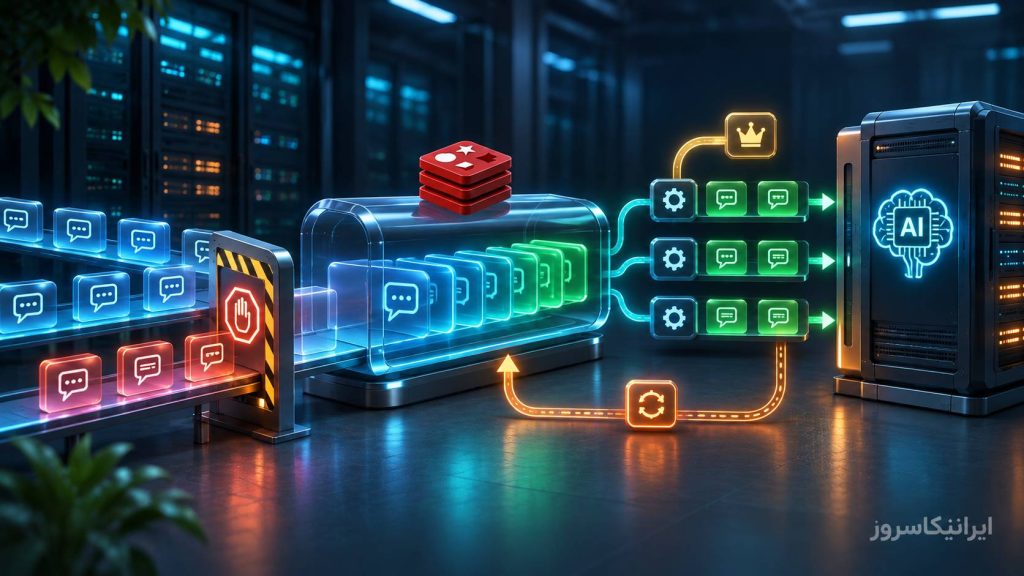
تصور کنید یک چتبات هوش مصنوعی راهاندازی کردهاید که در حالت عادی با ۱۰ کاربر همزمان بهخوبی کار میکند. اما بعد از معرفی محصول یا اجرای یک کمپین تبلیغاتی، ناگهان صدها نفر همزمان درخواست ارسال میکنند. اگر سرور بخواهد همه درخواستها را همان لحظه پردازش کند، ممکن است مصرف حافظه بالا برود، اتصالها بیش از حد زیاد شوند، API مدل با خطای 429 پاسخ دهد و در نهایت سرویس از دسترس خارج شود.
LLM Request Queue یا صف درخواست مدل زبانی، راهکاری برای کنترل این وضعیت است. بهجای ارسال فوری تمام درخواستها به مدل هوش مصنوعی، آنها را بهصورت کارهای مستقل یا Job در یک صف ثبت میکنیم. سپس تعدادی Worker با ظرفیت مشخص، کارها را بهتدریج پردازش میکنند.
اما ساخت صف بهتنهایی کافی نیست. اگر هزاران درخواست بدون محدودیت وارد Redis شوند، خود صف به یک مشکل جدید تبدیل میشود. برای ایجاد یک سیستم پایدار باید مفاهیمی مانند Backpressure، Concurrency، Rate Limit، Timeout، Retry، Priority و Queue Monitoring را نیز در نظر بگیریم.
در این مقاله ابتدا معماری صف درخواستهای AI را توضیح میدهیم و سپس با Node.js، Redis و BullMQ یک نمونه عملی میسازیم. همچنین روش جلوگیری از انباشتهشدن درخواستها، کنترل هزینه API و مدیریت خطاهای موقت را بررسی خواهیم کرد.
LLM Request Queue چیست؟
LLM Request Queue یک لایه مدیریت کار است که بین برنامه و مدل هوش مصنوعی قرار میگیرد. وظیفه آن دریافت درخواست، ثبت امن کار، مدیریت ترتیب اجرا و تحویل آن به پردازشگرهای پسزمینه است.
در یک برنامه ساده، مرورگر درخواست را به سرور ارسال میکند و سرور تا دریافت پاسخ مدل منتظر میماند. اگر این انتظار طولانی شود و تعداد اتصالها افزایش پیدا کند، مصرف منابع و احتمال Timeout بیشتر خواهد شد.
در معماری مبتنی بر صف، سرور پس از ثبت موفق Job، یک شناسه به کاربر برمیگرداند. پردازش در پسزمینه انجام میشود و کاربر میتواند با آن شناسه وضعیت نتیجه را بررسی کند.
- Producer: بخشی از برنامه که درخواست را به صف اضافه میکند.
- Queue: محل نگهداری کارهای در انتظار پردازش.
- Worker: پردازشگری که کار را دریافت و API مدل را فراخوانی میکند.
- Job: واحد مستقل کار، مثلاً خلاصهسازی یک متن یا پاسخ به یک سؤال.
- Result Store: محل نگهداری نتیجه پردازش برای دریافت بعدی.
استفاده از صف بهویژه برای خلاصهسازی اسناد، تولید گزارش، پردازش دستهای محتوا، Embedding و عملیات AI که به پاسخ فوری نیاز ندارند مناسب است.
چرا هجوم درخواستهای AI میتواند سرور را از کار بیندازد؟
درخواستهای هوش مصنوعی معمولاً نسبت به یک API ساده زمان پردازش طولانیتری دارند. ممکن است هر درخواست چندین ثانیه طول بکشد و در این مدت، منابع شبکه، حافظه و اتصالها درگیر بمانند.
سه مشکل رایج هنگام افزایش ناگهانی ترافیک عبارتاند از:
۱. افزایش درخواستهای همزمان
اگر اپلیکیشن بدون محدودیت درخواستهای خارجی ارسال کند، تعداد اتصالهای باز و عملیات منتظر پاسخ افزایش پیدا میکند. در یک مدل محلی نیز ممکن است GPU یا حافظه پردازشی اشباع شود.
۲. رسیدن به محدودیت API ارائهدهنده
بسیاری از ارائهدهندگان مدلهای ابری، محدودیت تعداد درخواست در دقیقه (RPM) و تعداد توکن در دقیقه (TPM) دارند. ارسال ناگهانی درخواستها میتواند باعث خطای 429 Too Many Requests شود.
۳. انباشتهشدن کار در حافظه برنامه
اگر تمام کارها در آرایههای حافظه یا Promiseهای بدون محدودیت نگهداری شوند، مصرف RAM افزایش مییابد. همچنین در صورت Restart یا Crash، کارهای ثبتنشده در سیستم پایدار ممکن است از بین بروند.
طبق مستندات رسمی Rate Limits در OpenAI، محدودیت درخواست و توکن مستقلاند و خطاهای موقت باید با کاهش نرخ درخواست، توجه به Retry-After و سیاست Retry کنترلشده مدیریت شوند.
معماری استاندارد صف درخواستهای AI
Client / Application
         |
    Authentication
         |
    Input Validation
         |
 Admission Control
    /         \
 Accept      Reject / 429
    |
 Redis / BullMQ Queue
    |
 Priority + Scheduling
    |
 Concurrency Limiter
    |
 Worker 1 / 2 / 3
    |
 AI API / Local LLM
    |
 Result + Job Status
    |
 Client Polling / Webhook
در این معماری، Admission Control اهمیت ویژهای دارد. این بخش تصمیم میگیرد آیا سیستم ظرفیت پذیرش یک Job جدید را دارد یا باید به درخواستکننده اعلام کند بعداً تلاش کند.
در نتیجه، صف تنها بخشی از معماری کنترل بار است؛ محدودکردن ورود کارها، محدودکردن پردازش همزمان و نظارت بر ظرفیت نیز ضروری هستند.
تفاوت Queue، Rate Limit و Backpressure چیست؟
| مفهوم | کاربرد | مثال |
|---|---|---|
| Queue | نگهداری و زمانبندی کارها | ثبت ۱۰۰ درخواست در انتظار |
| Rate Limit | محدودکردن نرخ اجرای درخواست | حداکثر ۳۰ درخواست در دقیقه |
| Concurrency Limit | محدودکردن عملیات همزمان | حداکثر ۳ درخواست فعال |
| Backpressure | کاهش یا توقف ورود بار اضافی | ردکردن Job جدید هنگام پرشدن ظرفیت |
| Retry | تلاش دوباره پس از خطای قابلبازیابی | تکرار پس از خطای موقت 503 |
بهعنوان مثال، اگر یک Worker همزمان ۳ درخواست اجرا کند، لزوماً به این معنی نیست که محدودیت ۳۰ درخواست در دقیقه نیز رعایت میشود. وقتی درخواستها کوتاه باشند، همان ۳ Worker ممکن است در یک دقیقه تعداد بسیار بیشتری فراخوانی انجام دهند.
از طرف دیگر، Rate Limit بدون Concurrency Limit نیز کافی نیست. ممکن است با وجود نرخ مجاز، درخواستهای طولانی مدت زیادی همزمان فعال بمانند.
Backpressure چیست و چگونه جلوی Crash را میگیرد؟
Backpressure به معنی اعمال فشار معکوس از سمت بخشی است که ظرفیت پردازش کافی ندارد. یعنی اگر Workerها نمیتوانند به سرعت درخواستها را انجام دهند، سیستم باید سرعت ورود کار جدید را کاهش دهد.
فرض کنید سرویس AI در هر ثانیه ۵ درخواست را پردازش میکند، اما کاربران در هر ثانیه ۲۰ درخواست جدید ارسال میکنند. در این شرایط صف بهطور متوسط هر ثانیه ۱۵ کار افزایش پیدا میکند.
اگر این وضعیت ادامه داشته باشد، انتظار کاربران بیشتر میشود و مصرف حافظه Redis افزایش مییابد. بنابراین هیچ صفی با ظرفیت محدود نمیتواند برای مدت نامحدود این اختلاف را تحمل کند.
راهکارهای رایج Backpressure شامل موارد زیر است:
- تعیین حداکثر تعداد کار در انتظار و فعال.
- محدودکردن تعداد درخواست هر کاربر یا سازمان.
- بازگرداندن HTTP 429 یا 503 هنگام نبود ظرفیت.
- استفاده از زمان انتظار تخمینی برای تصمیمگیری درباره پذیرش کار.
- محدودکردن اندازه ورودی و حداکثر توکن خروجی.
- جداکردن کارهای طولانی از درخواستهای سریع.
نکته: شرطی مانند «اگر تعداد Jobها از ۱۰۰۰ بیشتر بود، درخواست را رد کن» در یک API چندنمونهای باید بهصورت اتمیک اعمال شود. خواندن تعداد Jobها و سپس افزودن کار در دو عملیات مستقل، زیر بار همزمان میتواند از حد مجاز عبور کند.
مقایسه Redis، BullMQ، Celery و Redis Streams
| ابزار | ویژگی اصلی | مناسب برای |
|---|---|---|
| Redis | زیرساخت نگهداری داده و ساختارهای صف | لایه ذخیرهسازی و هماهنگی کارها |
| BullMQ | Job، Worker، Retry، Priority و Rate Limit | پروژههای Node.js و TypeScript |
| Celery | صف وظایف توزیعشده و Worker | پروژههای Python و Django |
| Redis Streams | Consumer Group، ACK و بازیابی پیام | پیادهسازی سفارشی جریان کار |
Redis Streams با دستورهایی مانند XREADGROUP، XACK و XAUTOCLAIM امکان تقسیم کار و بازیابی پیامهای پردازشنشده را فراهم میکند؛ اما مدیریت کامل Retry، Timeout، اولویت و چرخه Job را باید با دقت طراحی کرد.
در این مقاله از BullMQ استفاده میکنیم، چون ساختار Job و Worker و امکانات زمانبندی را بدون نیاز به پیادهسازی همه جزئیات از ابتدا ارائه میدهد.
منابع رسمی:
BullMQ،
Celery و
Redis Streams.
پیشنیازهای راهاندازی صف روی Ubuntu
برای اجرای نمونه آموزشی به یک سرور لینوکسی با Node.js نسخه LTS پشتیبانیشده، npm، Docker یا Redis نصبشده و یک کلید معتبر API هوش مصنوعی نیاز دارید.
این مثال از یک مدل ابری استفاده میکند؛ بنابراین GPU لازم نیست. اگر Workerها درخواست را به Ollama یا vLLM محلی ارسال کنند، منابع سختافزاری مدل باید جداگانه بررسی شوند.
برای شروع، پوشه پروژه را ایجاد کنید:
mkdir -p ~/ai-request-queue
cd ~/ai-request-queue

node --version
npm --version
اگر Node.js روی سیستم نصب نیست، از راهنمای رسمی نصب Node.js استفاده کنید. نسخههای منقضیشده را برای محیط عملیاتی انتخاب نکنید.
مرحله اول: اجرای Redis
برای آزمایش محلی میتوان Redis را در یک کانتینر Docker اجرا کرد. دستور زیر Redis را فقط روی Loopback میزبان منتشر میکند:
docker volume create ai-queue-redis-data

docker run -d \
  --name ai-queue-redis \
  --restart unless-stopped \
  -p 127.0.0.1:6379:6379 \
  -v ai-queue-redis-data:/data \
  redis:7-alpine \
  redis-server \
  --appendonly yes \
  --maxmemory-policy noeviction

docker exec ai-queue-redis redis-cli ping
اگر پاسخ PONG دریافت کردید، Redis در دسترس است. این تنظیم برای آزمایش روی میزبان محلی است. در Production باید نسخه تصویر ثابت و بررسیشده، کنترل دسترسی شبکه، پشتیبانگیری، امنیت Redis و تنظیمات مناسب Persistence در نظر گرفته شود.
در مستندات تولید BullMQ توصیه شده Redis با Persistence مناسب، ترجیحاً AOF، و سیاست حافظه noeviction تنظیم شود. این سیاست مانع حذف خودکار کلیدهای Queue میشود، اما به معنی نامحدود بودن حافظه نیست؛ در نبود ظرفیت کافی ممکن است عملیات نوشتن خطا بدهد.
مرحله دوم: نصب BullMQ و وابستگیها
در پوشه پروژه، بستههای لازم را نصب کنید:
npm init -y
npm pkg set type=module

npm install bullmq ioredis express dotenv openai
اکنون یک فایل .env ایجاد کنید و اطلاعات اتصال را داخل آن قرار دهید:
REDIS_HOST=127.0.0.1
REDIS_PORT=6379
PORT=3000

DEMO_API_TOKEN=REPLACE_WITH_LONG_RANDOM_SECRET
OPENAI_API_KEY=YOUR_REAL_API_KEY
AI_MODEL=YOUR_AVAILABLE_MODEL_ID
برای فایلهای محرمانه سطح دسترسی مناسب تنظیم کنید:
chmod 600 .env
printf ".env\nnode_modules/\n" >> .gitignore
در این نمونه باید مقدار توکن آزمایشی را به یک رشته تصادفی طولانی و شناسه مدل را به مدل موجود در حساب خود تغییر دهید. فایل محیطی را داخل Git منتشر نکنید.
مرحله سوم: ساخت فایل صف درخواست
فایل queue.mjs را ایجاد کنید. این فایل اتصال Redis و تنظیمات مشترک Queue را تعریف میکند.
import "dotenv/config";
import { Queue } from "bullmq";
import IORedis from "ioredis";

export const QUEUE_NAME = "ai-requests";

export const redisOptions = {
  host: process.env.REDIS_HOST || "127.0.0.1",
  port: Number(process.env.REDIS_PORT || 6379),
};

export const producerConnection = new IORedis({
  ...redisOptions,
  maxRetriesPerRequest: 1,
  enableOfflineQueue: false,
});

export const aiQueue = new Queue(QUEUE_NAME, {
  connection: producerConnection,
  defaultJobOptions: {
    attempts: 3,
    backoff: {
      type: "exponential",
      delay: 2000,
      jitter: 0.5,
    },
    removeOnComplete: {
      age: 3600,
      count: 1000,
    },
    removeOnFail: {
      age: 86400,
      count: 2000,
    },
  },
});
در این پیکربندی، هر Job در صورت خطای قابلبازیابی حداکثر ۳ تلاش دارد؛ یعنی تلاش اولیه بهعلاوه حداکثر ۲ تلاش دیگر. تاخیر بین تلاشها بهصورت افزایشی تنظیم شده است.
اتصال Producer عمداً با سیاست Fail Fast تنظیم شده تا اگر Redis در دسترس نبود، درخواست HTTP برای مدت نامحدود منتظر نماند.
همچنین برای جلوگیری از رشد بیپایان دادههای تکمیلشده، تعداد و عمر نتایج نگهداریشده محدود شدهاند. حذف خودکار Jobهای پایانیافته در BullMQ هنگام پایان کارهای بعدی انجام میشود و تضمین پاکسازی دقیق در همان ثانیه انقضا نیست.
مرحله چهارم: ساخت API دریافت درخواستها
در فایل server.mjs یک API ساده ایجاد میکنیم که کارها را به صف اضافه میکند و شناسه آنها را برمیگرداند.
در این نمونه، یک توکن آزمایشی ثابت برای محافظت از مسیرها استفاده میشود. این روش فقط برای محیط آموزشی یا استفاده داخلی است و جایگزین احراز هویت چندکاربری Production نمیشود.
import "dotenv/config";
import express from "express";
import { aiQueue } from "./queue.mjs";

const app = express();
app.use(express.json({ limit: "32kb" }));

const token = process.env.DEMO_API_TOKEN;

if (!token || token.startsWith("REPLACE_")) {
  throw new Error("Configure DEMO_API_TOKEN");
}

app.use((req, res, next) => {
  if (req.get("x-demo-token") !== token) {
    return res.sendStatus(401);
  }
  next();
});

app.post("/ai/jobs", async (req, res) => {
  try {
    const prompt = req.body?.prompt;

    if (
      typeof prompt !== "string" ||
      prompt.length < 1 || prompt.length > 4000
    ) {
      return res.status(400).json({
        error: "Invalid prompt length",
      });
    }

    const counts = await aiQueue.getJobCounts(
      "waiting",
      "active",
      "delayed",
      "prioritized"
    );

    const outstanding = Object.values(counts)
      .reduce((sum, n) => sum + n, 0);

    if (outstanding >= 1000) {
      res.set("Retry-After", "30");
      return res.status(429).json({
        error: "Queue capacity reached",
      });
    }

    const job = await aiQueue.add(
      "generate",
      { prompt },
      { priority: 10 }
    );

    return res.status(202).json({
      job_id: job.id,
      status: "queued",
      status_url: `/ai/jobs/${job.id}`,
    });

  } catch (err) {
    console.error("Queue admission failed:", err.message);
    return res.status(503).json({
      error: "Queue temporarily unavailable",
    });
  }
});

app.get("/ai/jobs/:id", async (req, res) => {
  try {
    const job = await aiQueue.getJob(req.params.id);

    if (!job) {
      return res.status(404).json({
        error: "Job not found or expired",
      });
    }

    const state = await job.getState();

    res.json({
      job_id: job.id,
      status: state,
      result: state === "completed"
        ? job.returnvalue
        : null,
      error: state === "failed"
        ? "Processing failed"
        : null,
    });
  } catch {
    res.status(503).json({
      error: "Status temporarily unavailable",
    });
  }
});

app.listen(
  Number(process.env.PORT || 3000),
  "127.0.0.1",
  () => console.log("Queue API ready")
);
در این معماری، API پس از ثبت موفق Job پاسخ 202 Accepted ارسال میکند. این کد به معنی پایان پردازش نیست؛ فقط نشان میدهد درخواست برای پردازش بعدی پذیرفته شده است.
همچنین در مثال بالا وضعیت Queue پیش از افزودن Job خوانده میشود. این روش برای نمایش مفهوم Backpressure مناسب است، ولی بررسی و ثبت آن اتمیک نیست و در چند Producer همزمان ممکن است تعداد کارها از حد ۱۰۰۰ عبور کند.
برای Production باید ظرفیت پذیرش با یک شمارنده اتمیک و رزرو ظرفیت در Redis یا یک مکانیزم پذیرش تراکنشی کنترل شود. ظرفیت رزروشده باید در تمام مسیرهای موفقیت، شکست نهایی، لغو و بازیابی کار آزاد شود؛ در غیر این صورت سیستم بهمرور ظرفیت کاذب مصرفشده خواهد داشت.
مرحله پنجم: ساخت Worker برای پردازش AI API
حالا فایل worker.mjs را ایجاد کنید. این Worker درخواستهای موجود در صف را به API مدل زبانی ارسال میکند.
import "dotenv/config";
import { Worker, UnrecoverableError } from "bullmq";
import IORedis from "ioredis";
import OpenAI from "openai";
import {
  QUEUE_NAME,
  redisOptions,
} from "./queue.mjs";

if (!process.env.OPENAI_API_KEY ||
    !process.env.AI_MODEL) {
  throw new Error("Configure AI credentials and model");
}

const connection = new IORedis({
  ...redisOptions,
  maxRetriesPerRequest: null,
});

const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  maxRetries: 0,
  timeout: 25000,
});

const worker = new Worker(
  QUEUE_NAME,
  async (job) => {
    try {
      const response = await client.responses.create({
        model: process.env.AI_MODEL,
        input: job.data.prompt,
        max_output_tokens: 250,
      });

      return {
        text: response.output_text,
        processed_at: new Date().toISOString(),
      };
    } catch (err) {
      const status = err.status;

      if ([400, 401, 403, 404].includes(status)) {
        throw new UnrecoverableError(
          `Permanent upstream error: ${status}`
        );
      }

      throw err;
    }
  },
  {
    connection,
    concurrency: 3,
    limiter: {
      max: 30,
      duration: 60000,
    },
  }
);

worker.on("completed", job => {
  console.log("Completed:", job.id);
});

worker.on("failed", (job, err) => {
  console.error(
    "Failed:",
    job?.id,
    err.message
  );
});

worker.on("error", err => {
  console.error("Worker error:", err.message);
});

async function shutdown() {
  await worker.close();
  await connection.quit();
  process.exit(0);
}

process.once("SIGINT", shutdown);
process.once("SIGTERM", shutdown);
این Worker بهصورت نمونه حداکثر سه Job را همزمان اجرا میکند و نرخ شروع پردازش را با Limiter کنترل میکند. SDK نیز در این نمونه Retry داخلی ندارد تا تعداد تلاشهای واقعی با تنظیمات صف قابل محاسبه باشد.
در استفاده عملی باید محدودیتهای RPM و TPM واقعی مدل را در نظر بگیرید. Limiter مبتنی بر تعداد Job بهتنهایی تضمین نمیکند که سهمیه توکن رعایت شود؛ ممکن است ۳۰ درخواست بسیار طولانی بیش از ظرفیت توکنی مجاز مصرف کنند.
همچنین Timeout کلاینت به معنای توقف قطعی عملیات در سرور ارائهدهنده نیست. ممکن است درخواست در سمت سرویس AI انجام شده باشد، اما پاسخ به Worker نرسیده باشد؛ بنابراین Retry میتواند پردازش یا هزینه تکراری ایجاد کند.
مرحله ششم: اجرای API و Worker و تست اولیه
ابتدا در ترمینال اول API را اجرا کنید:
node server.mjsسپس در ترمینال دوم Worker را اجرا کنید:
node worker.mjsدر ترمینال سوم، با توکن آزمایشی درخواست ارسال کنید:
curl -X POST http://127.0.0.1:3000/ai/jobs \
  -H "Content-Type: application/json" \
  -H "x-demo-token: YOUR_DEMO_TOKEN" \
  -d '{
    "prompt": "Explain Redis queues briefly."
  }'
در صورت پذیرش موفق، پاسخی مشابه زیر دریافت میکنید:
{
  "job_id": "1",
  "status": "queued",
  "status_url": "/ai/jobs/1"
}
شناسه بالا صرفاً نمونه است. برای بررسی نتیجه واقعی، شناسه برگشتی را در درخواست وضعیت جایگزین کنید:
curl http://127.0.0.1:3000/ai/jobs/1 \
  -H "x-demo-token: YOUR_DEMO_TOKEN"
وضعیت میتواند در انتظار، فعال، تکمیلشده یا شکستخورده باشد. پس از اتمام کار، نتیجه ذخیرهشده در Job قابل دریافت است، مگر اینکه بهدلیل سیاست نگهداری حذف شده باشد.
محدودیت امنیتی نمونه: API آموزشی فقط یک توکن مشترک دارد و برای چند مشتری مستقل مناسب نیست. در محصول واقعی باید مالکیت Job و مجوز مشاهده نتیجه بر اساس کاربر یا Tenant کنترل شود؛ صرف دانستن شناسه Job نباید امکان دسترسی به پاسخ دیگران را فراهم کند.
چگونه Concurrency مناسب Worker را تعیین کنیم؟
Concurrency تعداد Jobهایی است که یک Worker میتواند همزمان پردازش کند. اگر کارها بیشتر منتظر پاسخ API ابری هستند، Concurrency بالاتر ممکن است استفاده بهتری از منابع شبکه ایجاد کند.
اما اگر Worker روی همان سرور مدل محلی اجرا شود و کارها پردازش CPU یا GPU سنگین داشته باشند، افزایش Concurrency میتواند باعث کمبود حافظه و کاهش سرعت شود.
برای شروع، یک مقدار محافظهکارانه انتخاب کنید و سپس با تست بار آن را تغییر دهید. در نمونه آموزشی از مقدار ۳ استفاده کردیم، ولی این مقدار برای تمام سرورها مناسب نیست.
اگر چند Worker روی چند سرور اجرا میکنید، مجموع عملیات همزمان اهمیت دارد. برای مثال، چهار Worker با Concurrency برابر ۳ میتوانند تا ۱۲ کار را همزمان آغاز کنند، مگر اینکه محدودیت سراسری دیگری اعمال شده باشد.
در نسخههایی از BullMQ که Global Concurrency را پشتیبانی میکنند میتوان سقف سراسری را با API خود صف تنظیم کرد:
await aiQueue.setGlobalConcurrency(4);این سقف با Concurrency محلی Worker متفاوت است. مستندات:
Global Concurrency در BullMQ.
کنترل RPM و TPM برای جلوگیری از خطای 429
دو محدودیت مهم ارائهدهندگان AI عبارتاند از:
- RPM: حداکثر تعداد درخواست در دقیقه.
- TPM: حداکثر تعداد توکن مصرفی در دقیقه.
اگر محدودیت حساب شما ۶۰ RPM باشد، بهطور ساده میتوان میانگین نرخ ارسال را نزدیک یک درخواست در ثانیه طراحی کرد، اما این کار بهتنهایی تضمین نمیکند که محدودیتهای بازه کوتاهتر رعایت شوند.
از طرف دیگر، اگر مدل شما محدودیت توکن داشته باشد، باید تعداد توکنهای ورودی و حداکثر خروجی را پیش از اجرای Job تخمین بزنید و ظرفیت توکنی را رزرو کنید.
در سیستم واقعی، Rate Limiter بهتر است برای هر Provider یا گروه مدل مشترک بهصورت مرکزی عمل کند. اگر چند Queue مستقل از یک کلید API استفاده کنند، هرکدام نباید تصور کنند تمام سهمیه متعلق به خودشان است.
تفاوت Timeout درخواست، Worker و کل Job
Timeout فقط یک عدد نیست و بهتر است سه سطح آن جداگانه بررسی شود.
| نوع Timeout | معنی | اقدام مناسب |
|---|---|---|
| HTTP Timeout | مدت انتظار اتصال کاربر به API | بازگرداندن سریع Job ID |
| Upstream Timeout | حداکثر انتظار برای پاسخ مدل | لغو تلاش یا اعلام خطا |
| Job Deadline | آخرین زمان مجاز تکمیل کار | توقف پذیرش Retry و تعیین وضعیت نهایی |
بهعنوان مثال، اگر درخواست یک گزارش فقط تا ۲ دقیقه ارزش داشته باشد، Retry آن پس از ۱۰ دقیقه ممکن است بیفایده یا حتی زیانآور باشد.
برای Production بهتر است زمان ایجاد، Deadline، زمان شروع پردازش و مدت هر تلاش در Metadata کار ثبت شوند. Worker باید پیش از اجرای مجدد بررسی کند که Deadline منقضی نشده باشد.
همچنین لغو درخواست HTTP لزوماً باعث توقف اجرای مدل در سمت ارائهدهنده نمیشود. این موضوع در سیستمهای دارای Tool Calling یا عملیات دارای اثر جانبی اهمیت بیشتری دارد.
Retry درست برای خطاهای AI API
Retry نباید برای تمام خطاها یکسان عمل کند.
| خطا | رفتار پیشنهادی |
|---|---|
| 429 موقت | رعایت Retry-After و کاهش نرخ درخواست |
| 503 یا خطای موقت سرویس | Backoff محدود همراه با Jitter |
| Timeout شبکه | Retry محتاطانه با احتمال اجرای قبلی |
| 401 یا 403 | بررسی اعتبارنامه و مجوز؛ بدون Retry کورکورانه |
| 400 مربوط به ورودی نامعتبر | اصلاح درخواست بهجای تکرار |
| سقف هزینه یا اعتبار حساب | توقف و اعلام نیاز به اقدام مدیریتی |
در نمونه آموزشی، BullMQ از Exponential Backoff استفاده میکند؛ ولی تأخیر اعلامشده توسط ارائهدهنده در هدر Retry-After هنوز بهصورت اختصاصی در سیاست Queue لحاظ نشده است.
برای Production باید این هدر در صورت وجود و معتبر بودن رعایت شود. اگر تأخیر لازم بیشتر از زمان مجاز Job باشد، نباید زودتر از زمان اعلامشده Retry کرد؛ بلکه باید کار را به زمان مناسب موکول کرد یا به وضعیت پایانیافته منتقل کرد.
همچنین اگر SDK خودش Retry انجام میدهد، باید تعداد تلاشهای SDK و BullMQ هماهنگ شوند تا دو حلقه Retry تودرتو باعث مصرف اضافی نشوند.
اولویتبندی درخواستهای AI با Priority Queue
در یک سرویس هوش مصنوعی ممکن است بعضی کارها فوری و بعضی دیگر قابلانتظار باشند. برای مثال، پاسخ به کاربر آنلاین معمولاً اولویت بیشتری از تولید گزارش شبانه دارد.
BullMQ از Priority پشتیبانی میکند. در Jobهای دارای اولویت، عدد کوچکتر اولویت بالاتری دارد؛ مثلاً Priority برابر ۱ از Priority برابر ۱۰ بالاتر است.
await aiQueue.add(
  "urgent-answer",
  { prompt: "Important support request" },
  { priority: 1 }
);

await aiQueue.add(
  "batch-summary",
  { prompt: "Summarize a public document" },
  { priority: 10 }
);
یک نکته مهم BullMQ این است که Job بدون Priority یا با مقدار صفر، در برخی رفتارهای صف قبل از Jobهای دارای اولویت قرار میگیرد. بنابراین اگر از سیاست اولویتبندی استفاده میکنید، بهتر است برای همه کلاسهای کار مقدار مشخص و معتبر تعریف کنید.
Priority بیش از حد سختگیرانه میتواند باعث گرسنگی یا Starvation کارهای کماولویت شود. برای جلوگیری از آن، میتوان ظرفیت پردازش را میان صفهای جداگانه تقسیم کرد یا برای Jobهای قدیمی محدودیت حداکثر انتظار در نظر گرفت.
منبع:
Prioritized Jobs در BullMQ.
چگونه از اجرای دوباره یک درخواست جلوگیری کنیم؟
سیستمهای Queue معمولاً تضمین اجرای دقیقاً یکبار در همه شرایط ارائه نمیدهند. ممکن است Worker بعد از ارسال درخواست به مدل، پیش از ثبت نتیجه Crash کند و همان Job دوباره اجرا شود.
در نتیجه، رفتار At-Least-Once باید در طراحی برنامه در نظر گرفته شود.
برای کنترل این وضعیت میتوان از Idempotency Key استفاده کرد؛ یعنی یک شناسه پایدار برای عملیات منطقی که از ایجاد درخواست تکراری جلوگیری میکند.
برای مثال، در تولید گزارش یک سفارش، میتوان شناسه عملیات را از شناسه سفارش و نسخه درخواست ساخت. اما باید مراقب بود دو درخواست متفاوت فقط به دلیل شباهت متن به اشتباه یکسان فرض نشوند.
Job ID یکتا در BullMQ میتواند در حذف بعضی درخواستهای تکراری کمک کند، ولی اگر Job قبلی حذف شده باشد، همان شناسه دیگر لزوماً مانع ثبت درخواست جدید نمیشود.
برای عملیات دارای اثر جانبی مانند ثبت سفارش، ارسال ایمیل یا تغییر موجودی، Idempotency باید در دیتابیس اصلی نیز اجرا شود. صرف تکیه بر Queue کافی نیست.
چه شاخصهایی را در Queue مانیتور کنیم؟
برای شناسایی ازدحام قبل از Crash باید وضعیت صف و Workerها را بهصورت مستمر اندازهگیری کنید.
- Queue Depth: تعداد کارهای در انتظار.
- Oldest Job Age: مدت انتظار قدیمیترین Job.
- Processing Throughput: تعداد Jobهای تکمیلشده در واحد زمان.
- Job Failure Rate: درصد کارهای شکستخورده.
- Retry Rate: تعداد تلاشهای مجدد.
- Worker Concurrency: تعداد کارهای فعال.
- Queue Wait P95: زمان انتظار بخش عمده درخواستها در صف.
- Redis Memory: مصرف حافظه Redis و وضعیت Persistence.
- AI API Errors: خطاهای 429، 503 و Timeout به تفکیک مدل.
بالارفتن تعداد کارها همیشه نشانه خرابی نیست؛ اما اگر نرخ ورود بهطور مداوم بیشتر از نرخ خروج باشد، صف دیر یا زود به محدودیت خواهد رسید.
برای هشدار عملیاتی، فقط تعداد Jobها را در نظر نگیرید. گاهی ۱۰۰ کار کوتاه در چند ثانیه پردازش میشوند، ولی ۲۰ کار سنگین ممکن است چندین دقیقه منابع را اشغال کنند.
چگونه سیستم Queue را زیر بار آزمایش کنیم؟
برای ارزیابی رفتار سیستم، بهتر است ابتدا از یک مدل ساختگی یا Mock Provider استفاده کنید تا بدون هزینه فراخوانی API واقعی، تأخیر و خطا را شبیهسازی کنید.
سه سناریوی مهم برای تست عبارتاند از:
- بار عادی: نرخ ورود کمتر از ظرفیت پردازش باشد.
- افزایش ناگهانی: تعداد زیادی درخواست در مدت کوتاه وارد شود.
- خرابی سرویس خارجی: مدل بهصورت موقت خطای 429 یا 503 برگرداند.
برای هر سناریو، زمان انتظار، نرخ خطا، مصرف RAM، تعداد Jobهای در صف، زمان بازیابی و درصد درخواستهای ردشده را ثبت کنید.
هدف تست این نیست که سیستم هر تعداد درخواست را بپذیرد؛ هدف این است که در زمان فشار، سرویس رفتاری قابل پیشبینی داشته باشد، ظرفیت خودش را رعایت کند و درخواستهای پذیرفتهشده را بدون گمشدن یا اجرای ناخواسته پردازش کند.
چکلیست استقرار صف AI در Production
پیش از استفاده واقعی از این معماری، موارد زیر را بررسی کنید:
- احراز هویت و سهمیه مستقل برای هر کاربر یا سازمان.
- کنترل اتمیک ظرفیت پذیرش درخواست.
- محدودیت همزمانی در سطح Worker و کل سرویس.
- کنترل RPM و TPM به تفکیک ارائهدهنده و مدل.
- سیاست Retry با Backoff، Jitter و Retry-After.
- Deadline برای پایان اعتبار Job.
- Idempotency و جلوگیری از اثرات جانبی تکراری.
- کنترل دسترسی به نتیجه Job بر اساس مالکیت.
- رمزنگاری و عدم نگهداری اطلاعات حساس غیرضروری در Redis.
- Persistence، نسخه پشتیبان و نظارت بر مصرف حافظه Redis.
- مدیریت Shutdown و بازیابی Jobهای نیمهتمام.
- تفکیک Queueهای فوری و پردازشهای دستهای در صورت نیاز.
- هشدار برای رشد مداوم صف، توقف Worker و افزایش خطا.
اگر همه این موارد پیادهسازی شوند، احتمال ازکارافتادن سیستم بر اثر هجوم درخواستها کاهش مییابد؛ هرچند هیچ معماری صفی بهتنهایی تضمین دسترسپذیری صددرصدی نمیدهد.
اشتباههای رایج در طراحی LLM Request Queue
۱. صف نامحدود بدون Admission Control
اگر هر درخواست وارد صف شود، با ترافیک بیش از ظرفیت، حافظه و زمان انتظار رشد میکنند. باید سقف پذیرش و سیاست رد درخواست مشخص باشد.
۲. افزایش Concurrency بدون توجه به TPM
ممکن است تعداد درخواستهای همزمان کم باشد، ولی مصرف توکن از سهمیه API عبور کند. تعداد درخواست و حجم توکن دو محدودیت متفاوتاند.
۳. Retry تمام خطاها
تکرار خطاهای احراز هویت، مدل ناموجود یا ورودی نامعتبر فقط منابع و زمان را هدر میدهد. Retry باید بر اساس نوع خطا تصمیمگیری شود.
۴. نگهداری Prompt محرمانه بدون سیاست حذف
Jobهای موجود در Redis ممکن است متن کامل درخواست و نتیجه را ذخیره کنند. باید محدوده دسترسی، نگهداری و حذف داده تعریف شود.
۵. اولویتبندی بدون جلوگیری از Starvation
اگر تمام ظرفیت صرف کارهای فوری شود، درخواستهای معمولی ممکن است برای مدت طولانی در صف بمانند. تفکیک ظرفیت یا سیاست Aging کمک میکند.
۶. فرض اینکه Timeout مانع اجرای قبلی میشود
قطع ارتباط با API همیشه به معنی متوقفشدن پردازش در سمت ارائهدهنده نیست. اجرای تکراری باید در هزینه و Idempotency لحاظ شود.
چه زمانی استفاده از Queue ضروری است؟
اگر برنامه فقط تعداد محدودی درخواست کوتاه و همزمان دارد، یک محدودکننده ساده Concurrency ممکن است کافی باشد. ایجاد صف توزیعشده، Redis، Worker مستقل و سیستم وضعیت کار، پیچیدگی عملیاتی بیشتری ایجاد میکند.
اما برای پردازش فایلها، تولید گزارش، Embedding، پردازش دستهای و برنامههایی که هجوم درخواست یا اختلال موقت API در آنها قابل انتظار است، استفاده از Queue مزایای قابلتوجهی دارد.
برای برنامههای چت تعاملی و Streaming نیز باید تجربه کاربر را جداگانه طراحی کرد؛ همه درخواستهای زنده را نمیتوان مانند یک گزارش پسزمینه به صف طولانی منتقل کرد. گاهی ترکیب ظرفیت تعاملی رزروشده و صف جداگانه برای کارهای سنگین انتخاب مناسبتری است.
جمعبندی؛ چگونه جلوی Crash سرور AI را بگیریم؟
LLM Request Queue یک ابزار مهم برای کنترل فشار بر API هوش مصنوعی و سرور برنامه است. با انتقال کارهای طولانی به Workerهای پسزمینه، میتوان تعداد عملیات همزمان را کنترل کرد، درخواستها را اولویتبندی کرد و خطاهای موقت را با سیاست مشخص مدیریت کرد.
اما پایداری واقعی زمانی به دست میآید که Queue در کنار Backpressure، محدودیت ظرفیت، کنترل RPM و TPM، Timeout مناسب، Retry محدود، نظارت عملیاتی و امنیت داده استفاده شود.
برای شروع، یک صف کوچک با تعداد Worker محدود بسازید، سناریوهای شلوغی و خرابی را آزمایش کنید و سپس ظرفیت را متناسب با آمار واقعی افزایش دهید. بهترین سیستم، سیستمی نیست که همه درخواستها را بدون محدودیت قبول کند؛ بلکه سیستمی است که در زمان ازدحام نیز قابل پیشبینی و قابل بازیابی باقی بماند.
سؤالات متداول درباره LLM Request Queue
آیا Redis Queue بهتنهایی جلوی Crash سرور را میگیرد؟
خیر. صف باید همراه با محدودیت ظرفیت، Backpressure، Concurrency و نظارت بر منابع پیادهسازی شود.
تفاوت Queue و Rate Limit چیست؟
Queue کارها را نگهداری و زمانبندی میکند، اما Rate Limit سرعت اجرای درخواستها را محدود میکند. معمولاً هر دو لازماند.
برای Queue هوش مصنوعی BullMQ بهتر است یا Celery؟
برای پروژههای Node.js معمولاً BullMQ گزینه مناسبی است و برای Python و Django میتوان Celery را بررسی کرد. انتخاب به معماری و تیم توسعه بستگی دارد.
چند Worker برای AI API مناسب است؟
عدد ثابتی وجود ندارد. ظرفیت واقعی مدل، RPM، TPM، منابع سرور، مدت درخواستها و بار همزمان تعیینکنندهاند.
آیا Retry خطای 429 همیشه درست است؟
فقط وقتی خطا موقت است و زمان مجاز Job اجازه میدهد. باید Retry-After رعایت شود و تعداد تلاشها محدود باشد.
چطور درخواستهای مهم را زودتر پردازش کنیم؟
میتوان از Priority Queue یا صفهای مستقل با ظرفیت رزروشده استفاده کرد و برای جلوگیری از انتظار بیپایان کارهای عادی سیاست جداگانه داشت.
دیدگاهها (۰)