
 Amir Jabbari
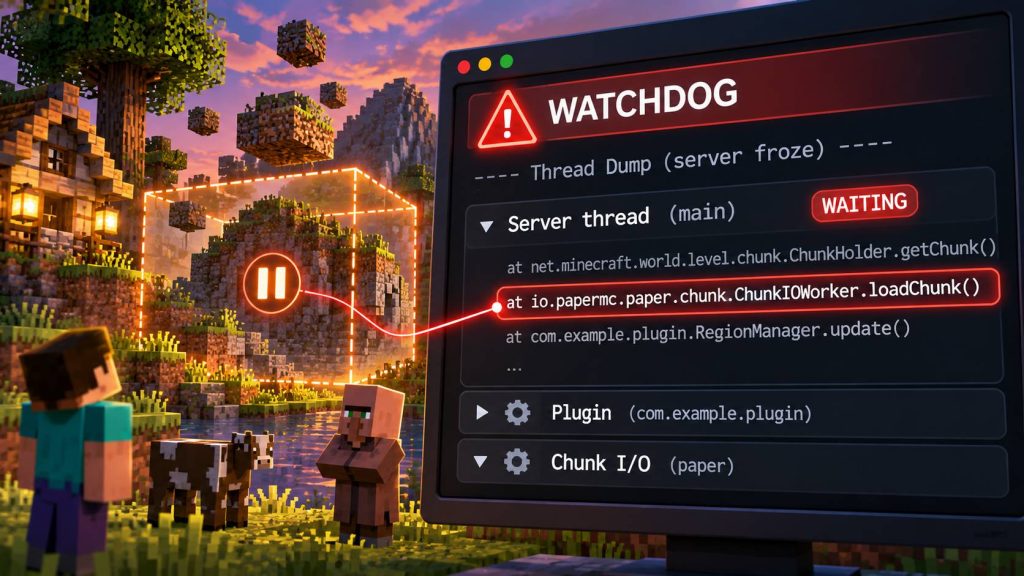
اگر سرور ماینکرافت شما ناگهان هنگ میکند، بازیکنان از سرور خارج میشوند یا در کنسول پیام Paper Watchdog نمایش داده میشود، احتمالاً Thread اصلی سرور برای مدت غیرعادی درگیر یک عملیات شده است. این مشکل ممکن است با یک پلاگین، بارگذاری Chunk، عملیات دیسک، ارتباط با دیتابیس یا حتی قفلشدن چند Thread ارتباط داشته باشد.
یکی از پیامهای شناختهشده در این شرایط عبارت DO NOT REPORT THIS TO PAPER است. این پیام معمولاً همراه با یک Thread Dump نمایش داده میشود؛ گزارشی که وضعیت اجرای Threadهای جاوا را در لحظه هنگکردن سرور نشان میدهد.
نکته مهم این است که مشاهده هشدار Watchdog همیشه به معنی Crash نیست. Paper ممکن است ابتدا به دلیل طولانیشدن یک Tick هشدار بدهد و گزارش تهیه کند. اگر توقف ادامه پیدا کند و از آستانه نهایی عبور کند، امکان خاموششدن اجباری سرور وجود دارد.
در این آموزش ایرانیکاسرور یاد میگیرید Paper Watchdog چیست، چگونه فایلهای Log و Crash Report را پیدا کنید، Thread Dump را بخوانید و از روی Stack Trace تشخیص دهید مشکل احتمالی از پلاگین، Chunk Loading، عملیات I/O یا منابع سرور است. همچنین روش استفاده از Spark برای تأیید علت مشکل و جلوگیری از تکرار آن را بررسی میکنیم.
Paper Watchdog چیست و چرا سرور ماینکرافت را متوقف میکند؟
Watchdog یک سازوکار نظارتی است که وضعیت پاسخگویی Thread اصلی سرور را کنترل میکند. در سرورهای معمولی Minecraft Java، منطق اصلی بازی باید Tickها را بهصورت پیوسته پردازش کند.
ماینکرافت بهطور معمول هدف ۲۰ Tick در ثانیه را دنبال میکند؛ یعنی حدود ۵۰ میلیثانیه زمان برای هر Tick.
اگر یک Tick بسیار طولانی شود، بازیکنان ممکن است با توقف حرکت موجودات، تأخیر در تعاملات، قطع اتصال یا فریزشدن کامل دنیای بازی مواجه شوند.
Watchdog برای تشخیص چنین توقفهای غیرعادی طراحی شده است. در تنظیمات متداول Paper ممکن است پس از حدود ۱۰ ثانیه عدم پاسخگویی، هشدار و Thread Dump ایجاد شود. در صورت ادامه توقف تا آستانه نهایی، که معمولاً ۶۰ ثانیه است، سرور میتواند بهصورت اجباری متوقف شود.
این زمانها به نسخه و تنظیمات سرور وابستهاند و نباید برای تمام نصبهای Paper یکسان فرض شوند.
تفاوت Watchdog Warning و Watchdog Crash
این دو وضعیت را نباید یکسان در نظر گرفت:
| وضعیت | معنی | اقدام |
|---|---|---|
| Watchdog Warning | یک Tick بیش از حد معمول طول کشیده است | بررسی Thread Dump و وضعیت عملکرد |
| Server Not Responding | Thread اصلی برای مدت قابلتوجه پاسخ نداده است | شناسایی عملیات مسدودکننده |
| Watchdog Shutdown | توقف از آستانه نهایی عبور کرده است | بررسی گزارش و بازیابی کنترلشده |
| JVM Crash یا OOM Kill | فرآیند جاوا به دلایل دیگری متوقف شده است | بررسی گزارش JVM و سیستمعامل |
بنابراین اگر در کنسول فقط هشدار اولیه را مشاهده کردید اما سرور بعداً به کار خود ادامه داد، لزوماً Crash رخ نداده است. بااینحال، تکرار این هشدار نشانه مشکلی است که باید بررسی شود.
مرحله اول: پیدا کردن گزارش Paper Watchdog در کنسول و فایلهای سرور
اولین قدم برای عیبیابی، پیدا کردن گزارش کامل است. صرف مشاهده آخرین خط کنسول یا پیام Restart شدن سرور برای تشخیص علت کافی نیست.
در سرورهای Paper معمولاً باید این محلها را بررسی کنید:
- logs/latest.log: گزارش مربوط به اجرای فعلی یا آخرین اجرای ثبتشده، بسته به وضعیت سرور.
- logs/: فایلهای آرشیوشده مربوط به اجراهای قبلی.
- crash-reports/: گزارشهای Crash در صورت ایجادشدن توسط سرور.
- خروجی کنسول پنل: بهخصوص زمانی که سرور بلافاصله بعد از توقف، دوباره اجرا میشود.
- لاگهای سیستمعامل: برای تشخیص توقف ناشی از کمبود حافظه یا مشکل سرویس.
اگر پنل میزبانی قابلیت Auto Restart دارد، پیش از اجرای مجدد مکرر سرور، گزارشهای مربوط به زمان خطا را ذخیره کنید. Restart خودکار ممکن است تشخیص توالی واقعی رخدادها را دشوار کند.
جستوجوی خطای Watchdog در لینوکس
اگر به SSH و فایلهای سرور دسترسی دارید، در پوشه اصلی Minecraft دستور زیر را اجرا کنید:
grep -nEi 'watchdog|not responded|not responding|single server tick|thread dump' logs/latest.logبرای بررسی گزارشهای قدیمیتر:
zgrep -nEi 'watchdog|not responded|single server tick' logs/*.gzاین دستورات فقط به شناسایی محل پیامها کمک میکنند. برای تحلیل اصلی باید چند ده یا چند صد خط بعد از پیام Watchdog، مخصوصاً بخش Server thread dump، بررسی شود.
مرحله دوم: شناسایی پیام اصلی Watchdog
یک گزارش Watchdog ممکن است حاوی پیامهایی مشابه نمونه زیر باشد:
[Paper Watchdog Thread/ERROR]:
--- DO NOT REPORT THIS TO PAPER ---

[Paper Watchdog Thread/ERROR]:
The server has not responded for 10 seconds!
Creating thread dump
نمونه بالا خلاصه و آموزشی است و قالب دقیق پیام در نسخههای مختلف Paper متفاوت خواهد بود.
عبارت DO NOT REPORT THIS TO PAPER به این معنی نیست که هیچوقت احتمال باگ در Paper وجود ندارد. هدف این هشدار آن است که ابتدا علتهای رایج مانند پلاگینها، عملیات سنگین و مشکلات زیرساخت بررسی شوند.
اگر گزارش نشان دهد مشکل از یک مسیر داخلی Paper است و بتوان آن را در محیط مناسب بازتولید کرد، ممکن است بررسی توسط توسعهدهندگان Paper نیز ضروری باشد.
مرحله سوم: Thread Dump چیست و چه اطلاعاتی به ما میدهد؟
Thread Dump گزارشی از وضعیت Threadهای یک برنامه جاوا در یک لحظه مشخص است. هر Thread میتواند در حال اجرای کد، انتظار برای یک رویداد، دریافت اطلاعات یا انتظار برای آزادشدن یک Lock باشد.
در سرور ماینکرافت، Thread Dump نشان میدهد هنگام ثبت گزارش، بخشهای مختلف JVM در چه وضعیتی بودهاند.
برای عیبیابی Paper Watchdog، مهمترین قسمت معمولاً Stack مربوط به Thread پردازش اصلی سرور است.
Thread اصلی سرور یا Server thread چیست؟
در سرورهای معمولی Paper، بسیاری از فعالیتهای اصلی بازی از طریق یک Thread مرکزی پردازش میشوند. این عملیات شامل اجرای Tickها، مدیریت Entityها، بخشهایی از پردازش جهان و فراخوانیهای مرتبط با پلاگینها هستند.
اگر یک عملیات طولانی یا مسدودکننده روی این Thread اجرا شود، ممکن است پردازش Tickهای بعدی متوقف شود.
نکته مهم این است که تمام Threadهای موجود در Dump مربوط به پردازش اصلی بازی نیستند. ممکن است Threadهای شبکه، دیتابیس، فایل، Garbage Collector و Taskهای جانبی نیز در گزارش دیده شوند.
بنابراین نباید اولین Thread یا اولین نام پلاگین موجود در فایل را عامل اصلی Crash فرض کرد.
مرحله چهارم: پیدا کردن Server thread در گزارش Watchdog
در بسیاری از گزارشهای Paper، بخش مهم با عبارتی مشابه زیر مشخص میشود:
Server thread dump
(Look for plugins here before reporting to Paper!)
در این بخش باید Stack Trace را خطبهخط بررسی کنید.
در Thread Dumpهای استاندارد جاوا، هر فراخوانی معمولاً با عبارت at شروع میشود. خطهای بالاتر Stack نشاندهنده تابعهایی هستند که در لحظه ثبت گزارش در بخش عمیقتر زنجیره فراخوانی قرار دارند.
برای مثال، یک Stack آموزشی ممکن است چنین ساختاری داشته باشد:
"Server thread" #25
   java.lang.Thread.State: RUNNABLE

    at com.example.heavyplugin.Task.scanEntities(Task.java:84)
    at com.example.heavyplugin.Task.run(Task.java:42)
    at org.bukkit.craftbukkit.scheduler.CraftTask.run(...)
    at org.bukkit.craftbukkit.scheduler.CraftScheduler.mainThreadHeartbeat(...)
    at net.minecraft.server.MinecraftServer.tickChildren(...)
این مثال ساختگی است و صرفاً برای توضیح ساختار Stack نوشته شده است.
در این نمونه، نام یک پلاگین فرضی داخل مسیر اجرای Task دیده میشود. همچنین Stack نشان میدهد که Task از طریق Scheduler اجرا شده است.
اگر همین مسیر در چند Dump متوالی تکرار شود و شواهد عملکردی نیز آن را تأیید کنند، احتمال درگیری پلاگین در توقف سرور افزایش پیدا میکند.
اما یک Stack Trace بهتنهایی همیشه علت قطعی را مشخص نمیکند؛ زیرا فقط وضعیت اجرای برنامه را در یک لحظه ثبت کرده است.
مرحله پنجم: معنی RUNNABLE، WAITING و BLOCKED در Thread Dump
یکی از مهمترین قسمتهای تحلیل Thread Dump، بررسی وضعیت Thread است.
| وضعیت Thread | معنی | نکته عیبیابی |
|---|---|---|
| RUNNABLE | Thread در وضعیت قابل اجرا یا اجرای عملیات است | بررسی تابع فعال، حلقه سنگین یا I/O بومی |
| WAITING | Thread منتظر یک رویداد یا هماهنگی است | بررسی علت انتظار و Threadهای وابسته |
| TIMED_WAITING | انتظار با محدودیت زمانی | ممکن است حالت طبیعی یا بخشی از توقف باشد |
| BLOCKED | انتظار برای ورود به بخش synchronized | بررسی Lock و Thread مالک آن |
آیا RUNNABLE همیشه به معنی مصرف بالای CPU است؟
خیر. وضعیت RUNNABLE در جاوا لزوماً نشان نمیدهد Thread در همان لحظه واقعاً CPU مصرف میکند. بعضی عملیات I/O بومی نیز ممکن است با این وضعیت نمایش داده شوند.
بنابراین باید Stack، رفتار CPU و اطلاعات زمان رخداد را در کنار یکدیگر بررسی کرد.
اگر Server thread در وضعیت BLOCKED باشد چه کنیم؟
در این حالت Thread ممکن است منتظر آزادشدن یک قفل باشد. باید در گزارش به دنبال اطلاعات Lock و Thread دیگری بگردید که آن قفل را در اختیار دارد.
اگر امکان تهیه چند Dump در فاصلههای کوتاه وجود داشته باشد، میتوان بررسی کرد آیا وضعیت قفل و زنجیره انتظار ثابت باقی مانده است یا خیر.
همچنین باید میان انتظار طبیعی Threadها و Deadlock واقعی تفاوت قائل شد. هر WAITING یا BLOCKED به معنای Deadlock نیست.
مرحله ششم: پیدا کردن پلاگین مقصر در Watchdog Dump
پلاگینها یکی از منابع احتمالی توقف Thread اصلی هستند؛ بهخصوص زمانی که عملیات طولانی، درخواست شبکه یا پردازش گسترده را بهصورت همگام اجرا کنند.
برای پیدا کردن پلاگین مشکوک، در Stack مربوط به Server thread به دنبال نام Package یا Classهای غیرمرتبط با کد اصلی Minecraft و Paper بگردید.
برای مثال:
at com.example.myplugin.DatabaseManager.load(...)
at com.example.myplugin.PlayerListener.onJoin(...)
at org.bukkit.plugin.RegisteredListener.callEvent(...)
در این نمونه آموزشی، نام پلاگین فرضی داخل Stack دیده میشود. اگر تابع DatabaseManager.load در حال انجام عملیات کند دیتابیس باشد، احتمال دارد Handler مربوط به ورود بازیکن Thread اصلی را منتظر نگه داشته باشد.
بااینحال، باید بررسی شود آیا کندی از پیادهسازی پلاگین است یا از سرویس خارجی، اتصال شبکه یا منبع دیگری ناشی میشود.
چطور نقش پلاگین را تأیید کنیم؟
- نام و نسخه پلاگین مشکوک را ثبت کنید.
- بررسی کنید آیا Stackهای متوالی به همان مسیر اشاره میکنند.
- لاگهای قبل از رخداد را برای یافتن رویداد فعالکننده بررسی کنید.
- در صورت امکان، مشکل را در محیط آزمایشی بازتولید کنید.
- یک تغییر کنترلشده در تنظیمات یا نسخه پلاگین انجام دهید.
- با گزارش جدید بررسی کنید آیا توقف دوباره رخ میدهد یا خیر.
برای حذف یا جایگزینی پلاگین در محیط عملیاتی، ابتدا بکاپ تهیه کنید و از راهاندازی مجدد کامل استفاده کنید؛ زیرا Reload کردن بعضی پلاگینها میتواند وضعیت سرور را ناپایدار کند.
مرحله هفتم: تشخیص مشکل Chunk Loading و World Generation
اگر در Thread Dump مسیرهایی مرتبط با Chunk Loading، تولید جهان یا انتظار برای نتیجه عملیات Chunk مشاهده میکنید، مشکل ممکن است به فعالیتهای مربوط به جهان ماینکرافت ارتباط داشته باشد.
برای مثال، یک پلاگین ممکن است هنگام Teleport کردن بازیکن، Chunk موردنظر را بهصورت همگام درخواست کند. اگر تکمیل این عملیات طول بکشد، Thread اصلی ممکن است منتظر بماند.
نمونه سادهشده یک Stack احتمالی:
at java.util.concurrent.CompletableFuture.join(...)
at net.minecraft.server.level.ServerChunkCache.getChunk(...)
at com.example.teleportplugin.TeleportTask.run(...)
at org.bukkit.craftbukkit.scheduler.CraftTask.run(...)
نام دقیق متدهای داخلی با توجه به نسخه Minecraft و Paper متفاوت است.
در چنین شرایطی باید هم درخواستکننده Chunk و هم دلیل طولانیشدن عملیات بارگذاری بررسی شوند.
چه عواملی Chunk Loading را کند میکنند؟
- Teleport همزمان تعداد زیادی بازیکن
- تولید Chunkهای جدید در مناطق کشفنشده
- بارگذاری گسترده مناطق توسط پلاگینها
- تأخیر زیاد در خواندن فایلهای جهان
- مشکل در دادههای یک Region یا Chunk مشخص
- فشار پردازشی هنگام World Generation
اگر مشکل فقط هنگام ورود به یک منطقه خاص رخ میدهد، لازم است دادههای آن منطقه بررسی شود. بااینحال، حذف فایل Region بدون تهیه بکاپ میتواند بخش بزرگی از جهان و سازههای بازیکنان را از بین ببرد.
استفاده از ابزارهای پیشتولید Chunk نیز باید در زمان مناسب و تحت نظارت منابع انجام شود؛ زیرا این فرآیند خودش میتواند فشار پردازشی ایجاد کند.
مرحله هشتم: پیدا کردن عملیات I/O و دیتابیس در Thread Dump
ورودی/خروجی یا I/O شامل فعالیتهایی مانند خواندن فایل، ذخیره اطلاعات، ارتباط با دیتابیس و درخواستهای شبکه است.
اگر یک عملیات I/O کند روی Thread اصلی اجرا شود، ممکن است سرور تا پایان آن عملیات نتواند Tickهای بعدی را پردازش کند.
نشانههای I/O در Stack Trace
بسته به نوع عملیات، ممکن است نامهایی مرتبط با موارد زیر مشاهده کنید:
- FileInputStream و FileOutputStream
- خواندن یا نوشتن دادههای فایلسیستم
- SocketRead و عملیات شبکه
- JDBC و درایورهای دیتابیس
- CompletableFuture و انتظار برای نتیجه عملیات
- فراخوانیهای ذخیرهسازی جهان و فایلهای Region
برای مثال، اگر Stack نشان دهد یک پلاگین در زمان اجرای Event منتظر دریافت نتیجه Query دیتابیس است، باید وضعیت Query، اتصال شبکه، زمان پاسخ دیتابیس و پیادهسازی پلاگین بررسی شود.
در توسعه پلاگینهای Paper، عملیات کند مانند دسترسی به فایل و دیتابیس بهتر است در شرایط مناسب خارج از Thread اصلی انجام شوند؛ البته دسترسی به APIهای غیر Thread-safe ماینکرافت نیز نباید بدون رعایت محدودیتهای Thread انجام شود.
بررسی دیسک سرور لینوکسی
اگر نشانههایی از کندی ذخیرهسازی مشاهده میکنید، وضعیت فضای دیسک را بررسی کنید:
df -h
df -i
در سرورهایی که ابزار sysstat نصب شده است، برای مشاهده آمار I/O میتوانید دستور زیر را اجرا کنید:
iostat -xz 1 5مقادیر تأخیر و بار I/O باید متناسب با نوع دیسک، ماشین مجازی و الگوی فعالیت سرور تفسیر شوند.
اگر عملیات شبکه یا دیتابیس عامل انتظار باشد، فقط بررسی دیسک محلی کافی نیست.
مرحله نهم: گرفتن Thread Dump دستی با jcmd هنگام هنگکردن سرور
گاهی Watchdog هنوز گزارش کامل ثبت نکرده یا لازم است چند نمونه از وضعیت Threadها تهیه شود. اگر فرآیند جاوا همچنان فعال است و به SSH دسترسی دارید، ابزار jcmd میتواند کمک کند.
ابتدا فرآیندهای جاوا را شناسایی کنید:
jcmd -lدر خروجی، شناسه فرآیند یا PID مربوط به سرور Minecraft را پیدا کنید.
سپس برای ثبت وضعیت Threadها از دستور زیر استفاده کنید:
jcmd PID Thread.print -l > thread-dump.txtمقدار PID باید با شناسه واقعی فرآیند جاوا جایگزین شود.
گزینه -l اطلاعات بیشتری درباره قفلهای java.util.concurrent نمایش میدهد و میتواند برای بررسی انتظار Threadها کاربردی باشد.
برای اجرای jcmd معمولاً باید ابزار JDK مناسب موجود باشد و دستور با همان کاربر اجراکننده فرآیند جاوا یا دسترسی مجاز معادل اجرا شود.
در محیطهای Container یا پنلهای محدود، ممکن است دسترسی به jcmd یا اتصال به JVM امکانپذیر نباشد.
اگر چند Dump در فاصله زمانی مناسب تهیه کنید، میتوانید بررسی کنید آیا Server thread در یک مسیر ثابت باقی مانده یا در حال پیشرفت است.
برای آشنایی بیشتر، مستندات رسمی ابزار jcmd در Java 21 را ببینید.
مرحله دهم: استفاده از Spark برای تأیید علت Watchdog
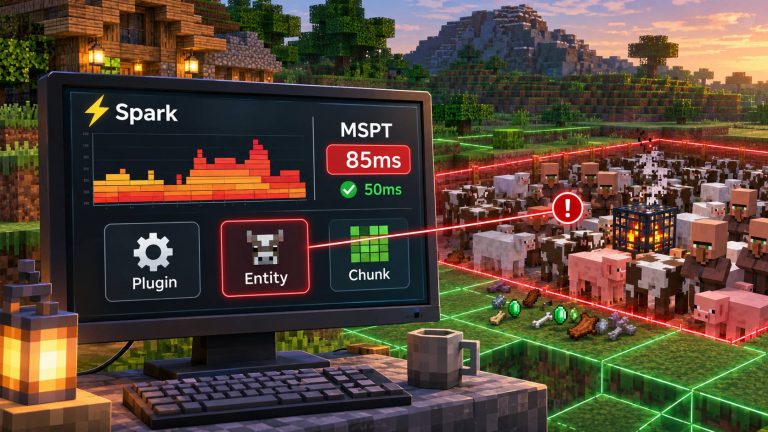
Thread Dump یک تصویر لحظهای از وضعیت برنامه است. برای تشخیص اینکه کدام عملیات بهصورت مداوم یا در بازهای مشخص منابع مصرف میکند، میتوان از Spark Profiler کمک گرفت.
در نسخههای Paper از Minecraft 1.21 به بعد، Spark بهصورت داخلی در دسترس است. در نسخههای قدیمیتر ممکن است به نصب جداگانه Spark نیاز داشته باشید.
اگر سرور بعد از رخداد Watchdog دوباره قابل استفاده شده است، در زمان تکرار شرایط مشکلساز یک پروفایل تهیه کنید.
بررسی TPS و MSPT
/spark tpsبرای ثبت یک پروفایل پنجدقیقهای:
/spark profiler start --timeout 300برای تمرکز روی Tickهایی که بیش از ۱۰۰ میلیثانیه طول میکشند:
/spark profiler start --only-ticks-over 100 --timeout 300آستانه ۱۰۰ میلیثانیه فقط یک مثال است و باید متناسب با الگوی مشکل انتخاب شود.
پس از پایان نمونهبرداری، Spark لینکی برای مشاهده گزارش در Viewer ارائه میکند.
در آنجا میتوانید سهم اجرای کدهای پلاگین، پردازش Entityها، فعالیتهای Chunk و مسیرهای دیگر را بررسی کنید.
نکته: اگر Thread اصلی کاملاً قفل شده است، ممکن است فرمانهای Spark از داخل بازی یا کنسول عادی نیز قابل پردازش نباشند. بهتر است برای مشکلات تکرارشونده، پروفایل را پیش از وقوع هنگ فعال کنید یا از ابزارهای تشخیصی سطح JVM استفاده کنید.
همچنین Spark یک ابزار نمونهبرداری است. گزارش آن باید در کنار Watchdog Dump، وضعیت CPU، حافظه و اطلاعات ذخیرهسازی تحلیل شود.
مستندات رسمی Spark در راهنمای دستورات Spark و آموزش تحلیل Spark Viewer در دسترس هستند.
مرحله یازدهم: آیا افزایش max-tick-time مشکل Watchdog را حل میکند؟
در فایل server.properties تنظیمی به نام max-tick-time وجود دارد که حداکثر زمان مجاز یک Tick را برای Watchdog مشخص میکند.
مقدار رایج پیشفرض آن به شکل زیر است:
max-tick-time=60000عدد بالا بر حسب میلیثانیه است و معادل ۶۰ ثانیه خواهد بود.
برخی مدیران سرور برای جلوگیری از خاموششدن، مقدار آن را بسیار افزایش میدهند یا Watchdog را کاملاً غیرفعال میکنند.
این روش معمولاً راهحل مناسبی برای سرور عملیاتی نیست؛ زیرا اگر Thread اصلی در یک عملیات طولانی یا انتظار بیپایان گیر کرده باشد، افزایش Timeout فقط مدت بیشتری سرور را در حالت غیرپاسخگو نگه میدارد.
تنظیم مقدار -1 برای غیرفعالکردن Watchdog نیز بهطور معمول توصیه نمیشود.
در محیط توسعه و هنگام استفاده از Debugger ممکن است غیرفعالکردن Watchdog برای جلوگیری از هشدارهای ناشی از توقف عمدی برنامه کاربرد داشته باشد؛ اما این شرایط با سرور عمومی تفاوت دارد.
پیش از تغییر Timeout باید علت اصلی توقف از طریق Thread Dump و ابزارهای تشخیصی شناسایی شود.
مرحله دوازدهم: اگر سرور بدون Thread Dump خاموش شود چه کنیم؟
همه توقفهای سرور Minecraft مربوط به Watchdog نیستند. ممکن است فرآیند جاوا توسط سیستمعامل کشته شده باشد، JVM با خطای داخلی متوقف شده باشد یا پنل میزبانی فرآیند را خاتمه داده باشد.
اگر هیچ گزارش Watchdog وجود ندارد، علت را در سطح سیستمعامل نیز بررسی کنید.
بررسی Out of Memory Kill در لینوکس
اگر دسترسی مدیریتی به سرور دارید، میتوانید پیامهای مربوط به OOM Killer را بررسی کنید:
sudo journalctl -k -b --no-pager | grep -Ei 'out of memory|oom-kill|killed process'این دستور برای بررسی رخدادهای ثبتشده در بوت فعلی کاربرد دارد. اگر سرور یا میزبان دوباره راهاندازی شده باشد، ممکن است لازم باشد بوتهای قبلی نیز بررسی شوند.
برای مثال، اگر مجموع مصرف حافظه JVM و سایر فرآیندها از محدودیت حافظه ماشین یا Container عبور کند، ممکن است فرآیند توسط سیستمعامل متوقف شود.
این نوع توقف با هنگ طولانی Server thread و توقف Watchdog تفاوت دارد.
بررسی گزارش خطای JVM
در برخی خطاهای جدی ماشین مجازی جاوا، فایلی با نامی مشابه hs_err_pid1234.log ساخته میشود.
اگر چنین فایلی وجود دارد، باید آن را نیز بررسی کنید؛ زیرا ممکن است مشکل مربوط به JVM، کتابخانه بومی یا محیط اجرا باشد.
مرحله سیزدهم: مقایسه چند Thread Dump برای تشخیص توقف واقعی
یکی از دقیقترین روشهای تحلیل هنگهای تکرارشونده، مقایسه چند Thread Dump است.
فرض کنید در سه گزارش با فاصله زمانی، Stack مربوط به Server thread تقریباً در یک مسیر ثابت باقی مانده است.
اگر این مسیر مربوط به انتظار برای پاسخ دیتابیس باشد، احتمال وجود عملیات مسدودکننده افزایش پیدا میکند. اگر Thread در یک حلقه پردازشی سنگین باقی مانده باشد، باید رفتار CPU و مدت زمان اجرای آن بررسی شود.
اما اگر Stack در هر نمونه تغییر میکند، ممکن است Thread همچنان در حال پیشرفت باشد و مشکل مربوط به کندی شدید بهجای توقف کامل باشد.
چه اطلاعاتی را از هر Dump ثبت کنیم؟
- زمان دقیق ثبت گزارش
- وضعیت Server thread
- چند فراخوانی بالایی Stack
- نام پلاگین یا مسیر کد مشکوک
- نشانههای انتظار برای Lock، I/O یا Chunk
- فعالیتهای همزمان سرور و تعداد بازیکنان
- مصرف CPU، حافظه و وضعیت دیسک در همان زمان
با این روش میتوان بهجای نتیجهگیری از یک پیام خطا، الگوی تکرارشونده توقف را شناسایی کرد.
جدول عیبیابی سریع Paper Watchdog
| نشانه در گزارش | احتمال اصلی | اقدام پیشنهادی |
|---|---|---|
| Stack مربوط به یک Plugin Task | پردازش طولانی پلاگین | بررسی Task، نسخه پلاگین و Spark |
| JDBC یا Network Read | انتظار برای دیتابیس یا شبکه | بررسی Timeout و عملیات همگام |
| ServerChunkCache و Chunk Loading | انتظار برای بارگذاری Chunk | بررسی درخواستکننده و ذخیرهسازی |
| BLOCKED و Lock | انتظار برای قفل | شناسایی Thread مالک Lock |
| World Save یا Region I/O | ذخیرهسازی یا عملیات سنگین جهان | بررسی دیسک و حجم عملیات |
| Entity Tick با سهم بالا در Spark | پردازش سنگین Entityها | بررسی فارمها و موجودات پرتراکم |
| توقف بدون Watchdog Log | احتمال OOM یا خطای JVM | بررسی لاگ سیستمعامل و hs_err |
این جدول برای اولویتبندی عیبیابی است و هیچکدام از نشانهها بهتنهایی علت قطعی را اثبات نمیکنند.
اشتباهات رایج در رفع مشکل Paper Watchdog
هنگام مواجهه با Watchdog، بعضی اقدامات ممکن است تشخیص مشکل را دشوارتر کنند.
- افزایش بیهدف max-tick-time: این کار ممکن است فقط توقف طولانی را پنهان کند.
- غیرفعالکردن Watchdog: در محیط عملیاتی میتواند باعث باقیماندن سرور در وضعیت هنگ شود.
- خواندن فقط آخرین خط لاگ: معمولاً اطلاعات اصلی در Server thread dump قرار دارد.
- مقصر دانستن اولین نام پلاگین: باید کل زنجیره فراخوانی و شرایط اجرای آن بررسی شود.
- حذف تصادفی فایلهای World: ممکن است دادههای بازیکنان از بین برود.
- افزایش RAM بدون شواهد: توقف ناشی از Lock یا I/O الزاماً با حافظه بیشتر حل نمیشود.
- استفاده از Reload برای آزمایش پلاگینها: بعضی پلاگینها از Reload ایمن پشتیبانی نمیکنند.
- نادیدهگرفتن منابع میزبان: محدودیت CPU، حافظه و دیسک میتواند عامل اصلی یا تشدیدکننده مشکل باشد.
چگونه از تکرار Watchdog Crash جلوگیری کنیم؟
برای کاهش احتمال توقفهای ناگهانی سرور Paper، بهتر است یک فرآیند نگهداری منظم داشته باشید.
- نسخه Paper و پلاگینها را پس از تهیه بکاپ و بررسی سازگاری بهروز نگه دارید.
- در بازههای پرترافیک، TPS و MSPT را مانیتور کنید.
- پیش از اعمال تغییرات مهم در پلاگینها و World بکاپ معتبر داشته باشید.
- پلاگینهایی را که عملیات همگام سنگین انجام میدهند شناسایی و اصلاح کنید.
- از اجرای گسترده عملیات Chunk Generation در ساعات شلوغ خودداری کنید.
- زمان پاسخ دیتابیس و فضای ذخیرهسازی را کنترل کنید.
- هنگام وقوع Lag Spike، از Spark برای تهیه گزارش قابلمقایسه استفاده کنید.
- در صورت تکرار Hang، چند Thread Dump از زمان مشکل تهیه کنید.
بهروزرسانی و مانیتورینگ منظم به کاهش مشکلات کمک میکنند؛ اما هیچ تنظیمی نمیتواند تضمین کند که هر نوع باگ یا توقف احتمالی کاملاً از بین میرود.
سؤالات متداول درباره Paper Watchdog و Thread Dump
آیا پیام DO NOT REPORT THIS TO PAPER یعنی خود Paper هیچ مشکلی ندارد؟
خیر. این پیام برای هدایت عیبیابی اولیه است. بسیاری از توقفها به پلاگینها، عملیات سنگین یا شرایط محیطی مربوط هستند؛ اما در صورت وجود شواهد معتبر و امکان بازتولید مشکل، احتمال باگ Paper نیز باید بررسی شود.
آیا Watchdog Warning همیشه به معنی Crash است؟
خیر. ممکن است Watchdog فقط یک توقف طولانی را ثبت کند و سرور پس از آن به کار خود ادامه دهد. اگر توقف از آستانه نهایی عبور کند، احتمال خاموششدن سرور وجود دارد.
چگونه پلاگین مقصر Watchdog را پیدا کنیم؟
ابتدا Server thread dump را بررسی کنید و مسیرهای مربوط به پلاگینها را پیدا کنید. سپس با بررسی چند گزارش، لاگهای قبلی و در صورت امکان Spark Profiler مشخص کنید آیا همان پلاگین واقعاً عامل توقف بوده است.
آیا افزایش max-tick-time برای رفع Crash مناسب است؟
معمولاً خیر. افزایش Timeout علت اصلی توقف را برطرف نمیکند و ممکن است مدت هنگکردن سرور را افزایش دهد. تغییر این مقدار باید فقط در شرایط مشخص و پس از تحلیل فنی انجام شود.
تفاوت Thread Dump با Crash Report چیست؟
Thread Dump وضعیت Threadهای JVM را در یک لحظه نشان میدهد. Crash Report گزارشی از یک خطای جدی یا توقف ثبتشده است که ممکن است شامل اطلاعاتی درباره خطا، محیط اجرا و Stack Trace باشد. در یک رخداد Watchdog ممکن است هر دو نوع اطلاعات در دسترس باشند.
اگر Server thread در حالت WAITING باشد، یعنی Deadlock رخ داده است؟
خیر. WAITING میتواند بخشی از رفتار طبیعی برنامه باشد. برای تشخیص Deadlock باید Lockها، وابستگی Threadها و وضعیت چند نمونه متوالی بررسی شوند.
آیا Spark میتواند علت توقف کامل Thread اصلی را تشخیص دهد؟
Spark برای بررسی عملکرد و مسیرهای اجرای کد بسیار مفید است، اما اگر سرور کاملاً قفل شده باشد ممکن است اجرای فرمان جدید ممکن نباشد. در این حالت Thread Dumpهای Watchdog یا ابزارهای JVM مانند jcmd اهمیت بیشتری دارند.
اگر Paper بدون هیچ لاگی بسته شود چه باید کرد؟
باید گزارشهای پنل، سیستمعامل و JVM بررسی شوند. توقف بدون لاگ میتواند ناشی از Out of Memory Kill، خطای JVM یا دخالت ابزار مدیریت سرویس باشد و الزاماً مربوط به Watchdog نیست.
جمعبندی: بهترین روش رفع Paper Watchdog Crash
زمانی که سرور ماینکرافت با هشدار Paper Watchdog مواجه میشود، مهمترین کار پیدا کردن دلیل توقف Thread اصلی است؛ نه افزایش فوری منابع یا غیرفعالکردن Watchdog.
با بررسی گزارشهای کنسول و Server thread dump میتوانید متوجه شوید سرور هنگام توقف در چه بخشی از برنامه قرار داشته است. سپس با تحلیل Stack Trace، وضعیت Lockها، عملیات Chunk، پلاگینها و I/O میتوان دامنه مشکل را محدود کرد.
اگر مشکل تکرارشونده است، استفاده از Spark Profiler و تهیه چند Thread Dump میتواند به شناسایی دقیقتر علت کمک کند. پس از هر اصلاح نیز باید عملکرد سرور در شرایط مشابه بررسی شود تا مشخص شود مشکل واقعاً برطرف شده است.
این روش باعث میشود عیبیابی Crashهای Paper از یک فرآیند حدسی به روشی مستند و قابلآزمایش تبدیل شود.
دیدگاهها (۰)