
 Amir Jabbari
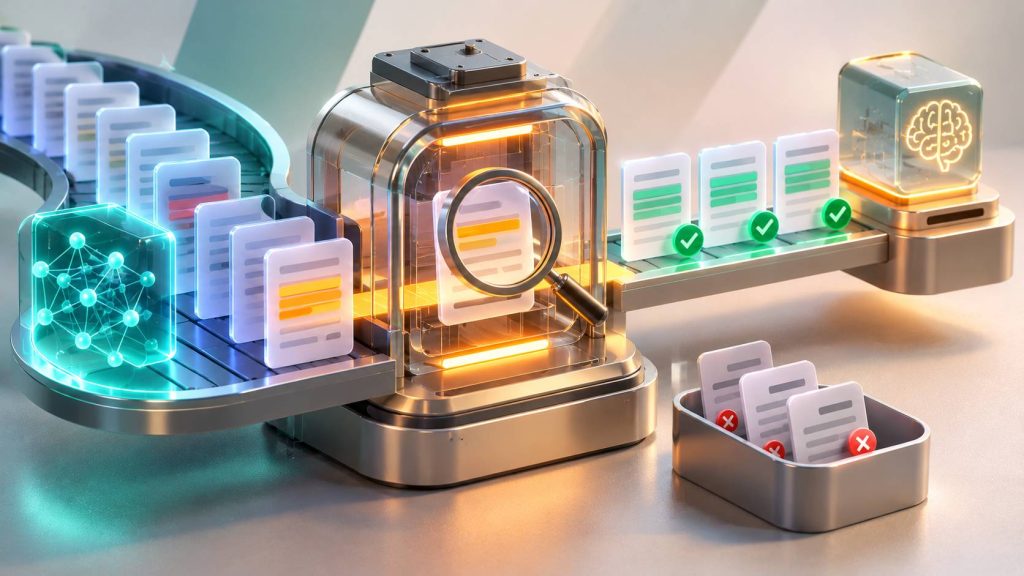
فرض کنید یک سیستم RAG برای پاسخگویی به سؤالات مشتریان ساختهاید. کاربر میپرسد «چرا API بعد از ارسال درخواستهای زیاد خطای 429 میدهد؟» و موتور جستوجوی برداری پنج سند را پیدا میکند. بااینحال، اولین نتیجه فقط درباره محدودیت منابع سرور صحبت میکند و سندی که دقیقاً علت خطای 429 را توضیح میدهد، در رتبه چهارم قرار گرفته است.
اگر سه سند اول را مستقیماً به مدل زبانی بدهید، ممکن است مهمترین منبع پاسخ حذف شود. حتی اگر Vector Search از نظر معنایی اسناد مرتبطی پیدا کرده باشد، ترتیب آنها الزاماً برای پاسخگویی دقیق مناسب نیست.
اینجا RAG Reranker وارد عمل میشود. Reranker یک مرحله رتبهبندی مجدد است که پس از بازیابی اولیه، ارتباط هر سند با سؤال کاربر را دقیقتر بررسی میکند و نتایج مناسبتر را در رتبههای بالاتر قرار میدهد.
در این مقاله یاد میگیریم Reranker چیست، چرا فقط Vector Search کافی نیست، تفاوت Bi-Encoder و Cross-Encoder چیست و چگونه پارامترهای retrieve-k، rerank-k و تعداد اسناد نهایی را تنظیم کنیم. همچنین با Python یک نمونه اجرایی میسازیم و روش ارزیابی دقت و تأخیر آن را بررسی میکنیم.
Reranker در RAG چیست؟
Reranker مدلی یا الگوریتمی است که مجموعهای از اسناد بازیابیشده را دریافت و براساس میزان ارتباط آنها با سؤال، دوباره مرتب میکند.
در معماری RAG، معمولاً دو مرحله متفاوت وجود دارد:
- Retrieval: پیدا کردن تعداد نسبتاً زیادی سند مرتبط احتمالی از میان کل مجموعه.
- Reranking: بررسی دقیقتر همان کاندیدها و تعیین ترتیب مناسب برای استفاده در پاسخ نهایی.
برای مثال، یک Retriever ممکن است ۴۰ Chunk را از میان هزاران سند پیدا کند. سپس Reranker همین ۴۰ Chunk را بررسی کند و پنج مورد مناسبتر برای پاسخگویی را انتخاب کند.
این الگو با عنوان Retrieve & Re-Rank شناخته میشود.
برخلاف مرحله بازیابی اولیه، Reranker معمولاً روی تعداد محدودی از اسناد کار میکند؛ زیرا بررسی دقیق هر جفت سؤال و سند نسبت به بازیابی برداری ساده پرهزینهتر است.
منبع:
راهنمای رسمی Retrieve & Re-Rank در Sentence Transformers.
چرا Vector Search بهتنهایی کافی نیست؟
Vector Search با تبدیل سؤال و اسناد به Embedding، شباهت آنها را در یک فضای برداری محاسبه میکند. این روش برای پیدا کردن ارتباطهای معنایی بسیار مفید است، اما همیشه دقیقترین ترتیب اسناد را تولید نمیکند.
۱. شباهت معنایی همیشه به معنی پاسخ مناسب نیست
فرض کنید سؤال درباره روش رفع خطای 502 باشد. دو سند ممکن است از نظر موضوعی به سرور، Gateway و شبکه ارتباط داشته باشند، اما فقط یکی از آنها مراحل واقعی عیبیابی را توضیح دهد.
مدل Embedding میتواند هر دو را نزدیک تشخیص دهد، ولی ممکن است سند کاربردیتر در رتبه پایینتر قرار بگیرد.
۲. تفاوتهای کوچک در متن اهمیت دارند
سؤال «چگونه SSL را تمدید کنم؟» با «چگونه SSL را غیرفعال کنم؟» کلمات مشترک زیادی دارد، اما هدف دو سؤال متفاوت است.
مدلی که سؤال و سند را بهصورت جداگانه به بردار تبدیل میکند، ممکن است همیشه این تفاوتها را با دقت کافی در رتبهبندی منعکس نکند.
۳. نزدیکترین Chunk لزوماً کاملترین پاسخ نیست
گاهی Chunk اول فقط مقدمه یک موضوع است، درحالیکه Chunk سوم شامل دستورها، استثناها و شرایط دقیق انجام کار است.
اگر Context محدود باشد، انتخاب نادرست Chunkها میتواند کیفیت پاسخ نهایی را کاهش دهد.
۴. بازیابی تقریبی ممکن است خطا داشته باشد
بعضی موتورهای Vector Search از الگوریتمهای Approximate Nearest Neighbor یا ANN استفاده میکنند. این الگوریتمها سرعت را افزایش میدهند، اما ممکن است همه نزدیکترین بردارهای واقعی را پیدا نکنند.
Reranker میتواند ترتیب کاندیدهای دریافتشده را بهتر کند، اما نمیتواند سندی را که اصلاً در مرحله بازیابی پیدا نشده است، بازیابی کند.
نتیجه: Reranking کیفیت انتخاب و ترتیب اسناد موجود را هدف قرار میدهد؛ نه اینکه جایگزین یک Retriever با Recall مناسب شود.
معماری Retrieve & Re-Rank چگونه است؟
در یک خط لوله استاندارد، ابتدا سؤال کاربر وارد Retriever میشود، سپس اسناد پیداشده توسط Reranker ارزیابی و بهترین موارد برای مدل زبانی ارسال میشوند.
User Question
      |
      v
Query Embedding
      |
      v
Vector Search
      |
      v
Retrieve Top 40
      |
      v
Deduplication / Access Control
      |
      v
Rerank Top 20
      |
      v
Cross-Encoder Scores
      |
      v
Select Final Top 5
      |
      v
Context Construction
      |
      v
LLM Answer + Source IDs
در این مثال، ابتدا ۴۰ سند بازیابی میشود. سپس پس از حذف موارد نامعتبر یا تکراری، ۲۰ کاندید برای Reranker انتخاب میشوند و در نهایت پنج سند به مدل زبانی داده میشود.
این اعداد یک پیکربندی آموزشی هستند و مقدار استاندارد یا بهینه برای تمام پروژهها محسوب نمیشوند.
تفاوت Bi-Encoder و Cross-Encoder چیست؟
برای فهم بهتر Reranking باید تفاوت دو روش مهم پردازش سؤال و سند را بشناسیم.
Bi-Encoder
در Bi-Encoder، متن سؤال و متن سند جداگانه پردازش میشوند. هرکدام یک Embedding مستقل تولید میکنند و سپس شباهت بردارها محاسبه میشود.
مزیت اصلی این روش، سرعت جستوجو در مجموعههای بزرگ است؛ زیرا Embedding اسناد میتواند از قبل ذخیره شود.
Cross-Encoder
در Cross-Encoder، سؤال و متن سند همزمان به مدل داده میشوند. مدل ارتباط آن دو را مستقیماً بررسی میکند و یک امتیاز ارتباط تولید میکند.
این روش میتواند تفاوتهای ظریف معنایی و جزئیات متن را بهتر تحلیل کند، اما معمولاً برای هر جفت سؤال و سند نیاز به پردازش جداگانه دارد.
| ویژگی | Bi-Encoder | Cross-Encoder |
|---|---|---|
| ورودی | سؤال و سند بهصورت جداگانه | سؤال و سند با هم |
| خروجی | Embedding مستقل | امتیاز ارتباط |
| کاربرد اصلی | بازیابی اولیه | رتبهبندی مجدد |
| ایندکسگذاری قبلی اسناد | امکانپذیر | معمولاً کاربرد مستقیم ندارد |
| مناسب برای کل دیتابیس بزرگ | بله، با ایندکس مناسب | معمولاً خیر |
| هزینه هر Query | وابسته به موتور و Embedding | وابسته به تعداد جفتهای بررسیشده |
به همین دلیل، ترکیب این دو روش در بسیاری از سیستمهای RAG کاربرد دارد: ابتدا Bi-Encoder کاندیدهای محتمل را سریع پیدا میکند و سپس Cross-Encoder آنها را دقیقتر مرتب میکند.
منبع:
مستندات Cross-Encoder در Sentence Transformers.
پارامتر Retrieve-K چیست؟
Retrieve-K تعداد اسنادی است که در مرحله بازیابی اولیه دریافت میشوند.
مثلاً اگر retrieve_k=40 باشد، موتور جستوجو تا ۴۰ نتیجه اولیه را برای پردازش بعدی برمیگرداند.
افزایش Retrieve-K دو اثر مهم دارد:
- ممکن است احتمال حضور سند واقعاً مرتبط در مجموعه کاندیدها افزایش پیدا کند.
- تعداد اسناد قابل بررسی و هزینه مراحل بعدی بیشتر میشود.
اگر Retrieve-K بیش از حد کوچک باشد، ممکن است سند اصلی اصلاً به Reranker نرسد.
اگر بیش از حد بزرگ باشد، زمان دریافت داده و هزینه پردازش کاندیدها افزایش پیدا میکند، بدون اینکه لزوماً کیفیت به همان نسبت بهتر شود.
بنابراین باید Candidate Recall@K را در مقادیر مختلف اندازهگیری کرد.
پارامتر Rerank-K چیست؟
Rerank-K در این مقاله به تعداد کاندیدهایی گفته میشود که واقعاً به مدل Reranker داده میشوند.
برای مثال، میتوان ۵۰ سند دریافت کرد، ۳۰ مورد را پس از حذف تکرار و فیلتر اولیه نگه داشت و تنها ۲۰ سند اول را با Cross-Encoder رتبهبندی کرد.
در این وضعیت:
retrieve_k = 50
rerank_k   = 20
final_k    = 5
مفهوم final_k نیز تعداد Chunkهایی است که پس از رتبهبندی مجدد برای Context نهایی انتخاب میشوند.
نکته: نامگذاری پارامترها در کتابخانهها یکسان نیست. ممکن است یک سرویس، تعداد خروجی نهایی را با top_n مشخص کند و تعداد کاندیدها را از طول فهرست ورودی به دست آورد.
چه مقدار برای Retrieve-K و Rerank-K مناسب است؟
یک مقدار ثابت که برای تمام سیستمهای RAG مناسب باشد وجود ندارد. انتخاب به حجم اسناد، نوع سؤال، مدل Reranker، سرعت سختافزار و طول Chunkها بستگی دارد.
بااینحال میتوان برای Benchmark از چند پیکربندی اولیه استفاده کرد.
| سناریوی آزمایشی | Retrieve-K | Rerank-K | Final-K |
|---|---|---|---|
| سبک | ۱۰ | ۱۰ | ۳ |
| متعادل | ۳۰ | ۲۰ | ۵ |
| بازیابی گستردهتر | ۵۰ | ۳۰ | ۵ |
| آزمایش Recall بالا | ۱۰۰ | ۵۰ | ۱۰ |
این جدول صرفاً یک شبکه آزمایشی برای تنظیم پارامترها است و نشاندهنده نتیجه Benchmark واقعی نیست.
در پروژهای با تعداد سند کم، ممکن است Rerank-K برابر ۱۰ کافی باشد. در مجموعهای با سؤالهای پیچیده و اسناد زیاد، تعداد کاندیدهای بیشتری لازم باشد.
برای تصمیم دقیق باید هم کیفیت و هم P95 Latency اندازهگیری شود.
چه مدلهایی برای Reranking وجود دارند؟
مدلهای Reranker از نظر معماری، هزینه و کیفیت با یکدیگر تفاوت دارند.
۱. Cross-Encoder محلی
این مدلها روی سرور خودتان اجرا میشوند و معمولاً با کتابخانههایی مانند Sentence Transformers قابل استفاده هستند.
مزایا شامل کنترل بیشتر بر دادهها و امکان اجرای بدون ارسال محتوای اسناد به یک API خارجی است.
در مقابل، به منابع پردازشی، حافظه و مدیریت استقرار نیاز دارند.
۲. Reranking API
در این روش، سؤال و اسناد کاندید برای یک سرویس تخصصی ارسال میشوند و ترتیب جدید دریافت میشود.
راهاندازی اولیه سادهتر است، اما هزینه درخواست، تأخیر شبکه، قوانین نگهداری داده و محرمانگی اسناد باید بررسی شوند.
۳. LLM-Based Reranking
گاهی از یک مدل زبانی عمومی برای مقایسه اسناد و رتبهبندی آنها استفاده میشود.
این روش میتواند برای معیارهای پیچیده مفید باشد، اما معمولاً کنترل هزینه و زمان اجرا دشوارتر است و باید ثبات خروجی، خطاهای داوری و قالب پاسخ نیز بررسی شوند.
مقایسه گزینههای انتخاب Reranker در ۲۰۲۶
| گزینه | نوع | نکته انتخاب |
|---|---|---|
| BAAI/bge-reranker-v2-m3 | Cross-Encoder چندزبانه | گزینه مناسب برای آزمایش اولیه روی فارسی |
| مدلهای کوچک Cross-Encoder | محلی | مناسب بررسی محدودیت CPU و Latency |
| Cohere Rerank | سرویس API | نیازمند بررسی تعرفه، مدل انتخابی و سیاست داده |
| LLM Judge / Reranker | مدل زبانی | انعطاف بیشتر، اما هزینه و پیچیدگی بالاتر |
مدل BAAI/bge-reranker-v2-m3 یک گزینه چندزبانه شناختهشده است؛ بااینحال، چندزبانه بودن به معنی تضمین عملکرد مطلوب برای زبان فارسی و اصطلاحات تخصصی پروژه نیست.
مدلهای جدید سرویسهای تجاری نیز ممکن است در طول زمان تغییر کنند. قبل از استفاده باید نام مدل، وضعیت پشتیبانی، قیمت و محدودیت اسناد بررسی شود.
منابع:
مدل BGE Reranker v2 M3 و
مستندات Cohere Rerank.
آموزش عملی ساخت RAG Reranker با Python
در ادامه یک نمونه ساده Retrieve & Re-Rank میسازیم.
برای آنکه تفاوت Retriever و Reranker مشخص باشد، ابتدا با مدل Embedding اسناد اولیه را پیدا میکنیم. سپس با Cross-Encoder ارتباط آنها با سؤال را دوباره امتیازدهی میکنیم.
این مثال یک دیتاست کوچک فارسی دارد و برای یادگیری معماری طراحی شده است؛ نه برای Benchmark سرعت یا دقت مدلها در Production.
مرحله اول: ایجاد محیط Python
برای شروع، یک محیط مجازی بسازید:
mkdir -p ~/rag-reranker
cd ~/rag-reranker

python3 -m venv .venv
source .venv/bin/activate

python -m pip install --upgrade pip
python -m pip install sentence-transformers numpy
در اولین اجرا مدلهای Embedding و Reranker دانلود میشوند. بنابراین فضای دیسک، RAM و اتصال شبکه مناسب لازم است.
بهتر است پس از اجرای موفق، نسخههای کتابخانه و مدل را برای استقرار عملیاتی ثابت نگه دارید.
مرحله دوم: ساخت Retriever و Reranker
فایل rag_reranker.py را با محتوای زیر ایجاد کنید:
from time import perf_counter
import numpy as np
from sentence_transformers import (
SentenceTransformer,
CrossEncoder,
)
DOCUMENTS = [
{
"id": "doc-1",
"text": (
"خطای HTTP 429 به معنی Too Many Requests "
"است و معمولاً در اثر عبور از Rate Limit "
"رخ میدهد."
),
},
{
"id": "doc-2",
"text": (
"برای مدیریت بار زیاد API میتوان از "
"صف درخواست و محدودیت نرخ استفاده کرد."
),
},
{
"id": "doc-3",
"text": (
"گواهی SSL برای ایجاد ارتباط امن HTTPS "
"در وبسایت استفاده میشود."
),
},
{
"id": "doc-4",
"text": (
"خطای 502 زمانی رخ میدهد که Gateway "
"پاسخ مناسبی از سرویس بالادستی نگیرد."
),
},
{
"id": "doc-5",
"text": (
"برای کاهش خطای 429 باید تعداد درخواستها "
"را کنترل کرد و Retry-After و Backoff "
"را در کلاینت رعایت کرد."
),
},
{
"id": "doc-6",
"text": (
"تعداد اتصالهای همزمان دیتابیس "
"با Connection Pool مدیریت میشود."
),
},
]
EMBEDDING_MODEL = "intfloat/multilingual-e5-small"
RERANKER_MODEL = "BAAI/bge-reranker-v2-m3"
def retrieve(question, encoder, embeddings, k):
query_vector = encoder.encode(
"query: " + question,
normalize_embeddings=True,
convert_to_numpy=True,
)
similarities = embeddings @ query_vector
indices = np.argsort(-similarities)[:k]
return [
{
**DOCUMENTS[int(index)],
"retrieval_score": float(
similarities[index]
),
}
for index in indices
]
def rerank(question, candidates, model, top_k):
pairs = [
(question, document["text"])
for document in candidates
]
scores = model.predict(
pairs,
batch_size=4,
)
ranked = sorted(
[
{
**document,
"rerank_score": float(score),
}
for document, score in zip(
candidates,
scores,
)
],
key=lambda item: item["rerank_score"],
reverse=True,
)
return ranked[:top_k]
def main():
retrieve_k = 6
rerank_k = 5
final_k = 3
question = (
"چطور خطای 429 ناشی از درخواست زیاد "
"به API را برطرف کنم؟"
)
encoder = SentenceTransformer(
EMBEDDING_MODEL
)
reranker = CrossEncoder(
RERANKER_MODEL
)
passages = [
"passage: " + doc["text"]
for doc in DOCUMENTS
]
embeddings = encoder.encode(
passages,
normalize_embeddings=True,
convert_to_numpy=True,
)
retrieval_start = perf_counter()
candidates = retrieve(
question,
encoder,
embeddings,
k=retrieve_k,
)
retrieval_ms = (
perf_counter() - retrieval_start
) * 1000
rerank_start = perf_counter()
final_docs = rerank(
question,
candidates[:rerank_k],
reranker,
top_k=final_k,
)
rerank_ms = (
perf_counter() - rerank_start
) * 1000
print("Retrieval results:")
for doc in candidates:
print(
doc["id"],
round(doc["retrieval_score"], 4),
)
print("\nReranked results:")
for doc in final_docs:
print(
doc["id"],
round(doc["rerank_score"], 4),
doc["text"],
)
print(
f"\nRetrieval: {retrieval_ms:.1f} ms"
)
print(
f"Reranking: {rerank_ms:.1f} ms"
)
if __name__ == "__main__":
main()در این برنامه، مدل E5 اسناد را به بردار تبدیل میکند. Embedding سؤال نیز با پیشوند query: ساخته میشود و Embedding اسناد با پیشوند passage: تولید میشوند.
این پیشوندها بخشی از روش استفاده توصیهشده برای خانواده مدلهای E5 هستند.
از میان شش سند نمونه، شش کاندید بازیابی میشود و پنج مورد اول به Reranker داده میشوند. سپس سه نتیجه دارای بالاترین امتیاز Reranker انتخاب خواهند شد.
در مجموعه داده واقعی، Retrieve-K معمولاً بسیار کمتر از کل تعداد اسناد است و جستوجو با ایندکس مناسب انجام میشود.
مرحله سوم: اجرای نمونه
python rag_reranker.pyبرنامه دو فهرست چاپ میکند:
- فهرست اولیه بر اساس شباهت برداری.
- فهرست نهایی پس از امتیازدهی Cross-Encoder.
همچنین زمان اجرای Retrieval و Reranking بهصورت جداگانه نمایش داده میشود.
اعداد خروجی به نسخه کتابخانهها، دستگاه اجرا و مدلها وابستهاند و در این مقاله یک رتبهبندی ثابت بهعنوان نتیجه واقعی اعلام نمیشود.
نکته مهم: زمان بارگیری مدل و محاسبه Embedding اولیه اسناد در اندازهگیری بالا لحاظ نشده است. این تفکیک برای نمایش زمان Query پس از آمادهشدن مدلهاست. در Benchmark عملیاتی باید Warm-up، زمان End-to-End و تأخیر درخواستهای همزمان نیز اندازهگیری شوند.
امتیاز Reranker چه معنایی دارد؟
یکی از اشتباههای رایج این است که امتیاز خام Reranker مستقیماً بهعنوان درصد اطمینان معرفی شود.
برای مثال، اگر یک مدل Cross-Encoder امتیاز ۴٫۲ تولید کند، نمیتوان گفت سند با احتمال ۴۲۰ درصد یا حتی با اطمینان ۹۸ درصد مرتبط است.
بعضی مدلها Logit خام تولید میکنند. بعضی دیگر خروجی نرمالشده یا کالیبرهشده دارند.
بنابراین تفسیر امتیاز به مدل و تنظیمات خروجی وابسته است.
در بسیاری از سیستمها، استفاده اصلی از امتیاز Reranker مقایسه و مرتبکردن کاندیدها برای همان سؤال است.
اگر قصد تعریف آستانهای مانند «فقط اسناد با امتیاز بالاتر از مقدار مشخص انتخاب شوند» را دارید، باید آن آستانه را روی داده واقعی ارزیابی و کالیبره کنید.
Reranker چه اثری بر Latency دارد؟
اجرای Cross-Encoder میتواند زمان پاسخ RAG را افزایش دهد؛ زیرا هر سؤال باید همراه چند سند پردازش شود.
زمان کل پاسخ را میتوان بهصورت مفهومی چنین در نظر گرفت:
Total Latency =
    Query Encoding
  + Initial Retrieval
  + Reranking
  + Context Preparation
  + LLM Generation
  + Network / Queue Overhead
در نتیجه، سریعبودن Vector Search بهتنهایی به معنی سریعبودن کل سیستم نیست.
زمان Reranking معمولاً به چند عامل وابسته است:
- تعداد کاندیدهای ارسالشده به Reranker.
- طول سؤال و متن هر کاندید.
- اندازه مدل و معماری آن.
- استفاده از CPU یا GPU.
- Batch Size.
- تعداد درخواستهای همزمان.
- سرویس محلی یا API خارجی.
برای سرویسهای آنلاین بهتر است علاوه بر میانگین زمان پاسخ، P95 Latency نیز اندازهگیری شود؛ چون تأخیر درخواستهای کندتر بر تجربه کاربران تأثیر زیادی دارد.
چگونه Latency مدل Reranker را کاهش دهیم؟
۱. کاهش کاندیدهای غیرضروری
اگر Retrieve-K برابر ۵۰ است اما ۲۰ کاندید اول تقریباً تمام اسناد مرتبط را پوشش میدهند، ممکن است Rerank-K برابر ۲۰ کافی باشد.
این نتیجه باید از اندازهگیری Candidate Recall به دست آید.
۲. انتخاب مدل سبکتر
گاهی یک مدل کوچکتر با افت کیفیت ناچیز، زمان پاسخ را بهطور قابل توجهی کاهش میدهد.
مقایسه باید با سختافزار، طول ورودی و تعداد کاندید یکسان انجام شود.
۳. استفاده از Batch Processing
پردازش چند جفت سؤال و سند در یک Batch ممکن است استفاده از GPU را بهبود دهد.
اما افزایش بیش از حد Batch Size میتواند مصرف VRAM یا RAM را افزایش دهد.
۴. کوتاهکردن Chunkهای بسیار بلند
اگر یک Chunk بیش از حد طولانی باشد، پردازش آن هزینه بیشتری دارد و ممکن است توسط مدل بریده شود.
بهتر است Chunking بر اساس ساختار متن و محل پاسخ انجام شود؛ نه فقط تعداد ثابت کاراکتر.
۵. فعالسازی مشروط Reranker
ممکن است بعضی درخواستهای شناسهمحور با جستوجوی دقیق پاسخ داده شوند و نیازی به Reranking نداشته باشند.
میتوان برای چنین مواردی مسیر سادهتری تعریف کرد؛ به شرطی که Router نیز ارزیابی شود.
۶. محدودکردن زمان اجرا
برای Reranker باید Deadline مشخصی تعیین شود. اگر سرویس خارجی در زمان تعیینشده پاسخ نداد، سیستم میتواند بر اساس سیاست ازپیشتعریفشده از رتبهبندی اولیه استفاده کند یا درخواست را کنترلشده متوقف سازد.
Fallback باید در مانیتورینگ ثبت شود تا افت کیفیت پنهان نماند.
Reranker محلی بهتر است یا API خارجی؟
انتخاب بین اجرای مدل روی سرور خودتان و استفاده از API به حجم درخواست، حساسیت دادهها و توان زیرساخت بستگی دارد.
| معیار | مدل محلی | API خارجی |
|---|---|---|
| کنترل داده | بیشتر | وابسته به ارائهدهنده |
| راهاندازی | نیازمند تنظیم مدل و Runtime | معمولاً سادهتر |
| هزینه اولیه | مصرف CPU/GPU و RAM | وابسته به تعرفه |
| Latency | وابسته به سختافزار | وابسته به شبکه و سرویس |
| مقیاسپذیری | نیازمند مدیریت ظرفیت | وابسته به سهمیه API |
| بهروزرسانی | تحت کنترل تیم | وابسته به ارائهدهنده |
برای اسناد محرمانه، قبل از ارسال داده به API خارجی باید الزامات حریم خصوصی، نگهداری اطلاعات و قرارداد ارائهدهنده بررسی شود.
نمونه استفاده از Reranking API
برای مقایسه با اجرای محلی، میتوان از یک سرویس Reranking API استفاده کرد.
در API نسخه دوم Cohere، درخواست شامل سؤال، فهرست اسناد، نام مدل و تعداد نتایج نهایی است.
نمونه زیر ساختار یک درخواست را نشان میدهد:
import os
import cohere
client = cohere.ClientV2(
api_key=os.environ["COHERE_API_KEY"]
)
documents = [
"خطای 429 به محدودیت نرخ درخواست مربوط است.",
"SSL برای ارتباط امن HTTPS استفاده میشود.",
"Backoff میتواند Retryهای متوالی را کنترل کند.",
]
response = client.rerank(
model="rerank-v3.5",
query="علت خطای 429 چیست؟",
documents=documents,
top_n=2,
)
for item in response.results:
print(
item.index,
item.relevance_score,
documents[item.index],
)برای اجرای این قطعه باید کتابخانه Cohere و اعتبارنامه معتبر داشته باشید. نام مدل نیز باید در حساب و نسخه API مورد استفاده پشتیبانی شود؛ پیش از استفاده عملیاتی فهرست مدلهای جاری را بررسی کنید.
در این ساختار، top_n تعداد نتایج برگشتی را محدود میکند. این پارامتر با تعداد کاندیدهای ارسالشده به API متفاوت است.
منابع:
Cohere Rerank API و
فهرست مدلهای Cohere.
چالشهای Reranker برای متن فارسی
در فارسی، Reranker باید تفاوتهای نگارشی و معنایی را بهخوبی مدیریت کند.
برای مثال، سؤال «چطور هزینه اشتراک را کمتر کنم؟» ممکن است در سندی با عبارت «ارتقای کارایی منابع و انتخاب پلن اقتصادی» پاسخ داده شده باشد.
از طرف دیگر، بعضی عبارتهای فارسی و انگلیسی باید به شکل دقیق حفظ شوند؛ مانند نام دستورات لینوکس، نسخه نرمافزار یا کدهای خطا.
برای ارزیابی Reranker فارسی، بهتر است Golden Dataset شامل دستههای زیر باشد:
- سؤالهای فارسی محاورهای و رسمی.
- عبارتهای دارای نیمفاصله و شکلهای نوشتاری متفاوت.
- سؤالهای ترکیبی فارسی و انگلیسی.
- کدهای خطا و نام دقیق دستورات.
- پرسشهایی با نفی و تفاوت معنایی ظریف.
- پاسخهای چندمرحلهای و وابسته به شرایط.
همچنین مهم است که هم Retriever و هم Reranker روی همان زبان و دامنه کاربردی ارزیابی شوند. یک Reranker خوب نمیتواند همیشه ضعف شدید بازیابی اولیه فارسی را جبران کند.
Relevance Evaluation برای Reranker چیست؟
Relevance Evaluation یعنی بررسی اینکه نتایج رتبهبندیشده تا چه اندازه با نیاز واقعی کاربر ارتباط دارند.
برای این کار معمولاً مجموعهای از سؤالها و برچسبهای ارتباط سند ساخته میشود.
در حالت ساده، برای هر سؤال میتوان اسناد را به دو گروه مرتبط و نامرتبط تقسیم کرد.
اما برای سنجش دقیقتر، برچسبهای چندسطحی مفید هستند:
| درجه ارتباط | تفسیر |
|---|---|
| ۰ | نامرتبط |
| ۱ | تا حدی مرتبط |
| ۲ | مرتبط و مفید |
| ۳ | پاسخ مستقیم و کامل |
در این حالت میتوان با معیار nDCG بررسی کرد آیا اسناد بسیار مرتبط در رتبههای بالاتر قرار گرفتهاند یا خیر.
معیارهای مهم برای ارزیابی Reranker
| معیار | کاربرد |
|---|---|
| Candidate Recall@K | پوشش اسناد مرتبط در مرحله بازیابی اولیه |
| MRR@K | جایگاه اولین سند مرتبط |
| nDCG@K | کیفیت ترتیب اسناد با درجه ارتباط متفاوت |
| Precision@K | نسبت نتایج مرتبط در K سند اول |
| P50/P95 Latency | زمان پاسخ معمول و کند |
| Cost per Query | هزینه پردازش کاندیدها |
| Answer Correctness | درستی پاسخ مدل نهایی |
| Citation Accuracy | درستی استناد پاسخ به اسناد |
برای ارزیابی منصفانه Reranker نباید اسناد مرتبطی را که Retriever پیدا نکرده است بهصورت مصنوعی به فهرست کاندیدها اضافه کنیم.
در غیر این صورت، ممکن است نتیجه آزمون بهتر از عملکرد واقعی سیستم نمایش داده شود.
در مستندات CrossEncoderRerankingEvaluator نیز امکان ارزیابی روی کاندیدهای واقعی بدون افزودن اجباری اسناد مثبت وجود دارد.
منبع:
CrossEncoder Reranking Evaluation.
آموزش محاسبه MRR و Recall با Python
برای آنکه ارزیابی از مرحله بازیابی مستقل باشد، میتوان فهرست نتایج قبل و بعد از Reranking را ذخیره و با یک اسکریپت ساده مقایسه کرد.
فایل evaluate_reranker.py را با کد زیر ایجاد کنید:
GOLD = {
    "q1": {"doc-1", "doc-5"},
    "q2": {"doc-3"},
    "q3": {"doc-4"},
}

BEFORE = {
    "q1": ["doc-2", "doc-1", "doc-5"],
    "q2": ["doc-2", "doc-3", "doc-6"],
    "q3": ["doc-6", "doc-4", "doc-2"],
}

AFTER = {
    "q1": ["doc-1", "doc-5", "doc-2"],
    "q2": ["doc-3", "doc-2", "doc-6"],
    "q3": ["doc-4", "doc-6", "doc-2"],
}


def evaluate(rankings, k=3):
    recalls = []
    reciprocal_ranks = []

    for query_id, relevant in GOLD.items():
        ranked = rankings[query_id][:k]

        found = set(ranked) & relevant

        recalls.append(
            len(found) / len(relevant)
        )

        first_rank = next(
            (
                rank
                for rank, document_id
                in enumerate(ranked, start=1)
                if document_id in relevant
            ),
            None,
        )

        reciprocal_ranks.append(
            1 / first_rank if first_rank else 0
        )

    return {
        "recall_at_k": round(
            sum(recalls) / len(recalls), 4
        ),
        "mrr_at_k": round(
            sum(reciprocal_ranks)
            / len(reciprocal_ranks), 4
        ),
    }


print("Before:", evaluate(BEFORE))
print("After: ", evaluate(AFTER))
در این مثال ساختگی، مجموعه اسناد موجود در سه نتیجه اول هر سؤال یکسان باقی مانده است؛ فقط ترتیب آنها تغییر کرده است.
بنابراین انتظار داریم Recall@3 ثابت بماند، اما MRR@3 بهتر شود.
این نکته اهمیت زیادی دارد؛ زیرا Reranker همیشه تعداد اسناد مرتبط پیداشده را افزایش نمیدهد، اما میتواند همان اسناد را در رتبههای مناسبتری قرار دهد.
نمونه فرضی Benchmark برای Reranker
جدول زیر صرفاً یک مثال آموزشی است و اعداد آن از اجرای مدل واقعی به دست نیامدهاند.
| روش | Recall@5 فرضی | MRR@5 فرضی | P95 فرضی |
|---|---|---|---|
| Vector Search | ۰٫۸۱ | ۰٫۶۸ | ۳۵ms |
| Vector + Reranker سبک | ۰٫۸۱ | ۰٫۷۹ | ۹۵ms |
| Vector + Reranker بزرگتر | ۰٫۸۱ | ۰٫۸۴ | ۲۳۰ms |
در این مثال فرض میکنیم هر Reranker دقیقاً همان پنج کاندید را مرتب میکند و هیچ سندی از خارج این مجموعه به نتایج اضافه نمیشود. به همین دلیل Recall@5 تغییر نمیکند.
برای تحلیل نتیجه، باید بررسی کنیم آیا افزایش MRR ارزش تأخیر اضافه را دارد یا خیر.
همچنین بهتر است کیفیت پاسخ نهایی RAG را جداگانه بسنجیم؛ زیرا بهبود ترتیب اسناد الزاماً تضمین نمیکند مدل زبانی پاسخ دقیقتری تولید کند.
چگونه تأثیر Reranker بر پاسخ نهایی RAG را بسنجیم؟
برای اندازهگیری اثر واقعی Reranker، بهتر است دو نسخه از یک سیستم RAG را با شرایط یکسان مقایسه کنیم.
در نسخه اول، اسناد مستقیماً از Vector Search وارد Context میشوند. در نسخه دوم، همان کاندیدها قبل از ورود به Context رتبهبندی مجدد میشوند.
در هر دو نسخه باید مدل زبانی، Prompt، تعداد Chunkهای نهایی، تنظیمات تولید و مجموعه سؤالها تا حد امکان ثابت بمانند.
سپس معیارهای زیر بررسی شوند:
- درستی پاسخ نسبت به منبع معتبر.
- پوشش نکات ضروری پاسخ.
- درستی ارجاع به اسناد.
- میزان اطلاعات نامرتبط واردشده به Context.
- نرخ پاسخ «اطلاعات کافی نیست» در موارد مناسب.
- زمان کل پاسخ و هزینه هر درخواست.
اگر Reranker فقط nDCG را بهبود دهد اما هزینه پاسخ را بهشدت افزایش دهد و دقت نهایی تغییر نکند، ممکن است فعالکردن آن برای تمام درخواستها توجیه نداشته باشد.
چه زمانی Reranker نتیجه را بدتر میکند؟
۱. مدل با زبان اسناد سازگار نیست
ممکن است مدلی برای انگلیسی عملکرد خوبی داشته باشد اما در متن فارسی یا اصطلاحات تخصصی رتبهبندی ضعیفی تولید کند.
۲. متن Chunk بریده میشود
اگر پاسخ در انتهای یک سند طولانی باشد و ورودی مدل Truncate شود، Reranker ممکن است بخش اصلی پاسخ را نبیند.
۳. اسناد مربوط به Tenant دیگر وارد کاندیدها شدهاند
Reranking نباید جایگزین کنترل دسترسی باشد. فیلتر مجوز باید پیش از ارائه داده به مدل رتبهبندی نیز اعمال شود.
۴. نوع سؤال نیازمند جستوجوی دقیق است
برای برخی درخواستها مانند جستوجوی شناسه سفارش، SQL یا Exact Match ممکن است بهتر از Reranking معنایی باشد.
۵. مجموعه کاندیدها کیفیت کافی ندارد
اگر Retriever سند درست را پیدا نکرده، تغییر Reranker معمولاً مشکل اصلی را حل نخواهد کرد.
۶. آستانه امتیاز نادرست تنظیم شده است
امتیاز خام برخی مدلها احتمال کالیبرهشده نیست. یک آستانه نامناسب ممکن است اسناد معتبر را حذف کند.
معماری پیشنهادی Reranker برای Production
در یک سرویس واقعی، بهتر است Reranker بهعنوان بخشی مستقل از Retrieval Pipeline اجرا شود تا بتوان زمان، خطا و هزینه آن را جدا اندازهگیری کرد.
User Request
      |
      v
Authorization + Tenant Filter
      |
      v
Retriever
      |
      v
Candidate Recall Tracking
      |
      v
Deduplicate / Candidate Limit
      |
      v
Reranker Service
      |
      +-- Model Version
      +-- Batch Size
      +-- Timeout
      +-- Resource Budget
      |
      v
Final Top-K Selection
      |
      v
Context Token Budget
      |
      v
LLM Generation
      |
      v
Answer + Verified Sources
      |
      v
Audit / Evaluation / Monitoring
در این معماری باید شناسه اسناد، نسخه مدل Reranker و زمان هر مرحله ثبت شود.
همچنین بهتر است روی دادههای حساس، سیاست نگهداری Log و جلوگیری از ثبت محتوای محرمانه رعایت شود.
چکلیست راهاندازی RAG Reranker
- مشخصکردن هدف رتبهبندی و نوع سؤال کاربران.
- ساخت Golden Dataset با اسناد مرتبط.
- اندازهگیری Recall@K در Retriever اولیه.
- آزمایش چند مقدار برای Retrieve-K.
- آزمایش چند مقدار برای Rerank-K.
- انتخاب Final-K متناسب با بودجه Context.
- مقایسه حداقل دو مدل Reranker.
- ارزیابی فارسی و سؤالهای ترکیبی فارسی/انگلیسی.
- اندازهگیری MRR، nDCG و Precision.
- ثبت P50 و P95 Latency.
- اندازهگیری مصرف CPU، RAM یا GPU.
- تعیین Timeout و رفتار Fallback.
- اعمال مجوز دسترسی قبل از Reranking.
- کنترل طول Chunk و Truncation.
- بررسی Citation Accuracy در پاسخ نهایی.
- اجرای Regression Test بعد از تغییر مدل یا پارامترها.
جمعبندی؛ آیا اضافهکردن Reranker به RAG ارزش دارد؟
Vector Search برای پیدا کردن اسناد مرتبط احتمالی بسیار مفید است، اما نزدیکترین بردار همیشه بهترین پاسخ را در اختیار مدل زبانی قرار نمیدهد.
RAG Reranker با بررسی دقیقتر ارتباط سؤال و اسناد کاندید، میتواند نتایج مناسبتر را به رتبههای بالاتر منتقل کند و کیفیت Context نهایی را بهبود دهد.
بااینحال، استفاده از Reranker همیشه ضروری نیست. اگر Retriever اولیه اسناد بسیار دقیق پیدا کند یا محدودیت Latency سختگیرانه باشد، هزینه مرحله دوم ممکن است توجیه نداشته باشد.
بهترین روش این است که Retrieve-K، Rerank-K و Final-K را براساس Golden Dataset تنظیم و عملکرد مدلها را با معیارهایی مانند Recall، MRR، nDCG، دقت پاسخ و P95 Latency مقایسه کنیم.
اصل نهایی: هدف Reranker افزایش تعداد مدلهای موجود در معماری نیست؛ هدف انتخاب بهتر اسناد برای پاسخ دقیقتر با هزینه و زمان قابل قبول است.
سؤالات متداول درباره RAG Reranker
Reranker در RAG چیست؟
Reranker مرحلهای است که پس از بازیابی اولیه، ارتباط سؤال و اسناد کاندید را بررسی و آنها را دوباره مرتب میکند.
چرا فقط Vector Search برای RAG کافی نیست؟
چون شباهت برداری همیشه به معنی مناسبترین سند برای پاسخ نیست و ممکن است اسناد دارای پاسخ مستقیم در رتبههای پایینتر قرار بگیرند.
تفاوت Retrieve-K و Rerank-K چیست؟
Retrieve-K تعداد اسناد بازیابیشده در مرحله اول است و Rerank-K تعداد کاندیدهایی است که برای رتبهبندی مجدد پردازش میشوند.
آیا Reranker میتواند Recall را افزایش دهد؟
Reranker معمولاً اسناد جدیدی اضافه نمیکند. با ثابتبودن مجموعه کاندیدها، Recall کل آن مجموعه تغییر نمیکند، ولی Recall در تعداد کمترِ نتایج نهایی ممکن است بهتر شود.
برای Reranking فارسی چه مدلی مناسب است؟
مدلهای چندزبانه مانند BGE Reranker v2 M3 گزینههای قابل بررسی هستند، اما باید روی سؤالها و اسناد واقعی فارسی آزمایش شوند.
آیا استفاده از Reranker باعث کندشدن RAG میشود؟
بله، مرحله پردازش اضافی میتواند Latency را افزایش دهد. میزان افزایش به تعداد کاندیدها، طول متن، اندازه مدل و سختافزار بستگی دارد.
بهترین معیار برای ارزیابی Reranker چیست؟
معیارهایی مانند MRR و nDCG برای کیفیت رتبهبندی مهم هستند، اما باید در کنار Candidate Recall، Latency و دقت پاسخ نهایی بررسی شوند.
آیا Reranker برای هر درخواست لازم است؟
خیر. برای بعضی درخواستهای دقیق یا ساده، بازیابی مستقیم ممکن است کافی باشد و Reranking فقط هزینه و تأخیر اضافی ایجاد کند.
دیدگاهها (۰)