
 Amir Jabbari
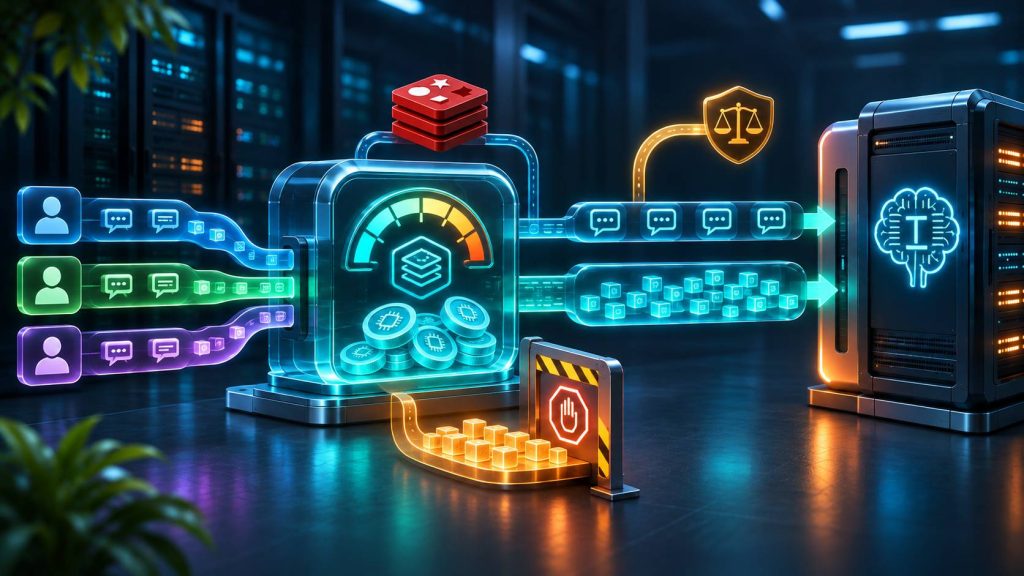
فرض کنید یک سرویس هوش مصنوعی ساختهاید که به هر کاربر اجازه میدهد روزانه ۱۰۰ درخواست ارسال کند. در نگاه اول، این محدودیت منطقی به نظر میرسد؛ اما یک مشکل مهم وجود دارد: تمام درخواستهای هوش مصنوعی به یک اندازه منابع مصرف نمیکنند.
ممکن است یک کاربر با ۱۰ درخواست کوتاه فقط ۱۰۰۰ توکن مصرف کند، درحالیکه کاربر دیگری با همان تعداد درخواست، صدها هزار توکن ورودی و خروجی تولید کند. اگر محدودیت سرویس فقط بر اساس تعداد درخواست باشد، امکان مصرف نامتعادل منابع، افزایش هزینه API و رسیدن به محدودیت ارائهدهنده وجود دارد.
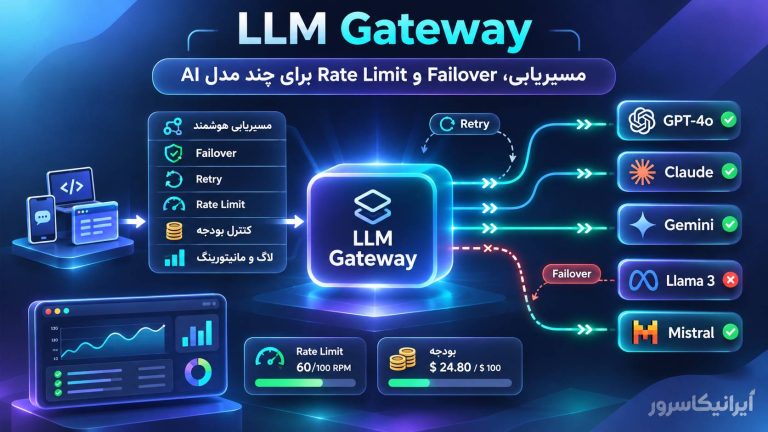
LLM Rate Limit Tokens راهکاری برای مدیریت هوشمند این وضعیت است. در این روش، علاوه بر تعداد درخواستها، میزان توکن مصرفی، ظرفیت هر مدل، بودجه کاربر، درخواستهای ناگهانی یا Burst و تعداد پردازشهای همزمان نیز کنترل میشود.
در این مقاله، مفاهیم RPM و TPM را با مثال توضیح میدهیم، الگوریتم Token Bucket را بررسی میکنیم و با Python و Redis یک محدودکننده توزیعشده میسازیم. سپس درباره کنترل بودجه کاربران، جلوگیری از سوءاستفاده، مدیریت خطای 429 و استقرار واقعی صحبت میکنیم.
Rate Limit هوشمند برای AI API چیست؟
Rate Limiting به معنی محدودکردن میزان استفاده از یک سرویس در بازه زمانی مشخص است. این محدودیت ممکن است برای هر کاربر، کلید API، سازمان، مدل یا مجموعهای از سرویسها اعمال شود.
در APIهای معمولی، اغلب تعداد درخواست در دقیقه یا ثانیه کنترل میشود. اما در سرویسهای مدل زبانی، تعداد درخواست بهتنهایی معیار کافی برای سنجش مصرف نیست.
برای مثال، دو درخواست زیر هرکدام یک واحد RPM مصرف میکنند:
- درخواست اول: ۱۰۰ توکن ورودی و ۱۵۰ توکن خروجی.
- درخواست دوم: ۲۰ هزار توکن ورودی و ۳ هزار توکن خروجی.
اگر محدودیت فقط ۶۰ درخواست در دقیقه باشد، هر دو درخواست از نظر تعداد یکسان حساب میشوند؛ درحالیکه درخواست دوم بسیار سنگینتر است.
یک Rate Limiter مناسب برای LLM باید علاوه بر تعداد درخواستها، میزان توکن، تعداد کارهای فعال، سقف هزینه و محدودیت ارائهدهنده را نیز در نظر بگیرد.
تفاوت RPM و TPM در هوش مصنوعی چیست؟
دو مفهوم اصلی در مدیریت ظرفیت مدلهای زبانی عبارتاند از:
- RPM یا Requests Per Minute: تعداد درخواست مجاز در یک دقیقه.
- TPM یا Tokens Per Minute: تعداد توکن مجاز در یک دقیقه.
توکن واحد پردازش متن در مدل زبانی است. تعداد توکن با تعداد کلمات یا کاراکترهای متن برابر نیست و به Tokenizer مدل وابسته است.
برخی ارائهدهندگان علاوه بر RPM و TPM، محدودیت روزانه درخواست، محدودیت روزانه توکن یا سهمیه جداگانه برای مدلها و گروههای مدل نیز دارند.
| معیار | چه چیزی را کنترل میکند؟ | کاربرد |
|---|---|---|
| RPM | تعداد فراخوانیها | جلوگیری از ارسال بیش از حد درخواست |
| TPM | حجم توکن در بازه زمانی | کنترل بار پردازشی مدل |
| Concurrency | درخواستهای همزمان فعال | جلوگیری از اشباع اتصالها و Workerها |
| Budget | هزینه مالی مصرفشده | کنترل هزینه هر کاربر یا پروژه |
| Burst Limit | مصرف ناگهانی ظرفیت | جلوگیری از هجوم کوتاهمدت |
مثال: چرا محدودیت ۱۰۰ درخواست کافی نیست؟
فرض کنید در یک سناریوی فرضی، حساب API دارای محدودیت ۶۰ RPM و ۱۲۰ هزار TPM باشد.
اگر ۳۰ درخواست در یک دقیقه ارسال شوند و هر درخواست بهطور متوسط ۵ هزار توکن مصرف کند، مجموع مصرف به ۱۵۰ هزار توکن میرسد.
در این وضعیت تعداد درخواستها کمتر از سقف RPM است، اما مصرف توکن از سقف TPM فراتر میرود.
بنابراین رعایت RPM الزاماً به معنی رعایت TPM نیست.
منبع:
مستندات رسمی Rate Limits در OpenAI.
چرا محدودکردن توکن مهمتر از شمارش ساده درخواست است؟
در سرویسهای LLM، هزینه و ظرفیت پردازش با حجم ورودی، خروجی و نوع مدل ارتباط مستقیم دارند. بعضی درخواستها فقط یک پاسخ کوتاه میخواهند، اما برخی دیگر اسناد طولانی، تاریخچه گفتگو و خروجی چند هزار توکنی دارند.
اگر API عمومی شما فقط تعداد درخواست را کنترل کند، ممکن است یک کاربر با درخواستهای بسیار طولانی سهم عمده ظرفیت را اشغال کند.
کنترل توکن در کنار RPM چند مزیت دارد:
- توزیع عادلانهتر ظرفیت بین کاربران.
- جلوگیری از مصرف بیش از حد یک مدل گرانقیمت.
- کاهش احتمال دریافت خطای 429 از ارائهدهنده.
- امکان تعریف پلنهای متفاوت با سهمیه مشخص.
- کنترل هزینه و جلوگیری از مصرف ناخواسته.
- افزایش قابلیت پیشبینی ظرفیت سرویس.
بااینحال، TPM بهتنهایی جایگزین محدودیت مالی نیست. دو مدل ممکن است تعداد توکن مشابهی مصرف کنند، ولی قیمت هر توکن آنها متفاوت باشد.
معماری Rate Limiter هوشمند برای LLM
در معماری پیشنهادی، درخواست ابتدا احراز هویت میشود، سپس ظرفیت مجاز کاربر، مدل و ارائهدهنده بررسی میشود. تنها درخواستهایی که تمام کنترلهای لازم را با موفقیت پشت سر بگذارند به سرویس AI ارسال میشوند.
Client / API Consumer
           |
      Authentication
           |
   Input Token Estimation
           |
     Admission Control
           |
   +-------+--------+
   |       |        |
  RPM     TPM     Budget
   |       |        |
   +-------+--------+
           |
  Distributed Redis Limiter
           |
   Concurrency Control
           |
     AI API Provider
           |
   Actual Token Usage
           |
   Usage Reconciliation
           |
Metrics / Logsمهمترین نکته این معماری این است که مصرف توکن پیش از فراخوانی مدل تخمین زده میشود؛ زیرا تعداد دقیق توکن خروجی معمولاً تا پایان تولید پاسخ مشخص نیست.
پس از تکمیل درخواست، میزان مصرف واقعی باید ثبت و اختلاف آن با مقدار رزروشده مدیریت شود.
چگونه مصرف توکن را قبل از ارسال درخواست تخمین بزنیم؟
یک درخواست Chat Completion معمولاً شامل پیامهای System، User و Assistant، تاریخچه مکالمه، خروجی ابزارها و تنظیمات مدل است.
برای محدودکردن مصرف، بهتر است تعداد توکن ورودی با Tokenizer مناسب همان مدل محاسبه شود.
سپس حداکثر توکن خروجی موردنیاز نیز به آن اضافه شود.
برای مثال:
Estimated Input Tokens:  4,000
Reserved Output Tokens:  1,000

Total Reservation:       5,000 tokens
این روش باعث میشود قبل از فراخوانی مدل، برای درخواست ظرفیت رزرو شود.
البته سیاست محاسبه TPM ارائهدهنده ممکن است با جمع ساده توکنهای ورودی و خروجی تفاوت داشته باشد. بعضی APIها برای پذیرش درخواست از برآورد توکن یا مقدار حداکثر خروجی استفاده میکنند. بنابراین باید کنترل داخلی را با روش محاسبه ارائهدهنده هماهنگ کرد.
نکته: برای متن فارسی، حدس تعداد توکن از روی تعداد کلمات یا تقسیم تعداد کاراکترها بر یک عدد ثابت، برای اعمال سقف سخت مناسب نیست. از Tokenizer یا سرویس شمارش توکن معتبر استفاده کنید.
الگوریتم Token Bucket چیست؟
Token Bucket یکی از روشهای متداول Rate Limiting است. این الگوریتم یک مخزن فرضی با ظرفیت مشخص دارد. مخزن در طول زمان با نرخ معینی پر میشود و هر درخواست بهاندازه مصرف خود از آن ظرفیت برداشت میکند.
برای مثال، یک کاربر میتواند مخزنی با ظرفیت ۱۰ هزار واحد و نرخ پرشدن ۱۰۰۰ واحد در دقیقه داشته باشد.
اگر درخواست ۳ هزار واحد ظرفیت مصرف کند، مقدار موجود کاهش پیدا میکند. پس از مدتی، بخشی از ظرفیت دوباره قابل استفاده خواهد بود.
در محدودکننده تعداد درخواست، هر درخواست ممکن است یک واحد مصرف کند؛ اما در محدودکننده توکن، هر درخواست میتواند چند صد یا چند هزار واحد مصرف کند.
این تفاوت، دلیل مناسببودن مدل Weighted Token Bucket برای AI API است.
Burst چیست و چرا باید کنترل شود؟
Burst به افزایش ناگهانی تعداد یا حجم درخواستها در یک بازه کوتاه گفته میشود.
در الگوریتم Token Bucket، ظرفیت مخزن تعیین میکند چه مقدار Burst مجاز است و نرخ پرشدن، میانگین مصرف بلندمدت را کنترل میکند.
برای مثال، اگر ظرفیت Burst برابر ۶ هزار توکن و نرخ پرشدن ۱۰۰۰ توکن در دقیقه باشد، یک درخواست ۵ هزار توکنی ممکن است با وجود کمبودن میانگین مصرف پذیرفته شود.
اما پس از آن، کاربر برای بازیابی ظرفیت باید منتظر بماند.
توجه: اگر محدودیت ارائهدهنده بر اساس پنجره زمانی سخت اعمال میشود، Token Bucket داخلی را نباید بهتنهایی معادل همان محدودیت دانست. ظرفیت Burst باید بهاندازهای تنظیم شود که محدودیتهای واقعی Upstream نیز رعایت شوند.
مقایسه الگوریتمهای Rate Limiting
| الگوریتم | ویژگی | مناسب برای |
|---|---|---|
| Fixed Window | شمارش مصرف در بازه ثابت | سهمیه ساده و محدودیت دورهای |
| Sliding Window | بررسی مصرف در بازه متحرک | کنترل دقیقتر هجوم نزدیک مرز بازه |
| Token Bucket | ظرفیت ذخیرهشده با نرخ پرشدن | Burst کنترلشده و نرخ متوسط |
| Leaky Bucket | هموارسازی سرعت خروج کار | ارسال یکنواخت درخواست |
| Weighted Token Bucket | مصرف چند واحد برای هر درخواست | محدودسازی توکنهای LLM |
برای سیستم AI، میتوان چند کنترل را ترکیب کرد؛ مثلاً یک محدودکننده RPM، یک محدودکننده توکن و یک بودجه مالی جداگانه.
چرا Rate Limiter باید Distributed باشد؟
فرض کنید برنامه شما روی سه سرور اجرا میشود و هر سرور محدودیت ۳۰ درخواست در دقیقه را داخل حافظه خودش نگه میدارد.
در این حالت یک کاربر ممکن است با تقسیم درخواستها میان سرورها، در مجموع بهجای ۳۰ درخواست، ۹۰ درخواست ارسال کند.
برای جلوگیری از این مشکل باید همه سرورها از یک وضعیت مشترک استفاده کنند. Redis یکی از گزینههای رایج برای نگهداری شمارندهها و ظرفیت مصرف است.
مزیت مهم Redis امکان اجرای اتمیک منطق بررسی و کاهش ظرفیت با Lua است. به این معنی که چند درخواست همزمان نمیتوانند در یک نمونه Redis واحد، یک ظرفیت موجود را دوبار مصرف کنند.
منبع:
راهنمای رسمی Rate Limiting با Redis.
پیشنیازهای آموزش عملی
برای اجرای نمونه آموزشی از ترکیب زیر استفاده میکنیم:
- Ubuntu Server 24.04 LTS یا سیستم لینوکسی سازگار.
- Python 3 و محیط مجازی Python.
- Redis در شبکه خصوصی یا روی همان سرور.
- کتابخانه redis-py برای ارتباط با Redis.
- دسترسی SSH و امکان اجرای دستورات ترمینال.
این نمونه برای یادگیری محدودکننده توکن است و به GPU یا کلید API واقعی نیاز ندارد. فراخوانی مدل اصلی پس از پذیرش درخواست، در لایه جداگانه برنامه انجام میشود.
مرحله اول: آمادهسازی Redis
اگر Redis روی سرور نصب نیست، میتوانید برای آزمایش محلی از Docker استفاده کنید.
docker run -d \
  --name ai-rate-redis \
  --restart unless-stopped \
  -p 127.0.0.1:6379:6379 \
  redis:7-alpine \
  redis-server \
  --appendonly yes \
  --maxmemory-policy noeviction

docker exec ai-rate-redis redis-cli ping
اگر پاسخ PONG دریافت کردید، Redis در دسترس است.
در محیط Production بهتر است نسخه Docker Image بررسی و ثابت شود، دسترسی Redis محدود باشد و Persistence و مانیتورینگ متناسب با نیاز سرویس تنظیم شوند.
پورت Redis را بدون احراز هویت و محدودیت شبکه در اینترنت عمومی باز نکنید.
مرحله دوم: ایجاد پروژه Python
یک پوشه برای پروژه ایجاد کنید:
mkdir -p ~/llm-token-limiter
cd ~/llm-token-limiter

python3 -m venv .venv
source .venv/bin/activate

pip install redis
در این مرحله فقط کتابخانه Redis نصب میشود و هنوز هیچ درخواست واقعی به مدل هوش مصنوعی ارسال نمیشود.
مرحله سوم: ساخت Weighted Token Bucket اتمیک با Redis
برای جلوگیری از Race Condition، منطق بررسی ظرفیت و کمکردن توکنها را در یک اسکریپت Lua اجرا میکنیم.
در این نمونه، دو مخزن جدا داریم: یکی برای تعداد درخواست و دیگری برای تعداد توکن. هر دو در یک عملیات بررسی و بهروزرسانی میشوند.
فایل limiter.py را با محتوای زیر ایجاد کنید:
import math
import redis

client = redis.Redis(
    host="127.0.0.1",
    port=6379,
    decode_responses=True,
    socket_timeout=2,
)

LUA = """
local now = redis.call("TIME")
local time_ms = tonumber(now[1]) * 1000
  + math.floor(tonumber(now[2]) / 1000)

local required = {
  tonumber(ARGV[1]),
  tonumber(ARGV[2])
}

local capacities = {
  tonumber(ARGV[3]),
  tonumber(ARGV[4])
}

local refill_per_ms = {
  tonumber(ARGV[5]),
  tonumber(ARGV[6])
}

local available = {}
local updated_at = {}
local wait_ms = 0

for i = 1, 2 do
  local values = redis.call(
    "HMGET", KEYS[i], "tokens", "updated_at"
  )

  local tokens = tonumber(values[1])
  local last = tonumber(values[2])

  if tokens == nil then
    tokens = capacities[i]
  end

  if last == nil then
    last = time_ms
  end

  local elapsed = math.max(0, time_ms - last)

  tokens = math.min(
    capacities[i],
    tokens + elapsed * refill_per_ms[i]
  )

  available[i] = tokens
  updated_at[i] = time_ms

  if required[i] > capacities[i] then
    return {0, -1, "request_exceeds_capacity"}
  end

  if tokens < required[i] then local missing = required[i] - tokens local wait = math.ceil( missing / refill_per_ms[i] ) wait_ms = math.max(wait_ms, wait) end end if wait_ms > 0 then
  return {0, wait_ms, "rate_limited"}
end

for i = 1, 2 do
  redis.call(
    "HSET", KEYS[i],
    "tokens", available[i] - required[i],
    "updated_at", updated_at[i]
  )

  redis.call("PEXPIRE", KEYS[i], 120000)
end

return {1, 0, "allowed"}
"""

script = client.register_script(LUA)


def reserve_tokens(user_id, estimated_tokens):
    if not user_id or not user_id.isalnum():
        raise ValueError("Invalid user identifier")

    if not isinstance(estimated_tokens, int):
        raise ValueError("Token count must be integer")

    if estimated_tokens < 1:
        raise ValueError("Invalid token count")

    # Example quotas, not provider limits.
    rpm_capacity = 10
    tpm_capacity = 12000

    # Ten requests/minute, 12000 tokens/minute.
    rpm_refill = rpm_capacity / 60000
    tpm_refill = tpm_capacity / 60000

    result = script(
        keys=[
            f"rl:{{{user_id}}}:rpm",
            f"rl:{{{user_id}}}:tpm",
        ],
        args=[
            1,
            estimated_tokens,
            rpm_capacity,
            tpm_capacity,
            rpm_refill,
            tpm_refill,
        ],
    )

    allowed = int(result[0]) == 1
    wait_ms = int(result[1])

    return {
        "allowed": allowed,
        "retry_after_ms": wait_ms,
        "reason": result[2],
    }


if __name__ == "__main__":
    for tokens in [1000, 4000, 7000, 2000]:
        print(
            tokens,
            reserve_tokens("demo1", tokens)
        )
اسکریپت در هر درخواست از ساعت Redis استفاده میکند و ظرفیت را بر اساس زمان سپریشده محاسبه میکند. سپس ابتدا هر دو محدودیت RPM و TPM را بررسی میکند و اگر هر دو ظرفیت کافی داشته باشند، سهمیه موردنیاز را کسر میکند.
در Redis Cluster، دو کلید مربوط به یک کاربر با Hash Tag یکسان ساخته شدهاند تا در یک Hash Slot قرار بگیرند و اجرای اسکریپت چندکلیدی امکانپذیر باشد.
محدودیت این نمونه: مقدار مصرف پیشبینیشده بهصورت کامل رزرو میشود و پس از پایان درخواست بهصورت خودکار با مصرف واقعی تطبیق داده نمیشود. بنابراین این کد یک Admission Limiter آموزشی با رزرو محافظهکارانه است، نه سیستم کامل حسابداری توکن.
مرحله چهارم: آزمایش محدودکننده
برای اجرای مثال، دستور زیر را وارد کنید:
python limiter.pyدرخواستهای اولیه تا زمانی پذیرفته میشوند که ظرفیت هر دو مخزن کافی باشد. با مصرف ظرفیت، نتیجه rate_limited بازگردانده میشود و مقدار retry_after_ms زمان تقریبی لازم برای بازیابی ظرفیت را نشان میدهد.
اگر اندازه یک درخواست از ظرفیت کل مخزن بزرگتر باشد، نتیجه request_exceeds_capacity دریافت میشود؛ چنین درخواستی صرفاً با صبرکردن قابل پذیرش نخواهد شد.
این محدودکننده فقط بر اساس مصرف کاربر عمل میکند. برای جلوگیری از عبور مجموع کاربران از سهمیه ارائهدهنده، باید یک محدودکننده سراسری نیز در مسیر اجرا قرار گیرد.
چگونه توکن رزروشده را با مصرف واقعی تطبیق دهیم؟
پیش از ارسال درخواست، تعداد دقیق توکنهای خروجی مشخص نیست. به همین دلیل معمولاً مقداری ظرفیت برای خروجی رزرو میشود و پس از دریافت پاسخ، میزان مصرف واقعی در سیستم حسابداری مصرف ثبت میشود.
برای مثال:
Reserved Tokens:
5000

Actual Input Tokens:
3100

Actual Output Tokens:
900

Actual Total:
4000

Difference:
1000
در این مثال، ۱۰۰۰ توکن بیشتر از مصرف واقعی رزرو شده است.
برای یک Rate Limiter داخلی میتوان اختلاف را طبق سیاست مشخص آزاد کرد؛ اما یک مسئله مهم وجود دارد: حسابداری توکن ارائهدهنده الزاماً با میزان مصرف واقعی ثبتشده در پاسخ یکسان نیست. ممکن است در زمان پذیرش درخواست، مقدار رزرو خروجی در محاسبه محدودیت ارائهدهنده اثر داشته باشد.
بنابراین پیشنهاد میشود دو دفتر محاسباتی جدا طراحی شوند:
- Capacity Reservation: کنترل ظرفیت برای پذیرش درخواست، بر اساس سیاست ارائهدهنده.
- Actual Usage Ledger: ثبت مصرف واقعی و هزینه نهایی کاربر.
در پیادهسازی عملیاتی، هر رزرو باید شناسه یکتا داشته باشد و عملیات تکمیل، لغو یا بازپرداخت آن Idempotent باشد. در غیر این صورت، اجرای دوباره Callback یا پایان همزمان دو Worker میتواند باعث آزادشدن تکراری ظرفیت شود.
تعریف محدودیت جداگانه برای هر کاربر
در یک سرویس چندکاربری، نباید تمام کاربران بدون محدودیت از سهمیه مشترک مدل استفاده کنند. برای مثال، یک محصول SaaS ممکن است سه سطح دسترسی داشته باشد:
| پلن فرضی | RPM | TPM | بودجه ماهانه نمونه |
|---|---|---|---|
| رایگان | ۵ | ۳۰۰۰ | ۱ دلار |
| استاندارد | ۲۰ | ۲۰٬۰۰۰ | ۲۰ دلار |
| تجاری | ۶۰ | ۱۰۰٬۰۰۰ | ۱۰۰ دلار |
این اعداد صرفاً مثال طراحی محصول هستند، نه محدودیت رسمی ارائهدهندگان یا پیشنهاد قیمتگذاری.
در معماری واقعی، محدودیت میتواند در چند سطح اعمال شود:
- محدودیت هر کاربر برای جلوگیری از مصرف نامتوازن.
- محدودیت هر تیم یا سازمان برای کنترل سهمیه گروهی.
- محدودیت هر مدل برای توزیع ظرفیت بین مدلهای مختلف.
- محدودیت کل ارائهدهنده برای جلوگیری از عبور از سهمیه Upstream.
- محدودیت همزمانی برای کنترل منابع سرور.
اگر کاربر چند API Key داشته باشد، محدودیت واقعی او باید بر اساس شناسه معتبر حساب اعمال شود؛ نه صرفاً کلیدی که با آن درخواست ارسال کرده است.
تفاوت محدودیت توکن با بودجه مالی چیست؟
TPM مشخص میکند چه مقدار توکن در یک بازه زمانی قابل مصرف است. اما Budget سقف هزینه مالی را تعیین میکند.
فرض کنید دو مدل با قیمت متفاوت دارید. ممکن است هر دو درخواست ۵ هزار توکن مصرف کنند، اما هزینه آنها یکسان نباشد.
برای کنترل هزینه باید تعرفه مدل، تعداد توکن ورودی و خروجی، قابلیتهای خاص و در صورت وجود هزینه ابزارها یا پردازشهای دیگر را لحاظ کنید.
بودجه میتواند روزانه، هفتگی یا ماهانه باشد. برای مثال، تعریف سقف روزانه در کنار سقف ماهانه مانع میشود یک خطا در چند ساعت کل اعتبار ماه را مصرف کند.
بهترین طراحی، ترکیب محدودیت توکن و بودجه مالی است؛ زیرا هرکدام یک مشکل متفاوت را حل میکنند.
مدیریت TPM و RPM با LiteLLM
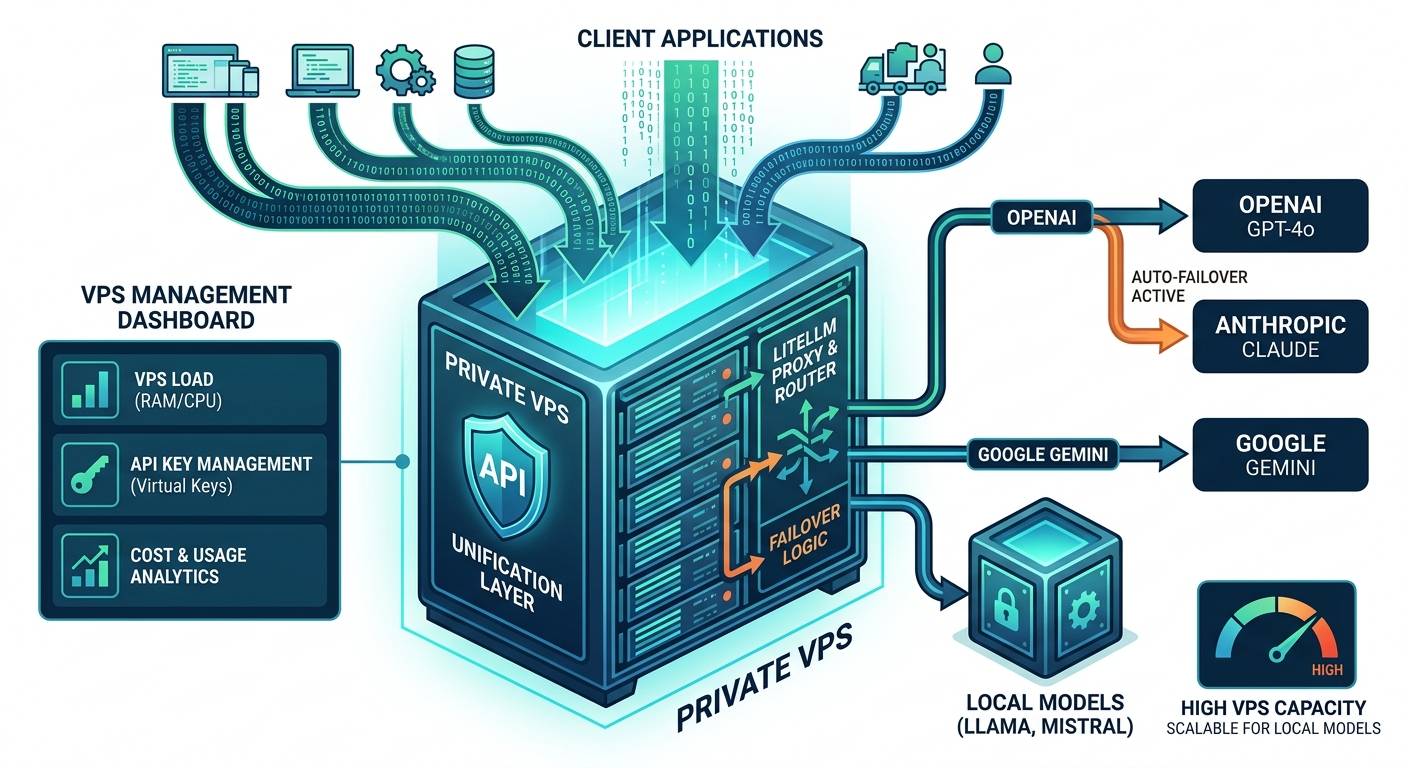
اگر از LiteLLM بهعنوان Gateway مشترک مدلهای هوش مصنوعی استفاده میکنید، لازم نیست تمام منطق Rate Limiting را از ابتدا بسازید.
LiteLLM امکان تعریف محدودیت RPM، TPM، تعداد درخواست همزمان و Budget برای کلیدهای مجازی و سطوح دیگر مانند تیمها را فراهم میکند.
برای مثال، پس از راهاندازی امن Proxy میتوان از API مدیریتی برای ایجاد یک کلید مجازی محدودشده استفاده کرد:
curl -X POST \
  http://127.0.0.1:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "rpm_limit": 20,
    "tpm_limit": 20000,
    "max_parallel_requests": 3,
    "max_budget": 10,
    "budget_duration": "30d"
  }'
در این مثال، محدودیتهای نمونهای برای یک کلید تعریف شدهاند. مقدار ۱۰ برای بودجه بر حسب دلار در سیستم هزینه LiteLLM است و فقط نمونه محسوب میشود.
نکته مهم: برای مدیریت بودجه LiteLLM به دیتابیس PostgreSQL متصل نیاز دارید. بدون دیتابیس، تنظیم مقدار Budget الزاماً سقف مصرف قابل اتکا ایجاد نمیکند.
همچنین در استقرار چندنمونهای، هماهنگی محدودیتها به تنظیمات Redis و سیاست اجرایی نسخه نصبشده وابسته است.
مستندات رسمی:
LiteLLM Budgets و Rate Limits.
Rate Limiting توزیعشده روی چند سرور
در معماری چندسروری، همه نمونههای برنامه باید از یک سیاست مشترک برای کنترل ظرفیت استفاده کنند.
اگر هر نمونه بهصورت محلی شمارنده داشته باشد، مجموع مصرف میتواند از سقف موردنظر بیشتر شود.
برای محدودیتهای سخت، باید مرحله بررسی و رزرو ظرفیت در تمام نمونهها هماهنگ باشد. اسکریپت Lua در یک Redis واحد میتواند این هماهنگی را فراهم کند.
اما اگر به چند محدودیت همزمان نیاز دارید، مانند سهمیه کاربر، تیم و مدل، طراحی پیچیدهتر میشود. بررسی جداگانه هر محدودیت ممکن است باعث رزرو ناقص ظرفیت شود.
برای یک استقرار Redis Cluster، تمام کلیدهایی که در یک اسکریپت چندکلیدی بررسی میشوند باید در یک Hash Slot مناسب قرار داشته باشند. برای سهمیههای واقعاً سراسری و چندبعدی ممکن است به طراحی جداگانه، تقسیم منابع یا سرویس متمرکز پذیرش نیاز باشد.
در سیستمهایی که محدودیت مالی یا امنیتی باید سختگیرانه باشد، هنگام قطع Redis باید تصمیم مشخصی درباره Fail Open یا Fail Closed وجود داشته باشد.
Fail Open و Fail Closed چه تفاوتی دارند؟
- Fail Open: اگر Rate Limiter در دسترس نباشد، درخواستها همچنان پذیرفته میشوند. دسترسپذیری بیشتر است، ولی خطر عبور از سهمیه وجود دارد.
- Fail Closed: اگر وضعیت ظرفیت قابل بررسی نباشد، درخواست رد یا موقتاً متوقف میشود. محدودیت سخت حفظ میشود، اما سرویس ممکن است موقتاً در دسترس نباشد.
برای APIهایی که احتمال هزینه بسیار زیاد یا سوءاستفاده دارند، معمولاً باید Fail Closed را جدیتر بررسی کرد.
LiteLLM نیز برای بعضی سناریوهای چندنمونهای گزینه fail_closed_rate_limit_enforcement ارائه میدهد. اثر دقیق آن به نسخه و تنظیمات Redis وابسته است.
جلوگیری از Abuse و سوءاستفاده از AI API
Rate Limiting فقط برای مدیریت ظرفیت نیست؛ یکی از لایههای کنترل سوءاستفاده نیز محسوب میشود.
برای مثال، یک کاربر ممکن است با ساخت چند حساب یا ارسال درخواستهای طولانی، تلاش کند از سهمیه بیشتری استفاده کند.
راهکارهای پیشنهادی عبارتاند از:
- اعمال سهمیه بر اساس شناسه معتبر کاربر و سازمان.
- محدودکردن طول Prompt و حداکثر توکن خروجی.
- تعیین سقف هزینه روزانه و ماهانه.
- محدودکردن تعداد درخواستهای همزمان.
- شناسایی افزایش غیرعادی مصرف توکن.
- اعمال محدودیت سختگیرانهتر روی حسابهای تازه.
- محافظت از API Keyها و امکان لغو سریع کلید.
- ثبت رویدادهای امنیتی بدون نگهداری غیرضروری متن محرمانه درخواست.
- اعمال محدودیت IP بهعنوان لایه کمکی، نه تنها روش شناسایی کاربر.
استفاده از Rate Limiter نباید جایگزین احراز هویت، کنترل دسترسی یا بررسی محتوای ورودی شود. این ابزار فقط بخشی از معماری امنیتی API است.
مدیریت صحیح خطای HTTP 429
وقتی ظرفیت کاربر یا مدل به پایان میرسد، سرور معمولاً میتواند پاسخ 429 Too Many Requests برگرداند.
در صورت امکان، بهتر است مقدار Retry-After نیز مشخص شود تا کلاینت بداند چه زمانی دوباره تلاش کند.
نمونه پاسخ:
HTTP/1.1 429 Too Many Requests
Content-Type: application/json
Retry-After: 15

{
  "error": "token_rate_limit_exceeded",
  "message": "Token capacity exhausted",
  "retry_after_seconds": 15
}
اگر علت خطا موقتی باشد، کلاینت میتواند پس از زمان مشخصشده مجدداً تلاش کند. اما اگر بودجه مالی کاربر به پایان رسیده یا دسترسی او غیرفعال شده باشد، تکرار درخواست بدون رفع علت مشکل را حل نمیکند.
در نبود هدر Retry-After، استفاده از Exponential Backoff همراه با Jitter و سقف تلاش محدود توصیه میشود.
ترکیب Rate Limiter با Queue درخواستهای AI
در سرویسهای پرترافیک، میتوان Rate Limiter را در کنار Queue قرار داد.
در این معماری، درخواست ابتدا بررسی میشود. اگر ظرفیت فوری موجود باشد، ممکن است مستقیماً پردازش شود. در غیر این صورت، اگر نوع کار اجازه دهد و ظرفیت صف کافی باشد، میتوان آن را برای پردازش بعدی نگه داشت.
اما انتقال درخواست به صف به معنی دورزدن Rate Limit نیست. Worker نیز باید پیش از ارسال درخواست به مدل، ظرفیت واقعی و بهروز را بررسی و رزرو کند.
برای جلوگیری از رشد بینهایت صف، سقف پذیرش، حداکثر زمان انتظار و Deadline نیز لازم است.
به این ترتیب:
- Rate Limiter مقدار مصرف مجاز را مشخص میکند.
- Queue درخواستهای قابلانتظار را زمانبندی میکند.
- Concurrency Limiter تعداد پردازشهای فعال را کنترل میکند.
- Budget Manager هزینه کاربر را مدیریت میکند.
این لایهها مکمل یکدیگرند و جایگزین هم محسوب نمیشوند.
چه معیارهایی را برای Rate Limiter مانیتور کنیم؟
برای تشخیص عملکرد واقعی سیستم بهتر است مجموعهای از شاخصهای عملیاتی جمعآوری شود.
| شاخص | کاربرد |
|---|---|
| RPM Usage | تعداد درخواست مصرفشده در بازه زمانی |
| TPM Usage | حجم توکن مصرفی و رزروشده |
| 429 Rate | نرخ رد درخواست به دلیل محدودیت |
| Budget Utilization | درصد بودجه مالی مصرفشده |
| Reservation Error | اختلاف مصرف تخمینی و واقعی |
| Limiter Latency | زمان پاسخ محدودکننده Redis |
| Concurrency | تعداد درخواستهای همزمان فعال |
| Redis Availability | وضعیت دسترسپذیری محدودکننده |
افزایش خطاهای 429 همیشه به معنی نیاز به افزایش سهمیه نیست. ممکن است کاربران بهصورت غیرعادی درخواست ارسال کنند، تخمین توکن اشتباه باشد یا سیاست Burst بیش از حد سختگیرانه تنظیم شده باشد.
برای تحلیل صحیح باید علت ردشدن درخواستها به تفکیک کاربر، تیم، مدل و نوع محدودیت ثبت شود.
چگونه Rate Limiter را Benchmark کنیم؟
برای بررسی عملکرد، بهتر است ابتدا از یک مدل شبیهسازیشده استفاده کنید تا بدون هزینه API واقعی، رفتار محدودکننده مشخص شود.
سناریوهای پیشنهادی شامل موارد زیر است:
- ارسال درخواستهای کوتاه با تعداد زیاد برای آزمایش RPM.
- ارسال درخواستهای طولانی با تعداد کم برای آزمایش TPM.
- ارسال ناگهانی درخواست برای بررسی Burst.
- اجرای چند نمونه برنامه برای آزمایش محدودیت توزیعشده.
- قطع موقت Redis برای بررسی رفتار Fail Open یا Fail Closed.
- ارسال درخواستهای همزمان از یک حساب برای بررسی Race Condition.
- مقایسه مصرف رزروشده و واقعی پس از پایان درخواستها.
برای هر سناریو باید تعداد درخواستهای مجاز و ردشده، میزان مصرف توکن، زمان پاسخ Redis و میزان عبور از ظرفیت ثبت شود.
یک بنچمارک معتبر باید نشان دهد که آیا محدودیت موردنظر واقعاً در شرایط همزمانی و بار سنگین رعایت شده است یا خیر.
اشتباههای رایج در Rate Limiting هوش مصنوعی
۱. محدودکردن فقط تعداد درخواست
درخواستهای بلند ممکن است با تعداد کم، حجم بسیار زیادی توکن مصرف کنند. برای کنترل ظرفیت LLM باید RPM و TPM را همزمان بررسی کرد.
۲. استفاده از شمارنده داخل حافظه هر سرور
در معماری چندسروری، شمارندههای مستقل میتوانند باعث عبور مجموع درخواستها از سقف اصلی شوند.
۳. استفاده از تعداد کاراکتر بهجای Tokenizer
تعداد توکن واقعی به مدل و نوع متن وابسته است. تخمین نادرست میتواند باعث رد درخواست سالم یا پذیرش درخواست بیش از ظرفیت شود.
۴. یکیدانستن TPM و Budget
TPM ظرفیت توکن در زمان مشخص را کنترل میکند، درحالیکه Budget هزینه مالی را محدود میکند.
۵. نداشتن کنترل Burst
ممکن است میانگین مصرف قابل قبول باشد ولی هجوم کوتاهمدت درخواستها سرویس را با خطا مواجه کند.
۶. Retry بدون توجه به محدودیت
تکرار سریع درخواستهای ردشده میتواند بار بیشتری ایجاد کند. باید زمان انتظار و تعداد تلاشها محدود شود.
۷. نبود کنترل مصرف واقعی پس از پاسخ
اگر تمام تصمیمها بر اساس تخمین اولیه باشد، گزارش هزینه واقعی و ظرفیت باقیمانده ممکن است دقیق نباشد.
چکلیست استقرار Rate Limiter در Production
- احراز هویت معتبر و تعیین هویت کاربر یا Tenant.
- کنترل همزمان RPM و TPM.
- تخمین توکن با Tokenizer متناسب با مدل.
- رزرو ظرفیت پیش از فراخوانی مدل.
- ثبت مصرف واقعی و مدیریت اختلاف رزرو.
- محدودیت هزینه روزانه و ماهانه.
- محدودیت همزمانی و کنترل Burst.
- Rate Limit مشترک برای تمام نمونههای برنامه.
- رفتار مشخص در زمان قطع Redis.
- حفاظت از کلیدهای API و اطلاعات حساس.
- پایش خطاهای 429 و زمان انتظار.
- تست همزمانی، بازیابی و Failover.
در سامانههایی که کنترل هزینه باید کاملاً سختگیرانه باشد، بهتر است علاوه بر Rate Limiter، دفتر مصرف تراکنشی و سیستم رزرو مالی مستقل طراحی شود. کنترل مصرف توکن بهتنهایی تضمین نمیکند که هزینه نهایی در تمام شرایط از سقف تعیینشده فراتر نرود.
جمعبندی؛ بهترین روش Rate Limit برای AI API چیست؟
برای مدیریت صحیح API هوش مصنوعی، محدودکردن تعداد درخواست کافی نیست. حجم توکن ورودی و خروجی، ظرفیت مدل، هزینه مالی، تعداد پردازشهای همزمان و الگوی مصرف کاربران نیز باید بررسی شوند.
LLM Rate Limit Tokens به شما کمک میکند ظرفیت پردازش را عادلانهتر توزیع کنید، احتمال عبور از سهمیه ارائهدهنده را کاهش دهید و مصرف کاربران را بهتر مدیریت کنید.
برای شروع میتوان از RPM و TPM همراه با Redis استفاده کرد. سپس با افزودن Budget، محدودیت Burst، کنترل Concurrency و ثبت مصرف واقعی، سیستم را برای کاربردهای تجاری توسعه داد.
هدف نهایی این نیست که صرفاً درخواستهای بیشتری رد شوند؛ هدف ایجاد سرویسی است که در زمان افزایش بار نیز قابل پیشبینی، منصفانه و از نظر هزینه قابل مدیریت باقی بماند.
سؤالات متداول درباره LLM Rate Limit Tokens
تفاوت RPM و TPM در AI API چیست؟
RPM تعداد درخواست در دقیقه را محدود میکند، اما TPM حجم توکن مصرفی در دقیقه را کنترل میکند. هر دو محدودیت میتوانند مستقل از یکدیگر اعمال شوند.
آیا محدودیت TPM بهتنهایی کافی است؟
خیر. برای کنترل کامل مصرف باید RPM، تعداد درخواست همزمان، Burst و بودجه مالی نیز در نظر گرفته شوند.
آیا Redis برای Rate Limiting چندسروری مناسب است؟
بله. Redis با وضعیت مشترک و عملیات اتمیک Lua میتواند محدودیت توزیعشده را میان چند نمونه برنامه هماهنگ کند.
Token Bucket چه تفاوتی با سهمیه ثابت دارد؟
Token Bucket ظرفیت را بهمرور زمان بازیابی میکند و امکان Burst کنترلشده را فراهم میسازد؛ درحالیکه سهمیه ثابت معمولاً بر یک بازه مشخص تکیه دارد.
چگونه برای هر کاربر بودجه هوش مصنوعی تعیین کنیم؟
باید مصرف واقعی مدلها و هزینه آنها را برای شناسه معتبر کاربر ثبت کرد و سقف مالی مستقل از محدودیت TPM تعریف کرد.
آیا LiteLLM از محدودیت TPM و RPM پشتیبانی میکند؟
بله. LiteLLM امکان تنظیم محدودیت درخواست، توکن و تعداد پردازش همزمان را برای کلیدهای مجازی و سطوح مدیریتی مختلف فراهم میکند.
دیدگاهها (۰)