
 Amir Jabbari
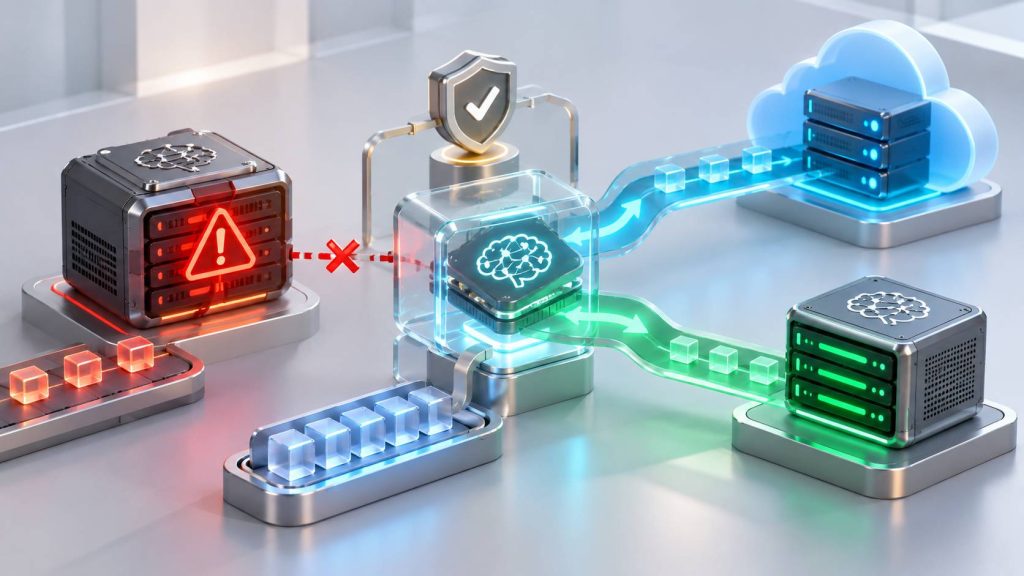
تصور کنید یک چتبات پشتیبانی یا AI Agent روی سرور راهاندازی کردهاید و همه درخواستهای کاربران به یک مدل ابری ارسال میشوند. ناگهان API اصلی با خطای 503 یا Timeout مواجه میشود؛ پاسخها متوقف میشوند، صف درخواستها بزرگ میشود و کاربران تصور میکنند کل سامانه شما از کار افتاده است. درحالیکه وبسرور و دیتابیس ممکن است کاملاً سالم باشند، وابستگی به یک ارائهدهنده مدل، نقطه شکست واحدی ایجاد کرده است.
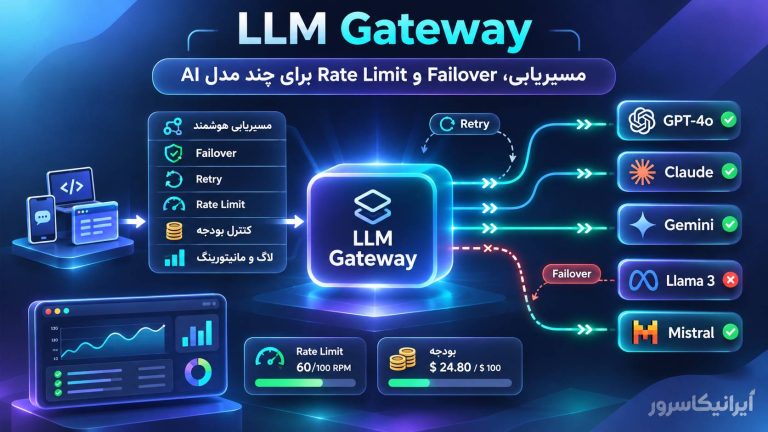
LLM Failover روشی برای تغییر مسیر درخواستهای هوش مصنوعی از مدل یا Provider اصلی به گزینه جایگزین هنگام اختلال است. این جایگزین ممکن است Provider ابری دوم، استقرار مستقل همان مدل یا یک مدل محلی با قابلیتهای محدودتر باشد. اما Failover فقط عوضکردن آدرس API نیست؛ باید سازگاری مدل، امنیت داده، حداکثر هزینه و زمان، وضعیت ابزارهای Agent و کیفیت پاسخ بررسی شود.
در این آموزش، معماری Disaster Recovery سامانه هوش مصنوعی را بررسی میکنیم و با Python یک نمونه عملی برای Provider Failover، Model Capability Mapping، Circuit Breaker و Degraded Mode میسازیم. در ادامه، راهاندازی مسیر پشتیبان با LiteLLM، مدل محلی با Ollama، سیاست صف درخواستها و سناریوهای آزمایش قطعی را توضیح میدهیم.
LLM Failover چیست و چه تفاوتی با Disaster Recovery دارد؟
Failover یعنی در صورت ازکارافتادن مسیر اصلی، درخواستهای واجد شرایط به مسیر سالم دیگری منتقل شوند. Disaster Recovery مفهوم گستردهتری دارد و علاوه بر مسیر مدل، بازیابی وضعیت مکالمه، صف Jobها، تنظیمات، ذخیرهسازی و ابزارهای خارجی را نیز دربرمیگیرد.
| مفهوم | معنی | نمونه در سامانه AI |
|---|---|---|
| LLM Failover | تغییر مسیر پردازش | انتقال از API اصلی به Provider دوم |
| High Availability | کاهش احتمال توقف سرویس | چند Worker و Gateway مستقل |
| Disaster Recovery | بازیابی پس از بحران | بازسازی صف، وضعیت کار و نشستها |
| Degraded Mode | ادامه خدمت با امکانات محدود | پاسخ FAQ بدون Tool Calling |
| Failback | بازگشت کنترلشده به مسیر اصلی | انتقال تدریجی ترافیک پس از بازیابی |
چرا API مدل اصلی از دسترس خارج میشود؟
دلایل رایج عبارتاند از خطاهای موقت 502، 503 و 504، Timeout شبکه، اشباع ظرفیت مدل، Rate Limit با کد 429، اختلال DNS، منقضیشدن اعتبارنامه، پایان بودجه، حذف نسخه مدل و خرابی GPU یا Runtime مدل محلی.
همه خطاها نباید به یک شکل مدیریت شوند. مثلاً Retry برای 503 یا Timeout موقت ممکن است منطقی باشد، اما 401 و 403 اغلب به مشکل مجوز یا اعتبارنامه مربوطاند. همچنین رد درخواست بهدلیل سیاست ایمنی نباید از طریق تغییر Provider دور زده شود. در 429، ابتدا باید مشخص شود محدودیت موقت نرخ رخ داده یا سهمیه و بودجه تمام شده است.
معماری پیشنهادی LLM Failover روی سرور
بهترین نقطه برای کنترل انتقال، یک Model Router مستقل است که همه درخواستهای AI از آن عبور میکنند. Router قبل از انتخاب مدل، قابلیتهای ضروری، محل مجاز پردازش داده، بودجه و Deadline درخواست را بررسی میکند. سپس وضعیت سلامت Providerها و Circuit Breakerها را در نظر میگیرد.
User / AI Agent
       |
       v
API Gateway + Authentication
       |
       v
Request Policy
       |
       +-- Required Capabilities
       +-- Token / Cost Budget
       +-- Allowed Region
       +-- Deadline
       |
       v
Model Router + Circuit Breakers
       |
       +-- Primary Provider
       |
       +-- Backup Provider
       |
       +-- Local Model
       |
       +-- Degraded Mode
       |
       v
Output Validation + Audit
       |
       v
User Response

Background:
Queue / Worker / Metrics / Trace
در این طراحی، سالمبودن Provider جایگزین کافی نیست؛ مدل جایگزین باید برای همان نوع وظیفه نیز مجاز و قابل اعتماد باشد. همچنین Gateway، Queue و پایگاه داده وضعیت نباید خودشان نقطه شکست واحد باشند.
Provider Failover چگونه انجام میشود؟
برای هر درخواست ابتدا یک Deadline کلی تعیین کنید. Router Provider اصلی را انتخاب میکند، در صورت خطای قابل بازیابی و باقیماندن زمان و بودجه، به Provider سازگار بعدی میرود و خروجی را اعتبارسنجی میکند. تعداد تلاشها محدود است و خطاهای دائمی باعث توقف یا ارجاع به مسیر پشتیبانی میشوند.
Retry با Failover متفاوت است: Retry همان عملیات را دوباره امتحان میکند؛ Failover مسیر اجرا را تغییر میدهد. اگر SDK، Gateway و Worker هرکدام Retry مستقل داشته باشند، تعداد واقعی تماسها ممکن است چندین برابر شود. از Backoff و Jitter استفاده کنید و مسئولیت محدودیت تلاشها را در یک لایه مشخص نگه دارید.
منبع: AWS Builders’ Library: Timeouts, retries, and backoff with jitter.
Model Capability Mapping؛ چرا هر مدل جایگزینی مناسب نیست؟
مدلها از نظر Tool Calling، JSON Schema، پشتیبانی تصویر، طول Context، Streaming، عملکرد فارسی، محل پردازش و هزینه تفاوت دارند. درخواستی که به ابزار نیاز دارد نباید به مدل فاقد Tool Calling برود؛ همینطور محتوای محرمانه نباید برای دورزدن قطعی به منطقه پردازش غیرمجاز فرستاده شود.
| قابلیت | سیاست انتخاب |
|---|---|
| Tool Calling | الزام برای Agent ابزارمحور |
| Structured Output | بررسی سازگاری JSON Schema و تست خروجی |
| Context Window | ظرفیت کافی برای ورودی و خروجی رزروشده |
| Vision / Audio | فقط Provider پشتیبان آن رسانه |
| Data Residency | حذف Provider خارج از مناطق مجاز |
| Cost / Quota | رد مسیر گرانتر از بودجه مصوب |
| Language Quality | ارزیابی مستقل روی داده و زبان پروژه |
یک Capability Map باید برای نسخه دقیق مدل و Endpoint نگهداری و با تغییر نسخه بهروزرسانی شود؛ صرف ادعای سازگاری API، کیفیت و رفتار یکسان را تضمین نمیکند.
Local Fallback با Ollama؛ وقتی اینترنت یا Providerهای ابری قطعاند
مدل محلی میتواند در شرایط بحران بعضی وظایف سبک مانند پاسخ به FAQ تأییدشده، دستهبندی درخواست یا خلاصهسازی کوتاه را انجام دهد. اما مدل کوچک محلی نباید بدون ارزیابی جایگزین مدل قوی اصلی در تصمیمهای حساس شود.
پس از نصب Ollama و دریافت مدل متناسب با منابع سرور، API محلی بهصورت معمول از مسیر زیر قابل استفاده است:
curl http://127.0.0.1:11434/api/chat \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "YOUR_INSTALLED_MODEL",
    "stream": false,
    "messages": [
      {
        "role": "user",
        "content": "Explain an API gateway."
      }
    ]
  }'
نام مدل را باید با مدل از قبل نصبشده جایگزین کرد. Endpoint محلی را بدون کنترل شبکه در اینترنت عمومی منتشر نکنید. برای Disaster Recovery واقعی، مدل باید از قبل دانلود و آماده اجرا باشد. اگر Ollama روی همان ماشین Gateway قرار داشته باشد، خرابی کل ماشین هر دو مسیر را قطع میکند.
منبع: Ollama Chat API.
Circuit Breaker؛ جلوگیری از فشار بیهوده به Provider خراب
وقتی یک Provider چند بار خطای موقت میدهد، Circuit Breaker برای مدتی مسیر آن را میبندد. الگوی استاندارد سه وضعیت دارد: Closed برای عبور عادی، Open برای قطع موقت و Half-Open برای آزمون بازیابی با تعداد محدود درخواست.
در پیادهسازی چندسروری، شمارندهها باید بهشکل هماهنگ نگهداری شوند و نباید همه Workerها همزمان درخواست آزمایشی ارسال کنند. از طرف دیگر، خطای ورودی نامعتبر یا رد ایمنی را نباید بهعنوان شکست سلامت Provider شمرد.
منبع: AWS Circuit Breaker Pattern.
آموزش عملی LLM Failover با Python
برای یادگیری منطق انتخاب Provider، یک نمونه مستقل با Python میسازیم. این مثال به API واقعی متصل نیست؛ بنابراین بدون هزینه میتوان شکست Provider، سازگاری قابلیتها و انتقال به مدل محلی را آزمایش کرد. برای اجرا Python 3.10 یا جدیدتر لازم است.
mkdir -p ~/llm-failover-lab
cd ~/llm-failover-lab
python3 --version
فایل failover_demo.py را ایجاد کنید:
import time
from dataclasses import dataclass, field


class TemporaryProviderError(Exception):
    pass


class PermanentProviderError(Exception):
    pass


@dataclass
class Request:
    prompt: str
    required: set[str] = field(
        default_factory=lambda: {"text"}
    )
    allowed_regions: set[str] = field(
        default_factory=lambda: {
            "region-a",
            "on-prem",
        }
    )
    max_context_tokens: int = 2000


@dataclass
class CircuitBreaker:
    threshold: int = 2
    cooldown_seconds: float = 30.0

    failures: int = 0
    opened_at: float | None = None

    def available(self):
        if self.opened_at is None:
            return True

        elapsed = (
            time.monotonic() - self.opened_at
        )

        return elapsed >= self.cooldown_seconds

    def success(self):
        self.failures = 0
        self.opened_at = None

    def failure(self):
        self.failures += 1

        if self.failures >= self.threshold:
            self.opened_at = time.monotonic()


@dataclass
class Provider:
    name: str
    capabilities: set[str]
    region: str
    context_limit: int
    handler: object

    breaker: CircuitBreaker = field(
        default_factory=CircuitBreaker
    )


def is_compatible(provider, request):
    return (
        request.required <= provider.capabilities
        and provider.region in request.allowed_regions
        and request.max_context_tokens
        <= provider.context_limit ) def primary_handler(prompt): raise TemporaryProviderError( "Primary service is unavailable" ) def backup_handler(prompt): return "Backup answer: " + prompt def local_handler(prompt): return "Local answer: " + prompt PROVIDERS = [ Provider( name="primary", capabilities={ "text", "tools", "json_schema", }, region="region-a", context_limit=128000, handler=primary_handler, ), Provider( name="backup", capabilities={ "text", "tools", "json_schema", }, region="region-a", context_limit=32000, handler=backup_handler, ), Provider( name="local", capabilities={"text"}, region="on-prem", context_limit=8192, handler=local_handler, ), ] def route_request( request, providers, deadline_seconds=3, ): deadline = ( time.monotonic() + deadline_seconds ) errors = [] for provider in providers: if time.monotonic() >= deadline:
            break

        if not is_compatible(provider, request):
            continue

        if not provider.breaker.available():
            continue

        try:
            answer = provider.handler(
                request.prompt
            )

            provider.breaker.success()

            return {
                "status": "ok",
                "provider": provider.name,
                "answer": answer,
            }

        except TemporaryProviderError as error:
            provider.breaker.failure()

            errors.append(
                f"{provider.name}: "
                f"{type(error).__name__}"
            )

        except PermanentProviderError:
            return {
                "status": "failed",
                "reason": "permanent_error",
            }

    return {
        "status": "degraded",
        "reason": "no_compatible_provider",
        "attempts": errors,
    }


if __name__ == "__main__":
    simple_request = Request(
        prompt="Explain server monitoring.",
        required={"text"},
    )

    result = route_request(
        simple_request,
        PROVIDERS,
    )

    print(result)

    tools_request = Request(
        prompt="Check an order using a tool.",
        required={"text", "tools"},
    )

    result = route_request(
        tools_request,
        PROVIDERS,
    )

    print(result)
در این مثال، Provider اصلی عمداً خطای موقت تولید میکند و Router به گزینه سازگار بعدی میرود.
برای درخواستی که نیازمند Tool Calling است، مدل محلی به دلیل نداشتن قابلیت tools از فهرست کاندیدهای مجاز کنار گذاشته میشود.
محدودیت نمونه: Circuit Breaker بالا یک نسخه تکپردازشی سادهشده است و وضعیت Half-Open و کنترل همزمانی کامل ندارد. همچنین Deadline فقط بین تلاشها بررسی میشود و اجرای یک درخواست شبکهای مسدودشده را قطع نمیکند. در Production باید Timeout واقعی در Client، وضعیت سلامت مشترک بین Workerها و سیاست Half-Open کنترلشده اضافه شود.
اجرای نمونه Python
python3 failover_demo.pyدر هر دو درخواست، انتظار داریم Provider اصلی شکست بخورد و Provider پشتیبان پاسخ بدهد.
اگر Provider پشتیبان را نیز عمداً دچار خطای موقت کنید، درخواست ساده میتواند به مدل محلی منتقل شود؛ اما درخواست ابزارمحور، به دلیل ناسازگاری قابلیت مدل محلی، باید بهشکل کنترلشده متوقف شود.
راهاندازی LLM Failover با LiteLLM
اگر بهجای ساخت Router اختصاصی بخواهید از یک ابزار آماده استفاده کنید، LiteLLM قابلیت Routing و Fallback را ارائه میدهد.
Router میتواند چند Deployment را در گروههای مختلف قرار دهد و هنگام شکست گروه اصلی، درخواست را به گروه جایگزین ارسال کند.
ابتدا کتابخانه را نصب کنید:
python3 -m pip install litellmنمونه ساده زیر از دو Deployment سازگار با API چت استفاده میکند:
import os

from litellm import Router


router = Router(
    model_list=[
        {
            "model_name": "primary-group",
            "litellm_params": {
                "model": "openai/YOUR_PRIMARY_MODEL",
                "api_key": os.environ[
                    "PRIMARY_API_KEY"
                ],
            },
        },
        {
            "model_name": "backup-group",
            "litellm_params": {
                "model": "openai/YOUR_BACKUP_MODEL",
                "api_key": os.environ[
                    "BACKUP_API_KEY"
                ],
                "api_base": os.environ[
                    "BACKUP_API_BASE"
                ],
            },
        },
    ],
    fallbacks=[
        {
            "primary-group": ["backup-group"]
        }
    ],
    num_retries=1,
    timeout=10,
)


response = router.completion(
    model="primary-group",
    messages=[
        {
            "role": "user",
            "content": "Explain API failover.",
        }
    ],
)

print(
    response.choices[0].message.content
)
در این نمونه، مدلها و Endpointها باید با مقادیر واقعی و معتبر جایگزین شوند. استفاده از پیشوند openai/ برای مسیر دوم فرض میکند آن سرویس از رابط سازگار پشتیبانی میکند؛ تفاوت قابلیتها و پارامترها باید جداگانه بررسی شود.
همچنین اگر از SDK با Retry داخلی استفاده میکنید، باید تنظیمات Retry تمام لایهها هماهنگ شوند تا تعداد واقعی تلاشها بیش از حد انتظار افزایش پیدا نکند.
منابع رسمی:
LiteLLM Retries, Fallbacks and Cooldowns
و
LiteLLM Routing.
کدام خطاها باید Failover را فعال کنند؟
| نوع خطا | سیاست پیشنهادی |
|---|---|
| 503 یا اختلال موقت | Failover به Provider سازگار |
| Timeout شبکه | انتقال محدود با Deadline |
| 429 موقت | بررسی Retry-After و سهمیه |
| 401 یا 403 | بررسی اعتبارنامه و دسترسی |
| 400 یا ورودی نامعتبر | اصلاح درخواست |
| Context Window Exceeded | انتخاب مدل با Context کافی |
| Safety Rejection | عدم دورزدن سیاست ایمنی |
| Budget Exceeded | توقف یا مسیر دارای بودجه مستقل مجاز |
در شرایط بحرانی، دستهبندی خطا از خود Retry مهمتر است. انتقال بیهدف خطاهای دائمی میتواند هزینه و Latency را افزایش دهد.
مدیریت Failover هنگام Streaming
در پاسخهای Streaming ممکن است بخشی از خروجی مدل اصلی قبلاً به کاربر رسیده باشد و سپس اتصال قطع شود.
در چنین شرایطی، Router نباید بدون بررسی، ادامه متن را از مدل دیگری دریافت و به خروجی قبلی متصل کند.
برای مدیریت صحیح این وضعیت:
- اگر هنوز خروجی منتشر نشده است، درخواست را میتوان با مدل سازگار دیگری دوباره اجرا کرد.
- اگر خروجی ناقص منتشر شده، وضعیت آن را مشخص کنید و در صورت نیاز پاسخ را از ابتدا بازسازی کنید.
- برای خروجیهای JSON یا عملیات حساس، نتیجه نیمهکاره را معتبر فرض نکنید.
- شناسه پاسخ و نسخه مدل تولیدکننده را ثبت کنید.
جلوگیری از اجرای دوباره Tool Call هنگام Failover
در AI Agent ممکن است مدل قبل از قطع اتصال یک عملیات دارای اثر جانبی مانند ثبت سفارش یا ارسال پیام را اجرا کرده باشد.
اگر بعد از Timeout کل Workflow روی مدل دوم تکرار شود، خطر اجرای دوباره ابزار وجود دارد.
برای جلوگیری از این مشکل بهتر است:
- هر عملیات شناسه Idempotency داشته باشد.
- وضعیت اجرای ابزار بهصورت پایدار ثبت شود.
- قبل از Retry، وضعیت واقعی عملیات قبلی بررسی شود.
- مدل دوم فقط ادامه مجاز Workflow را دریافت کند.
- عملیات مبهم و حساس به بررسی انسانی ارجاع داده شود.
نکته: وضعیت اجرای ابزارها باید مستقل از مدل و Provider نگهداری شود.
نقش Queue در Disaster Recovery هوش مصنوعی
صف درخواستها میتواند کارهای قابل تأخیر را هنگام اختلال نگهداری کند. برای مثال، خلاصهسازی دستهای اسناد ممکن است بتواند چند دقیقه منتظر بماند، اما درخواست یک چت زنده معمولاً نیازمند پاسخ سریع است.
| نوع درخواست | رفتار پیشنهادی |
|---|---|
| Interactive | Failover سریع یا پاسخ شفاف |
| Background | Queue با Deadline و Retry محدود |
| Critical Action | توقف امن و بررسی وضعیت |
برای هر Job بهتر است شناسه، قابلیتهای موردنیاز، زمان انقضا، تعداد تلاشها، Provider قبلی و وضعیت Idempotency ذخیره شود.
صف نباید بدون محدودیت رشد کند. همچنین بعد از بازگشت Provider، ارسال ناگهانی تمام Jobهای انباشتهشده میتواند اختلال جدیدی ایجاد کند.
Degraded Mode؛ ادامه خدمات با امکانات محدود
وقتی هیچ Provider جایگزینی با قابلیت کامل در دسترس نیست، میتوان سرویس را وارد حالت Degraded Mode کرد.
در این حالت بخشی از امکانات غیرفعال میشوند، اما قابلیتهای کمریسک میتوانند همچنان ارائه شوند.
برای مثال:
- پاسخگویی به سؤالات متداول تأییدشده.
- ثبت درخواست پشتیبانی برای بررسی بعدی.
- خلاصهسازی متن کوتاه با مدل محلی.
- غیرفعالسازی موقت Tool Calling حساس.
- صفبندی پردازشهای غیرفوری.
- اعلام محدودیت موقت به کاربر.
Degraded Mode باید از قبل طراحی و آزمایش شده باشد و نباید هنگام بحران اجازه عملیات حساس را به مدلی با توانایی کمتر بدهد.
RTO، RPO و استقلال Failure Domain
RTO حداکثر زمان هدف برای بازگرداندن سرویس است. RPO میزان از دسترفتن قابل قبول داده بر حسب فاصله زمانی از آخرین وضعیت بازیابی است.
در سامانه AI، RPO بیشتر به مکالمهها، صفها، نتیجه ابزارها و دادههای عملیاتی مربوط میشود، نه وزنهای مدل ابری.
داشتن دو آدرس API لزوماً استقلال ایجاد نمیکند. هر دو ممکن است به یک منطقه ابری، Gateway، DNS یا مدل مشترک متکی باشند.
حتی مدل محلی روی همان میزبان Gateway میتواند همراه آن از کار بیفتد. برای بازیابی واقعی، وابستگیهای مشترک و ظرفیت مسیر پشتیبان را از قبل بررسی کنید.
Health Check، Circuit Breaker و Failback تدریجی
سالمبودن فرایند Gateway الزاماً به معنای آمادهبودن همه قابلیتهای مدل نیست. Health Check باید متناسب با نوع درخواست، قابلیت و وضعیت Provider طراحی شود.
همچنین خطای موقت Provider نباید لزوماً باعث Restart برنامه شود.
هنگام بازگشت Provider اصلی، تمام ترافیک را ناگهان به آن برنگردانید. ابتدا یک درخواست آزمایشی کنترلشده بفرستید، سپس سهم کوچکی از ترافیک را منتقل کنید و نرخ خطا و P95 Latency را بسنجید.
در صورت ثبات، سهم ترافیک را تدریجی افزایش دهید.
منبع:
Kubernetes Liveness, Readiness and Startup Probes.
مانیتورینگ LLM Failover
| شاخص | دلیل اهمیت |
|---|---|
| Provider Availability | تشخیص نرخ موفقیت و خرابی |
| Failover Rate | درصد درخواستهای منتقلشده |
| Circuit Breaker State | وضعیت مسیرهای باز و بسته |
| P95 Latency | تأثیر مسیر جایگزین بر زمان پاسخ |
| Queue Backlog | تشخیص انباشت Jobها |
| Oldest Message Age | مدت انتظار قدیمیترین Job |
| Capability Mismatch | کمبود Provider سازگار |
| Degraded Mode Rate | سهم خدمات محدود |
| Cost per Request | کنترل هزینه زمان بحران |
| Recovery Time | اندازهگیری RTO واقعی |
موفقیت HTTP بهتنهایی کافی نیست. خروجی مدل جایگزین باید از نظر ساختار JSON، صحت ابزار و کیفیت پاسخ نیز با یک Golden Dataset ارزیابی شود.
چکلیست آزمایش Disaster Recovery
| سناریو | نتیجه مورد انتظار |
|---|---|
| Provider اصلی 503 بدهد | مسیر سازگار فعال شود |
| Provider اصلی Timeout شود | مهلت کلی رعایت شود |
| Backup فاقد Tool Calling باشد | درخواست ابزارمحور به آن نرود |
| هر دو API قطع شوند | Local Fallback مجاز یا Degraded Mode |
| مدل محلی اشباع شود | سقف ظرفیت و صف رعایت شود |
| Streaming نیمهکاره بماند | خروجی دو مدل بدون کنترل ترکیب نشود |
| Tool Call قبل از Timeout اجرا شده باشد | عملیات تکرار نشود |
| Provider اصلی بازیابی شود | Failback تدریجی انجام شود |
| Job از Deadline عبور کرده باشد | اجرا نشود و علت ثبت شود |
این سناریوها باید در محیط Staging و با داده آزمایشی اجرا شوند. تغییر نسخه SDK، Gateway یا مدل باید با تست Regression همراه باشد.
اشتباههای رایج در پیادهسازی LLM Failover
- استفاده از مدل جایگزین بدون Capability Mapping.
- فعالکردن Retry نامحدود در چند لایه.
- انتقال داده حساس به Provider خارج از منطقه مجاز.
- نداشتن Deadline سراسری درخواست.
- اجرای مجدد Tool Call بدون Idempotency.
- دانلود مدل Local Fallback فقط هنگام وقوع بحران.
- رشد بدون محدودیت Queue و نبود سیاست انقضا.
- فرض استقلال کامل دو Endpoint دارای زیرساخت مشترک.
- بازگشت فوری تمام ترافیک پس از یک Health Check موفق.
- معرفی پاسخ محدود و نامطمئن بهعنوان نتیجه قطعی.
جمعبندی؛ چگونه از توقف کامل سرویس هوش مصنوعی جلوگیری کنیم؟
یک سامانه AI پایدار نباید به در دسترسبودن یک مدل یا API وابسته باشد.
LLM Failover با انتخاب Provider جایگزین، کنترل Deadline، بودجه و Circuit Breaker میتواند اثر قطعی را کاهش دهد؛ اما فقط زمانی ایمن است که قابلیت مدل، محل پردازش داده و وضعیت ابزارهای Agent نیز بررسی شوند.
برای کارهای قابل تأخیر، Queue پایدار و برای وظایف ساده، مدل محلی میتواند به ادامه خدمات کمک کند.
اگر هیچ مسیر سازگار و مجازی وجود ندارد، Degraded Mode یا توقف شفاف بهتر از پاسخ نادرست است.
در نهایت، معماری باید با آزمایشهای قطعی واقعی و سنجش RTO، RPO، Latency و هزینه اعتبارسنجی شود.
سؤالات متداول درباره LLM Failover
LLM Failover چیست؟
انتقال کنترلشده درخواست هوش مصنوعی از Provider یا مدل اصلی به یک مسیر سازگار هنگام اختلال است.
آیا دو API Key برای جلوگیری از قطعی کافی است؟
خیر. باید سلامت سرویس، قابلیت مدلها، محدودیت هزینه، Deadline، سیاست داده و وضعیت ابزارها نیز کنترل شوند.
تفاوت Retry و Failover چیست؟
Retry تلاش دوباره پس از خطاست؛ Failover مسیر پردازش را به ارائهدهنده یا استقرار دیگری منتقل میکند.
آیا Ollama میتواند Fallback باشد؟
بله؛ اگر مدل محلی از قبل آماده باشد و برای وظیفه و سطح حساسیت درخواست کیفیت و قابلیت لازم را داشته باشد.
Circuit Breaker چه کمکی میکند؟
بعد از شکستهای مکرر، مسیر Provider معیوب را موقتاً میبندد و فقط آزمایش بازیابی محدود انجام میدهد.
Degraded Mode چه زمانی مناسب است؟
وقتی مدل سازگار در دسترس نیست ولی بخشی از خدمات تأییدشده مانند FAQ یا ثبت درخواست میتواند ادامه یابد.
آیا Failover میتواند Tool Call را دوباره اجرا کند؟
بله؛ بدون ثبت وضعیت و Idempotency ممکن است عملیات دارای اثر جانبی تکرار شوند.
چه زمانی درخواست را در Queue نگه داریم؟
برای کارهای قابل تأخیر با Deadline مشخص؛ درخواستهای تماس یا گفتوگوی زنده معمولاً به پاسخ سریع یا خطای شفاف نیاز دارند.
چگونه Failover را تست کنیم؟
با شبیهسازی 503، Timeout، ناسازگاری مدل، قطعی تمام Providerها، ازدحام صف، Streaming ناقص و Failback در محیط Staging.
دیدگاهها (۰)