
 Amir Jabbari
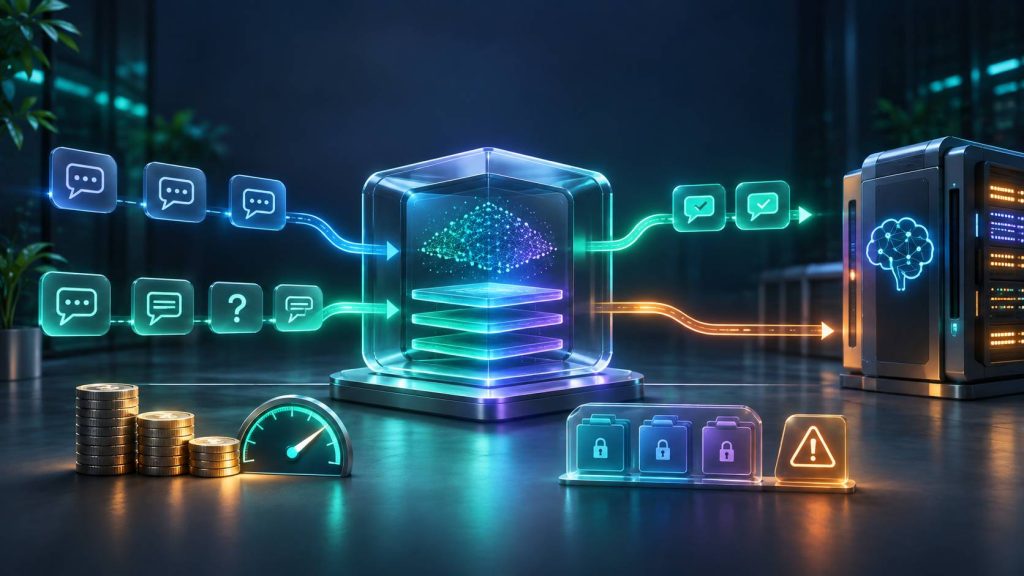
فرض کنید یک چتبات پشتیبانی روزانه به هزاران سؤال درباره خدمات شما پاسخ میدهد. یک کاربر میپرسد «چطور رمز عبورم را عوض کنم؟» و کاربر دیگری مینویسد «روش تغییر پسورد حساب چیست؟». هر دو در واقع یک پاسخ میخواهند، اما اگر برنامه برای هر سؤال دوباره API مدل زبانی را فراخوانی کند، هزینه و زمان پردازش تکرار میشود.
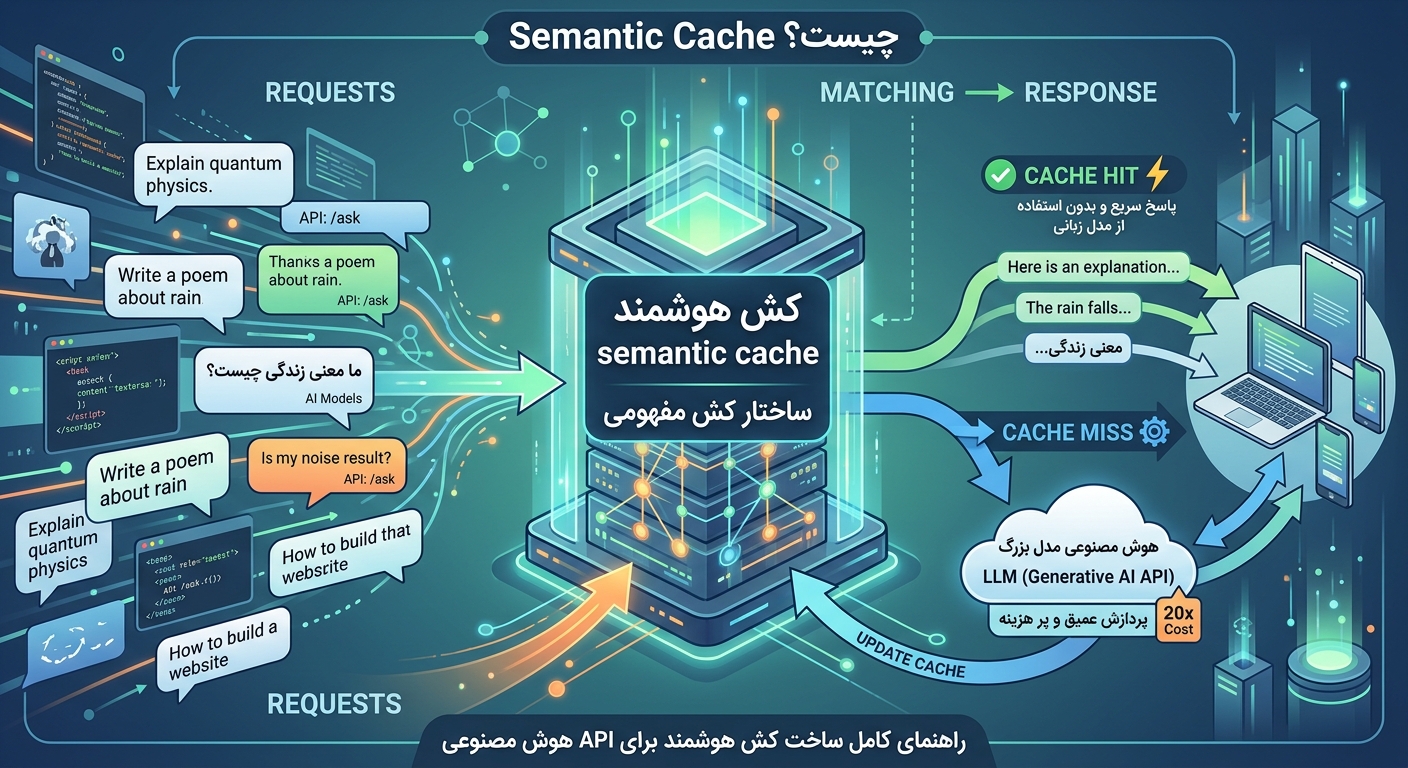
LLM Semantic Cache یا کش معنایی پاسخ مدل زبانی، راهکاری است که پاسخ درخواستهای مشابه را ذخیره میکند تا در شرایط مناسب بدون فراخوانی دوباره مدل، پاسخ قبلی بازگردانده شود. این روش میتواند هزینه مصرف توکن و زمان پاسخ را کاهش دهد؛ اما همیشه اقتصادی یا حتی مناسب نیست.
اگر درخواستها تنوع زیادی داشته باشند، هزینه ساخت Embedding از سود ذخیرهسازی بیشتر شود یا کش پاسخ اشتباهی به یک سؤال متفاوت برگرداند، نتیجه ممکن است برخلاف انتظار باشد. همچنین استفاده نادرست از کش مشترک میتواند به افشای اطلاعات کاربران منجر شود.
در این راهنما، Exact Cache و Semantic Cache را مقایسه میکنیم، روش انتخاب Similarity Threshold، قوانین Invalidation، امنیت داده و محاسبه هزینه واقعی را توضیح میدهیم و در پایان یک روش بنچمارک برای سنجش Hit Rate، خطا و صرفهجویی ارائه میکنیم.
LLM Semantic Cache چیست و چگونه کار میکند؟
کش یا Cache به معنی نگهداری موقت دادهای است که احتمال دارد دوباره موردنیاز قرار بگیرد. در برنامههای معمولی، این داده ممکن است نتیجه یک کوئری دیتابیس باشد؛ اما در هوش مصنوعی میتوان پاسخ تولیدشده توسط مدل زبانی را ذخیره کرد.
تفاوت کش معنایی با کش معمولی در نحوه پیدا کردن پاسخ است. کش معمولی اغلب به دنبال کلید دقیقاً برابر میگردد، ولی Semantic Cache از نمایش برداری معنی جمله، یعنی Embedding، برای پیدا کردن پرسشهای نزدیک به هم استفاده میکند.
برای مثال، دو عبارت زیر از نظر نوشتاری متفاوتاند:
- «چگونه دامنه خود را به هاست متصل کنم؟»
- «برای وصل کردن دامنه به فضای میزبانی چه کاری باید انجام دهم؟»
اگر هر دو درخواست درباره یک سرویس و شرایط یکسان باشند، احتمال دارد پاسخ کششده برای هر دو مناسب باشد. البته این شباهت باید با معیارهای فنی و قواعد اعتبارسنجی بررسی شود؛ نزدیک بودن بردارها بهتنهایی معادل یکسان بودن پاسخ درست نیست.
تفاوت Exact Cache و Semantic Cache چیست؟
در Exact Match Cache، برنامه از ورودی یا مجموعه پارامترهای درخواست یک کلید میسازد. اگر همان کلید قبلاً ثبت شده باشد، پاسخ ذخیرهشده بازگردانده میشود.
در Semantic Cache ابتدا متن درخواست به یک بردار عددی تبدیل میشود. سپس نزدیکترین بردار ذخیرهشده در پایگاه داده برداری یا سیستم کش جستوجو میشود. اگر میزان شباهت از حد تعیینشده بیشتر باشد و سایر شرایط هم برقرار باشند، پاسخ قبلی استفاده میشود.
| ویژگی | Exact Cache | Semantic Cache |
|---|---|---|
| روش تطبیق | برابری کلید درخواست | شباهت معنایی بردارها |
| سؤال با عبارت متفاوت | معمولاً Cache Miss | امکان Cache Hit |
| هزینه Embedding | معمولاً ندارد | دارد |
| خطر پاسخ به سؤال غیرمعادل | کمتر؛ در صورت طراحی صحیح کلید | بیشتر |
| تنظیمات اصلی | Cache Key، TTL و Invalidation | Embedding، Threshold، TTL و فیلترها |
| مناسب برای | درخواستهای کاملاً تکراری | سؤالات مشابه با نگارش متفاوت |
برای بسیاری از محصولات، بهترین راهحل انتخاب انحصاری یکی از این دو روش نیست. میتوان ابتدا Exact Cache را بررسی کرد و فقط در صورت پیدا نشدن نتیجه، سراغ Semantic Cache رفت.
با این معماری، درخواستهای دقیقاً تکراری هزینه جستوجوی برداری یا Embedding مجدد را تحمیل نمیکنند.
معماری کش پاسخ مدل زبانی
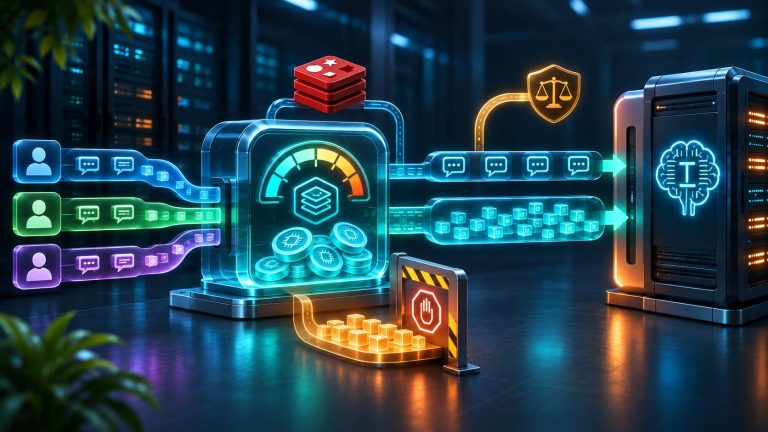
یک معماری ساده میتواند شامل API برنامه، کش دقیق، سرویس Embedding، پایگاه داده برداری و مدل زبانی باشد.
User Request
      |
 Authentication + Data Policy
      |
 Exact Cache Lookup
      |
   +-- HIT -------------> Cached Response
   |
   +-- MISS
        |
     Embedding
        |
   Semantic Lookup
        |
   +-- Valid HIT -------> Cached Response
   |
   +-- MISS
        |
     LLM API
        |
   Validate Response
        |
   Store Cache Entry
        |
     Response
در این طراحی، شرط Valid HIT بسیار مهم است. نزدیکترین بردار همیشه پاسخ مناسب نیست. برای استفاده از پاسخ ذخیرهشده باید هم امتیاز شباهت قابل قبول باشد و هم محدوده کاربر، نسخه اطلاعات، مجوز دسترسی و نوع درخواست یکسان یا سازگار باشند.
نکته دیگر این است که کش پاسخ با کش Prompt ارائهدهنده مدل تفاوت دارد. در Prompt Caching معمولاً پیشوندهای مشترک درخواست برای کاهش هزینه پردازش مجدد استفاده میشوند، ولی مدل همچنان فراخوانی میشود. در Response Cache معتبر، میتوان فراخوانی مدل را بهطور کامل حذف کرد.
Semantic Cache چه زمانی واقعاً هزینه را کم میکند؟
صرفهجویی واقعی زمانی اتفاق میافتد که هزینه درخواستهایی که از مدل اصلی حذف میشوند، از هزینه ساخت و نگهداری کش بیشتر باشد.
برای تصمیمگیری باید چند عامل را همزمان بررسی کنیم:
۱. تعداد درخواستهای مشابه زیاد باشد
اگر کاربران بارها درباره قوانین تمدید سرویس، راهنمای اتصال دامنه یا خطاهای متداول سؤال کنند، احتمال استفاده مجدد از پاسخها بالاست. اما در یک ابزار تولید متن خلاقانه که هر درخواست کاملاً متفاوت است، Hit Rate ممکن است بسیار پایین بماند.
۲. پاسخ قبلی برای درخواست جدید معتبر باشد
شباهت متن به معنی یکسان بودن پاسخ درست نیست. برای مثال، دو سؤال «چطور سرویس A را تمدید کنم؟» و «چطور سرویس B را تمدید کنم؟» ممکن است از نظر برداری نزدیک باشند، اما قوانین تمدید آنها متفاوت باشد.
اگر Semantic Cache این دو سؤال را یکسان فرض کند، هزینه API کم میشود ولی کیفیت و صحت پاسخ آسیب میبیند.
۳. هزینه پردازش مدل از هزینه Cache Lookup بیشتر باشد
برای یک مدل گرانقیمت با پاسخ بلند، حذف حتی بخشی از فراخوانیها میتواند ارزشمند باشد. در مقابل، اگر مدل بسیار ارزان باشد و ساخت Embedding نیازمند یک API جداگانه باشد، سود ممکن است کم شود.
۴. دادهها سریع تغییر نکنند
سؤالاتی مانند «HTTP چیست؟» یا «چگونه به SSH متصل شویم؟» ممکن است پاسخهایی با اعتبار نسبتاً طولانی داشته باشند. اما سؤال «قیمت سرویس امروز چقدر است؟» به داده زنده وابسته است و کش طولانیمدت آن میتواند مشکل ایجاد کند.
۵. کش باعث افت کیفیت غیرقابل قبول نشود
یک سیستم که ۷۰ درصد درخواستها را از کش پاسخ میدهد اما در ۵ درصد این موارد پاسخ نادرست ارائه میکند، لزوماً بهتر از سیستمی با Hit Rate پایینتر و دقت بیشتر نیست.
بنابراین معیار اصلی موفقیت، صرفهجویی خالص همراه با حفظ کیفیت پاسخ است؛ نه صرفاً بالا بردن Hit Rate.
فرمول محاسبه صرفهجویی واقعی Semantic Cache
برای تحلیل اقتصادی میتوانیم هزینه هر درخواست بدون کش را با هزینه متوسط همان درخواست پس از فعالشدن کش مقایسه کنیم.
تعاریف زیر را در نظر بگیرید:
- C: هزینه متوسط فراخوانی مدل اصلی.
- H: نسبت درخواستهایی که پاسخ معتبر را از کش دریافت میکنند.
- L: هزینه متوسط جستوجو و پردازش کش برای هر درخواست.
- S: سهم هزینه ثابت نگهداری زیرساخت کش به ازای هر درخواست.
اگر هزینه درخواست اصلی در Cache Miss همان C باشد، رابطه ساده زیر برقرار است:
هزینه متوسط با کش = L + S + (1 – H) × C
و در نتیجه:
صرفهجویی خالص هر درخواست = H × C – L – S
این فرمول یک مدل سادهشده است. اگر درخواستهای تکراری هزینه متفاوتی داشته باشند، نرخ Cache Hit با توزیع هزینه همبسته باشد یا خطاهای کش باعث پردازش مجدد شوند، باید هزینه هر درخواست بهصورت جداگانه محاسبه شود.
مثال عددی: آیا Hit Rate برابر ۴۰ درصد سودآور است؟
فرض کنید در یک سناریوی فرضی، هزینه متوسط هر فراخوانی مدل ۰٫۰۱ دلار، هزینه جستوجو و Embedding برای هر درخواست ۰٫۰۰۰۵ دلار و سهم زیرساخت کش ۰٫۰۰۰۲ دلار باشد.
اگر ۴۰ درصد درخواستها پاسخ معتبر از کش دریافت کنند:
C = $0.0100
H = 0.40
L = $0.0005
S = $0.0002

Cost without cache:
$0.0100

Cost with cache:
0.0005 + 0.0002 + (1 - 0.40) * 0.0100
= $0.0067

Net saving per request:
$0.0033

Net saving:
33%
در این مثال، صرفهجویی خالص ۳۳ درصد است، نه ۴۰ درصد. علت این تفاوت، هزینه عملیاتی خود کش است.
این اعداد قیمت واقعی API یا نتیجه آزمایش نیستند؛ فقط برای توضیح روش محاسبه انتخاب شدهاند.
حداقل Hit Rate لازم برای اقتصادی بودن کش چقدر است؟
با استفاده از رابطه قبلی میتوان حداقل نرخ پاسخ معتبر از کش را محاسبه کرد:
Break-even Hit Rate = (L + S) ÷ C
در مثال بالا:
Break-even =
($0.0005 + $0.0002) / $0.0100

= 0.07
= 7%
بنابراین در این مدل ساده، نرخ Cache Hit معتبر باید بیشتر از ۷ درصد باشد تا هزینه مستقیم کاهش پیدا کند.
البته این عدد شامل زیان ناشی از پاسخ اشتباه، هزینه رفع مشکلات کاربران، مدیریت تغییرات داده و هزینه اولیه توسعه نیست. برای محیط واقعی باید این موارد نیز در مدل اقتصادی لحاظ شوند.
Similarity Threshold چیست و چگونه انتخاب میشود؟
Similarity Threshold آستانهای است که مشخص میکند دو درخواست از نظر معنایی به اندازه کافی مشابه هستند یا نه.
مدلهای Embedding متن را به بردارهای عددی تبدیل میکنند. سپس با معیارهایی مانند Cosine Similarity میزان نزدیکی این بردارها محاسبه میشود.
در سیستمی که از امتیاز شباهت استفاده میکند، معمولاً مقدار بالاتر به معنی شباهت بیشتر است. اما بعضی کتابخانهها بهجای Similarity از Distance استفاده میکنند؛ در این حالت مقدار کمتر میتواند به معنی شباهت بیشتر باشد.
به همین دلیل، مقدار Threshold را نباید بدون بررسی مستندات بین ابزارهای مختلف کپی کرد.
| Threshold نمونه | رفتار احتمالی | ریسک |
|---|---|---|
| 0.80 | پذیرش موارد مشابه بیشتر | احتمال تطبیق اشتباه بالاتر |
| 0.85 | تعادل نسبی برای برخی مجموعهدادهها | نیازمند ارزیابی واقعی |
| 0.90 | تطبیق سختگیرانهتر | کاهش Hit Rate احتمالی |
| 0.95 | تطبیق بسیار سختگیرانه | از دست رفتن بسیاری از بازنویسیهای معتبر |
مقادیر جدول فقط نمونههایی برای شروع آزمایش هستند و نباید بهعنوان مقدار بهینه عمومی در نظر گرفته شوند. مدل Embedding، زبان فارسی، نوع پرسش و حوزه کاربرد همگی روی نتیجه اثر میگذارند.
در مستندات Redis LangCache نیز تأکید شده که انتخاب آستانه، موازنهای بین افزایش Hit Rate و خطر بازگرداندن پاسخ نامناسب است.
چگونه Threshold مناسب را با داده واقعی پیدا کنیم؟
بهجای انتخاب یک مقدار دلخواه، باید مجموعهای از پرسشهای واقعی بسازید که مشخص باشد کدام درخواستها میتوانند از یک پاسخ مشترک استفاده کنند.
برای نمونه، سه گروه داده تهیه کنید:
- Equivalent: سؤالهایی با نگارش متفاوت که پاسخ یکسان و معتبر دارند.
- Related but Different: سؤالهایی که درباره یک موضوعاند، اما پاسخ متفاوت میخواهند.
- Unrelated: سؤالهایی که ارتباط معنایی کافی ندارند.
سپس برای Thresholdهای مختلف، نسبت تطبیقهای صحیح و اشتباه را محاسبه کنید.
معیارهای مفید عبارتاند از:
- Precision: چه نسبتی از Cache Hitهای پذیرفتهشده واقعاً پاسخ معتبر داشتهاند؟
- False Positive Rate: چه نسبتی از درخواستهایی که نباید تطبیق میشدند، اشتباهاً Hit شدهاند؟
- Valid Hit Rate: چه سهمی از کل درخواستها پاسخ صحیح را از کش دریافت کردهاند؟
- Net Cost Saving: هزینه واقعی حذفشده پس از کسر هزینه کش چقدر است؟
در محصولات حساس، افزایش Precision و کنترل False Positive معمولاً مهمتر از افزایش حداکثری Hit Rate است.
Cache Invalidation چیست و چرا اهمیت دارد؟
Invalidation یعنی بیاعتبار کردن پاسخ ذخیرهشده زمانی که دیگر نباید مورد استفاده قرار بگیرد.
فرض کنید در چتبات فروش، پاسخ سؤال «قیمت تمدید سرویس چقدر است؟» کش شده باشد. اگر تعرفه سرویس تغییر کند ولی پاسخ کش همچنان استفاده شود، مشتری قیمت قدیمی دریافت میکند.
برای جلوگیری از این مسئله چند روش رایج وجود دارد:
TTL یا زمان انقضای کش
TTL مشخص میکند هر پاسخ چه مدت معتبر باقی بماند. برای اطلاعات نسبتاً ثابت میتوان زمان بیشتری در نظر گرفت، اما برای اطلاعات متغیر بهتر است از TTL کوتاهتر یا عدم کش استفاده شود.
Version-Based Invalidation
در این روش، هر پاسخ با نسخه اطلاعات، مدل یا Prompt مرتبط میشود. با تغییر نسخه، پاسخ قبلی دیگر در محدوده جستوجوی معتبر قرار نمیگیرد.
برای مثال، یک پاسخ میتواند این Metadata را داشته باشد:
{
  "tenant_id": "company-12",
  "locale": "fa-IR",
  "knowledge_version": "2026-11",
  "prompt_version": "v3",
  "model_family": "support-model",
  "ttl_seconds": 3600
}
این اطلاعات باید در مرحله جستوجو و اعتبارسنجی استفاده شوند، نه اینکه صرفاً کنار پاسخ ذخیره شوند.
Event-Based Invalidation
در این روش، رویدادهای واقعی باعث حذف یا بیاعتبارشدن کش میشوند؛ مثلاً تغییر قیمت محصول، اصلاح سیاست بازگشت وجه یا انتشار نسخه جدید مستندات.
عدم کش برای دادههای کاملاً پویا
برخی درخواستها اصولاً برای Response Cache مناسب نیستند؛ مانند موجودی لحظهای، اطلاعات زنده سفارش یا دادههایی که فقط با مجوز کاربر فعلی قابل مشاهدهاند.
در این موارد میتوان بخشهای پایدار پاسخ یا نتیجه ابزارهای مشخص را جداگانه کش کرد، اما نباید کل خروجی شخصیسازیشده را بدون کنترل مجوز دوباره استفاده کرد.
حریم خصوصی و جلوگیری از نشت اطلاعات در Semantic Cache
یکی از مهمترین ریسکها، بازگرداندن پاسخ یک مشتری به مشتری دیگر است. این اتفاق ممکن است زمانی رخ دهد که یک کش مشترک فقط بر اساس شباهت متن جستوجو شود.
برای مثال، دو کاربر میپرسند «وضعیت فاکتور من چیست؟». متن سؤالها تقریباً یکسان است، اما پاسخ باید از داده حساب همان کاربر تولید شود.
اگر Cache Scope بهدرستی تعریف نشده باشد، امکان بازگشت پاسخ مربوط به حساب دیگر وجود دارد.
برای جلوگیری از این خطر:
- محدوده Tenant یا سازمان را در خود کوئری کش اعمال کنید.
- در پاسخهای وابسته به کاربر، شناسه و مجوز دسترسی را بررسی کنید.
- پاسخهای دارای اطلاعات شخصی را بهصورت عمومی بین کاربران به اشتراک نگذارید.
- محتوای Embedding و لاگها را نیز داده بالقوه حساس در نظر بگیرید.
- کلیدها، رمزها و توکنهای احراز هویت را در پاسخ یا Metadata کش ذخیره نکنید.
- برای دادههای محرمانه، خطمشی نگهداری، حذف و رمزنگاری مستقل تعریف کنید.
- پس از تغییر مجوز کاربر، کش وابسته به مجوز قبلی را نامعتبر کنید.
برای برنامههایی با اطلاعات حساب کاربری، همیشه باید بررسی شود که کش علاوه بر شباهت معنایی، محدوده مجاز داده را نیز رعایت میکند.
چرا Semantic Cache برای گفتوگوهای چندمرحلهای خطرناک است؟
در گفتوگوهای چندمرحلهای، پاسخ درست فقط به آخرین پیام وابسته نیست. تاریخچه مکالمه، خروجی ابزارها، وضعیت کار و دستورات قبلی نیز اهمیت دارند.
اگر فقط متن آخرین درخواست کش شود، عبارت «همان مورد قبلی را اصلاح کن» ممکن است با درخواست مشابه کاربر دیگری تطبیق داده شود؛ درحالیکه زمینه گفتگو کاملاً متفاوت است.
حتی Embedding کل تاریخچه هم همیشه مشکل را حل نمیکند. در بعضی Agentها، افزودن یک پیام کوتاه به تاریخچه طولانی باعث میشود بردار جدید همچنان بسیار شبیه بردار مرحله قبلی باشد.
در نتیجه، کش معنایی میتواند پاسخ قدیمی را برگرداند و Agent وارد چرخه تکرار شود.
پیشنهاد عملی: برای Agentهای دارای Tool Calling، مراحل دارای اثر جانبی و گفتگوهای وابسته به وضعیت، Semantic Cache عمومی را بهصورت پیشفرض غیرفعال نگه دارید. در صورت نیاز از Exact Cache با کلید کامل و اعتبارسنجی وضعیت یا کش اختصاصی نتایج ابزارهای بیخطر استفاده کنید.
این هشدار در مستندات Semantic Caching در LiteLLM نیز مطرح شده است.
چه ابزارهایی برای پیادهسازی Semantic Cache مناسباند؟
| ابزار | کاربرد | نکته مهم |
|---|---|---|
| Redis | کش سریع همراه با جستوجوی برداری | نیازمند طراحی Index و محدودیتهای مناسب |
| RedisVL | کتابخانه Python برای کش برداری | امکان تنظیم Distance Threshold و TTL |
| LiteLLM | Gateway با قابلیت Exact و Semantic Cache | پشتیبانی از Backendهای مختلف کش |
| Qdrant | پایگاه داده برداری | مناسب برای جستوجوی Embedding و فیلترها |
| LangCache | سرویس مدیریتشده کش معنایی | نیازمند بررسی هزینه، محل داده و سیاست امنیتی |
اگر از قبل Redis دارید، بررسی قابلیت کش معنایی آن میتواند نقطه شروع مناسبی باشد. برای برنامهای که از LiteLLM استفاده میکند، قابلیتهای کش داخلی Gateway نیز ارزش ارزیابی دارند.
برای انتخاب ابزار، صرفاً به پشتیبانی از Vector Search توجه نکنید. TTL، حذف داده، فیلترهای Tenant، هزینه Embedding، مشاهدهپذیری و قابلیت کنترل Hitهای اشتباه نیز مهماند.
نمونه تنظیم Semantic Cache در LiteLLM
LiteLLM علاوه بر Exact Cache، قابلیت کش معنایی با Backendهایی مانند Redis، Valkey و Qdrant را ارائه میدهد.
پیکربندی زیر یک نمونه آموزشی برای استفاده از Redis Semantic Cache است. برای اجرا باید Redis مناسب، مدل Embedding معتبر و تنظیمات اتصال را آماده کرده باشید.
model_list:
  - model_name: support-ai
    litellm_params:
      model: openai/YOUR_MODEL_ID
      api_key: os.environ/OPENAI_API_KEY

  - model_name: cache-embedding
    litellm_params:
      model: openai/YOUR_EMBEDDING_MODEL_ID
      api_key: os.environ/OPENAI_API_KEY

litellm_settings:
  cache: true
  cache_params:
    type: redis-semantic
    similarity_threshold: 0.85
    redis_semantic_cache_embedding_model: cache-embedding
مقادیر YOUR_MODEL_ID و YOUR_EMBEDDING_MODEL_ID باید با شناسههای معتبر در سرویس انتخابی جایگزین شوند. همچنین اتصال Redis باید مطابق مستندات نسخه نصبشده تنظیم شود.
عدد 0.85 صرفاً یک نقطه شروع آزمایشی است و به معنی Threshold بهینه برای تمام کاربردها نیست.
از فعالکردن عمومی این تنظیم روی همه درخواستها، بهویژه Agentها و اطلاعات شخصی، خودداری کنید. ابتدا محدوده کاربران و نوع درخواستهای مجاز برای کش را مشخص کنید.
روش اصولی Benchmark برای LLM Semantic Cache
برای تشخیص سود واقعی کش، باید مقایسهای قابل تکرار بین سه وضعیت انجام دهیم:
- بدون کش؛ تمام درخواستهای مجاز به مدل اصلی ارسال میشوند.
- Exact Cache؛ فقط کلیدهای دقیقاً برابر مجدداً استفاده میشوند.
- Exact + Semantic Cache؛ ابتدا تطبیق دقیق و سپس جستوجوی معنایی انجام میشود.
تست باید روی مجموعهای از درخواستهای واقعی یا داده آزمایشی نماینده انجام شود. همچنین لازم است ترتیب درخواستها، وضعیت اولیه کش، توزیع کاربران و شرایط بارگذاری کنترل شوند.
مرحله اول: ساخت مجموعه آزمون
برای مثال، میتوانید ۱۰۰۰ درخواست نماینده از یک چتبات پشتیبانی جمعآوری کنید؛ پس از حذف یا ناشناسسازی اطلاعات شخصی و با رعایت مجوز پردازش داده.
این دادهها را از نظر نوع درخواست و امکان استفاده مجدد از پاسخ برچسبگذاری کنید. همچنین درخواستهایی با شباهت بالا اما پاسخ متفاوت را عمداً در مجموعه قرار دهید.
مرحله دوم: اجرای Baseline بدون کش
در مرحله اول، هزینه توکن ورودی و خروجی، زمان پاسخ و نرخ موفقیت را بدون کش ثبت کنید.
مرحله سوم: اجرای Exact Cache
سپس همان توزیع درخواست را با کش دقیق آزمایش کنید و درصد Hitها، هزینه و زمان پاسخ را اندازه بگیرید.
مرحله چهارم: اجرای Semantic Cache
برای Thresholdهای مختلف، نرخ Hit صحیح و غلط را بررسی کنید. ضروری است که پاسخهای کششده در برابر پاسخ مرجع یا معیار اعتبارسنجی مشخص ارزیابی شوند.
مرحله پنجم: محاسبه هزینه خالص
هزینه Embedding، جستوجوی Redis، ذخیره داده، نگهداری زیرساخت و فراخوانیهای مدل را جمع بزنید.
هزینه تولید پاسخ اولیه هنگام Cache Miss را نیز لحاظ کنید. Cache Hitها بهتنهایی برای محاسبه هزینه کافی نیستند.
نمونه جدول Benchmark؛ اعداد فرضی
جدول زیر فقط یک نمونه آموزشی از نحوه گزارشدادن نتایج است و نباید بهعنوان بنچمارک واقعی Redis یا LiteLLM منتشر شود.
| شاخص | بدون کش | Exact Cache | Exact + Semantic |
|---|---|---|---|
| کل درخواستها | 1000 | 1000 | 1000 |
| Cache Hit | 0% | 18% | 42% |
| Hit معتبر | نامرتبط | 18% | 40% |
| Hit اشتباه | 0 | 0 | 20 درخواست |
| هزینه کل فرضی | $10.00 | $8.35 | $6.90 |
| صرفهجویی ظاهری | 0% | 16.5% | 31% |
در سناریوی فرضی بالا، کش معنایی هزینه را ۳۱ درصد کاهش داده است. ولی ۲۰ پاسخ اشتباه نیز ایجاد شدهاند؛ یعنی دو درصد کل درخواستها پاسخ نامناسب دریافت کردهاند.
اگر هزینه اصلاح این خطاها یا پیامدهای تجاری آنها بیشتر از صرفهجویی باشد، Semantic Cache در این تنظیم اقتصادی نیست.
بنابراین علاوه بر هزینه مستقیم، لازم است نرخ پاسخ معتبر، نرخ خطا و هزینه پیامدهای خطا نیز گزارش شود.
Hit Rate را چگونه درست اندازه بگیریم؟
تعریف معمول Cache Hit Rate برابر است با تعداد درخواستهایی که پاسخ آنها از کش بازگردانده شده، تقسیم بر کل درخواستهای واجد شرایط.
اما در Semantic Cache بهتر است دو شاخص جداگانه ثبت شود:
- Raw Hit Rate: تعداد پاسخهای بازگرداندهشده از کش، صرفنظر از درستی.
- Valid Hit Rate: فقط پاسخهایی که از نظر معنایی، زمینه و مجوز استفاده صحیح بودهاند.
برای نمونه، اگر از ۱۰۰۰ درخواست، ۴۲۰ مورد Cache Hit شوند ولی فقط ۴۰۰ پاسخ معتبر باشند، Raw Hit Rate برابر ۴۲ درصد و Valid Hit Rate برابر ۴۰ درصد است.
استفاده از Raw Hit Rate بهتنهایی ممکن است نتیجه آزمایش را بهتر از واقعیت نشان دهد.
نمونه محاسبه هزینه و Hit Rate با Python
اسکریپت زیر دادههای یک آزمایش فرضی را دریافت و هزینه متوسط و میزان صرفهجویی را محاسبه میکند. این کد برای تحلیل نتایج است و خودش Redis یا مدل زبانی را Benchmark نمیکند.
total_requests = 1000
cache_hits = 420
valid_hits = 400

baseline_cost = 10.00
cache_total_cost = 6.90

raw_hit_rate = cache_hits / total_requests
valid_hit_rate = valid_hits / total_requests

false_hits = cache_hits - valid_hits

savings = baseline_cost - cache_total_cost
savings_percent = (
    savings / baseline_cost
) * 100

print(f"Raw Hit Rate: {raw_hit_rate:.1%}")
print(f"Valid Hit Rate: {valid_hit_rate:.1%}")
print(f"Incorrect Hits: {false_hits}")
print(f"Cost Savings: ${savings:.2f}")
print(f"Savings Percent: {savings_percent:.1f}%")
خروجی مورد انتظار:
Raw Hit Rate: 42.0%
Valid Hit Rate: 40.0%
Incorrect Hits: 20
Cost Savings: $3.10
Savings Percent: 31.0%
این محاسبه فقط نشان میدهد چگونه نتایج جمعآوریشده را گزارش کنیم. برای یک بنچمارک واقعی باید درخواستها اجرا شوند، زمان و هزینه از سیستمهای واقعی جمعآوری شوند و کیفیت پاسخها با مجموعه مرجع ارزیابی شود.
تأثیر کش معنایی بر سرعت پاسخ
در یک Cache Hit معتبر، برنامه میتواند بدون اجرای مدل اصلی پاسخ را بازگرداند. بنابراین در بسیاری از کاربردها زمان پاسخ کاهش پیدا میکند.
اما در Cache Miss، فرآیند تولید Embedding و جستوجوی برداری به مسیر عادی اجرای مدل اضافه میشود. در نتیجه ممکن است تأخیر این درخواستها بیشتر از حالت بدون کش باشد.
بهتر است این معیارها را جداگانه ثبت کنید:
- زمان پاسخ Exact Hit.
- زمان پاسخ Semantic Hit.
- زمان پاسخ Semantic Miss.
- زمان تولید Embedding.
- زمان Vector Search.
- P50 و P95 کل درخواستها.
اگر سرویس Embedding کند باشد، حتی Cache Hit هم میتواند تأخیر نامطلوبی داشته باشد. انتخاب مدل Embedding سبک یا اجرای محلی آن ممکن است مفید باشد، اما باید با کیفیت تطبیق ارزیابی شود.
بهترین روشهای استفاده از Semantic Cache در Production
برای استقرار واقعی بهتر است قابلیتهای کش را بهتدریج فعال کنید و امکان بازگشت سریع به حالت بدون کش وجود داشته باشد.
- ابتدا Exact Cache را برای درخواستهای کاملاً تکراری فعال کنید.
- Semantic Cache را فقط روی گروههای مشخص از درخواستهای کمریسک آزمایش کنید.
- برای هر مدل Embedding، Threshold مستقل ارزیابی کنید.
- Tenant، Locale، نسخه داده و سایر محدودیتها را در جستوجو اعمال کنید.
- برای پاسخهای وابسته به اطلاعات متغیر، TTL و Invalidation مناسب تعیین کنید.
- تغییر مدل، Prompt یا پایگاه دانش را در سیاست اعتبار کش لحاظ کنید.
- از پاسخهای خطادار، خروجیهای نامعتبر و اطلاعات حساس بدون سیاست مشخص کش نسازید.
- بهصورت دورهای نمونهای از Hitها را برای بررسی کیفیت و نشت اطلاعات ارزیابی کنید.
- امکان غیرفعالکردن سریع کش را در زمان بروز خطا در نظر بگیرید.
- هزینه عملیاتی و کیفیت را همراه Hit Rate در داشبورد نمایش دهید.
اشتباههای رایج در LLM Semantic Cache
انتخاب Threshold صرفاً برای افزایش Hit Rate
هرچه شرط تطبیق آسانتر باشد، احتمال دریافت Hit بیشتر میشود؛ اما ممکن است سؤالهای غیرمعادل به یک پاسخ اشتباه متصل شوند. Threshold باید با کیفیت خروجی تنظیم شود.
کش کردن پاسخهای شخصیسازیشده بدون محدودیت
پاسخ وابسته به حساب کاربری نباید صرفاً به دلیل شباهت متن به کاربر دیگری برگردانده شود. محدوده دسترسی باید در خود فرآیند Lookup اعمال شود.
نداشتن سیاست Invalidation
پاسخی که دیروز درست بوده، ممکن است امروز به دلیل تغییر قیمت، شرایط خدمات یا داده منبع نامعتبر باشد.
استفاده عمومی از Semantic Cache برای Agentها
درخواستهای چندمرحلهای و دارای Tool Calling ممکن است به زمینهای وابسته باشند که با تطبیق برداری ساده قابل تشخیص نیست.
گزارش صرفهجویی بدون هزینه کش
اگر فقط تعداد فراخوانیهای حذفشده مدل شمارش شود ولی هزینه Embedding، Redis، ذخیرهسازی و نگهداری محاسبه نشود، نتیجه اقتصادی قابل اتکا نیست.
چه زمانی Semantic Cache را فعال کنیم و چه زمانی نه؟
| نوع کاربرد | پیشنهاد | علت |
|---|---|---|
| FAQ و راهنمای عمومی خدمات | مناسب برای آزمایش | پرسشهای تکراری و پاسخهای نسبتاً پایدار |
| پشتیبانی با اطلاعات عمومی | مناسب با کنترل کیفیت | قابلیت استفاده مجدد از پاسخ |
| تولید محتوای خلاقانه | معمولاً اولویت پایینتر | انتظار خروجی متفاوت و تنوع درخواست |
| اطلاعات لحظهای حساب و سفارش | عدم کش عمومی پاسخ | وابستگی به کاربر و داده زنده |
| Agent چندمرحلهای | احتیاط جدی | وابستگی به وضعیت و تاریخچه |
| پردازش داده محرمانه | فقط با سیاست امنیتی مشخص | خطر نشت یا استفاده مجدد غیرمجاز |
جمعبندی؛ آیا LLM Semantic Cache ارزش استفاده دارد؟
LLM Semantic Cache زمانی ارزشمند است که درخواستهای مشابه زیادی وجود داشته باشد، پاسخهای ذخیرهشده برای درخواستهای جدید معتبر بمانند و هزینه Lookup و نگهداری کش از هزینه حذفشده فراخوانی مدل کمتر باشد.
برای شروع، بهتر است یک کش دومرحلهای شامل Exact Cache و Semantic Cache طراحی کنید. سپس روی داده واقعی، Threshold را تنظیم و کیفیت پاسخها را در کنار هزینه اندازهگیری کنید.
در نهایت، هدف افزایش عدد Hit Rate نیست؛ هدف این است که برنامه با هزینه کمتر، سرعت مناسبتر و بدون کاهش قابلتوجه دقت و امنیت پاسخ بدهد.
سؤالات متداول درباره LLM Semantic Cache
آیا Semantic Cache همیشه هزینه API هوش مصنوعی را کم میکند؟
خیر. اگر درخواستهای مشابه کم باشند یا هزینه Embedding و نگهداری کش زیاد باشد، صرفهجویی ممکن است ناچیز یا منفی شود.
تفاوت Exact Cache و Semantic Cache چیست؟
Exact Cache به دنبال درخواست با کلید یکسان میگردد، اما Semantic Cache با استفاده از Embedding میتواند درخواستهای دارای معنی مشابه را نیز تطبیق دهد.
بهترین Similarity Threshold چقدر است؟
مقدار ثابتی برای همه کاربردها وجود ندارد. Threshold باید بر اساس مدل Embedding، نوع داده، کیفیت پاسخ و نرخ تطبیق اشتباه انتخاب شود.
آیا Semantic Cache برای اطلاعات کاربران امن است؟
فقط زمانی که محدوده دسترسی، شناسه کاربر یا سازمان، سیاست نگهداری داده و اعتبارسنجی پاسخ بهدرستی اعمال شده باشند.
آیا Semantic Cache جایگزین Prompt Caching است؟
خیر. Semantic Response Cache میتواند در Cache Hit معتبر فراخوانی مدل را حذف کند، درحالیکه Prompt Caching معمولاً به استفاده مجدد از بخشهایی از پردازش ورودی در سمت ارائهدهنده کمک میکند.
چگونه بفهمیم کش معنایی واقعاً اقتصادی است؟
با اجرای آزمایش روی دادههای نماینده و مقایسه هزینه کل، Valid Hit Rate، نرخ پاسخ غلط، زمان پاسخ و هزینه نگهداری در حالت بدون کش، کش دقیق و کش معنایی.
دیدگاهها (۰)