
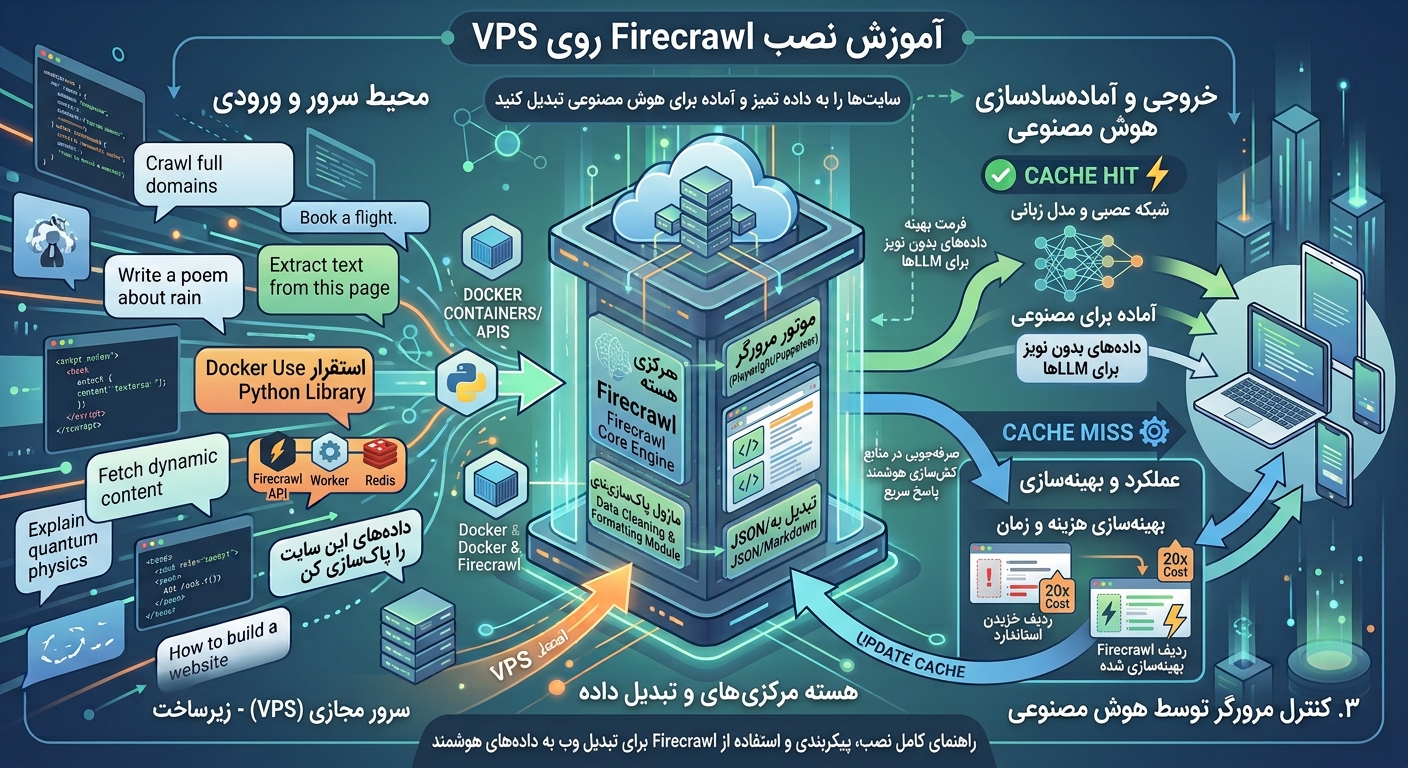
اگر روی پروژههای هوش مصنوعی کار میکنید، احتمالاً با این چالش روبهرو شدهاید: دادههای مورد نیازتان داخل صدها صفحه وب پخش شدهاند و استخراج دستی آنها غیرممکن است. ابزارهای زیادی برای وباسکرپینگ وجود دارند، اما Firecrawl تفاوت مهمی دارد — این ابزار سایت را بهطور کامل میخواند، محتوای اصلی را از زوائد جدا میکند و خروجی را به فرمت Markdown یا JSON تحویل میدهد؛ دقیقاً همان چیزی که مدلهای زبانی به آن نیاز دارند.
در این مقاله، بهصورت گامبهگام روی یک سرور مجازی نصبش میکنیم، تنظیمات ضروری را انجام میدهیم و یک اسکرپ واقعی را تست میکنیم. نکته مهم: Firecrawl بهصورت پیشفرض به منابع قابلتوجهی نیاز دارد. اگر روی یک VPS ضعیف نصبش کنید، یا سرویس بالا نمیآید یا در اولین درخواست سنگین از پا درمیآید. مشخصات سرور را باید جدی بگیرید.
Firecrawl دقیقاً چه کاری انجام میدهد؟
Firecrawl یک API متنباز برای وباسکرپینگ در مقیاس است. بهجای اینکه با BeautifulSoup یا Selenium درگیر شوید، یک URL میدهید و خروجی تمیز میگیرید . قابلیتهای اصلی شامل این موارد است:
🔹 Scrape — یک صفحه را میخواند و به Markdown یا JSON تبدیل میکند.
🔹 Crawl — کل یک دامنه را دنبال میکند و از همه صفحات داده جمع میکند.
🔹 Map — فقط لیست URLهای موجود در سایت را برمیگرداند (برای نقشهبرداری سریع).
🔹 Search — جستجوی وب میکند و نتایج را با محتوای کامل برمیگرداند .
نکته کلیدی برای پروژههای AI: خروجی Markdown Firecrawl ساختار تیترها، لیستها و کدها را حفظ میکند. این یعنی chunking برای RAG و fine-tuning بدون تمیزکاری اضافی انجام میشود.
چرا روی VPS نصب کنیم؟
Firecrawl Cloud سریعترین راه شروع است، اما سه محدودیت دارد: هزینه بر اساس تعداد درخواست، عدم کنترل روی دادههای خروجی و وابستگی به سرورهای خارجی. نسخه self-hosted این محدودیتها را ندارد .
با نصب روی VPS، دادهها هرگز از سرور شما خارج نمیشوند، میتوانید بدون محدودیت درخواست بزنید و تنظیمات را مطابق نیاز پروژه تغییر دهید. اما در عوض، مسئولیت نگهداری، آپدیت و رفع خطا هم با خودتان است.
📌 نکته مهم درباره منابع سرور
Firecrawl برای اجرای روان، حداقل ۴ هسته CPU و ۸ گیگابایت رم نیاز دارد. سرویس Playwright که مسئول رندر صفحات JavaScript است، خودش ۲ هسته و ۴ گیگ رم اضافه میخواهد . اگر سرور شما ۲ هسته و ۲ گیگ رم دارد، نصب را شروع نکنید — قبل از هر چیز یک VPS مناسب تهیه کنید.
پیشنیازها
قبل از شروع، این موارد باید روی سرور نصب باشند:
🔹 Git — برای دریافت سورسکد.
🔹 Docker Engine — موتور اجرای کانتینرها.
🔹 Docker Compose v2 — برای orchestration سرویسها. دقت کنید که با docker compose (با فاصله) اجرا میشود، نه docker-compose قدیمی.
🔹 curl — برای تست API.
اگر Ubuntu 22.04 یا 24.04 دارید، نصب Docker و Compose با اسکریپت رسمی سریع انجام میشود. پورت 3002 هم باید آزاد باشد .
نصب گامبهگام Firecrawl
مرحله ۱ — دریافت نسخه پایدار
مخزن Firecrawl را clone کنید و روی نسخه v2.11.162 سوییچ کنید. این نسخه در مستندات رسمی تأیید شده و فایل Compose آن پایدار است :
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
مرحله ۲ — ساخت فایل تنظیمات
یک فایل .env در ریشه پروژه بسازید. حداقل تنظیمات لازم برای اجرای اولیه شامل رمز PostgreSQL و غیرفعال بودن احراز هویت است :
cat > .env <<'EOF'
USE_DB_AUTHENTICATION=false
POSTGRES_USER=postgres
POSTGRES_PASSWORD=یک-رمز-تصادفی-حداقل-۳۲-کاراکتری-اینجا-بگذارید
POSTGRES_DB=postgres
EOF
⚠️ هشدار امنیتی: این تنظیمات احراز هویت را غیرفعال میکند. هر کسی که به پورت ۳۰۰۲ دسترسی داشته باشد، میتواند از API استفاده کند. اگر سرور شما IP عمومی دارد، حتماً یک reverse proxy با احراز هویت یا محدودیت IP در جلوی آن قرار دهید .
مرحله ۳ — بیلد و اجرا
حالا سرویسها را بیلد و در پسزمینه اجرا کنید :
docker compose up --build -d
docker compose ps --all
دستور دوم وضعیت سرویسها را نشان میدهد. باید ببینید که api، worker، postgres، redis و playwright-service در حال اجرا هستند. سرویسهای initialization بهصورت one-shot اجرا میشوند و بعد از اتمام متوقف میشوند — این طبیعی است.
اگر بعضی سرویسها هنوز در حال starting هستند، چند ثانیه صبر کنید و دوباره چک کنید.
⚠️ محدودیت نسخه self-hosted: Firecrawl خودمیزبان به Fire-engine دسترسی ندارد. این یعنی قابلیتهای پیشرفتهای مثل دور زدن IP block، مدیریت bot detection و proxy چرخشی در نسخه رایگان وجود ندارد . برای سایتهای معمولی این محدودیت مشکلی ایجاد نمیکند، اما اگر هدف اسکرپ سایتهای سنگین با anti-bot قوی باشد، باید سراغ نسخه Cloud بروید یا از proxy خارجی استفاده کنید.
تست عملکرد API
اول مطمئن شوید API به درخواست HTTP پاسخ میدهد :
curl --fail --silent --show-error http://localhost:3002/v0/health/readiness
خروجی مورد انتظار: {“status”:”ok”}
حالا یک اسکرپ واقعی انجام دهید. این تست نشان میدهد که worker به درستی کار میکند و Playwright میتواند صفحات را رندر کند :
curl --fail-with-body --max-time 75 \
  -X POST http://localhost:3002/v2/scrape \
  -H 'Content-Type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"],"timeout":60000}'
پاسخ موفق چیزی شبیه این است: {“success”:true,”data”:{“markdown”:”…”,”metadata”:{“statusCode”:200}}}
اگر markdown برگشت، نصب شما کامل است.
مقایسه منابع موردنیاز سرویسها
قبل از انتخاب پلن VPS، این جدول را در نظر بگیرید. Firecrawl یک سرویس سبک نیست و کمبود منابع باعث از کار افتادن workerها میشود :
| سرویس | حداقل CPU | حداقل RAM | نقش |
|---|---|---|---|
| API + Worker | ۴ هسته | ۸ گیگابایت | دریافت درخواست، مدیریت صف، اجرای crawl |
| Playwright | ۲ هسته | ۴ گیگابایت | رندر صفحات JavaScript |
| PostgreSQL + Redis | ۱ هسته | ۲ گیگابایت | صف وظایف و ذخیرهسازی موقت |
| مجموع پیشنهادی | ۶ هسته | ۱۲–۱۴ گیگابایت | برای کارکرد روان و بدون بلاک شدن |
سرور مجازی مناسب برای Firecrawl و پروژههای AI
ایرانیکاسرور VPS با منابع کاملاً اختصاصی CPU و RAM ارائه میدهد؛ بدون oversell و بدون افت عملکرد در ساعات اوج. دیسک NVMe سرعت خواندن/نوشتن را بالا میبرد و پهنای باند نامحدود اجازه میدهد crawlهای سنگین را بدون نگرانی از مصرف ترافیک اجرا کنید. برای پروژههای دادهمحور، آپتایم ۹۹.۹٪ و پشتیبانی ۲۴/۷ یعنی سرویس شما همیشه در دسترس است.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
نکات مهم برای اجرای پایدار
بعد از نصب، این تنظیمات را حتماً بررسی کنید:
🔹 محدودیت منابع worker: Firecrawl دو متغیر محیطی MAX_CPU و MAX_RAM دارد که بهصورت پیشفرض روی ۰.۸ تنظیم شدهاند. اگر سرور شما RAM کم دارد، این مقادیر را پایینتر بیاورید تا worker قبل از مصرف کامل حافظه، درخواست جدید را رد کند .
🔹 ذخیرهسازی پایدار: PostgreSQL در تنظیمات پیشفرض volume اختصاصی دارد، اما بکاپگیری خودکار انجام نمیشود. اگر دادههای crawl شده برایتان ارزشمند است، یک cron job برای pg_dump بگذارید.
🔹 دسترسی به Playwright: سرویس Playwright بهصورت پیشفرض اجرا میشود، اما اگر فقط سایتهای ایستا (HTML ساده) را اسکرپ میکنید، میتوانید آن را غیرفعال کنید و منابع آزاد کنید. برای این کار متغیر PLAYWRIGHT_MICROSERVICE_URL را خالی بگذارید .
خطاهای رایج و راهحل
خطای “port 3002 already in use” — یک سرویس دیگر روی این پورت در حال اجراست. با دستور sudo lsof -i :3002 پیدا کنید و متوقفش کنید، یا پورت Firecrawl را در فایل .env تغییر دهید.
Worker مدام ریاستارت میشود — تقریباً همیشه به خاطر کمبود RAM است. خروجی docker compose logs worker را چک کنید. اگر خطای OOM دیدید، پلن سرور را ارتقا دهید.
Scrape روی سایتهای JavaScript-heavy برمیگردد به صفحه خالی — سرویس Playwright به درستی کار نمیکند. با docker compose logs playwright-service بررسی کنید و مطمئن شوید کرومیوم نصب شده است.
API به درخواستهای خارجی پاسخ نمیدهد — فایروال پورت ۳۰۰۲ را بسته است. یا پورت را باز کنید (با احتیاط امنیتی) یا از reverse proxy مثل Nginx استفاده کنید.
جمعبندی
Firecrawl روی VPS به شما کنترل کامل روی دادههایی میدهد که مدلهای هوش مصنوعیتان با آنها تغذیه میشوند. نصبش پیچیده نیست — Docker Compose کار را ساده کرده — اما منابع سرور را دستکم نگیرید. حداقل ۶ هسته CPU و ۱۲ گیگابایت RAM برای یک اجرای پایدار لازم است. اگر سرور شما این مشخصات را دارد، در کمتر از ۱۵ دقیقه میتوانید اولین crawl خود را شروع کنید. اگر نه، اول یک VPS مناسب تهیه کنید و بعد سراغ نصب بروید.
مشکلی در کانفیگ Firecrawl دارید؟
تیم فنی ایرانیکاسرور آماده کمک است. درخواستتان را ثبت کنید یا مستقیم تماس بگیرید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.