
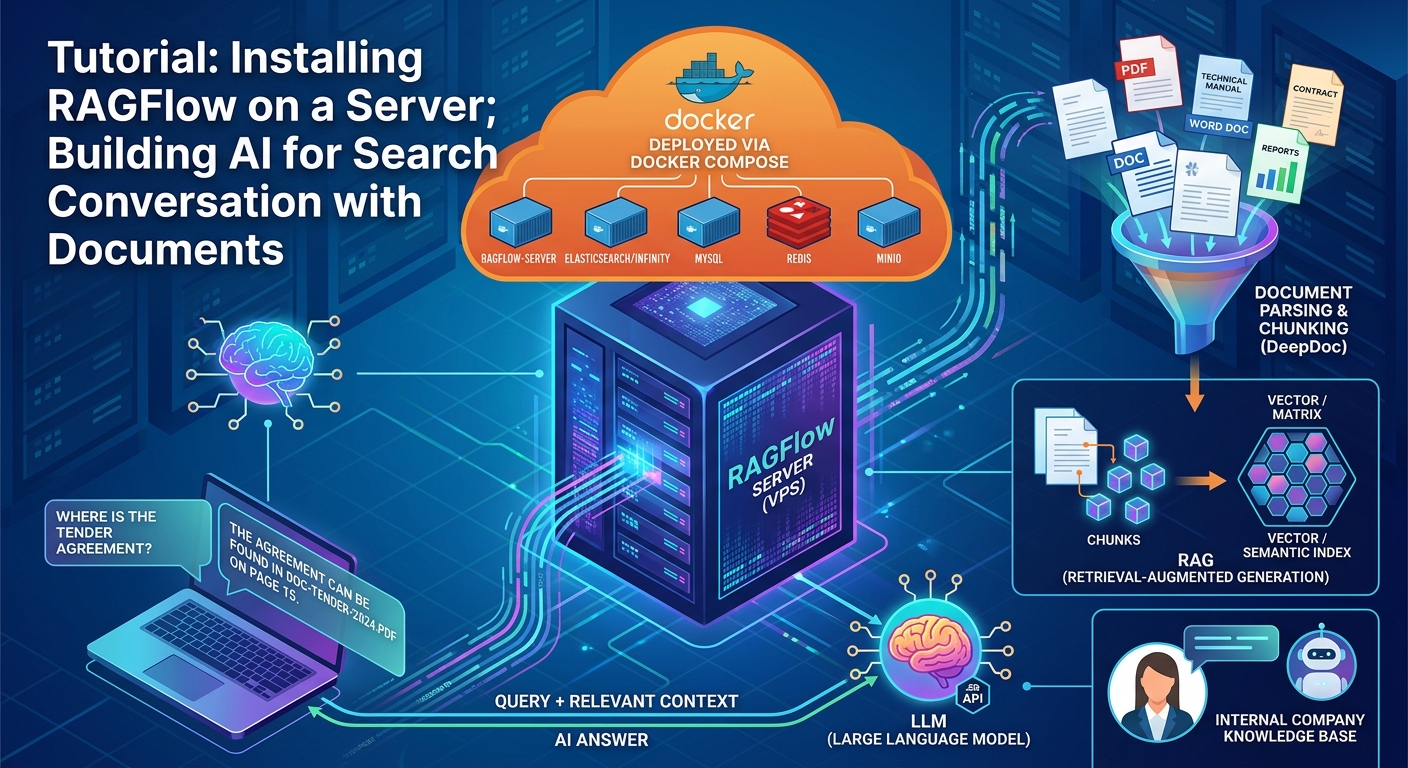
اگر حجم زیادی از فایلهای PDF، قرارداد، مستندات فنی و گزارشهای سازمانی دارید و هر بار برای پیدا کردن یک نکته باید دهها فایل را باز کنید، RAGFlow میتواند نقطه پایانی این اتلاف وقت باشد. RAGFlow یک موتور متنباز RAG (Retrieval-Augmented Generation) است که اسناد شما را پردازش میکند، اطلاعات مرتبط را پیدا میکند و پاسخها را بر اساس محتوای واقعی همان اسناد به شما تحویل میدهد. در این آموزش، نصب RAGFlow روی سرور مجازی را با Docker بهصورت عملی و قدمبهقدم بررسی میکنیم و کنار آن مفاهیم RAG، انتخاب منابع سختافزاری مناسب و خطاهای رایج را نیز پوشش میدهیم.
RAGFlow دقیقاً چه کاری انجام میدهد؟
یک مدل زبانی عمومی مثل ChatGPT یا Gemini به فایلهای خصوصی شرکت شما دسترسی ندارد. اگر بپرسید «شرایط گارانتی محصول X چیست؟» یا «آخرین تمدید قرارداد با تأمینکننده Y چه زمانی بوده؟»، مدل چیزی برای پاسخ دادن ندارد. RAGFlow این شکاف را پر میکند: ابتدا اسناد شما را میخواند، به قطعات قابل جستوجو تقسیم میکند، آنها را به بردارهای عددی تبدیل میکند و در یک موتور جستوجو ذخیره میکند. وقتی سؤال میپرسید، RAGFlow ابتدا مرتبطترین قطعات را پیدا میکند و سپس آن قطعات را در اختیار مدل زبانی میگذارد تا پاسخ نهایی ساخته شود [citation:3][citation:10].
مسیر کلی پردازش یک سند در RAGFlow به این شکل است:
PDF / Word / Excel
      ↓
  RAGFlow
      ↓
Document Parsing
      ↓
   Chunking
      ↓
  Embedding
      ↓
Vector + Full-Text Search
      ↓
Relevant Chunks
      ↓
   LLM
      ↓
 AI Answer
نکته کلیدی این است که RAGFlow خودش مدل زبانی نیست. این ابزار لایه مدیریت دانش، پردازش اسناد و بازیابی اطلاعات است. برای تولید پاسخ نهایی، باید یک مدل زبانی (از طریق API مثل OpenAI، DeepSeek، Qwen یا حتی Ollama لوکال) به آن متصل کنید [citation:1][citation:12].
📌 برای شروع، حداقل منابع اعلامشده RAGFlow شامل ۴ هسته CPU، ۱۶ گیگابایت RAM و ۵۰ گیگابایت فضای دیسک است. اگر سرور مجازی شما منابع کمتری دارد، بهتر است قبل از نصب به فکر ارتقا باشید [citation:3][citation:10].
چرا RAGFlow را روی VPS نصب کنیم و نه روی سیستم شخصی؟
اجرای RAGFlow روی یک سرور مجازی مزیتهای عملی دارد: سرور همیشه روشن است، تیم میتواند از هر دستگاهی به آن دسترسی داشته باشد، منابع سختافزاری بهصورت اختصاصی در اختیار RAGFlow قرار میگیرد و دادهها در زیرساخت خودتان باقی میمانند. برخلاف استفاده از سرویسهای ابری RAG که اسناد را روی سرورهای شرکت دیگری ذخیره میکنند، Self-Hosted کردن RAGFlow روی VPS کنترل کامل روی دادههای حساس سازمانی میدهد.
منابع پیشنهادی برای محیط واقعی
حداقلهای اعلامشده برای تست کافیاند، اما اگر قرار است روزانه چند کاربر با صدها سند کار کنند، منابع بیشتری نیاز دارید. تجربه عملی نشان میدهد ترکیب زیر نقطه شروع منطقیتری است:
| منبع | حداقل اعلامشده | پیشنهاد برای محیط واقعی |
|---|---|---|
| CPU | ۴ هسته | ۸ هسته |
| RAM | ۱۶ GB | ۳۲ GB |
| دیسک | ۵۰ GB | ۱۰۰ تا ۲۰۰ GB NVMe |
| Docker | نسخه 24+ | نسخه 24+ |
| Docker Compose | نسخه 2.26.1+ | نسخه 2.26.1+ |
اگر تعداد اسناد زیاد است (مثلاً بیش از ۱۰ هزار فایل PDF) یا چند کاربر همزمان از سیستم استفاده میکنند، RAM بیشتر و دیسک NVMe سریعتر تفاوت محسوسی در سرعت بازیابی و پایداری سرویس ایجاد میکند.
⚠️ نکته مهم: RAGFlow چند سرویس را بهصورت همزمان اجرا میکند: MySQL، Elasticsearch (یا Infinity)، Redis، MinIO و خود RAGFlow. اگر RAM سرور کمتر از ۱۶GB باشد، احتمال Crash یا کندی شدید وجود دارد. این موضوع را قبل از نصب جدی بگیرید.
پیشنیازهای نصب روی سرور Ubuntu
در این آموزش فرض میکنیم یک سرور مجازی Ubuntu (نسخه 22.04 یا 24.04) در اختیار دارید و با SSH به آن متصل هستید. ابتدا سیستم را بهروزرسانی کنید و ابزارهای پایه را نصب کنید:
sudo apt update && sudo apt upgrade -y
sudo apt install -y git curl wget
بررسی سریع منابع سرور
قبل از هر چیز، مطمئن شوید منابع سرور با نیازمندیهای RAGFlow همخوانی دارد:
lscpu # تعداد هستههای CPU free -h # وضعیت RAM df -h # فضای دیسک
اگر RAM کمتر از ۱۶GB است، نصب RAGFlow را متوقف کنید و ابتدا سرور را ارتقا دهید. این توصیه سختگیرانه است، اما از تجربه خطاهای مکرر و ناپایداری سرویس جلوگیری میکند.
نصب Docker و Docker Compose
RAGFlow بهصورت رسمی از Docker برای استقرار پشتیبانی میکند [citation:3][citation:10]. سادهترین روش نصب Docker روی Ubuntu استفاده از اسکریپت رسمی است:
curl -fsSL https://get.docker.com | sh
sudo systemctl enable --now docker
پس از نصب، نسخه Docker و Docker Compose را بررسی کنید:
docker --version
docker compose version
خروجی باید حداقل Docker 24 و Docker Compose 2.26.1 را نشان دهد [citation:10]. اگر نسخه قدیمیتر است، Docker را بهروزرسانی کنید.
تنظیم حیاتی vm.max_map_count
این مرحله را جدی بگیرید. Elasticsearch (موتور جستوجوی پیشفرض RAGFlow) به مقدار کافی vm.max_map_count نیاز دارد. اگر این مقدار کمتر از 262144 باشد، سرویسهای وابسته ممکن است با خطا متوقف شوند [citation:1][citation:3][citation:10].
ابتدا مقدار فعلی را بررسی کنید:
sysctl vm.max_map_count
اگر خروجی کمتر از 262144 بود، مقدار را موقتاً تنظیم کنید:
sudo sysctl -w vm.max_map_count=262144
برای دائمی کردن این تنظیمات (تا بعد از ریبوت هم باقی بماند)، خط زیر را به /etc/sysctl.conf اضافه کنید:
echo "vm.max_map_count=262144" | sudo tee -a /etc/sysctl.conf
sudo sysctl -p
دوباره با دستور sysctl vm.max_map_count بررسی کنید که مقدار 262144 نمایش داده شود.
دریافت RAGFlow و اجرای سرویس
مخزن رسمی RAGFlow را Clone کنید و وارد پوشه Docker شوید:
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/docker
سپس اسکریپت entrypoint را قابل اجرا کنید و سرویسها را با Docker Compose بالا بیاورید:
chmod +x ./entrypoint.sh
docker compose up -d
اولین اجرا ممکن است چند دقیقه طول بکشد، چون Docker Imageهای RAGFlow و سرویسهای وابسته (Elasticsearch، MySQL، Redis، MinIO) دانلود و آمادهسازی میشوند. حجم Image اصلی حدود ۹GB است [citation:10]، بنابراین صبور باشید.
بررسی وضعیت سرویس و مشاهده لاگ
پس از اجرا، وضعیت Containerها را بررسی کنید:
docker compose ps
برای مشاهده لاگ RAGFlow:
docker logs -f ragflow-server
📌 نکته: اگر نام Container متفاوت بود، ابتدا با docker ps نام دقیق را پیدا کنید. پس از اجرای موفق، در لاگها پیامی شبیه به “Running on all addresses” ظاهر میشود که نشاندهنده آماده بودن سرویس است [citation:10].
ورود به رابط وب RAGFlow
در تنظیمات پیشفرض، RAGFlow روی پورت 80 ارائه میشود. مرورگر را باز کنید و IP سرور خود را وارد کنید:
http://SERVER_IP
اگر پورت 80 روی سرور شما اشغال است (مثلاً Nginx یا Apache در حال استفاده از آن است)، میتوانید پورت را در فایل docker-compose.yml تغییر دهید. خط 80:80 را به مثلاً 8080:80 تغییر دهید و سپس Containerها را دوباره راهاندازی کنید [citation:6][citation:15].
RAGFlow را روی یک سرور مجازی پایدار اجرا کنید
اجرای RAGFlow به منابع پایدار و اختصاصی نیاز دارد. اگر از سرور مجازی اشتراکی با منابع نامطمئن استفاده کنید، احتمال کندی، Crash سرویسهای وابسته و از کار افتادن ناگهانی پایگاه دانش وجود دارد. ایرانیکاسرور سرورهای مجازی ایران و خارج را با منابع اختصاصی CPU و RAM، دیسک NVMe برای I/O سریع، آپتایم بالا و پشتیبانی ۲۴/۷ ارائه میدهد تا RAGFlow بدون وقفه روی زیرساخت شما اجرا شود.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
ساخت Dataset و بارگذاری اسناد
بعد از ورود به RAGFlow، اولین کار ساخت یک Dataset (Knowledge Base) است. Dataset را مثل یک پوشه هوشمند در نظر بگیرید که مجموعهای از اسناد مرتبط را در خود نگه میدارد. میتوانید چند Dataset جداگانه بسازید: مستندات فنی، قراردادها، منابع انسانی، راهنمای محصولات و غیره. این جداسازی باعث میشود جستوجوها دقیقتر و سریعتر انجام شوند.
پس از ساخت Dataset، فایلهای خود را بارگذاری کنید. RAGFlow از فرمتهای متنوعی پشتیبانی میکند: PDF، Word، Excel، PowerPoint، TXT، تصاویر و صفحات وب [citation:10]. هر فایل پس از بارگذاری، وارد مرحله Parsing و Chunking میشود.
Chunking چیست و چرا اهمیت دارد؟
یک PDF ۵۰۰ صفحهای را نمیتوان یکجا به مدل زبانی داد. RAGFlow سند را به قطعات کوچکتر (Chunk) تقسیم میکند تا هنگام پرسش، فقط مرتبطترین قطعات پیدا و به مدل داده شوند. کیفیت Chunking مستقیماً روی دقت پاسخها اثر میگذارد. اگر Chunkها بیش از حد کوچک باشند، ارتباط بین جملات از بین میرود. اگر بیش از حد بزرگ باشند، اطلاعات غیرمرتبط وارد Context میشود و کیفیت پاسخ پایین میآید.
در RAGFlow میتوانید برای هر Dataset نوع Chunking (مثلاً General یا مبتنی بر Template) را انتخاب کنید. برای اسناد ساختاریافته مثل CSV یا SQL Schema، تنظیمات Chunking متفاوتی وجود دارد تا هر جدول بهصورت مستقل ایزوله شود [citation:4].
Embedding و جستوجوی معنایی
پس از Chunking، هر قطعه متن به یک بردار عددی تبدیل میشود که Embedding نام دارد. این بردارها معنای متن را نشان میدهند، نه فقط کلمات آن را. به همین دلیل اگر کاربر سؤال را با عبارتی متفاوت از متن اصلی سند بنویسد، سیستم همچنان میتواند محتوای مرتبط را پیدا کند.
📌 نمونه ساده: اگر در سند نوشته شده «برای تغییر پورت SSH فایل sshd_config را ویرایش کنید» و کاربر بپرسد «چطور پورت SSH را عوض کنم؟»، جستوجوی معنایی میتواند همان قطعه را پیدا کند، حتی اگر کلمات دقیقاً یکسان نباشند.
اتصال مدل زبانی (LLM) به RAGFlow
RAGFlow خودش پاسخ نهایی را تولید نمیکند. باید یک مدل زبانی به آن متصل کنید. دو مسیر اصلی وجود دارد:
🔹 استفاده از API سرویسهای ابری: OpenAI، DeepSeek، Qwen، Gemini یا هر ارائهدهنده دیگری که API دارد. کافی است API Key را در بخش تنظیمات مدل RAGFlow وارد کنید [citation:10].
🔹 استفاده از مدل لوکال با Ollama: اگر میخواهید مدل هم روی همان سرور اجرا شود (بدون ارسال درخواست به بیرون)، میتوانید Ollama را نصب کنید و مدلهایی مثل Qwen2 یا Llama 3 را به RAGFlow وصل کنید [citation:1][citation:12].
پس از اتصال مدل، میتوانید یک Chat بسازید، Dataset موردنظر را به آن متصل کنید و از کاربران بخواهید سؤالات خود را بپرسند. RAGFlow ابتدا اسناد را جستوجو میکند، قطعات مرتبط را پیدا میکند و سپس آنها را همراه با سؤال به مدل میفرستد.
# نمونه اتصال Ollama به RAGFlow
# در تنظیمات مدل RAGFlow، آدرس Ollama را وارد کنید:
http://host.docker.internal:11434
نکته مهم: چون RAGFlow داخل Docker اجرا میشود و Ollama روی هاست، باید از host.docker.internal استفاده کنید (نه localhost). در برخی سیستمهای لینوکسی ممکن است نیاز به تنظیمات شبکه اضافه داشته باشید [citation:12].
تنظیم دامنه و HTTPS برای دسترسی امن
برای محیط واقعی، دسترسی به RAGFlow از طریق IP و پروتکل HTTP توصیه نمیشود. یک دامنه مثل ai.yourdomain.com تعریف کنید و با Nginx بهعنوان Reverse Proxy آن را به RAGFlow متصل کنید. سپس با Let’s Encrypt یک گواهی TLS رایگان بگیرید تا ارتباط رمزنگاری شود.
ساختار پیشنهادی:
کاربر
  ↓
HTTPS (Nginx + Let's Encrypt)
  ↓
RAGFlow (پورت 80 داخلی)
  ↓
Docker Containers
همچنین سرویسهای داخلی RAGFlow (MySQL، Redis، Elasticsearch، MinIO) را هرگز مستقیماً روی اینترنت باز نکنید. فقط پورتهای 22، 80 و 443 باید از بیرون قابل دسترس باشند.
خطاهای رایج و راهحلها
۱. خطای vm.max_map_count هنگام بالا آمدن Elasticsearch
اگر Container مربوط به Elasticsearch یا Infinity مرتباً Restart میشود، مقدار vm.max_map_count را بررسی کنید. این مقدار باید حداقل 262144 باشد [citation:3][citation:10]. راهحل در بخشهای قبلی توضیح داده شده است.
۲. پورت 80 اشغال است
اگر هنگام اجرای docker compose up خطای bind: address already in use دریافت کردید، پورت 80 توسط سرویس دیگری (مثل Nginx یا Apache) اشغال شده است. میتوانید آن سرویس را متوقف کنید یا پورت RAGFlow را در docker-compose.yml تغییر دهید [citation:1][citation:6].
# بررسی چه سرویسی از پورت 80 استفاده میکند sudo lsof -i :80 # یا sudo ss -lntp | grep :80
۳. سرویس بالا نمیآید یا مدام Restart میشود
اول لاگ Container مربوطه را بررسی کنید:
docker ps -a
docker logs CONTAINER_NAME
دلایل رایج: کمبود RAM، تنظیمات اشتباه در .env، ناسازگاری نسخه Image یا عدم دسترسی سرویس وابسته. اگر RAM تقریباً پر است، احتمال Crash سرویسها بالاست.
۴. مدل زبانی پاسخ نمیدهد
اگر RAGFlow بالا آمده ولی Chat پاسخی تولید نمیکند، مشکل معمولاً از اتصال LLM است. این موارد را بررسی کنید:
🔹 صحت API Key و نام مدل
🔹 آدرس API (درست بودن endpoint)
🔹 دسترسی سرور به اینترنت (اگر از API ابری استفاده میکنید)
🔹 تنظیمات Embedding Model
۵. پاسخها دقیق نیستند
گاهی مشکل از مدل نیست، از Retrieval است. یعنی قطعات اشتباهی پیدا و به مدل داده میشوند. این موارد را بررسی کنید:
🔹 Chunking: اندازه Chunkها را متناسب با نوع سند تنظیم کنید.
🔹 Parsing: اگر PDF اسکنشده بدون OCR پردازش شده، متن قابل جستوجو نیست.
🔹 Embedding Model: انتخاب مدل Embedding مناسب برای زبان فارسی یا تخصصی.
🔹 کیفیت خود اسناد: فایلهای بیکیفیت یا ناخوانا ورودی ضعیفی به سیستم میدهند.
نکات امنیتی برای استقرار سازمانی
🔹 RAGFlow را بدون HTTPS در معرض اینترنت قرار ندهید.
🔹 سرویسهای داخلی (MySQL، Redis، Elasticsearch، MinIO) را Public نکنید.
🔹 از دادهها و اسناد اصلی Backup منظم بگیرید.
🔹 API Key مدل زبانی را در فایلهای عمومی یا مخازن Git قرار ندهید.
🔹 اگر اسناد محرمانه دارید، Datasetهای مختلف را با کنترل دسترسی مناسب مدیریت کنید.
در نصب یا کانفیگ RAGFlow به مشکل خوردهاید؟
اگر در مراحل نصب Docker، تنظیمات سرور، اتصال مدل زبانی یا هر بخش دیگری از این آموزش با خطا مواجه شدید، تیم فنی ایرانیکاسرور آماده کمک است. کافی است درخواست خود را از طریق صفحه کانفیگ ارسال کنید تا راهنمایی لازم را دریافت کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
جمعبندی: مسیر اجرای RAGFlow روی سرور مجازی
RAGFlow یکی از جدیترین ابزارهای متنباز برای ساخت سیستمهای RAG و دستیار هوش مصنوعی اختصاصی است. اگر روی سرور مجازی با منابع کافی نصب شود، میتواند به یک پایگاه دانش هوشمند برای سازمان شما تبدیل شود.
فرآیند کلی:
VPS → Ubuntu → Docker → RAGFlow → Dataset → Documents → Embedding → LLM → AI Chat
حداقل منابع اعلامشده ۴ هسته CPU، ۱۶GB RAM و ۵۰GB دیسک است و مقدار vm.max_map_count باید 262144 تنظیم شود. اگر هدف شما استفاده چندکاربره و پردازش حجم زیادی از اسناد است، سرور مجازی قویتری با RAM و دیسک NVMe انتخاب کنید.
منابع خارجی: RAGFlow در GitHub، مستندات رسمی RAGFlow، نصب Docker Engine







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.