
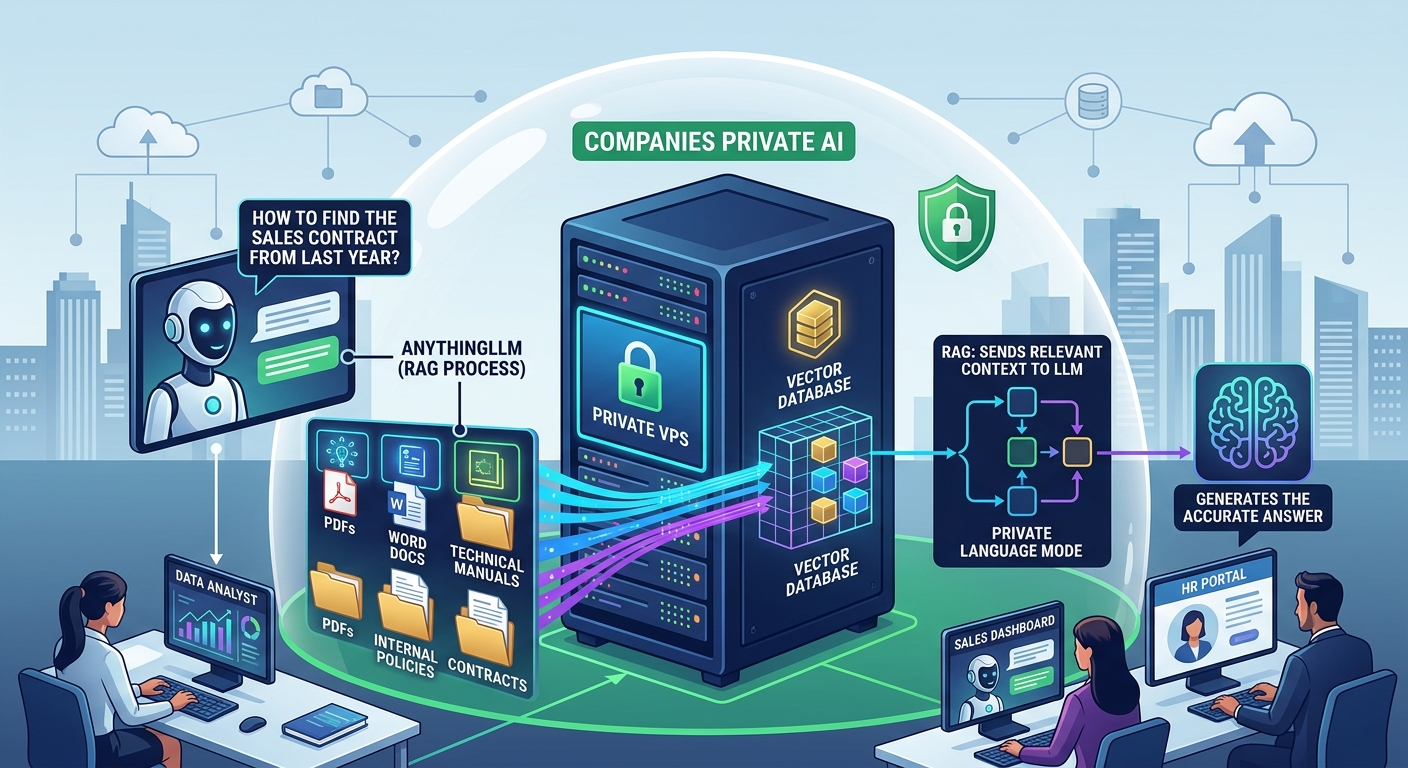
اگر شرکت شما انبوهی از فایلهای PDF، قرارداد، مستندات فنی، آییننامه داخلی و فایلهای Word دارد، پیدا کردن یک بند مشخص از میان این اسناد میتواند وقت زیادی بگیرد. راهحل مدرن این مشکل، راهاندازی یک دستیار هوش مصنوعی خصوصی روی سرور مجازی است که به محتوای اسناد شما پاسخ میدهد.
با استفاده از AnythingLLM میتوانید اسناد سازمانی را روی سرور قرار دهید و با فناوری RAG از هوش مصنوعی درباره محتوای آنها سؤال بپرسید. بهجای باز کردن چندین PDF، کارمند شما فقط میپرسد: «شرایط فسخ قرارداد در اسناد شرکت چیست؟» و پاسخ را مستقیماً دریافت میکند.
AnythingLLM چیست و چه کاری انجام میدهد؟
AnythingLLM یک پلتفرم متنباز برای ساخت محیطهای خصوصی هوش مصنوعی است که اسناد، مدلهای زبانی، Embedding و پایگاههای داده برداری را در یک محیط واحد یکپارچه میکند. این نرمافزار را میتوان روی سرور مجازی یا سیستم شخصی اجرا کرد و برای هر موضوع، یک Workspace جداگانه ساخت.
هر Workspace مجموعه اسناد و زمینه اطلاعاتی مخصوص خودش را دارد. AnythingLLM نقش یک لایه مدیریتی بین شما، اسناد و مدل هوش مصنوعی ایفا میکند.
User
  │
  ▼
AnythingLLM
  │
  ▼
Workspace
  │
  ▼
RAG (Retrieval-Augmented Generation)
  │
  ▼
Document Knowledge Search
  │
  ▼
Language Model
  │
  ▼
Response to User
چرا Self-Hosting روی سرور مجازی برای اسناد شرکت منطقیتر است؟
وقتی اسناد شرکت حاوی اطلاعات محرمانه هستند، استفاده از سرویسهای عمومی هوش مصنوعی همیشه گزینه مناسبی نیست. با Self-Hosting روی سرور مجازی ایران یا سرور اختصاصی خودتان، کنترل کامل روی زیرساخت و دادهها در دست شماست.
مزایای این روش:
🔹 کنترل کامل روی محل ذخیرهسازی اسناد و اطلاعات
🔹 امکان استفاده از دامنه اختصاصی با HTTPS
🔹 ساخت Workspaceهای مجزا برای هر بخش سازمان
🔹 اتصال به مدلهای ابری یا مدلهای محلی (Ollama)
🔹 پشتیبانگیری منظم از دانش سازمانی
🔹 مناسب برای تیمهای فنی، منابع انسانی، فروش و پشتیبانی
RAG چیست و چرا برای اسناد سازمانی حیاتی است؟
RAG یا Retrieval-Augmented Generation روشی است که در آن مدل هوش مصنوعی مجبور نیست تمام اطلاعات شرکت را از قبل در حافظه داشته باشد. زمانی که کاربر سؤال میپرسد، سیستم ابتدا مرتبطترین بخشهای اسناد را پیدا میکند و سپس آن اطلاعات را در اختیار مدل قرار میدهد.
مثلاً اگر ۵۰۰ فایل PDF داشته باشید و بپرسید «شرایط فسخ قرارداد مشتریان چیست؟»، سیستم مراحل زیر را طی میکند:
User Question
      │
      ▼
Semantic Search
      │
      ▼
Find Relevant Document Sections
      │
      ▼
Send Context to LLM
      │
      ▼
Generate Answer Based on Your Documents
در نتیجه مدل بهجای پاسخ صرفاً بر اساس دانش عمومی، از اطلاعات موجود در اسناد شما استفاده میکند.
مشخصات سرور مجازی مورد نیاز برای AnythingLLM
مستندات رسمی AnythingLLM حداقل ۲ گیگابایت RAM، یک پردازنده دو هستهای و ۵ گیگابایت فضای ذخیرهسازی را برای اجرای خود سرویس ذکر میکند [citation:4][citation:16]. اما برای استفاده واقعی سازمانی، منابع بیشتری نیاز دارید.
⚠️ نکته مهم: پردازنده شما باید از دستور AVX2 پشتیبانی کند، در غیر این صورت LanceDB (دیتابیس برداری پیشفرض) بارگذاری نمیشود و Container بلافاصله با خطای Illegal instruction متوقف میشود [citation:5]. در سرورهای مجازی، حتماً از داخل ماشین مجازی این قابلیت را بررسی کنید.
اگر مدل هوش مصنوعی را روی سرویس ابری اجرا کنید، سرور مجازی فقط AnythingLLM و پردازش RAG را اجرا میکند. اما اجرای مدلهایی مثل Llama بهصورت محلی، منابع سختافزاری بسیار بیشتری میطلبد.
⚠️ هشدار مهم: قبل از خرید سرور مجازی، مطمئن شوید که پردازنده سرور از AVX2 پشتیبانی میکند. در غیر این صورت باید VECTOR_DB را در فایل .env به گزینهای غیر از LanceDB تغییر دهید [citation:4].
مرحله اول تا سوم: آمادهسازی سرور و نصب Docker
با SSH به سرور متصل شوید:
ssh root@SERVER_IP
سیستم را بهروزرسانی کنید و ابزارهای پایه را نصب کنید:
apt update && apt upgrade -y
apt install curl wget ca-certificates gnupg -y
اگر Docker نصب نیست، از مخزن رسمی Docker نصب کنید. پس از نصب بررسی کنید:
systemctl status docker
docker --version
باید وضعیت active (running) را مشاهده کنید.
مرحله چهارم: ساخت مسیر ذخیرهسازی دائمی
نکته حیاتی در Self-Hosting این است که اطلاعات برنامه را خارج از چرخه حذف و ساخت مجدد Container نگه دارید. یک مسیر دائمی بسازید:
mkdir -p /opt/anythingllm
cd /opt/anythingllm
touch .env
chown -R 1000:1000 /opt/anythingllm
⚠️ دستور chown بسیار مهم است. Container AnythingLLM با کاربر UID 1000 اجرا میشود و اگر مسیر ذخیرهسازی متعلق به root باشد، با خطای unable to open database file مواجه میشوید [citation:5].
دستیار هوش مصنوعی خصوصی شرکت شما، فقط یک سرور مجازی با منابع پایدار میخواهد
AnythingLLM را روی سرور مجازی ایرانیکاسرور نصب کنید و اسناد سازمان را بدون نگرانی از محدودیت منابع، پردازش کنید. منابع اختصاصی CPU و RAM، دیسک NVMe برای سرعت Embedding، و پشتیبانی واقعی ۲۴/۷ در کنار شماست.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
مرحله پنجم: اجرای AnythingLLM با Docker
Image رسمی را دریافت کنید و Container را با Volume دائمی اجرا کنید:
docker pull mintplexlabs/anythingllm:latest

export STORAGE_LOCATION="/opt/anythingllm" && \
mkdir -p $STORAGE_LOCATION && \
touch "$STORAGE_LOCATION/.env" && \
docker run -d \
  --name anythingllm \
  --restart always \
  -p 3001:3001 \
  --cap-add SYS_ADMIN \
  -v ${STORAGE_LOCATION}:/app/server/storage \
  -v ${STORAGE_LOCATION}/.env:/app/server/.env \
  -e STORAGE_DIR="/app/server/storage" \
  mintplexlabs/anythingllm:latest
دستور cap-add SYS_ADMIN برای قابلیت Scraping وبسایتها توسط PuppeteerJS ضروری است [citation:1].
مرحله ششم و هفتم: بررسی وضعیت و ورود به برنامه
docker ps
docker logs anythingllm
docker logs -f anythingllm
در حالت تست، از مرورگر وارد شوید:
http://SERVER_IP:3001
مرحله هشتم تا دهم: دامنه، Nginx و HTTPS
برای استفاده سازمانی، AnythingLLM را مستقیماً با IP و پورت خام در اینترنت قرار ندهید. ساختار پیشنهادی:
Internet
   │
   ▼
HTTPS (443)
   │
   ▼
Nginx / Reverse Proxy
   │
   ▼
AnythingLLM (127.0.0.1:3001)
   │
   ▼
Docker Container
Nginx را نصب کنید و فایل تنظیمات ایجاد کنید:
apt install nginx -y
nano /etc/nginx/sites-available/anythingllm
محتوا:
server {
    listen 80;
    server_name ai.example.com;

    location / {
        proxy_pass http://127.0.0.1:3001;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
    }
}
تنظیمات را فعال و بررسی کنید:
ln -s /etc/nginx/sites-available/anythingllm /etc/nginx/sites-enabled/
nginx -t
systemctl reload nginx
برای HTTPS از Certbot استفاده کنید:
apt install certbot python3-certbot-nginx -y
certbot --nginx -d ai.example.com
اکنون از طریق https://ai.example.com وارد شوید.
مرحله یازدهم: انتخاب مدل زبانی (LLM)
دو معماری اصلی دارید:
روش اول: استفاده از API مدلهای ابری
VPS → AnythingLLM → API Provider → LLM. مناسب برای سرورهایی که GPU ندارند [citation:16]. کافی است API Key از سرویسی مثل OpenAI دریافت کنید.
روش دوم: اجرای مدل محلی با Ollama
User → AnythingLLM → Ollama → Local LLM. در این حالت وابستگی به API خارجی ندارید، اما اجرای LLM محلی به RAM، CPU و بهویژه GPU زیادی نیاز دارد.
⚠️ اگر Ollama روی همان سرور اجرا شود، آدرس آن در AnythingLLM باید http://172.17.0.1:11434 باشد (آدرس Host از داخل Docker). استفاده از 127.0.0.1 داخل Container به خود Container اشاره میکند، نه سرور میزبان [citation:12].
مرحله دوازدهم و سیزدهم: Embedding و Vector Database
Embedding متن را به نمایش عددی تبدیل میکند تا سیستم بتواند شباهت معنایی بین سؤال و بخشهای اسناد را پیدا کند. مثلاً «قوانین مرخصی» و «کارمندان سالانه ۳۰ روز مرخصی دارند» از نظر کلمات یکسان نیستند، اما Embedding ارتباط معنایی آنها را کشف میکند.
ساختار پردازش اسناد:
PDF / Word / TXT
       │
       ▼
Text Extraction
       │
       ▼
Chunking
       │
       ▼
Embedding
       │
       ▼
Vector Database (LanceDB)
AnythingLLM در حالت Docker بهطور پیشفرض از LanceDB بهعنوان Vector Database داخلی استفاده میکند که برای شروع کاملاً کافی است [citation:4].
مرحله چهاردهم تا شانزدهم: ساخت Workspace، آپلود اسناد و پرسش
پس از ورود به AnythingLLM، یک Workspace جدید بسازید. مثلاً «پشتیبانی شرکت» یا «قوانین منابع انسانی». Workspace را مانند یک محیط مستقل برای یک موضوع یا مجموعه اسناد در نظر بگیرید.
برای یک سازمان میتوانید Workspaceهای زیر را بسازید:
🔹 منابع انسانی — قوانین استخدام، مرخصی، آییننامه
🔹 فروش — قیمتها، شرایط فروش، قراردادها
🔹 فنی — مستندات، Troubleshooting، Network Guide
🔹 قراردادها — اسناد حقوقی و تعهدات
🔹 پشتیبانی — FAQ، راهنمای حل مشکل
🔹 مالی — گزارشها، سیاستهای مالی
اسناد خود را آپلود کنید. پس از پردازش، سؤالات زیر را امتحان کنید:
طبق آییننامه شرکت، تعداد روزهای مرخصی کارکنان چقدر است؟ شرایط بازگشت کالا طبق مستندات شرکت چیست؟ در قرارداد مشتریان، بند مربوط به فسخ قرارداد کدام است؟
آیا AnythingLLM خودش یک مدل هوش مصنوعی است؟
این نکته بسیار مهم است: AnythingLLM را نباید بهعنوان یک LLM مستقل در نظر گرفت. AnythingLLM یک پلتفرم مدیریتی برای LLM، Embedding، Vector Database و اسناد است [citation:16].
AnythingLLM
     │
     ├── LLM Provider (Cloud API or Ollama)
     │
     ├── Embedding Model
     │
     ├── Vector Database (LanceDB)
     │
     └── Documents (PDF, Word, TXT)
بنابراین باید برای تولید پاسخ و Embedding، Provider مناسب انتخاب کنید. این میتواند یک API ابری یا یک مدل محلی باشد [citation:16].
آیا اسناد فارسی پشتیبانی میشود؟
بله، اما کیفیت نهایی به عوامل زیر بستگی دارد:
🔹 مدل زبانی (توانایی درک فارسی)
🔹 مدل Embedding (پشتیبانی چندزبانه)
🔹 کیفیت استخراج متن از PDF
🔹 فونت و Encoding فایل
🔹 اسکن بودن یا نبودن PDF
🔹 کیفیت OCR (برای فایلهای اسکنشده)
⚠️ مشکل PDFهای اسکنشده: اگر PDF شما فقط عکس صفحه است و متن واقعی ندارد، جستوجوی عادی کار نمیکند. باید ابتدا با OCR متن را استخراج کنید:
Scanned PDF
     │
     ▼
OCR (Tesseract or similar)
     │
     ▼
Extracted Text
     │
     ▼
Chunking → Embedding → RAG
تنظیم Prompt برای دستیار سازمانی
یکی از کارهای مفید، تعریف دستورالعمل مشخص برای دستیار است. در تنظیمات Workspace، Prompt سفارشی زیر را وارد کنید:
You are an internal company assistant.

Answer questions ONLY based on the provided document context.

If the answer is not found in the documents, explicitly state:
"I could not find sufficient information in the company documents."

Do not fabricate information. Always cite the source document name when possible.
این دستورالعمل رفتار دستیار را برای کاربرد سازمانی قابلکنترلتر میکند.
⚠️ هشدار مهم: RAG تضمین نمیکند که مدل همیشه پاسخ صحیح بدهد. ممکن است سند نامرتبط پیدا کند یا بخش اشتباه را انتخاب کند. برای اطلاعات حساس شرکت، پاسخهای هوش مصنوعی باید با بررسی انسانی تأیید شوند.
مدیریت دسترسی کاربران در محیط سازمانی
اگر AnythingLLM برای چند کارمند استفاده میشود، نباید فرض کنید همه به تمام اسناد دسترسی داشته باشند. ساختار دسترسی پیشنهادی:
HR Manager         → HR Documents Workspace
Sales Expert       → Sales Documents Workspace
Technical Support  → Technical Documents Workspace
Finance Team       → Financial Documents Workspace
قبل از قرار دادن اطلاعات حساس، مدل دسترسی و Permissionها را بهدقت بررسی و آزمایش کنید.
امنیت AnythingLLM روی سرور مجازی
قرار دادن یک سرویس AI روی اینترنت بدون توجه به امنیت خطرناک است. نکات کلیدی:
🔹 HTTPS اجباری: بهجای http از https استفاده کنید (Certbot)
🔹 رمز عبور قوی: از 123456 و admin پرهیز کنید
🔹 پورت 3001 را عمومی نکنید: فقط از طریق Nginx دسترسی بدهید
🔹 Backup منظم: از پوشه /opt/anythingllm نسخه پشتیبان تهیه کنید
🔹 بهروزرسانی منظم: قبل از Update در Production، Backup بگیرید
🔹 غیرفعال کردن Telemetry: از تنظیمات Privacy این گزینه را بررسی کنید
حل مشکلات رایج AnythingLLM
چه فایلهایی برای Knowledge Base مناسب هستند؟
AnythingLLM برای انواع محتوای سازمانی قابل استفاده است:
شرکتها: قراردادها، آییننامهها، اسناد HR، راهنمای کارکنان، مستندات محصول
تیم فنی: Documentation، API Docs، Runbook، Troubleshooting، Configuration
فروش: Price List، Product Catalog، Sales Guide، FAQ، Contract
پشتیبانی: راهنمای حل مشکل، FAQ، Manual، Knowledge Base
آیا VPS بدون GPU کافی است؟
برای اجرای خود AnythingLLM، GPU الزاماً ضروری نیست [citation:16]. اما اگر قصد اجرای مدل زبانی بزرگ بهصورت Local دارید، موضوع کاملاً متفاوت است:
AnythingLLM + Cloud API  →  VPS with 2-4GB RAM is enough
AnythingLLM + Ollama    →  VPS with 16GB+ RAM and GPU preferred
بنابراین بین «اجرای AnythingLLM» و «اجرای مدل هوش مصنوعی روی همان سرور» تفاوت قائل شوید.
سرور مجازی مناسب برای AnythingLLM و اسناد سازمانی
برای اجرای پایدار AnythingLLM و پردازش سریع Embedding، به سروری با منابع اختصاصی و دیسک NVMe نیاز دارید. سرور مجازی ایران ایرانیکاسرور با آپتایم ۹۹.۹٪، پشتیبانگیری خودکار و پشتیبانی واقعی ۲۴/۷، بستر مناسبی برای دستیار هوش مصنوعی سازمانی شماست.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
مشکل کانفیگ یا خطا در AnythingLLM دارید؟
تیم فنی ایرانیکاسرور در کنار شماست. درخواست خود را از طریق صفحه کانفیگ و رفع مشکل ارسال کنید یا با پشتیبانی تماس بگیرید. راهاندازی AnythingLLM، تنظیم Nginx، اتصال به Ollama و هر مشکل دیگر را بررسی میکنیم.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
جمعبندی: دستیار هوش مصنوعی خصوصی برای سازمان شما
AnythingLLM یکی از بهترین گزینههای متنباز برای ساخت ChatGPT خصوصی روی سرور مجازی است.
در این آموزش Docker را نصب کردیم، AnythingLLM را روی VPS اجرا کردیم، Storage دائمی در نظر گرفتیم و درباره دامنه، HTTPS، مدل زبانی، Embedding، Vector Database و RAG صحبت کردیم.
اگر منابع سرور و مدل مناسب انتخاب شوند، میتوان از همین معماری برای ساخت دستیار هوش مصنوعی خصوصی برای شرکت، تیم فنی، پشتیبانی، فروش و مدیریت اسناد استفاده کرد.
⚠️ نکات نهایی قبل از انتقال اسناد محرمانه:
🔹 Backup منظم از پوشه /opt/anythingllm تهیه کنید
🔹 HTTPS را حتماً فعال کنید
🔹 احراز هویت و سطح دسترسی کاربران را دقیق تنظیم کنید
🔹 اگر از API ابری استفاده میکنید، مسیر انتقال داده به Provider را بررسی کنید
🔹 برای اطلاعات حساس، حتماً مدل و Embedding محلی را در نظر بگیرید







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.