
 Amir Jabbari
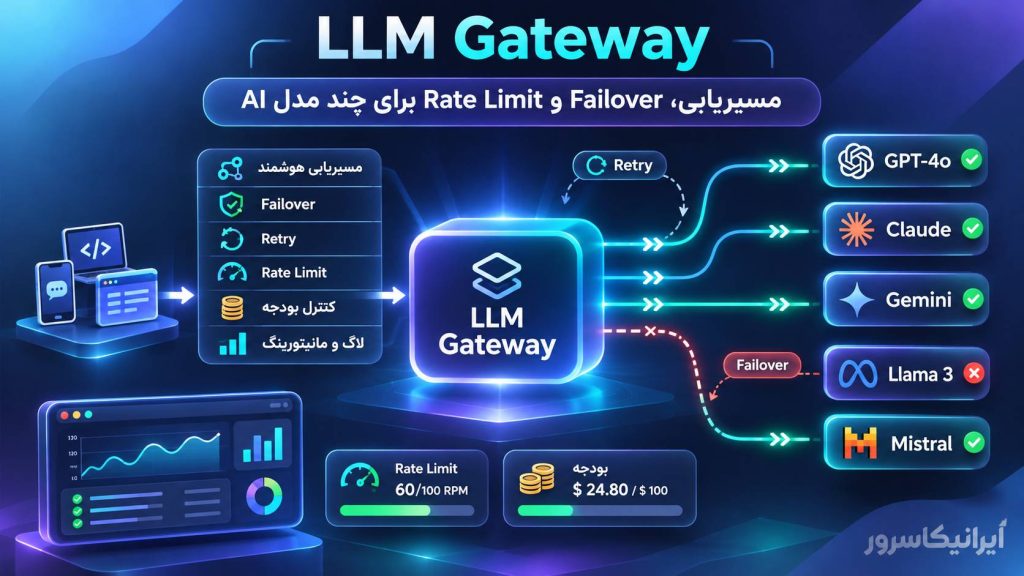
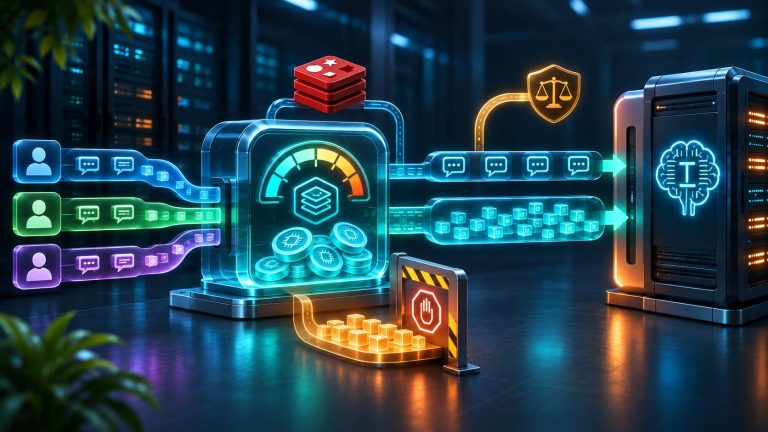
اگر برنامه شما همزمان از چند مدل هوش مصنوعی استفاده میکند، احتمالاً با یک مشکل آشنا روبهرو شدهاید: هر سرویس API، کلید، محدودیت درخواست، قیمت و پیام خطای خودش را دارد. حالا فرض کنید یکی از مدلها به خطای 429 برسد یا موقتاً از دسترس خارج شود. آیا باید تمام برنامه را تغییر دهید؟ LLM Gateway یا «درگاه مشترک مدلهای زبانی» برای حل همین مسئله ساخته شده است: یک آدرس API در اختیار برنامه میگذارد و در پشت صحنه درخواستها را به مدل مناسب میفرستد، در صورت خطا مسیر جایگزین انتخاب میکند و مصرف را زیر نظر میگیرد.
در این راهنما ابتدا مفهوم Gateway را با یک مثال ساده یاد میگیریم، سپس LiteLLM، Portkey، Cloudflare AI Gateway و Kong AI Gateway را مقایسه میکنیم. در بخش عملی نیز با LiteLLM یک درگاه چندمدلی میسازیم و مدیریت Routing، Fallback، Retry، Rate Limit، Budget و Logging را مرحلهبهمرحله بررسی میکنیم. این آموزش برای توسعهدهندگان، تیمهای SaaS و مدیران سروری نوشته شده که میخواهند کنترل ارتباط با سرویسهای AI را از کد اپلیکیشن جدا کنند.
LLM Gateway چیست و چه مشکلی را حل میکند؟
LLM مخفف Large Language Model یا مدل زبانی بزرگ است. Gateway یک سرویس واسط است که بین اپلیکیشن شما و ارائهدهندگان مدل قرار میگیرد. بهجای اینکه فرانتاند یا بکاند مستقیماً برای هر ارائهدهنده کد جداگانه داشته باشد، فقط به Gateway درخواست میفرستد.
- بدون Gateway: اپلیکیشن باید اتصال، کلیدها، محدودیتها و خطاهای هر ارائهدهنده را جداگانه مدیریت کند.
- با Gateway: اپلیکیشن به یک API ثابت متصل میشود و مسیر واقعی درخواست در تنظیمات مرکزی تعیین میشود.
برای مثال، یک فروشگاه اینترنتی میتواند نام منطقی support-ai را صدا بزند. Gateway ابتدا مدل اصلی را امتحان میکند و اگر آن مدل با خطای قابلبازیابی مواجه شود، درخواست را به مدل پشتیبان میفرستد. البته Fallback تضمین نمیکند که پاسخ دو مدل از نظر کیفیت، ساختار JSON یا رفتار ابزارها یکسان باشد. این تفاوت باید در تستهای اپلیکیشن لحاظ شود.
معماری یک درگاه چندمدلی چگونه است؟
Web App / Backend / AI Agent
              |
        Virtual API Key
              |
      LLM Gateway (HTTPS)
      /       |        \
  Auth     Routing    Limits / Budget
              |
       Primary model
              |
      Retry / Fallback
              |
       Backup model
              |
      Metrics / Logs / Traces
در این معماری «کلید مجازی» با کلید واقعی ارائهدهنده فرق دارد. کلید واقعی OpenAI یا Anthropic فقط روی سرور Gateway نگهداری میشود؛ اپلیکیشن کلید مجازی و محدودشده دریافت میکند. اگر چند کاربر یا چند پروژه دارید، میتوانید مصرف هرکدام را جداگانه ببینید و محدود کنید.
مقایسه LiteLLM با جایگزینهای امروزی
انتخاب ابزار فقط به تعداد مدلهای پشتیبانیشده مربوط نیست؛ محل استقرار، کنترل داده، تجربه عملیاتی و سیاستهای بودجه هم مهماند. جدول زیر یک مقایسه کاربردی است، نه ادعای یکسان بودن همه قابلیتها در تمام پلنها و نسخهها.
| ابزار | نقطه قوت | مدل استقرار/نکته مهم | مناسب برای |
|---|---|---|---|
| LiteLLM | API سازگار با OpenAI، مسیریابی و Fallback، کلید مجازی، بودجه و لاگ | خودمیزبان؛ برای بودجه و کلید مجازی به PostgreSQL نیاز دارد | تیمهایی که کنترل زیرساخت میخواهند |
| Portkey | Routing شرطی، Retry، Fallback، Load Balancing و مشاهدهپذیری | گزینههای استقرار و امکانات تجاری را باید با نسخه/پلن بررسی کرد | تیمهای محصول با نیاز به مدیریت متمرکز |
| Cloudflare AI Gateway | Alias، Dynamic Routing، Rate Limit، Budget و گزارش مصرف | مدیریتشده در اکوسیستم Cloudflare؛ سیاست نگهداری داده را بررسی کنید | تیمهایی که راهاندازی سریع و Edge میخواهند |
| Kong AI Gateway | ادغام با مدیریت API، سیاستهای سازمانی و مسیریابی پیشرفته | بسته به محصول/نسخه، پیکربندی و مجوز متفاوت است | سازمانهایی که از قبل Kong دارند |
در مستندات جدید Cloudflare، «Dynamic Routing» حتی گرههای شرطی، تقسیم درصدی، کنترل بودجه و مسیر پشتیبان را پشتیبانی میکند؛ بنابراین نمیتوان آن را صرفاً یک پراکسی ساده دانست. از سوی دیگر، Kong برای سناریوهای سازمانی گزینههایی مانند مسیریابی مبتنی بر تأخیر یا اولویت دارد. اگر هدف شما استقرار روی VPS و تنظیم مستقیم YAML است، LiteLLM نقطه شروع قابلفهمی است.
منابع رسمی:
LiteLLM،
Portkey،
Cloudflare و
Kong.
پیشنیازهای راهاندازی روی سرور مجازی
برای انجام آزمایش به یک سرور لینوکسی مجهز به Docker و Docker Compose، دسترسی SSH، دستکم یک کلید معتبر API از ارائهدهنده مدل و دسترسی خروجی HTTPS نیاز دارید. SSH روش اتصال امن به خط فرمان سرور است و Docker برنامه را در محیطی جداگانه به نام کانتینر اجرا میکند. مشخصات CPU و RAM به حجم درخواستها بستگی دارد؛ برای شروع، منابع سبک کافی است اما برای سرویس پرترافیک باید پس از تست بار ظرفیتسنجی کنید.
در این سناریو مدلها روی VPS اجرا نمیشوند؛ فقط Gateway روی سرور اجرا میشود و درخواستها را به API ارائهدهندگان میفرستد. بنابراین خرید GPU برای همین معماری ضروری نیست. اگر قصد اجرای مدل محلی با vLLM یا Ollama را دارید، ظرفیت حافظه و در صورت نیاز GPU موضوع جداگانهای است.
هشدار امنیتی: پورت مدیریتی 4000 را مستقیماً روی اینترنت باز نکنید. برای محیط واقعی از HTTPS و Reverse Proxy، محدودیت IP، مدیریت Secrets و کنترل دسترسی استفاده کنید. Reverse Proxy سرویسی مانند Nginx است که درخواستهای خارجی را میگیرد و با قواعد امنیتی به سرویس داخلی منتقل میکند.
مرحله اول: نصب LiteLLM همراه PostgreSQL
برای اینکه فقط یک نمونه نمایشی بدون کنترل بودجه نسازیم، راهاندازی رسمی Docker Compose را انتخاب میکنیم که PostgreSQL هم دارد. در خط فرمان سرور یک پوشه مخصوص ایجاد کنید:
mkdir -p ~/litellm-gateway
cd ~/litellm-gateway
فایل Compose رسمی را دریافت کنید. برای استفاده عملیاتی، محتوای فایل را پیش از اجرا بازبینی و نسخه تصویر کانتینر را به یک نسخه بررسیشده و مشخص محدود کنید؛ از اجرای بیبررسی اسکریپتهای اینترنتی یا تگ شناور latest در تولید پرهیز کنید.
curl -sSLO https://github.com/BerriAI/litellm/raw/main/docker/docker-compose.quickstart.yml

printf 'LITELLM_MASTER_KEY=sk-%s\nLITELLM_SALT_KEY=sk-%s\n' \
  "$(openssl rand -hex 32)" "$(openssl rand -hex 32)" > .env

chmod 600 .env

docker compose -f docker-compose.quickstart.yml config

# پس از بازبینی فایل، نسخه و تنظیمات شبکه:
docker compose -f docker-compose.quickstart.yml up -d
دو مقدار تصادفی تولیدشده را محرمانه نگه دارید. SALT KEY را بعداً بدون برنامه مهاجرت تغییر ندهید؛ چون رمزگشایی اعتبارنامههای ذخیرهشده ممکن است مختل شود. آدرس پنل مدیریت در محیط محلی معمولاً http://localhost:4000/ui است. برای دسترسی امن از بیرون، ابتدا HTTPS یا SSH Tunnel فراهم کنید.
راهنمای مرجع:
Quickstart رسمی LiteLLM.
اگر فایل Compose نسخه جدید ساختار متفاوتی داشت، تنظیمات همان نسخه را مبنا قرار دهید؛ بهویژه نام سرویسها، متغیرهای محیطی و اتصال دیتابیس را بهصورت حدسی تغییر ندهید.
مرحله دوم: تعریف چند مدل زیر یک API مشترک
در پنل مدیریت، ارائهدهندهها را اضافه کنید و کلید اصلی هرکدام را در تنظیمات محرمانه ذخیره کنید. سپس مدلها را ثبت کنید. برای درک منطق مسیریابی، نمونه زیر یک الگوی آموزشی YAML است. نامهای provider-model-primary و provider-model-backup نام واقعی مدل نیستند و باید با شناسه مدلهایی که حساب شما پشتیبانی میکند جایگزین شوند. این نمونه فقط پس از تنظیم ارائهدهندگان و اتصال آن به پیکربندی فعال LiteLLM قابل استفاده است.
model_list:
  - model_name: support-ai
    litellm_params:
      model: openai/provider-model-primary
      api_key: os.environ/OPENAI_API_KEY
      rpm: 60
      tpm: 60000

  - model_name: support-ai-backup
    litellm_params:
      model: anthropic/provider-model-backup
      api_key: os.environ/ANTHROPIC_API_KEY
      rpm: 30
      tpm: 30000

router_settings:
  routing_strategy: simple-shuffle
  fallbacks:
    - support-ai: [support-ai-backup]

litellm_settings:
  num_retries: 1
در این مثال درخواست به support-ai ارسال میشود. اگر مسیر اصلی خطای مشمول Fallback داشته باشد، Router میتواند گروه support-ai-backup را امتحان کند. این پیکربندی از متغیرهای محیطی برای کلیدها استفاده میکند؛ کلید واقعی را داخل فایل YAML یا مخزن Git ننویسید.
برای جزئیات نسخهای و تفاوت Retry با Fallback به
مستندات Routing و
Reliability / Fallbacks
مراجعه کنید.
نکته عملی: اگر چند استقرار از یک مدل دارید، میتوانید هرکدام را با model_name یکسان تعریف کنید تا درخواستها بین آنها توزیع شوند. جابهجایی بین استقرارهای همگروه با «تغییر به مدل پشتیبان از گروه دیگر» یکسان نیست.
Routing چیست و چه استراتژیهایی دارد؟
Routing یعنی تصمیمگیری درباره اینکه هر درخواست به کدام استقرار یا مدل برسد. چند روش رایج عبارتاند از:
- Weighted / Simple Shuffle: توزیع درخواست با توجه به وزن یا ظرفیت تعیینشده؛ گزینه پیشفرض توصیهشده LiteLLM برای کارایی.
- Rate-Limit-Aware: در تصمیمگیری، محدودیت یا مصرف RPM و TPM را لحاظ میکند؛ ممکن است نسبت به روش ساده سربار بیشتری داشته باشد.
- Latency-Based: انتخاب مسیر با توجه به سرعت پاسخگویی ثبتشده.
- Priority: اولویت دادن به یک استقرار و انتقال به لایه بعدی در صورت ناکامی.
- Conditional / Semantic Routing: انتخاب بر اساس ویژگی درخواست یا معنای آن؛ جزئیات به ابزار و نسخه وابسته است.
برای یک پروژه تازهکار معمولاً بهتر است از مسیر ساده با مدل اصلی و پشتیبان شروع کنید و تنها پس از جمعآوری داده واقعی، تصمیمگیری مبتنی بر تأخیر یا هزینه را فعال کنید. کمهزینهترین مدل لزوماً بهترین انتخاب برای همه درخواستها نیست؛ کیفیت خروجی و سازگاری با ابزارها را هم بسنجید.
تفاوت Failover، Fallback و Retry در چیست؟
این اصطلاحها نزدیکاند اما یکی نیستند. Retry تکرار یک تلاش شکستخورده است؛ معمولاً با تأخیر افزایشی. Failover انتقال ترافیک از یک مسیر خراب به مسیر سالم است. Fallback رفتن سراغ گزینه جایگزین تعریفشده، مثلاً یک مدل دیگر، است.
| وضعیت | رفتار پیشنهادی | احتیاط |
|---|---|---|
| خطای 429 از ارائهدهنده | احترام به Retry-After، Backoff و سپس مسیر سالم | تکرار بیرویه مشکل را تشدید میکند |
| خطای موقت 502/503/504 | Retry محدود و Fallback بعد از شکست | Timeout کل درخواست را محدود کنید |
| کلید نامعتبر 401 یا مجوز 403 | بررسی تنظیمات و کلید | تکرار همان کلید معمولاً کمکی نمیکند |
| درخواست نامعتبر 400 | اصلاح ورودی یا پارامترهای مدل | Fallback ممکن است فقط خطا را پنهان کند |
| پنجره متن مدل پر شده | کاهش ورودی یا مدل با Context بیشتر | صرفاً تکرار همان درخواست مشکل را رفع نمیکند |
برای عملیات دارای اثر جانبی، مانند اجرای ابزار و ثبت سفارش، به خطر تکرار عملیات توجه کنید. اگر پاسخ مدل در حین Streaming قطع شد، ارسال دوباره لزوماً ادامه همان پاسخ نیست و ممکن است هزینه یا خروجی تکراری بسازد. برای این سناریوها شناسه درخواست، طراحی Idempotency و سیاست روشن Retry ضروری است.
مرحله سوم: کنترل Rate Limit با RPM، TPM و همزمانی
RPM تعداد درخواست در دقیقه و TPM تعداد توکن در دقیقه است. توکن واحد تقریبی پردازش متن در مدل است و دقیقاً با تعداد کلمات برابر نیست. محدودیت Concurrency هم تعداد درخواستهای همزمان را کنترل میکند. مثال: 60 RPM به معنی «حداکثر 60 درخواست در هر ثانیه» نیست و 60 هزار TPM هم لزوماً اجازه تعداد نامحدود درخواست کوتاه نمیدهد.
در LiteLLM میتوان برای استقرار، کلید مجازی، کاربر، تیم و برخی سطوح دیگر محدودیت قرار داد. مقادیر rpm و tpm مثال YAML بالا صرفاً نمونهاند؛ باید آنها را با سهمیه واقعی ارائهدهنده و ظرفیت موردنظر هماهنگ کنید.
راهنمای رسمی Budgets و Rate Limits جزئیات این سطوح را توضیح میدهد.
نکته: محدودیت ظرفیت یک Deployment با محدودیت مجاز مصرف یک کاربر فرق دارد. اگر فقط سمت ارائهدهنده Rate Limit تعیین کنید، ممکن است یک کاربر پرمصرف سهم دیگران را اشغال کند. در محیط چندمشتری بهتر است برای هر مشتری یا تیم کلید مجازی مستقل صادر شود.
مرحله چهارم: تعیین سقف هزینه برای هر پروژه
اگر یک مشتری اشتباهی هزاران درخواست بفرستد، صرف محدودکردن سرعت ممکن است جلوی افزایش هزینه را نگیرد. بودجه سقف مصرف مالی را در یک بازه تعریف میکند؛ مثلاً 10 دلار در 30 روز برای محیط آزمایش. مبلغها در این مقاله صرفاً مثال آموزشی هستند، نه قیمت مدلها.
برای صدور کلید مجازی با بودجه و محدودیت، پس از راهاندازی PostgreSQL و ورود امن به پنل، میتوانید از قسمت Virtual Keys استفاده کنید یا با API مدیریتی درخواست بفرستید. مثال زیر از متغیرهای محیطی استفاده میکند:
export GATEWAY_URL="http://127.0.0.1:4000"

# مقدار ADMIN_KEY را از محل امن بارگذاری کنید.

curl -sS "$GATEWAY_URL/key/generate" \
  -H "Authorization: Bearer $ADMIN_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "models": ["support-ai"],
    "max_budget": 10,
    "budget_duration": "30d",
    "rpm_limit": 20,
    "tpm_limit": 20000
  }'
خروجی شامل کلید مجازی محرمانه است؛ آن را در لاگ عمومی یا اسکرینشات منتشر نکنید. اگر support-ai به مدل پشتیبان منتقل شود، لازم است کنترل بودجه مدل مقصد هم در نسخه نصبشده بررسی شود.
توجه کنید که بودجه در LiteLLM بدون دیتابیس متصل واقعاً اعمال نمیشود؛ اجرای Proxy بدون PostgreSQL برای آزمایش API قابل استفاده است، اما برای کنترل قابل اتکای هزینه کافی نیست. همچنین کنترل بودجه مبتنی بر محاسبه مصرف است و لزوماً به معنای تضمین حسابداری لحظهای در تمام شرایط همزمانی نیست.
برای اطلاعات بیشتر:
مستندات Virtual Keys.
مرحله پنجم: ارسال درخواست با یک آدرس ثابت
حالا میتوان از هر برنامهای که با API سازگار با OpenAI کار میکند به Gateway وصل شد. فرض میکنیم کلید مجازی از مرحله قبل ایجاد شده و نام منطقی مدل نیز ثبت شده است.
export VIRTUAL_KEY="sk-your-virtual-key"

curl -sS http://127.0.0.1:4000/v1/chat/completions \
  -H "Authorization: Bearer $VIRTUAL_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "support-ai",
    "messages": [
      {
        "role": "user",
        "content": "سلام، یک جمله درباره رایانش ابری بگو."
      }
    ]
  }'
در کد اپلیکیشن نیز بهجای آدرس ارائهدهنده اصلی، base_url را به دامنه HTTPS درگاه خود تغییر دهید. اگر مدل اصلی را عوض کنید، تا زمانی که نام منطقی و قرارداد خروجی ثابت بماند، نیازی به تغییر نام مدل در تمام بخشهای برنامه ندارید.
توجه: سازگاری OpenAI-compatible تضمین پشتیبانی یکسان تمام پارامترها، ابزارها، Streaming یا JSON Schema توسط مدلهای مختلف نیست.
مرحله ششم: Logging و Observability
وقتی Gateway را روی چند پروژه اجرا میکنید، فقط دانستن تعداد درخواستها کافی نیست. حداقل باید نرخ خطا، تأخیر پاسخ، مصرف توکن، هزینه تخمینی، مدل انتخابشده و تعداد فعالشدن Fallback را پایش کنید. Logging ثبت رخدادهاست؛ Observability توانایی فهم وضعیت سامانه از لاگها، متریکها و ردگیری درخواستها است.
- Metrics: نرخ موفقیت، خطاهای 429 و 5xx، زمان پاسخ P50/P95 و میزان مصرف هر تیم.
- Tracing: دنبالکردن یک درخواست از اپلیکیشن تا Gateway و مدل مقصد با یک شناسه.
- Cost tracking: تخمین و گزارش هزینه هر کلید، پروژه یا سرویس.
- Privacy: کاهش ثبت متن کامل Prompt و پاسخ، حذف اطلاعات حساس و تعیین دوره نگهداری.
LiteLLM امکان اتصال به Langfuse، OpenTelemetry و مقصدهای لاگ دیگر را دارد. نمونه تنظیم زیر صرفاً روش فعالسازی Callback موفق در یک پیکربندی است و برای کارکردن به کلیدها و سرویس Langfuse نیاز دارد:
litellm_settings:
  success_callback: ["langfuse"]

# متغیرهای محیطی لازم:
# LANGFUSE_PUBLIC_KEY
# LANGFUSE_SECRET_KEY
در صورت نیاز ثبت خطا و Tracing را هم مطابق نسخه و محیط تنظیم کنید. برای دادههای مشتریان، ضبط خام درخواست و پاسخ را بدون ارزیابی حریم خصوصی روشن نکنید.
مرجع:
Logging در LiteLLM.
چکلیست امنیت و استقرار واقعی
Gateway به کلیدهای API چند ارائهدهنده دسترسی دارد؛ بنابراین یک نقطه حساس زیرساخت است. در مارس ۲۰۲۶، پروژه LiteLLM درباره انتشار مخرب برخی نسخههای PyPI از جمله 1.82.7 و 1.82.8 اطلاعیه امنیتی منتشر کرد. پیش از نصب یا ارتقا، اطلاعیه رسمی حادثه و توصیههای مربوط به نسخهها و اعتبارنامهها را بخوانید. اگر قبلاً نسخه آسیبدیده را اجرا کردهاید، صرف ارتقای نرمافزار جای بررسی و تعویض کلیدهای در معرض خطر را نمیگیرد.
- نسخه کانتینر را Pin کنید، تصویر یا بسته را از منبع معتبر بگیرید و وابستگیها را پایش کنید.
- کلیدهای ارائهدهندگان را در Secrets نگهداری کنید؛ Master Key را به اپلیکیشنهای مشتری ندهید.
- پنل مدیریت را پشت HTTPS، احراز هویت مناسب و محدودیت دسترسی قرار دهید.
- برای هر تیم کلید مستقل، سقف مصرف و سطح دسترسی مدل تعریف کنید.
- از PostgreSQL نسخه پشتیبان بگیرید؛ کلیدهای لازم برای رمزگشایی را جدا و امن نگه دارید.
- برای بیش از یک نمونه Gateway، هماهنگی Rate Limit و Cache از طریق Redis را طبق راهنمای استقرار بررسی کنید.
- بهصورت دورهای قطعی ساختگی، 429، مصرف بیش از بودجه و بازیابی سرویس را تست کنید.
راهنمای
استقرار Production در LiteLLM
نقش PostgreSQL، Redis و چند Replica را مشخص میکند.
اشتباههای رایج هنگام ساخت Gateway
چرا با وجود Fallback باز هم درخواست خطا میدهد؟
ممکن است نوع خطا مشمول سیاست جایگزینی نباشد، گروه پشتیبان تعریف نشده باشد، کلید مدل دوم معتبر نباشد یا هر دو مسیر به محدودیت رسیده باشند. ابتدا لاگ درخواست و نوع خطا را بررسی کنید و سپس سیاست را تغییر دهید؛ Retry نامحدود راهحل نیست.
چرا Budget تنظیم کردهام ولی هزینه همچنان افزایش مییابد؟
ابتدا اتصال PostgreSQL، انتساب کلید مجازی، محدوده بودجه و گزارش مصرف را کنترل کنید. اگر Proxy را بدون دیتابیس اجرا کردهاید، تنظیم سقف بهتنهایی مانع مصرف نخواهد شد. محدودیت مالی سمت ارائهدهنده را نیز بهعنوان لایه حفاظتی دوم فعال کنید.
چرا پاسخ دو مدل پشتیبان یکسان نیست؟
مدلها در نحوه تبعیت از دستور، ساختار خروجی، فراخوانی ابزار، پنجره زمینه و سیاست محتوا تفاوت دارند. برای کارهای حساس، روی هر مدل مجموعه تست خروجی و اعتبارسنجی ساختار داشته باشید.
چه زمانی باید Gateway را خودمان بسازیم؟
اگر فقط یک مدل و چند درخواست کمحجم دارید، شاید یک لایه ساده در بکاند کافی باشد. زمانی Gateway مستقل ارزش پیدا میکند که چند تیم، چند مدل، بودجه مشترک، Fallback و پایش مرکزی دارید. ساخت درگاه از صفر معمولاً به معنای نگهداری دائمی کنترل دسترسی، شمارندهها و منطق خطاست.
در نهایت کدام LLM Gateway را انتخاب کنیم؟
برای راهاندازی روی سرور مجازی خودتان و کنترل کامل تنظیمات، LiteLLM همراه PostgreSQL و در صورت توسعه چندنمونهای Redis انتخاب مناسبی برای شروع ارزیابی است. اگر نمیخواهید زیرساخت نگهداری کنید و در اکوسیستم Cloudflare هستید، AI Gateway آن را ارزیابی کنید. اگر تجربه توسعهدهنده و مشاهدهپذیری آماده اولویت دارد، Portkey را بررسی کنید؛ برای سازمانی که از قبل مدیریت API را با Kong انجام میدهد، یکپارچگی Kong میتواند مهمتر از سادگی شروع باشد.
پیشنهاد اجرایی این است که ابتدا فقط دو مدل و یک مسیر جایگزین تعریف کنید، بعد با خطای ساختگی Failover را بسنجید، سپس Rate Limit و Budget هر پروژه را فعال و در پایان لاگها و هشدارها را اضافه کنید. معیار موفقیت، صرفاً پاسخدادن یک درخواست نیست؛ باید بدانید در زمان قطعی، ازدحام و افزایش هزینه چه اتفاقی میافتد.
پرسشهای متداول درباره LLM Gateway
آیا LLM Gateway سرعت مدل را افزایش میدهد؟
خود Gateway لزوماً مدل را سریعتر نمیکند و حتی کمی سربار شبکه دارد؛ اما با انتخاب مسیر مناسب، Cache در صورت پشتیبانی و جلوگیری از درخواست به مسیر خراب میتواند تجربه پاسخگویی را بهبود دهد.
آیا برای استفاده از LiteLLM به GPU نیاز داریم؟
اگر فقط درخواستها را به API مدلهای ابری میفرستید، خیر. GPU زمانی مطرح میشود که مدل را روی سرور خودتان اجرا کنید.
آیا LiteLLM بدون PostgreSQL کار میکند؟
بله، حالت ساده Proxy با فایل پیکربندی ممکن است؛ ولی کلیدهای مجازی و کنترل هزینه مبتنی بر دیتابیس در آن حالت در دسترس و قابل اتکا نیستند.
آیا Fallback هزینه را کم میکند؟
نه الزاماً؛ مدل پشتیبان ممکن است گرانتر باشد و Retry هم مصرف اضافه ایجاد کند. باید بودجه و سقف تعداد تلاشها را جدا تنظیم کنید.
آیا میتوان یک API را به OpenAI و Anthropic وصل کرد؟
بله، درگاهی مثل LiteLLM درخواست را از یک رابط مشترک میگیرد و به سرویس مقصد تبدیل میکند؛ اما سازگاری امکانات و ساختار پاسخ مدلها را باید در برنامه تست کنید.
دیدگاهها (۰)