
 Amir Jabbari
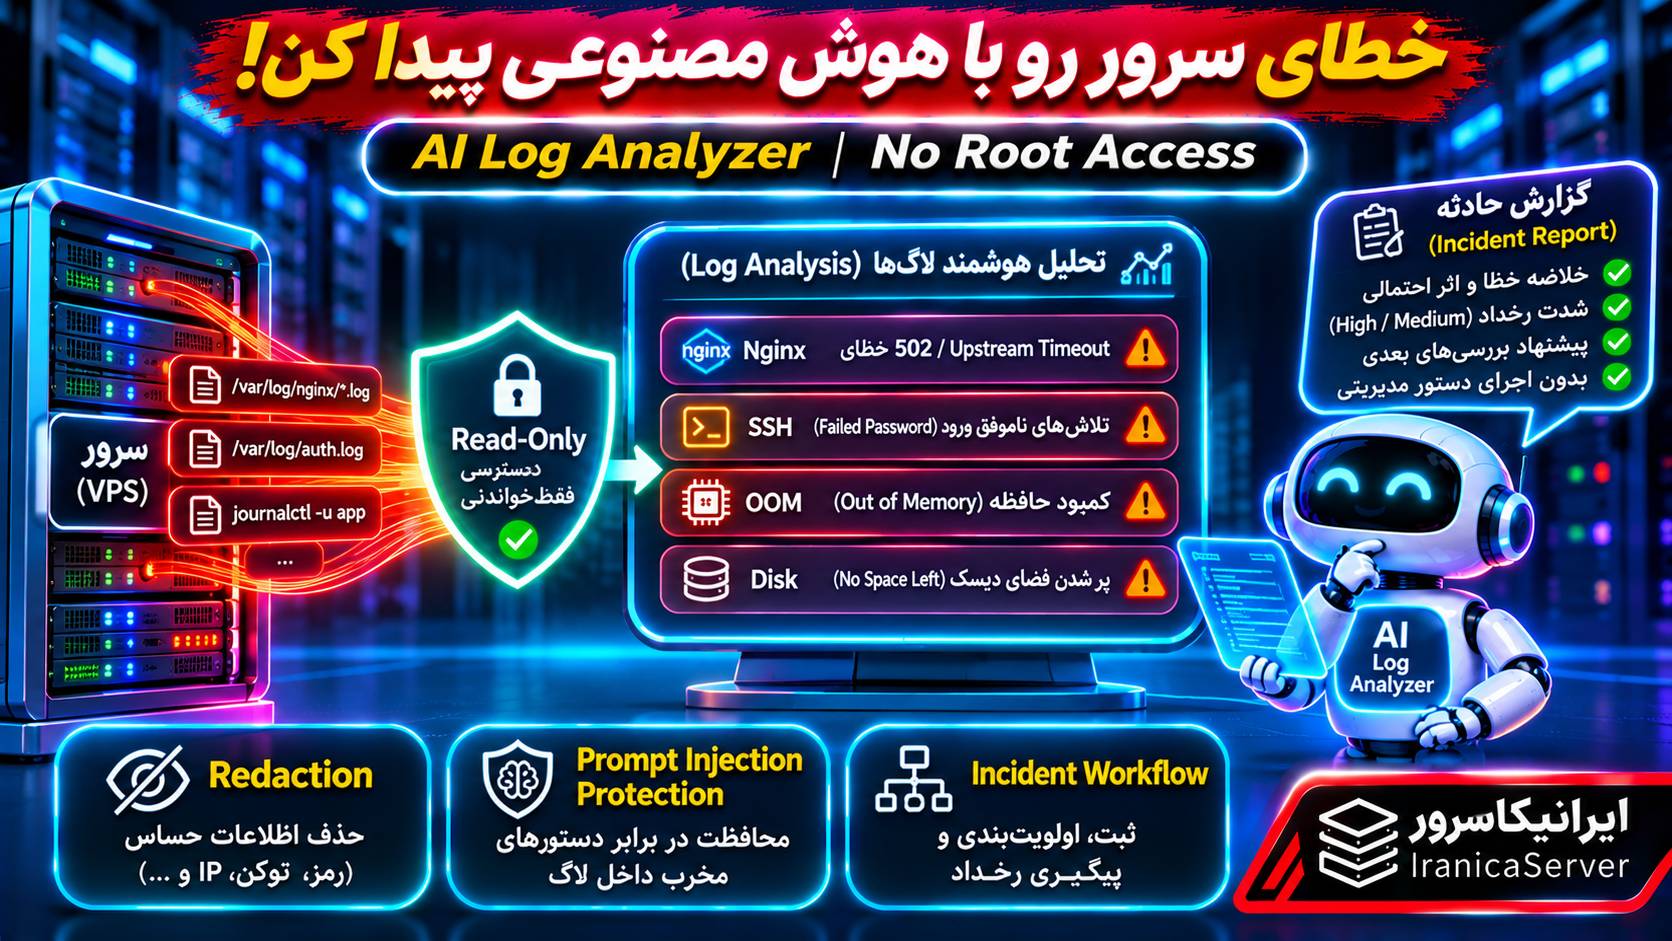
پاسخ مثبت است. برای تحلیل لاگ، Agent الزاماً نیازی به اجرای فرمانهای مدیریتی ندارد. میتوان یک برنامه مستقل ساخت که فقط لاگ سرویسهای مشخص را بخواند، اطلاعات حساس را پیش از پردازش حذف کند و سپس نشانههای خطا را برای تحلیل و تهیه گزارش در اختیار هوش مصنوعی قرار دهد.
این روش مبنای طراحی AI Log Analyzer Server است؛ سیستمی که به جای دادن اختیار کامل سرور به مدل، از یک Collector فقطخواندنی، پردازش کنترلشده اطلاعات و گردش کار مدیریت حادثه استفاده میکند.
البته یک خطر مهم وجود دارد: لاگها همیشه داده قابل اعتماد نیستند. مهاجم ممکن است متن دلخواه خود را از طریق URL، User-Agent یا ورودیهای یک نرمافزار وارد لاگ کند. اگر این متن مستقیماً در اختیار یک Agent دارای دسترسی مدیریتی قرار گیرد، احتمال Prompt Injection و سوءاستفاده از ابزارهای Agent افزایش پیدا میکند.
در این مقاله آموزش میدهیم چگونه با Python و SQLite یک تحلیلگر لاگ برای VPS بسازیم که بدون Root کار کند، فقط فایلهای مجاز را بخواند، اطلاعات محرمانه را Redact کند، الگوهایی مانند خطای احراز هویت، قطعی سرویس، پر شدن دیسک و مشکل Upstream را شناسایی کند و نتیجه را در قالب Incident Report ذخیره کند.
سپس معماری اتصال اختیاری به مدل هوش مصنوعی، مدیریت Permissionها در Ubuntu، خواندن امن Journal، محافظت در برابر Prompt Injection داخل لاگ، طراحی Incident Workflow و تستهای عملی امنیت را بررسی میکنیم.
هدف این آموزش، تشخیص و گزارش مشکلات است؛ نه دادن دسترسی خودکار به Agent برای Restart سرویس، تغییر Firewall یا حذف فایلهای سیستم.
AI Log Analyzer Server چیست و چگونه کار میکند؟
AI Log Analyzer سیستمی است که دادههای لاگ را از منابع مشخص دریافت میکند، آنها را پردازش و دستهبندی میکند و با استفاده از قواعد نرمافزاری یا مدل هوش مصنوعی، مشکلات احتمالی را برای مدیر سرور توضیح میدهد.
برای مثال، اگر لاگ وبسرور شامل تعداد زیادی خطای Upstream Timeout باشد، Analyzer میتواند این وضعیت را شناسایی کند و پیشنهاد دهد ارتباط وبسرور با سرویس Backend، زمان پاسخ برنامه و وضعیت منابع بررسی شوند.
اما وجود یک خطای مشخص بهتنهایی همیشه علت نهایی مشکل را اثبات نمیکند. یک Upstream Timeout میتواند دلایل مختلفی داشته باشد و نیازمند بررسی شواهد دیگر باشد.
تفاوت Log Parser و AI Log Analyzer
Log Parser معمولاً از قواعد مشخص برای استخراج اطلاعات استفاده میکند. AI Log Analyzer میتواند علاوه بر این دادهها، ارتباط میان چند رخداد را تحلیل کند، احتمالهای مختلف را توضیح دهد و گزارش قابل فهمتری تهیه کند.
بااینحال مدل زبانی نباید جایگزین شواهد فنی شود. بهتر است دادههای قابل اندازهگیری مانند تعداد خطا، زمان و نام سرویس ابتدا توسط برنامه استخراج شوند.
آیا برای تحلیل لاگ همیشه LLM لازم است؟
خیر. شناسایی الگوهایی مانند No space left on device یا Failed password را میتوان با قواعد ساده انجام داد.
مدل هوش مصنوعی بیشتر برای توضیح رابطه رخدادها، خلاصهسازی یافتهها و پیشنهاد بررسیهای بعدی مفید است.
به همین دلیل در پروژه عملی ابتدا یک هسته تحلیل بدون LLM میسازیم و اتصال به مدل را بهعنوان لایه اختیاری در نظر میگیریم.
Agent تحلیل لاگ چه مشکلاتی را میتواند تشخیص دهد؟
نوع خطاهای قابل تشخیص به سرویسهای نصبشده، قالب لاگ و مجوزهای Collector بستگی دارد.
| منبع | نشانه قابل تشخیص | بررسی پیشنهادی |
|---|---|---|
| Nginx | 502 یا Upstream Timeout | سلامت Backend و زمان پاسخ |
| Apache | خطای اتصال یا محدودیت Worker | تنظیمات سرویس و بار درخواستها |
| SSH | Failed Password | تعداد تلاشها و سیاست دسترسی |
| PHP-FPM | خطای Worker یا Timeout | منابع و تنظیمات Pool |
| MySQL / MariaDB | خطای اتصال یا Crash | وضعیت سرویس و مصرف منابع |
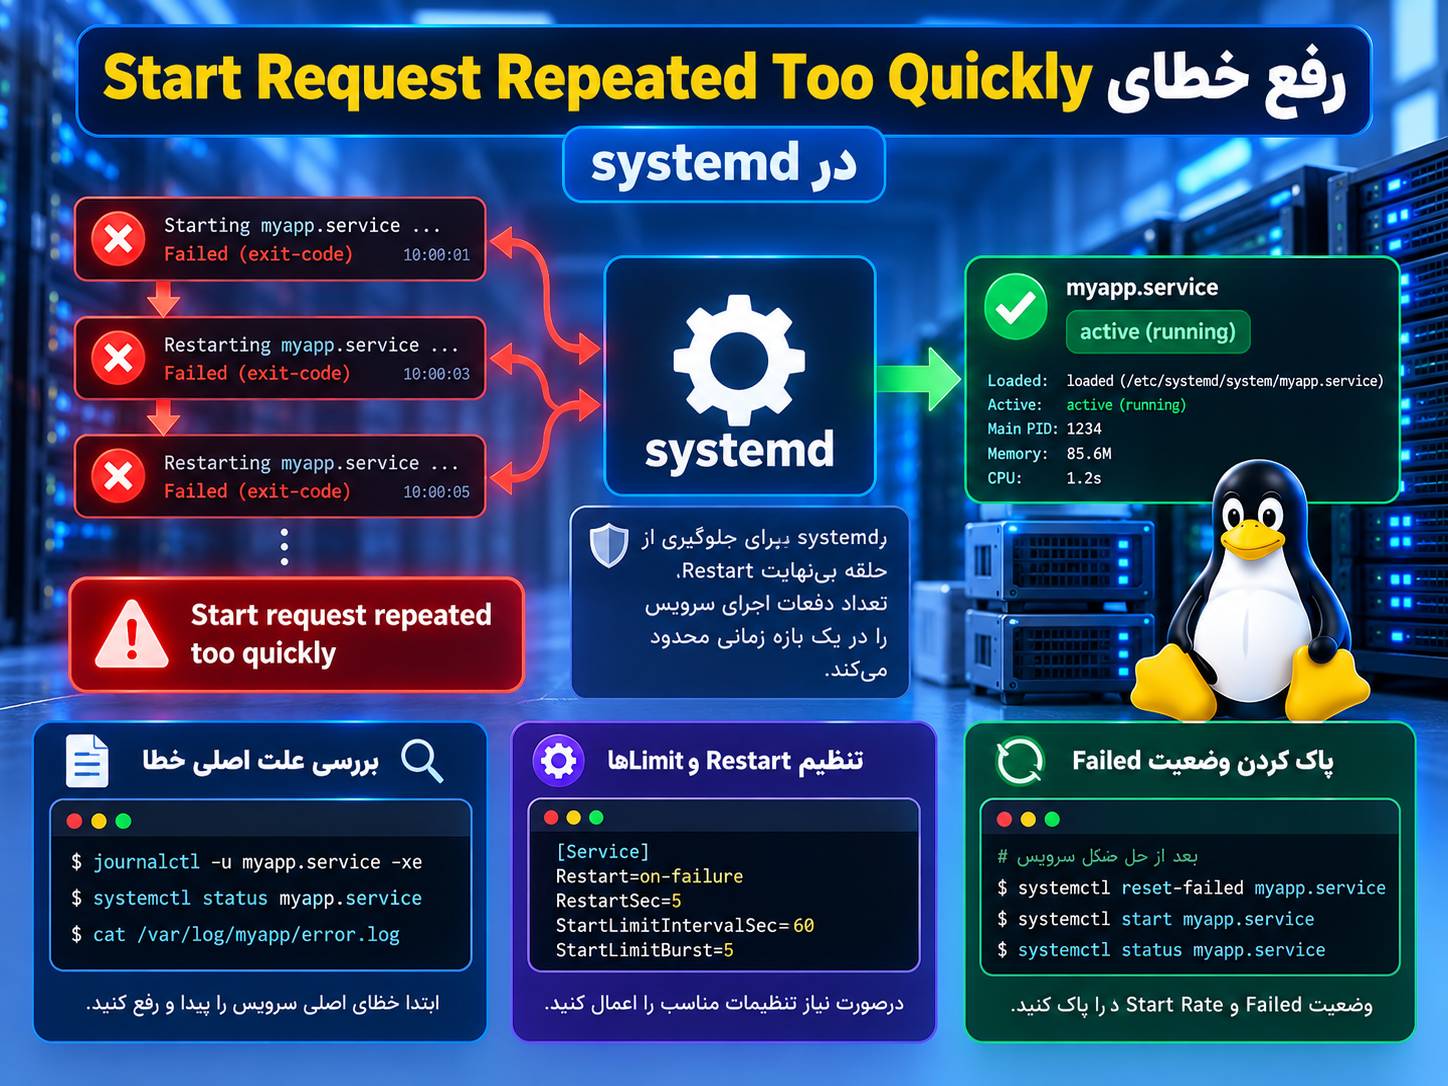
| systemd | Main Process Exited | وضعیت سرویس و علت توقف |
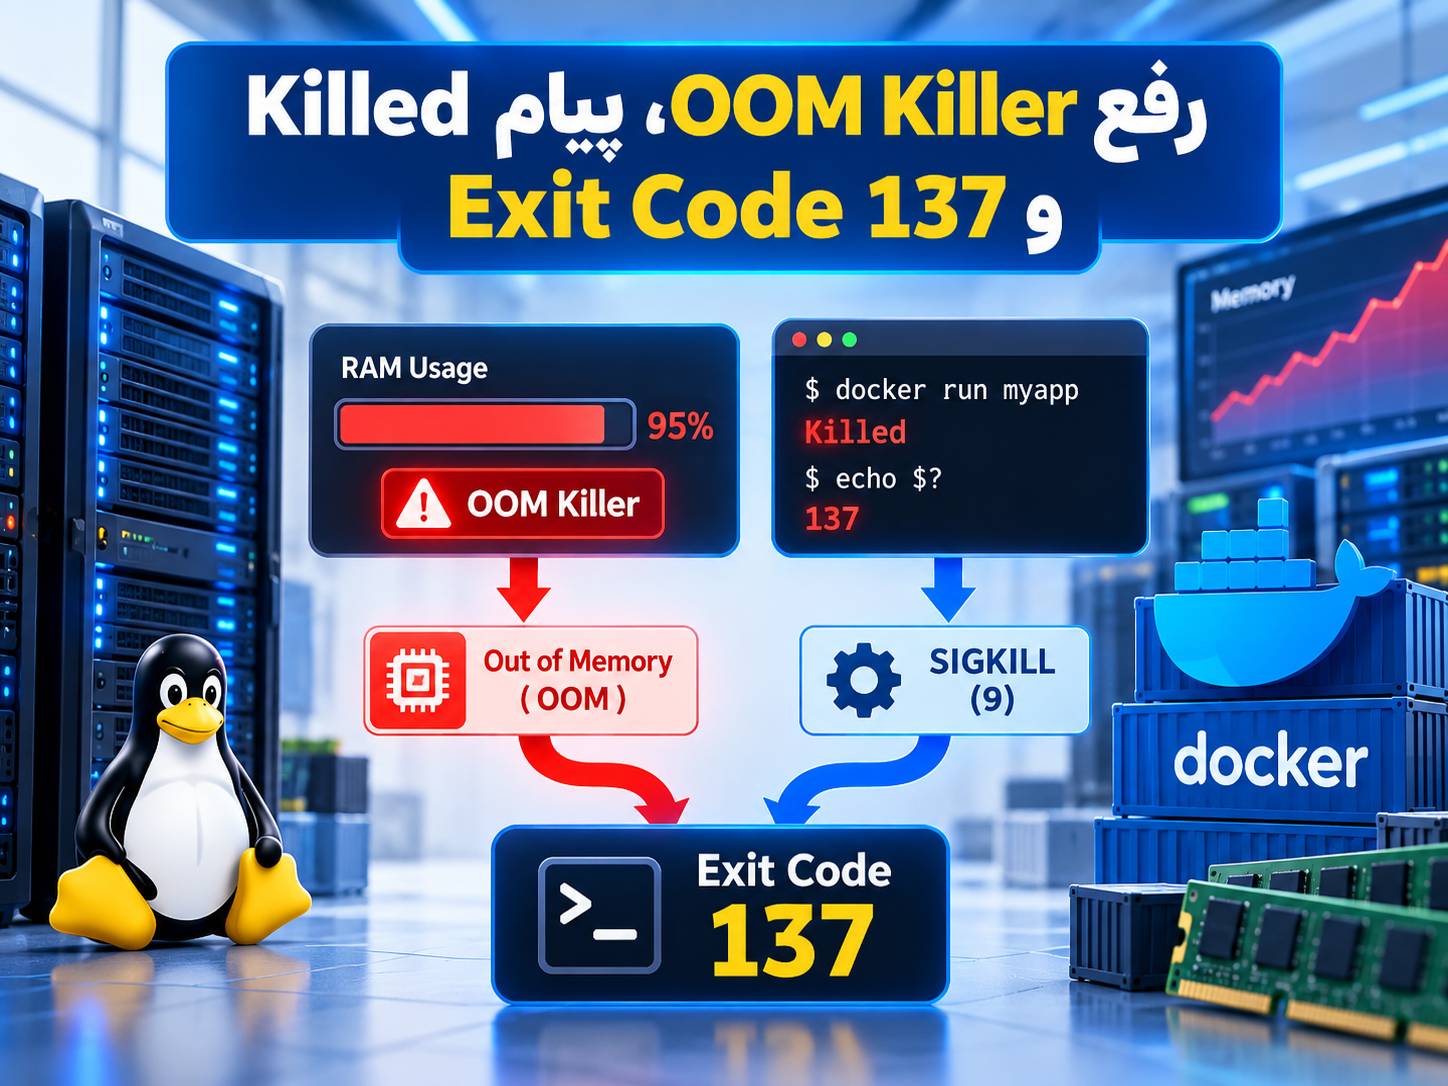
| Linux | Out of Memory | مصرف حافظه و رخدادهای OOM |
| Filesystem | No space left on device | فضای دیسک و Inodeها |
| Game Server | Crash یا خطای اتصال | وضعیت فرآیند و لاگ همان بازی |
آیا AI Log Analyzer میتواند علت قطعی همه خطاها را تشخیص دهد؟
خیر. لاگها فقط بخشی از شواهد هستند. گاهی برای تشخیص علت واقعی به دادههای مانیتورینگ، مصرف منابع، وضعیت شبکه یا اطلاعات اپلیکیشن نیاز است.
خروجی مناسب باید میان «نشانه مشاهدهشده»، «علت احتمالی» و «علت تأییدشده» تفاوت مشخصی داشته باشد.
معماری امن Agent بررسی لاگ روی VPS
برای حفظ امنیت، بهتر است خواندن لاگ از تحلیل هوش مصنوعی جدا شود.
ساختار پیشنهادی شامل پنج بخش است:
۱. Log Source
منبع داده میتواند فایل لاگ یک سرویس، Journal مربوط به یک Unit مشخص یا خروجی سامانه مرکزی جمعآوری لاگ باشد.
۲. Read-only Collector
Collector فقط دادههای مجاز را دریافت میکند و اجازه تغییر فایلهای منبع را ندارد.
۳. Redaction و Normalization
در این مرحله، دادههای حساس رایج حذف و اطلاعات به قالب مشخص تبدیل میشوند.
۴. Analyzer
Analyzer روی دادههای کنترلشده کار میکند و نشانههای مشکل را دستهبندی میکند.
۵. Incident Manager
این بخش گزارش حادثه را ثبت میکند و آن را در اختیار مدیر یا تیم فنی قرار میدهد.
Approved Log Source
        |
Read-only Collector
        |
Size and Path Limits
        |
Redaction + Normalization
        |
Structured Error Signals
        |
Rule-based Analyzer
        |
Optional LLM Summary
        |
Incident Database
        |
Human Investigation
        |
Approved Operational Action
در این طراحی، مدل هوش مصنوعی هیچ دسترسی مستقیمی به Shell، سرویسهای مدیریتی یا فایلهای خام سرور ندارد.
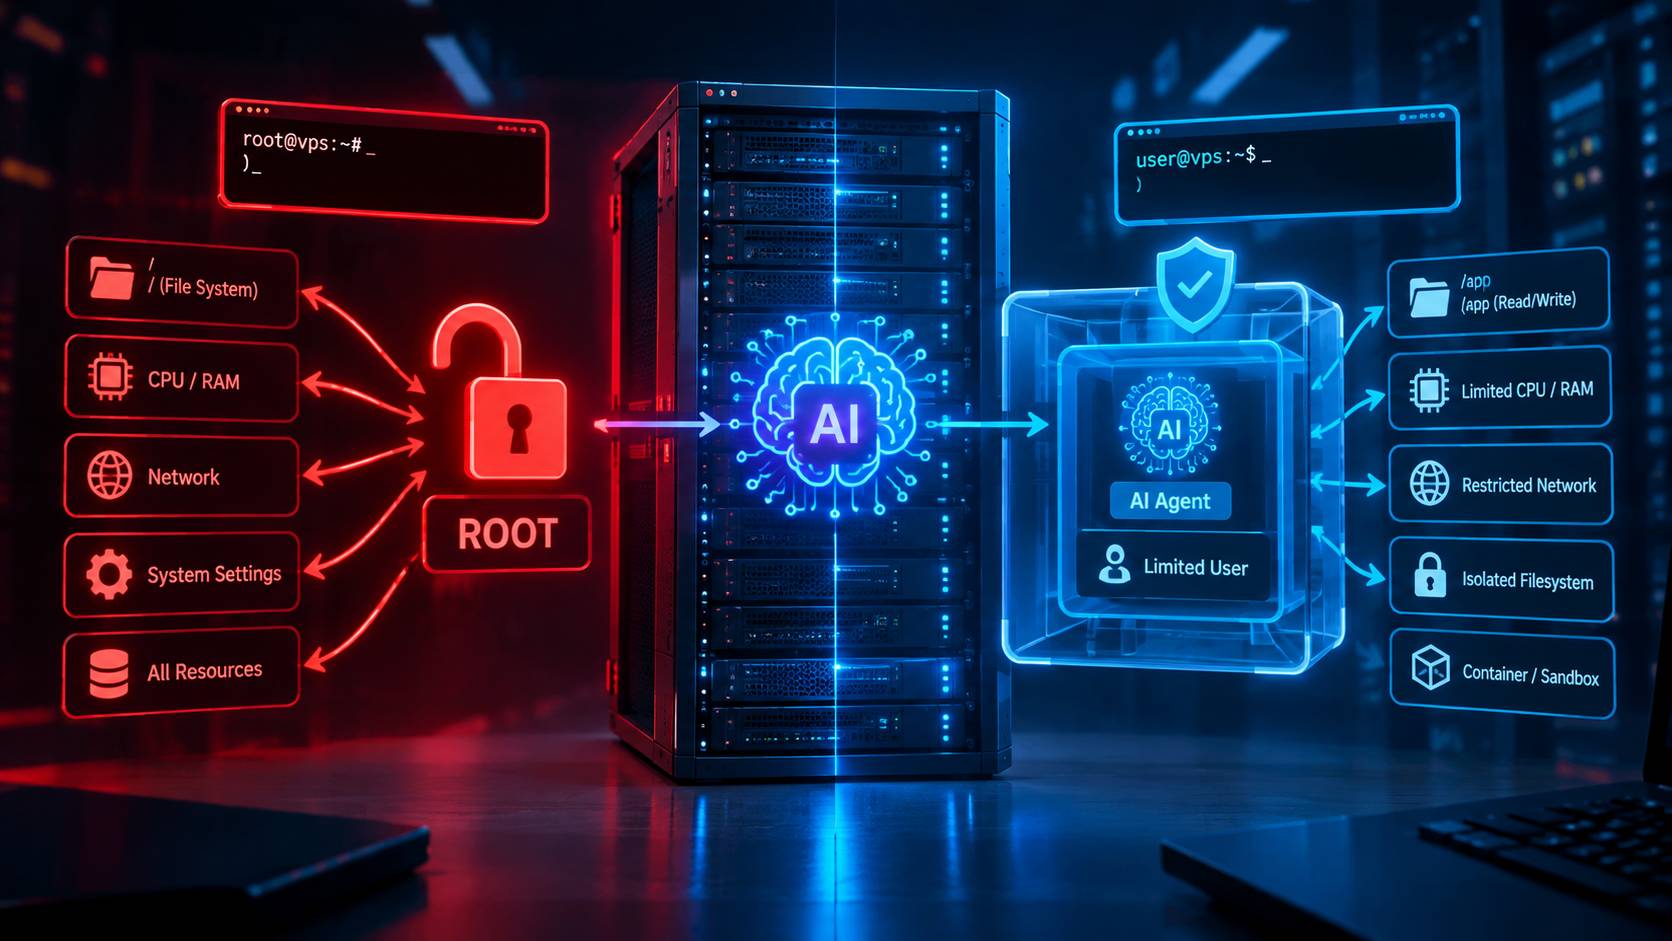
چرا نباید به Agent بررسی لاگ Root Access بدهیم؟
حساب Root در Linux میتواند به بخش بزرگی از فایلها، فرآیندها و تنظیمات سیستم دسترسی داشته باشد.
اگر Agent با چنین مجوزی اجرا شود، خطا در انتخاب ابزار یا Prompt Injection ممکن است پیامد جدی ایجاد کند.
مشکلات دسترسی Root برای Agent
- امکان خواندن فایلهای محرمانه غیرمرتبط.
- امکان تغییر تنظیمات سیستم.
- امکان توقف یا Restart سرویسها.
- امکان دسترسی به دادههای سایر کاربران.
- افزایش پیامد احتمالی Prompt Injection.
آیا نداشتن Root برای امنیت کافی است؟
خیر. یک حساب غیر Root نیز ممکن است به گروههایی تعلق داشته باشد که اطلاعات بسیار گستردهای را قابل خواندن میکنند.
برای مثال، عضویت در گروههای adm یا systemd-journal ممکن است دسترسی به Journalهای مختلف سیستم ایجاد کند.
بنابراین باید حداقل مجوز لازم برای همان منبع مشخص اعطا شود؛ نه صرفاً یک حساب کاربری غیر Root.
چگونه دسترسی خواندن لاگ را در Ubuntu محدود کنیم؟
فرض کنید یک برنامه اختصاصی لاگ خود را در مسیر مشخصی ذخیره میکند.
بهتر است حساب Collector فقط به همان فایل یا دایرکتوری مجاز دسترسی داشته باشد.
ساخت حساب اختصاصی
sudo useradd --system --create-home \
--home-dir /opt/iranica-log-agent \
--shell /usr/sbin/nologin logagent
این دستور برای نصب جدید است. اگر حساب logagent از قبل وجود دارد، ابتدا وضعیت آن را بررسی کنید.
ساخت گروه مختص لاگهای مجاز
sudo groupadd logread_demo

sudo usermod -aG logread_demo logagent
این گروه فقط یک نام اختصاصی برای مثال است و بهصورت پیشفرض دسترسی به فایلهای سیستم ندارد.
ساخت فایل لاگ آزمایشی
sudo install -d -o root -g logread_demo -m 750 \
/var/log/iranica-demo

echo "ERROR upstream timed out" | sudo tee \
/var/log/iranica-demo/app.log > /dev/null

sudo chown root:logread_demo \
/var/log/iranica-demo/app.log

sudo chmod 640 \
/var/log/iranica-demo/app.log
حالا فایل متعلق به Root است و اعضای گروه logread_demo فقط اجازه خواندن آن را دارند.
تست مجوز خواندن
sudo -u logagent test -r \
/var/log/iranica-demo/app.log && echo READ_OK

sudo -u logagent test -w \
/var/log/iranica-demo/app.log || echo WRITE_DENIED
نتیجه مورد انتظار این است که خواندن مجاز و نوشتن غیرمجاز باشد.
نکته درباره Log Rotation
اگر سرویس از logrotate استفاده میکند، ممکن است هنگام چرخش لاگ، فایل جدید با مالکیت یا مجوز متفاوت ساخته شود.
بنابراین تنظیمات Rotation نیز باید با دسترسی خواندن محدود سازگار شوند. مجوز فایل آزمایشی را نباید بدون بررسی روی تمام فایلهای /var/log اعمال کنید.
خواندن Journal با journalctl بدون دادن دسترسی گسترده به Agent
در بسیاری از توزیعهای Linux، خروجی سرویسهای systemd از طریق journalctl قابل مشاهده است.
نمونه بررسی یک سرویس توسط مدیر مجاز
sudo journalctl \
-u nginx.service \
--since "30 minutes ago" \
--no-pager
این دستور برای استفاده مدیر سرور است؛ نباید آن را بهعنوان Tool با پارامترهای آزاد در اختیار مدل قرار دهید.
چرا نباید logagent را به گروه systemd-journal اضافه کنیم؟
زیرا این گروه معمولاً اجازه مشاهده Journalهای گسترده سیستم را ایجاد میکند و محدود به یک Unit مشخص نیست.
بنابراین اگر Agent فقط به خطاهای Nginx نیاز دارد، اعطای دسترسی به همه Journalها با اصل حداقل دسترسی سازگار نیست.
روش پیشنهادی برای Production
یک Collector جداگانه و مورد اعتماد داشته باشید که فقط Unitهای از پیش مجاز را بخواند و خروجی پالایششده را به مسیر مخصوص Analyzer منتقل کند.
اگر Collector برای دسترسی به Journal به مجوز بالاتر نیاز دارد، این مجوز فقط متعلق به همان سرویس جمعآوری باشد؛ نه فرآیند مدل.
نام Unit، بازه زمانی و مسیر خروجی باید از تنظیمات محافظتشده تعیین شوند و مدل نتواند آنها را آزادانه تغییر دهد.
آیا sudo محدود کافی است؟
میتوان برای بعضی عملیاتها سیاست sudo محدود طراحی کرد، اما اشتباه در تعریف آرگومانها یا برنامه مجاز ممکن است دسترسی بیشتری از انتظار ایجاد کند.
برای این پروژه، جدا کردن Collector از حساب Agent و استفاده از یک برنامه با ورودی ثابت، طراحی قابل کنترلتری است.
Read-only Collector چیست و چه محدودیتهایی باید داشته باشد؟
Collector برنامهای است که دادهها را از منبع مشخص دریافت میکند، بدون اینکه اجازه تغییر همان منبع را داشته باشد.
در نمونه عملی، Collector تنها یک فایل معمولی را از دایرکتوری مجاز میخواند.
محدودیتهای Collector نمونه
- پذیرش فقط فایل موجود در دایرکتوری مجاز.
- رد Symlink در مسیر فایل ورودی.
- رد فایلهای غیرمعمول مانند FIFO.
- محدودیت حدود یک مگابایت برای بخش خواندهشده.
- محدودیت تعداد خطوط پردازششده.
- عدم اجرای فرمان Shell.
- عدم فراخوانی API خارجی.
- عدم تغییر فایل لاگ اصلی.
این محدودیتها باعث میشوند حتی در صورت دریافت محتوای مخرب، سطح اثر برنامه کمتر باشد.
محدودیت مهم نمونه آموزشی
در CLI پروژه، مسیر دایرکتوری مجاز از پارامتر root دریافت میشود. این قابلیت فقط برای آزمایش محلی است.
در Production، مسیر مجاز باید در تنظیمات محافظتشده و غیرقابل تغییر توسط Agent قرار داشته باشد. نباید اجازه دهید کاربر عمومی یا مدل هوش مصنوعی مسیر خواندن را انتخاب کند.
Redaction لاگ چیست و چه اطلاعاتی باید حذف شوند؟
Redaction به معنی حذف یا جایگزینی اطلاعات حساس پیش از ذخیره یا ارسال برای تحلیل است.
برای مثال، یک پیام خطا ممکن است حاوی Token، رمز عبور، IP کاربر یا آدرس ایمیل باشد.
اگر چنین اطلاعاتی بدون کنترل به مدل خارجی ارسال شوند، ممکن است با سیاست محرمانگی سرویس ناسازگار باشند.
نمونه قبل از Redaction
2026-11-04 ERROR
password=DEMO_PASSWORD
client_ip=192.0.2.25
نمونه بعد از Redaction
2026-11-04 ERROR
[REDACTED_CREDENTIAL]
client_ip=[REDACTED_IPV4]
در این مثال، مقادیر جایگزینشده برای توضیح مفهوم Redaction هستند و اطلاعات واقعی محسوب نمیشوند.
چه دادههایی را بررسی کنیم؟
- Password و API Key.
- Bearer Token و Authorization Header.
- Session ID و Cookie.
- آدرس ایمیل و اطلاعات هویتی.
- IP مشتری در صورت عدم ضرورت.
- Query String دارای اطلاعات حساس.
- کلیدهای خصوصی یا اطلاعات اتصال.
آیا Regex برای حذف همه اطلاعات محرمانه کافی است؟
خیر. Regex فقط الگوهای شناختهشده را تشخیص میدهد. دادههای حساس ممکن است با نام فیلد متفاوت، فرمت JSON، کدگذاری یا ساختار نامعمول در لاگ ظاهر شوند.
در سامانه حساس بهتر است بهجای ارسال متن آزاد لاگ، در همان Collector فیلدهای مشخصی مانند Timestamp، Service، Error Code و Event Type استخراج شوند و فقط خروجی ساختاریافته به مدل برسد.
همچنین باید Redaction با دادههای نمونه واقعی هر سرویس آزمایش شود.
Prompt Injection از طریق لاگ سرور چگونه اتفاق میافتد؟
Prompt Injection زمانی اتفاق میافتد که محتوای غیرقابل اعتماد تلاش کند رفتار مدل هوش مصنوعی را تغییر دهد.
در سیستم تحلیل لاگ، مهاجم ممکن است بتواند بخشی از متن ثبتشده در لاگ را کنترل کند.
نمونه حمله از طریق User-Agent
فرض کنید وبسرور درخواست HTTP را همراه User-Agent ثبت میکند. مهاجم میتواند در این فیلد عبارتی قرار دهد که از Agent بخواهد دستورهای قبلی را نادیده بگیرد یا اطلاعاتی را افشا کند.
وقتی Agent لاگ را میخواند، این متن در محتوای ورودی او ظاهر میشود.
اگر سیستم مرز میان «داده لاگ» و «دستور مورد اعتماد» را حفظ نکند، احتمال پیروی مدل از چنین متنهایی وجود دارد.
چرا این حمله غیرمستقیم است؟
زیرا مهاجم مستقیماً با Agent گفتگو نکرده است؛ او دادهای را دستکاری کرده که Agent بعداً برای انجام وظیفه مجاز خود میخواند.
راهکار اول: جدا کردن داده از دستور
متن لاگ باید بهعنوان داده غیرقابل اعتماد وارد پردازش شود و نباید داخل System Message یا Developer Message قرار بگیرد.
راهکار دوم: حذف اختیار عملیات حساس
اگر Analyzer هیچ ابزار Restart، Shell، تغییر Firewall یا ارسال HTTP آزاد نداشته باشد، حتی در صورت شکست برخی کنترلهای متنی، امکان انجام مستقیم بسیاری از عملیات مخرب محدودتر میشود.
راهکار سوم: خروجی ساختاریافته
بهتر است به جای ارسال چند هزار خط خام، اطلاعاتی مانند تعداد خطاهای احراز هویت، تعداد Timeout و وضعیت سرویس به مدل داده شود.
راهکار چهارم: محدودسازی محتوای مشکوک
در پروژه نمونه، برخی عبارتهای شناختهشده Prompt Injection تشخیص داده میشوند و بهجای متن اصلی، یک نشانگر محدود ثبت میشود.
این روش تنها یک لایه دفاعی است و تضمین نمیکند تمام حملات تشخیص داده شوند؛ مهاجم ممکن است از زبان، قالب یا روش متفاوتی استفاده کند.
راهکار پنجم: کنترل خروجی مدل
پاسخ مدل نیز باید داده غیرقابل اعتماد تلقی شود. اگر مدل پیشنهادی برای اجرای فرمان ارائه میدهد، این پیشنهاد نباید بهصورت خودکار اجرا شود.
روشهای تشخیص خطا در AI Log Analyzer
میتوان تحلیل خطا را به سه سطح تقسیم کرد.
سطح اول: Rule-based Detection
در این سطح، الگوهای مشخص با Regex یا Parser شناسایی میشوند.
برای مثال، وجود عبارت No space left on device یک نشانه قابل ثبت از مشکل نوشتن روی فضای ذخیرهسازی است.
سطح دوم: Correlation
در این سطح، چند نشانه از سرویسهای مختلف کنار هم بررسی میشوند.
برای مثال، افزایش خطای 502 همراه با توقف فرآیند Backend ممکن است برای بررسی ارتباط این دو رخداد مفید باشد.
اما همزمانی رخدادها لزوماً رابطه علت و معلولی را ثابت نمیکند.
سطح سوم: LLM-assisted Explanation
در این مرحله، مدل زبانی میتواند دادههای استخراجشده را خلاصه کند و چند فرضیه فنی همراه با شواهد و محدودیتها ارائه دهد.
برای محیط عملیاتی، بهتر است مدل در گزارش خود میان Observed، Suspected و Unverified تفاوت مشخص داشته باشد.
نمونه الگوهای پروژه
PATTERNS = {
    "authentication_failures": (
        r"failed password|authentication failure"
    ),
    "upstream_errors": (
        r"upstream timed out|502 bad gateway"
    ),
    "out_of_memory": (
        r"out of memory|oom.kill"
    ),
    "disk_errors": (
        r"no space left on device|disk i/o error"
    ),
    "service_crash": (
        r"segmentation fault|core dumped"
    ),
}
این فهرست برای نمایش مفهوم است. در فایل کامل پروژه، الگوهای گستردهتر با re.compile تعریف شدهاند.
تشخیص یک الگو نباید بهتنهایی مبنای انجام عملیات اصلاحی باشد.
پیشنیازها و منابع VPS برای تحلیل لاگ
برای نمونه این مقاله به Ubuntu 24.04، Python 3 و SQLite نیاز داریم.
چون مدل زبانی و پردازش برداری در نمونه اصلی اجرا نمیشوند، منابع بسیار زیادی لازم نیست.
| نوع استفاده | RAM پیشنهادی اولیه | CPU پیشنهادی اولیه |
|---|---|---|
| نمونه آفلاین یک فایل | ۱ گیگابایت | ۱ vCPU |
| چند سرویس با پردازش دورهای | ۲ تا ۴ گیگابایت | ۲ vCPU |
| Collector و Queue چندسروری | براساس حجم لاگ | براساس نرخ رخداد |
| مدل محلی تحلیل لاگ | براساس مدل انتخابی | احتمال نیاز به GPU |
این مقادیر برآوردهای اولیه هستند. برای سامانه پرترافیک، نرخ تولید لاگ، حجم داده، تعداد Collectorها و مدت نگهداری از مهمترین عوامل انتخاب منابع هستند.
مرحله اول: نصب پروژه AI Log Analyzer روی VPS
نصب Python
sudo apt update
sudo apt install -y python3 python3-venvآمادهسازی پروژه
فایل ZIP همراه مقاله را در محیط آزمایشی استخراج کنید.
ساختار پروژه به این شکل است:
iranica-log-analyzer-demo/
  log_analyzer.py
  test_log_analyzer.py
  sample.log
  README.md
ساخت محیط مجازی
cd iranica-log-analyzer-demo

python3 -m venv .venv

.venv/bin/python --version
پروژه اصلی فقط از کتابخانههای استاندارد Python استفاده میکند و نیازی به نصب پکیج خارجی ندارد.
مرحله دوم: بررسی کد Read-only Collector و Redaction
حالا قسمتهای اصلی فایل log_analyzer.py را بررسی میکنیم.
محدود کردن حجم لاگ
MAX_BYTES = 1_048_576
MAX_LINES = 2000
MAX_LINE_CHARS = 1600
این محدودیتها کمک میکنند Collector یک فایل چندگیگابایتی را بهصورت کامل وارد RAM نکند.
بررسی مسیر مجاز فایل
root_path = Path(root).resolve(strict=True)

requested = Path(path)

if requested.is_symlink():
    raise PermissionError("Symlink input refused")

resolved = requested.resolve(strict=True)

if root_path not in resolved.parents:
    raise PermissionError(
        "Log path outside allowlisted directory"
    )
این بخش مانع انتخاب مستقیم فایل خارج از محدوده تعریفشده میشود.
در نسخه کامل، فایل با حالت Read-only باز و نوع آن بررسی میشود. برای سامانهای که با کاربران محلی غیرقابل اعتماد یا دایرکتوری قابلتغییر کار میکند، باید کنترلهای سطح File Descriptor و جلوگیری از Race Condition نیز تقویت شوند.
حذف اطلاعات حساس
def sanitize(raw):
    text = (
        raw.replace("\x00", " ")
        .replace("\r", " ")
        .replace("\n", " ")
    )[:MAX_LINE_CHARS]

    suspicious = bool(INJECTION.search(text))

    for pattern, replacement in REDACTIONS:
        text = pattern.sub(replacement, text)

    if suspicious:
        return (
            "[UNTRUSTED_INSTRUCTION_QUARANTINED]",
            True,
        )

    return text, False
این تابع کاراکترهای کنترلی مشخص را حذف میکند، حجم متن را محدود میکند و بعضی الگوهای محرمانه را جایگزین میکند.
اگر یک الگوی شناختهشده Prompt Injection تشخیص داده شود، متن کامل آن خط وارد خلاصه ذخیرهشده نمیشود.
اما باید توجه داشت که این تابع یک Sanitizer کامل برای تمام انواع لاگ و حملات نیست.
تشخیص الگوهای خطا
tags = [
    name
    for name, pattern in PATTERNS.items()
    if pattern.search(safe)
]
در این مرحله، متن پاکسازیشده برای شناسایی نشانههای شناختهشده بررسی میشود.
در پروژه کامل، نتیجه هر خط همراه Tagهای مربوطه برای ساخت گزارش به مرحله بعد ارسال میشود.
چرا Collector هیچ فرمان سیستمی اجرا نمیکند؟
زیرا وظیفه آن خواندن و دستهبندی داده است.
اگر قرار باشد براساس نتیجه تحلیل عملیاتی مانند Restart انجام شود، باید در یک سیستم جداگانه، پس از بررسی مجوز و تأیید مناسب اجرا شود.
مرحله سوم: اجرای AI Log Analyzer با فایل آزمایشی
پروژه دارای فایل sample.log است که چند رخداد ساختگی را شامل میشود:
- تلاش ناموفق برای ورود.
- خطای Upstream Timeout.
- خطای کمبود فضای دیسک.
- یک Credential آزمایشی که باید حذف شود.
- یک خط دارای الگوی Prompt Injection.
اجرای تحلیل
.venv/bin/python log_analyzer.py \
--root "$PWD" \
--input "$PWD/sample.log" \
--db "$PWD/incidents.sqlite3"
نمونه نتیجه
{
  "severity": "high",
  "signals": {
    "authentication_failures": 1,
    "upstream_errors": 1,
    "disk_errors": 1
  },
  "injection_suspect_count": 1,
  "lines_examined": 5,
  "status": "needs_human_triage",
  "remediation_executed": false
}
این خروجی نشان میدهد پنج خط بررسی شده و سه نوع نشانه خطا شناسایی شده است.
یک خط نیز به دلیل احتمال Prompt Injection علامتگذاری شده است.
Severity چگونه تعیین میشود؟
در نمونه آموزشی، اگر نشانه OOM یا مشکل دیسک وجود داشته باشد، سطح گزارش high تعیین میشود. سایر خطاهای شناختهشده معمولاً در دسته medium قرار میگیرند.
این سطحبندی صرفاً یک قاعده آموزشی است. Severity واقعی حادثه باید براساس تعداد کاربران تحت تأثیر، اهمیت سرویس، مدت اختلال و شواهد معتبر تعیین شود.
آیا اجرای کد باعث تغییر سرور میشود؟
برنامه فایل لاگ منبع را تغییر نمیدهد و هیچ دستور اصلاحی اجرا نمیکند. تنها فایل SQLite مربوط به گزارش و Audit را در مسیر خروجی تعیینشده ایجاد یا بهروزرسانی میکند.
Incident Workflow؛ از تشخیص نشانه تا رسیدگی به حادثه
تحلیل لاگ زمانی ارزش عملیاتی دارد که نتیجه آن وارد یک گردش کار مشخص شود.
یک گزارش خطا بدون مسئول رسیدگی، اولویت و وضعیت پیگیری ممکن است بهراحتی فراموش شود.
مرحله اول: Detection
Collector و Analyzer نشانههای مشخص را ثبت میکنند.
مرحله دوم: Triage
سیستم اطلاعات اولیه مانند نوع خطا، تعداد، محدوده زمانی و سرویس مرتبط را آماده میکند.
مرحله سوم: Validation
اپراتور بررسی میکند مشکل واقعی است یا False Positive و آیا شواهد برای تعیین علت کافی هستند.
مرحله چهارم: Investigation
در صورت نیاز، دادههای تکمیلی مانند مصرف RAM، وضعیت دیسک، سلامت سرویس و رخدادهای شبکه بررسی میشوند.
مرحله پنجم: Response
اگر اقدام عملیاتی لازم باشد، توسط شخص یا سامانه دارای مجوز و پس از تأیید مناسب انجام میشود.
مرحله ششم: Recovery و Lessons Learned
پس از رفع مشکل، وضعیت سرویس و اثر اقدام بررسی و تجربه حادثه مستند میشود.
این ساختار با رویکرد مدیریت حادثه در NIST SP 800-61 Revision 3 سازگار است؛ هرچند استاندارد جدید مدیریت رخداد را در چارچوب گستردهتر مدیریت ریسک امنیت سایبری بررسی میکند.
نمونه گزارش Incident
| فیلد | مثال آموزشی |
|---|---|
| Incident ID | شناسه یکتای ثبتشده |
| Severity | High |
| Observed Signal | No space left on device |
| Evidence | بخش پاکسازیشده خط لاگ |
| Possible Impact | احتمال اختلال در نوشتن فایل |
| Confirmed Root Cause | هنوز تأیید نشده |
| Next Step | بررسی فضای دیسک توسط اپراتور |
| Status | Needs Human Triage |
آیا AI Agent باید مشکل را خودکار برطرف کند؟
برای مرحله اول بهتر است خیر. تشخیص و پیشنهاد را از اجرای عملیات جدا نگه دارید.
اگر در آینده به Auto-remediation نیاز داشتید، باید سیاست تأیید، محدوده ابزارها، Idempotency، Rollback و ثبت Audit مستقل طراحی شود.
ثبت Audit و نگهداری شواهد بدون افشای اطلاعات
برای تحلیل رخدادهای امنیتی و عملیاتی، ثبت تاریخچه تصمیمها اهمیت زیادی دارد.
اما Audit نباید به محلی برای ذخیره دوباره رمزها و اطلاعات محرمانه تبدیل شود.
جداول پروژه
نمونه عملی از دو جدول اصلی استفاده میکند:
| جدول | کاربرد |
|---|---|
| incidents | ذخیره گزارش و وضعیت تشخیص |
| audit | ثبت ایجاد گزارش حادثه |
نمونه ساخت جدول Incident
CREATE TABLE IF NOT EXISTS incidents (
    id TEXT PRIMARY KEY,
    created_at INTEGER NOT NULL,
    status TEXT NOT NULL,
    severity TEXT NOT NULL,
    report_json TEXT NOT NULL
);
آیا باید تمام لاگ خام ذخیره شود؟
خیر. در این پروژه فقط گزارشهای پاکسازیشده ذخیره میشوند.
اگر نگهداری لاگ خام برای بررسی قانونی یا Forensics لازم است، بهتر است آن را در سامانه لاگبرداری مستقل با کنترل دسترسی، سیاست نگهداری و حفاظت مناسب حفظ کنید.
متن خام نباید بدون ضرورت به مدل هوش مصنوعی منتقل شود.
اتصال اختیاری AI Log Analyzer به مدل هوش مصنوعی
تا اینجا سیستم بدون استفاده از مدل زبانی نشانههای خطا را شناسایی کرده است.
حالا میتوان از مدل برای تهیه توضیح قابل فهم درباره نتیجه استفاده کرد.
برای حفظ امنیت، بهتر است فقط اطلاعات ساختاریافته و غیرحساس به مدل ارسال شوند.
نمونه داده قابل ارسال
{
  "signals": {
    "authentication_failures": 12,
    "upstream_errors": 4,
    "disk_errors": 1
  },
  "status": "needs_human_triage"
}
در این ساختار هیچ IP، Credential یا متن آزاد لاگ وجود ندارد.
نمونه اتصال با OpenAI Responses API
ابتدا OpenAI SDK را در محیط مجازی نصب کنید:
.venv/bin/python -m pip install openaiاین قابلیت در بسته اصلی Demo فعال نیست و کد زیر نمونه مستقل اتصال اختیاری است.
import json
import os
from openai import OpenAI

client = OpenAI()

signals = {
    "authentication_failures": 12,
    "upstream_errors": 4,
    "disk_errors": 1,
}

response = client.responses.create(
    model=os.environ["LOG_ANALYZER_MODEL"],
    instructions=(
        "You analyze structured server error counts. "
        "Write a concise Persian incident summary. "
        "Separate observations from hypotheses. "
        "Never claim a root cause is confirmed "
        "without supporting evidence. "
        "Do not request or execute commands. "
        "Suggest read-only investigation steps."
    ),
    input=json.dumps({
        "signals": signals,
        "status": "needs_human_triage",
    }),
    store=False,
)

print(response.output_text)
متغیر LOG_ANALYZER_MODEL باید با نام یک مدل معتبر و قابل دسترسی در پروژه API تنظیم شود.
چرا متن خام لاگ را ارسال نکردیم؟
زیرا حتی پس از Redaction، متن آزاد ممکن است حاوی داده محرمانه شناسایینشده یا دستور مخرب باشد.
ارسال شمارندهها و فیلدهای مشخص میتواند سطح داده ورودی و احتمال اثرگذاری Prompt Injection را کاهش دهد.
آیا مدل میتواند علت قطعی را اعلام کند؟
فقط زمانی که شواهد کافی وجود داشته باشد. در غیر این صورت باید چند فرضیه و مراحل بررسی پیشنهاد کند.
خروجی مدل نیز پیش از استفاده عملیاتی باید توسط برنامه یا اپراتور بررسی شود.
چگونه تحلیل لاگ را با systemd بهصورت دورهای اجرا کنیم؟
اگر میخواهید یک فایل لاگ مشخص بهصورت دورهای بررسی شود، میتوانید از systemd Timer استفاده کنید.
برای مثال، فرض کنیم پروژه در مسیر /opt/iranica-log-agent و دیتابیس در /var/lib/iranica-log-agent قرار دارد.
ساخت دایرکتوری ذخیره گزارش
sudo install -d \
-o logagent -g logagent -m 700 \
/var/lib/iranica-log-agent
نمونه Service
[Unit]
Description=Iranica Read-only Log Analyzer

[Service]
Type=oneshot
User=logagent
Group=logagent
SupplementaryGroups=logread_demo

WorkingDirectory=/opt/iranica-log-agent

ExecStart=/usr/bin/python3 /opt/iranica-log-agent/log_analyzer.py --root /var/log/iranica-demo --input /var/log/iranica-demo/app.log --db /var/lib/iranica-log-agent/incidents.sqlite3

NoNewPrivileges=true
PrivateTmp=true
ProtectSystem=strict
ProtectHome=true
ReadWritePaths=/var/lib/iranica-log-agent
RestrictAddressFamilies=AF_UNIX
IPAddressDeny=any
این Unit نمونه برای فایل مجاز مشخص است. قبل از استفاده باید مسیرها، مالکیتها و محدودیتهای Service در محیط واقعی بررسی شوند.
گزینههای Network Hardening در این سرویس مناسب هستند؛ زیرا نمونه آفلاین به اینترنت نیاز ندارد.
ساخت Timer
[Unit]
Description=Run Iranica Log Analyzer periodically

[Timer]
OnBootSec=2min
OnUnitActiveSec=5min
Unit=iranica-log-agent.service

[Install]
WantedBy=timers.targetفایلهای Service و Timer را در /etc/systemd/system با نامهای متناسب ذخیره کنید.
فعالسازی
sudo systemctl daemon-reload

sudo systemctl enable --now \
iranica-log-agent.timer

sudo systemctl status \
iranica-log-agent.timer --no-pager
نکته درباره تحلیل تکراری
نمونه آموزشی در هر اجرا بخش انتهایی فایل را بررسی میکند و ممکن است رخدادهای قبلی را دوباره بشمارد.
برای Production باید Offset یا Cursor پایدار، مدیریت Log Rotation، جلوگیری از دوبارهشماری و تشخیص وقفههای جمعآوری پیادهسازی شوند.
همچنین بهتر است حادثههای مشابه در یک بازه زمانی بهصورت کنترلشده تجمیع شوند تا سیستم با گزارشهای تکراری اشباع نشود.
چه تستهای امنیتی برای AI Log Analyzer ضروری هستند؟
قبل از اتصال Analyzer به لاگهای واقعی، باید مطمئن شویم محدودیتهای دسترسی و پردازش آن درست کار میکنند.
| سناریو | نتیجه مورد انتظار |
|---|---|
| فایل مجاز | امکان خواندن |
| فایل خارج از Allowlist | رد دسترسی |
| Symlink ورودی | رد دسترسی |
| فایل غیرمعمول | رد پردازش |
| Token در لاگ | حذف مقدار حساس رایج |
| IP و ایمیل در لاگ | اعمال Redaction تعریفشده |
| متن مشکوک Prompt Injection | علامتگذاری یا قرنطینه |
| خطای دیسک | ثبت Signal مناسب |
| نبود خطای شناختهشده | عدم اعلام علت قطعی |
| تحلیل خطا | عدم اجرای Restart یا فرمان |
| ایجاد Incident | ثبت وضعیت و Audit |
| Crash Collector | حفظ لاگ منبع و امکان بررسی مجدد |
اجرای تستهای خودکار پروژه
.venv/bin/python -m unittest -v \
test_log_analyzer.py
این فایل شش تست خودکار برای بخشهای اصلی پروژه دارد.
موفقیت این تستها به معنی ایمن بودن کامل سیستم Production نیست. لازم است رفتار Collector با قالب واقعی لاگها و شرایط امنیتی محیط نیز بررسی شود.
تست Prompt Injection
در یک فایل آزمایشی، متن غیرقابل اعتماد قرار دهید که سعی میکند Analyzer را به تغییر وظیفه ترغیب کند.
بررسی کنید این متن بهعنوان دستور اجرایی استفاده نمیشود و Analyzer همچنان فقط نشانههای خطا را گزارش میکند.
تست عدم دسترسی Root
حساب logagent را بررسی کنید و مطمئن شوید عضو گروههای مدیریتی یا گروههای گسترده خواندن Journal نیست.
id logagent

sudo -l -U logagent
خروجی باید توسط مدیر بررسی شود. داشتن حساب غیر Root بهتنهایی اثبات نمیکند تمام دسترسیهای جانبی محدود هستند.
نکات مهم برای راهاندازی AI Log Analyzer در Production
نمونه عملی این مقاله یک تحلیلگر آموزشی برای فایل مشخص است.
برای استفاده در سامانه واقعی باید چند قابلیت تکمیلی پیادهسازی شود.
۱. Collector مستقل از مدل
بهتر است Collector هیچ API Key مدل و هیچ مجوز اجرای عملیات مدیریتی نداشته باشد.
۲. مسیرهای منبع ثابت
فهرست فایلها و سرویسهای مجاز باید در تنظیمات محافظتشده نگهداری شوند.
۳. حفاظت از داده در انتقال
اگر لاگ از سرور دیگری جمعآوری میشود، انتقال باید با احراز هویت و رمزنگاری مناسب انجام شود.
۴. مدیریت Log Rotation
Collector باید تغییر Inode، فایل جدید و جابهجایی فایلهای قدیمی را مدیریت کند.
۵. Backpressure و محدودیت صف
اگر حجم خطاها ناگهان افزایش یابد، سیستم نباید تمام RAM یا فضای ذخیرهسازی را مصرف کند.
۶. نگهداری Cursor
برای جلوگیری از ازدسترفتن یا دوبارهشماری رخدادها، موقعیت خواندن باید بهصورت پایدار ثبت شود.
۷. تعریف سیاست Alert
هر خطای منفرد نباید الزاماً هشدار فوری ایجاد کند. بهتر است آستانهها براساس نرخ رخداد، نوع سرویس و اهمیت آن تنظیم شوند.
۸. جدا کردن Incident از Remediation
تشخیص خطا فقط باید پیشنهاد یا درخواست بررسی تولید کند. عملیات اصلاحی حساس باید در مسیر مجوز مستقل قرار بگیرند.
۹. کنترل هزینه مدل
به جای ارسال تکتک خطوط به LLM، دادهها را در بازههای زمانی مشخص تجمیع کنید.
۱۰. نگهداری شواهد برای Forensics
اگر احتمال حادثه امنیتی واقعی وجود دارد، لاگ خام باید در محل معتبر و قابل دسترسی برای افراد مجاز حفظ شود.
Redaction برای تحلیل با مدل نباید باعث حذف شواهد اصلی از سامانه ثبت وقایع شود.
اشتباهات رایج هنگام ساخت Agent بررسی لاگ
۱. دادن SSH یا Root به مدل
برای تحلیل لاگ ضروری نیست. یک Collector مستقل با دسترسی فقطخواندنی و محدود طراحی کنید.
۲. افزودن Agent به گروه adm
ممکن است دسترسی گستردهتری از نیاز ایجاد کند. بهتر است مجوز به فایل یا سرویس مشخص محدود باشد.
۳. ارسال لاگ خام به مدل
لاگ ممکن است شامل داده شخصی، Credential یا Prompt Injection باشد. Redaction و استخراج دادههای ساختاریافته را پیش از ارسال انجام دهید.
۴. اعتماد کامل به Regex Redaction
الگوهای نامعمول یا کدگذاریشده ممکن است از فیلتر عبور کنند. تست واقعی و حداقلسازی داده ضروری است.
۵. تبدیل متن لاگ به دستور سیستم
محتوای لاگ غیرقابل اعتماد است و نباید سیاست یا Tool Callهای Agent را تعیین کند.
۶. اعلام علت قطعی از روی یک خط
وجود یک نشانه به معنی اثبات علت اصلی نیست. گزارش باید شواهد و فرضیهها را جدا کند.
۷. ذخیره مکرر همان Incident
نمونه ساده در هر اجرا گزارش جدید ایجاد میکند. برای Production به Deduplication و Cursor نیاز دارید.
۸. نادیده گرفتن Rotation
ممکن است Collector بخشی از لاگ را از دست بدهد یا یک فایل را دوباره بخواند. تغییر فایل و Inode باید مدیریت شود.
۹. نبود محدودیت حجم
خواندن فایل بسیار بزرگ میتواند منابع برنامه را مصرف کند. حجم، تعداد خطوط و زمان پردازش را محدود کنید.
۱۰. اجرای خودکار پیشنهاد مدل
حتی یک پیشنهاد فنی منطقی ممکن است در شرایط واقعی خطرناک باشد. اجرای عملیات باید مستقل از تحلیل و همراه مجوز مناسب باشد.
۱۱. ثبت Secrets در Audit
Audit باید اطلاعات ضروری مانند نوع رخداد، زمان و وضعیت تصمیم را ثبت کند، نه متن خام دارای اطلاعات حساس.
۱۲. نداشتن تست Prompt Injection
لاگهای کنترلشده توسط کاربران یکی از مسیرهای ورود محتوای مخرب هستند. آزمون دفاع در برابر ورودیهای غیرقابل اعتماد ضروری است.
۱۳. ارسال تمام هشدارها به اپراتور
هشدارهای تکراری میتوانند باعث خستگی اپراتور شوند. تجمیع، اولویتبندی و تعیین آستانه مناسب اهمیت دارد.
۱۴. نداشتن مسیر Incident Workflow
تشخیص بدون رسیدگی کافی نیست. وضعیت حادثه، مسئول بررسی و نتیجه اقدامات باید قابل پیگیری باشند.
سؤالات متداول درباره AI Log Analyzer Server
AI Log Analyzer Server چیست؟
سیستمی برای جمعآوری و تحلیل کنترلشده لاگهای سرور است که میتواند خطاها را شناسایی کند و گزارش یا پیشنهاد بررسی ارائه دهد.
آیا برای ساخت Log Analyzer به Root Access نیاز داریم؟
خیر. میتوان Agent را با حساب محدود اجرا کرد و دسترسی خواندن را فقط به فایلهای مجاز اختصاص داد.
آیا بدون Root میتوان Journal را خواند؟
بعضی Journalها برای کاربران مجاز قابل مشاهدهاند؛ اما دسترسی کامل معمولاً به گروهها یا مجوزهای ویژه وابسته است. برای حداقل دسترسی بهتر است Collector اختصاصی طراحی شود.
آیا گروه systemd-journal برای Agent مناسب است؟
معمولاً برای یک Agent محدود مناسب نیست؛ زیرا میتواند دسترسی گسترده به Journalهای سیستم ایجاد کند.
Read-only Collector چیست؟
برنامهای است که داده را فقط از منابع مجاز میخواند و اجازه تغییر فایلهای اصلی را ندارد.
آیا Collector میتواند باعث قطع سرویس شود؟
جمعآوری بیش از حد نیز ممکن است منابع مصرف کند. به همین دلیل باید حجم خواندن، دوره اجرا و مصرف منابع محدود شوند.
Redaction چیست؟
حذف یا جایگزینی اطلاعات حساس مانند Token، رمز، آدرس ایمیل یا IP پیش از پردازش و انتقال است.
آیا Regex تمام Secrets را حذف میکند؟
خیر. برای دادههای حساس بهتر است فیلدهای مشخص استخراج شوند و از ارسال متن آزاد غیرضروری جلوگیری شود.
Prompt Injection در لاگ چگونه رخ میدهد؟
مهاجم متنی را وارد یک منبع ثبت لاگ میکند که هنگام خواندن توسط مدل تلاش کند رفتار آن را تغییر دهد.
آیا فقط قرار دادن لاگ داخل علامت نقلقول کافی است؟
خیر. جدا کردن متن از دستور مفید است، اما باید محدودیت ابزار، کنترل خروجی و جداسازی مجوز نیز وجود داشته باشد.
آیا AI Agent میتواند خطای 502 را تشخیص دهد؟
میتواند نشانه خطا را شناسایی کند، اما برای تعیین علت نهایی ممکن است بررسی Backend، منابع و وضعیت شبکه لازم باشد.
آیا Agent میتواند حملات ورود ناموفق SSH را گزارش دهد؟
بله. میتوان تعداد رخدادهای احراز هویت ناموفق را ثبت کرد؛ اما تعیین حمله واقعی نیازمند تحلیل زمینه و شواهد بیشتر است.
آیا AI Log Analyzer باید IP کاربران را به مدل بفرستد؟
لزوماً خیر. در بسیاری از گزارشها تعداد رخدادها کافی است. دادههای هویتی باید فقط در صورت ضرورت و با مجوز مناسب پردازش شوند.
آیا میتوان Analyzer را به OpenAI API متصل کرد؟
بله. بهتر است مدل فقط دادههای ساختاریافته و پاکسازیشده را دریافت کند و هیچ ابزار مدیریتی در اختیار نداشته باشد.
آیا AI Log Analyzer به GPU نیاز دارد؟
اگر مدل از طریق API اجرا شود، معمولاً GPU محلی لازم نیست.
آیا SQLite برای پروژه کافی است؟
برای نمونه آموزشی و بار محدود مناسب است. برای حجم بالا و چند Worker، PostgreSQL یا سامانه اختصاصی مدیریت رخداد میتواند مناسبتر باشد.
Incident Workflow چیست؟
گردش کاری برای ثبت، اولویتبندی، بررسی، پاسخ و پیگیری رخدادهای شناساییشده است.
آیا Agent باید سرویس خراب را خودکار Restart کند؟
در معماری این مقاله خیر. Agent فقط تحلیل و گزارش تولید میکند و عملیات حساس در مسیر جداگانه دارای مجوز انجام میشوند.
چگونه جلوی هشدارهای تکراری را بگیریم؟
با مدیریت Cursor، تجمیع رخدادها، Deduplication و تعریف آستانههای مناسب.
آیا Systemd Timer برای بررسی دورهای مناسب است؟
بله. میتوان Collector یا Analyzer را در بازههای مشخص اجرا کرد، مشروط به اینکه تکرار خواندن و محدودیت منابع مدیریت شود.
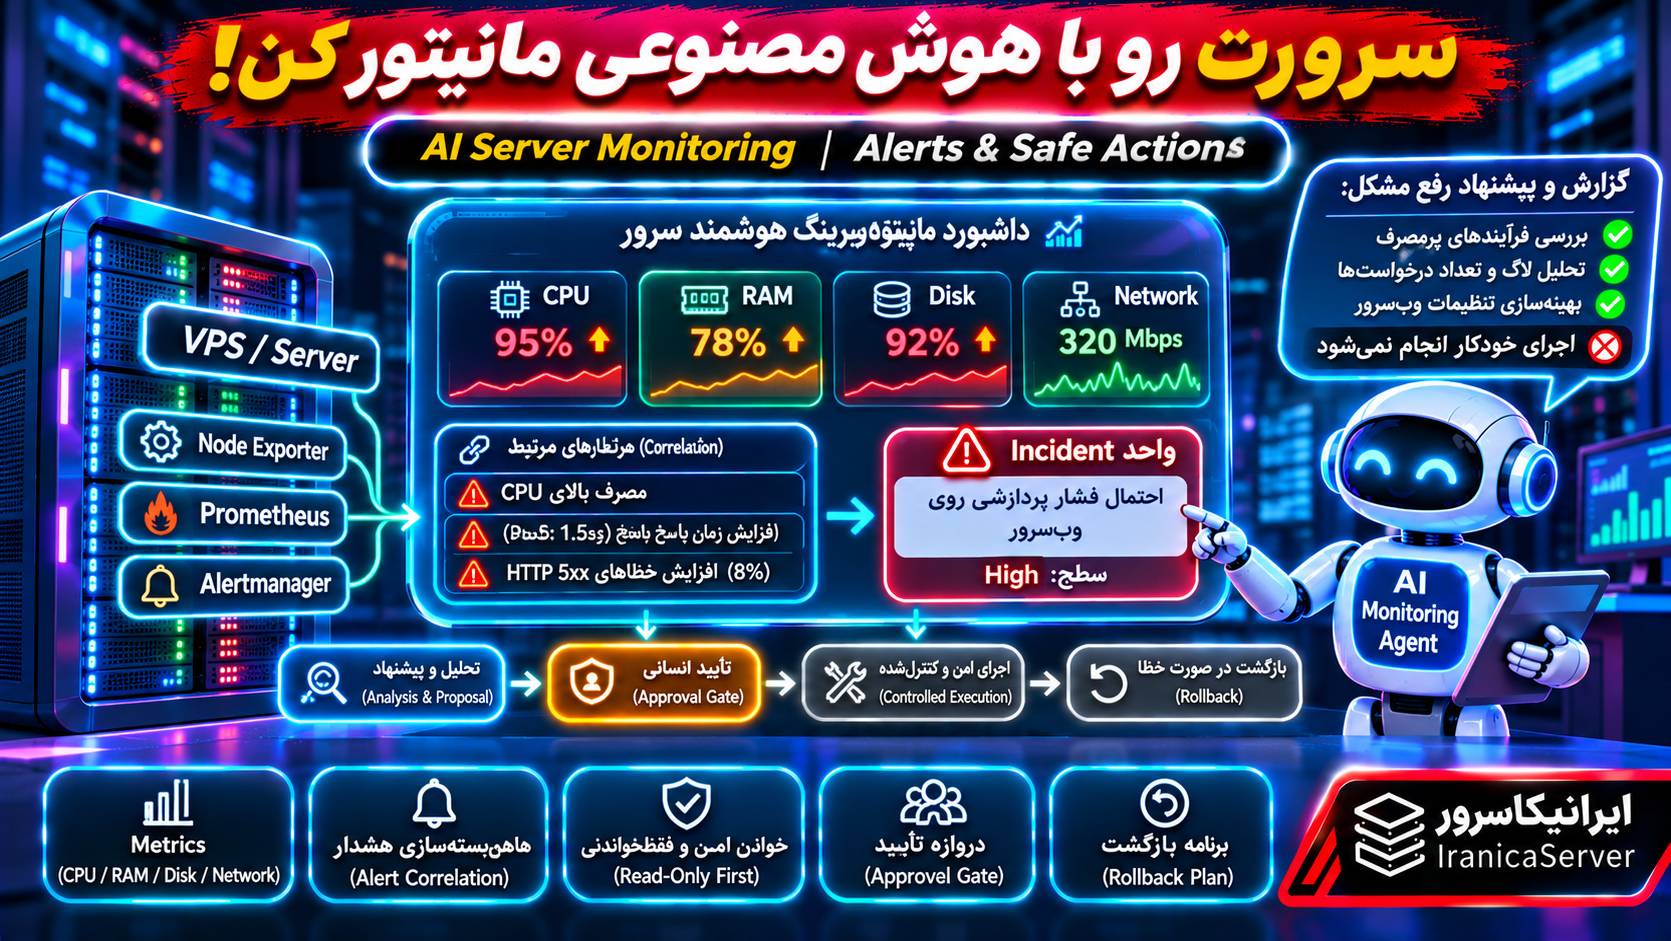
آیا AI Log Analyzer جایگزین مانیتورینگ سرور است؟
خیر. تحلیل لاگ مکمل ابزارهای مانیتورینگ منابع، سلامت سرویس و شبکه است.
چگونه دقت Agent را اندازه بگیریم؟
با مجموعه رخدادهای دارای برچسب معتبر، اندازهگیری خطاهای مثبت و منفی، دقت دستهبندی و کیفیت پیشنهادهای بررسی.
آیا میتوان لاگ سرورهای مختلف را تحلیل کرد؟
بله. اما برای چند سرور باید احراز هویت Collector، انتقال امن، جداسازی منابع و مدیریت حجم داده طراحی شود.
آیا میتوان از این سیستم برای سرور بازی استفاده کرد؟
بله. با Parser و الگوهای مناسب میتوان Crash، خطاهای اتصال و توقف فرآیند سرور بازی را شناسایی کرد.
مهمترین اصل امنیتی در ساخت AI Log Analyzer چیست؟
جدا نگه داشتن دسترسی خواندن لاگ، تحلیل مدل و اجرای عملیات مدیریتی؛ همراه با اصل حداقل دسترسی و فرض غیرقابل اعتماد بودن متن لاگ.
جمعبندی
ساخت AI Log Analyzer Server میتواند بررسی خطاهای VPS، وبسرور، دیتابیس و سرویسهای اختصاصی را سادهتر کند؛ اما برای رسیدن به یک سیستم قابل اعتماد لازم نیست دسترسی کامل سرور را به هوش مصنوعی بدهیم.
در این آموزش یک معماری مبتنی بر Read-only Collector طراحی کردیم که فقط فایلهای مجاز را میخواند، دادههای حساس رایج را حذف میکند، نشانههای خطا را دستهبندی میکند و نتیجه را در قالب Incident Report ذخیره میکند.
همچنین بررسی کردیم که لاگها ممکن است حامل Prompt Injection باشند؛ بنابراین متن آنها نباید به دستورهای مورد اعتماد Agent تبدیل شود.
برای اتصال به مدل هوش مصنوعی نیز بهتر است از اطلاعات ساختاریافته مانند شمارنده خطاها و نوع رخداد استفاده شود، نه ارسال بیقیدوشرط فایلهای خام.
درنهایت، Agent باید بتواند مشکل احتمالی را گزارش کند، اما هر اقدام حساس مانند Restart، تغییر Firewall یا حذف فایل باید توسط یک مسیر اجرایی مجاز و قابل بررسی انجام شود.
اصل نهایی: برای ساخت Agent تحلیل لاگ، خواندن محدود و پردازش امن دادهها کافی است؛ دسترسی Root نباید پیشنیاز هوشمندسازی مانیتورینگ سرور باشد.
اگر قصد دارید اجرای عملیات حساس Agent را نیز کنترل کنید، راهنمای ساخت Human-in-the-Loop برای AI Agent را مطالعه کنید. برای جلوگیری از ذخیره اطلاعات حساس و قدیمی در حافظه Agent نیز مقاله معماری حافظه AI Agent مفید است.
منابع و مستندات رسمی
۱. systemd — journalctl
مرجع رسمی نحوه خواندن Journal، فیلتر Unitها و محدودیتهای دسترسی.
۲. systemd — Journald Access Control
توضیح مجوزهای فایل Journal و دسترسی گروههای سیستمی.
۳. systemd — Service Hardening
تنظیمات امنیتی Service شامل NoNewPrivileges و محدودیت فایلسیستم.
۴. OWASP — LLM Prompt Injection Prevention
روشهای مقابله با Prompt Injection غیرمستقیم در Log، Tool Output و سایر دادههای غیرقابل اعتماد.
راهنمای پیشگیری از Prompt Injection
۵. OWASP — Logging Cheat Sheet
اصول ثبت رخدادها، حذف دادههای محرمانه و حفاظت از فایلهای لاگ.
۶. OWASP — AI Agent Security
اصل حداقل دسترسی، کنترل ابزارها و مرزهای امنیتی در Agentها.
۷. NIST — Incident Response SP 800-61 Rev. 3
نسخه سوم راهنمای مدیریت رخداد امنیتی در چارچوب Cybersecurity Risk Management که در آوریل ۲۰۲۵ منتشر شده است.
راهنمای رسمی NIST Incident Response
۸. OpenAI — Safety Best Practices
توصیههای رسمی درباره محدودیت ابزارها، Red Teaming و نظارت انسانی.
۹. OpenAI — Agent Safety
روشهای کاهش خطر دادههای غیرقابل اعتماد، Structured Outputs و ابزارهای حساس.
۱۰. Python — sqlite3
مرجع رسمی کار با پایگاه داده SQLite در Python.
۱۱. Linux — logrotate
مستندات ابزار چرخش و مدیریت فایلهای لاگ.
دیدگاهها (۰)