
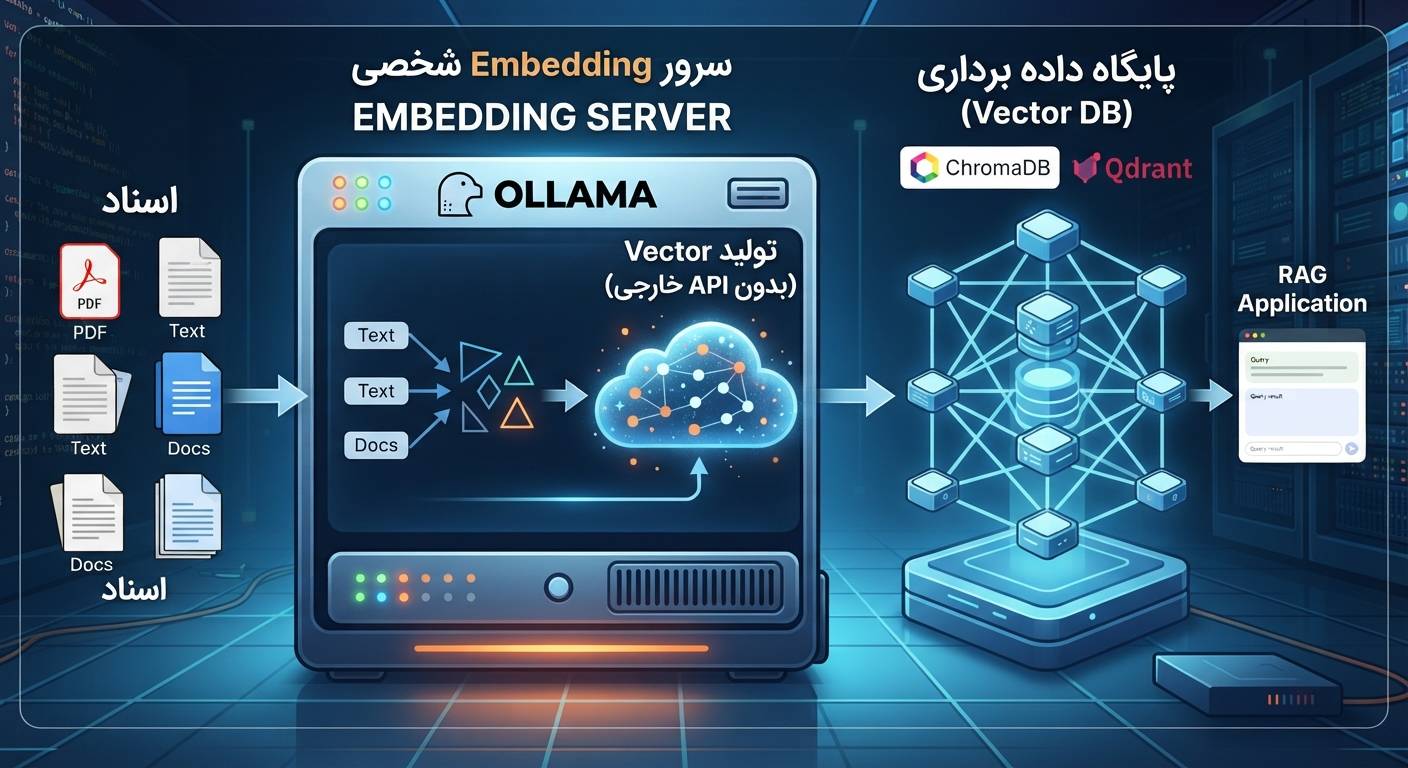
اگر روی پروژههای هوش مصنوعی، دستیار سازمانی یا چتبات مبتنی بر اسناد داخلی کار میکنید، حتماً با چالش Embedding مواجه شدهاید. سرویسهایی مثل OpenAI یا Cohere خیلی سریع هستند، اما وقتی پای اسناد محرمانه شرکت، قراردادهای مالی یا دیتای مشتریان وسط باشد، فرستادن آنها به API خارجی ریسک جدی است. از طرف دیگر هزینهی هر توکن در مقیاس بزرگ واقعاً سنگین میشود.
راهحل؟ یک سرور Embedding شخصی روی VPS خودتان. در این مقاله قدمبهقدم میسازیمش. مدل BGE-M3 را به عنوان موتور اصلی انتخاب میکنیم، یک API با FastAPI بالا میآوریم و به یک Vector Database وصلش میکنیم. همهچیز Self-hosted، خصوصی و مقرونبهصرفه.
🔹 در این راهنما یاد میگیرید:
🔹 Embedding چیست و چرا برای RAG حیاتی است
🔹 چطور یک سرور Embedding اختصاصی روی Ubuntu 24.04 راهاندازی کنید
🔹 مدل BGE-M3 را با FastAPI سرو کنید
🔹 با Docker همهچیز را قابل حمل و تکرارپذیر کنید
🔹 Vector Database را به سرویس Embedding متصل کنید
Embedding چیست و چه نقشی در RAG دارد؟
Embedding فرآیندی است که متن را به یک بردار عددی تبدیل میکند. این بردار معنای متن را در یک فضای چندبعدی رمزگذاری میکند. جملههایی که معنای مشابهی دارند، بردارهایشان به هم نزدیکتر است.
در معماری RAG (Retrieval Augmented Generation)، این کار حیاتی است. بدون Embedding، سیستم نمیتواند بفهمد سؤال کاربر با کدام بخش از اسناد شما ارتباط دارد. فرآیند به این شکل است:
وقتی کاربر میپرسد «شرایط فسخ قرارداد چیه؟»، سیستم سؤال را به بردار تبدیل میکند، نزدیکترین بخشهای سند را در Vector Database پیدا میکند و آنها را به عنوان Context به LLM میدهد. بدون Embedding، این جستجوی معنایی ممکن نیست.
چرا Embedding را روی سرور شخصی اجرا کنیم؟
سه دلیل اصلی وجود دارد که کسبوکارها را به سمت Self-hosting سوق میدهد:
⚠️ حریم خصوصی: وقتی اسناد شما شامل قرارداد، اطلاعات مشتری یا کد اختصاصی است، ارسال آن به API خارجی ریسک امنیتی جدی است.
⚠️ هزینه: در مقیاس هزاران سند و میلیونها درخواست، هزینه API میتواند سرسامآور شود.
⚠️ کنترل: با مدل متنباز، محدودیت Rate Limit، تغییر قیمت یا قطع سرویس خارجی ندارید.
علاوه بر این، یک سرور Embedding شخصی پایهی ساخت PrivateGPT، چتبات سازمانی، دستیار دانش داخلی و موتور جستجوی معنایی اختصاصی است.
انتخاب مدل Embedding: چرا BGE-M3؟
مدلهای زیادی وجود دارند، اما BAAI/bge-m3 برای پروژههای فارسی و چندزبانه انتخاب هوشمندانهای است. این مدل توسط تیم BAAI توسعه داده شده و ویژگیهای منحصربهفردی دارد :
🔹 چندزبانه: از بیش از ۱۰۰ زبان پشتیبانی میکند و روی فارسی هم عملکرد خوبی دارد
🔹 چندگرانولی: از جملات کوتاه تا اسناد ۸۱۹۲ توکنی را پردازش میکند
🔹 چندعملکردی: هم Dense Retrieval، هم Sparse Retrieval و هم Multi-Vector را همزمان انجام میدهد
🔹 حجم معقول: حدود ۲.۲۷ گیگابایت فضای دیسک نیاز دارد
مدلهای جایگزین مثل multilingual-e5-large یا paraphrase-multilingual هم گزینههای خوبی هستند، اما BGE-M3 تعادل بهتری بین کیفیت، سرعت و پشتیبانی زبانی ارائه میدهد.
نکته مهم: اگر فقط با اسناد انگلیسی کار میکنید، BAAI/bge-base-en-v1.5 با حجم ۴۴۰ مگابایت و دقت بالا انتخاب بهینهتری است .
مشخصات VPS موردنیاز
منابع موردنیاز به مدل و حجم پردازش بستگی دارد. یک جدول مقایسهای آماده کردهام:
| سناریو | CPU | RAM | Storage |
|---|---|---|---|
| تست و پروژه شخصی | ۴ هسته | ۸GB | ۴۰GB SSD |
| سازمانی (BGE-M3) | ۸ هسته | ۱۶–۳۲GB | NVMe SSD |
| با GPU (اختیاری) | — | ۱۶GB+ | RTX 3090 / 4090 |
برای شروع، یک VPS با Ubuntu 24.04، حداقل ۴ هسته CPU و ۸ گیگابایت رم کافی است. اگر تعداد اسناد بالای ۱۰,۰۰۰ سند میرود، ۱۶ گیگابایت رم توصیه میشود.
گامبهگام: راهاندازی سرور Embedding
۱. آمادهسازی سیستم
ابتدا سیستم را بروزرسانی کنید و پایتون را نصب کنید:
sudo apt install python3 python3-pip python3-venv -y
python3 –version
۲. ساخت محیط مجازی
python3 -m venv venv
source venv/bin/activate
۳. نصب کتابخانهها
۴. ساخت API با FastAPI
یک فایل به نام app.py بسازید:
from sentence_transformers import SentenceTransformer
app = FastAPI()
model = SentenceTransformer(“BAAI/bge-m3”)
@app.post(“/embedding”)
def create_embedding(text: str):
vector = model.encode(text)
return {“vector”: vector.tolist()}
نکته: مدل BGE-M3 در اولین اجرا دانلود میشود (حدود ۲.۲۷ گیگابایت). برای محیطهای Production، حجم دانلود را جداگانه کش کنید.
۵. اجرا و تست
حالا API شما روی http://SERVER_IP:8000 فعال است. تست کنید:
اتصال به Vector Database
Vectorها باید جایی ذخیره شوند. گزینههای محبوب:
| دیتابیس | مناسب برای | منابع پیشنهادی |
|---|---|---|
| ChromaDB | پروژههای کوچک، تست، توسعه سریع | ۲GB RAM |
| Qdrant | پروژههای حرفهای، حجم زیاد | ۴GB RAM+ |
| Milvus | پروژههای بزرگ AI | ۸GB RAM+ |
برای شروع ChromaDB سریعترین گزینه است. نصب و استفاده:
import chromadb
client = chromadb.Client()
collection = client.create_collection(“docs”)
collection.add(embeddings=[vector], documents=[text], ids=[“id1”])
اگر به دنبال یک دیتابیس Vector قویتر با قابلیتهای فیلترینگ پیشرفته هستید، Qdrant انتخاب بهتری است .
🚀 زیرساخت هوش مصنوعی اختصاصی خود را روی سرور مجازی ایرانیکاسرور بسازید
برای اجرای مدلهای Embedding، Vector Database و سیستمهای RAG، به یک VPS با منابع اختصاصی، دیسک NVMe پرسرعت و پهنای باند پایدار نیاز دارید. ایرانیکاسرور با ۱۷ سال تجربه، سرورهای مجازی ایران و خارج را با منابع کاملاً اختصاصی، آپتایم ۹۹.۹٪ و پشتیبانی ۲۴/۷ ارائه میدهد.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
اجرای سرور با Docker
برای محیط Production، Docker بهترین گزینه است. یک Dockerfile بسازید:
WORKDIR /app
COPY requirements.txt .
RUN pip install –no-cache-dir -r requirements.txt
COPY app.py .
CMD [“uvicorn”, “app:app”, “–host”, “0.0.0.0”, “–port”, “8000”]
و requirements.txt:
fastapi
uvicorn
ساخت و اجرا:
docker run -d -p 8000:8000 –name embed embedding-server
اگر نمیخواهید از صفر بسازید، پروژه hwdsl2/docker-embeddings یک Image آماده با API سازگار OpenAI ارائه میدهد که از مدلهایی مثل BGE-M3 و BGE-Reranker پشتیبانی میکند .
مشکلات رایج و راهحلها
⚠️ مصرف زیاد RAM
BGE-M3 حدود ۱ گیگابایت رم برای Inference نیاز دارد. اگر رم کم است، از BAAI/bge-small-en-v1.5 با ۲۵۰ مگابایت رم استفاده کنید .
⚠️ سرعت پایین تولید Vector
از Batch Processing استفاده کنید. مدل را یکبار لود کنید و لیستی از متنها را همزمان Encode کنید. برای حجم بالا، GPU یا مدل Quantized (نسخه Q8_0) انتخاب بهتری است .
⚠️ کیفیت پایین جستجوی فارسی
مطمئن شوید از مدل چندزبانه استفاده میکنید، نه فقط انگلیسی. BGE-M3 و multilingual-e5-large گزینههای مناسب فارسی هستند. اندازه Chunk را هم تنظیم کنید (معمولاً ۵۰۰ تا ۱۰۰۰ کاراکتر).
مقایسه API خارجی و سرور شخصی
| ویژگی | API خارجی | سرور شخصی |
|---|---|---|
| هزینه | به ازای هر توکن | ماهانه ثابت |
| حریم خصوصی | محدود | کامل |
| کنترل مدل | کم | زیاد |
| سرعت | وابسته به اینترنت | داخلی، پایدار |
| مناسب سازمان | متوسط | عالی |
کاربردهای واقعی
این زیرساخت برای چه پروژههایی استفاده میشود؟
✅ چت با PDFها و اسناد شرکت
✅ موتور جستجوی معنایی داخلی
✅ دستیار هوشمند سازمانی (PrivateGPT)
✅ سیستم مدیریت دانش
✅ تحلیل قراردادها و اسناد حقوقی
✅ جستجو در سورس کدها
✅ Agentهای AI اختصاصی
سوالات متداول
آیا BGE-M3 روی فارسی خوب کار میکند؟
بله. BGE-M3 از بیش از ۱۰۰ زبان پشتیبانی میکند و روی فارسی نتایج قابل قبولی دارد . اگر تمرکز شما فقط فارسی است، میتوانید مدلهای فارسی اختصاصی مثل heydariAI/persian-embeddings را هم امتحان کنید .
حداقل VPS برای شروع چقدر است؟
برای BGE-M3 روی CPU، یک VPS با ۴ هسته و ۸ گیگابایت رم کافی است. اگر تعداد درخواستها بالاست یا مدل بزرگتری اجرا میکنید، ۱۶ گیگابایت رم توصیه میشود.
آیا میتوانم از GPU استفاده کنم؟
بله. PyTorch و Sentence Transformers از CUDA پشتیبانی میکنند. اگر GPU در دسترس باشد، سرعت Encode چندین برابر میشود. اما برای شروع و حجم متوسط، CPU کافی است.
چطور API را امن کنم؟
API Key اضافه کنید، با Nginx و SSL (Let’s Encrypt) ترافیک را رمزنگاری کنید و در صورت امکان IP Whitelist بگذارید. پروژه docker-embeddings از API Key با Bearer Token پشتیبانی میکند .
آیا میتوانم از OpenAI Embedding API هم استفاده کنم؟
بله، اگر مدل شما OpenAI-compatible باشد (مثل پروژه docker-embeddings)، میتوانید کلاینت OpenAI را به سرور خودتان Point کنید و از همان کد قبلی استفاده کنید .
جمعبندی
ساخت یک سرور Embedding شخصی روی VPS، کلید استقلال در پروژههای RAG است. با BGE-M3، FastAPI و یک Vector Database ساده، میتوانید بدون API خارجی و با حفظ حریم خصوصی کامل، سیستم جستجوی معنایی خودتان را راهاندازی کنید.
برای شروع، یک سرور مجازی با منابع کافی انتخاب کنید، مدل را با Docker اجرا کنید و مرحلهبهمرحله پیش بروید. اگر به کمک نیاز دارید، تیم پشتیبانی ایرانیکاسرور آماده راهنمایی است.
📌 مشکل دارید؟ درخواست کانفیگ بدهید
اگر در راهاندازی سرور Embedding، نصب مدل یا اتصال به Vector Database به مشکل خوردهاید، تیم فنی ما کمکتان میکند. کافی است درخواست خود را از طریق صفحه کانفیگ ارسال کنید یا با پشتیبانی تماس بگیرید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.