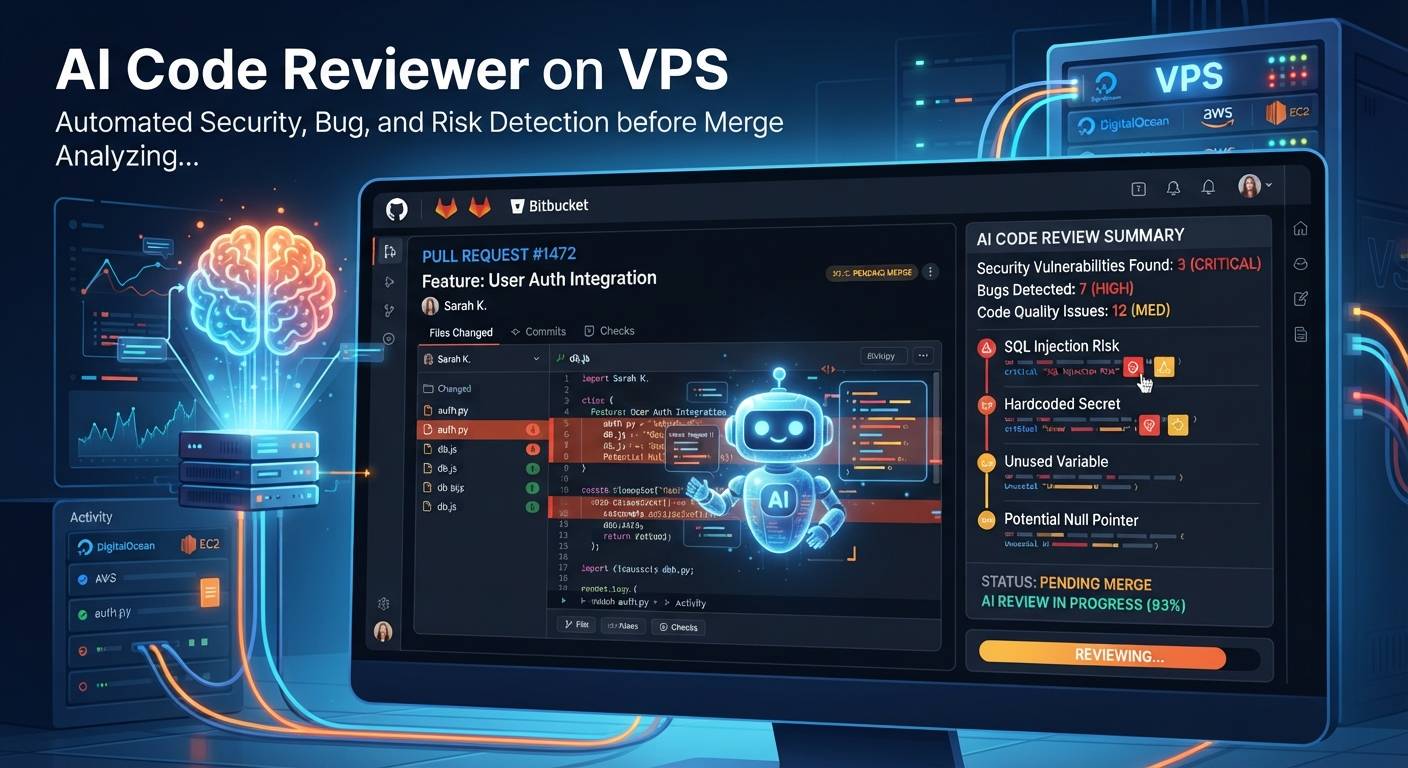
فرض کنید یک توسعهدهنده Pull Request را برای پروژه باز کرده است. کد ظاهراً درست اجرا میشود، تستها هم سبز هستند، اما داخل تغییرات یک Query ناامن، یک شرط اشتباه، Memory Leak یا یک تغییر ناسازگار با معماری پروژه قرار گرفته است. اگر تیم کوچک باشد، ممکن است Reviewer انسانی ساعتها بعد به این PR برسد.
اینجاست که AI Pull Request Review میتواند بهعنوان یک لایه بررسی اولیه وارد فرآیند شود. هدف این سیستم جایگزین کردن کامل برنامهنویس نیست؛ هدف این است که قبل از رسیدن کد به مرحله Merge، تغییرات مشکوک زودتر دیده شوند.
در روزهای اخیر پروژههای متنباز و Self-hosted بیشتری روی همین ایده تمرکز کردهاند. برای نمونه، Proval یک Agent بررسی کد Self-hosted است که از GitHub، GitLab و Forgejo پشتیبانی میکند و میتواند از مدلهای محلی یا APIهای سازگار با OpenAI استفاده کند. :contentReference[oaicite:0]{index=0}
چرا بررسی خودکار Pull Request اهمیت دارد؟
Code Review سنتی هنوز بخش مهمی از توسعه نرمافزار است، اما همیشه سریع و یکدست نیست. وقتی تعداد PRها افزایش پیدا میکند، Reviewer باید همزمان چند موضوع را بررسی کند؛ از منطق برنامه گرفته تا امنیت، Performance، تست، Dependency و اثر تغییرات روی بخشهای دیگر پروژه.
یک AI Reviewer خوب میتواند این موارد را بهصورت اولیه بررسی کند:
🔹 خطاهای منطقی و شرطهای اشتباه
🔹 مشکلات احتمالی امنیتی مانند SQL Injection یا افشای Secret
🔹 تغییرات پرریسک در Authentication و Authorization
🔹 مشکلات Performance و مصرف غیرضروری منابع
🔹 تستهای ناقص یا تغییراتی که بدون Test اضافه شدهاند
🔹 ناسازگاری با الگوی موجود پروژه
🔹 تغییرات مشکوک در فایلهای Configuration و Infrastructure
نکته مهم این است که AI نباید هر تفاوتی را بهعنوان Bug اعلام کند. سیستم مناسب باید بتواند بین یک تغییر واقعی، یک پیشنهاد سلیقهای و یک ریسک جدی تفاوت بگذارد. در غیر این صورت، تعداد هشدارهای اشتباه زیاد میشود و تیم بعد از مدتی کامنتهای Bot را نادیده میگیرد.
معماری AI Code Reviewer روی VPS چگونه است؟
برای ساخت سیستم، بهتر است چند وظیفه را از هم جدا کنیم. VPS نقش مرکز اجرای سرویس را دارد و GitHub یا GitLab فقط رویداد Pull Request را به آن ارسال میکند.
| بخش | وظیفه | منبع |
|---|---|---|
| GitHub / GitLab | تشخیص Pull Request و ارسال Webhook | Git Provider |
| AI Reviewer | دریافت Diff، تحلیل و تولید Finding | VPS |
| LLM | تحلیل کد و استدلال درباره تغییرات | Ollama یا API |
| Docker | اجرای ایزوله سرویسها | VPS لینوکس |
| HTTPS | دریافت امن Webhook | Nginx + SSL |
GitHub برای GitHub Appها امکان دریافت Webhook مربوط به Pull Request را فراهم میکند و App میتواند بعد از دریافت رویداد، از API برای ارسال Comment یا Review استفاده کند. همچنین GitHub توصیه میکند Permissionهای App تا حد ممکن محدود و فقط به نیاز واقعی سرویس اختصاص داده شوند. :contentReference[oaicite:1]{index=1}
چه ابزاری برای این پروژه انتخاب کنیم؟
در این مقاله از معماری Self-hosted AI Code Review استفاده میکنیم و برای نمونه عملی، Proval را در نظر میگیریم. این پروژه در حال توسعه است و در حال حاضر از GitHub، GitLab و Forgejo پشتیبانی میکند. طبق مستندات پروژه، Proval میتواند با مدلهای محلی مانند Ollama و llama.cpp یا APIهای سازگار با OpenAI کار کند. :contentReference[oaicite:2]{index=2}
مزیت این رویکرد این است که Reviewer را از سرویس اصلی Git جدا میکنید. در نتیجه میتوانید VPS را به یک نقطه مرکزی برای چند Repository تبدیل کنید.
⚠️ نکته: Self-hosted بودن به معنی بدون هزینه بودن نیست. اگر مدل را روی VPS اجرا کنید، CPU، RAM یا GPU مصرف میشود. اگر مدل را از API دریافت کنید، هزینه پردازش مدل به هزینه VPS اضافه خواهد شد.
حداقل منابع VPS برای AI Code Review
منابع موردنیاز کاملاً به روش اجرای مدل بستگی دارد. اگر فقط Agent را روی VPS اجرا کنید و مدل را از یک API خارجی بگیرید، نیاز سختافزاری بسیار کمتر است. اما اگر بخواهید مدل را نیز روی همان VPS اجرا کنید، RAM و در صورت استفاده از مدلهای بزرگ، GPU اهمیت زیادی پیدا میکند.
| سناریو | CPU | RAM | دیسک | مدل |
|---|---|---|---|---|
| Reviewer + API | 2 تا 4 هسته | 4 تا 8 GB | 40 تا 60 GB SSD/NVMe | ابری |
| Reviewer + مدل محلی کوچک | 4 تا 8 هسته | 16 تا 32 GB | 80 تا 150 GB NVMe | Local |
| مدل Coding بزرگ | بسته به مدل | 32 GB به بالا | 150 GB به بالا | GPU یا RAM بالا |
برای نمونه، صفحه رسمی Ollama برای Qwen3-Coder نسخه 30B را با حجم حدود 19GB معرفی میکند و Context Window آن را 256K Token اعلام میکند. نسخههای بزرگتر این مدل به منابع بسیار بیشتری نیاز دارند؛ بنابراین اجرای مدل محلی بزرگ روی یک VPS معمولی تصمیم مناسبی نیست. :contentReference[oaicite:3]{index=3}
مرحله اول؛ آمادهسازی VPS لینوکس
برای این پروژه بهتر است از یک VPS لینوکس تمیز استفاده کنید. Ubuntu و Debian گزینههای مناسبی برای اجرای Docker و سرویسهای AI هستند.
sudo apt update
sudo apt upgrade -y
sudo apt install -y curl git ca-certificates
اگر Docker روی VPS نصب نیست، ابتدا Docker Engine را طبق مستندات توزیع خود نصب کنید و سپس Compose را فعال کنید. مستندات رسمی Docker نصب افزونه Compose از Repository را برای Ubuntu و Debian نیز توضیح میدهد. :contentReference[oaicite:4]{index=4}
docker --version
docker compose version
مرحله دوم؛ نصب AI Code Reviewer با Docker
Proval برای Docker Compose یک روش ساده ارائه میکند. نمونه زیر بر اساس ساختار پیشنهادی خود پروژه تنظیم شده است.
mkdir -p ~/ai-code-reviewer
cd ~/ai-code-reviewer
nano docker-compose.yml
محتوای Compose را به شکل زیر قرار دهید:
services:
  proval:
    image: ghcr.io/seoes/proval:latest
    ports:
      - "7900:7900"
      - "7901:7901"
    volumes:
      - ./data:/data
    environment:
      - ENCRYPTION_KEY=CHANGE_THIS_SECRET
برای ساخت کلید رمزنگاری، خود پروژه استفاده از یک مقدار تصادفی تولیدشده با OpenSSL را پیشنهاد میکند. :contentReference[oaicite:5]{index=5}
openssl rand -base64 32
خروجی را در فایل Compose قرار دهید و سرویس را اجرا کنید:
docker compose up -d
docker compose ps
در معماری Proval، پورت Dashboard و پورت Webhook از یکدیگر جدا هستند. مستندات پروژه برای Docker Compose نیز همین ساختار را نشان میدهد. :contentReference[oaicite:6]{index=6}
مرحله سوم؛ اتصال مدل هوش مصنوعی
حالا بخش مهم سیستم مشخص میشود: Reviewer باید بداند برای تحلیل Pull Request از کدام مدل استفاده کند.
اگر VPS شما GPU ندارد، دو معماری منطقی دارید. در حالت اول مدل را از API دریافت میکنید و VPS فقط وظیفه Orchestration و Review را انجام میدهد. در حالت دوم از یک VPS قدرتمندتر برای اجرای مدل محلی استفاده میکنید.
Ollama یک API محلی ارائه میکند و مدلهای مخصوص Coding مانند Qwen3-Coder را در Library خود دارد. برای نمونه، دستور اجرای مدل در مستندات رسمی Ollama به شکل زیر است. :contentReference[oaicite:7]{index=7}
ollama run qwen3-coder:30b
در عمل، انتخاب مدل باید بر اساس حجم Repository، اندازه Diff، تعداد PRها، سرعت پاسخ و منابع VPS انجام شود. برای PRهای کوچک لازم نیست همیشه بزرگترین مدل موجود را اجرا کنید.
📌 پیشنهاد معماری:
🔹 VPS اول: Webhook و AI Reviewer
🔹 VPS دوم یا GPU Server: مدل Local
🔹 ارتباط داخلی: API امن بین Reviewer و Model Server
🔹 GitHub/GitLab: فقط ارسال Event و دریافت نتیجه Review
سرور مناسب برای اجرای AI Code Review
وقتی Pull Requestهای تیم زیاد میشوند، سرعت دیسک، CPU، RAM و پایداری شبکه مستقیماً روی زمان بررسی اثر میگذارند. برای اجرای Reviewer، Docker و سرویسهای جانبی، یک سرور مجازی ایران با منابع اختصاصی میتواند محیط کنترلشدهای برای اجرای دائمی سرویس ایجاد کند.
ایرانیکاسرور امکان انتخاب سرویسهای VPS را برای سناریوهای مختلف فراهم میکند تا بتوانید منابع موردنیاز AI، Webhook و سرویسهای توسعه را جدا از سیستم شخصی خود اجرا کنید.
📞 تماس با پشتیبانی: 021-91302467 | ایرانیکاسرور
مرحله چهارم؛ ساخت GitHub App برای دریافت Pull Request
برای اینکه سیستم بدون دخالت دستی متوجه باز شدن PR شود، باید GitHub را به Reviewer متصل کنیم. GitHub App میتواند Webhook دریافت کند و پس از دریافت رویداد، API مربوط به Pull Request را فراخوانی کند. :contentReference[oaicite:8]{index=8}
در GitHub به بخش Settings → Developer settings → GitHub Apps بروید و یک App جدید ایجاد کنید.
تنظیمات اصلی GitHub App:
🔹 یک نام مشخص مانند AI-PR-Reviewer انتخاب کنید.
🔹 Webhook را فعال کنید.
🔹 Webhook URL را روی Endpoint عمومی Reviewer قرار دهید.
🔹 یک Webhook Secret تصادفی تعیین کنید.
🔹 Permission مربوط به Pull Requests را فقط به اندازه نیاز سرویس فعال کنید.
🔹 Event مربوط به Pull Request را فعال کنید.
مستندات GitHub برای یک GitHub App نمونه نیز استفاده از Pull Request Permission، Webhook و امکان ارسال Comment به PR را نشان میدهد. GitHub همچنین توصیه میکند App فقط حداقل Permissionهای لازم را دریافت کند. :contentReference[oaicite:9]{index=9}
مرحله پنجم؛ قرار دادن Webhook پشت HTTPS
Webhook را نباید روی یک HTTP ساده و بدون محافظ رها کنید. GitHub برای Webhook URL از HTTPS و SSL Verification پشتیبانی میکند و در تنظیم GitHub App نیز فعال بودن SSL Verification توصیه شده است. :contentReference[oaicite:10]{index=10}
فرض کنیم Reviewer روی پورت 7901 اجرا شده و دامنه شما review.example.com است. Nginx میتواند درخواستهای HTTPS را به سرویس داخلی منتقل کند.
server {
    listen 443 ssl;
    server_name review.example.com;

```
location / {
    proxy_pass http://127.0.0.1:7901;
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
    proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    proxy_set_header X-Forwarded-Proto $scheme;
}
```

}
نام دامنه و مسیر را متناسب با سرویس خود تغییر دهید. سپس SSL را با یک گواهی معتبر فعال کنید.
AI دقیقاً چه چیزی را داخل Pull Request بررسی میکند؟
یکی از اشتباهات رایج این است که فقط Diff را به مدل بدهیم و بگوییم «کد را بررسی کن». این روش برای Repositoryهای واقعی همیشه کافی نیست. AI باید تا حد امکان Context مناسب داشته باشد.
| لایه بررسی | سؤال AI | اهمیت |
|---|---|---|
| Correctness | آیا منطق جدید رفتار اشتباهی ایجاد میکند؟ | بالا |
| Security | آیا ورودی یا Permission ناامن شده است؟ | بحرانی |
| Performance | آیا Query، Loop یا عملیات جدید هزینه غیرضروری دارد؟ | متوسط تا بالا |
| Testing | آیا رفتار جدید Test مناسب دارد؟ | بالا |
| Maintainability | آیا تغییر جدید با ساختار پروژه هماهنگ است؟ | متوسط |
پرومپت مناسب برای AI Code Reviewer
کیفیت خروجی فقط به مدل وابسته نیست. دستور بررسی باید از AI بخواهد که از ایجاد هشدارهای سلیقهای خودداری کند و برای هر Finding، دلیل فنی ارائه دهد.
You are an automated senior code reviewer.

Review only the actual changes introduced by this pull request,
but inspect surrounding code when needed to understand behavior.

Focus on:

1. Correctness bugs
2. Security vulnerabilities
3. Data loss or corruption risks
4. Performance regressions
5. Concurrency and race conditions
6. Missing validation
7. Broken error handling
8. Missing or inadequate tests

Do not report:

* Pure style preferences
* Minor naming preferences
* Hypothetical issues without evidence
* Problems unrelated to the changed code

For every finding provide:

* Severity
* File and line
* Why it is a real problem
* A concise fix suggestion

If no meaningful issue exists, say so clearly.
این نوع Prompt باعث میشود مدل به جای تولید یک لیست طولانی از پیشنهادهای کمارزش، روی Findingهای قابل اقدام تمرکز کند.
Severity را چگونه طراحی کنیم؟
اگر همه هشدارها اهمیت یکسان داشته باشند، Review خیلی زود تبدیل به Noise میشود. بهتر است Findingها بر اساس اثر واقعی دستهبندی شوند.
Critical: احتمال جدی برای آسیب امنیتی، از دست رفتن داده یا خرابی گسترده.
High: Bug مهم یا ریسک قابل توجه که باید پیش از Merge بررسی شود.
Medium: مشکل واقعی که در شرایط خاص میتواند اثر بگذارد.
Low: پیشنهاد یا ایرادی با اثر محدود که مانع Merge نیست.
در GitHub API امکان ارسال Review با وضعیتهایی مانند APPROVE، REQUEST_CHANGES و COMMENT وجود دارد. بنابراین میتوان معماری را طوری طراحی کرد که فقط Findingهای جدی به Review رسمی تبدیل شوند و موارد کماهمیت صرفاً بهصورت Comment نمایش داده شوند. :contentReference[oaicite:11]{index=11}
چگونه AI را به خطهای دقیق کد متصل کنیم؟
یک Reviewer حرفهای نباید فقط بنویسد «در فایل auth.php مشکل امنیتی وجود دارد». بهتر است Finding دقیقاً کنار خط مربوط به تغییر نمایش داده شود.
GitHub برای Pull Request Review Comment API امکان ایجاد Comment روی Diff را فراهم کرده است. برای Commentهای چندخطی نیز API پارامترهای مربوط به Line و Side را ارائه میکند. :contentReference[oaicite:12]{index=12}
به این ترتیب تجربه کاربر شبیه یک Code Review انسانی میشود: توسعهدهنده روی همان خط مشکل را میبیند، توضیح AI را میخواند و تغییر لازم را انجام میدهد.
بررسی فقط Diff کافی نیست؛ Repository Context مهم است
فرض کنید PR یک تابع را از فایل A تغییر داده، اما رفتار آن تابع به Interface موجود در فایل B وابسته است. اگر AI فقط Diff را ببیند ممکن است متوجه اثر تغییر نشود.
برای همین، سیستمهای جدیدتر AI Code Review به سمت Agentهایی حرکت کردهاند که علاوه بر Diff میتوانند بخشهای مرتبط Repository را نیز بررسی کنند. نمونههایی از پروژههای Self-hosted جدید، معماریهایی شامل RAG، چند Agent تخصصی و تحلیل Context را ارائه میکنند. :contentReference[oaicite:13]{index=13}
یک Pipeline حرفهای میتواند این ترتیب را داشته باشد:
🔹 دریافت Pull Request
🔹 استخراج Diff
🔹 شناسایی فایلهای تغییرکرده
🔹 پیدا کردن فایلها و توابع وابسته
🔹 اجرای تحلیل امنیتی و Correctness
🔹 اجرای Test یا Static Analysis در صورت نیاز
🔹 ارسال Findingهای قابل اثبات
🔹 تولید Summary نهایی برای Reviewer انسانی
ترکیب AI Review با تست و CI/CD
AI نباید جایگزین Test Suite، Linter، SAST یا Dependency Scanner شود. هرکدام یک نوع مسئله را بهتر پوشش میدهند.
| ابزار | تمرکز | نقش AI |
|---|---|---|
| Unit Tests | رفتار قابل آزمایش | پیدا کردن Caseهای فراموششده |
| Linter | قواعد Syntax و Style | تمرکز روی منطق و Context |
| SAST | الگوهای امنیتی شناختهشده | تفسیر Context و کاهش Noise |
| AI Reviewer | منطق، Context و ریسک | تحلیل تغییرات و توضیح انسانی |
آیا میتوان Merge را به نتیجه AI وابسته کرد؟
از نظر فنی میتوان Review Bot را بخشی از CI/CD کرد، اما بهتر است از ابتدا یک قاعده محافظهکارانه داشته باشید. AI ممکن است False Positive یا False Negative داشته باشد.
⚠️ پیشنهاد عملی:
🔹 Findingهای Critical را نیازمند بررسی انسانی کنید.
🔹 Findingهای High را در Branch Protection جدی بگیرید.
🔹 Findingهای Medium را بهصورت Comment یا Check نمایش دهید.
🔹 Findingهای Low را مانع Merge نکنید.
🔹 هیچوقت صرفاً بر اساس یک پاسخ متنی AI کد را خودکار Merge نکنید.
امنیت VPS و Secretهای GitHub را جدی بگیرید
این سرویس برخلاف یک Chatbot معمولی با کد واقعی، Repository و Tokenهای GitHub سروکار دارد. بنابراین امنیت آن باید بخشی از معماری باشد، نه کاری که بعداً انجام شود.
🔹 Secretها را داخل Repository ذخیره نکنید.
🔹 برای GitHub App فقط Permissionهای لازم را فعال کنید.
🔹 Webhook را پشت HTTPS قرار دهید.
🔹 Dashboard را مستقیماً روی اینترنت باز نگذارید مگر اینکه Authentication مناسب داشته باشد.
🔹 دسترسی SSH سرور را محدود و لاگها را بررسی کنید.
🔹 Docker Container را با دسترسی غیرضروری به Host اجرا نکنید.
🔹 برای Repositoryهای حساس، مدل Local یا Endpoint خصوصی را در نظر بگیرید.
GitHub نیز در مستندات مربوط به App Permission تأکید میکند که باید حداقل دسترسی لازم را انتخاب کرد. این اصل برای AI Reviewer اهمیت بیشتری دارد، چون سرویس عملاً به محتوای Repository دسترسی پیدا میکند. :contentReference[oaicite:14]{index=14}
چه زمانی مدل Local بهتر از API است؟
| معیار | مدل Local | API خارجی |
|---|---|---|
| حریم خصوصی | کنترل بیشتر روی داده | وابسته به Provider |
| هزینه اولیه | نیازمند منابع VPS/GPU | هزینه زیرساخت کمتر |
| مدیریت | مسئولیت با شماست | سادهتر |
| مقیاسپذیری | وابسته به سختافزار | وابسته به محدودیت Provider |
| کنترل | بسیار بالا | وابسته به سرویس |
چگونه مصرف منابع AI Code Reviewer را کنترل کنیم؟
اگر برای هر Push یک Review کامل روی کل Repository اجرا شود، مصرف Token و CPU میتواند سریع بالا برود. طراحی Trigger اهمیت زیادی دارد.
🔹 فقط زمانی Review را اجرا کنید که PR باز یا آماده Review شده باشد.
🔹 در Pushهای کوچک، فقط تغییرات جدید را بررسی کنید.
🔹 برای فایلهای مستندات Review کامل AI را غیرفعال کنید.
🔹 فایلهای Lock و Generated Code را از تحلیل سنگین خارج کنید.
🔹 حداکثر اندازه Diff را مشخص کنید.
🔹 Reviewهای همزمان را Queue کنید.
برخی Agentهای Self-hosted جدید نیز از همین ایده استفاده میکنند و Review را بر اساس Pushهای معنادار، تغییرات جدید یا Triggerهای مشخص اجرا میکنند. :contentReference[oaicite:15]{index=15}
یک خروجی خوب از AI Review چه شکلی است؟
خروجی خوب نباید یک متن چند هزار کلمهای باشد. توسعهدهنده باید بتواند در چند ثانیه بفهمد چه چیزی مشکل دارد و چه اقدامی لازم است.
نمونه ساختار خروجی:
Severity: High
File: src/auth/login.ts
Problem: ورودی کاربر بدون اعتبارسنجی کافی وارد مسیر احراز هویت شده است.
Why: در شرایط مشخص میتواند باعث عبور داده نامعتبر از لایه اعتبارسنجی شود.
Suggested fix: ورودی را قبل از ورود به منطق Authentication اعتبارسنجی کنید و Test مربوط به حالت نامعتبر را اضافه کنید.
آیا این سیستم برای تیمهای کوچک هم کاربرد دارد؟
بله، اتفاقاً در تیمهای کوچک، یک Reviewer خودکار میتواند نقش یک لایه دوم بررسی را داشته باشد. اما بهتر است از ابتدا آن را بهعنوان Reviewer کمکی تعریف کنید، نه یک مدیر خودکار Merge.
برای یک تیم دو یا سه نفره میتوان ابتدا فقط Security، Correctness و Regressionهای مهم را بررسی کرد. بعد از جمع شدن دادههای واقعی، Prompt و قوانین Review را بر اساس خطاهایی که واقعاً در پروژه رخ دادهاند اصلاح کنید.
اگر در راهاندازی VPS یا Docker به مشکل خوردید
اگر Webhook دریافت نمیشود، Docker Container بالا نمیآید، پورتها در دسترس نیستند یا تنظیمات سرویس AI روی VPS با مشکل مواجه شده است، میتوانید از بخش کانفیگ و رفع مشکل ایرانیکاسرور کمک بگیرید.
📞 تماس با پشتیبانی: 021-91302467 | ایرانیکاسرور
سناریوی کامل اجرای پروژه
اگر بخواهیم کل سیستم را از ابتدا تا انتها ساده کنیم، جریان کار چنین خواهد بود:
🔹 توسعهدهنده یک Branch ایجاد میکند.
🔹 تغییرات را Push میکند.
🔹 Pull Request باز میشود.
🔹 GitHub Webhook را به VPS میفرستد.
🔹 AI Reviewer اطلاعات PR و Diff را دریافت میکند.
🔹 Agent فایلهای مرتبط Repository را بررسی میکند.
🔹 مدل زبانی مشکلات واقعی را تحلیل میکند.
🔹 Findingها با Severity مشخص میشوند.
🔹 Comment یا Review روی PR قرار میگیرد.
🔹 توسعهدهنده مشکل را اصلاح میکند.
🔹 CI دوباره اجرا میشود.
🔹 Reviewer انسانی تصمیم نهایی را میگیرد.
این معماری را میتوان بعداً توسعه داد و به جای یک مدل ساده، چند Agent تخصصی برای Security، Performance، Testing و Architecture ایجاد کرد. پروژههای جدید Self-hosted در همین مسیر حرکت کردهاند و از چند متخصص برای تحلیل بخشهای مختلف Pull Request استفاده میکنند. :contentReference[oaicite:16]{index=16}
محدودیتهایی که نباید فراموش کنید
AI Code Review هرچقدر هم قوی باشد، یک ابزار احتمالاتی است. ممکن است یک Bug را نبیند یا چیزی را اشتباه تفسیر کند. به همین دلیل، معماری درست باید چند لایه داشته باشد.
⚠️ AI نباید جایگزین Test Suite شود.
⚠️ Finding بدون Evidence نباید بهعنوان Bug قطعی معرفی شود.
⚠️ Secret و Token را داخل Prompt یا Log ذخیره نکنید.
⚠️ مدل Local نیز نیازمند مدیریت منابع و بهروزرسانی است.
⚠️ برای Repositoryهای حساس، مسیر خروج داده را قبل از انتخاب مدل بررسی کنید.
جمعبندی؛ ساخت Reviewer هوشمند روی VPS
ساخت یک AI Pull Request Reviewer دیگر فقط یک ایده آزمایشی نیست. امروز میتوان GitHub یا GitLab را با یک Agent Self-hosted روی VPS، یک مدل زبانی و Webhook به هم متصل کرد و یک لایه بررسی خودکار برای کد ایجاد کرد.
برای شروع، معماری سادهتر یعنی Git Provider + Webhook + AI Reviewer + API Model انتخاب مناسبی است. اگر حریم خصوصی و کنترل داده اهمیت بیشتری داشته باشد، میتوان مدل Coding را نیز روی زیرساخت خودتان و با ابزارهایی مانند Ollama اجرا کرد.
نقطه مهم این پروژه، بزرگترین مدل ممکن نیست؛ بلکه طراحی درست فرآیند Review است. AI باید فقط Findingهای قابل اثبات را گزارش کند، Context کافی داشته باشد، با CI/CD ترکیب شود و در نهایت تصمیم Merge همچنان تحت کنترل تیم توسعه باقی بماند.
برای اجرای دائمی چنین سرویسهایی، VPS با منابع پایدار، دیسک سریع، شبکه مناسب و دسترسی مدیریتی کامل میتواند پایه مناسبی برای AI Infrastructure تیم توسعه باشد.
VPS برای اجرای AI، Docker و ابزارهای توسعه
اگر قصد دارید AI Code Reviewer، Ollama، Docker، Webhook، CI/CD یا سرویسهای توسعه را بهصورت ۲۴ ساعته اجرا کنید، منابع سرور را متناسب با حجم Repository و مدل مورد استفاده انتخاب کنید. ایرانیکاسرور سرویسهای سرور مجازی را برای سناریوهای مختلف در اختیار شما قرار میدهد.
📞 تماس با پشتیبانی: 021-91302467 | ایرانیکاسرور
سؤالات متداول درباره AI Code Review
آیا میتوان AI Code Reviewer را روی VPS اجرا کرد؟
بله. میتوان سرویس Reviewer را روی VPS لینوکس اجرا کرد و آن را از طریق Webhook به GitHub یا GitLab متصل کرد. مدل نیز میتواند روی همان سرور، یک سرور جدا یا یک API خارجی اجرا شود.
آیا برای AI Code Review حتماً GPU لازم است؟
خیر. اگر مدل را از API دریافت کنید، VPS میتواند بدون GPU هم Reviewer را اجرا کند. برای اجرای مدلهای بزرگ بهصورت Local، GPU یا RAM و CPU قدرتمند اهمیت بیشتری پیدا میکند.
آیا AI میتواند Pull Request را خودش Merge کند؟
از نظر فنی میتوان فرآیندهای خودکار بیشتری ایجاد کرد، اما برای کدهای واقعی بهتر است AI ابتدا نقش Reviewer داشته باشد و تصمیم نهایی Merge تحت کنترل فرآیند انسانی و CI/CD باقی بماند.
آیا مدل Local برای بررسی کد مناسب است؟
مدلهای Coding قابل اجرا با Ollama میتوانند برای این سناریو استفاده شوند. مزیت اصلی مدل Local کنترل بیشتر روی مسیر داده است، اما باید منابع سختافزاری و کیفیت مدل را نیز در نظر گرفت.
Proval چیست؟
Proval یک AI Code Review Agent متنباز و Self-hosted است که برای GitHub، GitLab و Forgejo طراحی شده و میتواند با مدلهای Local یا APIهای سازگار با OpenAI کار کند.
آیا AI Code Review جایگزین برنامهنویس میشود؟
خیر. بهترین استفاده، قرار دادن AI بهعنوان یک لایه بررسی اولیه و کمکی در کنار تست، CI/CD، ابزارهای امنیتی و Reviewer انسانی است.
منابع رسمی و مطالعه بیشتر:
مستندات و مخزن Proval در GitHub

دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.