
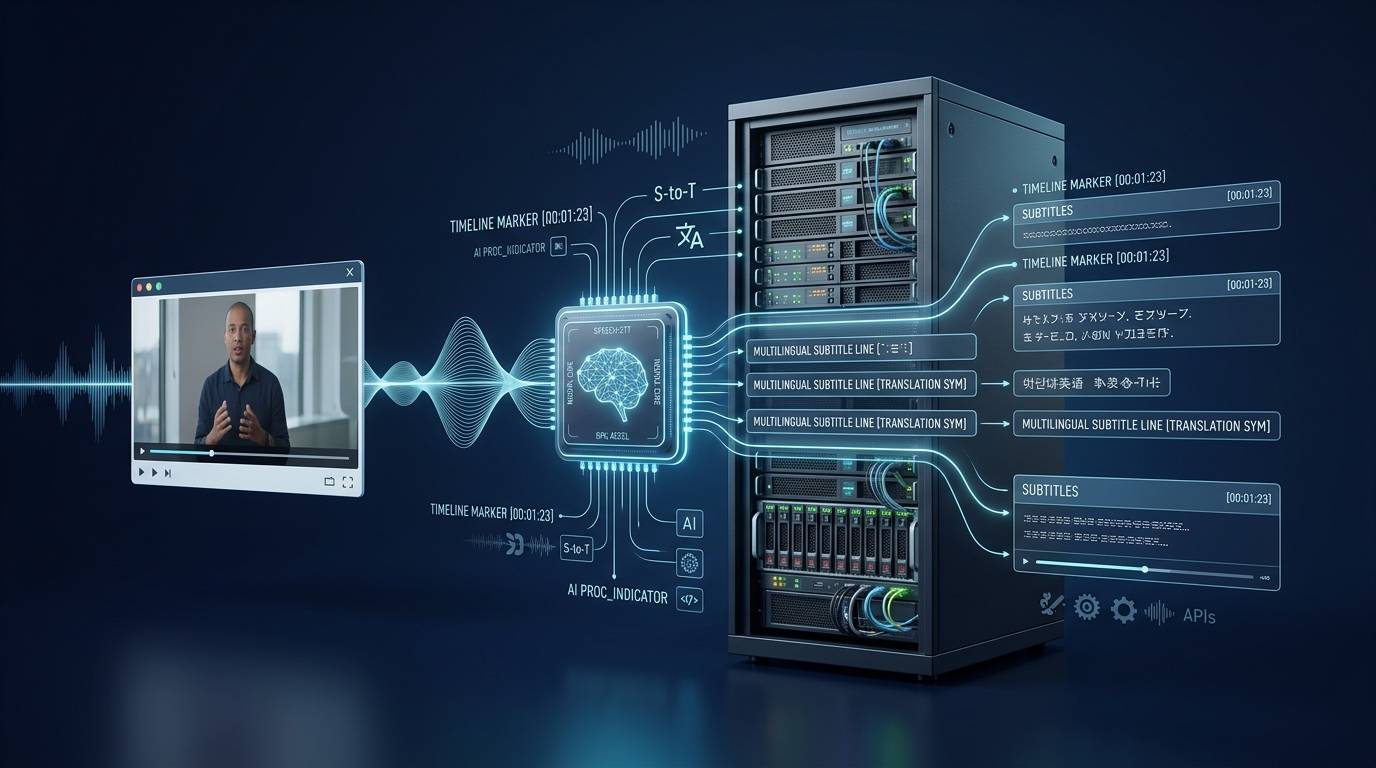
اگر تولیدکننده محتوا هستید، دوره آموزشی میسازید، برای شبکههای اجتماعی ویدیو منتشر میکنید یا قصد دارید یک سرویس SaaS برای تولید زیرنویس راهاندازی کنید، تبدیل دستی ویدیو به متن یکی از زمانبرترین بخشهای کار است. در این آموزش یک معماری عملی برای ساخت سرویس زیرنویس و ترجمه ویدیو روی VPS میسازیم که میتواند فایل ویدیویی را دریافت کند، صدای آن را استخراج کند، با Whisper گفتار را به متن تبدیل کند، زمانبندی جملهها را نگه دارد و در نهایت فایل زیرنویس SRT یا WebVTT تولید کند.
نکته مهم این معماری این است که پردازش اصلی روی سرور خودتان انجام میشود. بنابراین میتوانید آن را به یک پنل آپلود، API اختصاصی، سیستم عضویت یا حتی یک سرویس SaaS تبدیل کنید. در ادامه علاوه بر نصب اولیه، درباره انتخاب VPS، GPU، مدیریت صف پردازش، ترجمه چندزبانه، امنیت فایلهای کاربران و مقیاسپذیری هم صحبت میکنیم.
📌 در این آموزش چه چیزی میسازیم؟
یک سرویس اولیه Video/Speech AI که ویدیو را دریافت میکند، صدا را استخراج میکند، با faster-whisper متن و زمانبندی را تولید میکند و خروجی SRT میدهد. سپس معماری را برای ترجمه و تبدیل به سرویس SaaS آماده میکنیم.
ساختار سرویس زیرنویس هوش مصنوعی چگونه است؟
برای اینکه سرویس از همان ابتدا قابل توسعه باشد، بهتر است همه کارها را در یک اسکریپت بزرگ قرار ندهیم. جریان پیشنهادی به این شکل است:
🔹 مرحله ۱: کاربر فایل ویدیو را آپلود میکند.
🔹 مرحله ۲: سرور فایل را در فضای موقت ذخیره میکند.
🔹 مرحله ۳: FFmpeg صدای مناسب برای پردازش را استخراج میکند.
🔹 مرحله ۴: faster-whisper گفتار را تشخیص میدهد.
🔹 مرحله ۵: متن همراه با زمان شروع و پایان هر بخش ذخیره میشود.
🔹 مرحله ۶: در صورت نیاز، متن برای موتور ترجمه ارسال میشود.
🔹 مرحله ۷: SRT، VTT یا JSON نهایی تولید میشود.
🔹 مرحله ۸: کاربر فایل زیرنویس را دانلود میکند.
این تفکیک بعداً اجازه میدهد بخشهایی مانند صف پردازش، پنل کاربری، پرداخت، محدودیت تعداد دقیقه و حتی چند سرور GPU را بدون بازنویسی کل سیستم اضافه کنید.
Whisper دقیقاً چه کاری انجام میدهد؟
Whisper یک مدل تشخیص گفتار چندمنظوره است که برای Speech Recognition، شناسایی زبان و Speech Translation طراحی شده است. نسخههای چندزبانه میتوانند گفتار را به متن همان زبان تبدیل کنند و قابلیت ترجمه گفتار به انگلیسی نیز دارند. :contentReference[oaicite:0]{index=0}
برای اجرای سرویس روی VPS، در این مقاله از faster-whisper استفاده میکنیم. این پروژه پیادهسازی Whisper بر پایه CTranslate2 است و طبق مستندات پروژه میتواند نسبت به پیادهسازی اصلی در شرایط مشخص سرعت بالاتر و مصرف حافظه کمتری داشته باشد. اجرای ۸ بیتی نیز برای کاهش مصرف حافظه در نظر گرفته شده است. :contentReference[oaicite:1]{index=1}
⚠️ یک تفاوت مهم در ترجمه
Whisper بهصورت مستقیم قابلیت Speech Translation به انگلیسی دارد. اگر مثلاً بخواهید یک ویدیوی انگلیسی را به فارسی، آلمانی یا ترکی ترجمه کنید، بهتر است یک مرحله Translation جداگانه به معماری اضافه کنید. این کار باعث میشود موتور تشخیص گفتار و موتور ترجمه مستقل باشند و بعداً بتوانید هر کدام را جداگانه ارتقا دهید. :contentReference[oaicite:2]{index=2}
چه VPS برای سرویس زیرنویس ویدیو مناسب است؟
پردازش ویدیو با پردازش یک API معمولی فرق دارد. فایل ممکن است چند صد مگابایت یا حتی چند گیگابایت باشد و مدل هوش مصنوعی نیز CPU، RAM، فضای ذخیرهسازی و در حالت GPU به VRAM نیاز دارد.
| نوع سرویس | پیشنهاد منابع | کاربرد |
|---|---|---|
| تست و توسعه | 4 vCPU، 8GB RAM، NVMe | ویدیوهای کوتاه و مدلهای سبک |
| سرویس کوچک | 8 vCPU، 16GB RAM، NVMe | پردازش CPU و تعداد محدود کاربران |
| پردازش GPU | GPU، RAM مناسب و NVMe | تولید زیرنویس سریعتر و پردازش همزمان |
| SaaS پرترافیک | چند Worker و یک یا چند GPU | صف پردازش و کاربران همزمان |
این اعداد «نسخه عملی برای شروع» هستند، نه حداقل رسمی مدل. سرعت واقعی به مدل انتخابی، طول و کیفیت صدا، تعداد کاربران همزمان، تنظیمات پردازش و سختافزار بستگی دارد. خود پروژه faster-whisper نیز بنچمارکهای متفاوتی برای مدلها و سختافزارهای مختلف ارائه میکند. :contentReference[oaicite:3]{index=3}
سرور مناسب برای پردازش ویدیوهای AI
اگر قرار است سرویس زیرنویس را از حالت تست خارج کنید، منابع CPU، RAM و مخصوصاً فضای NVMe اهمیت زیادی پیدا میکنند. برای مدلهای سنگینتر یا پردازش همزمان، سرور GPU میتواند معماری مناسبتری باشد.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
نصب پیشنیازها روی Ubuntu
در این آموزش Ubuntu 22.04 یا 24.04 را بهعنوان محیط نمونه در نظر میگیریم. ابتدا سیستم را بهروزرسانی کنید.
sudo apt update
sudo apt upgrade -y
sudo apt install -y python3 python3-venv python3-pip ffmpeg git
FFmpeg برای کار با فایلهای صوتی و ویدیویی استفاده میشود. مستندات رسمی FFmpeg ابزارهایی مانند ffmpeg و ffprobe و امکانات مربوط به انتخاب Stream، تبدیل رسانه و زیرنویس را پوشش میدهد. :contentReference[oaicite:4]{index=4}
ساخت پروژه Python برای سرویس Video AI
sudo mkdir -p /opt/video-subtitle
sudo chown -R $USER:$USER /opt/video-subtitle
cd /opt/video-subtitle

python3 -m venv .venv
source .venv/bin/activate

pip install --upgrade pip
نصب کتابخانهها
pip install fastapi uvicorn python-multipart faster-whisperfaster-whisper طبق مستندات پروژه با Python نسخه 3.9 یا بالاتر قابل استفاده است و برای GPU به کتابخانههای NVIDIA مانند cuBLAS و cuDNN نیاز دارد. :contentReference[oaicite:5]{index=5}
انتخاب مدل Whisper
برای تست اولیه لازم نیست از سنگینترین مدل شروع کنید. مدلهای Whisper از اندازههای کوچک تا مدلهای بزرگتر ارائه شدهاند و انتخاب مدل بین سرعت، حافظه و کیفیت تعادل ایجاد میکند. :contentReference[oaicite:6]{index=6}
| مدل | هدف پیشنهادی | فشار منابع |
|---|---|---|
| tiny | آزمایش و نمونه اولیه | کم |
| base | سرویس سبک | کم تا متوسط |
| small | کیفیت بهتر برای سرویس عمومی | متوسط |
| medium | کیفیت بالاتر | زیاد |
| large-v3 | پردازش حرفهای و چندزبانه | زیاد |
برای اولین تست میتوانید با small شروع کنید و بعد بر اساس دقت، زمان پردازش و منابع سرور مدل را تغییر دهید. فهرست مدلهای قابل استفاده در نسخههای جدید faster-whisper شامل مدلهایی مانند large-v3 و مدلهای distil نیز میشود. :contentReference[oaicite:7]{index=7}
ساخت API آپلود ویدیو
اکنون یک API ساده میسازیم. FastAPI برای دریافت فایل، کلاس UploadFile دارد و این روش برای فایلهای بزرگ مناسبتر از نگهداشتن کامل فایل در حافظه است. :contentReference[oaicite:8]{index=8}
nano app.pyکد زیر یک نمونه MVP است. برای محیط واقعی بهتر است وضعیت Job و صف پردازش در Redis یا دیتابیس ذخیره شود.
import os
import uuid
import subprocess
from pathlib import Path

from fastapi import FastAPI, UploadFile, BackgroundTasks, HTTPException
from fastapi.responses import FileResponse
from faster_whisper import WhisperModel

BASE_DIR = Path("/opt/video-subtitle")
UPLOAD_DIR = BASE_DIR / "uploads"
OUTPUT_DIR = BASE_DIR / "outputs"

UPLOAD_DIR.mkdir(parents=True, exist_ok=True)
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)

app = FastAPI(title="AI Video Subtitle API")

MODEL_SIZE = os.getenv("WHISPER_MODEL", "small")
DEVICE = os.getenv("WHISPER_DEVICE", "cpu")
COMPUTE_TYPE = os.getenv("WHISPER_COMPUTE", "int8")

model = WhisperModel(
    MODEL_SIZE,
    device=DEVICE,
    compute_type=COMPUTE_TYPE
)

jobs = {}


def timestamp(seconds: float) -> str:
    hours = int(seconds // 3600)
    minutes = int((seconds % 3600) // 60)
    secs = int(seconds % 60)
    millis = int((seconds - int(seconds)) * 1000)

    return f"{hours:02d}:{minutes:02d}:{secs:02d},{millis:03d}"


def write_srt(segments, output_path):
    with open(output_path, "w", encoding="utf-8") as f:
        for index, segment in enumerate(segments, start=1):
            f.write(f"{index}\n")
            f.write(
                f"{timestamp(segment.start)} --> "
                f"{timestamp(segment.end)}\n"
            )
            f.write(segment.text.strip())
            f.write("\n\n")


def process_video(job_id: str, video_path: Path):
    audio_path = UPLOAD_DIR / f"{job_id}.wav"
    srt_path = OUTPUT_DIR / f"{job_id}.srt"

    try:
        jobs[job_id]["status"] = "extracting_audio"

        subprocess.run(
            [
                "ffmpeg",
                "-y",
                "-i",
                str(video_path),
                "-vn",
                "-ac",
                "1",
                "-ar",
                "16000",
                "-c:a",
                "pcm_s16le",
                str(audio_path),
            ],
            check=True,
            stdout=subprocess.DEVNULL,
            stderr=subprocess.DEVNULL,
        )

        jobs[job_id]["status"] = "transcribing"

        segments, info = model.transcribe(
            str(audio_path),
            vad_filter=True
        )

        segments = list(segments)

        write_srt(segments, srt_path)

        jobs[job_id]["status"] = "completed"
        jobs[job_id]["language"] = info.language
        jobs[job_id]["subtitle"] = str(srt_path)

    except Exception as exc:
        jobs[job_id]["status"] = "failed"
        jobs[job_id]["error"] = str(exc)

    finally:
        if audio_path.exists():
            audio_path.unlink()

        if video_path.exists():
            video_path.unlink()


@app.post("/jobs")
async def create_job(
    file: UploadFile,
    background_tasks: BackgroundTasks
):
    if not file.filename:
        raise HTTPException(status_code=400, detail="File name is required")

    job_id = uuid.uuid4().hex
    extension = Path(file.filename).suffix.lower() or ".mp4"
    video_path = UPLOAD_DIR / f"{job_id}{extension}"

    with open(video_path, "wb") as buffer:
        while chunk := await file.read(1024 * 1024):
            buffer.write(chunk)

    jobs[job_id] = {
        "status": "queued"
    }

    background_tasks.add_task(
        process_video,
        job_id,
        video_path
    )

    return {
        "job_id": job_id,
        "status": "queued"
    }


@app.get("/jobs/{job_id}")
def get_job(job_id: str):
    if job_id not in jobs:
        raise HTTPException(status_code=404, detail="Job not found")

    return jobs[job_id]


@app.get("/jobs/{job_id}/subtitle")
def download_subtitle(job_id: str):
    if job_id not in jobs:
        raise HTTPException(status_code=404, detail="Job not found")

    if jobs[job_id].get("status") != "completed":
        raise HTTPException(
            status_code=409,
            detail="Subtitle is not ready"
        )

    return FileResponse(
        jobs[job_id]["subtitle"],
        media_type="application/x-subrip",
        filename=f"{job_id}.srt"
    )
اجرای API
cd /opt/video-subtitle
source .venv/bin/activate

uvicorn app:app --host 0.0.0.0 --port 8000
اکنون API روی پورت 8000 اجرا میشود. برای تست میتوانید از ابزارهایی مانند curl یا مستندات خودکار FastAPI استفاده کنید.
curl -X POST \
  -F "file=@video.mp4" \
  http://SERVER_IP:8000/jobs
پاسخ چیزی شبیه این خواهد بود:
{
  "job_id": "8b7f...",
  "status": "queued"
}
سپس وضعیت Job را بررسی کنید:
curl http://SERVER_IP:8000/jobs/JOB_IDچرا پردازش را به Background Task منتقل کردیم؟
تبدیل یک ویدیوی طولانی به متن ممکن است چند ثانیه یا چند دقیقه طول بکشد. بنابراین نباید کاربر را مجبور کنیم همان درخواست HTTP را تا پایان پردازش باز نگه دارد.
FastAPI امکان اجرای Background Task بعد از پاسخ را دارد. مستندات رسمی نیز پردازش فایل را یکی از نمونههای این کاربرد معرفی میکند؛ با این حال برای محاسبات سنگین و صفهای بزرگ، خود FastAPI توصیه میکند به سراغ راهکارهای بزرگتر مانند Celery و یک Queue بروید. :contentReference[oaicite:9]{index=9}
⚠️ نکته مهم برای SaaS
دیکشنری Python در کد بالا فقط برای MVP مناسب است. اگر سرویس را با چند Worker اجرا کنید، وضعیت Job بین پردازشها قابل اتکا نیست. برای محصول واقعی از Redis، PostgreSQL و Celery یا یک Queue مشابه استفاده کنید.
ساخت زیرنویس SRT چگونه انجام میشود؟
هر قطعه SRT از سه بخش اصلی تشکیل میشود: شماره، زمان شروع و پایان و متن. نکته مهم این است که Whisper علاوه بر متن، زمان شروع و پایان Segment را نیز در اختیار برنامه قرار میدهد و همین اطلاعات برای تولید زیرنویس زمانبندیشده استفاده میشود.
برای مثال خروجی میتواند به شکل زیر باشد:
1
00:00:01,200 --> 00:00:04,600
Welcome to our video.

2
00:00:04,800 --> 00:00:08,300
Today we are going to build an AI service.
FFmpeg نیز SRT و WebVTT را در میان قالبهای زیرنویس پشتیبانی میکند و امکان استفاده از Streamهای زیرنویس در عملیات رسانهای را فراهم میکند. :contentReference[oaicite:10]{index=10}
چطور ویدیو را به زیرنویس فارسی ترجمه کنیم؟
اینجا معماری از یک Speech-to-Text ساده به یک Pipeline کامل Video Translation تبدیل میشود:
🔹 ویدیو → استخراج صدا
🔹 صدا → Whisper
🔹 Whisper → متن + Timestamp
🔹 متن → Translation Model
🔹 متن ترجمهشده + Timestamp اصلی → SRT فارسی
این روش یک مزیت مهم دارد: ترجمه نباید زمانبندی ویدیو را دوباره تولید کند. فقط متن هر Segment ترجمه میشود و Timestamp همان Segment حفظ میشود.
سه روش برای موتور ترجمه
| روش | مزیت | مناسب برای |
|---|---|---|
| Whisper Translate | ساده و سریع | ترجمه گفتار به انگلیسی |
| مدل ترجمه محلی | عدم ارسال متن به سرویس خارجی | Privacy و SaaS خصوصی |
| API ترجمه خارجی | راهاندازی سریع | MVP و محصول اولیه |
افزودن مدل ترجمه محلی به سرویس
اگر هدف شما ساخت یک سرویس واقعاً مستقل است، میتوانید موتور ترجمه را بهصورت یک Worker جداگانه اجرا کنید. این معماری از قرار دادن همه مدلها در یک Process بهتر است، زیرا مدل Speech-to-Text و مدل Translation میتوانند منابع زیادی مصرف کنند.
معماری پیشنهادی برای نسخه حرفهای
🔹 API Server: دریافت فایل و مدیریت کاربران
🔹 Redis: صف Jobها
🔹 Speech Worker: اجرای faster-whisper
🔹 Translation Worker: اجرای مدل ترجمه
🔹 Storage: نگهداری موقت و خروجی فایلها
🔹 PostgreSQL: کاربران، Jobها و محدودیت مصرف
🔹 Nginx/Caddy: HTTPS و Reverse Proxy
اضافه کردن GPU به سرویس
اگر سرور NVIDIA دارید، faster-whisper میتواند با CUDA اجرا شود. در Docker Compose نیز میتوان GPU را به یک Container اختصاص داد. مستندات Docker برای Compose روش رزرو GPU را با قابلیت gpu توضیح میدهد. :contentReference[oaicite:11]{index=11}
برای اجرای GPU در محیط Python، ابتدا مطمئن شوید درایور NVIDIA روی سرور سالم است:
nvidia-smiسپس میتوانید مدل را با تنظیمات GPU اجرا کنید:
export WHISPER_MODEL=large-v3
export WHISPER_DEVICE=cuda
export WHISPER_COMPUTE=float16

uvicorn app:app --host 0.0.0.0 --port 8000
مقادیر دقیق مناسب به GPU و نسخه CUDA/CTranslate2 وابسته هستند. مستندات فعلی faster-whisper برای اجرای GPU به کتابخانههای NVIDIA اشاره میکند و نسخههای CUDA/cuDNN را نیز مشخص میکند؛ بنابراین در زمان نصب باید نسخههای سازگار را بررسی کنید. :contentReference[oaicite:12]{index=12}
Docker Compose برای Worker پردازش ویدیو
برای محیط Production بهتر است API و Worker را از هم جدا کنید. یک نمونه ساده برای Worker دارای GPU:
services:
  worker:
    build: .
    restart: unless-stopped
    environment:
      WHISPER_MODEL: large-v3
      WHISPER_DEVICE: cuda
      WHISPER_COMPUTE: float16
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
در Compose جدید، Docker همچنین گزینه gpus را برای اختصاص GPU ارائه کرده است؛ انتخاب روش مناسب به نسخه Compose و محیط اجرایی شما بستگی دارد. :contentReference[oaicite:13]{index=13}
ساخت WebVTT در کنار SRT
برای دانلود عمومی، SRT گزینه بسیار رایجی است. برای پخش ویدیویی در وب نیز WebVTT کاربرد زیادی دارد. بنابراین بهتر است سرویس SaaS شما هر دو فرمت را تولید کند.
ساخت VTT بسیار شبیه SRT است، اما فایل با WEBVTT شروع میشود و قالب زمانبندی متفاوتی دارد:
WEBVTT

00:00:01.200 --> 00:00:04.600
Welcome to our video.

00:00:04.800 --> 00:00:08.300
Today we are building an AI service.
FFmpeg در مستندات رسمی خود پشتیبانی از SRT و WebVTT را در بخش قالبهای زیرنویس فهرست کرده است. :contentReference[oaicite:14]{index=14}
اضافه کردن زیرنویس به خود ویدیو
دو نوع خروجی را باید از هم جدا کنید: Soft Subtitle که فایل زیرنویس جداگانه است و Burned-in Subtitle که متن داخل تصویر ویدیو رندر میشود.
برای نمونه، اگر فایل SRT آماده باشد میتوان آن را با FFmpeg روی ویدیو رندر کرد:
ffmpeg -i input.mp4 \
-vf "subtitles=subtitle.srt" \
-c:a copy \
output-subtitled.mp4
این مرحله CPU و دیسک بیشتری مصرف میکند، چون دیگر فقط فایل متنی تولید نمیشود و ویدیو باید دوباره پردازش شود. اگر کاربر فقط زیرنویس میخواهد، تولید SRT/VTT بسیار سبکتر از Render کردن مجدد ویدیو است.
چرا برای SaaS بهتر است زیرنویس جداگانه هم ارائه شود؟
کاربر ممکن است بخواهد متن را در Premiere، DaVinci Resolve، YouTube یا نرمافزار تدوین دیگری استفاده کند. بنابراین بهتر است سرویس حداقل SRT + VTT + TXT + JSON را ارائه دهد و در صورت نیاز نسخه ویدیویی Burned-in را نیز بهعنوان یک Job جداگانه بسازد.
کنترل کیفیت زیرنویس هوش مصنوعی
هیچ سیستم ASR را نباید بدون کنترل کیفیت بهعنوان خروجی کاملاً دقیق در نظر گرفت. کیفیت میتواند با نویز، چند گوینده، موسیقی پسزمینه، لهجه، سرعت صحبت و اصطلاحات تخصصی تغییر کند.
🔹 زبان ویدیو را قبل از پردازش در صورت امکان مشخص کنید.
🔹 برای فایلهای دارای سکوت طولانی از VAD استفاده کنید.
🔹 متن Segmentهای بسیار طولانی را برای نمایش بهتر تقسیم کنید.
🔹 بعد از ترجمه، طول جمله و زمان نمایش را بررسی کنید.
🔹 نام اشخاص، برندها و اصطلاحات تخصصی را در مرحله بازبینی کنترل کنید.
مدیریت فایلهای کاربران؛ مهمترین بخش امنیت
وقتی سرویس SaaS میسازید، فایل ویدیو فقط یک فایل معمولی نیست. ممکن است محتوای آموزشی، جلسه شرکت، ویدیوی خصوصی یا محتوای دارای مالکیت معنوی باشد.
بنابراین برای نسخه واقعی این موارد را در نظر بگیرید:
⚠️ برای فایلها نام تصادفی UUID تولید کنید.
⚠️ لینک دانلود را عمومی و دائمی نکنید.
⚠️ برای فایلهای موقت زمان انقضا تعیین کنید.
⚠️ محدودیت حجم آپلود اعمال کنید.
⚠️ نوع فایل و MIME را بررسی کنید.
⚠️ فضای Temporary را مرتب پاکسازی کنید.
⚠️ نرخ درخواست API را محدود کنید.
برای ساخت SaaS زیرنویس چه چیزهایی باید اضافه کنیم؟
MVP بالا فقط هسته پردازش را میسازد. برای تبدیل آن به یک سرویس تجاری، باید لایههای دیگری اضافه شوند:
| قابلیت | کاربرد |
|---|---|
| احراز هویت | مدیریت حساب کاربران |
| Quota | محدود کردن تعداد دقیقه پردازش |
| Redis Queue | صفبندی Jobها |
| PostgreSQL | ذخیره کاربران و Jobها |
| Object Storage | ذخیره ویدیو و خروجیها |
| Payment | فروش پلنهای پردازش |
| Dashboard | نمایش وضعیت پردازش و دانلود |
مدل تجاری مناسب برای سرویس ترجمه و زیرنویس ویدیو
برای یک SaaS مبتنی بر پردازش ویدیو، فروش بر اساس زمان پردازش معمولاً مدل قابلفهمی برای کاربر است. بهجای اینکه فقط بگویید «پلن حرفهای»، میتوانید میزان پردازش را به دقیقه تعریف کنید.
🔹 پلن آزمایشی: تعداد محدود دقیقه
🔹 پلن تولیدکننده محتوا: سهمیه ماهانه بیشتر
🔹 پلن تیمی: چند کاربر و صف پردازش بالاتر
🔹 پلن سازمانی: Worker اختصاصی و ذخیرهسازی جداگانه
چطور ظرفیت سرور را افزایش دهیم؟
وقتی تعداد کاربران زیاد شود، نباید فقط CPU یا GPU بزرگتری خریداری کنید. بهتر است معماری را به Workerهای مستقل تقسیم کنید.
🔹 API درخواست را ثبت میکند.
🔹 Redis Job را در صف قرار میدهد.
🔹 Worker اول ویدیو را پردازش میکند.
🔹 Worker دوم ترجمه را انجام میدهد.
🔹 Storage خروجی را نگه میدارد.
🔹 API نتیجه را به کاربر اعلام میکند.
در این معماری اگر تعداد درخواستها افزایش پیدا کند، میتوانید Workerهای بیشتری اضافه کنید. این روش برای یک سرویس SaaS بسیار قابل توسعهتر از اجرای همه کارها در یک VPS واحد است.
چند نکته برای کاهش مصرف GPU و RAM
🔹 برای فایلهای ساده از مدل کوچکتر استفاده کنید.
🔹 در صورت مناسب بودن مدل و سختافزار از Quantization استفاده کنید.
🔹 سکوتهای طولانی را با VAD حذف کنید.
🔹 همزمانی Workerها را متناسب با VRAM تنظیم کنید.
🔹 فایلهای موقت را بعد از پایان Job حذف کنید.
🔹 برای خروجیهای قدیمی سیاست حذف خودکار داشته باشید.
faster-whisper امکان استفاده از VAD و حالتهای مختلف محاسباتی را فراهم میکند و مستندات پروژه نیز استفاده از Quantization هشتبیتی را بهعنوان راهی برای بهبود بهرهوری حافظه مطرح میکند. :contentReference[oaicite:15]{index=15}
خطاهای رایج هنگام ساخت سرویس زیرنویس AI
خطای کمبود RAM یا VRAM
اگر مدل بزرگ را روی سختافزار ضعیف اجرا کنید، ممکن است فرآیند با Out of Memory متوقف شود. ابتدا مدل کوچکتر را تست کنید یا به Worker دارای GPU منتقل شوید.
پردازش بسیار کند است
مدل، CPU، تعداد Threadها، نوع محاسبات و طول فایل را بررسی کنید. اجرای مدل بزرگ روی CPU برای SaaS پرترافیک معمولاً انتخاب مناسبی نیست.
ویدیو آپلود میشود اما پردازش شروع نمیشود
لاگ FFmpeg، فضای دیسک، دسترسی پوشهها و وضعیت Job را بررسی کنید. همچنین مطمئن شوید فایل ورودی واقعاً قابل خواندن است.
ترجمه خوب است اما زیرنویس دیر نمایش داده میشود
Timestamp اصلی نباید هنگام ترجمه تغییر کند. ترجمه باید فقط متن هر Segment را تغییر دهد و زمان شروع و پایان همان Segment حفظ شود.
سرور در چند پردازش همزمان از کار میافتد
احتمالاً تعداد Workerها بیش از ظرفیت RAM یا VRAM است. صف Job ایجاد کنید و تعداد پردازش همزمان را محدود کنید.
برای کانفیگ سرور و رفع مشکلات پردازش AI کمک میخواهید؟
اگر هنگام نصب FFmpeg، Python، CUDA، GPU، Docker، Whisper یا راهاندازی سرویس Video AI با مشکل مواجه شدید، میتوانید تنظیمات سرور را بررسی و برای رفع مشکل آماده کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
منابع رسمی برای ادامه توسعه
برای توسعه این پروژه بهتر است مستندات اصلی پروژهها را مبنا قرار دهید:
🔹 مخزن رسمی OpenAI Whisper برای شناخت مدل و قابلیتهای Speech Recognition و Speech Translation. :contentReference[oaicite:16]{index=16}
🔹 مخزن رسمی faster-whisper برای نصب، اجرای CPU/GPU، مدلها و تنظیمات Performance. :contentReference[oaicite:17]{index=17}
🔹 مستندات رسمی FFmpeg برای پردازش ویدیو، صدا و زیرنویس. :contentReference[oaicite:18]{index=18}
🔹 مستندات رسمی FastAPI برای ساخت API، دریافت فایل و مدیریت درخواستها. :contentReference[oaicite:19]{index=19}
جمعبندی؛ از یک اسکریپت Whisper تا SaaS واقعی
ساخت سرویس زیرنویس و ترجمه ویدیو روی VPS فقط نصب Whisper نیست. اگر هدف شما یک محصول واقعی باشد، باید یک Pipeline کامل بسازید:
🔹 دریافت امن ویدیو
🔹 استخراج صدا با FFmpeg
🔹 تبدیل گفتار به متن با Whisper یا faster-whisper
🔹 حفظ Timestamp
🔹 ترجمه Segmentها با موتور ترجمه جداگانه
🔹 تولید SRT و WebVTT
🔹 مدیریت صف Job
🔹 کنترل مصرف CPU، RAM و GPU
🔹 امنیت و حذف فایلهای موقت
🔹 پنل کاربری، Quota و پرداخت برای SaaS
برای یک پروژه کوچک، یک VPS مناسب میتواند نقطه شروع باشد. با افزایش تعداد کاربران، معماری را به API، Queue، Workerهای پردازشی، Storage و GPUهای مستقل تقسیم کنید. این ساختار هم برای سرویس زیرنویس، هم برای Transcription، هم برای ترجمه ویدیو و حتی پروژههای بزرگتر Voice AI قابل توسعه است.
سوالات متداول
آیا میتوان Whisper را روی VPS بدون GPU اجرا کرد؟
بله. مدلهای سبک Whisper روی CPU قابل اجرا هستند، اما زمان پردازش به مدل، CPU و طول فایل بستگی دارد. برای سرویس پرترافیک، GPU میتواند گزینه مناسبتری باشد.
آیا Whisper مستقیماً زیرنویس فارسی تولید میکند؟
اگر گفتار فارسی باشد، میتوان از Whisper برای تشخیص گفتار فارسی و تولید متن استفاده کرد. برای ترجمه یک زبان دیگر به فارسی، باید یک مرحله Translation جداگانه به Pipeline اضافه شود.
SRT بهتر است یا WebVTT؟
برای دانلود و استفاده عمومی، SRT گزینه بسیار رایجی است. برای استفاده در پخشکنندههای وب، WebVTT نیز کاربرد زیادی دارد. یک سرویس حرفهای بهتر است هر دو را تولید کند.
آیا میتوان این سیستم را به SaaS تبدیل کرد؟
بله. کافی است احراز هویت، داشبورد، Quota، صف پردازش، Storage، سیستم پرداخت و Workerهای مستقل را به هسته پردازش اضافه کنید.
برای چند کاربر همزمان چه چیزی مهمتر است؟
فقط قدرت CPU یا GPU کافی نیست. مدیریت Queue، تعداد Workerها، VRAM، RAM، سرعت دیسک و سیاست محدود کردن Jobهای همزمان هم اهمیت دارد.
آیا میتوان زیرنویس را مستقیماً داخل ویدیو قرار داد؟
بله. پس از تولید SRT میتوان با FFmpeg آن را روی تصویر ویدیو Render کرد. این مرحله نسبت به تولید فایل متنی زیرنویس منابع پردازشی بیشتری مصرف میکند.
برای اجرای پروژه Video AI به سرور نیاز دارید؟
سرویس زیرنویس و ترجمه ویدیو برای فایلهای طولانی و پردازش همزمان به منابع مناسب نیاز دارد. اگر قصد دارید Whisper، Speech AI، پردازش ویدیو یا یک SaaS هوش مصنوعی را روی سرور خودتان اجرا کنید، ابتدا منابع موردنیاز پروژه را مشخص کنید و سپس VPS مناسب انتخاب کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.