
 Amir Jabbari
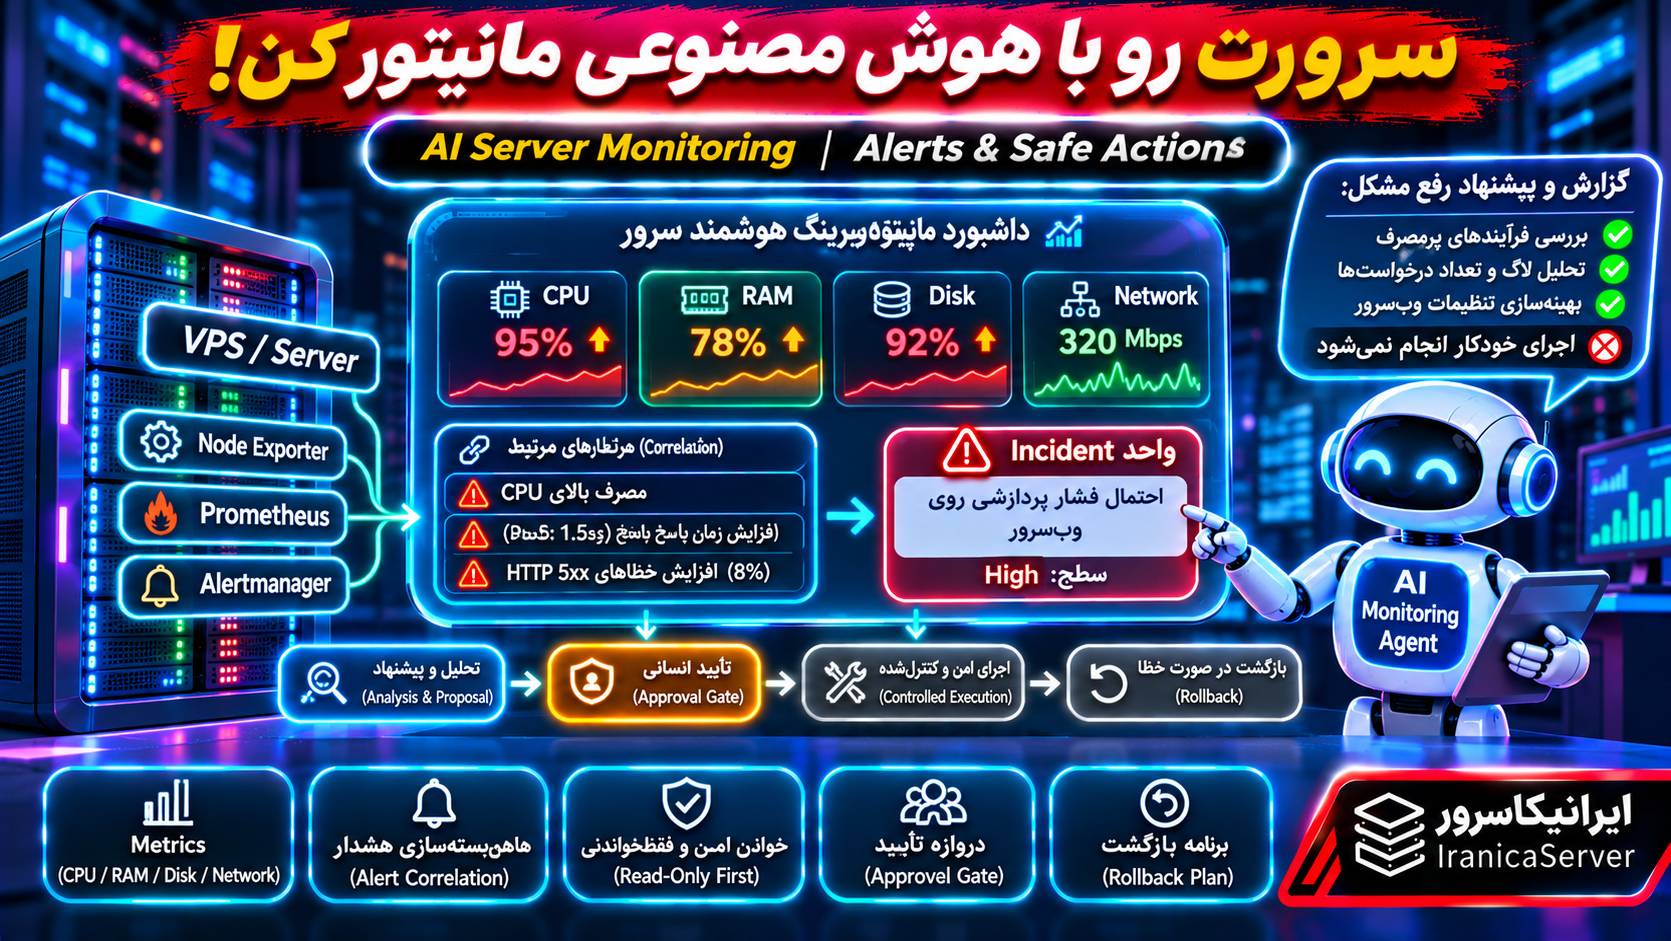
اینجاست که AI Server Monitoring Agent میتواند کاربرد داشته باشد. بهجای آنکه فقط چند نمودار یا هشدار جداگانه نمایش داده شود، یک Agent میتواند شاخصهای معتبر را کنار هم قرار دهد، رخدادهای مرتبط را شناسایی کند و برای مدیر سرور گزارشی شامل شواهد، علتهای احتمالی و پیشنهاد بررسی آماده کند.
اما این سیستم نباید اختیار نامحدود روی VPS داشته باشد. اگر Agent با دیدن مصرف بالای RAM فوراً فرآیندی را متوقف کند یا با تشخیص کمبود فضای دیسک فایلهایی را حذف کند، ممکن است بهجای رفع مشکل، اختلال بزرگتری ایجاد کند.
در این مقاله نحوه ساخت یک Agent مانیتورینگ سرور با رویکرد Read-Only First را آموزش میدهیم. ابتدا معماری Metrics، Prometheus، Node Exporter و Alertmanager را بررسی میکنیم و سپس با Python و SQLite یک نمونه عملی میسازیم که هشدارهای مربوط به CPU، حافظه، دیسک، خطاهای HTTP و دسترسپذیری را تحلیل میکند.
در ادامه یاد میگیریم چگونه هشدارهای مرتبط را Correlate کنیم، از تشخیص علت قطعی بدون شواهد جلوگیری کنیم، برای اقدامات حساس Approval Gate بسازیم، طرح Rollback آماده کنیم و تصمیمها را در Audit Log ثبت کنیم؛ بدون اینکه Agent به Root Access، اجرای Shell یا تغییر خودکار سرویسها نیاز داشته باشد.
AI Server Monitoring Agent چیست و چه کاری انجام میدهد؟
AI Server Monitoring Agent یک برنامه هوشمند است که اطلاعات قابل اندازهگیری زیرساخت را دریافت میکند و با تحلیل آنها، وضعیت سرویسها و رخدادهای احتمالی را توضیح میدهد.
یک Agent مانیتورینگ میتواند شاخصهایی مانند مصرف CPU، حافظه، فضای دیسک، تعداد خطاهای HTTP، تأخیر درخواستها و دسترسپذیری را بررسی کند و نتیجه را در قالب گزارش فنی ارائه دهد.
تفاوت اصلی این معماری با یک مانیتورینگ ساده در این است که Agent فقط وقوع هر هشدار را گزارش نمیکند؛ بلکه تلاش میکند ارتباط منطقی میان هشدارها را بررسی و مراحل مناسب تحقیق را پیشنهاد کند.
نمونه کاربردی
فرض کنید سه هشدار برای یک VPS ثبت شدهاند:
- مصرف CPU برابر ۹۵ درصد.
- زمان پاسخ صدک ۹۵ درخواستها برابر ۱۵۵۰ میلیثانیه.
- نرخ پاسخهای HTTP 5xx برابر ۸ درصد.
Agent میتواند توضیح دهد که این رخدادها در یک بازه نزدیک اتفاق افتادهاند و احتمال دارد فشار پردازشی در افزایش تأخیر نقش داشته باشد.
اما نباید اعلام کند CPU قطعاً علت خطای HTTP است؛ چون ممکن است مشکل اصلی در دیتابیس، شبکه یا یک سرویس وابسته باشد.
آیا AI Monitoring جایگزین Prometheus میشود؟
خیر. Prometheus مسئول جمعآوری و نگهداری Time Series و ارزیابی Ruleهای مشخص است. Agent بیشتر نقش تحلیلگر و هماهنگکننده بررسی رخدادها را دارد.
برای زیرساخت پایدار، بهتر است حتی در زمان قطع API هوش مصنوعی، جمعآوری Metrics و ارسال هشدارهای ضروری همچنان کار کنند.
تفاوت Agent مانیتورینگ سرور با Agent تحلیل لاگ چیست؟
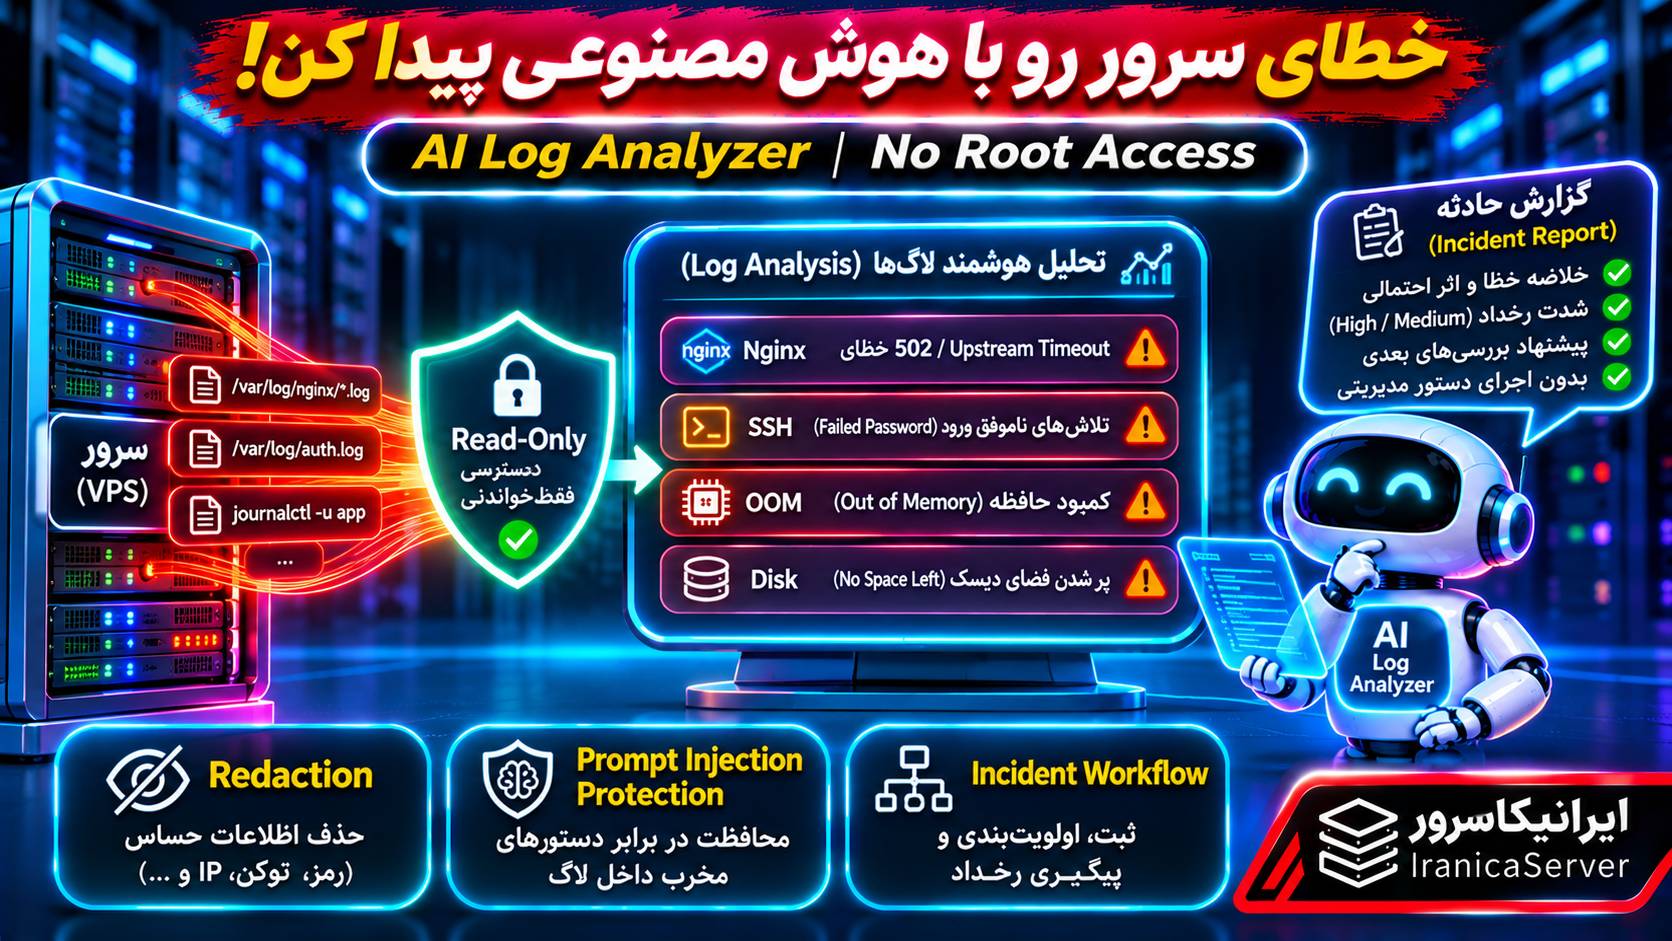
در مقاله قبلی، تمرکز بر خواندن امن لاگها و استخراج نشانههای خطا از متن بود. این مقاله روی Metrics و Alert Lifecycle تمرکز دارد.
| معیار | Log Analyzer | Monitoring Agent |
|---|---|---|
| داده اصلی | رخدادها و متن لاگ | اعداد و Time Series |
| پرسش معمول | چه خطایی ثبت شده است؟ | چه شاخصی تغییر کرده و چه اثری دارد؟ |
| ابزار نمونه | Journal، فایل لاگ، Parser | Prometheus، Node Exporter، Alertmanager |
| تحلیل | الگوی خطا و پیام رخداد | روند، آستانه، همبستگی و دسترسپذیری |
| خروجی | گزارش خطا | Incident، اولویت و فرضیه بررسی |
ترکیب این دو سیستم میتواند مفید باشد؛ اما بهتر است هرکدام مسئولیت، دسترسی و محدوده داده مشخصی داشته باشند.
معماری امن Agent مانیتورینگ روی VPS
برای طراحی یک سیستم قابل اعتماد، مانیتورینگ، تحلیل و اجرای عملیات باید از یکدیگر جدا شوند.
VPS / Application
       |
Node Exporter + App Metrics
       |
   Prometheus
       |
Alert Rules / PromQL
       |
   Alertmanager
       |
Trusted Metrics Adapter
       |
Validate Labels + Freshness
       |
Alert Correlation
       |
Incident + Evidence
       |
AI Analysis (optional)
       |
Read-only Recommendations
       |
Human Approval Gate
       |
Separate Authorized Executor
       |
Preflight / Verify / Rollback
       |
Audit and Incident Closure
در نمونه آموزشی، مسیر در مرحله ثبت پیشنهاد و تصمیم اپراتور متوقف میشود. بخش Separate Authorized Executor پیادهسازی نشده است و هیچ عملیات مدیریتی اجرا نمیشود.
چرا اجرای عملیات از Agent جداست؟
چون تشخیص و تصمیم مدل ممکن است اشتباه باشند. حتی وقتی اپراتور یک طرح را تأیید کرده است، اجرای واقعی باید مجوز، شناسه منبع، وضعیت فعلی سرویس و قابلیت بازگشت را دوباره بررسی کند.
مهمترین Metrics برای مانیتورینگ سرور کداماند؟
برای شروع بهتر است شاخصها را به دو دسته تقسیم کنیم: شاخصهای سلامت زیرساخت و شاخصهای تجربه واقعی کاربر.
| شاخص | چه چیزی نشان میدهد؟ | ملاحظه |
|---|---|---|
| CPU Busy | سهم زمان غیر Idle پردازنده | بهتنهایی علت کندی را ثابت نمیکند |
| Memory Used | نسبت مصرف حافظه | باید حافظه قابل استفاده و Cache را درست تفسیر کرد |
| Disk Used | مصرف ظرفیت Filesystem | Filesystem و Inode هر دو مهماند |
| Network Throughput | نرخ ارسال و دریافت داده | افزایش ترافیک الزاماً مشکل نیست |
| HTTP 5xx Rate | نسبت پاسخهای خطای سمت سرور | به تعداد کل درخواستها وابسته است |
| HTTP P95 Latency | زمان پاسخ برای صدک ۹۵ | باید براساس Histogram درست محاسبه شود |
| Up | موفقیت Scrape هدف | Up=0 الزاماً به معنی قطع کامل سرویس نیست |
چرا فقط CPU و RAM کافی نیستند؟
ممکن است سرور CPU پایینی داشته باشد، اما کاربران به دلیل کندی دیتابیس یا قطعی وابستگی خارجی با خطا مواجه شوند.
به همین دلیل بهتر است علاوه بر Metrics منابع، شاخصهای مرتبط با تجربه کاربران مانند Availability، Error Rate و Latency نیز بررسی شوند.
Prometheus و Node Exporter چه نقشی دارند؟
Node Exporter مجموعهای از شاخصهای سیستمعامل Linux و سختافزار را در قالب Metrics ارائه میدهد. Prometheus این دادهها را در بازههای مشخص جمعآوری میکند.
برای مشاهده راهنمای رسمی راهاندازی میتوانید به مستندات Node Exporter مراجعه کنید.
معماری ساده
Node Exporter :9100
         |
      Scrape
         |
Prometheus :9090
         |
   Rules / API
         |
Monitoring Agent
چرا پورت Node Exporter را نباید آزادانه در اینترنت باز کنیم؟
چون Metrics ممکن است اطلاعاتی درباره ساختار سیستم، Interfaceها، نام Filesystemها و وضعیت سرویسها آشکار کنند.
در یک VPS تکسروری میتوان سرویس را متناسب با معماری شبکه روی Loopback محدود کرد. برای چند سرور نیز باید از شبکه خصوصی، Firewall و کنترل دسترسی مناسب استفاده شود.
نکته مهم این است که Agent برای دریافت Metrics نباید بهصورت مستقیم به تمام میزبانها یا پورتهای دلخواه دسترسی داشته باشد.
بررسی Metrics محلی
اگر Node Exporter از قبل بهصورت محلی نصب و فعال است:
curl --fail --silent \
http://127.0.0.1:9100/metrics \
| head -30
این فرمان فقط داده را میخواند و هیچ تنظیمی را تغییر نمیدهد. در نمونه Production، آدرس و روش اتصال باید با پیکربندی واقعی و محافظتشده سیستم مطابقت داشته باشند.
چگونه با PromQL هشدار CPU، RAM و دیسک بسازیم؟
Prometheus امکان تعریف Alerting Rule براساس عبارتهای PromQL را فراهم میکند.
در یک Rule میتوان علاوه بر شرط عددی، مدت پایداری شرط را نیز تعیین کرد.
نمونه قانونهای هشدار
groups:
  - name: iranica-server-health
    rules:
      - alert: HighCPUUsage
        expr: |
          100 * (1 - avg by(instance) (
            rate(node_cpu_seconds_total{mode="idle"}[5m])
          )) > 90
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High CPU utilization"
          description: "CPU busy over 90 percent"

      - alert: HighMemoryUsage
        expr: |
          100 * (1 -
            node_memory_MemAvailable_bytes
            / node_memory_MemTotal_bytes
          ) > 90
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "High memory utilization"

      - alert: HighDiskUsage
        expr: |
          100 * (
            1 -
            node_filesystem_avail_bytes{
              fstype!~"tmpfs|overlay|squashfs"
            }
            /
            node_filesystem_size_bytes{
              fstype!~"tmpfs|overlay|squashfs"
            }
          ) > 90
        for: 10m
        labels:
          severity: critical
        annotations:
          summary: "High disk utilization"
این قانونها مثال آموزشیاند. در Production بهتر است Filesystemهای نامرتبط، دستگاههای موقت و Labelهای موردنیاز را دقیقتر فیلتر کنید و شرایط از دست رفتن داده یا خطای Scrape را نیز جداگانه بررسی کنید.
for چه کاری انجام میدهد؟
اگر شرط CPU برای مدت کوتاهی برقرار باشد، لزوماً هشدار Firing نمیشود. با `for: 5m`، شرط باید برای مدت تعریفشده فعال باقی بماند تا هشدار وارد وضعیت Firing شود.
keep_firing_for چه تفاوتی دارد؟
این گزینه میتواند مانع پایان سریع هشدار در نوسانهای کوتاه شود. تنظیم آن باید براساس رفتار سرویس و نیاز عملیاتی باشد؛ چون نگه داشتن هشدار پس از رفع شرط نیز پیامدهای خودش را دارد.
مرجع: مستندات رسمی Alerting Rules.
Alertmanager چگونه هشدارهای تکراری را مدیریت میکند؟
در زیرساخت واقعی ممکن است یک اختلال باعث فعال شدن تعداد زیادی Alert شود. برای مثال، قطع یک سرور ممکن است همزمان هشدار عدم دسترسی، اختلال API و خطای سرویسهای وابسته را ایجاد کند.
Alertmanager ابزارهایی برای کاهش هشدارهای تکراری و مدیریت اعلانها دارد.
Grouping
هشدارهای دارای Label مشترک میتوانند در یک اعلان گروهبندی شوند.
Deduplication
از ارسال بیدلیل اعلانهای تکراری برای یک وضعیت جلوگیری میکند.
Inhibition
میتواند اعلان یک هشدار وابسته را هنگام فعال بودن یک هشدار اصلی مهار کند.
Silence
اجازه میدهد برای مدت و محدوده مشخص، اعلان بعضی هشدارها موقتاً متوقف شوند.
بااینحال Silence نباید برای پنهان کردن دائمی مشکلات مورد استفاده قرار گیرد.
مستندات رسمی: Prometheus Alertmanager.
Alert Correlation چیست و چگونه چند هشدار را به یک Incident تبدیل کنیم؟
Alert Correlation یعنی بررسی اینکه آیا چند هشدار از نظر زمان، میزبان، سرویس یا وابستگی عملیاتی با یکدیگر ارتباط دارند یا خیر.
برای مثال، افزایش مصرف CPU و زمان پاسخ HTTP در یک VPS میتواند به یک Incident مشترک مرتبط باشد.
پیششرطهای Correlation
- همسان بودن میزبان یا سرویس مرتبط.
- تازه بودن دادهها.
- نزدیک بودن زمان رخدادها.
- معتبر بودن نوع Metric و Labelها.
- بررسی وابستگی سرویسها در صورت وجود.
- جلوگیری از ادغام رخدادهای نامرتبط.
نمونه آموزشی
اگر CPU بالای ۹۰ درصد و P95 Latency بالای یک ثانیه در یک بازه دهدقیقهای ثبت شده باشند، سیستم میتواند یک فرضیه درباره فشار CPU و کندی درخواستها تولید کند.
اما این تنها یک Hypothesis است و نیاز به بررسی نمودارها، دادههای اپلیکیشن و سایر شواهد دارد.
چه زمانی نباید هشدارها را ادغام کنیم؟
وقتی به میزبانهای متفاوت، سرویسهای مستقل یا بازههای زمانی نامرتبط تعلق دارند.
در برخی معماریها نیز رخدادهای یک سرویس وابسته میتوانند تحت تأثیر مشکل مشترک باشند؛ اما تشخیص آن نیازمند مدل وابستگیهای واقعی زیرساخت است.
چرا همبستگی دو Alert اثبات علت اصلی نیست؟
دو شاخص ممکن است همزمان افزایش پیدا کنند، بدون اینکه یکی علت دیگری باشد.
فرض کنید CPU و خطاهای HTTP همزمان افزایش یافتهاند. ممکن است CPU بالا باعث کندی سرویس شده باشد؛ اما احتمال دیگری این است که افزایش درخواستهای ناموفق به دلیل یک مشکل دیتابیس، مصرف CPU را نیز بیشتر کرده باشد.
بنابراین گزارش مناسب باید سه بخش مستقل داشته باشد:
- Observed: چه دادههایی واقعاً مشاهده شدهاند؟
- Hypothesis: چه توضیح احتمالی با دادهها سازگار است؟
- Verification: چه بررسیهایی برای تأیید یا رد فرضیه لازم است؟
Agent نباید عبارت «علت قطعی شناسایی شد» را فقط براساس چند Threshold تولید کند.
Read-Only First؛ چرا Agent ابتدا فقط باید مشاهده کند؟
یک Agent مانیتورینگ در مرحله اول به اطلاعات نیاز دارد، نه دسترسی مدیریتی.
این اطلاعات میتوانند از Prometheus API، Dashboardهای مجاز و Queryهای از پیش تعریفشده دریافت شوند.
اختیارات مجاز در مرحله اول
- خواندن Metrics مشخص.
- دریافت وضعیت Alertهای معتبر.
- بررسی روندهای زمانی مجاز.
- ساخت Incident Report.
- پیشنهاد مراحل بررسی.
اختیاراتی که نباید به Analyzer داده شوند
- اجرای فرمان دلخواه Shell.
- Restart یا Stop سرویس.
- حذف فایلها و Backupها.
- تغییر Ruleهای Firewall.
- تغییر تنظیمات PostgreSQL یا سیستمعامل.
- اجازه دسترسی به Credentialهای مدیریتی.
اگر در آینده نیاز به Auto-remediation دارید، باید یک Executor مستقل با ابزارهای محدود و کنترل مجوز جداگانه طراحی شود.
منابع موردنیاز برای اجرای AI Server Monitoring Agent روی VPS
اگر زیرساخت مانیتورینگ از قبل نصب شده باشد، هسته تحلیل Python منابع زیادی مصرف نمیکند.
| نوع استفاده | RAM پیشنهادی اولیه | CPU پیشنهادی اولیه |
|---|---|---|
| Demo آفلاین Python و SQLite | ۱ تا ۲ گیگابایت | ۱ vCPU |
| Adapter و Agent متصل به Prometheus | ۲ تا ۴ گیگابایت | ۲ vCPU |
| Prometheus و چند سرویس مانیتورینگ | براساس تعداد Time Series و Retention | براساس نرخ Scrape و Query |
| چند سرور و چند Worker | براساس بار و مدت نگهداری | براساس تعداد Job همزمان |
این اعداد حدود اولیه آموزشی هستند. ظرفیت واقعی Prometheus باید براساس تعداد Time Series، دوره Scrape، مدت نگهداری داده و حجم Queryها تعیین شود.
اگر تحلیل متنی با مدل APIمحور انجام شود، معمولاً اجرای خود مدل به GPU محلی نیاز ندارد؛ اما Worker، دیتابیس و ابزارهای محلی همچنان منابع مصرف میکنند.
مرحله اول: نصب پروژه عملی Monitoring Agent روی Ubuntu
نمونه عملی مقاله با Python 3 و SQLite اجرا میشود و به هیچ API خارجی نیاز ندارد.
نصب Python
sudo apt update
sudo apt install -y python3 python3-venv
ساخت محیط پروژه
mkdir -p ~/iranica-monitoring-agent
cd ~/iranica-monitoring-agent

python3 -m venv .venvفایلهای بسته دانلودی را در این پوشه قرار دهید.
ساختار فایلها
iranica-monitoring-agent-demo/
  monitor_agent.py
  make_demo.py
  test_monitor_agent.py
README.mdآمادهسازی دیتابیس
.venv/bin/python monitor_agent.py \
--db ./monitor.sqlite3 init
پس از اجرای دستور، جدولهای موردنیاز برای Incident، Approval و Audit ایجاد میشوند.
مرحله دوم: ساختار پایگاه داده Incident و Approval
در این نمونه، هشدارهای مرتبط به یک Incident تبدیل میشوند و تصمیم اپراتور جداگانه ثبت میشود.
| جدول | وظیفه |
|---|---|
| incidents | شناسه، وضعیت، Severity و گزارش |
| approvals | تصمیم اپراتور درباره طرح پیشنهادی |
| audit | تاریخچه ایجاد Incident و تصمیمها |
نمونه تعریف Incident
CREATE TABLE IF NOT EXISTS incidents (
    id TEXT PRIMARY KEY,
    fingerprint TEXT NOT NULL UNIQUE,
    host TEXT NOT NULL,
    status TEXT NOT NULL,
    severity TEXT NOT NULL,
    report_json TEXT NOT NULL,
    proposal_json TEXT NOT NULL,
    created_at INTEGER NOT NULL,
    updated_at INTEGER NOT NULL
);
Fingerprint کمک میکند هشدارهای مشابه در یک محدوده مشخص چند بار به Incident جدید تبدیل نشوند.
اما در Production، Deduplication باید چرخه کامل هشدار، زمان شروع و پایان، منبع و وضعیت Incident را نیز در نظر بگیرد؛ یک Hash ساده برای تمام سناریوها کافی نیست.
مرحله سوم: تحلیل Metrics و ایجاد فرضیههای فنی
در این پروژه، ورودی Metrics فقط شامل چهار فیلد مشخص است:
{
  "host": "demo-vps-01",
  "metric": "cpu_busy_percent",
  "value": 95,
  "timestamp": 1793784689
}
Timestamp این مثال صرفاً نمایشی است. فایل آزمایشی همراه پروژه با اجرای make_demo.py زمان فعلی را ثبت میکند.
Allowlist متریکهای مجاز
ALLOWED_METRICS = {
    "cpu_busy_percent",
    "memory_used_percent",
    "disk_used_percent",
    "http_5xx_rate_percent",
    "http_p95_ms",
    "up",
}
برنامه فقط نامهای مشخصشده را میپذیرد. این کار باعث میشود داده آزاد یا فیلدهای غیرمنتظره مستقیماً وارد تحلیل نشوند.
تعریف Thresholdها
THRESHOLDS = {
    "cpu_busy_percent": (90, "high"),
    "memory_used_percent": (90, "high"),
    "disk_used_percent": (90, "critical"),
    "http_5xx_rate_percent": (5, "high"),
    "http_p95_ms": (1000, "medium"),
}
این Thresholdها برای Demo انتخاب شدهاند و نباید بدون بررسی رفتار واقعی سرویس روی تمام VPSها اعمال شوند.
نمونه منطق Correlation
if {
    "cpu_busy_percent",
    "http_p95_ms",
} <= observed:

    candidates.append(
        "CPU saturation may contribute "
        "to request latency; verify with "
        "service traces and load history."
    )
در سورس کامل، نزدیک بودن زمان هشدارها نیز بررسی میشود تا دادههای نامرتبط بهصورت تصادفی ادغام نشوند.
این نتیجه عمداً بهعنوان یک فرضیه ذخیره میشود و مقدار root_cause_confirmed برابر False باقی میماند.
پیشنهادهای Read-only
نمونه بهجای تغییر تنظیمات، پیشنهادهایی مانند بررسی Dashboard، مطالعه Runbook و مقایسه روندها را آماده میکند.
اگر مشکل دیسک مشاهده شود، امکان بررسی یک طرح پاکسازی توسط انسان مطرح میشود؛ اما هیچ حذف فایلی در کد وجود ندارد.
مرحله چهارم: اجرای Agent مانیتورینگ با دادههای آزمایشی
ساخت Metrics آزمایشی با Timestamp معتبر
.venv/bin/python make_demo.pyاین فرمان فایل metrics-demo.json را با زمان فعلی ایجاد میکند.
اجرای تحلیل
.venv/bin/python monitor_agent.py \
--db ./monitor.sqlite3 \
scan --input ./metrics-demo.json
برنامه هشدارهای یک میزبان را بررسی و در صورت عبور از Thresholdها، Incident ایجاد میکند.
نمونه نتیجه منطقی
{
  "host": "demo-vps-01",
  "severity": "high",
  "root_cause_confirmed": false,
  "remediation_executed": false,
  "signals": [
    {"metric": "cpu_busy_percent", "value": 95},
    {"metric": "http_5xx_rate_percent", "value": 8},
    {"metric": "http_p95_ms", "value": 1550}
  ]
}
این خروجی خلاصهشده است. نسخه واقعی شامل Timestamp، شناسه Incident، فرضیهها و پیشنهادهای بررسی است.
مشاهده جزئیات Incident
.venv/bin/python monitor_agent.py \
--db ./monitor.sqlite3 \
show --incident INCIDENT_UUIDبهجای INCIDENT_UUID شناسه چاپشده توسط برنامه را وارد کنید.
تأیید طرح برای بررسی دستی
.venv/bin/python monitor_agent.py \
--db ./monitor.sqlite3 \
review \
--incident INCIDENT_UUID \
--reviewer local-operator \
--decision approve_plan
این دستور فقط طرح پیشنهادی را در وضعیت plan_approved_for_manual_review قرار میدهد.
مهم: این تأیید به معنی اجازه اجرای خودکار نیست و هیچ فرمانی روی سرور اجرا نمیشود.
چگونه Agent را به Prometheus API متصل کنیم؟
نمونه Demo دادههای JSON را از فایل میخواند. برای اتصال به Metrics واقعی میتوان یک Adapter مورد اعتماد ساخت که Queryهای ثابت PromQL را از Prometheus API دریافت و به قالب کنترلشده تبدیل کند.
نمونه Query فقطخواندنی
اگر Prometheus بهصورت محلی و با مجوز مناسب فعال است:
curl --get \
http://127.0.0.1:9090/api/v1/query \
--data-urlencode 'query=up'
این فرمان وضعیت Scrape اهداف را دریافت میکند.
چرا مدل نباید PromQL دلخواه بنویسد و مستقیماً اجرا کند؟
زیرا Queryهای پیچیده یا بسیار گسترده میتوانند منابع Prometheus را مصرف کنند و دادههایی خارج از محدوده موردنیاز Agent برگردانند.
بهتر است مجموعه Queryهای مجاز در Backend تعریف شود و Agent فقط از خروجی ساختاریافته استفاده کند.
مراحل Adapter امن
- انتخاب Query از Allowlist ثابت.
- احراز هویت به سرویس Metrics در صورت نیاز.
- اعمال Timeout و محدودیت تعداد Series.
- بررسی Timestamp و تازگی داده.
- اعتبارسنجی Label میزبان یا سرویس.
- تبدیل مقدارها به واحد مشخص.
- ارسال فقط فیلدهای لازم به Analyzer.
در Production، Adapter باید بهصورت جداگانه تست شود. بسته آموزشی حاضر عمداً درخواست شبکهای انجام نمیدهد.
چگونه تحلیل مدل هوش مصنوعی را به سیستم اضافه کنیم؟
پس از جمعآوری و Correlation، میتوان از مدل زبانی برای تبدیل شواهد به گزارش قابل فهم استفاده کرد.
مدل باید نقش تحلیلگر داشته باشد؛ نه تصمیمگیرنده نهایی اجرای عملیات.
چه دادههایی به مدل بدهیم؟
بهتر است فقط دادههای ساختاریافته و محدود مانند موارد زیر ارسال شوند:
- نام سرویس یا شناسه مجاز و غیرحساس.
- نوع و مقدار Metric.
- محدوده زمانی رخداد.
- هشدارهای مرتبط.
- نتیجه Correlation.
- متن Runbook تأییدشده و موردنیاز.
نمونه استفاده اختیاری از OpenAI Responses API
این نمونه مستقل از پروژه آفلاین است و فقط یک خلاصه پیشنهادی میسازد.
import json
import os
from openai import OpenAI

client = OpenAI()

evidence = {
    "host": "demo-vps-01",
    "metrics": {
        "cpu_busy_percent": 95,
        "http_p95_ms": 1550,
        "http_5xx_rate_percent": 8
    },
    "root_cause_confirmed": False
}

response = client.responses.create(
    model=os.environ["MONITOR_MODEL"],
    instructions=(
        "Analyze structured server metrics. "
        "Write a Persian incident report. "
        "Separate observed facts from hypotheses. "
        "Never claim a confirmed root cause "
        "from correlation alone. "
        "Suggest read-only verification steps. "
        "Do not execute commands or tools."
    ),
    input=json.dumps(evidence),
    store=False
)

print(response.output_text)
پیش از اجرا باید OpenAI SDK و API Key معتبر آماده باشند و MONITOR_MODEL به مدلی قابل دسترسی تنظیم شود.
این مثال هیچ Tool اجرایی به مدل نمیدهد. خروجی مدل نیز باید برای نمایش یا استفاده در فرآیند تصمیم، از نظر ساختار و سیاست بررسی شود.
آیا Agent باید همیشه از LLM استفاده کند؟
خیر. تشخیص Threshold، بررسی Timestamp، Deduplication و بسیاری از قواعد Correlation بهتر است با کد قطعی انجام شوند.
استفاده از مدل را میتوان به شرایطی محدود کرد که چند هشدار مرتبط وجود دارد یا تحلیل انسانیِ قابل فهم ارزش بیشتری ایجاد میکند.
Approval Gate برای عملیات حساس چگونه طراحی میشود؟
وقتی Agent پیشنهاد تغییر تنظیمات میدهد، باید میان «پیشنهاد»، «تأیید طرح» و «مجوز اجرای واقعی» تفاوت بگذاریم.
برای مثال، پیشنهاد پاکسازی فایلهای قدیمی ممکن است منطقی باشد؛ اما بدون مشخص بودن فایلها، مالکیت، Backup و اثر حذف، نباید اجرا شود.
سطوح پیشنهادی کنترل
| نوع اقدام | سطح کنترل |
|---|---|
| مشاهده نمودار | Read-only با مجوز مناسب |
| دریافت وضعیت سرویس | Read-only با Scope مشخص |
| پیشنهاد Restart | فقط ثبت طرح |
| Restart واقعی | مجوز معتبر، تأیید، Preflight و Executor محدود |
| تغییر Firewall | کنترل قویتر و مسیر بازگشت |
| حذف فایل یا Backup | سیاست ویژه و بررسی دقیق؛ بعضی عملیات غیرقابل جبراناند |
Approval دقیقاً باید شامل چه چیزی باشد؟
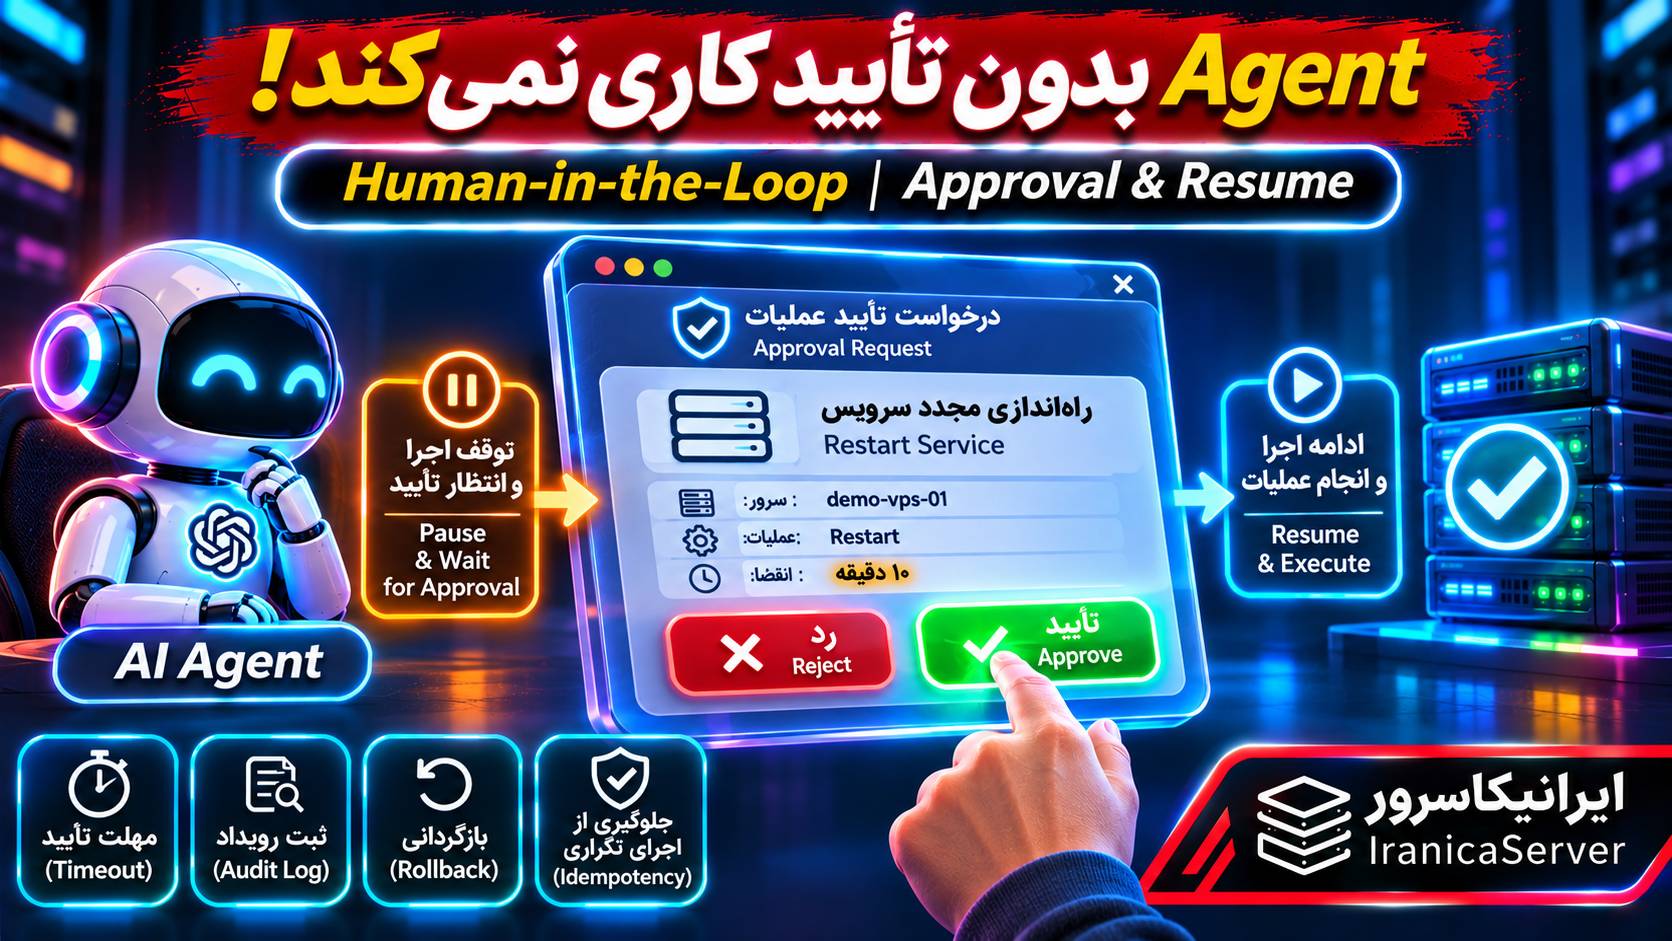
یک Approval معتبر باید به شناسه منبع، نام عملیات، پارامترهای نهایی، دلیل انجام، نسخه طرح و زمان اعتبار مرتبط باشد.
در Backend باید هویت و مجوز تأییدکننده بررسی شود و در صورت تغییر طرح، تأیید قبلی برای نسخه جدید معتبر نباشد.
چرا تصمیم مدل کافی نیست؟
زیرا مدل ممکن است داده ناقص دریافت کند، علت مشکل را اشتباه تشخیص دهد یا تحت تأثیر اطلاعات غیرقابل اعتماد قرار گیرد.
برای عملیات حساس، تصمیم نهایی باید از مرز امنیتی قابل اعتماد عبور کند.
برای طراحی کامل این لایه، مقاله ساخت Human-in-the-Loop برای AI Agent را مطالعه کنید.
Rollback در Agent مانیتورینگ چیست و چرا قبل از اجرا باید طراحی شود؟
Rollback یعنی برنامه بازگشت از یک تغییر در صورت شکست یا ایجاد اختلال جدید.
اما همه عملیاتها واقعاً قابل بازگردانی نیستند؛ به همین دلیل بهتر است پیش از تأیید یک اقدام، امکان جبران آن بررسی شود.
مثال: تغییر تنظیمات یک سرویس
برای تغییر تنظیمات میتوان نسخه قبلی را نگهداری، تغییر جدید را اعتبارسنجی و در صورت شکست، نسخه قبلی را بازیابی کرد.
مثال: Restart یک فرآیند
ممکن است بتوان سرویس را دوباره فعال کرد، اما قطع ارتباط کاربران در زمان Restart را نمیتوان از گذشته حذف کرد.
مثال: حذف فایل
اگر فایل نسخه پشتیبان یا امکان بازیابی نداشته باشد، عملیات ممکن است غیرقابل بازگشت باشد.
یک طرح تغییر امن چه اجزایی دارد؟
- هدف و ضرورت تغییر.
- نام دقیق سرویس یا منبع.
- شرایط قبل از اجرا.
- Snapshot یا Backup معتبر در صورت نیاز.
- تغییر محدود و قابل بررسی.
- معیار موفقیت بعد از اجرا.
- شرط توقف و بازگشت.
- مسئول اجرای طرح.
نکته مهم این است که خود عملیات Rollback نیز میتواند ریسک داشته باشد. بنابراین نباید فرض شود که اجرای خودکار آن در هر شرایطی امن است.
Incident Workflow؛ از Alert تا تصمیم مدیریتی
وقتی سیستم چند هشدار مرتبط پیدا میکند، باید آنها را به یک Incident قابل پیگیری تبدیل کند.
مرحله اول: Detect
Prometheus یا سیستم مانیتورینگ، شرایط هشدار را براساس دادههای واقعی تشخیص میدهد.
مرحله دوم: Correlate
هشدارهای مرتبط از نظر میزبان، زمان و سرویس کنار هم قرار میگیرند.
مرحله سوم: Triage
Severity اولیه، احتمال تأثیر روی کاربران و اولویت بررسی مشخص میشود.
مرحله چهارم: Investigate
اپراتور یا Agent با دسترسی فقطخواندنی، شواهد تکمیلی را بررسی میکند.
مرحله پنجم: Propose
پیشنهاد رفع مشکل همراه با خطرات و شرایط لازم آماده میشود.
مرحله ششم: Approve
درخواست حساس توسط شخص مجاز و براساس نسخه دقیق طرح بررسی میشود.
مرحله هفتم: Execute و Verify
اگر Executor عملیاتی مستقلی وجود داشته باشد، اجرای مجاز در آن انجام میشود و نتیجه واقعی بررسی خواهد شد.
مرحله هشتم: Close و Learn
پس از تأیید رفع مشکل، Incident بسته میشود و در صورت نیاز Thresholdها و Runbookها بهبود داده میشوند.
در Demo مقاله مراحل اجرای واقعی و بستن خودکار Incident پیادهسازی نشدهاند؛ تا مرز میان پیشنهاد و عملیات کاملاً روشن بماند.
چگونه تصمیمها و شواهد Agent را در Audit Log ثبت کنیم؟
Audit باید مشخص کند چه رخدادی شناسایی شد، چه فرضیهای مطرح شد، چه کسی درباره طرح تصمیم گرفت و آیا عملیاتی انجام شده است یا خیر.
رویدادهای نمونه
| رویداد | توضیح |
|---|---|
| incident_created | Incident جدید ایجاد شده است |
| approve_plan | اپراتور طرح را برای بررسی دستی تأیید کرده است |
| reject_plan | طرح پیشنهادی رد شده است |
برای سیستم عملیاتی باید رویدادهای بیشتری مانند تغییر طرح، اجرای واقعی، نتیجه Preflight، خطای Executor، Rollback و پایان Incident ثبت شوند.
آیا شناسه اپراتور در Demo احراز هویت میشود؟
خیر. پارامتر reviewer فقط برچسبی برای CLI محلی مورد اعتماد است.
در رابط وب واقعی، هویت باید از نشست یا توکن معتبر استخراج شود و مجوز همان عملیات بررسی گردد.
امنیت Agent مانیتورینگ و جلوگیری از Prompt Injection
Metrics معمولاً ساختاریافتهاند، اما Labelها، Annotationها و توضیحات هشدار ممکن است متن آزاد یا اطلاعاتی از سامانههای مختلف داشته باشند.
بنابراین نمیتوان فرض کرد تمام دادههای ورودی به Agent قابل اعتماد هستند.
۱. جلوگیری از PromQL دلخواه
مدل نباید بتواند آدرس Prometheus، نام Query یا محدوده دسترسی را آزادانه تعیین کند.
۲. اعتبارسنجی Labelها
نام میزبان، سرویس، Tenant و سایر Labelها باید از فهرست مجاز و با محدوده دسترسی معتبر دریافت شوند.
۳. محافظت از اطلاعات زیرساخت
جزئیات نام میزبانها، IPهای داخلی، نام پروژهها و آدرس Dashboardهای خصوصی ممکن است محرمانه باشند.
۴. جلوگیری از Prompt Injection
متن Annotation یا Runbook باید داده غیرقابل اعتماد تلقی شود و نباید بتواند دستورهای سیستم یا مجوز Tool را تغییر دهد.
۵. تفکیک Credentialها
حساب خواندن Metrics نباید Credentialهای مدیریت سرور یا تغییر Firewall را در اختیار داشته باشد.
۶. کنترل خروجی مدل
پیشنهاد LLM نباید مستقیماً به فرمان اجرایی تبدیل شود. نام اقدام، پارامتر و هدف باید در یک سیاست مستقل اعتبارسنجی شوند.
۷. محافظت از پایگاه داده Incident
گزارشها باید با مالکیت مناسب، حداقل مجوز، Backup و کنترل دسترسی نگهداری شوند.
منابع تکمیلی: OWASP AI Agent Security و OpenAI Guardrails and Human Review.
تستهای ضروری برای AI Server Monitoring Agent
پیش از اتصال Agent به مانیتورینگ واقعی باید هم مسیر موفق و هم وضعیتهای شکست آزمایش شوند.
| سناریو | نتیجه مورد انتظار |
|---|---|
| CPU بالاتر از Threshold | ثبت Signal |
| CPU و Latency نزدیک به هم | ایجاد فرضیه ارتباط، نه علت قطعی |
| Metric ناشناس | رد ورودی |
| داده قدیمی | رد داده Stale |
| میزبان نامعتبر | رد Label |
| Metrics عادی | عدم ایجاد Incident غیرضروری |
| هشدار تکراری | عدم ایجاد Incident دوم در محدوده نمونه |
| تأیید طرح | ثبت تصمیم بدون اجرای عملیات |
| تأیید دوباره | رد تصمیم تکراری |
| قطع Prometheus | ثبت خطای جمعآوری، نه اعلام سلامت قطعی |
| Timeout مدل | ادامه هشداردهی اصلی بدون وابستگی به LLM |
| دستور مخرب در Annotation | عدم اجرای فرمان یا تغییر مجوز |
اجرای تستهای خودکار
.venv/bin/python -m unittest -v \
test_monitor_agent.py
بسته دانلودی دارای هفت تست خودکار است که اعتبارسنجی داده، Correlation، نبود هشدار، Deduplication و ثبت تأیید بدون عملیات اجرایی را بررسی میکنند.
موفقیت تستها به معنی آماده بودن کل معماری Production نیست؛ اتصال Prometheus، احراز هویت اپراتور و Executor جداگانه در نمونه آموزشی وجود ندارند و باید مستقل تست شوند.
نکات Production برای Agent مانیتورینگ سرور
Collector و Adapter مستقل
داده واقعی باید توسط Adapter مورد اعتماد دریافت و پس از اعتبارسنجی در اختیار Analyzer قرار گیرد.
کنترل نرخ درخواست
Agent نباید هر ثانیه Queryهای سنگین اجرا کند. دوره بررسی، Timeout و سقف تعداد Query باید مشخص باشند.
تشخیص Data Gap
نبود داده نباید همیشه معادل سالم بودن سرویس در نظر گرفته شود. قطع Exporter یا Scrape باید بهعنوان وضعیت جداگانه بررسی شود.
تنظیم Alert Threshold با داده واقعی
آستانهها باید براساس الگوی ترافیک، SLO و تجربه واقعی کاربران تنظیم شوند. آستانه ثابت برای همه VPSها مناسب نیست.
مدیریت همزمانی
اگر چند Worker یک Incident را بررسی میکنند، باید از ایجاد تصمیمهای متناقض و تکراری جلوگیری شود.
مدیریت هزینه LLM
برای هر هشدار مستقل مدل را فراخوانی نکنید. بهتر است پس از Grouping و Correlation، فقط Incidentهای مناسب وارد تحلیل هوش مصنوعی شوند.
مانیتورینگ خود Agent
باید تأخیر تحلیل، خطای Adapter، تعداد Incidentهای باز، وضعیت Queue، مصرف منابع و نرخ شکست فرآیندهای Agent نیز ثبت شود.
اجرای مستقل هشدارهای حیاتی
قطع Agent نباید سیستم Alertmanager یا مسیر اطلاعرسانی اضطراری را مختل کند.
Backup و نگهداری Audit
دیتابیس Incident باید دارای سیاست Backup و Retention متناسب با نیاز عملیاتی باشد.
اشتباهات رایج هنگام ساخت AI Server Monitoring Agent
۱. دادن Root Access به Agent
برای مشاهده Metrics ضروری نیست. دسترسی خواندن را از عملیات مدیریتی جدا کنید.
۲. اعلام علت قطعی از روی Correlation
همزمانی دو Metric اثباتکننده علت نیست. فرضیه و شواهد را جدا ثبت کنید.
۳. استفاده از Threshold ثابت برای تمام سرورها
رفتار VPSها و سرویسهای مختلف یکسان نیست. معیارها را براساس بار واقعی تنظیم کنید.
۴. نادیده گرفتن خطای Scrape
اگر داده دریافت نشده باشد، نمیتوان صرفاً نتیجه گرفت سرور سالم است.
۵. ایجاد یک Incident برای هر هشدار کوچک
بدون Grouping و Deduplication، تعداد اعلانها میتواند بسیار زیاد شود.
۶. اعتماد کامل به پیشنهاد LLM
مدل ممکن است توصیه نامناسب یا پرخطر ارائه دهد. پیشنهاد باید با Runbook و سیاست مجوز بررسی شود.
۷. اجازه اجرای دستور دلخواه
Agent نباید بتواند فرمان Shell تولیدشده را مستقیماً روی سرور اجرا کند.
۸. تأیید بدون اتصال به پارامتر دقیق
Approval باید به هدف و نسخه مشخص طرح مرتبط باشد؛ نه یک اجازه عمومی و نامحدود.
۹. Rollback بدون Backup
برای بعضی عملیاتها بازگشت ممکن نیست. پیش از تغییر باید قابلیت جبران واقعی بررسی شود.
۱۰. نداشتن Audit
بدون Audit مشخص نمیشود چه کسی طرح را تأیید کرده و چه نتیجهای ثبت شده است.
۱۱. وابسته کردن هشداردهی به API مدل
اگر سرویس LLM قطع شود، هشدارهای ضروری نباید از کار بیفتند.
۱۲. نداشتن کنترل Freshness
داده قدیمی میتواند به پیشنهاد اشتباه منجر شود. Timestamp و وضعیت Scrape را بررسی کنید.
۱۳. نداشتن مدیریت Incidentهای تکراری
یک اختلال طولانی نباید بیدلیل صدها Incident مستقل ایجاد کند.
۱۴. ارسال اطلاعات حساس زیرساخت به مدل
فقط دادههای ضروری و مجاز را ارسال کنید و Credentialها یا جزئیات محرمانه را حذف کنید.
سؤالات متداول درباره AI Server Monitoring Agent
AI Server Monitoring Agent چیست؟
سیستمی است که دادههای مانیتورینگ سرور را تحلیل میکند، هشدارهای مرتبط را بررسی میکند و پیشنهادهای فنی برای رسیدگی آماده میکند.
آیا Agent مانیتورینگ به Root نیاز دارد؟
خیر. میتوان Metrics را از سرویسهای مخصوص مانیتورینگ با مجوز فقطخواندنی دریافت کرد.
آیا AI Monitoring جایگزین Prometheus میشود؟
خیر. معمولاً مکمل Prometheus و Alertmanager است، نه جایگزین جمعآوری Time Series و هشداردهی اصلی.
Node Exporter چه کاری انجام میدهد؟
شاخصهای مرتبط با سیستمعامل Linux و منابع میزبان را برای جمعآوری توسط Prometheus ارائه میکند.
Alertmanager چه تفاوتی با Prometheus دارد؟
Prometheus داده و Ruleها را ارزیابی میکند؛ Alertmanager هشدارهای دریافتی را گروهبندی، مسیردهی و مدیریت میکند.
Alert Correlation چیست؟
بررسی ارتباط احتمالی میان هشدارها براساس زمان، سرویس، میزبان و وابستگی عملیاتی است.
آیا همبستگی به معنی علت قطعی است؟
خیر. تشخیص علت نیازمند شواهد و بررسی تکمیلی است.
آیا CPU بالا همیشه مشکل است؟
خیر. به نوع بار کاری، مدت افزایش و اثر روی کاربران بستگی دارد.
آیا مصرف بالای RAM همیشه خطرناک است؟
خیر. باید حافظه قابل استفاده، Cache، Swap و نشانههای فشار حافظه نیز بررسی شوند.
آیا Up=0 به معنی قطع بودن قطعی سرویس است؟
خیر. این شاخص معمولاً عدم موفقیت Scrape را نشان میدهد و ممکن است علت آن در شبکه یا Exporter باشد.
Read-Only First چیست؟
رویکردی است که Agent ابتدا فقط اطلاعات را مشاهده و تحلیل میکند و مجوز تغییر سیستم ندارد.
آیا Agent میتواند Restart را پیشنهاد دهد؟
بله، اما پیشنهاد با اجرای واقعی تفاوت دارد و باید براساس شواهد و مجوز بررسی شود.
Approval Gate چه کاربردی دارد؟
مانع اجرای عملیات حساس بدون تأیید معتبر و بررسی شرایط لازم میشود.
آیا تأیید اپراتور بهتنهایی کافی است؟
خیر. مجوز، پارامترهای عملیات، وضعیت منبع و کنترل مستقل Backend نیز باید بررسی شوند.
Rollback چه زمانی لازم است؟
پیش از تغییراتی که امکان بازگشت دارند باید طرح جبران و شرایط اجرای آن مشخص شود.
آیا تمام عملیاتها قابل Rollback هستند؟
خیر. برخی اثرها مانند قطع ارتباط هنگام Restart یا حذف بدون Backup کاملاً قابل جبران نیستند.
آیا میتوان از OpenAI برای تحلیل Metrics استفاده کرد؟
بله. میتوان دادههای ساختاریافته را به مدل داد تا گزارش و فرضیه تولید کند؛ بدون اعطای ابزار مدیریتی.
آیا برای اجرای Agent به GPU نیاز است؟
اگر مدل از طریق API اجرا شود، معمولاً برای خود برنامه GPU محلی لازم نیست.
آیا SQLite برای شروع کافی است؟
برای Demo و بار محدود مناسب است. در محیط پرترافیک میتوان PostgreSQL و صف پایدار را بررسی کرد.
چگونه هزینه API را کم کنیم؟
با Grouping هشدارها، تحلیل قطعی شاخصها و فراخوانی مدل فقط برای Incidentهای مناسب.
آیا PromQL را به مدل بدهیم تا هر Query خواست اجرا کند؟
بهتر است خیر. Queryهای مجاز باید در Backend محدود و از پیش تعریف شده باشند.
چگونه از Prompt Injection جلوگیری کنیم؟
متن Annotationها و اطلاعات خارجی را غیرقابل اعتماد بدانید و ابزارهای اجرایی را از مدل جدا نگه دارید.
آیا Agent باید هر مشکل را خودکار برطرف کند؟
خیر. ابتدا مشاهده، تحلیل، ثبت Incident و پیشنهاد بررسی؛ سپس در صورت نیاز، اقدام مجاز با تأیید مستقل.
چگونه صحت سیستم را آزمایش کنیم؟
با تست داده قدیمی، هشدارهای مرتبط و نامرتبط، Metric ناشناس، Deduplication، مجوز اپراتور و عدم اجرای عملیات ناخواسته.
جمعبندی
ساخت AI Server Monitoring Agent میتواند مدیریت VPS و سرویسهای آنلاین را هوشمندتر کند؛ اما ارزش واقعی آن فقط در تولید هشدار بیشتر نیست، بلکه در دستهبندی رخدادها، بررسی ارتباط آنها و ارائه پیشنهادهای قابل پیگیری است.
در این آموزش با نقش Prometheus، Node Exporter و Alertmanager آشنا شدیم و یک نمونه Python ساختیم که شاخصهای مشخص را بررسی میکند، هشدارهای مربوط به یک میزبان را Correlate میکند و Incident را در SQLite ثبت میکند.
همچنین یاد گرفتیم که همبستگی به معنی علت قطعی نیست، داده قدیمی نباید مبنای تصمیم قرار بگیرد و مدل زبانی نباید بدون کنترل به ابزارهای مدیریتی دسترسی داشته باشد.
برای عملیات حساس، Approval Gate و یک Executor مستقل با مجوز محدود لازم است. همچنین پیش از هر تغییر، باید امکان Rollback، وضعیت فعلی سرویس و اثر احتمالی روی کاربران مشخص باشد.
اصل نهایی: Agent مانیتورینگ باید ابتدا مشاهده کند، سپس با شواهد تحلیل کند و پیشنهاد بدهد؛ اجرای عملیات خطرناک نباید نتیجه مستقیم تصمیم مدل باشد.
اگر به بررسی محتوای خطاها در فایلهای لاگ نیز نیاز دارید، مقاله ساخت Agent تحلیل لاگ سرور بدون Root Access را مطالعه کنید. برای طراحی تأیید انسانی عملیات حساس نیز راهنمای Human-in-the-Loop برای AI Agent مکمل این آموزش است.
منابع و مستندات رسمی
۱. Prometheus — Node Exporter
راهنمای رسمی مانیتورینگ Linux با Node Exporter
۲. Prometheus — Alerting Rules
ساخت Alert Rule و تنظیم for و keep_firing_for
۳. Prometheus — Alertmanager
Grouping، Deduplication، Silence و Inhibition
۴. Prometheus — HTTP API
راهنمای رسمی Query و Query Range
۵. Prometheus — Querying Basics
۶. Grafana — Alerting Best Practices
کاهش Alert Fatigue و طراحی هشدار قابل اقدام
۷. OpenAI — Guardrails and Human Review
تأیید انسانی و کنترل عملیات حساس Agent
۸. OWASP — AI Agent Security
مستندات امنیت Agent و حداقل دسترسی
۹. OWASP — Prompt Injection Prevention
مقابله با دستورهای مخرب در داده غیرقابل اعتماد
۱۰. Python — sqlite3
مستندات رسمی ذخیره Incident و Audit در SQLite
دیدگاهها (۰)