
 Amir Jabbari
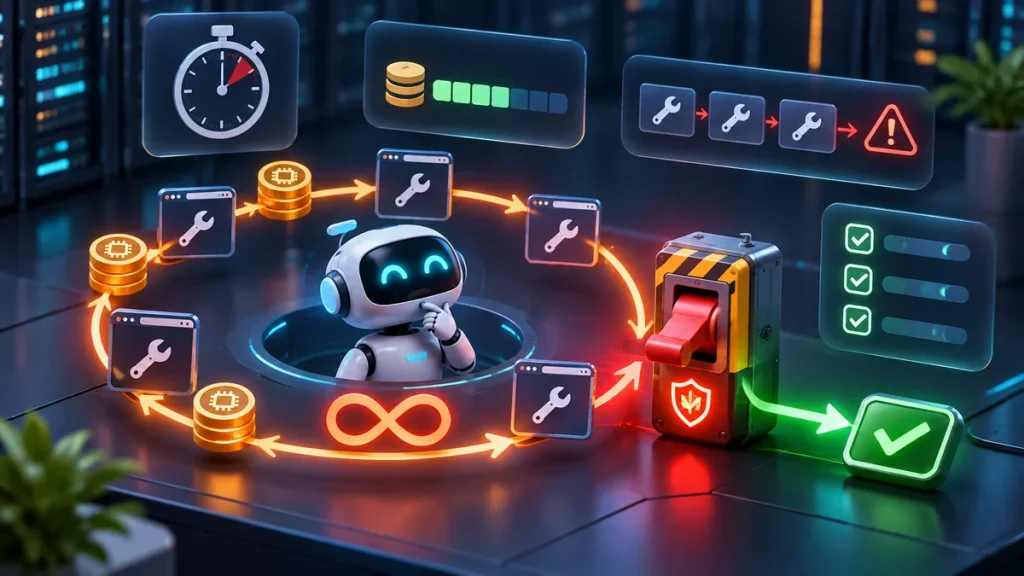
تصور کنید یک دستیار هوش مصنوعی برای بررسی سفارشهای مشتریان ساختهاید. کاربر میخواهد وضعیت سفارش خود را بداند، اما Agent بهجای پاسخدادن، مرتب ابزار جستوجوی سفارش را فراخوانی میکند. هر بار نتیجه تقریباً یکسانی دریافت میکند و دوباره همان درخواست را ارسال میکند. چند دقیقه بعد، تعداد فراخوانیهای API افزایش یافته، توکن زیادی مصرف شده و هنوز پاسخ مناسبی به کاربر داده نشده است.
این وضعیت یکی از مشکلات مهم سیستمهای عاملمحور هوش مصنوعی است و با نام AI Agent Infinite Loop یا حلقه بینهایت در Agent شناخته میشود. گاهی این حلقه واقعاً نامحدود است و گاهی فقط تعداد زیادی تکرار بیفایده دارد؛ اما در هر دو حالت میتواند باعث افزایش هزینه، طولانیشدن پاسخ، اشغال Workerها و حتی اجرای چندباره عملیات حساس شود.
برای جلوگیری از این مشکل نباید فقط به یک دستور در Prompt مانند «ابزارها را تکرار نکن» اعتماد کنیم. یک Agent پایدار باید محدودیتهای واقعی در سطح برنامه داشته باشد؛ از جمله Max Turns، Termination Conditions، Token Budget، تشخیص اقدام تکراری، Timeout و Circuit Breaker.
در این مقاله ابتدا علت ایجاد حلقه در AI Agent را بررسی میکنیم، سپس با Python یک محافظ اجرایی میسازیم و روش پیادهسازی محدودیت در OpenAI Agents SDK، LangGraph و AutoGen را توضیح میدهیم.
AI Agent Infinite Loop چیست؟
حلقه بینهایت در AI Agent زمانی رخ میدهد که سیستم بدون رسیدن به وضعیت پایان، مجموعهای از تصمیمها یا عملیات را بارها تکرار کند.
یک Agent معمولاً شامل چرخهای از فراخوانی مدل، انتخاب ابزار، اجرای ابزار، دریافت نتیجه و تصمیمگیری بعدی است. این ساختار برای انجام وظایف چندمرحلهای ضروری است؛ اما اگر شرط پایان مشخص نباشد، Agent ممکن است در همان چرخه باقی بماند.
یک مثال ساده:
User Request
     |
     v
Agent Decision
     |
     v
Tool: search_order
     |
     v
Result: not_found
     |
     v
Agent Decision
     |
     +----> Tool: search_order
                 |
                 v
            Result: not_found
                 |
                 +----> Repeat...
در این سناریو، Agent ممکن است تصور کند با تکرار جستوجو نتیجه متفاوتی به دست میآورد. اگر هیچ محدودیتی اعمال نشود، تعداد فراخوانیها و هزینه پردازش افزایش خواهد یافت.
نکته: هر تکراری نشانه Loop نیست. برخی وظایف مانند صفحهبندی نتایج، Retry کنترلشده و جستوجوی مرحلهای به تکرار نیاز دارند. مسئله اصلی، تکرار بدون پیشرفت معنادار است.
چرا Agent وارد حلقه بیپایان میشود؟
۱. نبود شرط پایان مشخص
اگر Agent نداند چه زمانی باید پاسخ نهایی بدهد، ممکن است تا رسیدن به یک نتیجه نامعلوم به ابزارها مراجعه کند.
۲. نتیجه مبهم یا ناقص ابزار
ابزار ممکن است خروجی خالی، خطای نامشخص یا دادهای برگرداند که برای تصمیمگیری کافی نباشد. مدل نیز بدون برنامه جایگزین، همان ابزار را تکرار کند.
۳. فراخوانی تکراری با پارامتر یکسان
برای مثال، ابزار search_products با یک عبارت ثابت بارها اجرا میشود، بدون اینکه Query یا وضعیت کار تغییر کند.
۴. گردش بین دو Agent یا Tool
در معماری Multi-Agent ممکن است Agent اول کار را به Agent دوم واگذار کند و Agent دوم دوباره آن را به Agent اول برگرداند.
۵. Retry بدون محدودیت
اگر یک ابزار خطا بدهد و سیستم بدون Backoff، سقف تلاش و بررسی نوع خطا دوباره آن را اجرا کند، یک حلقه Retry ایجاد میشود.
۶. Prompt Injection یا دستور غیرقابل اعتماد
گاهی متن بازیابیشده از وب یا نتیجه یک ابزار شامل دستورهایی است که Agent را به اجرای مکرر عملیات یا نادیدهگرفتن محدودیتها تشویق میکند. خروجی ابزار نباید بتواند سیاستهای توقف برنامه را تغییر دهد.
حلقه بینهایت چه آسیبی ایجاد میکند؟
| پیامد | توضیح |
|---|---|
| افزایش هزینه توکن | هر فراخوانی جدید مدل میتواند توکن ورودی و خروجی مصرف کند |
| افزایش Latency | کاربر برای پاسخ نهایی مدت بیشتری منتظر میماند |
| اشباع ظرفیت | Workerها و اتصالها درگیر عملیات بینتیجه میشوند |
| خطای Rate Limit | تعداد درخواست یا مصرف TPM ممکن است از سهمیه عبور کند |
| عملیات تکراری | ابزار دارای اثر جانبی ممکن است چندبار اجرا شود |
| افت تجربه کاربری | کاربر پاسخ ناقص، دیرهنگام یا هیچ پاسخی دریافت نمیکند |
فرض کنید هر دور Agent در یک مثال فرضی ۲۰۰۰ توکن ورودی و ۵۰۰ توکن خروجی مصرف کند. با ۲۰ دور تکرار، مجموع مصرف به ۵۰ هزار توکن میرسد؛ حتی اگر وظیفه اصلی با چند دور قابل انجام بوده باشد.
این محاسبه نمونه آموزشی است و هزینه واقعی به تعرفه مدل، طول تاریخچه، Cache، ابزارها و سایر عوامل بستگی دارد.
معماری جلوگیری از Infinite Loop در Agent
برای کنترل این مشکل، بهتر است تصمیم توقف به یک لایه مستقل از مدل سپرده شود.
User Request
      |
      v
Agent Runtime Guard
      |
      +-- Max Turns
      +-- Token / Cost Budget
      +-- Deadline / Timeout
      +-- Repeated Action Detection
      +-- Circuit Breaker
      |
      v
Model Decision
      |
      +---- Final Answer ---> Finish
      |
      v
Tool Execution
      |
      v
Progress Validation
      |
      +---- No Progress ---> Stop / Escalate
      |
      +---- Progress ------> Next Turn
در این معماری، مدل میتواند تصمیم بگیرد چه اقدامی انجام دهد، اما اجازه ندارد محدودیتهای اصلی زمان، تعداد مرحله و هزینه را بهصورت دلخواه غیرفعال کند.
Max Turns چیست و چگونه Loop را متوقف میکند؟
Max Turns حداکثر تعداد دورهای اجرای Agent را مشخص میکند. اگر Agent تا این تعداد نتواند پاسخ نهایی بسازد، اجرای آن متوقف میشود.
برای مثال، اگر یک Agent پشتیبانی معمولاً در ۲ تا ۴ دور پاسخ میدهد، میتوان سقف اولیه محافظهکارانهای برای تعداد دورهای مجاز در نظر گرفت و بعد از تست واقعی آن را تنظیم کرد.
اما تعریف Turn در فریمورکها یکسان نیست:
- در OpenAI Agents SDK، Turn به یک فراخوانی منطقی مدل اشاره دارد که میتواند شامل Tool Call نیز باشد.
- در LangGraph، محدودیت Recursion بر تعداد Super-stepهای اجرای گراف اعمال میشود؛ نه لزوماً تعداد فراخوانی مدل.
- در AutoGen، محدودیت پیامها و Turnهای Agent میتواند مفهوم متفاوتی داشته باشد.
بنابراین عدد ۱۰ در یک فریمورک الزاماً معادل عدد ۱۰ در فریمورک دیگر نیست.
نمونه Max Turns در OpenAI Agents SDK
در OpenAI Agents SDK میتوان هنگام اجرای Agent مقدار max_turns را مشخص کرد.
import asyncio

from agents import Agent, Runner
from agents.exceptions import MaxTurnsExceeded

agent = Agent(
    name="Support Assistant",
    instructions=(
        "Help users with support questions. "
        "Do not repeat actions without new evidence."
    ),
)

async def main():
    try:
        result = await Runner.run(
            agent,
            "Explain the order status workflow.",
            max_turns=5,
        )
        print(result.final_output)

    except MaxTurnsExceeded:
        print("Agent stopped: turn limit reached.")


if __name__ == "__main__":
    asyncio.run(main())
برای اجرای این نمونه، کتابخانه openai-agents و اعتبارنامه لازم مدل را باید مطابق مستندات رسمی نصب و تنظیم کنید.
در صورت عبور از سقف تعیینشده، SDK خطای MaxTurnsExceeded ایجاد میکند. این خطا را نباید با افزایش خودکار و نامحدود سقف پنهان کرد.
همچنین Max Turns بهتنهایی سقف دقیق هزینه نیست. ممکن است یک Turn بسیار پرمصرف باشد یا فراخوانیهای داخلی و ابزارهای خارجی هزینه جداگانه داشته باشند.
منبع:
مستندات اجرای OpenAI Agents SDK.
Termination Conditions چیست؟
Termination Condition قاعدهای است که مشخص میکند اجرای Agent چه زمانی باید به پایان برسد.
مهمترین شرایط پایان عبارتاند از:
- تولید پاسخ نهایی معتبر.
- تکمیل موفق هدف اصلی.
- رسیدن به سقف تعداد دورها.
- پایان ظرفیت توکن یا بودجه هزینه.
- عبور از حداکثر زمان اجرا.
- تشخیص تکرار بدون پیشرفت.
- شکست مکرر یک ابزار یا سرویس.
- تشخیص عملیات غیرمجاز یا نیازمند تأیید انسانی.
در بسیاری از سیستمها، ترکیب این شرایط با منطق OR مناسب است؛ یعنی اگر هر شرط حفاظتی فعال شد، اجرا متوقف شود.
اما شرط «موفقیت» با شرایط توقف ناشی از خطا متفاوت است. لازم است وضعیت پایان بهصورت شفاف مانند completed، budget_exceeded یا repeated_action ثبت شود.
Termination در AutoGen
در مستندات Microsoft AutoGen برای AgentChat شرطهایی مانند MaxMessageTermination، TokenUsageTermination و TimeoutTermination وجود دارد.
برای نمونه، میتوان سقف پیام و زمان را ترکیب کرد:
from autogen_agentchat.conditions import (
    MaxMessageTermination,
    TimeoutTermination,
)

termination = (
    MaxMessageTermination(max_messages=10)
    | TimeoutTermination(timeout_seconds=60)
)

# Pass termination to a supported team constructor.
این یک قطعه پیکربندی است و برای اجرای کامل آن باید Team و Agentهای مربوطه ساخته شوند.
همچنین محدودیت مبتنی بر توکن در AutoGen به گزارششدن Usage توسط Agentها وابسته است؛ پس نباید آن را بدون بررسی بهعنوان سقف مالی قطعی در نظر گرفت.
منبع:
AutoGen Termination Conditions.
جلوگیری از Loop در LangGraph
در LangGraph، ممکن است گرافی ساخته شود که دو Node مرتب یکدیگر را فراخوانی کنند. اگر شرط توقف بهدرستی تعریف نشده باشد، اجرای گراف ادامه پیدا میکند.
LangGraph برای جلوگیری از این اتفاق از recursion_limit پشتیبانی میکند.
from langgraph.errors import GraphRecursionError

try:
    result = graph.invoke(
        initial_state,
        {"recursion_limit": 20},
    )

except GraphRecursionError:
    print("Graph stopped: step limit exceeded.")
در این قطعه فرض شده graph و initial_state از قبل تعریف شدهاند.
مقدار ۲۰ نمونه آموزشی است. این محدودیت تعداد Super-stepهای گراف را کنترل میکند و نباید با تعداد دقیق درخواستهای مدل یا Tool Call اشتباه گرفته شود.
اگر گراف به حد مجاز رسید، بهتر است ابتدا مسیر Nodeها و شرطهای پایان بررسی شوند. افزایش مداوم recursion_limit بدون رفع علت میتواند فقط هزینه مشکل را بیشتر کند.
منبع:
LangGraph Recursion Limit.
چگونه برای Agent سقف توکن و هزینه تعریف کنیم؟
محدودیت تعداد دورها لازم است، اما کافی نیست. یک Agent میتواند در تعداد کمی دور نیز توکن زیادی مصرف کند.
برای مدیریت مصرف بهتر است سه نوع محدودیت جداگانه داشته باشیم:
| نوع محدودیت | کاربرد |
|---|---|
| Token Budget | کنترل تعداد توکن مصرفی یا رزروشده |
| Cost Budget | کنترل هزینه بر اساس تعرفه مدل و ابزارها |
| Time Budget | کنترل مدت زمان مجاز اجرای وظیفه |
فرض کنید برای یک وظیفه بودجه ۱۲ هزار توکن تعریف شده است. قبل از هر فراخوانی مدل باید مصرف قبلی و برآورد توکن درخواست بعدی بررسی شود.
اگر ظرفیت کافی باقی نمانده باشد، بهتر است Agent بهجای ارسال یک درخواست پرهزینه دیگر، اجرای فعلی را بهصورت کنترلشده متوقف کند.
نکته مهم: تعداد دقیق توکن خروجی قبل از تولید پاسخ مشخص نیست. برای اجرای سقف سخت باید ظرفیت محافظهکارانهای رزرو کرد، حداکثر خروجی را محدود ساخت و پس از پاسخ مصرف واقعی را ثبت کرد.
حتی با این روش نیز بهدلیل تفاوت در روش محاسبه توکن، Retryهای SDK یا هزینه ابزارها، سقف مالی دقیق نیازمند لایه حسابداری مستقل است.
Repeated-Action Detection چیست؟
Repeated-Action Detection یعنی تشخیص اینکه Agent در حال تکرار یک اقدام یکسان بدون پیشرفت واقعی است.
برای این کار میتوان نام ابزار و پارامترهای مؤثر آن را به یک شناسه قابل مقایسه تبدیل کرد.
بهعنوان مثال:
Call 1:
search_order(order_id=842)

Call 2:
search_order(order_id=842)

Call 3:
search_order(order_id=842)

Result:
Repeated action detected
البته نام ابزار و پارامترها بهتنهایی همیشه کافی نیستند. ممکن است یک درخواست ثابت در زمان متفاوت نتیجه جدیدی بدهد؛ برای مثال در Polling یک کار در حال انجام.
بنابراین بهتر است تشخیص تکرار به وضعیت کار، تغییر نتیجه و وجود پیشرفت معنادار وابسته باشد. عملیات Polling مجاز نیز باید فاصله زمانی و سقف تکرار مشخص داشته باشد.
Circuit Breaker در AI Agent چیست؟
Circuit Breaker الگویی برای متوقفکردن موقت فراخوانی یک سرویس یا ابزار مشکلدار است.
فرض کنید ابزار دریافت اطلاعات مشتری چند بار متوالی Timeout میدهد. اگر Agent بدون کنترل دوباره همان ابزار را اجرا کند، هم زمان و توکن هدر میرود و هم فشار روی سرویس معیوب افزایش پیدا میکند.
در Circuit Breaker معمولاً سه وضعیت وجود دارد:
| وضعیت | معنی |
|---|---|
| Closed | سرویس مجاز به دریافت درخواست است |
| Open | فراخوانی موقتاً متوقف میشود |
| Half-Open | پس از زمان بازیابی، تعداد محدودی درخواست آزمایشی مجاز است |
اگر درخواست آزمایشی موفق باشد، مدار میتواند دوباره بسته شود. اگر شکست ادامه پیدا کند، برای مدتی دیگر باز میماند.
تشخیص اقدام تکراری و Circuit Breaker دو مفهوم متفاوتاند: اولی رفتار Agent را بررسی میکند، دومی بیشتر برای جلوگیری از فشار مداوم بر یک وابستگی معیوب استفاده میشود.
آموزش عملی: ساخت محافظ ضد Loop با Python
برای درک بهتر این مفاهیم، یک کنترلکننده آموزشی با کتابخانههای استاندارد Python میسازیم. این نمونه به مدل واقعی متصل نیست و برای آزمایش منطق توقف، هزینه API ندارد.
ابتدا پوشه پروژه را ایجاد کنید:
mkdir -p ~/agent-loop-guard
cd ~/agent-loop-guard

python3 --version
اکنون فایل loop_guard.py را با محتوای زیر بسازید:
import hashlib
import json
import time

from dataclasses import dataclass, field


class AgentStopped(Exception):
    pass


def action_fingerprint(name, arguments):
    payload = json.dumps(
        {
            "tool": name,
            "arguments": arguments,
        },
        sort_keys=True,
        ensure_ascii=False,
        separators=(",", ":"),
    )

    return hashlib.sha256(
        payload.encode("utf-8")
    ).hexdigest()


@dataclass
class AgentGuard:
    max_turns: int = 6
    max_tokens: int = 12000
    max_seconds: float = 60
    max_same_action: int = 3

    started_at: float = field(
        default_factory=time.monotonic
    )

    turns: int = 0
    used_tokens: int = 0
    last_action: str | None = None
    consecutive_same: int = 0

    def check_deadline(self):
        elapsed = time.monotonic() - self.started_at

        if elapsed >= self.max_seconds:
            raise AgentStopped("deadline_exceeded")

    def before_model_call(self, reserved_tokens):
        self.check_deadline()

        if self.turns >= self.max_turns:
            raise AgentStopped("max_turns_exceeded")

        if reserved_tokens < 1: raise ValueError("Invalid reservation") if self.used_tokens + reserved_tokens > self.max_tokens:
            raise AgentStopped("token_budget_exceeded")

        self.turns += 1
        self.used_tokens += reserved_tokens

    def before_tool_call(self, name, arguments):
        self.check_deadline()

        fingerprint = action_fingerprint(
            name,
            arguments,
        )

        if fingerprint == self.last_action:
            self.consecutive_same += 1
        else:
            self.last_action = fingerprint
            self.consecutive_same = 1

        if self.consecutive_same >= self.max_same_action:
            raise AgentStopped("repeated_action_detected")


def run_demo():
    guard = AgentGuard()

    actions = [
        ("search_order", {"order_id": "842"}),
        ("search_order", {"order_id": "842"}),
        ("search_order", {"order_id": "842"}),
        ("search_order", {"order_id": "842"}),
    ]

    try:
        for name, arguments in actions:
            guard.before_model_call(
                reserved_tokens=1500
            )

            guard.before_tool_call(
                name,
                arguments,
            )

            print(
                "Executed:",
                name,
                arguments,
            )

        print("Agent completed")

    except AgentStopped as error:
        print("Agent stopped:", error)

    print("Turns:", guard.turns)
    print("Reserved tokens:", guard.used_tokens)


if __name__ == "__main__":
    run_demo()
این کنترلکننده چهار محدودیت دارد: تعداد فراخوانی مدل، ظرفیت توکن رزروشده، زمان اجرای کل وظیفه و تکرار متوالی یک Tool Call با پارامترهای یکسان.
برای اجرا:
python3 loop_guard.pyخروجی مورد انتظار:
Executed: search_order {'order_id': '842'}
Executed: search_order {'order_id': '842'}
Agent stopped: repeated_action_detected
Turns: 3
Reserved tokens: 4500
در فراخوانی سوم ابزار، کنترلکننده الگوی تکراری را شناسایی و اجرا را متوقف میکند؛ بنابراین عملیات سوم اجرا نمیشود.
محدودیت نمونه: مقدار ۴۵۰۰ نشاندهنده توکن رزروشده فرضی است، نه مصرف واقعی مدل. در یک برنامه عملی باید پس از هر پاسخ، Usage واقعی را ثبت و رزروها را مدیریت کرد. همچنین تابع بررسی زمان فقط قبل از مراحل اجرا فراخوانی میشود و نمیتواند یک عملیات مسدودشده را بهتنهایی قطع کند.
چرا Deadline بهتنهایی کافی نیست؟
در نمونه قبل، برنامه قبل از هر مرحله بررسی میکند که زمان مجاز تمام نشده باشد. اما اگر یک Tool Call برای دو دقیقه منتظر شبکه بماند، این بررسی نمیتواند اجرای در حال انتظار را خودکار متوقف کند.
برای عملیات ناهمزمان میتوان از Timeout در سطح اجرا استفاده کرد:
import asyncio


async def slow_tool():
    await asyncio.sleep(30)
    return {"status": "completed"}


async def main():
    try:
        result = await asyncio.wait_for(
            slow_tool(),
            timeout=5,
        )
        print(result)

    except TimeoutError:
        print("Tool stopped by timeout")


asyncio.run(main())
این نمونه از Cancellation در Python استفاده میکند. بااینحال، لغو یک Coroutine الزاماً عملیات خارجی را متوقف نمیکند؛ برای مثال، ممکن است درخواست در سمت ارائهدهنده AI یا دیتابیس همچنان در حال انجام باشد.
برای عملیات دارای اثر جانبی، علاوه بر Timeout باید Idempotency، وضعیت اجرا و سازوکار بازیابی نیز در نظر گرفته شود.
نمونه ساده Circuit Breaker در Python
کد زیر یک Circuit Breaker آموزشی برای یک ابزار خارجی ایجاد میکند. پس از چند شکست متوالی، فراخوانی موقتاً ممنوع میشود و پس از گذشت زمان مشخص، یک تلاش آزمایشی مجاز خواهد بود.
import time


class CircuitOpen(Exception):
    pass


class CircuitBreaker:
    def __init__(
        self,
        threshold=3,
        cooldown=30,
    ):
        self.threshold = threshold
        self.cooldown = cooldown
        self.failures = 0
        self.opened_at = None
        self.probe_in_progress = False

    def before_call(self):
        if self.opened_at is None:
            return

        elapsed = (
            time.monotonic() - self.opened_at
        )

        if elapsed < self.cooldown: raise CircuitOpen("circuit_open") if self.probe_in_progress: raise CircuitOpen("half_open_busy") self.probe_in_progress = True def success(self): self.failures = 0 self.opened_at = None self.probe_in_progress = False def failure(self): self.probe_in_progress = False self.failures += 1 if self.failures >= self.threshold:
            self.opened_at = time.monotonic()


breaker = CircuitBreaker(
    threshold=3,
    cooldown=30,
)


def call_with_breaker(tool_function):
    breaker.before_call()

    try:
        result = tool_function()
    except Exception:
        breaker.failure()
        raise
    else:
        breaker.success()
        return result
این نمونه در یک فرایند و برای اجرای غیرهمزمان طراحی شده است. اگر چند Worker یا چند سرور دارید، وضعیت Circuit Breaker باید بهصورت ایمن هماهنگ شود. در محیط چندنخی نیز قفل یا پیادهسازی آماده و آزموده لازم است.
برای Production بهتر است فقط خطاهای واقعاً مرتبط با سلامت وابستگی، مانند Timeout و خطاهای موقت سرویس، در شمارنده شکست لحاظ شوند. خطای ورودی نامعتبر کاربر نباید الزاماً Circuit Breaker کل سرویس را فعال کند.
چگونه پیشرفت واقعی Agent را تشخیص دهیم؟
تشخیص تکرار صرفاً از روی نام ابزار همیشه کافی نیست. بعضی Agentها باید چند بار همان ابزار را اجرا کنند، اما هر بار با اطلاعات جدید.
برای تشخیص پیشرفت میتوان شاخصهای زیر را بررسی کرد:
- آیا نتیجه ابزار نسبت به اجرای قبلی تغییر کرده است؟
- آیا داده جدیدی به وضعیت وظیفه اضافه شده است؟
- آیا تعداد زیرکارهای باقیمانده کاهش یافته است؟
- آیا Agent از یک مرحله معتبر به مرحله بعدی رسیده است؟
- آیا دلیل مشخصی برای تکرار عملیات وجود دارد؟
برای مثال، تکرار ابزار دریافت وضعیت پردازش تا زمان تکمیل یک Job میتواند طبیعی باشد؛ اما همان Polling باید حداکثر تعداد تلاش و فاصله زمانی مشخص داشته باشد.
در مقابل، تکرار جستوجوی یک محصول با ورودی و نتیجه کاملاً یکسان، بدون تغییر برنامه اجرا، میتواند نشانه نبود پیشرفت باشد.
چگونه از توقف اشتباه Agent جلوگیری کنیم؟
اگر سیاست تشخیص Loop بیش از حد سختگیرانه باشد، ممکن است Agentهای سالم را نیز متوقف کند. این وضعیت با نام False Positive شناخته میشود.
برای جلوگیری از آن بهتر است:
- ابزارهای Polling مجاز را از سایر ابزارها تفکیک کنید.
- برای هر ابزار محدودیت متناسب با نوع کار تعیین کنید.
- بهجای صرفاً شمار تکرار، پیشرفت واقعی را نیز بررسی کنید.
- برای وظایف طولانی، Budget و Deadline جداگانه تعریف کنید.
- دلیل توقف را در Trace ثبت کنید.
- سناریوهای تکرار مجاز را به Golden Dataset اضافه کنید.
تستهای رگرسیون کمک میکنند متوجه شوید تغییر سیاست ضد Loop، توانایی Agent برای انجام وظایف سالم را کاهش داده است یا خیر.
جلوگیری از Loop در سیستمهای Multi-Agent
در سیستمهای چندعاملی، تکرار ممکن است میان چند Agent رخ دهد و فقط با بررسی یک Tool Call قابل تشخیص نباشد.
برای مثال:
Planner Agent
      |
      v
Research Agent
      |
      v
Planner Agent
      |
      v
Research Agent
      |
     ...
برای کنترل این وضعیت بهتر است بودجه اصلی در سطح Workflow مشترک نگهداری شود، نه اینکه هر Agent با دریافت کار تازه محدودیت خود را از صفر شروع کند.
همچنین تعداد Handoffها، شناسه وظیفه و تاریخچه مسیرهای تکراری باید ثبت شوند.
در برنامههایی که اجرای Agent پس از Pause یا Restart ادامه پیدا میکند، وضعیت Budget و شمارنده مراحل نیز باید همراه Checkpoint ذخیره شود؛ وگرنه ممکن است با هر Resume محدودیتها دوباره آغاز شوند.
تفاوت Retry، Loop و Circuit Breaker
| مفهوم | هدف | خطر بدون کنترل |
|---|---|---|
| Retry | تلاش مجدد پس از خطای موقت | تکرار بیش از حد درخواست |
| Agent Loop | تکرار چرخه تصمیمگیری | نبود پیشرفت و مصرف بیرویه |
| Circuit Breaker | قطع موقت دسترسی به وابستگی معیوب | فشار مداوم به سرویس مشکلدار |
| Max Turns | تعیین سقف اجرای Agent | ادامه بیش از حد وظیفه |
| Deadline | تعیین آخرین زمان مجاز اجرا | اشغال طولانی منابع |
این کنترلها مکمل یکدیگر هستند. برای نمونه، Retry محدود و Circuit Breaker میتوانند از سرویس خارجی محافظت کنند، درحالیکه Max Turns و Budget از کل اجرای Agent محافظت میکنند.
چه معیارهایی را برای تشخیص Loop مانیتور کنیم؟
برای شناسایی Loop پیش از افزایش شدید هزینه، بهتر است اطلاعات زیر در سطح هر اجرای Agent ثبت شوند:
- Turn Count: تعداد دورهای مدل.
- Tool Call Count: تعداد اجرای ابزارها.
- Repeated Action Count: تعداد اقدامات تکراری.
- Progress Indicator: وضعیت پیشرفت وظیفه.
- Input/Output Tokens: مصرف واقعی توکن.
- Estimated Cost: هزینه محاسبهشده.
- Elapsed Time: مدت اجرای وظیفه.
- Termination Reason: علت پایان یا توقف.
- Circuit Breaker State: وضعیت مدار ابزارهای خارجی.
برای مثال، اگر تعداد فراخوانی ابزار یک Agent ناگهان افزایش پیدا کند، درحالیکه نرخ موفقیت وظایف ثابت مانده یا کاهش یافته است، میتواند نشانه وجود حلقه یا اجرای غیرضروری باشد.
برای تحلیل بهتر، نتایج را بر اساس نسخه Prompt، مدل، ابزار و نوع وظیفه تفکیک کنید.
چگونه سیستم ضد Loop را آزمایش کنیم؟
قبل از انتشار یک Agent، بهتر است مجموعهای از سناریوهای مشخص برای بررسی شرایط توقف اجرا شود.
| سناریوی تست | نتیجه مورد انتظار |
|---|---|
| ابزار یکسان سه بار تکرار شود | توقف طبق سیاست تکرار |
| Agent از سقف Turn عبور کند | توقف با دلیل max_turns_exceeded |
| بودجه توکن تمام شود | عدم ارسال فراخوانی بعدی |
| ابزار چند Timeout متوالی داشته باشد | فعالشدن Circuit Breaker |
| Polling با پیشرفت معتبر انجام شود | ادامه تا سقف مجاز |
| Agent به پاسخ نهایی معتبر برسد | پایان موفق، بدون فراخوانی اضافه |
| Workflow پس از Restart ادامه یابد | حفظ شمارندهها و بودجه قبلی |
این تستها میتوانند بخشی از مجموعه AI Agent Evaluation و فرایند CI باشند تا تغییر Prompt یا ابزارها باعث حذف ناخواسته محدودیتها نشود.
پس از توقف Agent چه پاسخی به کاربر بدهیم؟
زمانی که اجرای Agent متوقف میشود، بهتر است سیستم وضعیت را صادقانه و روشن گزارش کند.
برای مثال، اگر سقف زمان یا تعداد مراحل به پایان رسیده، نباید پاسخ ناقص بهعنوان نتیجه قطعی ارائه شود.
بهجای آن میتوان اعلام کرد که بررسی کامل نشده است و بسته به نوع کار، امکان تلاش مجدد با تأیید کاربر یا ارجاع به پشتیبانی وجود دارد.
اگر عملیات دارای اثر جانبی مانند ثبت سفارش یا پرداخت بوده است، قبل از Retry باید وضعیت واقعی عملیات بررسی شود. اجرای دوباره بدون کنترل میتواند باعث تغییرات تکراری شود.
اشتباههای رایج در جلوگیری از Agent Loop
۱. اعتماد صرف به Prompt
دستور «بیش از پنج بار ابزار اجرا نکن» مفید است، اما جایگزین محدودیت اجرایی مستقل از مدل نمیشود.
۲. افزایش پیوسته Max Turns
اگر Agent به سقف اجرا میرسد، ابتدا باید علت نبود پیشرفت بررسی شود. افزایش نامحدود سقف ممکن است هزینه خطا را بیشتر کند.
۳. شمارش توکن بدون رزرو ظرفیت
اگر فقط پس از پاسخ مصرف توکن بررسی شود، ممکن است درخواست بعدی از بودجه فراتر برود.
۴. توقف بر اساس هر تکرار یکسان
تکرار کنترلشده بعضی ابزارها ضروری است. تشخیص باید با نوع کار و پیشرفت واقعی هماهنگ باشد.
۵. ساخت Circuit Breaker بدون وضعیت Half-Open
در این حالت ممکن است سرویس پس از بازیابی همچنان مسدود بماند یا ناگهان تمام درخواستها دوباره به سمت آن ارسال شوند.
۶. فراموشکردن بودجه در Multi-Agent
اگر هر Handoff بودجه تازهای ایجاد کند، کنترل کل Workflow عملاً بیاثر میشود.
۷. ثبت نکردن دلیل توقف
بدون ثبت Termination Reason تشخیص تفاوت خطای مدل، سقف هزینه، Deadline و اختلال ابزار دشوار خواهد شد.
چکلیست جلوگیری از Loop در محیط Production
- سقف مشخص برای تعداد دورهای Agent.
- سقف مستقل برای تعداد Tool Call و Handoff.
- بودجه توکن و هزینه در سطح کل Workflow.
- Deadline واقعی همراه Timeout ابزارها.
- تشخیص اقدامات تکراری و نبود پیشرفت.
- Retry محدود با Backoff و Jitter.
- Circuit Breaker برای وابستگیهای ناپایدار.
- حفظ وضعیت محدودیتها پس از Resume یا Restart.
- Idempotency برای عملیات دارای اثر جانبی.
- ثبت Trace و علت توقف بدون افشای داده حساس.
- تست سناریوهای Loop در CI.
- پاسخ شفاف به کاربر هنگام توقف اجباری.
جمعبندی؛ بهترین راه جلوگیری از Loop بینهایت AI Agent چیست؟
برای جلوگیری از AI Agent Infinite Loop باید محدودیتها در سطح Runtime و خارج از تصمیمگیری آزاد مدل اعمال شوند.
Max Turns از اجرای بیش از حد دورهای مدل جلوگیری میکند؛ Token و Cost Budget مصرف منابع را کنترل میکنند؛ Repeated-Action Detection تکرار بدون پیشرفت را شناسایی میکند و Circuit Breaker جلوی فشار مداوم بر ابزارهای معیوب را میگیرد.
بهترین راهکار، ترکیب این کنترلها با Timeout، مانیتورینگ و تستهای رگرسیون است. به این ترتیب اگر Agent نتوانست وظیفه را تکمیل کند، بهجای ادامه بیپایان و مصرف نامحدود، با دلیل مشخص، هزینه کنترلشده و امکان بررسی و بازیابی متوقف میشود.
سؤالات متداول درباره AI Agent Infinite Loop
AI Agent Infinite Loop چیست؟
وضعیتی است که Agent بدون پیشرفت مؤثر، تصمیمها یا فراخوانی ابزارها را بارها تکرار میکند و به پاسخ نهایی نمیرسد.
آیا Max Turns بهتنهایی جلوی افزایش هزینه را میگیرد؟
خیر. Max Turns تعداد دورها را محدود میکند، ولی برای کنترل هزینه باید Budget توکن و هزینه، محدودیت خروجی و سیاست Retry نیز وجود داشته باشد.
چطور فراخوانی تکراری Tool را تشخیص دهیم؟
میتوان نام ابزار، پارامترهای مؤثر و وضعیت پیشرفت کار را مقایسه کرد و پس از تکرار بینتیجه، اجرا را متوقف ساخت.
تفاوت Circuit Breaker و Retry چیست؟
Retry برای تلاش دوباره پس از خطای موقت است؛ Circuit Breaker پس از شکستهای مشخص، فراخوانی سرویس مشکلدار را برای مدتی محدود میکند.
در LangGraph چگونه Loop را متوقف کنیم؟
با تعریف مسیر پایان صحیح، کنترل وضعیت گراف و استفاده از recursion_limit میتوان تعداد مراحل اجرا را محدود کرد.
آیا Agentهای چندگانه هم ممکن است Loop شوند؟
بله. ممکن است Agentها کار را مرتب به یکدیگر واگذار کنند. محدودیت کل Workflow و سقف Handoff برای کنترل این وضعیت مهم هستند.
آیا جلوگیری از Loop باید قبل از انتشار تست شود؟
بله. سناریوهای تکرار ابزار، پایان بودجه، Timeout و بازیابی پس از Restart بهتر است در تستهای خودکار و CI قرار بگیرند.
دیدگاهها (۰)