
 Amir Jabbari
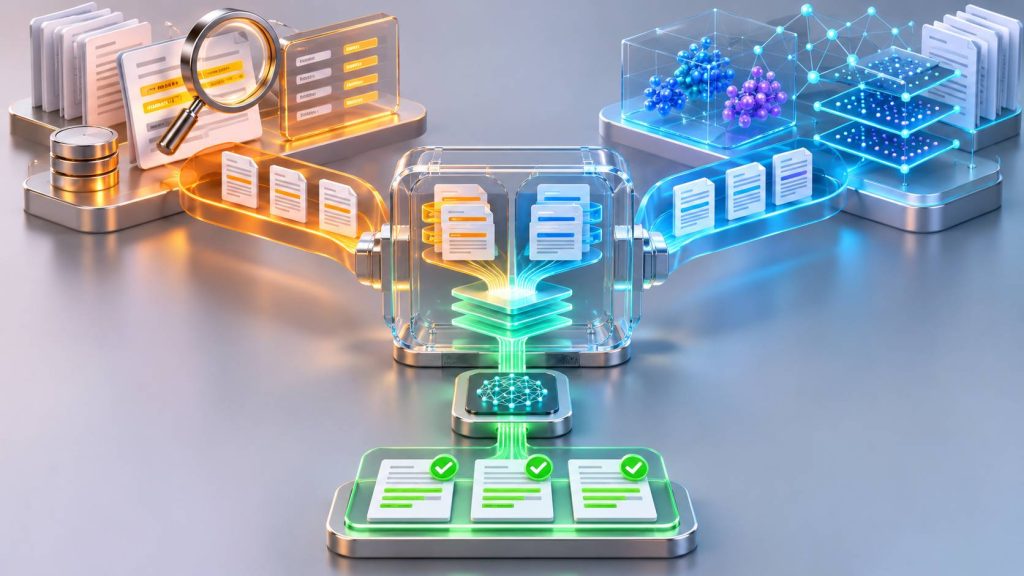
فرض کنید برای وبسایت یا نرمافزار خود یک سیستم RAG ساختهاید تا هوش مصنوعی بتواند بر اساس مستندات اختصاصی پاسخ دهد. یکی از کاربران عبارت «خطای 429 در API» را جستوجو میکند و کاربر دیگری میپرسد «چرا سرور بعد از ارسال درخواستهای زیاد پاسخ نمیدهد؟» هر دو سؤال ممکن است به یک موضوع اشاره داشته باشند، اما کلمات استفادهشده در آنها یکسان نیست.
جستوجوی واژگانی مانند BM25 معمولاً در پیدا کردن عبارتهای دقیق، نام محصولات، نسخه نرمافزار و کدهای خطا عملکرد مناسبی دارد. در مقابل، Vector Search با کمک Embedding میتواند اسنادی را پیدا کند که از نظر معنا به سؤال نزدیکاند، حتی اگر واژههای یکسانی نداشته باشند.
اما آیا میتوان از مزایای هر دو روش استفاده کرد؟ پاسخ مثبت است. Hybrid Search RAG روشی برای ترکیب جستوجوی واژگانی و جستوجوی معنایی است تا اطلاعات مرتبطتری برای پاسخگویی مدل زبانی بازیابی شوند.
در این مقاله ابتدا تفاوت BM25 و Vector Search را بررسی میکنیم، سپس روشهای ترکیب امتیازها مانند Reciprocal Rank Fusion یا RRF را توضیح میدهیم. در ادامه، یک جستوجوی ترکیبی با Python میسازیم، Reranking را اضافه میکنیم و روش ارزیابی کیفیت روی متن فارسی را یاد میگیریم.
Hybrid Search در RAG چیست؟
Hybrid Search یا جستوجوی ترکیبی، روشی است که نتایج دو یا چند موتور بازیابی اطلاعات را با یکدیگر ادغام میکند.
در یک معماری رایج RAG، دو مسیر جستوجو وجود دارد:
- Lexical Search: جستوجو بر اساس واژهها و عبارتهای موجود در اسناد، معمولاً با الگوریتمی مانند BM25.
- Semantic Search: جستوجو بر اساس بردارهای معنایی تولیدشده توسط مدل Embedding.
هر مسیر فهرستی از اسناد مرتبط احتمالی تولید میکند. سپس یک مرحله Fusion، این نتایج را ترکیب و رتبهبندی نهایی را ایجاد میکند.
برای مثال، اگر کاربری درباره مشکل اتصال Redis سؤال کند، جستوجوی واژگانی ممکن است مستنداتی را پیدا کند که دقیقاً عبارت Redis را دارند. جستوجوی معنایی نیز ممکن است راهنمای رفع مشکلات اتصال Cache یا سرویس ذخیرهسازی را بازیابی کند.
ترکیب درست این دو مسیر میتواند احتمال پیداکردن اطلاعات مرتبط را افزایش دهد؛ البته این بهبود باید با Benchmark واقعی تأیید شود.
معماری Hybrid Search چگونه کار میکند؟
معماری پایه جستوجوی ترکیبی معمولاً شامل دو Retriever و یک مرحله ادغام است.
User Question
       |
       +--------------------------+
       |                          |
       v                          v
Text Normalization          Query Embedding
       |                          |
       v                          v
BM25 / Lexical Search       Vector Search
       |                          |
       v                          v
Top 20 Keyword Results      Top 20 Vector Results
       |                          |
       +-------------+------------+
                     |
                     v
               Rank Fusion
                RRF / Other
                     |
                     v
             Candidate Documents
                     |
                     v
                Reranker
                 Optional
                     |
                     v
                Top 5 Chunks
                     |
                     v
                RAG Context
                     |
                     v
                   LLM
                     |
                     v
           Answer with Citations
در این معماری، هر دو Retriever میتوانند بهصورت موازی اجرا شوند. اگرچه این کار ممکن است زمان جستوجو را کاهش دهد، اما زمان ساخت Embedding، ادغام و Reranking همچنان باید در محاسبه Latency نهایی لحاظ شود.
نکته: اجرای Hybrid Search الزاماً به دو دیتابیس مستقل نیاز ندارد. بعضی موتورهای جستوجو هر دو قابلیت جستوجوی متنی و برداری را در یک سامانه ارائه میکنند.
BM25 چیست و چه مزیتی دارد؟
BM25 یکی از الگوریتمهای شناختهشده رتبهبندی اسناد در جستوجوی اطلاعات است. این الگوریتم بر اساس حضور واژههای Query در سند، میزان تکرار آنها، طول سند و میزان رایجبودن واژه در مجموعه اسناد امتیاز میدهد.
برای مثال، اگر کاربر عبارت ERR_CONNECTION_REFUSED را جستوجو کند، وجود دقیق این عبارت در یک سند میتواند نشانه مهمی از ارتباط آن سند با سؤال باشد.
از مزایای BM25 میتوان به موارد زیر اشاره کرد:
- عدم نیاز به مدل Embedding.
- عملکرد مناسب برای شناسهها و اصطلاحات دقیق.
- امکان ایجاد ایندکس واژگانی سریع.
- قابلیت کنترل وزن عنوان و متن.
- هزینه نسبتاً قابل پیشبینی در بسیاری از موتورهای جستوجو.
اما BM25 به کیفیت Tokenization و یکسانسازی متن وابسته است. اگر سؤال و سند از واژههای متفاوت استفاده کنند، ممکن است ارتباط معنایی میان آنها شناسایی نشود.
Vector Search چه تفاوتی با BM25 دارد؟
در Vector Search، متن سؤال و اسناد توسط یک مدل Embedding به بردار عددی تبدیل میشوند.
سپس فاصله یا شباهت بردار سؤال با بردار اسناد محاسبه میشود و نزدیکترین نتایج بازگردانده میشوند.
برای مثال، سؤال «چگونه مصرف منابع سرور را کاهش دهیم؟» ممکن است از نظر معنایی به سندی درباره «بهینهسازی CPU و RAM سرویسها» نزدیک باشد.
این قابلیت در جستوجوی مفهومها و عبارتهای متفاوت مفید است؛ بااینحال، Vector Search همیشه در پیداکردن شماره نسخه، شناسه سفارش و نام دقیق یک دستور برتری ندارد.
همچنین کیفیت آن به مدل Embedding، زبان اسناد، روش Chunking، نوع ایندکس و پارامترهای جستوجو وابسته است.
مقایسه BM25 و Vector Search
| معیار | BM25 | Vector Search |
|---|---|---|
| پایه جستوجو | واژهها و بسامد آنها | شباهت بردارهای معنایی |
| جستوجوی شناسه دقیق | معمولاً مناسب | ممکن است کمتر قابل اعتماد باشد |
| عبارتهای مترادف | به مترادفسازی و Query Expansion وابسته | اغلب مناسبتر |
| نیاز به Embedding | خیر | بله |
| حساسیت به Tokenizer | زیاد | وابسته به Tokenizer مدل |
| هزینه ایجاد ایندکس | ایندکس واژگانی | تولید و نگهداری بردارها |
| جستوجوی فارسی | نیازمند نرمالسازی و تحلیل زبانی مناسب | نیازمند مدل چندزبانه مناسب |
نقطه قوت Hybrid Search این است که میتواند هر دو نوع شواهد را وارد رتبهبندی کند. در نتیجه، لازم نیست برای تمام درخواستها فقط به تطبیق واژه یا فقط به شباهت معنایی تکیه کنیم.
چرا نباید امتیاز BM25 و Vector را مستقیم جمع کنیم؟
یکی از اشتباههای مهم در پیادهسازی Hybrid Search این است که امتیاز خام BM25 و امتیاز خام Vector Search بدون تبدیل یا نرمالسازی با یکدیگر جمع شوند.
فرض کنید نتیجه جستوجوی واژگانی به یک سند امتیاز ۱۲٫۵ داده، درحالیکه امتیاز شباهت Cosine آن در جستوجوی برداری ۰٫۸۶ است.
این دو عدد مستقیماً قابل مقایسه نیستند.
BM25 معمولاً مقیاس ثابت و جهانی ندارد. مقدار آن به Query، طول اسناد، پارامترهای الگوریتم و توزیع واژهها در مجموعه داده وابسته است.
در مقابل، شباهت Cosine مقیاس و تفسیر متفاوتی دارد.
اگر بدون نرمالسازی این امتیازها را جمع کنیم، ممکن است BM25 فقط به دلیل بزرگتربودن دامنه عددی بر نتیجه نهایی غالب شود.
برای حل این مشکل دو روش مهم وجود دارد: Fusion مبتنی بر رتبه و Fusion مبتنی بر امتیاز نرمالشده.
مستندات رسمی:
Hybrid Queries در Qdrant.
RRF چیست و چرا برای Hybrid Search مناسب است؟
Reciprocal Rank Fusion یا RRF روشی برای ترکیب چند فهرست رتبهبندی است.
مزیت RRF این است که بهجای جمعکردن امتیازهای خام ناهممقیاس، از رتبه هر سند در فهرست نتایج استفاده میکند.
در نسخه کلاسیک، امتیاز هر سند به شکل زیر محاسبه میشود:
RRF Score = مجموع 1 / (k + رتبه سند در هر فهرست)
در این رابطه، رتبه از عدد ۱ شروع میشود و k یک ثابت برای کنترل اثر جایگاه رتبه است.
مقدار ۶۰ یکی از مقادیر متداول در پیادهسازی کلاسیک RRF است، اما مقدار مناسب بسته به پیادهسازی و داده میتواند متفاوت باشد.
مثال ساده RRF
فرض کنید BM25 سه سند را به ترتیب A، B و C پیدا کرده است. جستوجوی برداری نیز اسناد B، D و A را به ترتیب برگردانده است.
| سند | رتبه BM25 | رتبه Vector |
|---|---|---|
| A | ۱ | ۳ |
| B | ۲ | ۱ |
| C | ۳ | — |
| D | — | ۲ |
در RRF، سند B به دلیل حضور در رتبههای بالای هر دو فهرست میتواند امتیاز ترکیبی بالاتری دریافت کند.
سندی که فقط در یکی از دو فهرست وجود دارد نیز حذف نمیشود؛ بلکه فقط از همان فهرست امتیاز دریافت میکند.
RRF یک نقطه شروع مناسب است، بهخصوص زمانی که امتیازهای خام Retrieverها کالیبره نشدهاند.
Relative Score Fusion چیست؟
در روش Relative Score Fusion، امتیازهای هر Retriever به یک مقیاس مشترک تبدیل میشوند و سپس با وزن مشخص ترکیب میشوند.
یکی از روشهای ساده نرمالسازی، Min-Max است:
Normalized Score = (Score – Minimum) / (Maximum – Minimum)
پس از نرمالسازی میتوان امتیازها را با وزنهای مشخص ترکیب کرد.
برای مثال، اگر وزن مسیر Vector برابر ۰٫۶ و وزن BM25 برابر ۰٫۴ باشد، سهم امتیاز معنایی بیشتر خواهد بود.
اما این وزنها نباید بدون ارزیابی انتخاب شوند.
در Weaviate، روش relativeScoreFusion از نسخه ۱٫۲۴ به بعد بهعنوان روش پیشفرض Fusion استفاده میشود. این روش اطلاعات مربوط به فاصله نسبی امتیازها را حفظ میکند، درحالیکه Fusion مبتنی بر رتبه فقط جایگاه اسناد را در نظر میگیرد.
منبع:
Hybrid Search در Weaviate.
RRF بهتر است یا نرمالسازی امتیازها؟
| روش | مزیت | محدودیت |
|---|---|---|
| RRF | عدم وابستگی به مقیاس امتیاز خام | فاصله واقعی بین امتیازها را نادیده میگیرد |
| Min-Max Fusion | حفظ تفاوت نسبی امتیازهای هر Query | حساسیت به نتایج پرت و اندازه فهرست |
| Weighted Fusion | قابلیت تنظیم سهم هر Retriever | نیازمند مجموعه ارزیابی معتبر |
| RRF + Reranker | ترکیب Recall اولیه و رتبهبندی دقیقتر | هزینه و Latency بیشتر |
اگر هنوز داده ارزیابی کافی ندارید، شروع با RRF بدون وزندهی خاص معمولاً منطقی است.
وقتی Golden Dataset آماده شد، میتوان وزنها و روش Fusion را روی بخشی از داده تنظیم و روی بخش مستقل دیگری ارزیابی کرد.
Hybrid Search فارسی چه مشکلاتی دارد؟
برای محتوای فارسی، کیفیت جستوجوی واژگانی بهشدت به نرمالسازی و Tokenization وابسته است.
برای مثال، عبارتهای زیر ممکن است از نظر کاربر یکسان باشند اما در متن خام متفاوت دیده شوند:
- «نرم افزار» و «نرمافزار»
- «صورتحساب» و «صورت حساب»
- «كاربری» و «کاربری»
- «مي شود» و «میشود»
از طرف دیگر، Queryهایی مانند HTTP 429، ERR_CONNECTION_REFUSED و Ubuntu 24.04 دارای شناسههای فنی هستند که نباید هنگام پردازش متن تخریب شوند.
برای ساخت Hybrid Search فارسی مناسب، بهتر است:
- حروف عربی و فارسی رایج را یکسانسازی کنیم.
- سیاست مشخصی برای نیمفاصله داشته باشیم.
- شناسهها، نام پکیجها و شماره نسخهها را حفظ کنیم.
- برای متنهای تخصصی مترادفهای معتبر تعریف کنیم.
- مدل Embedding چندزبانه را روی داده فارسی آزمایش کنیم.
- نتایج را به تفکیک نوع سؤال تحلیل کنیم.
هیچ Tokenizer سادهای برای تمام حالتهای فارسی کافی نیست. به همین دلیل در بخش عملی از یک نرمالسازی آموزشی استفاده میکنیم و محدودیتهای آن را مشخص خواهیم کرد.
پیشنیازهای آموزش عملی
برای ساخت نمونه Hybrid Search از Python و کتابخانههای زیر استفاده میکنیم:
- rank-bm25: اجرای جستوجوی واژگانی BM25.
- sentence-transformers: تولید Embedding اسناد و سؤالها.
- NumPy: محاسبه شباهت برداری.
- مدل multilingual-e5-small: تولید بردارهای چندزبانه برای آزمایش.
این آموزش برای مجموعه کوچک اسناد طراحی شده است و تمام بردارها را در حافظه نگهداری میکند. برای مجموعههای بزرگتر، باید از موتور ایندکسگذاری مناسب استفاده شود.
مدل intfloat/multilingual-e5-small طبق مستندات خود برای وظایف Retrieval به پیشوندهای query: و passage: نیاز دارد؛ این پیشوندها برای متن فارسی نیز باید رعایت شوند.
منبع:
مدل multilingual-e5-small.
مرحله اول: نصب کتابخانهها
روی سیستم لینوکسی دارای Python و pip، پوشه پروژه را ایجاد کنید:
mkdir -p ~/hybrid-rag
cd ~/hybrid-rag

python3 -m venv .venv
source .venv/bin/activate

python -m pip install --upgrade pip

python -m pip install \
  numpy \
  rank-bm25 \
  sentence-transformers
در اولین اجرا، مدل Embedding باید دانلود شود؛ بنابراین دسترسی اینترنت و فضای کافی برای فایلهای مدل لازم است.
اگر روی سرور Production کار میکنید، نسخه کتابخانهها و مدل را پس از آزمایش ثابت نگه دارید و فایلهای مدل را از منابع مورد اعتماد دریافت کنید.
مرحله دوم: ساخت Hybrid Retriever با Python
در این مثال چند سند فارسی ساختگی درباره خطاهای سرور، حسابداری و مدیریت API تعریف میکنیم.
دو مسیر جستوجو روی همین مجموعه اجرا خواهند شد. مسیر اول BM25 و مسیر دوم Embedding است.
در پایان نتایج با RRF ادغام میشوند.
فایل hybrid_search.py را با کد زیر بسازید:
import re
import unicodedata
import numpy as np
from rank_bm25 import BM25Okapi
from sentence_transformers import SentenceTransformer
DOCUMENTS = [
{
"id": "doc-1",
"title": "رفع خطای HTTP 429",
"body": (
"خطای 429 زمانی رخ میدهد که "
"تعداد درخواستها از محدودیت "
"Rate Limit بیشتر شود."
),
},
{
"id": "doc-2",
"title": "مدیریت فشار روی API",
"body": (
"برای جلوگیری از فشار درخواستها "
"میتوان از صف، محدودیت نرخ و "
"کنترل درخواست همزمان استفاده کرد."
),
},
{
"id": "doc-3",
"title": "راهنمای نصب SSL",
"body": (
"برای فعالسازی HTTPS باید "
"گواهی معتبر نصب و تمدید آن "
"بهدرستی تنظیم شود."
),
},
{
"id": "doc-4",
"title": "راهنمای ثبت فاکتور",
"body": (
"در نرم افزار حسابداری ابتدا "
"مشتری و کالا انتخاب میشوند "
"و سپس فاکتور ثبت میشود."
),
},
{
"id": "doc-5",
"title": "بررسی خطای ERR_CONNECTION_REFUSED",
"body": (
"این خطا ممکن است به بستهبودن "
"پورت، توقف سرویس یا مشکل "
"اتصال شبکه مربوط باشد."
),
},
]
def normalize_persian(text):
text = unicodedata.normalize("NFKC", text)
text = text.replace("ي", "ی").replace("ك", "ک")
text = text.replace("\u200c", " ")
return text.lower().strip()
def tokenize(text):
text = normalize_persian(text)
# Keep Latin identifiers and version numbers.
return re.findall(
r"[^\W_]+(?:[._-][^\W_]+)*",
text,
flags=re.UNICODE,
)
def document_text(doc):
return doc["title"] + "\n" + doc["body"]
class HybridRetriever:
def __init__(self, documents):
self.documents = documents
self.texts = [
document_text(doc)
for doc in documents
]
tokenized = [
tokenize(text)
for text in self.texts
]
self.bm25 = BM25Okapi(tokenized)
self.encoder = SentenceTransformer(
"intfloat/multilingual-e5-small"
)
passages = [
"passage: " + normalize_persian(text)
for text in self.texts
]
self.embeddings = self.encoder.encode(
passages,
normalize_embeddings=True,
convert_to_numpy=True,
)
def bm25_search(self, question, top_k=5):
scores = self.bm25.get_scores(
tokenize(question)
)
ranked = np.argsort(-scores)
return [
{
"id": self.documents[i]["id"],
"score": float(scores[i]),
}
for i in ranked[:top_k]
]
def vector_search(self, question, top_k=5):
query_vector = self.encoder.encode(
["query: " + normalize_persian(question)],
normalize_embeddings=True,
convert_to_numpy=True,
)[0]
# Embeddings are normalized:
# dot product equals cosine similarity.
scores = self.embeddings @ query_vector
ranked = np.argsort(-scores)
return [
{
"id": self.documents[i]["id"],
"score": float(scores[i]),
}
for i in ranked[:top_k]
]
@staticmethod
def rrf_fusion(lists, k=60, weights=None):
if weights is None:
weights = [1.0] * len(lists)
if len(weights) != len(lists):
raise ValueError("Invalid fusion weights")
scores = {}
for results, weight in zip(lists, weights):
for rank, item in enumerate(
results,
start=1,
):
doc_id = item["id"]
scores[doc_id] = (
scores.get(doc_id, 0.0)
+ weight / (k + rank)
)
return sorted(
scores,
key=lambda doc_id: (
-scores[doc_id],
doc_id,
),
)
def search(self, question, top_k=3):
candidate_k = min(
len(self.documents),
max(top_k, 5),
)
lexical = self.bm25_search(
question,
candidate_k,
)
semantic = self.vector_search(
question,
candidate_k,
)
ids = self.rrf_fusion(
[lexical, semantic],
k=60,
)[:top_k]
lookup = {
doc["id"]: doc
for doc in self.documents
}
return {
"bm25": lexical,
"vector": semantic,
"hybrid": [
lookup[doc_id]
for doc_id in ids
],
}
if __name__ == "__main__":
retriever = HybridRetriever(DOCUMENTS)
question = (
"چرا درخواستهای زیاد باعث خطای API میشوند؟"
)
result = retriever.search(
question,
top_k=3,
)
print("BM25:", result["bm25"])
print("VECTOR:", result["vector"])
print("\nHYBRID RESULTS:")
for doc in result["hybrid"]:
print(doc["id"], doc["title"])در این کد، تمام اسناد ابتدا بهصورت یکسان برای BM25 آماده میشوند. سپس مدل E5 برای هر سند یک Embedding تولید میکند.
هنگام جستوجو، سؤال کاربر به هر دو مسیر داده میشود و نتایج با RRF ادغام میشوند.
از آنجا که بردارها نرمال شدهاند، ضرب داخلی بردار سؤال و سند معادل شباهت Cosine آنها است.
محدودیت نمونه: این پیادهسازی برای آموزش و مجموعههای کوچک است. جستوجوی برداری با ضرب ماتریسی روی تمام اسناد انجام میشود و ایندکس ANN ندارد. همچنین BM25 پیادهسازیشده در حافظه برای ترافیک و مجموعه داده بسیار بزرگ طراحی نشده است.
مرحله سوم: اجرای جستوجوی ترکیبی
پس از ذخیره فایل، دستور زیر را اجرا کنید:
python hybrid_search.pyدر اولین اجرا، مدل Embedding بارگیری و بردارهای اسناد محاسبه میشوند.
خروجی برنامه سه بخش دارد: فهرست BM25، فهرست Vector و نتایج نهایی Hybrid.
ترتیب دقیق نتایج ممکن است با توجه به نسخه مدل و کتابخانهها متفاوت باشد. برای همین نباید بدون اجرای برنامه، یک رتبهبندی مشخص را بهعنوان نتیجه قطعی معرفی کرد.
برای بررسی تفاوت روشها میتوانید سؤال را به عبارتهای زیر تغییر دهید:
HTTP 429- «چطور فشار زیاد روی API را کنترل کنم؟»
ERR_CONNECTION_REFUSED- «چطور یک فاکتور برای مشتری ثبت کنم؟»
در Queryهایی که شناسه دقیق دارند، BM25 میتواند نقش مهمتری داشته باشد. در سؤالهای توصیفی، مسیر معنایی ممکن است اسناد بیشتری پیدا کند.
چرا RRF در نمونه Python درست کار میکند؟
تابع rrf_fusion بهجای استفاده از مقدار خام score هر Retriever، جایگاه سند در فهرست را میخواند.
مثلاً اگر سندی در رتبه اول BM25 و رتبه دوم Vector باشد، از هر دو مسیر سهم امتیاز دریافت میکند.
در صورت نبود یک سند در یکی از فهرستها، فقط امتیاز مسیر دیگر برای آن ثبت میشود.
همچنین در این مثال وزن هر دو مسیر برابر ۱ است.
اگر بعداً براساس Golden Dataset مشخص شود یکی از Retrieverها برای یک دسته سؤال بهتر عمل میکند، میتوان وزن مسیرها را تغییر داد.
اما برای جلوگیری از Overfitting بهتر است وزنها روی مجموعه Training یا Validation تنظیم شوند و عملکرد نهایی روی مجموعه Test مستقل اندازهگیری شود.
وزندهی BM25 و Vector در Hybrid Search
گاهی ترکیب برابر دو مسیر بهترین انتخاب نیست.
برای مثال، در یک مجموعه مستندات فنی شامل تعداد زیادی کد خطا، شماره نسخه و نام دستور، ممکن است بخواهیم BM25 سهم بیشتری داشته باشد.
در مقابل، برای مجموعهای از مقالات آموزشی با سؤالهای طبیعی، مسیر Vector میتواند ارزش بیشتری ایجاد کند.
در نمونه Python میتوان وزنها را بهشکل زیر تنظیم کرد:
fused_ids = retriever.rrf_fusion(
    [lexical_results, vector_results],
    k=60,
    weights=[1.5, 1.0],
)
این قطعه فرض میکند retriever و دو فهرست نتیجه قبلاً ایجاد شدهاند.
وزنهای فوق صرفاً مثالی هستند و مقدار بهینه عمومی محسوب نمیشوند.
در بعضی موتورهای جستوجو مانند Qdrant، امکانات تنظیم وزن و ثابت RRF به نسخه موتور وابستهاند؛ بنابراین قبل از انتقال همین تنظیمات به یک Backend دیگر باید مستندات همان نسخه بررسی شوند.
Reranker چیست و چرا پس از Hybrid Search استفاده میشود؟
حتی بعد از Fusion نیز ترتیب اسناد همیشه ایدهآل نیست.
برای مثال، ممکن است یک سند هم از نظر واژگانی و هم معنایی نسبتاً مرتبط باشد، اما پاسخ اصلی در سند دیگری قرار داشته باشد که رتبه پایینتری گرفته است.
در اینجا میتوان از Reranker استفاده کرد.
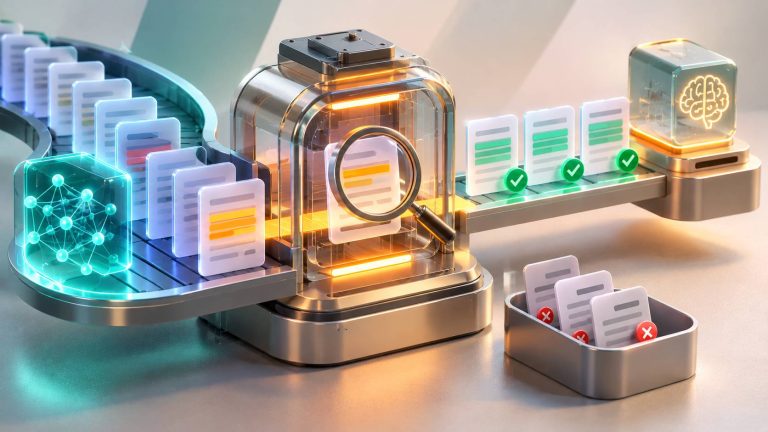
یک Reranker مبتنی بر Cross-Encoder معمولاً سؤال و متن هر سند کاندید را همزمان بررسی میکند و یک امتیاز ارتباط به آن جفت میدهد.
برخلاف مدل Embedding که بردار سؤال و سند را جداگانه تولید میکند، Cross-Encoder رابطه مستقیم بین آن دو متن را بررسی میکند.
این روش میتواند کیفیت رتبهبندی را بهتر کند، اما اجرای آن روی هزاران سند معمولاً پرهزینه است. به همین دلیل ابتدا با BM25 و Vector Search مجموعه محدودی از کاندیدها انتخاب میشود.
راهنمای رسمی:
Retrieve & Re-Rank در Sentence Transformers.
مرحله چهارم: افزودن Reranker چندزبانه
برای نمونه، میتوان از مدل چندزبانه BAAI/bge-reranker-v2-m3 استفاده کرد.
این مدل برای امتیازدهی به جفت سؤال و سند طراحی شده است. البته عملکرد آن روی اسناد فارسی پروژه باید جداگانه ارزیابی شود.
کد زیر را میتوانید در فایل مستقلی مانند rerank.py قرار دهید:
from sentence_transformers import CrossEncoder
from hybrid_search import (
DOCUMENTS,
HybridRetriever,
document_text,
)
retriever = HybridRetriever(DOCUMENTS)
reranker = CrossEncoder(
"BAAI/bge-reranker-v2-m3"
)
question = "چرا API با درخواست زیاد خطا میدهد؟"
result = retriever.search(
question,
top_k=5,
)
candidates = result["hybrid"]
pairs = [
(question, document_text(doc))
for doc in candidates
]
scores = reranker.predict(
pairs,
batch_size=4,
)
ranked = sorted(
zip(candidates, scores),
key=lambda pair: float(pair[1]),
reverse=True,
)
for doc, score in ranked[:3]:
print(
doc["id"],
round(float(score), 4),
doc["title"],
)این مثال پنج کاندید Hybrid را دوباره رتبهبندی میکند و سه نتیجه اول را نمایش میدهد.
در یک مجموعه واقعی بهتر است تعداد کاندیدهای اولیه را متناسب با ظرفیت و کیفیت بازیابی انتخاب کنید؛ مثلاً ۲۰ یا ۵۰ کاندید پیش از انتخاب پنج Chunk نهایی.
امتیاز خام Reranker الزاماً یک احتمال بین صفر و یک نیست. تفسیر مقدار آن به مدل و نوع خروجی بستگی دارد؛ بنابراین نباید آن را بدون کالیبراسیون بهعنوان درصد اطمینان نمایش داد.
منبع مدل:
BGE Reranker v2 M3.
چرا Reranking همیشه Recall را افزایش نمیدهد؟
نکته مهم این است که Reranker معمولاً اسناد جدیدی به مجموعه کاندیدها اضافه نمیکند؛ فقط همان نتایج را مرتب میکند.
فرض کنید یک سند مرتبط در هیچکدام از ۲۰ نتیجه اولیه BM25 و Vector وجود ندارد. Reranker که فقط همین کاندیدها را دریافت کرده، نمیتواند آن سند را به رتبه اول منتقل کند.
بنابراین باید دو کیفیت جدا اندازهگیری شوند:
- Candidate Recall: آیا Retrieverهای اولیه سند مرتبط را پیدا کردهاند؟
- Final Ranking Quality: آیا Reranker اسناد مرتبط را در رتبههای بالاتر قرار داده است؟
اگر کیفیت Candidate Recall ضعیف باشد، قبل از تغییر مدل Reranker باید BM25، Embedding، Chunking و اندازه Candidate Pool اصلاح شوند.
پیادهسازی Hybrid Search در Qdrant
اگر بهجای نمونه حافظهای Python از Qdrant استفاده میکنید، میتوانید از Query API برای ترکیب مسیرهای Dense و BM25 استفاده کنید.
در نسخههای جدید Qdrant، قابلیت Hybrid Queries امکان اجرای چند Prefetch و سپس Fusion نتایج را فراهم میکند.
در نمونه زیر فرض شده Collection از قبل با فیلدهای لازم برای BM25 و Dense Vector آماده شده است.
POST /collections/docs/points/query

{
  "prefetch": [
    {
      "query": {
        "text": "رفع خطای 429"
      },
      "using": "bm25",
      "limit": 20
    },
    {
      "query": [0.12, 0.35, 0.48],
      "using": "dense",
      "limit": 20
    }
  ],
  "query": {
    "rrf": {
      "k": 60
    }
  },
  "limit": 5
}
این قطعه صرفاً نمایشی است: بردار عددی نمونه فقط سه مقدار دارد و باید با Embedding واقعی و ابعاد Vector تعریفشده در Collection جایگزین شود. فیلدهای bm25 و dense نیز باید پیش از اجرا در Collection موجود باشند.
در Qdrant، تنظیم ثابت RRF با پارامتر k از نسخه ۱٫۱۶ پشتیبانی میشود و امکان Weighted RRF نیز در نسخههای جدیدتر ارائه شده است.
منبع:
مستندات Qdrant Hybrid Queries.
Hybrid Search در Weaviate
Weaviate نیز جستوجوی ترکیبی BM25 و Vector را در یک Query ارائه میکند.
برای مثال، در یک Collection از پیش آماده میتوان جستوجوی ترکیبی را به شکل زیر اجرا کرد:
collection = client.collections.use("Documents")

response = collection.query.hybrid(
    query="خطای 429 در API",
    alpha=0.5,
    limit=5,
)

for item in response.objects:
    print(item.properties)
این کد فرض میکند کلاینت Weaviate متصل شده، Collection وجود دارد و پیکربندی Vectorizer یا Query Vector لازم برای Hybrid Search آماده است.
پارامتر alpha میزان تأکید بر مسیر برداری و واژگانی را در Fusion مربوط به Weaviate مشخص میکند. مقدار صفر به سمت جستوجوی واژگانی و مقدار یک به سمت Vector Search میرود.
مقدار ۰٫۵ صرفاً نقطه شروع مناسبی برای مقایسه است؛ بهترین وزن باید روی مجموعه سؤالهای واقعی سنجیده شود.
منبع:
Weaviate Hybrid Search API.
چگونه کیفیت Hybrid Search را ارزیابی کنیم؟
اگر فقط چند سؤال دستی را امتحان کنیم، ممکن است نتیجهگیری اشتباهی داشته باشیم. برای انتخاب روش مناسب، باید یک Golden Dataset شامل سؤالها و شناسه اسناد مرتبط بسازیم.
برای مثال، ۱۰۰ تا ۳۰۰ سؤال واقعی یا بازبینیشده میتواند نقطه شروع یک آزمایش مقدماتی باشد؛ البته اندازه مناسب Dataset به تنوع داده و سطح اطمینان موردنیاز بستگی دارد.
بهتر است سؤالها در چند گروه تقسیم شوند:
- سؤالهای دارای شناسه و عبارت دقیق.
- سؤالهای مفهومی و مترادف.
- سؤالهای چندواژهای فارسی.
- سؤالهای ترکیبی فارسی و انگلیسی.
- سؤالهایی که پاسخ در چند سند قرار دارد.
- سؤالهای بدون پاسخ معتبر در مجموعه.
سپس عملکرد BM25، Vector، Hybrid و Hybrid + Reranker جداگانه اندازهگیری شود.
معیارهای اصلی ارزیابی جستوجوی ترکیبی
| معیار | چه چیزی را اندازه میگیرد؟ |
|---|---|
| Recall@K | سهم اسناد مرتبط که در K نتیجه اول پیدا شدهاند |
| MRR@K | جایگاه اولین سند مرتبط |
| nDCG@K | کیفیت رتبهبندی با درنظرگرفتن درجه ارتباط |
| Precision@K | سهم نتایج مرتبط در K نتیجه اول |
| P50 Latency | زمان پاسخ معمول |
| P95 Latency | زمان پاسخ درخواستهای کندتر |
| Cost per Query | هزینه هر جستوجو شامل Encoding و Reranking |
| Answer Correctness | درستی پاسخ تولیدشده توسط مدل نهایی |
برای ارزیابی Reranker، فقط Recall@K کافی نیست. ممکن است مجموعه کاندیدها ثابت باشد اما ترتیب آنها بهبود یافته باشد؛ در این حالت MRR و nDCG میتوانند تغییر را بهتر نشان دهند.
نمونه کد Benchmark برای BM25 و Hybrid
کد زیر یک روش ساده برای مقایسه رتبهبندیهای تولیدشده روی Golden Dataset ارائه میکند.
فایل evaluate.py را ایجاد کنید:
GOLDEN = {
    "q1": {"doc-1"},
    "q2": {"doc-2"},
    "q3": {"doc-4"},
}

RESULTS_BM25 = {
    "q1": ["doc-1", "doc-2", "doc-3"],
    "q2": ["doc-1", "doc-2", "doc-5"],
    "q3": ["doc-4", "doc-3", "doc-2"],
}

RESULTS_HYBRID = {
    "q1": ["doc-1", "doc-2", "doc-5"],
    "q2": ["doc-2", "doc-1", "doc-3"],
    "q3": ["doc-4", "doc-2", "doc-3"],
}


def evaluate(results, k=3):
    recalls = []
    reciprocal_ranks = []

    for qid, relevant in GOLDEN.items():
        ranking = results[qid][:k]

        found = set(ranking) & relevant

        recalls.append(
            len(found) / len(relevant)
        )

        first = next(
            (
                rank
                for rank, doc_id
                in enumerate(ranking, start=1)
                if doc_id in relevant
            ),
            None,
        )

        reciprocal_ranks.append(
            1 / first if first else 0
        )

    return {
        "recall_at_k": round(
            sum(recalls) / len(recalls), 4
        ),
        "mrr_at_k": round(
            sum(reciprocal_ranks)
            / len(reciprocal_ranks),
            4,
        ),
    }


print(
    "BM25:",
    evaluate(RESULTS_BM25),
)

print(
    "Hybrid:",
    evaluate(RESULTS_HYBRID),
)
در این مثال، رتبهبندیها از پیش تعریف شدهاند و نتیجه اجرای واقعی مدل Embedding نیستند. هدف، نمایش روش محاسبه معیارها است.
برای Benchmark واقعی باید همین معیارها روی شناسه اسنادی اجرا شوند که Retrieverها واقعاً تولید کردهاند.
نمونه جدول مقایسه BM25، Vector و Hybrid
جدول زیر فقط یک مثال فرضی برای نمایش قالب گزارش ارزیابی است و اعداد آن از آزمایش واقعی به دست نیامدهاند.
| روش | Recall@5 فرضی | MRR@5 فرضی | P95 فرضی |
|---|---|---|---|
| BM25 | ۰٫۷۸ | ۰٫۶۹ | ۲۵ms |
| Vector | ۰٫۸۲ | ۰٫۷۱ | ۴۵ms |
| Hybrid RRF | ۰٫۹۰ | ۰٫۷۸ | ۶۰ms |
| Hybrid + Reranker | ۰٫۹۰ | ۰٫۸۶ | ۲۲۰ms |
در این مثال فرضی، Reranker روی همان پنج کاندید نهایی اجرا شده است؛ بنابراین Recall@5 ثابت مانده ولی MRR@5 افزایش یافته است.
این اعداد برای توضیح طراحی Benchmark هستند و نباید بهعنوان نتیجه عملکرد واقعی Qdrant، Weaviate یا مدلهای معرفیشده استفاده شوند.
در پروژه واقعی، بهترین روش ممکن است BM25، Vector یا Hybrid باشد. تصمیم نهایی باید براساس نتایج آزمایش همان مجموعه اسناد گرفته شود.
چگونه Hybrid Search فارسی را منصفانه تست کنیم؟
برای ارزیابی فارسی، بهتر است مجموعه سؤالها از نظر شکل نوشتار متنوع باشد.
مثلاً یک موضوع را با چند عبارت متفاوت بررسی کنید:
- «چطور خطای ۴۲۹ را رفع کنیم؟»
- «علت Too Many Requests چیست؟»
- «چرا API درخواستهای من را محدود میکند؟»
این سؤالها ممکن است به یک سند مرتبط اشاره کنند، اما رفتار BM25 و Vector Search در آنها متفاوت باشد.
همچنین برای بررسی جستوجوی دقیق، باید Queryهایی شامل شماره نسخه، شناسه و اصطلاح انگلیسی اضافه شوند.
ارزیابی باید نشان دهد در کدام دسته از سؤالها Hybrid واقعاً بهتر عمل میکند و در کدام دسته، اضافهکردن جستوجوی برداری فقط تأخیر بیشتری ایجاد کرده است.
چگونه پارامترهای Hybrid Search را تنظیم کنیم؟
مهمترین پارامترهای این معماری عبارتاند از:
- BM25 k1 و b: کنترل اثر تکرار واژه و طول سند.
- Candidate Top-K: تعداد نتایج اولیه هر Retriever.
- RRF k: کنترل اثر جایگاه رتبهها.
- Fusion Weights: سهم BM25 و Vector در نتیجه ترکیبی.
- Reranker Top-K: تعداد اسنادی که دوباره رتبهبندی میشوند.
- Final Context K: تعداد Chunkهایی که به مدل زبانی داده میشوند.
برای تنظیم این پارامترها، ابتدا یک Baseline مشخص بسازید. سپس هر تغییر را روی مجموعه Validation بررسی کنید و نتیجه نهایی را روی Test Set مستقل بسنجید.
تغییر همزمان همه پارامترها تشخیص علت بهبود یا افت کیفیت را دشوار میکند.
نقش Chunking و حذف نتایج تکراری در Hybrid Search
گاهی مشکل اصلی از نوع موتور جستوجو نیست، بلکه از نحوه تقسیم اسناد به Chunkهای کوچکتر ناشی میشود.
اگر یک سند طولانی به چند Chunk بسیار مشابه تقسیم شده باشد، ممکن است بیشتر نتایج رتبههای بالا متعلق به همان سند باشند.
این وضعیت باعث کاهش تنوع Context و مصرف بیمورد توکن میشود.
برای کنترل آن میتوان:
- برای هر Chunk شناسه مستقل و شناسه سند اصلی نگهداری کرد.
- پس از Fusion نتایج تکراری را حذف کرد.
- تعداد Chunkهای انتخابشده از هر سند را محدود کرد.
- از Grouping بر اساس Document ID استفاده کرد.
- در صورت نیاز از روشهای تنوعبخشی مانند MMR استفاده کرد.
البته حذف بیدقت نتایج مشابه ممکن است بخشهای مکمل یک سند را از Context حذف کند. این سیاست نیز باید با Evaluation بررسی شود.
فیلتر امنیتی اسناد باید قبل از Fusion اعمال شود
در یک سیستم RAG چندکاربری، هر کاربر باید فقط اسنادی را مشاهده کند که مجوز دسترسی به آنها دارد.
فیلتر مالکیت یا Tenant باید در هر دو مسیر BM25 و Vector اعمال شود؛ نه اینکه تمام اسناد ابتدا بازیابی و سپس بدون بررسی کامل به مدل داده شوند.
برای مثال، اگر اسناد مالی یک شرکت در دیتابیس وجود دارند، کاربر شرکت دیگر نباید حتی با سؤال معنایی مشابه به آنها دسترسی پیدا کند.
بهتر است مجوز دسترسی از شناسه معتبر کاربر و لایه امنیتی برنامه تأمین شود، نه از متنی که مدل زبانی تولید کرده است.
همچنین اسناد بازیابیشده ممکن است حاوی Prompt Injection باشند. متن سند باید منبع اطلاعات تلقی شود، نه فرمانی برای تغییر قوانین Agent.
هزینه و Latency در Hybrid Search
اضافهکردن مسیر Vector و Reranker ممکن است کیفیت بازیابی را افزایش دهد، اما منابع بیشتری نیز مصرف میکند.
برای محاسبه هزینه واقعی باید موارد زیر بررسی شوند:
- هزینه تولید Embedding اسناد.
- هزینه بروزرسانی Embedding بعد از تغییر محتوا.
- زمان تولید Embedding سؤال.
- هزینه و تأخیر جستوجوی BM25.
- هزینه و تأخیر Vector Search.
- زمان اجرای RRF یا سایر روشهای Fusion.
- هزینه Reranker.
- تعداد توکن Context ارسالشده به مدل نهایی.
در یک سیستم پرترافیک، حتی افزایش کوچک تأخیر متوسط ممکن است در حجم بالای درخواستها اثرگذار باشد.
به همین دلیل بهتر است کیفیت بازیابی و هزینه هر Query در کنار یکدیگر گزارش شوند.
چه زمانی Hybrid Search بهتر نیست؟
با وجود مزایای Hybrid، همیشه لازم نیست هر درخواست از هر دو مسیر عبور کند.
برای مثال، اگر کاربر یک شناسه سفارش دقیق وارد کرده است و برنامه میتواند آن را با SQL پیدا کند، اجرای مدل Embedding ممکن است ضرورتی نداشته باشد.
همچنین در مجموعههای کوچک و دارای اصطلاحات ثابت، BM25 ممکن است کیفیت کافی داشته باشد.
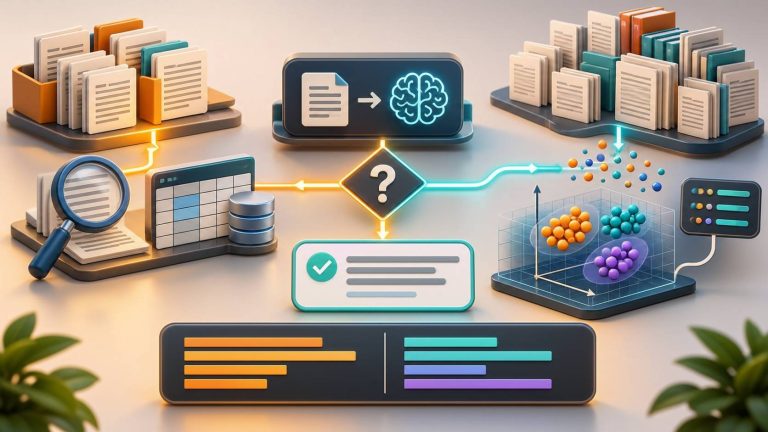
برای کاهش هزینه میتوان یک Query Router ساده تعریف کرد:
- درخواستهای شناسهمحور به جستوجوی دقیق یا SQL بروند.
- سؤالهای دارای اصطلاح فنی از BM25 استفاده کنند.
- سؤالهای طبیعی و توصیفی به مسیر Hybrid ارسال شوند.
- برای Queryهای دشوار یا کماطمینان، Reranker فعال شود.
این Router نیز ممکن است اشتباه کند؛ بنابراین باید نرخ انتخاب مسیر صحیح و اثر آن بر Recall نهایی اندازهگیری شود.
اشتباههای رایج در Hybrid Search RAG
۱. جمع مستقیم امتیاز BM25 و Cosine
این امتیازها مقیاس یکسانی ندارند و باید از RRF یا روش Fusion نرمالشده استفاده شود.
۲. استفاده از Embedding نامناسب برای فارسی
یک مدل چندزبانه لزوماً برای تمام موضوعات فارسی عملکرد مطلوب ندارد. انتخاب باید براساس داده واقعی باشد.
۳. نادیدهگرفتن نیمفاصله و حروف فارسی
Tokenization و Normalization نامناسب میتواند کیفیت BM25 را کاهش دهد.
۴. دریافت کاندیدهای بسیار کم
اگر هر Retriever فقط دو سند برگرداند، احتمال دارد سند مرتبط پیش از Fusion از دست برود.
۵. استفاده از Reranker روی همه اسناد
این کار معمولاً هزینه و زمان زیادی ایجاد میکند. بهتر است Reranking روی مجموعه محدود کاندیدها انجام شود.
۶. وزندهی بدون Golden Dataset
انتخاب وزن دلخواه ممکن است کیفیت یک گروه از Queryها را بهتر و گروه دیگری را ضعیفتر کند.
۷. ارزیابی فقط با چند سؤال دستی
برای تصمیم درست باید مجموعهای نماینده از پرسشها و اسناد مرتبط وجود داشته باشد.
۸. نادیدهگرفتن امنیت Tenant
هر دو Retriever باید سیاست مجوز مشترک و قابل اعتماد را رعایت کنند.
چکلیست اجرای Hybrid Search در Production
- انتخاب مجموعه اسناد و روش Chunking مناسب.
- نرمالسازی و Tokenization فارسی.
- ساخت Baseline مستقل برای BM25 و Vector.
- ثبت نسخه مدل Embedding و تنظیمات ایندکس.
- استفاده از RRF یا Fusion امتیازهای نرمالشده.
- تنظیم وزنها فقط با داده ارزیابی معتبر.
- اندازهگیری Candidate Recall پیش از Reranking.
- بررسی کیفیت Reranker روی زبان فارسی.
- ارزیابی Recall@K، MRR و nDCG.
- محاسبه Latency و هزینه کل مسیر جستوجو.
- کنترل دسترسی به اسناد در هر دو Retriever.
- حذف نتایج تکراری و مدیریت تنوع Context.
- ثبت شناسه و منبع Chunkهای استفادهشده.
- اجرای تست رگرسیون پس از تغییر مدل یا ایندکس.
- مقایسه نتیجه نهایی RAG با و بدون Hybrid Search.
جمعبندی؛ چگونه BM25 و Vector Search را درست ترکیب کنیم؟
Hybrid Search RAG روشی برای استفاده همزمان از قدرت جستوجوی واژگانی و معنایی است. BM25 در تطبیق اصطلاحات دقیق، شناسهها و کدهای فنی مفید است، درحالیکه Vector Search میتواند ارتباط معنایی میان عبارتهای متفاوت را پیدا کند.
برای ترکیب نتایج، باید به تفاوت مقیاس امتیازها توجه کرد. RRF یک روش عملی برای شروع است و روشهای مبتنی بر امتیاز نرمالشده نیز در شرایط مناسب میتوانند مفید باشند.
افزودن Reranker میتواند کیفیت ترتیب اسناد را افزایش دهد، اما فقط زمانی ارزشمند است که کاندیدهای مرتبط در مرحله بازیابی اولیه پیدا شده باشند.
در پروژههای فارسی، نرمالسازی متن، انتخاب مدل چندزبانه مناسب و ساخت Golden Dataset اهمیت زیادی دارند.
اصل نهایی: هدف Hybrid Search استفاده همیشگی از ابزارهای بیشتر نیست؛ هدف افزایش کیفیت پاسخ RAG با کمترین پیچیدگی و هزینهای است که بتوان آن را با بنچمارک واقعی توجیه کرد.
سؤالات متداول درباره Hybrid Search RAG
Hybrid Search RAG چیست؟
روشی برای ترکیب جستوجوی واژگانی مانند BM25 و جستوجوی معنایی مبتنی بر Embedding است تا اسناد مرتبطتری برای پاسخگویی RAG بازیابی شوند.
تفاوت BM25 و Vector Search چیست؟
BM25 بر تطبیق واژهها و ویژگیهای آماری متن تکیه دارد، اما Vector Search از بردارهای معنایی برای یافتن اسناد مشابه استفاده میکند.
چرا نباید امتیاز BM25 و Vector را مستقیم جمع کرد؟
زیرا مقیاس و توزیع آنها یکسان نیست. میتوان از RRF یا روشهای نرمالسازی امتیاز استفاده کرد.
RRF در Hybrid Search چه کاری انجام میدهد؟
RRF نتایج چند Retriever را براساس جایگاه رتبه اسناد ادغام میکند و به مقیاس امتیاز خام وابسته نیست.
آیا Reranker همیشه کیفیت RAG را بهتر میکند؟
خیر. Reranker به کیفیت کاندیدهای اولیه، مدل انتخابشده و نوع سؤال وابسته است و باید با Evaluation سنجیده شود.
برای Hybrid Search فارسی چه مدل Embedding مناسب است؟
میتوان از مدلهای چندزبانه مانند multilingual-e5-small شروع کرد، اما انتخاب نهایی باید با ارزیابی روی اسناد و سؤالهای فارسی همان پروژه انجام شود.
آیا برای Hybrid Search به دو دیتابیس نیاز داریم؟
خیر. بعضی موتورهای جستوجو مانند Qdrant و Weaviate قابلیتهای جستوجوی معنایی و واژگانی را در یک سامانه ارائه میکنند.
چگونه کیفیت Hybrid Search را Benchmark کنیم؟
با Golden Dataset شامل سؤال و اسناد مرتبط و مقایسه BM25، Vector، Hybrid و Reranker بر اساس Recall@K، MRR، nDCG، Latency و هزینه.
دیدگاهها (۰)