
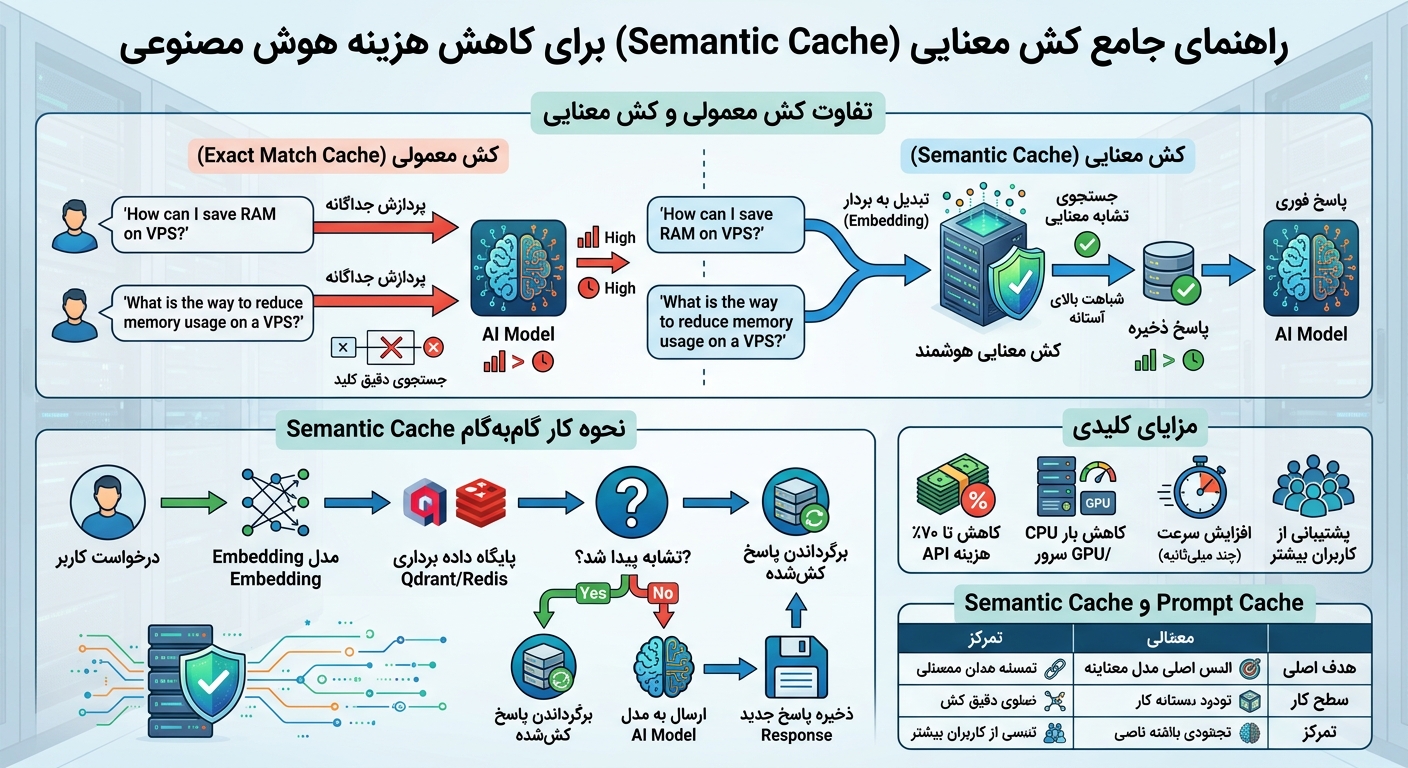
اگر یک چتبات، AI Agent، سیستم RAG یا API هوش مصنوعی دارید، احتمالاً بخشی از درخواستهای کاربران از نظر معنا بسیار شبیه یکدیگر هستند. کاربر اول میپرسد «چطور سرور مجازی ایران بخرم؟» و کاربر دیگری مینویسد «مراحل خرید VPS ایران چیست؟». اگر هر دو درخواست مستقیماً به مدل زبانی ارسال شوند، ممکن است برای تولید پاسخ تقریباً مشابه، دوباره هزینه پردازش و توکن پرداخت شود.
اینجاست که Semantic Cache یا کش معنایی وارد معماری سیستم هوش مصنوعی میشود. برخلاف کش معمولی که فقط درخواستهای کاملاً یکسان را تشخیص میدهد، کش معنایی با استفاده از Embedding، جستوجوی برداری و معیار شباهت بررسی میکند که آیا سؤال جدید از نظر معنا به یکی از درخواستهای ذخیرهشده نزدیک است یا خیر. در صورت عبور از آستانه شباهت، پاسخ قبلی بدون اجرای دوباره مدل برگردانده میشود. این الگو در مستندات Redis نیز بهعنوان روشی برای استفاده مجدد از پاسخهای LLM برای پرسشهای معنایی مشابه توضیح داده شده است. :contentReference[oaicite:0]{index=0}
📌 خلاصه سریع
Semantic Cache یعنی قبل از ارسال هر درخواست به LLM، بررسی کنیم آیا برای یک سؤال معنایی مشابه قبلاً پاسخ معتبر تولید شده است یا نه. اگر پاسخ مناسب وجود داشته باشد، همان پاسخ از Cache بازگردانده میشود و تماس غیرضروری با مدل حذف میشود.
Semantic Cache دقیقاً چیست؟
در کش سنتی، کلید معمولاً خود درخواست یا یک شناسه دقیق آن است. بنابراین این دو عبارت متفاوت محسوب میشوند:
سؤال اول: قیمت سرور مجازی ایران چقدر است؟
سؤال دوم: هزینه خرید VPS ایران چقدر میشود؟
اما برای یک سیستم هوشمند، این دو سؤال میتوانند از نظر معنا بسیار نزدیک باشند. Semantic Cache ابتدا سؤال را به یک بردار عددی یا Embedding تبدیل میکند. سپس این بردار با Embedding درخواستهای قبلی مقایسه میشود. اگر فاصله معنایی از مقدار تعیینشده کمتر باشد، Cache Hit اتفاق میافتد.
در معماریهای مبتنی بر Redis، میتوان Embedding، پاسخ LLM و متادیتاهایی مانند tenant، زبان، نسخه مدل و وضعیت امنیتی را کنار هم نگهداری کرد و جستوجوی KNN را با فیلترهای متادیتا انجام داد. :contentReference[oaicite:1]{index=1}
کش معمولی چه تفاوتی با Semantic Cache دارد؟
| ویژگی | Exact Cache | Semantic Cache |
|---|---|---|
| نوع تطبیق | تطبیق دقیق | تطبیق معنایی |
| درخواست مشابه با کلمات متفاوت | معمولاً Cache Miss | امکان Cache Hit |
| نیاز به Embedding | خیر | معمولاً بله |
| جستوجوی برداری | خیر | بله |
| صرفهجویی در تماس با LLM | در درخواستهای تکراری دقیق | در درخواستهای معنایی مشابه |
Semantic Cache چگونه کار میکند؟
یک پیادهسازی معمولی را میتوان در پنج مرحله خلاصه کرد:
🔹 مرحله ۱ — دریافت سؤال: کاربر درخواست خود را برای AI Agent یا API ارسال میکند.
🔹 مرحله ۲ — ساخت Embedding: متن سؤال توسط مدل Embedding به یک بردار تبدیل میشود.
🔹 مرحله ۳ — جستوجوی Semantic: سیستم نزدیکترین درخواستهای ذخیرهشده را پیدا میکند.
🔹 مرحله ۴ — بررسی Threshold: اگر شباهت از حد تعیینشده بیشتر باشد، Cache Hit رخ میدهد.
🔹 مرحله ۵ — اجرای LLM در صورت Miss: اگر پاسخ مناسبی پیدا نشود، درخواست به مدل ارسال و نتیجه برای استفادههای بعدی ذخیره میشود.
در مستندات Redis، همین جریان با سه بخش اصلی Embed، Lookup و در صورت Miss اجرای LLM و Write Back توضیح داده شده است. در مسیر Hit، مدل اصلاً فراخوانی نمیشود. :contentReference[oaicite:2]{index=2}
یک مثال واقعی از Semantic Cache
فرض کنید یک چتبات پشتیبانی برای فروش سرور دارید و این سؤال قبلاً پردازش شده است:
«آیا سرور مجازی ایران برای میزبانی سایت مناسب است؟»
LLM پاسخ را تولید میکند و سیستم آن را همراه با Embedding ذخیره میکند. چند دقیقه بعد کاربر دیگری میپرسد:
«برای اجرای وبسایت میتوان از VPS ایران استفاده کرد؟»
اگر فاصله برداری این دو پرسش از Threshold تعیینشده کمتر باشد، سیستم پاسخ ذخیرهشده را برمیگرداند. در نتیجه نیازی نیست دوباره مدل زبانی پاسخ را از صفر تولید کند.
چرا Semantic Cache هزینه API هوش مصنوعی را کاهش میدهد؟
هزینه یک برنامه مبتنی بر LLM فقط به خود سرور محدود نمیشود. در APIهای خارجی، تعداد درخواستها، توکنهای ورودی و خروجی و زمان پردازش مدل میتوانند روی هزینه نهایی اثر بگذارند.
وقتی یک درخواست از Cache پاسخ میگیرد، تماس کامل با LLM حذف میشود. بنابراین هرچه سهم درخواستهای قابل Cache بیشتر باشد، تعداد درخواستهای واقعی ارسالشده به مدل نیز کاهش پیدا میکند. Redis نیز Semantic Cache را با هدف کاهش تماسهای تکراری با LLM، کاهش هزینه و بهبود زمان پاسخ معرفی میکند. :contentReference[oaicite:3]{index=3}
⚠️ یک نکته مهم درباره صرفهجویی
Semantic Cache رایگان یا بدون هزینه نیست. ساخت Embedding، ذخیرهسازی، جستوجوی برداری و نگهداری Cache نیز منابع مصرف میکنند. مقدار صرفهجویی واقعی به نرخ Cache Hit، قیمت مدل، حجم پاسخها، مدل Embedding و معماری سیستم بستگی دارد.
معماری پیشنهادی Semantic Cache برای AI API
User
↓
Application / AI API
↓
Embedding Model
↓
Semantic Cache + Vector Search
↓
🔹 Cache Hit → پاسخ ذخیرهشده
🔹 Cache Miss → LLM → ذخیره پاسخ → ارسال نتیجه
چه اطلاعاتی باید داخل Semantic Cache ذخیره شود؟
برای یک سیستم ساده میتوان فقط سؤال، Embedding و پاسخ را ذخیره کرد؛ اما در محیط واقعی بهتر است متادیتا نیز وجود داشته باشد.
| فیلد | کاربرد |
|---|---|
| prompt | متن درخواست اصلی |
| embedding | بردار معنایی درخواست |
| response | پاسخ تولیدشده توسط مدل |
| model_version | نسخه مدل تولیدکننده پاسخ |
| tenant | تفکیک داده مشتریان یا سازمانها |
| locale | زبان یا منطقه کاربر |
| created_at / TTL | کنترل عمر پاسخ |
استفاده از فیلترهایی مانند tenant، locale و model version اهمیت زیادی دارد؛ چون یک پاسخ نباید بدون بررسی شرایط، از یک کاربر یا نسخه مدل به محیط دیگری منتقل شود. Redis نیز اعمال چنین محدودیتهایی را در جستوجوی Semantic Cache پیشنهاد میکند. :contentReference[oaicite:4]{index=4}
Threshold در Semantic Cache چیست؟
یکی از حساسترین تنظیمات Semantic Cache، Similarity Threshold یا آستانه شباهت است. سیستم باید تصمیم بگیرد نزدیکترین درخواست ذخیرهشده تا چه حد باید به سؤال جدید شبیه باشد تا پاسخ قبلی قابل استفاده تلقی شود.
| Threshold | رفتار احتمالی | ریسک |
|---|---|---|
| خیلی سختگیرانه | Hit کمتر | صرفهجویی کمتر |
| متعادل | تعادل Hit و دقت | نیازمند تست |
| بیش از حد باز | Hit بیشتر | احتمال ارائه پاسخ نامرتبط |
نکته مهم این است که یک عدد ثابت برای همه پروژهها وجود ندارد. نوع سؤال، مدل Embedding، زبان، حوزه کسبوکار و حساسیت پاسخها باید در تعیین Threshold در نظر گرفته شوند. در RedisVL نیز Threshold بهصورت قابل تنظیم در Semantic Cache ارائه شده است و مقدار فاصله کمتر به معنای تطبیق سختگیرانهتر در تنظیمات مبتنی بر cosine distance است. :contentReference[oaicite:5]{index=5}
ساخت Semantic Cache با Redis و Python
یکی از مسیرهای عملی برای ساخت Semantic Cache استفاده از Redis به همراه یک مدل Embedding است. Redis میتواند پاسخها و بردارها را نگهداری کند و قابلیت جستوجوی برداری را برای پیدا کردن موارد مشابه در اختیار برنامه قرار دهد. :contentReference[oaicite:6]{index=6}
در یک پیادهسازی واقعی، منطق کلی برنامه میتواند چیزی شبیه نمونه زیر باشد:
def ask_with_semantic_cache(prompt):

    embedding = create_embedding(prompt)

    cached = semantic_cache.search(
        embedding=embedding,
        threshold=THRESHOLD
    )

    if cached:
        return cached["response"]

    response = call_llm(prompt)

    semantic_cache.store(
        prompt=prompt,
        embedding=embedding,
        response=response,
        ttl=3600
    )

    return response
این نمونه فقط منطق معماری را نشان میدهد و برای استفاده در محیط Production باید مدیریت خطا، احراز هویت، محدودیت دسترسی، کنترل همزمانی، TTL، فیلترهای متادیتا و مانیتورینگ نیز به آن اضافه شود.
نصب ابزارهای موردنیاز روی سرور
اگر قرار است Embedding را روی سرور خودتان تولید کنید و Redis را نیز بهصورت Self-hosted اجرا کنید، داشتن منابع مناسب روی VPS اهمیت پیدا میکند. برای شروع یک نمونه آزمایشی، میتوانید Redis و محیط Python را روی Ubuntu اجرا کنید.
sudo apt update

sudo apt install -y python3 python3-pip redis-server

sudo systemctl enable --now redis-server

pip install redis sentence-transformers
در مستندات رسمی Redis نیز نمونههایی برای ساخت Semantic Cache با redis-py و sentence-transformers ارائه شده است. :contentReference[oaicite:7]{index=7}
آیا برای Semantic Cache حتماً Vector Database لازم است؟
خیر. این تصور رایج است که برای هر سیستم معنایی حتماً باید یک Vector Database جداگانه نصب شود. در حالی که بعضی سیستمها مانند Redis میتوانند ذخیرهسازی Cache و جستوجوی برداری را در یک زیرساخت انجام دهند.
البته Semantic Cache با Vector Database برای RAG یکسان نیست. در RAG معمولاً قطعات اسناد، Embedding آنها و اطلاعات مرتبط ذخیره میشوند تا برای ساخت Context به مدل ارسال شوند. در Semantic Cache هدف اصلی، ذخیره پاسخ کامل قبلی و حذف اجرای غیرضروری LLM است. Redis نیز این تفاوت را بهصراحت میان Semantic Cache و جستوجوی برداری RAG مطرح میکند. :contentReference[oaicite:8]{index=8}
📌 پیشنیاز مهم برای معماری AI روی سرور
اگر قصد دارید Semantic Cache را کنار RAG، Embedding Server یا Vector Database اجرا کنید، ابتدا معماری منابع سرور را مشخص کنید. اجرای همزمان مدل Embedding، Redis، Vector Database و سرویس API میتواند مصرف RAM و CPU را افزایش دهد.
در مطالب آموزشی قبلی ایرانیکاسرور نیز مباحث مربوط به ساخت سرور Embedding و استفاده از Qdrant برای زیرساخت RAG بررسی شدهاند. این دو فناوری را میتوان در معماری بزرگتر AI در کنار Semantic Cache قرار داد، اما وظیفه آنها با Cache پاسخ یکسان نیست.
Semantic Cache در کنار RAG چگونه استفاده میشود؟
ترکیب Semantic Cache و RAG میتواند برای سیستمهایی که پرسشهای تکراری زیادی دارند مفید باشد. مسیر درخواست میتواند به شکل زیر باشد:
🔹 دریافت پرسش کاربر
🔹 ساخت Embedding پرسش
🔹 بررسی Semantic Cache
🔹 اگر Hit شد → پاسخ ذخیرهشده
🔹 اگر Miss شد → جستوجوی RAG
🔹 ساخت Context
🔹 ارسال Context + Prompt به LLM
🔹 ذخیره پاسخ جدید در Semantic Cache
به این ترتیب Cache میتواند قبل از اجرای بخش پرهزینهتر Pipeline قرار بگیرد. البته اگر محتوای اسناد دائماً تغییر میکند، باید برای اعتبار پاسخهای Cache شده نیز سیاست مشخصی داشته باشید.
TTL چیست و چرا در Semantic Cache مهم است؟
فرض کنید پاسخ مربوط به قیمت یک محصول، وضعیت موجودی یا شرایط یک سرویس ذخیره شده است. اگر این اطلاعات تغییر کند، نباید پاسخ قدیمی برای همیشه به کاربر نمایش داده شود. TTL یا Time To Live عمر Cache را محدود میکند.
CACHE_TTL = 3600  # 1 hour

cache.store(
    prompt=prompt,
    response=response,
    embedding=embedding,
    ttl=CACHE_TTL
)
Redis نیز برای Cacheهای معنایی استفاده از TTL را برای منقضی شدن پاسخهای قدیمی و کنترل رشد داده پیشنهاد میکند. :contentReference[oaicite:9]{index=9}
چه زمانی نباید از Semantic Cache استفاده کنیم؟
Semantic Cache برای تمام درخواستها مناسب نیست. اگر پاسخ به اطلاعات لحظهای وابسته باشد یا کوچکترین تفاوت در ورودی باید پاسخ کاملاً متفاوتی ایجاد کند، استفاده بدون کنترل از Semantic Cache میتواند خطرناک باشد.
⚠️ قیمت لحظهای ارز، سهام یا داراییهای مالی
⚠️ وضعیت لحظهای سفارش و موجودی
⚠️ پاسخهایی که به تاریخ و ساعت دقیق وابسته هستند
⚠️ درخواستهایی که اطلاعات محرمانه کاربر در آنها وجود دارد
⚠️ عملیات حساس که نباید پاسخ یک کاربر به کاربر دیگر منتقل شود
برای چنین سیستمهایی بهتر است Cache را با فیلترهای دقیق، TTL کوتاه، namespace مجزا یا حتی عدم Cache کردن برخی مسیرها طراحی کنید.
مشکل امنیتی مهم: نشت پاسخ بین کاربران
یکی از مهمترین اشتباهات در پیادهسازی Semantic Cache این است که فقط شباهت معنایی را بررسی کنیم. فرض کنید دو مشتری متفاوت سؤالهایی مشابه میپرسند اما اطلاعات مورد استفاده برای پاسخ آنها کاملاً خصوصی است. اگر Cache فقط بر اساس Embedding جستوجو کند، ممکن است پاسخ یک مشتری به مشتری دیگری بازگردانده شود.
راهحل، اضافه کردن Metadata Filtering است. برای مثال، Cache میتواند علاوه بر شباهت برداری، tenant یا شناسه سازمان، زبان، نسخه مدل و سایر محدودههای امنیتی را نیز بررسی کند. این الگو در نمونههای Semantic Cache مبتنی بر Redis نیز استفاده شده است. :contentReference[oaicite:10]{index=10}
cached = cache.search(
    embedding=query_embedding,
    tenant=current_tenant,
    locale="fa",
    model_version="v1"
)
Cache Hit Rate چیست؟
برای اینکه بدانید Semantic Cache واقعاً چقدر مفید است، فقط به تعداد رکوردهای Cache نگاه نکنید. مهمترین شاخصها شامل Cache Hit Rate، Cache Miss Rate، زمان پاسخ، تعداد توکنهای جلوگیریشده از ارسال به LLM و هزینه تخمینی ذخیرهسازی و Embedding هستند.
| شاخص | فرمول یا مفهوم | کاربرد |
|---|---|---|
| Hit Rate | Hits ÷ Total Requests | اندازهگیری موفقیت Cache |
| Miss Rate | Misses ÷ Total Requests | شناسایی درخواستهای جدید |
| Latency | زمان پاسخ | بررسی اثر Cache روی سرعت |
| Token Saved | توکنهای جلوگیریشده از LLM | برآورد صرفهجویی API |
چگونه Threshold مناسب را پیدا کنیم؟
بهترین روش، حدس زدن یک عدد ثابت نیست. چند گروه سؤال واقعی کاربران را جمعآوری کنید و آنها را به دو دسته تقسیم کنید: درخواستهایی که واقعاً میتوانند یک پاسخ مشترک داشته باشند و درخواستهایی که فقط از نظر کلمات شبیه هستند.
🔹 مجموعهای از پرسشهای واقعی ایجاد کنید.
🔹 Embedding آنها را تولید کنید.
🔹 چند Threshold مختلف را آزمایش کنید.
🔹 Hitهای صحیح و Hitهای اشتباه را جداگانه بررسی کنید.
🔹 مقدار مناسب را بر اساس نوع کاربرد انتخاب کنید.
🔹 بعد از انتشار، Hit Rate و کیفیت پاسخها را دائماً پایش کنید.
Semantic Cache یا Prompt Cache؟
این دو مفهوم شبیه هم هستند اما یکسان نیستند. Prompt Caching معمولاً برای کاهش هزینه یا زمان پردازش بخشهای تکراری Prompt در زیرساخت مدل یا ارائهدهنده API استفاده میشود؛ اما Semantic Cache تلاش میکند کل پاسخ قبلی را برای پرسشهای معنایی مشابه دوباره استفاده کند.
| موضوع | Prompt Cache | Semantic Cache |
|---|---|---|
| تمرکز | Context یا Prompt تکراری | پاسخ درخواست مشابه |
| تطبیق معنایی | وابسته به سازوکار سرویس | هسته اصلی معماری |
| اجرای LLM | معمولاً همچنان انجام میشود | در Cache Hit حذف میشود |
در نتیجه این دو فناوری میتوانند حتی در یک معماری کنار هم قرار بگیرند و الزاماً جایگزین یکدیگر نیستند.
Semantic Cache برای چه پروژههایی مناسب است؟
🔹 چتباتهای FAQ و پشتیبانی
🔹 دستیارهای سازمانی
🔹 AI Agentهای دارای درخواستهای تکراری
🔹 سیستمهای RAG با پرسشهای پرتکرار
🔹 APIهای هوش مصنوعی با حجم بالای درخواست
🔹 سیستمهای تولید متن و پاسخهای استاندارد
🔹 سامانههای آموزشی و پرسشوپاسخ
چه منابع سروری برای Semantic Cache نیاز داریم؟
اگر فقط Redis و یک API سبک دارید، نیاز سختافزاری Semantic Cache میتواند نسبتاً محدود باشد. اما وقتی Embedding Model، RAG، Vector Database و LLM محلی را نیز روی همان سرور اجرا میکنید، منابع موردنیاز به شکل محسوسی افزایش پیدا میکند.
| سناریو | منابع مهم |
|---|---|
| Redis + API ساده | RAM و CPU |
| Redis + Embedding محلی | RAM، CPU و دیسک سریع |
| Semantic Cache + RAG | RAM، CPU و NVMe |
| Cache + RAG + Local LLM | RAM زیاد و در بسیاری از مدلها GPU/VRAM |
سرور مناسب برای اجرای زیرساخت هوش مصنوعی
اگر قرار است Semantic Cache را در کنار Redis، Embedding Server، RAG یا AI API اجرا کنید، منابع اختصاصی CPU و RAM و دیسک NVMe میتوانند در پایداری سرویس اهمیت داشته باشند. برای پروژههای بزرگتر نیز میتوانید معماری را روی چند سرور تفکیک کنید.
ایرانیکاسرور برای اجرای سرویسهای نرمافزاری، APIها، پایگاههای داده و زیرساختهای AI، سرورهای مجازی با منابع مختلف ارائه میکند.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
چگونه Semantic Cache را برای Production آماده کنیم؟
نسخه آزمایشی Semantic Cache را میتوان با چند خط کد ساخت، اما محیط Production به کنترلهای بیشتری نیاز دارد.
🔹 برای هر Cache Entry یک TTL مشخص کنید.
🔹 Tenant و سطح دسترسی را در Metadata نگهداری کنید.
🔹 نسخه مدل را در Cache Key یا Metadata لحاظ کنید.
🔹 پاسخهای حساس را بدون سیاست امنیتی Cache نکنید.
🔹 Hit Rate و Miss Rate را مانیتور کنید.
🔹 برای رشد حافظه، سیاست Eviction داشته باشید.
🔹 بعد از تغییر دانش پایه یا مدل، Cacheهای قدیمی را بررسی یا پاکسازی کنید.
🔹 کیفیت پاسخهای Cache شده را بهصورت دورهای ارزیابی کنید.
Eviction Policy چیست؟
با افزایش تعداد پرسشها، تعداد پاسخهای ذخیرهشده نیز رشد میکند. اگر حافظه بدون محدودیت پر شود، Cache دیگر قابل مدیریت نخواهد بود. بنابراین باید مشخص شود هنگام نزدیک شدن حافظه به سقف، کدام دادهها حذف شوند.
سیاستهایی مانند LRU یا LFU میتوانند برای مدیریت دادههای سرد مورد استفاده قرار بگیرند. در معماری Semantic Cache، TTL نیز نقش مهمی دارد و میتواند باعث حذف خودکار دادههای قدیمی شود. :contentReference[oaicite:11]{index=11}
اشتباهات رایج هنگام ساخت Semantic Cache
⚠️ Threshold بیش از حد باز: ممکن است پاسخ ظاهراً مشابه اما در واقع نامرتبط بازگردانده شود.
⚠️ نبود TTL: پاسخهای قدیمی برای مدت طولانی باقی میمانند.
⚠️ نبود Tenant Isolation: احتمال نشت داده بین کاربران یا سازمانها ایجاد میشود.
⚠️ Cache کردن اطلاعات لحظهای: اطلاعات منقضی ممکن است به کاربر نمایش داده شود.
⚠️ اندازهگیری نکردن Hit Rate: نمیدانید Cache واقعاً چه مقدار از بار LLM را کم کرده است.
⚠️ نادیده گرفتن هزینه Embedding: Semantic Cache خودش نیز به محاسبه Embedding نیاز دارد.
آیا Semantic Cache جایگزین LLM میشود؟
خیر. Semantic Cache یک لایه به معماری برنامه اضافه میکند. در صورت وجود پاسخ مناسب، Cache از اجرای دوباره مدل جلوگیری میکند؛ اما برای درخواستهای جدید یا درخواستهایی که با هیچ پاسخ قبلی شباهت کافی ندارند، LLM همچنان مورد استفاده قرار میگیرد.
بنابراین میتوان Semantic Cache را یک لایه بهینهسازی قبل از LLM دانست، نه جایگزین مدل زبانی.
Semantic Cache برای AI Agentها چه کاربردی دارد؟
در AI Agentها، یک کاربر ممکن است بارها درخواستهایی با هدف مشابه ارسال کند. علاوه بر پاسخ نهایی، برخی Tool Resultها نیز میتوانند قابلیت Cache شدن داشته باشند؛ البته فقط زمانی که نتیجه آن ابزار به زمان، کاربر یا وضعیت لحظهای وابسته نباشد.
در اکوسیستم Redis حتی الگوی Semantic Cache برای پاسخ LLM و Tool Result نیز ارائه شده است. :contentReference[oaicite:12]{index=12}
Redis یا GPTCache برای ساخت Semantic Cache؟
ابزارهای مختلفی برای پیادهسازی LLM Cache وجود دارند. Redis زمانی جذاب است که به یک زیرساخت سریع برای Cache، Metadata و Vector Search نیاز دارید. GPTCache نیز یک پروژه متنباز است که برای Cache کردن پرسشهای LLM طراحی شده و امکان انتخاب Embedding، Similarity Evaluation و Data Manager را فراهم میکند. :contentReference[oaicite:13]{index=13}
| راهکار | مناسب برای | نکته مهم |
|---|---|---|
| Redis Semantic Cache | Production و زیرساخت قابل کنترل | Cache + Vector Search + Metadata |
| GPTCache | پروژههای متنباز و آزمایش | انعطاف در Embedding و Evaluation |
| LangCache | سرویس مدیریتشده | نیاز کمتر به مدیریت زیرساخت Cache |
برای مطالعه پیادهسازیهای رسمی میتوانید مستندات Redis Semantic Cache و پروژه GPTCache را بررسی کنید. :contentReference[oaicite:14]{index=14}
رفع مشکل و کانفیگ سرور AI
اگر هنگام اجرای Redis، Embedding Server، Vector Database یا API هوش مصنوعی روی VPS با مشکل منابع، تنظیمات شبکه، سرویسها یا کانفیگ مواجه شدید، میتوانید درخواست کانفیگ یا رفع مشکل سرور را ارسال کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
چکلیست نهایی پیادهسازی Semantic Cache
✅ مدل Embedding مناسب انتخاب شده است.
✅ Vector Search یا زیرساخت مشابه آماده است.
✅ Threshold با داده واقعی تست شده است.
✅ TTL برای Cache تعریف شده است.
✅ Tenant و اطلاعات حساس از یکدیگر جدا شدهاند.
✅ نسخه مدل در Cache لحاظ شده است.
✅ Hit Rate و Miss Rate اندازهگیری میشوند.
✅ سیاست Eviction برای حافظه در نظر گرفته شده است.
✅ پاسخهای حساس و لحظهای بدون کنترل مناسب Cache نمیشوند.
✅ مسیر Cache در صورت خطا میتواند به LLM اصلی برگردد.
جمعبندی: آیا ساخت Semantic Cache ارزش دارد؟
Semantic Cache یکی از لایههای کاربردی برای بهینهسازی معماری برنامههای مبتنی بر LLM است. ایده اصلی ساده است: اگر قبلاً برای یک درخواست معنایی مشابه پاسخ مناسبی تولید شده، لازم نیست مدل دوباره همان کار را انجام دهد.
اما یک پیادهسازی حرفهای فقط به جستوجوی شباهت محدود نمیشود. Threshold، TTL، Metadata Filtering، Tenant Isolation، نسخه مدل، امنیت، Eviction و مانیتورینگ همگی روی کیفیت و هزینه نهایی اثر دارند.
برای پروژههای کوچک میتوان Semantic Cache را با Redis و یک Embedding Model شروع کرد و در پروژههای بزرگتر آن را کنار RAG، Qdrant، Embedding Server، AI Agent و حتی LLMهای محلی قرار داد. انتخاب منابع سرور نیز باید بر اساس تعداد درخواست، اندازه Embedding، حجم Cache و سرویسهای دیگری که همزمان اجرا میشوند انجام شود.
مطالعه مرتبط
اگر در حال ساخت زیرساخت RAG یا AI روی VPS هستید، مباحث Qdrant، سرور Embedding، PrivateGPT، Ollama و Dify میتوانند مرحله بعدی مسیر شما باشند. Semantic Cache در این معماریها نقش مکمل دارد و میتواند قبل از اجرای کامل Pipeline از درخواستهای تکراری جلوگیری کند.
منابع رسمی برای مطالعه بیشتر:
Redis Semantic Cache Documentation
Redis Semantic Cache with Python
۳۰ برچسب پیشنهادی وردپرس
Semantic Cache, کش معنایی, Semantic Caching, LLM Cache, AI Cache, کش هوش مصنوعی, Redis Semantic Cache, Redis, RedisVL, GPTCache, LLM, مدل زبانی, API هوش مصنوعی, هزینه API هوش مصنوعی, کاهش هزینه LLM, کاهش زمان پاسخ AI, Embedding, Vector Search, جستجوی برداری, Vector Database, RAG, AI Agent, هوش مصنوعی روی VPS, سرور هوش مصنوعی, Self Hosted AI, زیرساخت هوش مصنوعی, Cache API, کش پاسخ LLM, Threshold, TTL







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.