
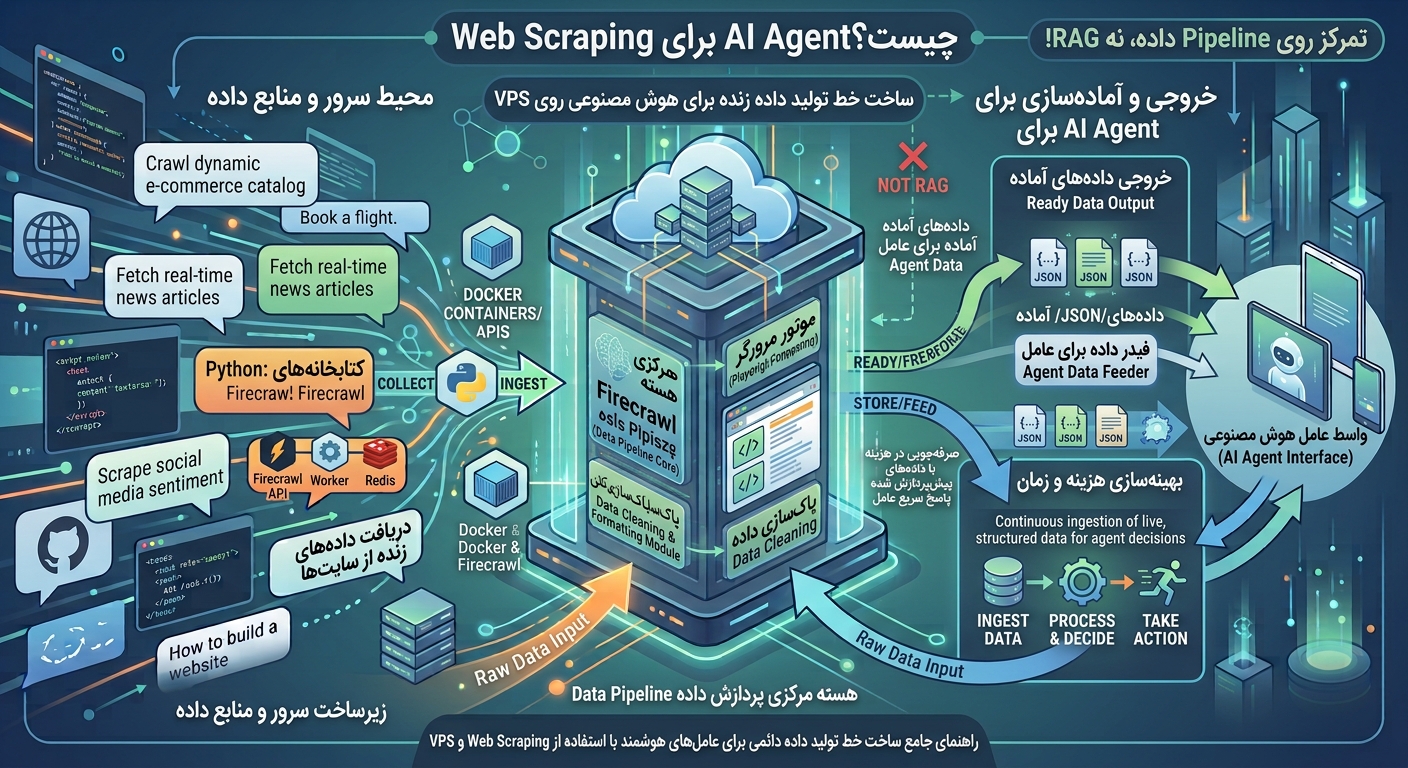
تصور کنید یک دستیار هوشمند دارید که هر روز صبح خودش به چند سایت سر میزند، قیمتها را میخواند، اخبار تازه را برمیدارد و بعد از آن برای شما خلاصهای از تغییرات مهم میسازد. چنین چیزی بدون یک خط تولید داده زنده ممکن نیست. مدلهای زبانی هرچقدر هم قوی باشند، دانششان به لحظهای محدود است که آموزش دیدهاند. یک AI Agent واقعی باید بتواند وب را ببیند، بخواند و از آن یاد بگیرد.
AI Agent واقعی به چه نوع دادهای نیاز دارد؟
قبل از ورود به بحث فنی، باید بدانیم یک Agent خودمختار چه انتظاری از داده دارد. برخلاف چتبات ساده که فقط به یک API متصل میشود، Agent باید چهار ویژگی کلیدی داشته باشد:
🔹 محتوای زنده وب را بخواند — قیمتها، اخبار، مستندات فنی و هر چیزی که مدام عوض میشود
🔹 خودش مسیر را انتخاب کند — از صفحهای به صفحه دیگر برود، فرم پر کند، دکمه بزند
🔹 داده ساختاریافته دریافت کند — LLM با HTML خام نمیتواند کار کند؛ داده باید به Markdown یا JSON تمیز تبدیل شود
🔹 بهصورت ۲۴/۷ فعال بماند — اینجا همان نقطهای است که بحث سرور مجازی جدی میشود
یک لپتاپ که شبها میخوابد نمیتواند میزبان Agent همیشهفعال باشد. Agent باید حافظه پایدار داشته باشد تا سابقه تعاملات و وضعیت خود را بین ریاستارتها حفظ کند.
تفاوت Web Scraping سنتی با Agentic Scraping
بسیاری از مقالات فقط به اسکریپتهای ساده Selenium یا BeautifulSoup اشاره میکنند. اما مفهوم Agentic Web Scraping بسیار فراتر از این است. در روش سنتی، اسکریپت شما به یک URL مشخص میرود و HTML را میگیرد؛ اگر سایت طراحیاش را عوض کند، اسکریپت میشکند.
در روش Agentic، خود AI Agent تصمیم میگیرد کدام صفحه را بخواند، چه زمانی درخواست را دوباره امتحان کند، اگر صفحه JavaScript-heavy بود چطور با یک مرورگر واقعی آن را رندر کند و داده استخراجشده را چطور تمیز و ساختاریافته کند.
⚠️ نکته کلیدی: Agentic Scraping وقتی ارزش دارد که سایتها ناشناخته باشند یا ساختارشان مدام تغییر کند. برای سایتهای ثابت با حجم بالا، اسکریپت معمولی سریعتر و ارزانتر است.
چرا سرور مجازی بهترین خانه برای AI Agent است؟
شاید بپرسید چرا Agent را روی لپتاپ خودمان اجرا نکنیم؟ پاسخ ساده است: Agent باید همیشه در دسترس باشد. وقتی لپتاپ میخوابد یا ریاستارت میشود، Agent و تمام اتوماسیونهایش از کار میافتند. اما یک سرور مجازی همیشه روشن است، منابع اختصاصی دارد و از هر دستگاهی قابل دسترسی است.
از نظر سختافزاری، برای Agent که از API مدلهای زبانی استفاده میکند (یعنی خود LLM روی سرور شما اجرا نمیشود)، ۴ vCPU و ۸ تا ۱۶ گیگابایت RAM کافی است. اگر قصد دارید مدل را بهصورت محلی با Ollama اجرا کنید، به GPU نیاز خواهید داشت — اما برای اکثر پروژهها، مسیر API مقرونبهصرفهتر است.
🔹 زیرساخت Agent خود را روی سرور مجازی ایران راهاندازی کنید
اگر میخواهید Agent خود را همیشه روشن و پایدار نگه دارید، ایرانیکاسرور با سرورهای مجازی NVMe و منابع کاملاً اختصاصی، دقیقاً همان زیرساختی را فراهم میکند که یک AI Agent واقعی نیاز دارد. منابع اختصاصی CPU و RAM، دیسک NVMe پرسرعت برای خواندن و نوشتن سریع داده، پهنای باند نامحدود برای Scraping بدون محدودیت، آپتایم ۹۹.۹٪ و پشتیبانی ۲۴/۷.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
معماری کامل خط تولید داده زنده (Live Data Pipeline)
حالا برسیم به بخش اصلی: چطور یک Pipeline داده زنده برای AI Agent بسازیم که روی VPS اجرا شود و بهصورت مداوم بهروز بماند؟ این معماری از سه لایه تشکیل میشود.
لایه ۱ — دریافت (Fetch Layer)
اولین لایه، داده را از وب میگیرد. دو انتخاب اصلی دارید. APIهای مدیریتشده مثل ScraperAPI یا Bright Data که پروکسی، مرورگر Headless و حل CAPTCHA را خودشان مدیریت میکنند و داده را بهصورت Markdown تمیز تحویل میدهند. یا ابزارهای متنباز مثل Playwright و Puppeteer روی VPS خودتان که کنترل کامل دارید اما باید خودتان با CAPTCHA، ریتلیمیت و تغییر ساختار سایتها بجنگید.
برای یک Agent خودمختار، ترکیب MCP Server با یک API معتبر بهترین گزینه است. MCP یا Model Context Protocol یک استاندارد است که به Agent اجازه میدهد بدون وابستگی به کد، به ابزارهای خارجی متصل شود.
لایه ۲ — پردازش (Processing Layer)
HTML خام برای LLM سمی است. باید آن را به فرمتی تبدیل کرد که مدل بخواند. Markdown بهترین گزینه برای محتوای متنی است. JSON ساختاریافته برای دادههای جدولی مثل قیمت محصولات یا لیستها مناسب است. در نهایت ناوبری، تبلیغات و اسکریپتهای بیربط باید حذف شوند تا نویز به مدل نرسد.
لایه ۳ — حافظه و ذخیرهسازی (Memory Layer)
Agent بدون حافظه، فقط یک چتبات است. برای یک Agent واقعی به Vector Database برای جستجوی معنایی در دادههای اسکرپشده، SQLite یا PostgreSQL برای ذخیره وضعیت Agent و تاریخچه تعاملات، و دیسک NVMe نیاز دارید. خواندن و نوشتن سریع روی دیسک مستقیماً روی سرعت پاسخ Agent اثر میگذارد و یکی از مهمترین دلایل انتخاب VPS مناسب است.
پیادهسازی عملی: یک اسکریپت نمونه برای شروع
بیایید یک مثال عملی ببینیم. این اسکریپت نشان میدهد چطور یک صفحه وب را با Playwright بگیرید و به Markdown تمیز تبدیل کنید. ابتدا پیشنیازها را روی اوبونتو نصب کنید:
sudo apt install -y python3 python3-pip
pip install playwright markdownify beautifulsoup4
playwright install chromium
حالا اسکریپت پایتون:
from playwright.async_api import async_playwright
from bs4 import BeautifulSoup
from markdownify import markdownify as md
async def fetch_as_markdown(url: str) -> str:
async with async_playwright() as p:
browser = await p.chromium.launch(headless=True)
page = await browser.new_page()
await page.goto(url, wait_until=”networkidle”, timeout=60000)
await page.wait_for_timeout(3000)
html = await page.content()
await browser.close()
soup = BeautifulSoup(html, “html.parser”)
for tag in soup([“script”, “style”, “nav”, “footer”, “header”]):
tag.decompose()
return md(str(soup), heading_style=”ATX”)
async def main():
content = await fetch_as_markdown(“https://example.com/article”)
print(content[:2000])
asyncio.run(main())
⚠️ هشدار: همیشه به robots.txt سایتها احترام بگذارید و نرخ درخواستها را کنترل کنید. Scraping غیرمسئولانه میتواند به IP شما آسیب بزند و از نظر حقوقی مشکلساز شود.
اتصال Agent به ابزارهای Web Scraping با MCP
MCP یک استاندارد است که اتصال Agent به ابزارهای خارجی را ساده میکند. بهجای اینکه برای هر ابزار کد بنویسید، یک MCP Server را به Agent وصل میکنید و تمام ابزارهای آن سرور بهصورت خودکار در دسترس Agent قرار میگیرند. مزیت اصلی MCP این است که لایه Fetch را قابل تعویض میکند. یعنی اگر بعداً بخواهید از یک سرویس Scraping دیگر استفاده کنید، فقط MCP Server را عوض میکنید بدون اینکه Agent را بازنویسی کنید.
یک نمونه پیکربندی ساده برای اتصال LangChain به MCP:
async def setup_agent_tools():
client = MultiServerMCPClient({
“scraper”: {
“url”: “https://your-mcp-server.com/sse”,
“transport”: “sse”
}
})
tools = await client.get_tools()
return tools
🔹 Agent خود را روی زیرساخت پایدار ایرانیکاسرور اجرا کنید
برای یک Pipeline داده زنده، پایداری شبکه و سرعت دیسک حیاتی است. ایرانیکاسرور با دیسکهای NVMe، پهنای باند اختصاصی و آپتایم تضمینشده، محیطی ایدهآل برای اجرای ۲۴/۷ AI Agent فراهم میکند. دیسک NVMe برای خواندن و نوشتن سریع Vector DB و حافظه Agent، منابع اختصاصی بدون افت عملکرد در ساعات اوج، و پشتیبانی فنی ۲۴/۷.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور
جدول مقایسه: انتخاب روش مناسب برای Scraping
| سناریو | روش پیشنهادی | دلیل |
|---|---|---|
| ۲۰۰ صفحه محصول، روزانه، یک سایت ثابت | اسکریپت معمولی | سریع، ارزان، قابل پیشبینی |
| ۳۰ سایت مختلف، فصلی | Agent | هر سایت ساختار متفاوتی دارد |
| منابع ناشناخته، تحقیق یکباره | Agent | مسیر از قبل مشخص نیست |
| سایت ثابت با تغییرات ماهانه | Hybrid (Agent + Script) | Agent منطق را آپدیت میکند، اسکریپت اجرا میکند |
| فرم لاگین، فرایند چندمرحلهای | Agent + Managed Retrieval | نیاز به تعامل و مدیریت نشست |
چالشهای واقعی Scraping برای AI Agent و راهحلها
چالش ۱ — بلاک شدن توسط Anti-Bot
سایتها روزبهروز هوشمندتر میشوند. Cloudflare، DataDome و سیستمهای مشابه بهراحتی درخواستهای Headless را شناسایی میکنند. راهحل استفاده از APIهای مدیریتشده مثل ScraperAPI یا Bright Data است که پروکسی Residential و مرورگر واقعی را مدیریت میکنند.
چالش ۲ — هزینه توکن
هر بار که Agent یک صفحه را میخواند، آن صفحه وارد Context Window میشود. یک صفحه ۱۰۰KB میتواند دهها هزار توکن مصرف کند. راهحل، استفاده از الگوی سهفازی است. در فاز اول Agent ساختار صفحه را کشف میکند و Selectorها را میگوید. در فاز دوم اسکریپت معمولی با همان Selectorها هزاران صفحه را میخواند. در فاز سوم فقط اگر صفحه تغییر کرد، Agent دوباره وارد میشود.
چالش ۳ — دادههای ناسازگار
HTML سایتها استاندارد نیست. گاهی داده در یک div است، گاهی در script و گاهی باید کلیک کرد تا ظاهر شود. راهحل این است که لایهای برای اعتبارسنجی داده بگذارید. اگر فیلدهای کلیدی خالی برگشتند، Agent باید بداند که فرایند استخراج شکسته است.
🔹 مقاله مرتبط: راهنمای کامل افزایش امنیت سرور مجازی
اگر روی VPS خودتان Agent اجرا میکنید، امنیت را جدی بگیرید. در مقالهای جداگانه بهطور کامل توضیح دادهایم که چگونه امنیت سرور مجازی و هاست خود را افزایش دهید — از تست نفوذ و مدیریت SSH تا پیکربندی فایروال و غیرفعالسازی سرویسهای غیرضروری. این مقاله برای هر کسی که روی VPS خود Agent یا سرویس حساس اجرا میکند، یک پیشنیاز ضروری است.
جمعبندی
Web Scraping برای AI Agent یک ابزار نیست — یک معماری است. تفاوت بین یک Agent معمولی و یک Agent حرفهای در این است که حرفهایها خط تولید داده را از روز اول طراحی میکنند، نه بعد از اینکه Agent به داده کهنه خورد.
🔹 از سرور مجازی همیشهروشن استفاده کنید تا Agent ۲۴/۷ بیدار بماند
🔹 لایه Fetch را قابل تعویض نگه دارید (با MCP) تا به یک سرویس خاص وابسته نشوید
🔹 الگوی سهفازی را پیادهسازی کنید تا هزینه توکن را کنترل کنید
🔹 امنیت زیرساخت را جدی بگیرید
اگر میخواهید Agent خود را روی یک زیرساخت پایدار و ایرانی راهاندازی کنید، ایرانیکاسرور با سرورهای مجازی NVMe، منابع اختصاصی و پشتیبانی ۲۴/۷ آماده همکاری است.
🔹 Agent خود را روی VPS راهاندازی کردید اما به مشکل خوردید؟
تیم فنی ایرانیکاسرور آماده است تا در کانفیگ سرور، نصب پیشنیازها، تنظیم منابع و رفع خطاهای مربوط به Scraping و AI Agent به شما کمک کند. کافی است درخواست خود را ارسال کنید.
📞 تماس با پشتیبانی: 021-91302460 | ایرانیکاسرور







دیدگاهها
0 دیدگاه برای این مطلب ثبت شده است.