
 Amir Jabbari
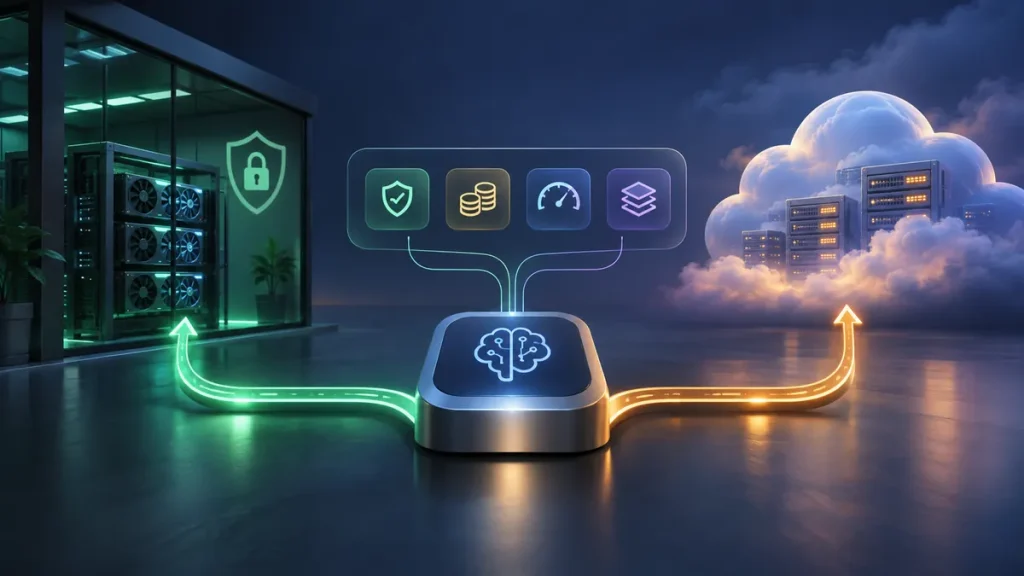
فرض کنید یک نرمافزار پشتیبانی مشتریان ساختهاید که از هوش مصنوعی برای پاسخگویی استفاده میکند. بعضی درخواستها کوتاه و سادهاند و میتوان آنها را با یک مدل محلی روی سرور خودتان پردازش کرد. بعضی دیگر به تحلیل پیچیده، Context طولانی یا قابلیتهایی نیاز دارند که فقط یک مدل ابری در اختیارشان میگذارد. از طرفی، اطلاعات بعضی مشتریان محرمانه است و نباید بدون مجوز به سرویس خارجی ارسال شود.
در چنین شرایطی، استفاده دائمی از یک مدل یا یک ارائهدهنده API بهترین راهحل نیست. Hybrid LLM Routing یا «مسیریابی ترکیبی مدلهای زبانی» روشی است که بر اساس ویژگی هر درخواست تصمیم میگیرد پردازش روی زیرساخت محلی انجام شود یا از یک سرویس هوش مصنوعی ابری استفاده کنیم.
در این مقاله، ابتدا مفهوم معماری Hybrid AI را توضیح میدهیم، سپس معیارهای تصمیمگیری مانند Latency، Cost، Privacy، Context Size، Failover و Data Classification را بررسی میکنیم. در ادامه، یک نمونه عملی با Ollama، API ابری و Python میسازیم و نشان میدهیم چگونه میتوان از LiteLLM برای یکپارچهسازی ارتباط با مدلها استفاده کرد.
Hybrid LLM Routing چیست؟
Hybrid LLM Routing به معنی انتخاب هوشمندانه بین دو یا چند محیط اجرای مدل زبانی است. در سادهترین حالت، یک مسیر برای مدل محلی و مسیر دیگر برای مدل ابری در نظر میگیریم.
- مدل محلی (Local LLM): مدل روی سرور، سیستم سازمانی یا زیرساخت خصوصی اجرا میشود. ابزارهایی مانند Ollama و vLLM برای ارائه API مدلهای محلی کاربرد دارند.
- مدل ابری (Cloud LLM): درخواست به API یک ارائهدهنده خارجی ارسال میشود و پردازش روی زیرساخت آن انجام میگیرد.
- موتور مسیریابی (Routing Engine): مشخص میکند کدام مدل برای درخواست فعلی مناسب یا مجاز است.
برای مثال، خلاصهسازی یک متن عمومی ممکن است روی سرور محلی انجام شود؛ اما تحلیل یک سند عمومی بسیار طولانی میتواند به مدلی با ظرفیت Context بیشتر در Cloud منتقل شود. در مقابل، درخواست حاوی اطلاعات مالی محرمانه باید مطابق سیاست امنیتی سازمان پردازش شود و صرفاً بهدلیل کندبودن مدل محلی نباید به سرویس ابری منتقل شود.
نکته مهم: Hybrid Routing فقط Load Balancing یا تقسیم مساوی درخواستها نیست. در این معماری، مسیر پردازش به ماهیت داده، نیازهای درخواست و سیاستهای سازمان بستگی دارد.
تفاوت Hybrid LLM Routing با LLM Gateway چیست؟
یک LLM Gateway رابط مشترکی برای اتصال به مدلها فراهم میکند و میتواند قابلیتهایی مانند احراز هویت، Rate Limit، Logging و Fallback داشته باشد. Hybrid Routing یک لایه تصمیمگیری است که مشخص میکند هر درخواست تحت چه شرایطی به مدل محلی یا ابری فرستاده شود.
| ویژگی | LLM Gateway عمومی | Hybrid LLM Routing |
|---|---|---|
| هدف اصلی | مدیریت متمرکز ارتباط با مدلها | انتخاب محل مناسب پردازش |
| مسیریابی | بر اساس مدل، ظرفیت و سیاستهای عمومی | بر اساس محرمانگی، هزینه، تأخیر و توان مدل |
| مدل محلی | میتواند پشتیبانی شود | یکی از مسیرهای اصلی معماری است |
| مدل ابری | یکی از ارائهدهندگان Gateway | مسیر جایگزین یا تکمیلی پردازش |
| حریم خصوصی | نیازمند پیکربندی امنیتی | یکی از معیارهای اصلی تصمیمگیری |
| Failover | انتقال بین استقرارها یا مدلها | انتقال فقط بین مسیرهای مجاز |
بنابراین میتوان Hybrid Routing را در کنار LiteLLM یا سایر Gatewayها پیادهسازی کرد. مقاله حاضر بر سیاست انتخاب مسیر تمرکز دارد، نه تکرار امکانات عمومی API Gateway.
معماری Hybrid AI Gateway چگونه کار میکند؟
در یک معماری استاندارد، درخواست ابتدا وارد لایه تصمیمگیری میشود. این لایه، قبل از انتخاب مدل، نوع داده و محدودیتهای آن را بررسی میکند.
Application / Backend
        |
   Authentication
        |
  Data Classification
        |
  Routing Policy Engine
        |
        +-- Restricted Data --> Local Only
        |
        +-- Public Data
                 |
          Context / Cost / Latency
                 |
             +---+---+
             |       |
         Local LLM  Cloud API
             |       |
             +---+---+
                 |
          Response Validation
                 |
          Logging / Metrics
در این معماری، چهار وظیفه از یکدیگر جدا هستند:
- احراز هویت تعیین میکند چه برنامه یا کاربری اجازه ارسال درخواست دارد.
- طبقهبندی داده مشخص میکند درخواست شامل چه نوع اطلاعاتی است.
- موتور سیاستگذاری مسیرهای مجاز را تعیین میکند.
- موتور انتخاب مدل، از بین مسیرهای مجاز، بهترین گزینه را انتخاب میکند.
این ترتیب اهمیت زیادی دارد. اگر ابتدا ارزانترین مدل انتخاب شود و محرمانگی داده بعداً بررسی شود، ممکن است درخواست قبل از اجرای کنترل امنیتی به مقصد نامناسب ارسال شده باشد.
شش معیار اصلی انتخاب بین مدل محلی و ابری
۱. تأخیر پاسخ یا Latency
Latency مدتزمانی است که از ارسال درخواست تا دریافت پاسخ صرف میشود. این زمان فقط به سرعت مدل بستگی ندارد؛ تأخیر شبکه، صف پردازش، زمان شروع تولید پاسخ و تعداد توکنهای خروجی نیز بر آن اثر میگذارند.
مدل محلی، بهویژه اگر نزدیک اپلیکیشن اجرا شود، ممکن است تأخیر شبکه کمتری داشته باشد. بااینحال، یک GPU ضعیف یا سرور پرترافیک میتواند پاسخ بسیار کندتری نسبت به API ابری ایجاد کند.
برای مقایسه واقعی این شاخصها را اندازه بگیرید:
- TTFT: زمان دریافت اولین توکن پاسخ.
- End-to-End Latency: زمان تکمیل کل پاسخ.
- P95 Latency: زمانی که ۹۵ درصد درخواستهای اندازهگیریشده در آن یا سریعتر تکمیل شدهاند.
- Queue Time: مدت انتظار درخواست در صف پردازش.
بهجای انتخاب ثابت یک مسیر، میتوان از دادههای واقعی چند دقیقه اخیر استفاده کرد. البته مقایسه باید روی درخواستهای مشابه انجام شود؛ پاسخ ۵۰ توکنی با خروجی ۲۰۰۰ توکنی معیار یکسانی ندارد.
۲. هزینه واقعی پردازش یا Cost
هزینه یک مدل ابری معمولاً به تعداد توکنهای ورودی و خروجی و تعرفه همان مدل وابسته است. هزینه مدل محلی ساختار متفاوتی دارد و شامل سختافزار، GPU، برق، نگهداری و ظرفیت بلااستفاده نیز میشود.
یک مدل محلی الزاماً ارزانتر نیست. اگر برای تعداد کمی درخواست، یک GPU گرانقیمت را شبانهروزی روشن نگه دارید، هزینه هر درخواست میتواند از API ابری بیشتر باشد.
برای محاسبه تقریبی هزینه محلی میتوان از این رابطه استفاده کرد:
هزینه هر درخواست = مجموع هزینه ساعتی زیرساخت ÷ تعداد درخواست موفق در ساعت
فرض کنید زیرساخت پردازشی و عملیاتی شما ساعتی ۰٫۶ دلار هزینه دارد و در یک ساعت ۳۰۰ درخواست موفق را پردازش میکند. هزینه متوسط زیرساخت به ازای هر درخواست تقریباً ۰٫۰۰۲ دلار خواهد بود. این فقط یک مثال محاسباتی است، نه قیمت واقعی سرور یا GPU.
برای تصمیم صحیح باید ظرفیت واقعی، ساعات کممصرف، هزینه نگهداری و کیفیت خروجی را هم وارد محاسبه کنید.
۳. حریم خصوصی و محل پردازش داده
Privacy یکی از مهمترین دلایل استفاده از مدل محلی است. اطلاعات پزشکی، اسناد محرمانه شرکت، دادههای هویتی یا قراردادهای منتشرنشده ممکن است دارای محدودیتهای قانونی یا قراردادی باشند.
اما اجرای مدل روی سرور خودتان بهتنهایی امنیت کامل ایجاد نمیکند. دسترسی مدیران، لاگها، نسخههای پشتیبان، وابستگیهای نرمافزاری، اتصال شبکه و سیاست نگهداری داده همچنان اهمیت دارند.
در حالت ابری نیز باید قرارداد پردازش داده، محل نگهداری، مدت Retention و شرایط استفاده ارائهدهنده بررسی شود. نمیتوان فرض کرد همه APIهای ابری سیاست یکسانی برای ذخیره یا پردازش داده دارند.
۴. اندازه Context Window
Context Window حداکثر ظرفیت متنی است که مدل میتواند در یک درخواست یا گفتوگو پردازش کند. این ظرفیت معمولاً شامل پیامهای قبلی، دستورهای سیستم، ورودی ابزارها و فضای موردنیاز برای تولید خروجی است.
اگر یک مدل محلی Context کوچکتری داشته باشد، درخواست طولانی ممکن است با خطا مواجه شود یا به کوتاهسازی متن نیاز داشته باشد.
بااینحال، افزایش Context فقط به تنظیم یک عدد محدود نیست. حافظه GPU، پیادهسازی مدل، نوع Cache و کیفیت مدل در استفاده از متن بلند نیز اهمیت دارند.
در Hybrid Routing میتوان قبل از ارسال درخواست، تعداد توکنها را با Tokenizer مناسب تخمین زد و مدلهایی را که ظرفیت کافی ندارند کنار گذاشت.
۵. توانایی و کیفیت مدل
ممکن است یک مدل محلی برای دستهبندی تیکت یا استخراج اطلاعات ساده کاملاً مناسب باشد، اما برای تحلیل پیچیده کد، استدلال چندمرحلهای یا پردازش چندرسانهای به مدل دیگری نیاز داشته باشید.
بهتر است درخواستها بر اساس نوع کار نیز دستهبندی شوند؛ برای مثال، خلاصهسازی، پاسخگویی، تولید کد، استخراج JSON و تحلیل تصویر. سپس کیفیت هر مدل روی مجموعه آزمون واقعی همان کار اندازهگیری شود.
۶. دسترسپذیری و Failover
اگر سرور محلی از دسترس خارج شود، انتقال درخواستهای عمومی به Cloud میتواند تداوم سرویس را حفظ کند. ولی درخواست محرمانه نباید بدون مجوز به Cloud منتقل شود.
قاعده اصلی: شکست مسیر اصلی نباید سیاست امنیتی را تغییر دهد. برای دادههای محدودشده، مسیر پشتیبان باید یک مدل محلی یا زیرساخت خصوصی مجاز دیگر باشد؛ در غیر این صورت بهتر است سرویس خطای کنترلشده برگرداند.
Data Classification؛ قبل از Routing دادهها را طبقهبندی کنید
طبقهبندی داده مشخص میکند هر درخواست تا چه سطحی از زیرساخت قابل انتقال است. در سادهترین حالت میتوان سه سطح تعریف کرد:
| سطح داده | مثال | مسیر پیشنهادی |
|---|---|---|
| Public | اطلاعات عمومی، محتوای منتشرشده | مدل محلی یا API ابری مجاز |
| Internal | اسناد داخلی و دادههای عملیاتی | مدل خصوصی یا Cloud تأییدشده طبق سیاست سازمان |
| Restricted | رمزها، اطلاعات حساس و دادههای با محدودیت قانونی | فقط محیطهای مشخصاً مجاز؛ معمولاً Local Only در این سناریو |
این جدول یک سیاست نمونه است و جایگزین الزامات واقعی سازمان یا قانون نمیشود. بهعنوان مثال، بعضی سازمانها برای داده داخلی نیز استفاده از هرگونه API خارجی را ممنوع میکنند.
همچنین طبقهبندی نباید صرفاً بر اساس درخواست خود کاربر انجام شود. اگر کاربر بتواند یک سند محرمانه را با برچسب Public ارسال کند، کنترل امنیتی عملاً قابل دورزدن است.
راهکار مناسب، طبقهبندی مبتنی بر منابع معتبر سازمان، نقش کاربر، نوع سند و سیاستهای سمت سرور است. تشخیص خودکار داده حساس میتواند لایه کمکی باشد، اما نباید تنها معیار امنیتی سیستم باشد.
جدول تصمیمگیری برای Hybrid LLM Routing
| سناریو | مسیر مناسب | دلیل |
|---|---|---|
| داده محرمانه با مدل محلی سازگار | Local | جلوگیری از خروج غیرمجاز داده |
| داده عمومی و درخواست کوتاه | Local یا Cloud | بر اساس هزینه و تأخیر واقعی |
| درخواست عمومی با Context بسیار بلند | مدل دارای ظرفیت کافی | پیشگیری از خطای Context |
| GPU محلی اشباع شده است | Cloud مجاز | کاهش زمان انتظار |
| API ابری قطع شده است | Local سازگار، در صورت مجازبودن | افزایش دسترسپذیری |
| داده محرمانه و مدل محلی قطع است | خطای کنترلشده یا Local پشتیبان | حفظ سیاست امنیتی |
| درخواست نیازمند قابلیت خاص است | مدل دارای قابلیت تأییدشده | جلوگیری از خروجی نامعتبر |
برای پیادهسازی از چه ابزارهایی استفاده کنیم؟
در یک معماری ترکیبی، به دو بخش نیاز داریم: محیط اجرای مدل محلی و لایه مدیریت ارتباط یا انتخاب مسیر.
| ابزار | نقش | کاربرد اصلی |
|---|---|---|
| Ollama | Local Model Server | راهاندازی ساده مدل محلی و API |
| vLLM | Inference Server | سرویسدهی مدل با تمرکز بر کارایی و ظرفیت |
| LiteLLM | LLM Gateway / Router | یکپارچهسازی ارائهدهندگان، Routing و Fallback |
| Python / FastAPI | Policy Engine | اعمال قواعد اختصاصی محرمانگی، هزینه و انتخاب مسیر |
برای آزمایش اولیه، ترکیب Ollama و یک برنامه Python کافی است. برای مدیریت چند برنامه و ارائهدهنده، LiteLLM میتواند لایه مشترک مناسبی باشد. در محیطهای پرترافیک نیز vLLM گزینهای است که باید با بار واقعی پروژه ارزیابی شود.
منابع رسمی:
سازگاری OpenAI در Ollama،
مستندات سرویس vLLM و
مسیریابی LiteLLM.
پیشنیازهای ساخت Hybrid AI Gateway
برای بخش عملی این آموزش، به یک سرور لینوکسی دارای دسترسی SSH، پایتون، محیط اجرای مدل محلی و یک API Key ابری نیاز دارید.
- سیستمعامل پیشنهادی آزمایش: Ubuntu Server 24.04 LTS
- Python 3 و محیط مجازی برای نصب کتابخانهها
- Ollama یا یک سرویس محلی سازگار با OpenAI API
- کلید معتبر ارائهدهنده مدل ابری
- دسترسی شبکه امن میان برنامه Routing و سرویس مدل محلی
مقدار RAM و VRAM موردنیاز به مدل انتخابی، روش Quantization، تعداد کاربران همزمان و Context بستگی دارد. بنابراین برای همه مدلها نمیتوان یک حداقل سختافزاری ثابت اعلام کرد.
مرحله اول: آمادهسازی مدل محلی با Ollama
ابتدا Ollama را طبق راهنمای رسمی نصب کنید. روش نصب باید پیش از اجرا از نظر منبع فایل و سیاست امنیتی سرور بررسی شود.
راهنمای رسمی نصب Ollama روی Linux
پس از نصب، وضعیت سرویس را بررسی کنید:
systemctl status ollama

ollama --version

ollama list
سپس یک مدل سازگار با سختافزار خود دریافت کنید. دستور زیر از یک مدل نمونه برای آزمایش استفاده میکند:
ollama pull llama3.2

ollama run llama3.2
در صورت نصب و دریافت موفق مدل، میتوانید با API محلی به آن درخواست بفرستید. برای آزمایش اولیه، دسترسی را روی Loopback سرور نگه دارید و پورت 11434 را مستقیماً در اینترنت عمومی منتشر نکنید.
مرحله دوم: آزمایش API مدل محلی
Ollama یک رابط سازگار با بخشی از APIهای OpenAI ارائه میدهد. بنابراین میتوان از کلاینتهای متداول برای ارتباط با آن استفاده کرد.
curl http://127.0.0.1:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama3.2",
    "messages": [
      {
        "role": "user",
        "content": "Explain hybrid AI in one sentence."
      }
    ],
    "stream": false
  }'
اگر پاسخ دریافت شد، مسیر محلی آماده است. آدرس 127.0.0.1 فقط زمانی درست است که برنامه Routing و Ollama روی یک ماشین یا یک فضای شبکه مشترک مناسب اجرا شوند. در استقرار چندسروری، باید از شبکه خصوصی و کنترل دسترسی استفاده شود.
مرحله سوم: معرفی مدل محلی و ابری به LiteLLM
LiteLLM میتواند مدل محلی و API ابری را پشت نامهای منطقی مشترک مدیریت کند. نمونه زیر، الگوی پیکربندی دو گروه مدل است. شناسه مدل ابری باید با مدلی که در حساب ارائهدهنده شما در دسترس است جایگزین شود.
model_list:
  - model_name: local-ai
    litellm_params:
      model: ollama/llama3.2
      api_base: http://127.0.0.1:11434

  - model_name: cloud-ai
    litellm_params:
      model: openai/YOUR_CLOUD_MODEL_ID
      api_key: os.environ/OPENAI_API_KEY

router_settings:
  routing_strategy: simple-shuffle

litellm_settings:
  num_retries: 1
این نمونه فقط دو مقصد را تعریف میکند. بهخودیخود تشخیص داده محرمانه، مقایسه هزینه یا مسیریابی هوشمند را انجام نمیدهد. برای آن وظایف، باید یک لایه Policy Engine پیش از Gateway قرار بگیرد یا قابلیتهای کنترلی مناسب نسخه نصبشده را پیکربندی کنید.
همچنین اگر LiteLLM داخل کانتینر اجرا میشود، آدرس 127.0.0.1 به همان کانتینر اشاره دارد و معمولاً به Ollama روی میزبان متصل نمیشود. در این حالت باید آدرس سرویس در شبکه Docker یا مسیر خصوصی معتبر را تنظیم کنید.
مرحله چهارم: پیادهسازی موتور انتخاب مسیر با Python
حالا میخواهیم تصمیمگیری را از APIهای اصلی جدا کنیم. منطق نمونه به این صورت است:
- ابتدا سیاست محرمانگی درخواست از یک منبع مورداعتماد مشخص میشود.
- برای درخواست محرمانه، فقط مدل محلی مجاز است.
- برای درخواست عمومی، اگر Context از ظرفیت مجاز محلی بیشتر باشد، Cloud انتخاب میشود.
- برای درخواست عمومی کوتاه، مدل محلی ابتدا امتحان میشود و در صورت خطای موقت، Cloud میتواند جایگزین شود.
- اگر هیچ مسیر مجازی در دسترس نباشد، سرویس خطای کنترلشده برمیگرداند.
در این نمونه، تصمیمگیری از یک تابع مستقل انجام میشود. مقدار estimated_tokens باید از Tokenizer متناسب با مدل یا سرویس قابلاعتماد شمارش توکن بهدست بیاید؛ حدس تعداد توکن بر اساس طول رشته برای کنترل قطعی Context کافی نیست.
from dataclasses import dataclass

LOCAL_CONTEXT_BUDGET = 6000

@dataclass
class RequestPolicy:
    data_class: str
    estimated_tokens: int
    cloud_allowed: bool

def choose_route(policy: RequestPolicy) -> str:
    if policy.data_class == "restricted":
        return "local-ai"

    if policy.data_class == "internal":
        if not policy.cloud_allowed:
            return "local-ai"

    if policy.data_class not in {
        "public", "internal", "restricted"
    }:
        raise ValueError("Unknown data classification")

    if policy.estimated_tokens > LOCAL_CONTEXT_BUDGET:
        if policy.cloud_allowed:
            return "cloud-ai"
        raise ValueError(
            "No permitted model with sufficient context"
        )

    return "local-ai"
برای مثال، اگر یک سند عمومی ۱۵ هزار توکن داشته باشد و سقف عملی ورودی مدل محلی ۶ هزار توکن باشد، تابع میتواند مسیر ابری را انتخاب کند؛ مشروط بر اینکه مدل ابری ظرفیت لازم را داشته باشد و ارسال داده به آن مجاز باشد.
در نسخه واقعی، علاوه بر Context باید ظرفیت خروجی، توانایی مدل، بودجه باقیمانده، سلامت سرویس و وضعیت صف نیز بررسی شوند. همچنین داده طبقهبندی باید سمت سرور و بر اساس منابع معتبر تعیین شود، نه صرفاً برچسبی که کاربر در درخواست فرستاده است.
مرحله پنجم: طراحی Fallback بدون نقض حریم خصوصی
یکی از اشتباههای مهم در Hybrid AI، تعریف Fallback خودکار از هر مدل محلی به API ابری است. چنین تنظیمی در زمان قطعی سرور محلی ممکن است دادهای را به Cloud ارسال کند که اصولاً اجازه خروج از زیرساخت خصوصی را ندارد.
بهتر است برای هر کلاس داده، مسیرهای مجاز بهصورت مستقل تعریف شوند:
restricted:
  primary: local-ai
  fallback: local-ai-backup
  allow_cloud: false

internal:
  primary: local-ai
  fallback: approved-private-cloud
  allow_cloud: conditional

public:
  primary: local-ai
  fallback: cloud-ai
  allow_cloud: true
این YAML صرفاً نمایش یک سیاست مفهومی است و فایل تنظیمات مستقیم LiteLLM نیست. برای عملیاتیشدن آن باید Policy Engine یا لایه کنترل دسترسی، سیاست را پیش از هر فراخوانی و هر تلاش مجدد اجرا کند.
اگر درخواست Restricted باشد و مدل محلی و پشتیبان خصوصی هر دو قطع شوند، نتیجه درست ممکن است پاسخ 503 Service Unavailable باشد؛ نه ارسال پنهانی اطلاعات به Cloud.
مرحله ششم: ترکیب Latency و Cost در انتخاب مدل
برای درخواستهای عمومی که هر دو مسیر مجازند، میتوان از یک امتیاز ترکیبی استفاده کرد. برای مثال:
Routing Score = وزن تأخیر × تأخیر نرمالشده + وزن هزینه × هزینه نرمالشده + جریمه کیفیت نامناسب
هرچه امتیاز کمتر باشد، مدل مناسبتر است؛ البته فقط در بین مدلهایی که از کنترلهای محرمانگی، Context و قابلیت عبور کردهاند.
فرض کنید برای یک کار مشخص دو گزینه زیر را اندازهگیری کردهاید:
| معیار فرضی | مدل محلی | مدل ابری |
|---|---|---|
| زمان پاسخ | ۱٫۸ ثانیه | ۱٫۲ ثانیه |
| هزینه متوسط درخواست | ۰٫۰۰۲ دلار | ۰٫۰۰۸ دلار |
| کیفیت در آزمون داخلی | قابل قبول | قابل قبول |
| وضعیت داده | مجاز | مجاز |
این اعداد صرفاً یک مثال فرضی هستند. اگر اولویت پروژه حداقل هزینه باشد، مدل محلی احتمالاً انتخاب مناسبتری است؛ اگر تأخیر کمتر اهمیت بیشتری داشته باشد، مدل ابری ممکن است ترجیح داده شود.
برای جلوگیری از نوسان مداوم مسیر، بهتر است از میانگینهای متحرک، محدودیت دفعات تغییر مسیر و حاشیه تصمیمگیری استفاده شود. همچنین دادههای عملکرد باید با بار واقعی و اندازه خروجی مشابه مقایسه شوند.
اگر Context مدل محلی کافی نباشد چه کنیم؟
بزرگبودن ورودی همیشه به معنی ضرورت استفاده از Cloud نیست. پیش از تغییر مسیر، گزینههای زیر را بررسی کنید:
- استفاده از مدل محلی با Context مناسبتر و ظرفیت سختافزاری کافی.
- تقسیم سند به بخشهای کوچک و پردازش مرحلهای.
- استفاده از RAG برای بازیابی بخشهای مرتبط بهجای ارسال کل سند.
- خلاصهسازی کنترلشده و حفظ اطلاعات ضروری.
- انتقال به مدل ابری با Context بزرگتر، فقط در صورت مجازبودن داده.
LiteLLM قابلیت بررسی پیش از فراخوانی را برای حذف استقرارهای نامناسب ارائه میدهد و در برخی حالتهای Routing امکان انتقال درخواست به مدل با Context بزرگتر وجود دارد. بااینحال، این قابلیت به تنظیمات و اطلاعات واقعی ظرفیت مدل وابسته است و جای بررسی سیاست حریم خصوصی را نمیگیرد.
مرجع:
مراحل انتخاب Deployment در LiteLLM.
امنیت در Hybrid AI Gateway
اجرای مدل در شبکه خصوصی به معنای حذف تمام خطرات امنیتی نیست. در معماری Hybrid، ارتباط میان مدل محلی، Gateway، برنامه اصلی و ارائهدهنده ابری باید بهصورت مستقل بررسی شود.
- API مدل محلی را بدون کنترل دسترسی در اینترنت منتشر نکنید.
- بین سرور Gateway و سرور GPU از شبکه خصوصی یا ارتباط رمزنگاریشده استفاده کنید.
- کلیدهای API ابری را در Secret Manager یا محیط امن نگهداری کنید.
- قبل از Routing، طبقهبندی داده و مجوز انتقال را بررسی کنید.
- متن کامل درخواستهای محرمانه را بدون ضرورت در لاگ ذخیره نکنید.
- برای ابزارهای قابلاجرا توسط مدل، مجوزها و کنترل اثرات جانبی را مستقل اعمال کنید.
- در زمان Fallback نیز سیاست امنیتی اولیه را حفظ کنید.
- قوانین نگهداری داده، منطقه پردازش و الزامات قراردادی ارائهدهندگان را بررسی کنید.
در vLLM نیز نباید فرض کرد تنظیم API Key بهتنهایی تمام Endpointها را محافظت میکند؛ مستندات رسمی محدودیت پوشش احراز هویت بعضی مسیرها را توضیح میدهد. استقرار امن نیازمند محدودیت شبکه و Reverse Proxy مناسب است.
مانیتورینگ و معیارهای سنجش موفقیت
برای آنکه بفهمید Hybrid Routing واقعاً باعث بهبود شده است، فقط تعداد درخواستهای Local و Cloud را نشمارید. معیارهای زیر مفیدترند:
- درصد درخواستهای پردازششده روی مدل محلی و ابری.
- هزینه متوسط هر درخواست موفق.
- زمان پاسخ P50 و P95 برای هر مسیر.
- تعداد درخواستهای ردشده بهدلیل سیاست محرمانگی.
- تعداد رخدادهای Failover و علت آنها.
- نرخ خطای Context Window و Timeout.
- میزان اشغال GPU و طول صف محلی.
- کیفیت خروجی روی مجموعه آزمون مشخص.
برای مثال، افزایش درصد پردازش محلی لزوماً موفقیت نیست؛ اگر هزینه زیرساخت ثابت مانده ولی کیفیت پاسخ افت کرده یا زمان انتظار چند برابر شده باشد، سیاست مسیریابی باید اصلاح شود.
اشتباههای رایج هنگام پیادهسازی Hybrid Routing
انتخاب مسیر فقط بر اساس ارزانترین مدل
مدلی که هزینه کمتری دارد ممکن است پاسخ ناقص تولید کند و باعث درخواست مجدد یا دخالت نیروی انسانی شود. هزینه واقعی را با کیفیت و نرخ موفقیت بسنجید.
انتقال خودکار داده محرمانه به Cloud هنگام قطعی
Fallback نباید مجوزهای داده را تغییر دهد. اگر مقصد مجاز وجود ندارد، خطای شفاف برگردانید.
استفاده از تعداد کاراکتر برای تشخیص قطعی Context
تعداد توکن به Tokenizer وابسته است. طول متن فقط تخمین بسیار تقریبی است و برای کنترل ظرفیت باید از شمارش مناسب استفاده شود.
نادیدهگرفتن زمان صف GPU
حتی اگر اجرای یک مدل محلی سریع باشد، افزایش درخواستهای همزمان میتواند زمان پاسخ را چند برابر کند. ظرفیت و صف را هم در Routing لحاظ کنید.
فرض سازگاری کامل مدلهای محلی با API ابری
مدلهای مختلف ممکن است در Tool Calling، خروجی ساختاریافته، Streaming و محدودیت پارامترها رفتار متفاوتی داشته باشند. هر مسیر باید تست سازگاری مستقل داشته باشد.
چه زمانی Hybrid LLM Routing انتخاب مناسبی است؟
این معماری برای محصولاتی مفید است که همزمان چند نوع درخواست و سطح محرمانگی دارند؛ مانند سامانههای پشتیبانی، نرمافزارهای سازمانی، دستیارهای هوشمند داخلی و پروژههای RAG.
اگر فقط چند درخواست عمومی در روز دارید، ساخت یک زیرساخت ترکیبی ممکن است پیچیدگی و هزینه غیرضروری ایجاد کند. اما اگر بخشی از دادهها باید خصوصی بماند و بخشی از پردازشها به ظرفیت یا قابلیت Cloud نیاز دارند، Hybrid Routing میتواند انعطاف بیشتری ایجاد کند.
برای شروع، یک مدل محلی، یک مدل ابری و سه سطح مشخص محرمانگی کافی است. پس از ثبت آمار واقعی میتوانید سیاست هزینه، تأخیر و ظرفیت را توسعه دهید.
جمعبندی؛ مدل محلی بهتر است یا API ابری؟
پاسخ ثابت و یکسانی وجود ندارد. مدل محلی میتواند کنترل بیشتری بر محل پردازش داده فراهم کند و برای بارهای کاری پایدار گزینه مناسبی باشد. API ابری نیز ممکن است دسترسی سریعتر به مدلهای قدرتمندتر یا ظرفیت منعطفتر ایجاد کند.
Hybrid LLM Routing این دو رویکرد را در یک معماری واحد ترکیب میکند تا هر درخواست با توجه به محرمانگی، Context، کیفیت موردنیاز، زمان پاسخ و هزینه به مقصد مناسب برسد.
بهترین نقطه شروع، تعریف سیاستهای امنیتی روشن و اندازهگیری عملکرد واقعی است؛ سپس میتوان تصمیمگیری را بهتدریج هوشمندتر کرد. در این معماری، ارزانترین یا سریعترین مسیر فقط زمانی انتخاب مناسبی است که از ابتدا مجاز و از نظر فنی سازگار باشد.
سؤالات متداول درباره Hybrid LLM Routing
آیا Hybrid LLM Routing به GPU نیاز دارد؟
برای اجرای مدل محلی، بسته به اندازه مدل و سطح کارایی موردنیاز، ممکن است GPU ضروری یا بسیار مفید باشد. خود موتور Routing الزاماً به GPU احتیاج ندارد.
آیا میتوان Ollama را به API ابری متصل کرد؟
بله. میتوان Ollama را بهعنوان مسیر محلی در کنار یک API ابری قرار داد و با برنامه Python یا یک Gateway مناسب بین آنها تصمیمگیری کرد.
آیا انتقال به Cloud هنگام خرابی مدل محلی همیشه درست است؟
خیر. فقط درخواستهایی که سیاست محرمانگی و مجوز انتقال آنها اجازه میدهد باید به Cloud منتقل شوند.
کدام معیار برای انتخاب مسیر مهمتر است؟
ابتدا مجازبودن پردازش و سازگاری فنی را بررسی کنید؛ سپس هزینه، تأخیر و کیفیت را بین مسیرهای مجاز مقایسه کنید.
آیا LiteLLM بهتنهایی تمام سیاستهای Hybrid Routing را اعمال میکند؟
LiteLLM امکانات متنوعی برای Routing و مدیریت مدل دارد، اما سیاستهای اختصاصی محرمانگی و طبقهبندی داده باید متناسب با نیاز سازمان طراحی و اجرا شوند.
دیدگاهها (۰)