
 Amir Jabbari
پیادهسازی AI Agent روی VPS یعنی چه؟
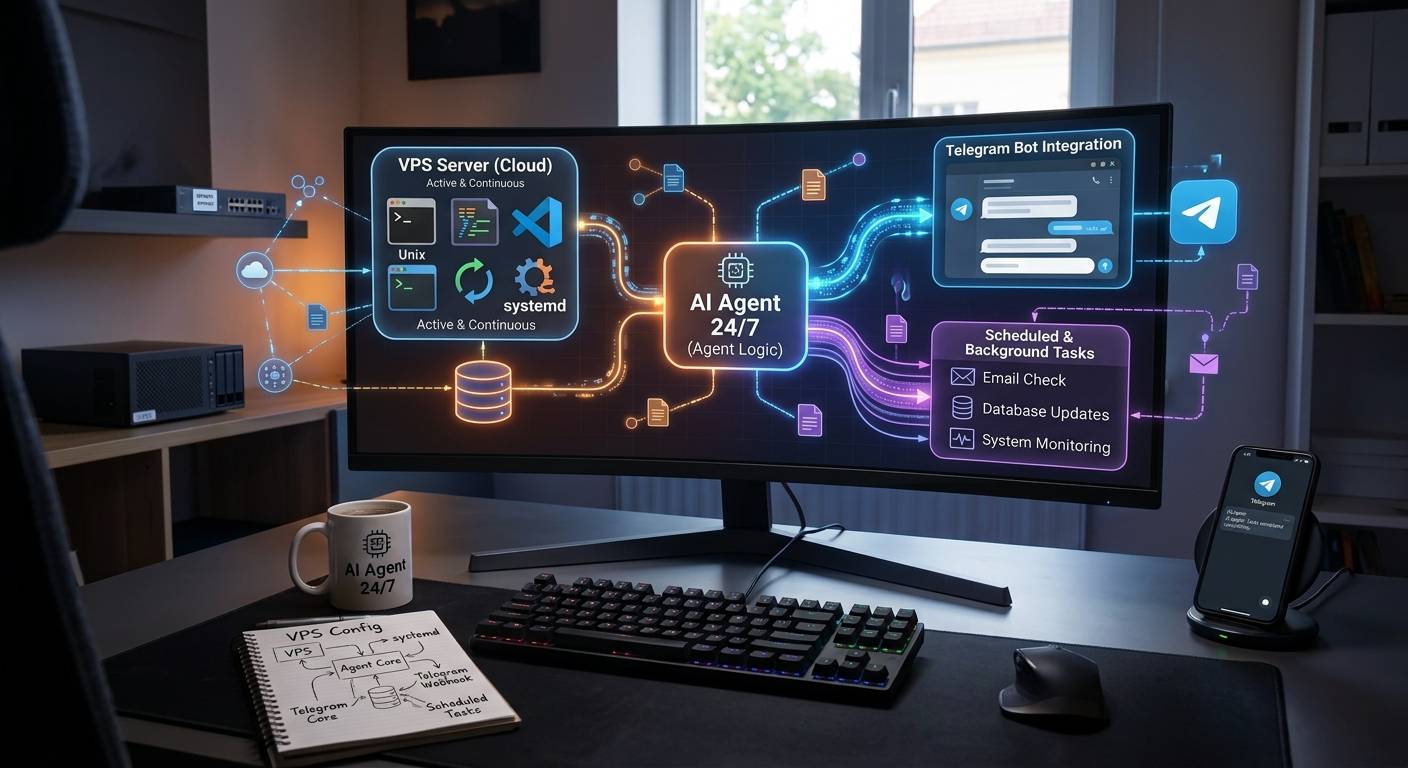
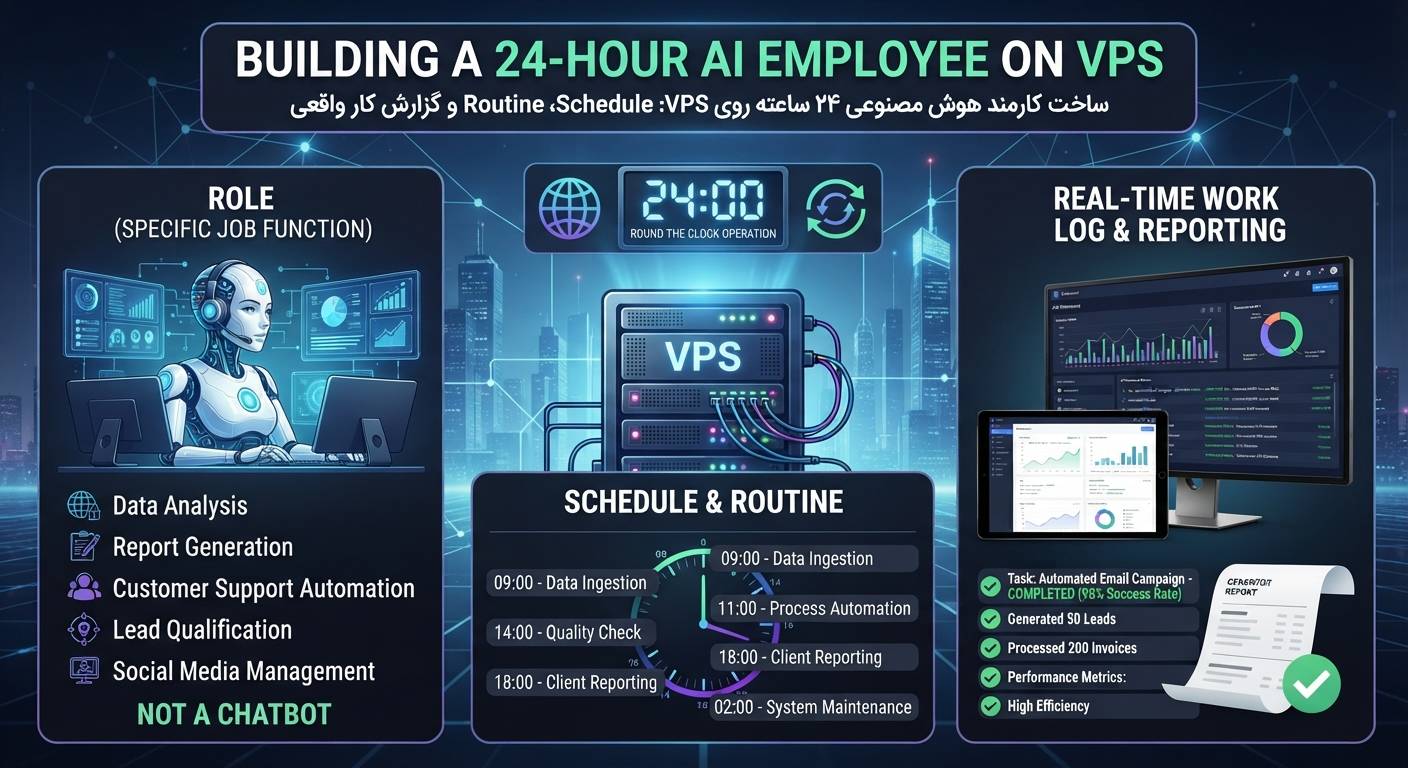
اگر میخواهید یک AI Agent فقط زمانی که لپتاپ شما روشن است کار نکند و بتواند ۲۴ ساعته پیام دریافت کند، ابزار اجرا کند، حافظه داشته باشد و به سرویسهای دیگر متصل شود، VPS یکی از سادهترین زیرساختها برای اجرای دائمی آن است.
اما یک نکته مهم وجود دارد: AI Agent با یک چتبات ساده فرق دارد. چتبات معمولاً ورودی میگیرد و پاسخ میدهد؛ Agent میتواند بر اساس هدف، ابزار انتخاب کند، چند مرحله را پشت سر هم اجرا کند، نتیجه ابزار را ببیند و در صورت نیاز تصمیم بعدی بگیرد. در معماریهای جدید LangChain نیز Agent بهصورت یک Graph اجرا میشود که بین مدل و Toolها رفتوبرگشت میکند تا به شرط توقف برسد.
در این راهنما چه میسازیم؟ یک AI Agent واقعی روی Ubuntu که بهصورت API روی سرور اجرا میشود، با Systemd بعد از Reboot بالا میآید، پشت Nginx قرار میگیرد، یک Tool نمونه دارد و برای توسعه به Memory، MCP، Human Approval، RAG و Sandbox آماده است.
AI Agent با Chatbot چه فرقی دارد؟
برای اینکه معماری اشتباه نسازیم، بهتر است تفاوت را روشن کنیم:
| ویژگی | Chatbot | AI Agent |
|---|---|---|
| تولید پاسخ | بله | بله |
| استفاده از Tool | اختیاری | بخش اصلی معماری |
| اجرای چندمرحلهای | معمولاً محدود | بله |
| حافظه و State | ممکن است داشته باشد | برای Agent واقعی مهم است |
| Human Approval | کمتر لازم است | برای Toolهای حساس ضروری است |
یک AI Agent واقعی از چه اجزایی تشکیل میشود؟
- Model: مدل زبانی که تصمیمگیری و تولید پاسخ را انجام میدهد.
- Tools: توابع یا سرویسهایی مثل جستوجو، دیتابیس، Git، ایمیل، CRM یا API داخلی.
- State: وضعیت اجرای Task و اطلاعات موقت هر Thread.
- Memory: اطلاعاتی که باید بین Sessionها باقی بمانند.
- Guardrail: محدودیتهایی برای جلوگیری از اجرای عملیات خطرناک.
- Human-in-the-loop: توقف Agent قبل از عملیات حساس برای تأیید انسان.
- Scheduler / Queue: برای Jobهای زمانبندیشده یا طولانی.
- Runtime: محیطی که Agent دائماً روی آن اجرا میشود؛ در اینجا VPS.
VPS چرا برای AI Agent مناسب است؟
اگر Agent روی لپتاپ اجرا شود، با Sleep، قطع اینترنت یا خاموششدن سیستم متوقف میشود. VPS محیطی دائمی برای اجرای API، Worker، Queue، Redis/PostgreSQL، Cron و سرویسهای جانبی فراهم میکند.
اگر مدل را از API خارجی میگیرید، معمولاً GPU لازم نیست. اگر مدل Local را روی همان سرور اجرا میکنید، منابع کاملاً متفاوت میشوند.
| سناریو | CPU شروع | RAM شروع | توضیح |
|---|---|---|---|
| Agent APIمحور ساده | 2 vCPU | 4GB | برای API، Webhook و Toolهای سبک |
| Agent با DB و چند Tool | 4 vCPU | 8GB | برای PostgreSQL، Redis و چند Worker |
| مدل Local کوچک | بسته به مدل | 16GB+ | Quantized و بار سبک |
| مدل Local سنگین | GPU Server | بسته به مدل | VRAM و Throughput تعیینکنندهاند |
این اعداد حداقل تضمینی نیستند. تعداد Toolها، همزمانی، مدل، طول Context، Queue و دیتابیس میتوانند مصرف منابع را تغییر دهند. بعد از Deploy حتماً مصرف واقعی را مانیتور کنید.
پیشنیازها؛ Ubuntu و کاربر غیر Root
برای این آموزش Ubuntu 24.04 مناسب است. بهتر است Agent را با کاربر محدود اجرا کنیم و نه با Root.
sudo apt update
sudo apt upgrade -y
sudo apt install -y python3 python3-venv python3-pip git curl nginx
یک کاربر سرویس بسازید:
sudo useradd --system --create-home --home-dir /opt/ai-agent --shell /usr/sbin/nologin aiagent
sudo mkdir -p /opt/ai-agent
sudo chown -R aiagent:aiagent /opt/ai-agent
مرحله ۱: ساخت محیط Python
sudo -u aiagent python3 -m venv /opt/ai-agent/venv
sudo -u aiagent /opt/ai-agent/venv/bin/pip install --upgrade pip
برای نمونه این مقاله از LangChain جدید، FastAPI و Uvicorn استفاده میکند:
sudo -u aiagent /opt/ai-agent/venv/bin/pip install \
  langchain langchain-openai fastapi "uvicorn[standard]" python-dotenv
مرحله ۲: ساخت Agent واقعی با Tool
در نسخههای جدید LangChain، تابع create_agent یک Agent Graph میسازد که مدل را در حلقه با Toolها اجرا میکند. این تفاوت مهمی با نمونه قدیمی «فقط ChatOpenAI + invoke» دارد؛ آن نمونه در واقع Chatbot بود، نه Agent کامل.
فایل /opt/ai-agent/app.py را بسازید:
import os
from datetime import datetime, timezone

from fastapi import FastAPI, Header, HTTPException
from pydantic import BaseModel

from langchain.agents import create_agent
from langchain_openai import ChatOpenAI

model = ChatOpenAI(
    model=os.environ["OPENAI_MODEL"],
    api_key=os.environ["OPENAI_API_KEY"],
)

def server_time() -> str:
    """Return the current UTC time of the agent server."""
    return datetime.now(timezone.utc).isoformat()

agent = create_agent(
    model=model,
    tools=[server_time],
    system_prompt=(
        "You are a private AI agent running on a VPS. "
        "Use tools only when needed. Never claim a tool succeeded unless "
        "you actually received a successful tool result."
    ),
)

app = FastAPI()

class ChatRequest(BaseModel):
    message: str

def verify_key(x_api_key: str | None):
    if not x_api_key or x_api_key != os.environ["AGENT_API_KEY"]:
        raise HTTPException(status_code=401, detail="Unauthorized")

@app.get("/health")
def health():
    return {"status": "ok"}

@app.post("/chat")
def chat(payload: ChatRequest, x_api_key: str | None = Header(default=None)):
    verify_key(x_api_key)

    result = agent.invoke({
        "messages": [
            {"role": "user", "content": payload.message}
        ]
    })

    return {
        "answer": result["messages"][-1].content
    }
Tool این نمونه فقط ساعت UTC سرور را برمیگرداند و Read-only است. بعداً میتوانید Toolهای واقعی خودتان را اضافه کنید.
مرحله ۳: ساخت Secretها بدون قرار دادن کلید داخل کد
برای API Key مدل و API Key داخلی Agent از Environment File استفاده کنید:
sudo openssl rand -hex 32خروجی را برای AGENT_API_KEY نگه دارید و سپس:
sudo nano /opt/ai-agent/.envOPENAI_API_KEY=YOUR_REAL_API_KEY
OPENAI_MODEL=YOUR_AVAILABLE_MODEL_NAME
AGENT_API_KEY=YOUR_LONG_RANDOM_KEYدسترسی فایل را محدود کنید:
sudo chown aiagent:aiagent /opt/ai-agent/.env
sudo chmod 600 /opt/ai-agent/.env
مدل را هاردکد نکردهایم. نام مدل را از مدلهای فعال حساب/API خودتان انتخاب کنید. این کار باعث میشود مقاله با تغییر نام مدلها منقضی نشود.
مرحله ۴: تست Agent قبل از دائمیکردن سرویس
cd /opt/ai-agent
sudo -u aiagent bash -c 'set -a; source .env; set +a; ./venv/bin/uvicorn app:app --host 127.0.0.1 --port 8000'
در ترمینال دیگری Health Check را اجرا کنید:
curl http://127.0.0.1:8000/healthانتظار داریم:
{"status":"ok"}برای تست Chat:
curl -X POST http://127.0.0.1:8000/chat \
  -H "Content-Type: application/json" \
  -H "X-API-Key: YOUR_LONG_RANDOM_KEY" \
  -d '{"message":"ساعت سرور را بررسی کن"}'
مرحله ۵: همیشهروشنکردن AI Agent با Systemd
در مقاله قبلی Agent به یک برنامه CLI متصل به Terminal تبدیل شده بود. برای سرویس ۲۴ ساعته بهتر است Process واقعی API را زیر Systemd اجرا کنیم.
sudo nano /etc/systemd/system/ai-agent.service[Unit]
Description=Iranica AI Agent API
After=network-online.target
Wants=network-online.target
[Service]
Type=simple
User=aiagent
Group=aiagent
WorkingDirectory=/opt/ai-agent
EnvironmentFile=/opt/ai-agent/.env
ExecStart=/opt/ai-agent/venv/bin/uvicorn app:app --host 127.0.0.1 --port 8000
Restart=on-failure
RestartSec=5
NoNewPrivileges=true
PrivateTmp=true
[Install]
WantedBy=multi-user.targetفعالسازی:
sudo systemctl daemon-reload
sudo systemctl enable --now ai-agent
sudo systemctl status ai-agent
برای لاگ:
sudo journalctl -u ai-agent -fمرحله ۶: قرار دادن Agent پشت Nginx
Port 8000 را روی اینترنت باز نکنید. Uvicorn روی localhost باقی میماند و Nginx درخواست را Proxy میکند.
sudo nano /etc/nginx/sites-available/ai-agentserver {
listen 80;
server_name agent.example.com;
location / {
proxy_pass http://127.0.0.1:8000;
proxy_http_version 1.1;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
proxy_set_header X-Forwarded-Proto $scheme;
}
}sudo ln -s /etc/nginx/sites-available/ai-agent /etc/nginx/sites-enabled/ai-agent
sudo nginx -t
sudo systemctl reload nginxمرحله ۷: HTTPS با Let’s Encrypt
sudo apt install -y certbot python3-certbot-nginx
sudo certbot --nginx -d agent.example.com
بعد از فعالشدن HTTPS، درخواست را از دامنه تست کنید. API Key همچنان لازم است؛ TLS جای Authentication را نمیگیرد.
Memory در AI Agent؛ حافظه کوتاهمدت و بلندمدت
حافظه را با «تاریخچه چت داخل RAM» اشتباه نگیرید. در LangGraph، Checkpointer برای حفظ State یک Thread استفاده میشود و Store برای دادههای بلندمدت میان Threadها کاربرد دارد.
برای تست میتوان از InMemorySaver استفاده کرد، اما مستندات فعلی LangGraph صریحاً آن را برای Debugging و Testing میدانند. برای Production، PostgresSaver و AsyncPostgresSaver گزینههای پایدارتر هستند.
| روش | کاربرد | Production؟ |
|---|---|---|
| InMemorySaver | تست سریع | خیر |
| SQLite Saver | پروژه کوچک / توسعه | برای بار جدی توصیه نمیشود |
| PostgresSaver | State پایدار و History | بله |
اگر Agent شما باید بعد از Restart دقیقاً از همان Thread ادامه دهد، این بخش از معماری را از ابتدا جدی بگیرید.
Human-in-the-loop؛ قبل از Toolهای خطرناک توقف کنید
یکی از مهمترین ارتقاهای Agentهای جدید این است که Tool حساس بدون تأیید انسان اجرا نشود. LangChain اکنون Middleware آماده Human-in-the-loop دارد که میتواند اجرای Tool را متوقف کند و تصمیمهایی مثل Approve، Edit یا Reject بگیرد.
Toolهای مناسب برای Approval:
- ارسال ایمیل
- حذف فایل
- نوشتن در دیتابیس
- اجرای SQL تغییردهنده
- ثبت سفارش
- ارسال پیام به مشتری
- تغییر تنظیمات سرور
اصل امنیتی: Toolهای Read-only را میتوان خودکارتر کرد؛ Toolهای Write/Delete/Execute باید محدودیت، Log و در بسیاری از سناریوها Approval داشته باشند.
MCP در AI Agent چه نقشی دارد؟
Model Context Protocol یک استاندارد برای اتصال AI Application به Toolها، Resourceها و سرویسهای بیرونی است. نسخه نهایی فعلی پروتکل 2026-07-28 است و SDKهای جدید روی همین نسل پروتکل حرکت کردهاند.
در Agent واقعی، MCP میتواند اتصال استاندارد به Git، فایلها، CRM، دیتابیس، سیستم Ticketing یا API داخلی را سادهتر کند. اما MCP Server Remote باید مثل هر سرویس شبکه دیگری احراز هویت، Scope و محدودیت دسترسی داشته باشد.
اگر میخواهید Agent شما با مرورگر کار کند، راهنمای Browser Use روی VPS برای AI Agent را ببینید.
برای اجرای ابزارهای پرریسک، مقاله Sandbox برای AI Agent نیز مکمل همین معماری است.
RAG چه زمانی به Agent اضافه میشود؟
اگر Agent باید بین هزاران سند، Wiki، فایل یا مستندات شرکت جستوجو کند، بهتر است همه داده را داخل Prompt نریزید. RAG بخش مرتبط را بازیابی میکند و همان Context را به مدل میدهد.
برای دیتابیس برداری میتوانید از ابزارهایی مثل Qdrant استفاده کنید. راهنمای Qdrant برای RAG روی VPS مسیر تخصصی این بخش را پوشش میدهد.
Agent را با Docker اجرا کنیم یا Systemd؟
هر دو معتبرند. Systemd برای یک سرویس ساده Python بسیار سبک و قابل فهم است. Docker زمانی جذابتر میشود که Agent چند سرویس وابسته، CI/CD یا محیط قابلانتقال داشته باشد.
| معیار | Systemd | Docker |
|---|---|---|
| راهاندازی | ساده | نیازمند Container |
| Isolation | کمتر | بیشتر |
| Deploy بین سرورها | دستیتر | قابلحملتر |
| مناسب چند سرویس | ممکن است | معمولاً بهتر |
امنیت AI Agent روی VPS
- Agent را با Root اجرا نکنید.
- Port داخلی Uvicorn را عمومی نکنید.
- Secretها را داخل Git نگذارید.
- API عمومی را بدون Authentication رها نکنید.
- HTTPS را فعال کنید.
- Toolهای حساس را Allowlist کنید.
- برای Write/Delete/Execute از Human Approval استفاده کنید.
- لاگ Tool Callها را نگه دارید.
- برای Shell یا Browser Automation از Sandbox استفاده کنید.
- Backup و Rollback را قبل از Upgrade آماده کنید.
Firewall ساده با UFW
sudo ufw allow OpenSSH
sudo ufw allow 'Nginx Full'
sudo ufw enable
sudo ufw status
مانیتورینگ و عیبیابی Agent
Agent بالا نمیآید
sudo systemctl status ai-agent
sudo journalctl -u ai-agent -n 100 --no-pager
Nginx خطای 502 میدهد
curl http://127.0.0.1:8000/health
sudo nginx -t
sudo tail -n 100 /var/log/nginx/error.log
RAM بالا میرود
free -h
htop
ps aux --sort=-%mem | head
اگر Memory Leak دارید، Swap فقط زمان میخرد و مشکل اصلی را حل نمیکند. Process، Queue، History و حجم Context را بررسی کنید.
API خطای Rate Limit یا Credit میدهد
این خطا از Agent Framework نیست. Billing، Rate Limit و Credential سرویس مدل را جداگانه بررسی کنید. Retry نامحدود نگذارید؛ Backoff و سقف Retry تعریف کنید.
یک Agent ۲۴ ساعته حرفهای چه معماریای دارد؟
Client: Telegram / Web / App / Internal Service
Gateway: Nginx + HTTPS + Authentication
Agent API: FastAPI + LangChain Agent
State: LangGraph Checkpointer
Long-term Memory: PostgreSQL / Store
Tools: API / DB / Search / MCP
Risk Control: Human Approval + Sandbox
Runtime: Systemd یا Docker
Observability: Log + Metrics + Error Tracking
چه زمانی Dify یا n8n بهتر از کدنویسی مستقیم است؟
اگر هدفتان ساخت سریع Workflow، Webhook و اتصال سرویسهاست، ابزارهای Low-code میتوانند زمان توسعه را کم کنند. اگر Agent باید State پیچیده، Tool Policy، Middleware، Test و منطق سفارشی داشته باشد، کدنویسی مستقیم انعطاف بیشتری میدهد.
برای Dify راهنمای آموزش Dify روی VPS را ببینید. اگر هدف شما زیرساخت AI Coding Agent برای تیم توسعه است، مقاله راهاندازی سرور هوش مصنوعی و Coding Agent خصوصی مکمل این آموزش است.
سؤالات متداول درباره پیادهسازی AI Agent
آیا برای ساخت AI Agent حتماً VPS لازم است؟
خیر. برای توسعه میتوانید روی سیستم شخصی کار کنید، اما برای Agent همیشهروشن، Webhook، API و Jobهای ۲۴ ساعته VPS محیط پایدارتر و مستقلتری فراهم میکند.
آیا AI Agent با Chatbot فرق دارد؟
بله. Agent علاوه بر تولید پاسخ میتواند Tool فراخوانی کند، State داشته باشد و چند مرحله برای تکمیل یک Task اجرا کند.
چطور Agent بعد از بستن SSH روشن میماند؟
با اجرای سرویس زیر Systemd یا Docker. در این مقاله API Agent را با Systemd مدیریت کردیم تا بعد از Reboot هم خودکار بالا بیاید.
آیا Agent به GPU نیاز دارد؟
اگر مدل را از API خارجی استفاده میکنید معمولاً خیر. GPU زمانی مهم میشود که مدل Local را روی خود سرور اجرا کنید.
برای حافظه Agent چه دیتابیسی مناسب است؟
برای Production، PostgreSQL یکی از گزینههای مناسب است و LangGraph نیز PostgresSaver و AsyncPostgresSaver برای Checkpoint پایدار ارائه میدهد.
MCP برای AI Agent ضروری است؟
خیر. MCP یک روش استاندارد برای اتصال Tool و Resource است. برای پروژه ساده میتوانید Toolهای مستقیم داشته باشید؛ در اکوسیستم بزرگتر MCP میتواند یکپارچهسازی را تمیزتر کند.
آیا Agent را میتوان بدون تأیید انسان آزاد گذاشت؟
برای Toolهای Read-only ممکن است، اما برای عملیات Write، Delete، پرداخت، ارسال پیام یا اجرای Shell بهتر است Guardrail و Human Approval داشته باشید.
منابع و مستندات رسمی
جمعبندی
برای پیادهسازی AI Agent روی VPS، فقط «اجرای یک اسکریپت Python» کافی نیست. یک Agent همیشهروشن باید API یا Worker پایدار، مدیریت Process، Authentication، Tool، State، Memory، Log و مسیر بازیابی از خطا داشته باشد. در سطح حرفهایتر، Human Approval، MCP، RAG و Sandbox نیز به معماری اضافه میشوند. با این ساختار، همان URL فعلی میتواند هم Intent «ساخت AI Agent» و هم «پیادهسازی AI Agent روی VPS» را پاسخ دهد بدون اینکه مقاله موازی و رقیب بسازیم.
برای اجرای AI Agent روی VPS نیاز به راهنمایی دارید؟
نوع Agent، تعداد Toolها، مدل مورد استفاده و اینکه سرویس APIمحور است یا مدل Local اجرا میکند را مشخص کنید تا منابع مناسبتر انتخاب شوند.
تماس با پشتیبانی ایرانیکاسرور: 021-91302467
دیدگاهها (۰)